Claude 智能体配置如何进入代码评审:ant apply 实战
Claude Managed Agents 的 ant apply 可将智能体、环境、技能、记忆存储和部署配置纳入仓库评审。本文拆解 claude-lock.json、CI 漂移检测、交接成本测算与生产边界,并给出从非生产智能体开始试点的可执行流程,帮助团队判断这套配置即代码工作流是否值得采用。

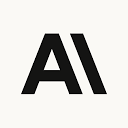


Claude 智能体的运维方式在 2026 年 9 月 3 日 迎来一项真正影响工作流的更新:Claude Managed Agents 现在可以通过 ant apply,把仓库中的文件部署为实际运行的智能体、环境、技能、记忆存储和部署任务。更关键的变化在于,智能体配置终于能像代码一样先接受评审,再进入生产环境。
Claude 智能体配置进入评审流程,而不只是多了一个 CLI 命令
Claude Managed Agents 是 Anthropic 面向长时间运行和异步任务提供的托管智能体系统。智能体定义模型、提示词、工具和技能;环境定义其运行位置;部署则可以让智能体按计划定时执行。
它与放在 .claude/agents/ 中的 Claude Code 子智能体不是一回事。本次更新针对的是 Claude API 的 Managed Agents 服务及其背后的资源。
如果团队通过 Console 或一次性 API 调用创建这些资源,真正有用的状态往往散落在两个地方:远端服务保存实际资源,而脚本、文档或某位同事的记忆负责解释资源当初是怎么建出来的。交接时,接手者必须重新把两边对应起来。
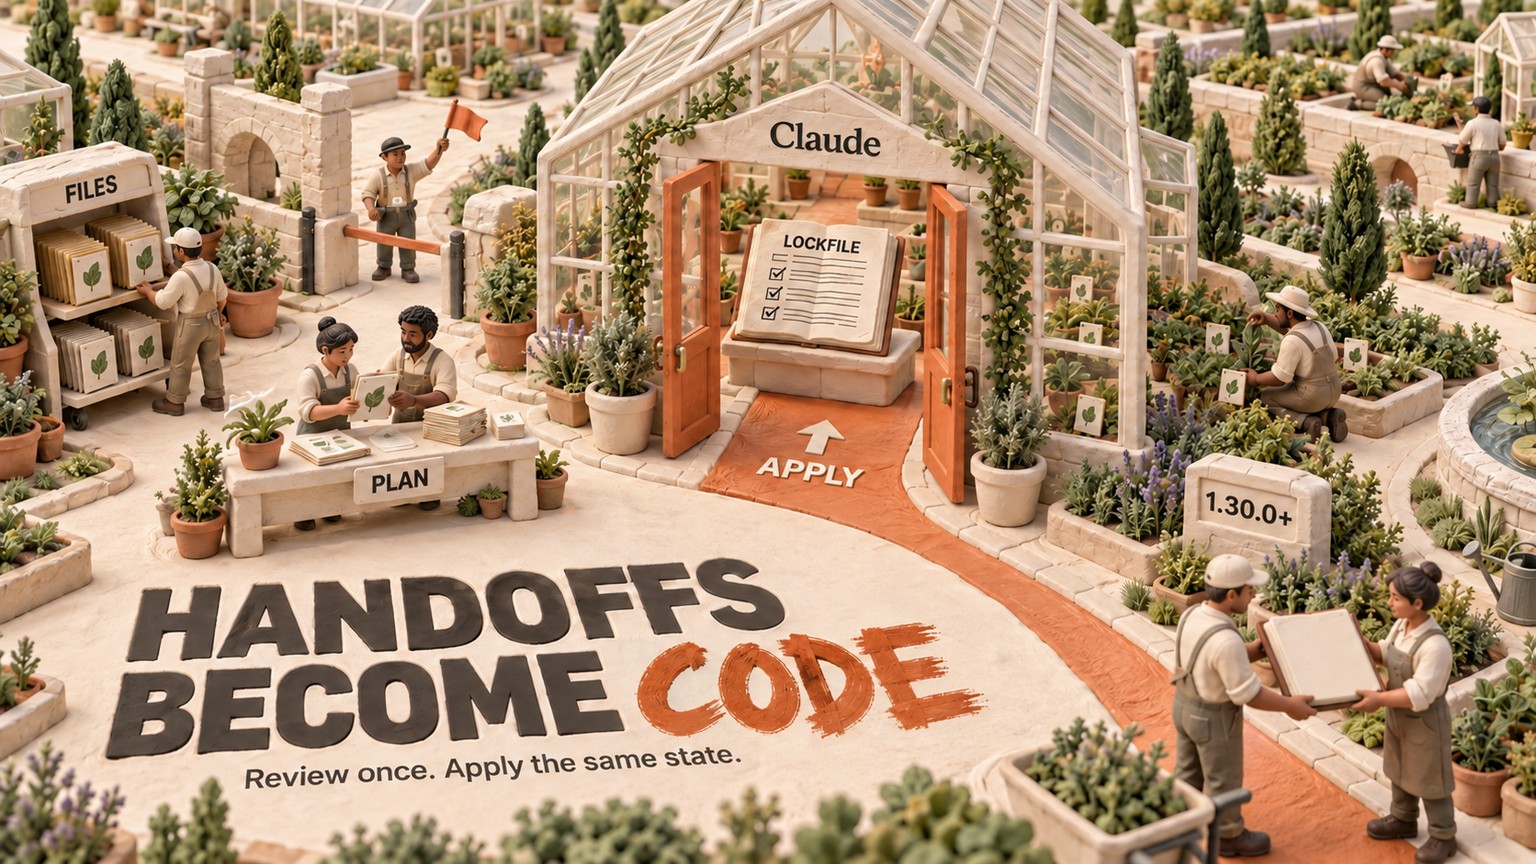
ant apply 把这项职责交给仓库。团队用 Markdown、YAML 或 JSON 描述资源;CLI 将文件与远端资源进行比较,输出执行计划,等待批准后再应用变更。
这样一来,系统提示词、工具权限、环境、技能包、记忆存储和调度计划都能进入同一个 pull request。真正持有部署凭据的人或 CI 作业动手之前,评审者就能看清将要发生什么变化。
本文面向已经在考虑使用 Managed Agents 的团队。如果只使用 Claude 应用、Claude Code,或基于 Messages API 自建智能体循环,ant apply 不会改变现有工作方式。
锁文件才是可靠交接的关键
真正重要的不只有智能体定义文件,还有 claude-lock.json。
第一次成功执行 apply 后,CLI 会在命令的运行目录写入这个锁文件。因此应从仓库根目录运行命令,并把锁文件与资源文件一起提交。
锁文件记录 API 来源、组织、工作区,以及每个本地文件所对应的远端 ID;它还保存本地哈希和远端哈希。本地哈希用来发现文件变更,远端哈希则能识别是否有人通过 Console 或其他 API 路径修改了资源。
可以把它理解成通讯录与收据的结合:资源文件描述期望状态,锁文件说明该文件负责哪个线上对象,以及上一次 apply 完成后两端分别是什么状态。
这正是交接变得更干净的原因。下一位操作人员或 CI runner 不必猜测哪个智能体 ID 属于 agents/reviewer.md;它会读取映射,更新同一份资源,而不是再创建一个副本。
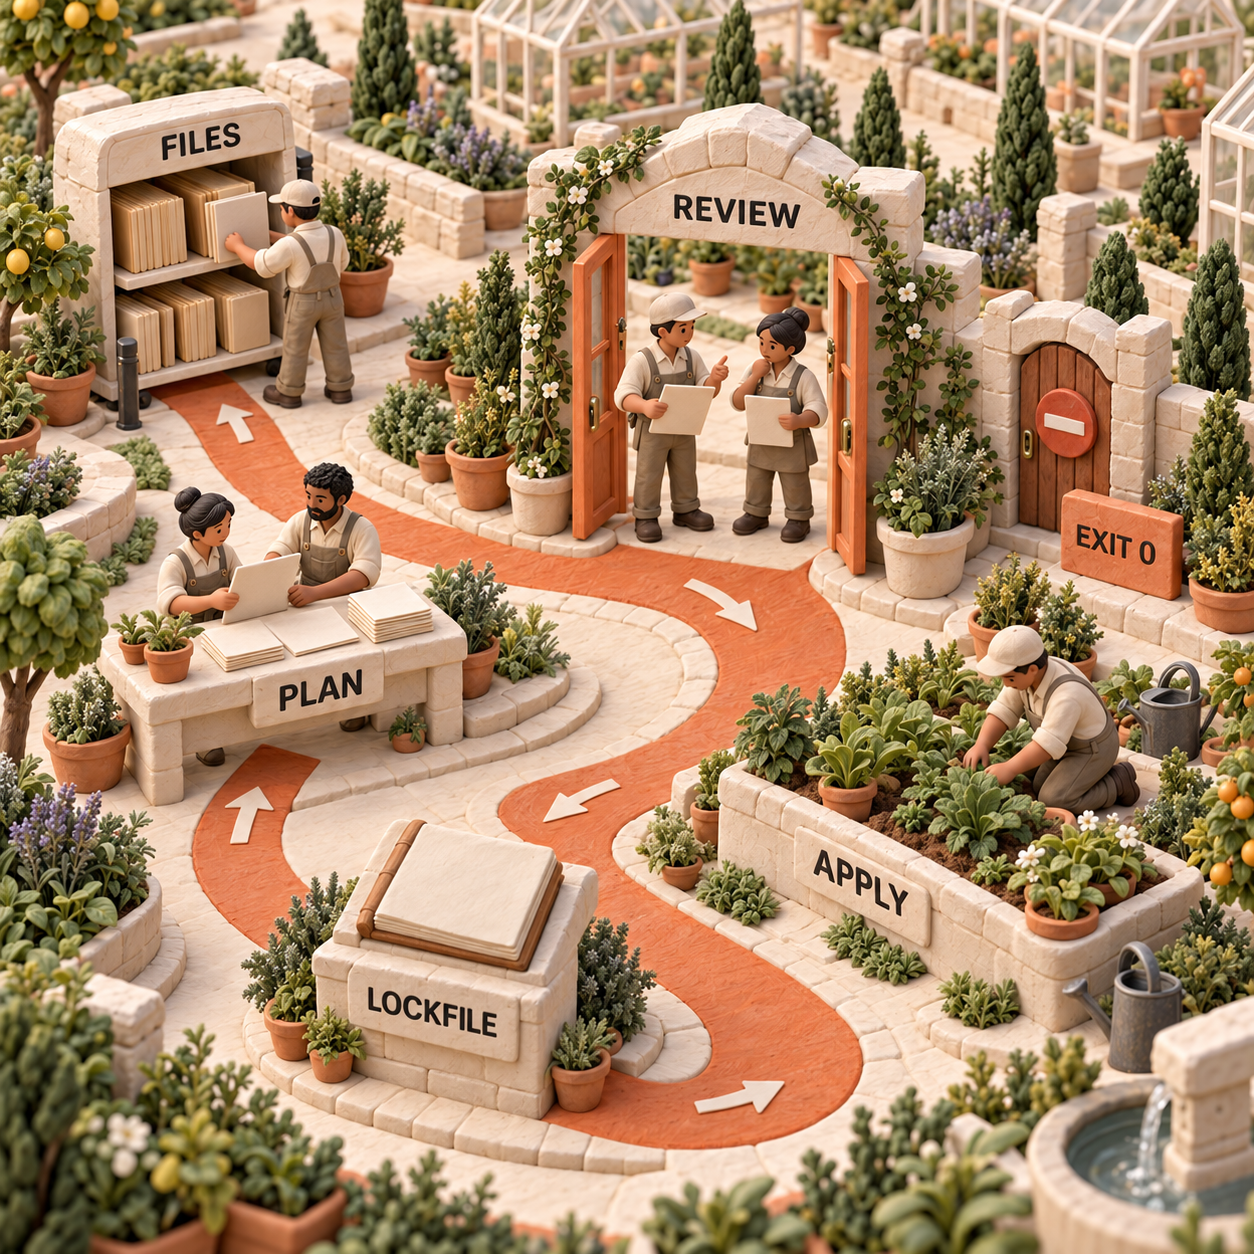
凡是 API 通常要求填写 ID 的位置,资源之间都可以改用相对路径引用。Apply 会自动计算依赖顺序,创建或更新各项资源,并填入真实 ID。智能体可以指向技能目录;部署可以指向对应的智能体、环境和记忆存储。
智能体和技能引用会固定在本次 apply 所使用的版本。从 GitHub URL 拉取的技能也会固定到解析出的 commit,直到使用 --upgrade。这样,评审面对的是一个明确目标,而不是不断移动的分支末端。
是否值得采用,算的是交接人力账
ant apply 不会让智能体运维变成零成本,它只是改变了预算花在哪儿。
旧成本来自反复配置、验证和交接;新成本则来自仓库搭建、pull-request 评审、CI 归属和锁文件维护。哪一种更便宜,取决于配置变更有多频繁,以及同一变更需要进入多少个环境。
下面只是一个带明确假设的例子,不是基准测试,也不是 Anthropic 宣称的节省幅度。
假设某团队每月进行四次配置变更,覆盖三个目标环境;每次变更在每个环境中的人工交接耗时 15 分钟。
每月人工操作时间为:
4 changes × 3 environments × 15 minutes = 180 minutes
再假设仓库流程中,每次变更需要 30 分钟评审,并需要 10 分钟在每个环境中应用和检查。
每月仓库流程时间为:
4 changes × (30 review minutes + 3 × 10 apply minutes) = 240 minutes
按这些输入计算,仓库流程每月反而慢 60 分钟。如果现有人工交接本就很轻,这就是应该接受的结论。
在不计搭建和维护成本时,单次人工交接达到 20 分钟才是盈亏平衡点。如果实测人工交接需要 30 分钟,同样的人工流程将增至 360 分钟,而仓库流程仍为 240 分钟,相差 120 分钟。不过,在团队真正测量工作量之前,这仍然只是一项表格计算。
把包含附加成本的人力费率代入这些分钟数,再加入一次性搭建成本,以及评审失败计划、解决漂移和维护 CI 的持续开销。只有完整成本低于现有流程时,这个工具才真正值得采用;演示看起来整洁,并不能证明它省钱。
哪些团队能从这套工作流中获益
平台团队获得统一的评审界面
软件公司的平台负责人可以把智能体、技能、环境、记忆存储和定时部署放进同一个 pull request。评审者能够一次查看完整的运行变更,不必再拿提示词文件与远端 Console 截图逐项比对。
收益在于可追溯性:团队可以从已合并的变更,一路对应到资源计划以及随后生成的锁文件状态。
服务商能更清楚地完成客户交接
服务商的技术负责人可以按客户保存资源文件,并让锁文件对应到该客户自己的组织和工作区。换人接手时,映射关系会跟着仓库一起交付。
收益是交接时少做资源身份猜测,但这并不意味着一个锁文件可以跨客户复用。只要凭据解析到不同的组织或工作区,Apply 就会拒绝执行——这恰好是服务商应该保留的边界。
运维团队获得明确的部署步骤
运维负责人可以在 pull request 中预览变更,并在默认分支上通过 ant apply --yes . 应用已经合并的目录。末尾的点号不能省略,因为不带路径的 apply 只会协调锁文件中已经跟踪的资源,可能漏掉刚新增的文件。
收益是得到一个可重复执行的部署步骤。不过运行时仍需要单一写入者,因为 apply 不会锁定锁文件;两个并发作业可能争用同一份状态。
安全负责人获得远端漂移拦截
安全负责人可以利用远端哈希,在仓库状态覆盖 Console 修改之前发现漂移。如果托管资源曾在文件之外被编辑、归档或删除,Apply 会阻止继续执行。
收益在于团队必须显式作出决定:调查并协调远端变更,或使用 --force 有意覆盖。需要 Zero Data Retention 或 HIPAA Business Associate Agreement 保障的团队,则应暂缓采用 Managed Agents 本身,因为该服务目前不符合这两项要求。
可直接执行的最小仓库示例
ant apply 要求 CLI 1.30.0 或更高版本。官方快速入门文档提供了 Homebrew 安装方式和浏览器登录流程。
安装并完成身份验证
安装 CLI,确认版本,然后登录:
Bashbrew install anthropics/tap/ant ant --version ant auth login创建一个智能体文件
按照文档中的最小定义创建
agents/summarizer.md:Markdown--- name: Summarizer model: claude-opus-5 tools: - type: agent_toolset_20260401 --- You are a helpful assistant that writes concise summaries.从仓库根目录执行第一次 apply
运行文档中的单文件命令:
Bashant apply agents/summarizer.md检查计划;如需查看逐字段差异,先请求详细信息,再批准执行。成功运行后,远端智能体会被创建,
claude-lock.json也会写入项目目录。将预览与应用拆成不同作业
在 pull request 中使用文档给出的预览命令:
Bashant apply --dry-run .合并后,将部署作业串行化,并对指定目录执行:
Bashant apply --yes .最后提交更新后的锁文件;即使 apply 部分失败也要提交,因为部分执行可能已经创建了资源,并将其写入锁文件。
CI 最容易踩的状态码陷阱
这一点很重要,因为远端漂移本就是正常的运维状态。有人可能在评审结束到合并完成之间,通过 Console 修改智能体。预览应当把这种情况变成一个可见、待决策的问题,而不是留下一个绿色方框,等部署作业稍后才发现异常。
apply 作业应使用 Workload Identity Federation,而不是保存 API key。作业必须绑定到锁文件记录的组织和工作区,并且同一时间只允许一个 apply 运行。
这套配置管理的真实边界
配置文件化并不意味着所有远端资源都能被纳入管理。
ant apply 无法接管一个已经通过 Console 或 ant beta:agents create 独立创建的智能体。如果文件和锁文件来自 Console 的 Export as code 流程,apply 可以继续更新这些已导出的资源;否则,即便应用一份内容匹配的文件,也会创建另一个资源。
删除策略同样保守。删除本地文件只会留下远端资源并输出警告;--prune 才会删除远端资源。重命名文件则会被视为声明一个新资源,旧资源仍会保留,直到执行 prune。
因此,--force 和 --prune 都是生产控制手段,而不是顺手清理的快捷方式,两者都应该经过评审。一次错误重命名之后若自动执行 prune,可能删掉部署仍在依赖的资源。
锁文件也会成为团队共享的运维状态。每次 apply 后都要提交它,保护其所在分支,并让写入操作串行执行。如果某次运行中途失败,不能因为作业标红就丢弃锁文件变更。
最后,Managed Agents 仍是一项 beta 服务。Claude API 账户默认启用 Claude Managed Agents,但需要 Zero Data Retention 或 HIPAA BAA 的团队仍受产品能力限制,仓库评审无法解决这一问题。
下周一可以怎么开始
如果有不止一个人会修改同一批 Managed Agents 资源、同一份配置需要进入多个环境,或定时部署需要明确负责人和评审记录,就值得在本周开始行动。
如果一个稳定实验始终由同一位操作人员负责、实测交接成本低于新增评审成本,或数据政策要求 Zero Data Retention 或 HIPAA BAA,则应暂缓采用。
如果智能体只运行在 Claude Code、Claude 应用或自建的 Messages API 循环中,且不使用 Claude Managed Agents 资源,这项变化与你无关。
下周一,先选择一个非生产智能体,把它的定义文件和锁文件放进一次真实的 pull request。分别记录当前交接流程与评审流程的耗时;然后在这个安全环境中制造一次远端修改,确认 pull-request 检查会把受阻计划真正标记为受阻。完成这些验证之后,再把 ant apply --yes . 放到合并操作之后执行。
- 最近更新
- 2026年9月8日
在 Google 中优先显示本站


把 omidsaffari.com 设为优先来源,Google 会在 Top Stories、AI Overviews 和 AI Mode 中为您优先展示。
Grok 语音转文字升级 2.0:价格不变,默认模型已切换
Grok Voice Transcribe 2.0 的批处理仍为每音频小时 $0.10,流式处理仍为 $0.20,但省略 model 参数时默认模型已经切换。本文拆解价格、适用场景和迁移风险,并给出用真实音频对比 1.0 与 2.0、核对人工校正时间和下游结果,再显式锁定生产模型的操作清单。2026年9月20日Explained
Cloudflare Browser Run 加强浏览器自动化调试:失败任务先查再重跑
Cloudflare 为已完成的 Browser Run 录制加入 Inspect 面板,可集中查看控制台日志、网络请求、HAR 和最终 DOM。本文讲清如何启用 Session Recording、按 target 获取网络轨迹,并判断哪些失败应先查现有证据,哪些仍需截图与应用日志,减少浏览器重跑和人工复现时间。2026年9月19日Explained
v0 接入 npm 私有包:让原型直接复用团队组件库
v0 现已支持通过共享环境变量安装 npm 私有包,让原型直接复用团队现有组件库。本文拆解 NPM_TOKEN 与 NPM_RC 的适用场景、最小权限配置、真实仓库交接检查,以及上线前仍需补齐的文档、安全与工程验证,帮助团队判断这项能力能否减少组件替换返工,并厘清凭证如何留在模型与沙箱文件系统之外。2026年9月19日Explained
Claude Code 自动模式不再单收分类器费用,但有前提
Claude Code 2.1.278 可在符合条件的 API 与 Enterprise 会话中取消自动模式分类器的单独费用,但网关、区域或凭证仍可能触发计费回退。本文说明如何通过 /status 确认服务端路径、排查 safeguards 等透传字段,并在调整智能体预算前验证真实生产链路。2026年9月19日Explained
Vercel 构建费用新机制:Turbo 可按单次部署启用
Vercel 现在允许 Pro 和 Enterprise 项目仅为一次部署启用 Turbo,无需修改项目默认构建机器。本文拆解 GitHub、CLI 与 API 三种用法,并用同一组计费数据说明何时值得为紧急发布支付更高的 Vercel 构建费用,以及如何验证下一次部署已恢复原配置。2026年9月18日Explained
ChatGPT for Word 上线:写文档不再来回复制
ChatGPT for Word 将起草、摘要、选中文本修改和基础排版直接带进 Word 侧边栏。本文详解插件的安装条件、Microsoft 与 ChatGPT 双重管理权限、共享用量和 token 费率、数据边界,以及一套可执行的文档编辑流程,帮助团队判断是否值得启用,并用真实文档衡量省下的搬运时间与新增的审核成本。2026年9月18日Explained
Antigravity 迁移指南:10 月 5 日前升级本地任务
Google 将于 2026 年 10 月 5 日停用 5 月版 Antigravity 智能体。本指南拆解 Antigravity 迁移路径:仅消费最终输出的远程任务只需更换智能体 ID;使用本地工具或解析 function_call 的集成,还必须更新工具适配器、参数校验与测试流程,避免定时任务在截止日后悄然中断。2026年9月18日Explained