Cloudflare AI Search 接入 R2:AI 搜索不再要求文件扩展名
Cloudflare AI Search 现可依据 HTTP Content-Type 索引无扩展名的 R2 对象,无需改动稳定键。本文说明支持范围、4 MB 限制、R2 元数据修复成本、同步节奏与验证流程,并给出可直接落地的 Worker 上传示例,帮助团队判断该更新能否简化现有 AI 搜索管线。

Cloudflare AI Search 在 2026 年 9 月 11 日的更新中,解决了 AI 搜索从 R2 摄取内容时受文件名限制的问题。如果文档保存在没有扩展名的稳定键下,现在无需改动这些键:只要为每个对象写入受支持的 HTTP Content-Type,就能让文件进入搜索。
这意味着摄取流程可以少一道重命名工序。但元数据清理、建立索引,以及确认文档确实能被搜索到,仍然不可省略。
这次 AI 搜索更新究竟改了什么
Cloudflare AI Search 是一项面向自有内容的托管搜索服务。R2 存储桶是其中一种数据来源;R2 则是 Cloudflare 的对象存储。AI Search 会读取存储桶,把受支持的文档转换为可搜索文本,再构建供应用查询的索引。
在这次更新之前,最稳妥的类型识别方式依赖文件扩展名。manual.pdf 这样的键会直接告诉索引器文件类型,而 documents/manual-alpha 这样的稳定键不会。
现在,AI Search 也能读取无扩展名对象的普通 HTTP Content-Type。application/pdf 表示内容是 PDF,text/markdown 表示 Markdown。Cloudflare 列出的支持类型还包括 text/plain、application/json、text/html 和 text/csv。
文件扩展名并未失效。Cloudflare 仍将可识别的扩展名视为首选且更快的检测路径。只有当改键会破坏 URL、数据库引用、租户映射、签名或现有上传契约时,新路径的价值才真正显现。
这里必须分清两类元数据。Content-Type 是 R2 对象上的 HTTP 元数据,并不是 AI Search 用来按类别、客户或文档状态筛选结果的自定义元数据。这些自定义字段通过 x-amz-meta-* 请求头传递,还需要在 AI Search 中定义 schema。添加 x-amz-meta-content-type 并不能替代真正的 HTTP 字段。
此次更新改变的是源内容摄取,也就是文档进入索引的环节;它没有改变检索之后负责生成答案的模型。GLM-5.3 Flash 更新发生在后面的生成阶段。
业务层面的变化:少维护一套命名体系
使用不透明键通常有充分理由。产品可以把稳定的数据库 ID 作为 R2 键,这样替换对象也不必更改地址;文档服务可以避免暴露客户的原始文件名;签名 URL 也可能依赖完全一致的键。
过去的变通办法,是为搜索副本另建一个带扩展名的名称,或在 AI Search 看到对象之前增加重命名工序。这样就多出一套需要保存、核对和清理的身份标识。
现在,只要 HTTP 元数据正确,原始键就可以保持不变。这才是此次更新真正省掉的流程。
下表对比了更新前后的摄取工作量。它是流程模型,并非实测基准数据,也不是对节省幅度的承诺。
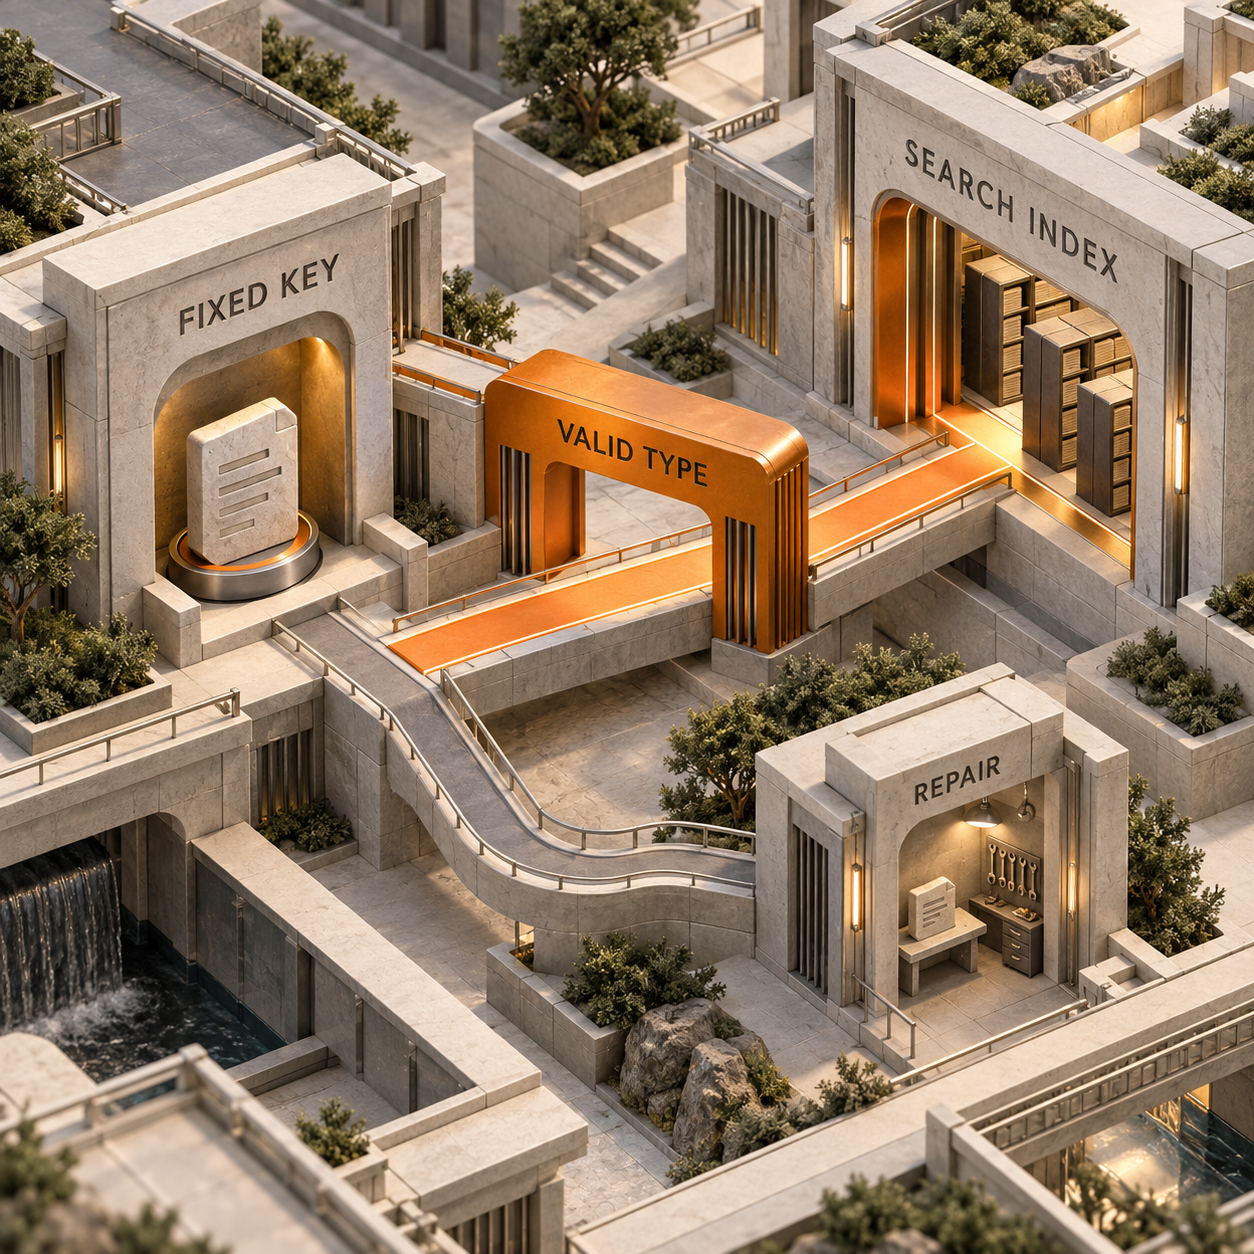
表中刻意没有给出金额收益。Cloudflare 没有公布该功能能节省多少时间,这次发布也不会替你重写现有元数据。
后续工作会产生哪些成本
在公开测试期间,AI Search 可在 Workers 套餐限制内免费使用,存储和向量索引均包含在内。Workers AI 和 AI Gateway 的用量仍可能单独计费,但此次摄取更新不会改变这些费率。
修复元数据可能产生 R2 费用。ListObjects、PutObject 和 CopyObject 属于 Class A 操作;修复工具可能用来检查或读取对象的 HeadObject 和 GetObject,则属于 Class B 操作。
对于 Standard 存储,每月 100 万次免费额度用完后,Class A 请求按每百万次 $4.50 收费。Infrequent Access 没有免费额度,Class A 请求按每百万次 $9.00 收费;读取或复制对象时,还可能按每 GB $0.01 计费。
据此可以得到一条务实的预算规则:Content-Type 正确的对象,无需为改名进行专门修复;值错误的对象仍可能需要写入或复制,具体取决于所用工具。安排全存储桶清理前,先计算这些操作的数量。
AI Search 侧同样受规模影响。Workers Free 的单实例上限为 100,000 个文件。Workers Paid 可容纳 100 万个文件;启用 hybrid search 时,上限为 500,000 个。两个套餐的单文件上限都仍是 4 MB。
哪些团队现在就能用上
使用稳定上传 ID 的独立 SaaS 创业者
保留数据库已经记录的 R2 键,并让上传器在写入对象时附上真实 MIME 类型。这样,客服搜索可以直接摄取同一对象,不必再增加第二个文件名字段,也不必运行批处理任务来创建搜索副本。
直接收益是:客户替换、删除或移动文档时,需要核对的身份标识更少。但如果对象需要进入搜索,上传流程仍应拒绝通用二进制类型。
维护旧存储桶的平台工程师
列出无扩展名对象及其 HTTP 元数据,把每个值与 Cloudflare 支持的 MIME 类型逐一比对,并单独整理失败项。先修复一小批样本,再处理整个存储桶。
这样可以把迁移控制在明确范围内:修复预算只花在确有问题的对象上,元数据有效的键则直接进入同步和验证流程。
多租户产品团队
继续使用不会泄露原始文件名的不透明对象键,并在上传时通过可信的服务端检查设置 Content-Type。如果各租户需要独立的索引边界,再分别配置 AI Search 路径过滤器或前缀。
其价值在于架构保持一致:存储身份与文件展示方式相互独立,索引器仍能获得可验证的类型。
代运营客户知识库的服务商
在操作手册中拆开两类元数据任务。HTTP Content-Type 决定无扩展名文件能否被摄取;自定义 x-amz-meta-* 字段则在 schema 定义后决定如何筛选已索引结果。
这样排障会更清晰。文档缺失时,团队会先检查摄取元数据,而不是直接调整筛选规则或答案模型。
让无扩展名对象进入支持路径
Cloudflare 的 R2 Workers API 通过 httpMetadata 接收请求头。下面这个 Worker 会保留请求路径作为对象键,并拒绝没有 Content-Type 的上传请求。
在 wrangler.jsonc 中将 R2 存储桶绑定为 DOCS:
{
  "$schema": "./node_modules/wrangler/config-schema.json",
  "name": "r2-document-upload",
  "main": "src/index.ts",
  "compatibility_date": "2026-09-11",
  "r2_buckets": [
    {
      "binding": "DOCS",
      "bucket_name": "your-bucket"
    }
  ]
}
然后使用这个 Worker:
interface Env {
  DOCS: R2Bucket;
}

export default {
  async fetch(request, env): Promise<Response> {
    if (request.method !== "PUT") {
      return new Response("Method Not Allowed", { status: 405 });
    }

    const key = new URL(request.url).pathname.replace(/^\//, "");
    const contentType = request.headers.get("content-type");

    if (!key || !contentType) {
      return new Response("Key and Content-Type are required");
    }

    await env.DOCS.put(key, request.body, {
      httpMetadata: request.headers,
    });

    return new Response(`Stored ${key}`);
  },
} satisfies ExportedHandler<Env>;
运行 npx wrangler dev,把 Wrangler 输出的本地地址赋给 WORKER_URL,然后把本地 PDF 上传到一个无扩展名的目标地址:
curl "$WORKER_URL/documents/manual-alpha" \
  --request PUT \
  --header "Content-Type: application/pdf" \
  --data-binary @manual.pdf
这个示例只能证明存储环节成功,不能证明索引已经完成。用于生产环境时,还需要加入授权,从可信的内容检查结果推断类型,而不是只相信用户提供的文件名,并将结果与 Cloudflare 的支持列表比对。
必须说清:上传成功不等于可以搜索
R2 写入具有强一致性,因此写入成功后,对象及其元数据就已可见。但 AI Search 建立索引是另一项异步任务:即使同步请求已被接受,条目之后仍可能失败。
使用 R2 数据源的实例默认每 6 小时同步一次。你可以选择 1、2、4、6、12 或 24 小时的间隔,也可以自行启动任务:
npx wrangler ai-search jobs create <INSTANCE_NAME>手动源同步最多每 30 秒运行一次。增加重试次数并不能修复错误的元数据。
任务结束后,应检查条目日志、条目详情或实例统计信息。如果 AI Search 无法接受检测到的文件类型,对应的条目级错误是 unsupported_type。修复对象后,再同步该条目或整个数据源。
如果所有 R2 键本来就带有可识别的扩展名,这次更新不会影响你;如果 AI Search 使用的是网站或内置存储,而不是外部 R2 存储桶,同样不受影响。它也不会让不受支持的格式或超出大小限制的文件突然变得可索引。
下周一该怎么做
先审计,不要一上来就批量重写。
找出被跳过的无扩展名对象
列出 R2 对象时包含
httpMetadata,持续分页,直到truncated为 false;再把这些键与 AI Search 条目日志及unsupported_type失败记录交叉核对。给元数据分类
把受支持的 MIME 类型,与缺失、格式错误、不受支持及
application/octet-stream的值分开。不要把自定义x-amz-meta-*字段纳入这项检查,因为它解决的是另一个问题。修复一小批导入样本
从实际存储的格式中选一组规模小但有代表性的样本。在工具允许的情况下保留原键,用正确的 HTTP
Content-Type写入或复制每个对象。同步并验证检索结果
触发一次源同步。等待条目处理完成,检查日志,再搜索每份文档中的一段已知文字。存储写入显示成功并不是终点,能够返回来源段落才算验证通过。
验证通过后再扩大范围
估算修复方式会产生多少 Class A 和 Class B 操作,确认 R2 存储类别,再扩大批次。同时更新上传器,确保新的无扩展名对象在写入时就带有受支持的元数据。
如果稳定或不透明的 R2 键迫使你为 AI Search 维护第二套命名路径,应在本周采取行动。如果现有对象缺少可信的类型信息,先不要动,因为批量重写前必须制定分类方案。如果可识别的扩展名已经让摄取流程顺畅运行,则无需操作。
如果希望把下一次平台更新也转化为可执行的运营判断,欢迎订阅邮件简报。
- 最近更新
- 2026年9月12日
在 Google 中优先显示本站


把 omidsaffari.com 设为优先来源,Google 会在 Top Stories、AI Overviews 和 AI Mode 中为您优先展示。
Grok 语音转文字升级 2.0:价格不变,默认模型已切换
Grok Voice Transcribe 2.0 的批处理仍为每音频小时 $0.10,流式处理仍为 $0.20,但省略 model 参数时默认模型已经切换。本文拆解价格、适用场景和迁移风险,并给出用真实音频对比 1.0 与 2.0、核对人工校正时间和下游结果,再显式锁定生产模型的操作清单。2026年9月20日Explained
Cloudflare Browser Run 加强浏览器自动化调试:失败任务先查再重跑
Cloudflare 为已完成的 Browser Run 录制加入 Inspect 面板,可集中查看控制台日志、网络请求、HAR 和最终 DOM。本文讲清如何启用 Session Recording、按 target 获取网络轨迹,并判断哪些失败应先查现有证据,哪些仍需截图与应用日志,减少浏览器重跑和人工复现时间。2026年9月19日Explained
v0 接入 npm 私有包:让原型直接复用团队组件库
v0 现已支持通过共享环境变量安装 npm 私有包,让原型直接复用团队现有组件库。本文拆解 NPM_TOKEN 与 NPM_RC 的适用场景、最小权限配置、真实仓库交接检查,以及上线前仍需补齐的文档、安全与工程验证,帮助团队判断这项能力能否减少组件替换返工,并厘清凭证如何留在模型与沙箱文件系统之外。2026年9月19日Explained
Claude Code 自动模式不再单收分类器费用,但有前提
Claude Code 2.1.278 可在符合条件的 API 与 Enterprise 会话中取消自动模式分类器的单独费用,但网关、区域或凭证仍可能触发计费回退。本文说明如何通过 /status 确认服务端路径、排查 safeguards 等透传字段,并在调整智能体预算前验证真实生产链路。2026年9月19日Explained
Vercel 构建费用新机制:Turbo 可按单次部署启用
Vercel 现在允许 Pro 和 Enterprise 项目仅为一次部署启用 Turbo,无需修改项目默认构建机器。本文拆解 GitHub、CLI 与 API 三种用法,并用同一组计费数据说明何时值得为紧急发布支付更高的 Vercel 构建费用,以及如何验证下一次部署已恢复原配置。2026年9月18日Explained
ChatGPT for Word 上线:写文档不再来回复制
ChatGPT for Word 将起草、摘要、选中文本修改和基础排版直接带进 Word 侧边栏。本文详解插件的安装条件、Microsoft 与 ChatGPT 双重管理权限、共享用量和 token 费率、数据边界,以及一套可执行的文档编辑流程,帮助团队判断是否值得启用,并用真实文档衡量省下的搬运时间与新增的审核成本。2026年9月18日Explained
Antigravity 迁移指南:10 月 5 日前升级本地任务
Google 将于 2026 年 10 月 5 日停用 5 月版 Antigravity 智能体。本指南拆解 Antigravity 迁移路径:仅消费最终输出的远程任务只需更换智能体 ID;使用本地工具或解析 function_call 的集成,还必须更新工具适配器、参数校验与测试流程,避免定时任务在截止日后悄然中断。2026年9月18日Explained