AI电话机器人价格怎么算?GPT-Live-1 通话成本拆解
GPT-Live-1 的语音会话按每分钟 $0.05 计费,但这不是一通电话的全部成本。本文拆解语音时长、后端模型与工具、运营商传输三笔账,并用 90 秒预约电话算清每次成功解决任务的真实支出,同时说明 SIP 接入、插话处理与人工转接为何会改变最终预算,帮助团队设计可衡量的入站电话试点。



谈到 AI电话机器人价格,GPT-Live-1 先把其中一项变得清晰:语音会话每分钟 $0.05。自 2026 年 9 月 10 日起,团队可以把听与说收进同一条链路;但真正值得拿来做预算的,仍是一通电话成功解决问题的完整成本,其中还包括后端推理、工具调用和电话传输。
每分钟五美分,只是语音层
GPT-Live-1 是一款全双工语音模型。所谓全双工,就是模型说话时仍能继续听:来电者可以随时插话、停顿、纠正细节,或简短回应,不必等一轮僵硬的对话完全结束。
这会改变整个系统的形态。传统语音智能体通常要串联语音转文字、语言模型和文字转语音。应用不仅要在每次交接时搬运信息,还得判断双方同时开口时该怎么处理。
GPT-Live-1 把实时对话集中在一个语音层中:它负责听、说、把握时机,并判断何时应把更复杂的工作交给后端。后端可以查询预约、读取账户记录、调用工具,也可以根据规则做进一步推理。
后端是刻意拆开的。你可以使用 Responses 委派,让 GPT-Live-1 把任务交给自行配置的 OpenAI 文本模型;也可以使用客户端委派,由自己的应用运行任意模型、智能体或服务,再把结果传回。语音体验无需改变,团队却能按任务选择更省钱或推理更深入的“大脑”。
电话连接 又是独立的一层。入站电话可以通过电话服务商提供的互联网连接——SIP 中继——接入 GPT-Live-1,也可以先进入应用,再由应用转发音频。OpenAI 负责 Live 会话,号码和电话传输仍由运营商负责。
预算上的变化就这些:在这条技术路径中,不必再把语音识别和语音生成拆成两个独立的 OpenAI 模型环节计价,但仍要把三笔账分清楚。
AI电话机器人价格由三笔账构成
第一个容易踩的坑是计时方式。GPT-Live-1 计费覆盖从会话开始到关闭的全部活跃时长。静默会计费,等待工具返回也会计费,把麦克风静音并不会让账单暂停。
第二个坑,是因为后端藏在对话背后,就把它当成免费资源。事实并非如此。标准短上下文价格中,GPT-5.6 Luna 每百万输入 token 为 $0.20,每百万输出 token 为 $1.20;GPT-5.6 Terra 分别为 $2.00 和 $12.00;GPT-6 Astra 则为 $10.00 和 $50.00。真正该比较的不是谁的 token 单价最低,而是哪种组合能以最少的总通话时长和返工,可靠地完成任务。
一通预约电话,才算得出真实成本
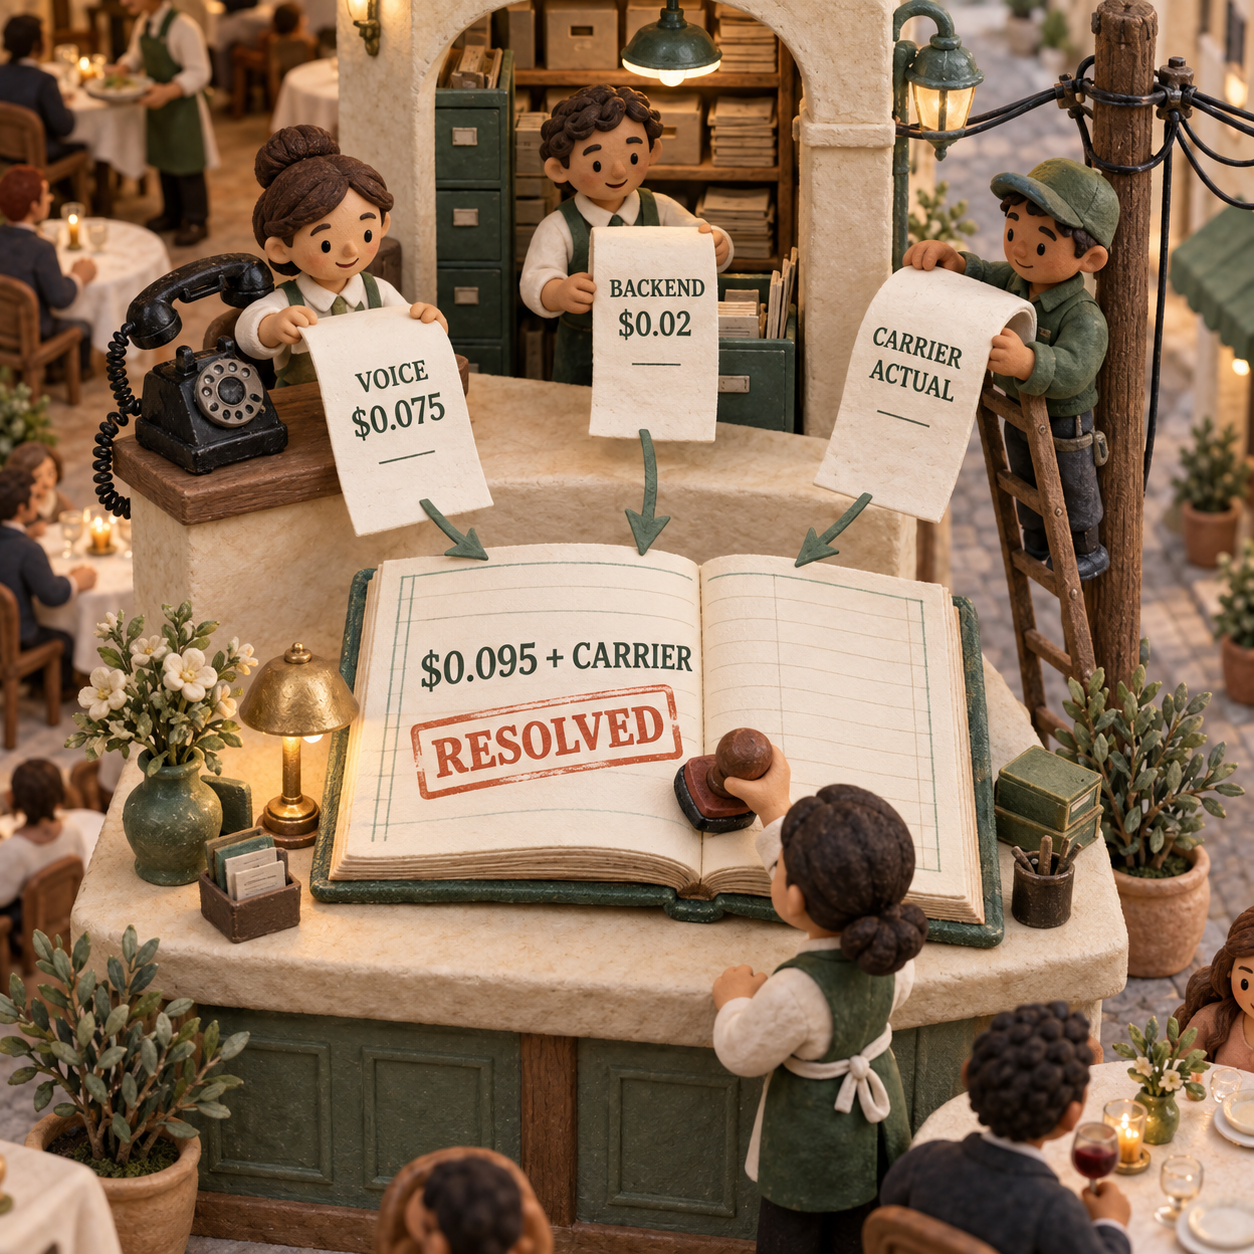
以一通 90 秒的餐厅入站预约电话为例。OpenAI 自己的成本示例给出了清晰的起点:
- 语音:90 秒除以 60,再乘以 $0.05,等于 $0.075。
- 后端:假设本例实测的模型与工具用量合计 $0.02。
- 语音加后端小计:$0.095。
- 电话传输:再加上这通电话实际产生的运营商费用。
所以,这通电话的成本并不是 $0.075。在这个示例中,它是 $0.095 加电话传输费。如果预约确认成功,这就是解决一笔预约的直接运行成本;如果智能体失败,最后还得由人工重做,计算每次成功解决任务的成本时,这通失败电话仍要留在分子里。
因此,与其随手编一个市场费率塞进总额,不如保留一个待填的运营商费用项。运营商这一笔不是 OpenAI 定价,应从自己的服务商账单中取数。
这里还有一层相互影响:后端即使 token 单价更高,只要能更快关闭 Live 会话,也可能更划算。会话少开一分钟,语音费用就能省下 $0.05。反过来,便宜的后端若让来电者重复信息、长时间等待工具,或最终无法完成预约,总成本反而更高。
放进真实通话流程,会是什么样
餐厅可以把 GPT-Live-1 接到入站预约号码上,并把任务边界收窄。语音层负责对话,低成本后端查询空位并准备预订;应用负责确认最终时段、写入预约,并阻止迟到的结果订错时间。
客服负责人可以沿用同一个前端,只调整后端策略。常规订单查询交给成本敏感型模型;有争议的扣款或规则例外,则转给推理更深入的模型或人工。价值不在于让一个语音模型包办所有工作,而在于保持同一套通话体验,同时按任务选择推理成本。
已经搭建了语音转文字、模型、文字转语音链路的产品团队,面对的是另一道选择题。GPT-Live-1 或许能减少交接代码,也更容易处理重叠语音;但只有任务完成率或维护效率的提升足以覆盖迁移投入,这笔改造才值得做。如果仍在权衡自建还是采购,也可以参考更完整的 AI 语音智能体成本对比。
浏览器应用可以通过 WebRTC 连接,完全省去电话服务商这一项,但 Live 会话时长和后端工作仍要付费。纯文本智能体、批处理工作流,以及根本不需要语音的应用,不受这次发布影响。
最小但有效的电话试点怎么做
SIP 直连的起点,是电话服务商把入站来电发送给 OpenAI,随后由你的 webhook 收到 Live 会话 ID。文档中的接受请求如下:
curl -X POST "https://api.openai.com/v1/live/sessions/$SESSION_ID/accept" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "session": {
      "type": "live",
      "model": "gpt-live-1",
      "instructions": "You are answering an inbound support call.",
      "audio": { "output": { "voice": "marin" } },
      "delegation": { "type": "client" }
    }
  }'
API 密钥必须留在可信后端。SIP 会协商音频格式,因此无需填写 audio.format。客户端委派意味着后端模型、工具、权限和用量记录都由自己的应用管理。
对于入站预约试点,任务足够短,正适合把测量口径保持清晰。
先确定唯一结果
成功标准应是预约已经确认,而不是对话听起来愉快。保存用户要求的时间、最终订到的时间,以及是否需要人工接手。
记录每一项成本
通话期间保留最新的累计语音秒数;会话正常关闭后,用
session.closed的最终用量替换它。每个后端 response ID 及其 token、工具用量只保存一次,再把这些记录与运营商的通话明细关联起来。按真实说话方式测试插话
测试来电者实际会出现的停顿、纠正、背景人声和简短回应。对照检查转录文本、后端执行的动作,以及来电者真正听到的音频。后端 response 已完成,并不能证明结果已经播报出去。
比较每个已完成任务的成本
汇总试点中的语音、后端和传输支出,再除以已确认的预约数。失败来电、重试和人工转接都必须计入支出,并用同一套通话脚本与现有系统比较。
打断能力到底如何,仍要用自己的数据验证
GPT-Live-1 为重叠语音而设计,但发布案例不能直接当成你的服务级别承诺。Speak 联合创始人兼 CTO Andrew Hsu 表示,与此前轮流说话的系统相比,Speak 的早期评测让思考停顿期间的打断减少了近 80%。这一结果只属于 Speak 的语言学习场景。
嘈杂的餐厅电话、照着念订单号的客服来电,以及说到日期前会停顿的患者,都是不同的工作负载。提示词、电话编解码器、运营商抖动、工具延迟和自己的播放控制,都会影响来电者的真实体验。没有一个放之四海皆准的打断或延迟改善幅度,可以直接复制进预算预测。
生产环境中的边界情况同样关键。来电者插话,把周五改成周四时,这句口头纠正不会自动取消后端正在处理的周五任务。应用必须修改或取消旧任务、忽略迟到的结果,并确保重试不会创建第二笔预约。
目前,GPT-Live SIP 直连只覆盖入站电话。Live 会话创建端点无法主动发起 SIP 外呼,因此外呼活动仍需要走由服务商掌控的合作伙伴链路。必须先做外呼的团队,应在规划迁移前确认这条路径。
周一上班后,先做这件事
如果正在运营入站预约或客服队列,先为一个边界清晰的试点补齐监测:把语音秒数、后端用量、运营商费用、已完成任务、人工转接和插话失败写进同一条记录,再让成本敏感型后端与预想中需要的深度模型正面对比。
当每次成功解决来电的完整成本优于现有技术栈,而且来电者纠正智能体时不会触发过期动作,就可以继续推进。如果唯一优势只剩 $0.05 这个醒目的价格,或运营商与外呼路径尚未确定,就应等待。对于纯文本工作,以及成本和完成率已经达标的语音体验,可以忽略这次发布。
想继续看到这类用直白语言拆解运营成本变化的文章,可以订阅邮件通讯。
- 最近更新
- 2026年9月14日
在 Google 中优先显示本站


把 omidsaffari.com 设为优先来源,Google 会在 Top Stories、AI Overviews 和 AI Mode 中为您优先展示。

ChatGPT Windows Appshots:少复制上下文,多检查结果
ChatGPT Windows 桌面版新增 Appshots,可用双 Alt 键把前台窗口的截图和应用可提供的文本带入对话。本文拆解 Appshot 的数据边界、发送目标与隐私风险,并结合客户邮件、报错窗口和设置页面等工作场景,说明如何衡量它是否真的减少上下文复制、准备和返工时间,以及哪些情况下应该暂缓使用。2026年9月14日Explained
Vercel CDN 直送 FastAPI 静态文件:Function 用量怎么降
Vercel CDN 现在可直接分发符合条件的 FastAPI 前端与静态文件,避免触发 Function 调用和相关计算用量。本文拆解路由顺序、中间件与依赖项形成的安全边界,说明 Pro、Hobby 账单中哪些指标会下降、哪些 CDN 成本仍然存在,并给出上线后的部署核验清单。2026年9月13日Explained
OpenAI API 密钥轮换:别等过期才救火
OpenAI 已支持为项目 API 密钥设置到期日,并可在组织或项目层级限制最长有效期。本文拆解一套可执行的 OpenAI API 密钥轮换流程:明确负责人和维护预算,提前创建替代密钥,经密钥库部署并验证真实任务,最后再撤销旧密钥,避免定时 Agent、批处理任务与客户自动化因凭证失效而中断。2026年9月13日Explained
Vercel 连接器权限:共享凭据如何指定负责人
Vercel 为 Pro 和 Enterprise 团队推出连接器权限,让 Owner 将共享连接器交给指定的 Connector Manager 管理。本文梳理 Member 默认权限、提供商 scope、运行时令牌与业务审批的边界,并用可验证的交接流程说明如何缩小共享凭据的变更范围。2026年9月13日Explained
Cloudflare AI Search 接入 R2:AI 搜索不再要求文件扩展名
Cloudflare AI Search 现可依据 HTTP Content-Type 索引无扩展名的 R2 对象,无需改动稳定键。本文说明支持范围、4 MB 限制、R2 元数据修复成本、同步节奏与验证流程,并给出可直接落地的 Worker 上传示例,帮助团队判断该更新能否简化现有 AI 搜索管线。2026年9月12日Explained
Vercel Sandbox 扩容至 64 GB:大型 Agent 任务如何改单机运行
Vercel Sandbox 将默认工作存储从 32 GB 提升至 64 GB。本文拆解这次扩容对大型代码仓库、AI Agent 修复、构建与落盘型数据任务的实际影响,并给出一套完整的峰值空间测量方法、持久化与 Drive 成本边界,以及判断是否可以安全取消清理或拆分流程的验证步骤。2026年9月12日Explained
Cloudflare Workflows 保留期缩短后,运行历史该怎么留
Cloudflare 已将新建 Workers Paid Workflow 的已完成与错误实例状态默认保留期从 30 天缩短为 7 天。本文拆解这项变化对故障调查窗口、成功与错误历史配置以及 GB-month 存储成本的影响,并给出一套可执行的保留策略,帮助团队避免证据先于事故暴露而过期的风险。2026年9月11日Explained