Murmure 语音转文字实测:离线听写值不值得用?
实测 Murmure 1.11.3:免费、离线的桌面语音转文字工具如何用 Parakeet、词典和格式化规则处理技术术语与文件路径。本文还对比 Windows、macOS、Linux 的安装限制,本地与远程 LLM 的隐私边界、速度表现、API 能力和 $0 定价,帮你判断它是否适合日常听写与开发工作流。

- MMurmure
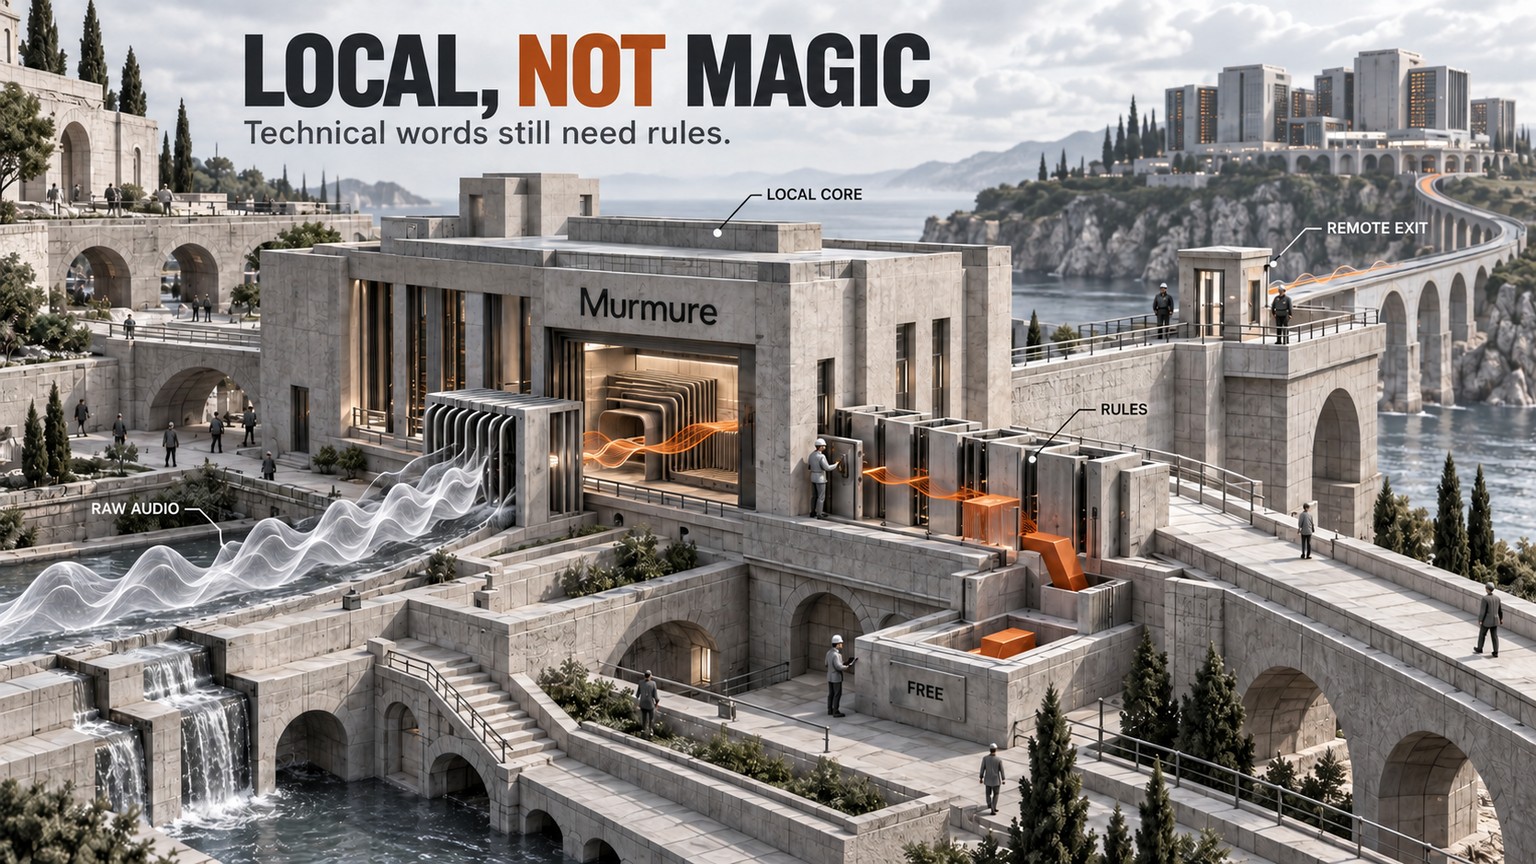
如果你想要一款免费、离线的桌面语音转文字工具,并愿意教它识别技术词汇,Murmure 1.11.3 值得安装。在一段 19.817 秒的合成开发者语音样本中,词典改善了名称识别,却也引入了一次误判;将词典精简到 6 个条目,再配合按顺序执行的格式化规则后,术语和文件路径都被正确还原,只少了句末句号。如果你追求零配置或托管支持,则不建议选择。
Murmure 语音转文字评测:先说结论
Murmure 是一款面向 Windows、macOS 和 Linux 的桌面听写软件。按住快捷键或切换录音状态后开口说话,内置 Parakeet 模型就会在 CPU 上把录音转成文字。Murmure 还能在将文字粘贴到当前应用之前,通过词典和按顺序执行的替换规则纠正结果。可选的 LLM 环节既能在本地运行,也能把转写文本发送到兼容 OpenAI 的服务器。即使语音识别本身仍在本地完成,后一种做法也会改变隐私边界。本文核查时,Murmure 官网列出的版本是 1.11.3,且只有一个免费开源版本,核查日期为 2026 年 9 月 14 日。
结论是值得推荐,但适用范围很明确:如果你是愿意为本地转写配置最后一公里的开发者,Murmure 很合适。它并不能神奇地识别所有专业词汇。在可重复样本中,原始模型能处理常见技术用语,但要得到可用结果,仍需判断哪些错误该交给词典,哪些该用格式化规则解决。
- 核心语音识别在本地运行,无需账号或订阅。
- 词典会影响解码,而不只是机械地查找替换。
- 按顺序执行的正则规则可稳定还原文件路径和重复出现的技术短语。
- 文档明确支持 Windows、Intel 与 Apple Silicon Mac、Linux X11 和 Linux Wayland。
- CLI 和实验性的 localhost API,让它不只是一款驻留托盘的听写工具。
- 词典可能引入误判;测试中的两个相似环境名称就触发了这个问题。
- Linux Wayland 无法使用按住说话,macOS 需要 3 项权限,Windows 还存在文档已记录的睡眠问题。
- 语言由系统自动检测,无法强制指定。
- 当前文档对旧版 5 分钟录音限制的说法互相矛盾。
- 远程 LLM 的行为取决于端点和模型默认设置,而外部处理会让转写文本离开本机。
下载前还要注意一个容易混淆的名称:本文评测的是 murmure.app 上的 Murmure。Microsoft Store 上的 Murmur、MurMur Voice-to-Text、macOS 上的 Murmur,以及 Murmur AI,都是不同产品。
哪些人适合 Murmure,哪些人应该跳过
Murmure 适合经常使用固定词汇的桌面用户,例如项目名、产品名、命令、路径和值得一次录入、长期复用的短语。如果音频不能上传,而且少量配置比每天反复改同一批词更省事,它尤其值得考虑。
下表中的价格和产品信息核查于 2026 年 9 月 14 日。
如果你的工作横跨编辑器、问题跟踪器、浏览器、聊天应用和终端,而且同一批难识别词汇会在这些应用间反复出现,选择 Murmure。它支持普通 Ctrl+V、终端常用的 Ctrl+Shift+V,以及模拟按键 3 种插入方式,代价是配置需要自己维护。
如果目标不是普通文章听写,而是用语音控制 Claude Code、Codex、Gemini CLI、Aider、Pi 或其他命令行智能体,选择 Dictare。Dictare 官网当前列出 macOS 和 Linux,支持本地 Whisper 或 Parakeet,采用 MIT 许可证且无需订阅。它更专注于这类工作流,但不能替代 Windows 方案。可参阅本站的 Dictare 价格分析和更全面的语音控制 AI 编程智能体指南。
如果安装配置比云端处理更令人头疼,选择 Windows voice typing。Microsoft 文档给出的快捷键是 Windows+H;由于它使用 Azure Speech 服务,因此需要联网。Windows voice access 是另一个独立功能,可在设备端离线控制电脑和输入文字;若你需要离线运行,却觉得 Murmure 配置过于复杂,也值得评估。Microsoft 对两者区别有详细说明。
如果你使用 Mac,只想走系统内置方案,选择 Apple Dictation。Apple 表示它可在任何能输入文字的地方工作,“键盘”设置则会说明普通 Dictation 是否在设备端处理。它没有 Murmure 从词典到正则规则的明确纠错链路,但配置门槛更低。不同 macOS 版本和语言的准确信息,请以 Apple Dictation 指南为准。
不要把以上 4 款工具中的任何一个,当作临床部署的采购捷径。 Murmure 虽然提供 Medical 词汇和提示词预设,但预设不等于经过临床验证,也不能替代组织级安全协议或 EHR 支持体系。Dragon Medical One 这类专业产品围绕临床文档和医学专业词汇构建。最终选择仍取决于组织所在司法管辖区、安全审查、集成需求和合同条款。
Murmure Parakeet 语音转文字:先看原始结果
Murmure 使用 NVIDIA Parakeet TDT 0.6B v3,在本地把 16 kHz 单声道音频转换为文字,随后再执行已启用的后处理。之所以要先看原始结果,是因为 LLM 能让较差的转写看起来很流畅,却可能在不易察觉的地方改变原意。先测试识别层,才能分清名称究竟是听错了、格式错了,还是两者都有。Murmure 转写文档也采用这一处理顺序。
为了提高测试难度,这里使用的可重复样本特意加入了通用听写不擅长的内容:
Project Kieirra uses the NovusFlow adapter. Open slash opt slash NovusFlow slash releases slash v three slash worker dot pie. Update the Kubernetes namespace, the PostgreSQL schema, and the Pydantic validator. Replace staging dash west with staging dash east.
样本使用 eSpeak NG 1.52 合成,采用美式英语语音,语速为每分钟 145 词、音高为 45,之后重采样为 16 kHz 单声道 16 位 WAV。音频时长 19.817 秒,共 39 个单词。测试机是一台 Ubuntu 26.04.1 x86_64 runner,配备 8 个 AMD EPYC-Rome 虚拟 CPU、15,608 MiB 内存,且没有可用 GPU。
官方 1.11.3 Debian 软件包大小为 624 MiB,公布的 SHA-256 校验和与下载文件一致。AppImage 为 693 MiB,其校验和同样匹配。由于最小化容器缺少桌面依赖,Debian 软件包无法在其中运行,因此测试改用 AppImage,并搭建了隔离的显示与库环境。这只是无头 runner 的环境记录,并不意味着普通 Ubuntu 桌面也需要这些操作。
使用 --no-dictionary 时,Murmure 返回:
Project key reuse the novusflow adapter. Open slash opt slash novusflow slash releases slash v3 slash worker dot pie. Update the Kubernetes namespace, the poster SQL schema, and the Pydentic validator. Replace staging dash west with staging dash east.
模型正确识别了 Kubernetes 和句子结构,但没有正确处理 Kieirra、NovusFlow 的大小写、PostgreSQL、Pydantic、文件扩展名和口述路径。从第一条 CLI 日志到得到转写大约用了 4 秒,其中包括模型加载。用 19.817 秒音频除以约 4 秒处理时间,这台 CPU runner 上的结果约为实时速度的 4.95 倍。这只是特定机器上的合成测试结果,不能用来佐证厂商另外给出的速度主张。
这条基准结果用于普通文章尚可,却不能直接用于命令、版本说明或问题单,因为一个错误的路径片段就可能抵消听写节省的全部时间。
自定义词典有帮助,但也可能矫枉过正
Murmure 的词典并不只是转写完成后查找并替换匹配文字。它会在 Parakeet 解码时提高候选词权重,再对置信度较低的相近词执行拼写纠正。这样一来,专有名词就有机会在被识别成无关常用短语之前得到挽救。词典文档同时提醒:词条越多,提升效果越弱,误判风险也越高。
第一次测试加入了 8 个条目:Kieirra、NovusFlow、Kubernetes、PostgreSQL、Pydantic、staging-west、staging-east 和 worker.py。结果如下:
Project key reuse the NovusFlow adapter. Open slash opt slash NovusFlow slash releases slash v3 slash worker.py. Update the Kubernetes namespace, the PostgreSQL SQL schema, and the Pydantic validator. Replace staging-east west with staging-east east.
进步很明显:NovusFlow 恢复了预期大小写,worker.py 被识别为一个词,Pydantic 也正确了。PostgreSQL 更接近目标,却多出一个重复的 SQL;Kieirra 仍然失败。问题最大的是两个相似的环境名称干扰了普通口语:在方向词出现前,两处“staging dash”都被拉向了 staging-east。
这个结果验证了厂商“少即是多”的提醒。词典条目只是解码候选,不是必定执行的语义指令;两个发音相近的条目可能相互竞争。因此,默认继续添加更多变体并不安全。
Murmure 1.11.3 接受单词或双词条目,最多只能包含 1 个空格。它支持字母、重音符号、标点和连字符,但不支持数字或能感知上下文的条目。词条超过 100 个后,拼写纠正阶段会被禁用,不过完全匹配的词仍会保留大小写。对于大型企业词汇表来说,这是设计限制,而不是无关紧要的小问题。
格式化规则才是技术词汇的确定性修复方案
Murmure 的格式化规则会在插入文字前执行确定性的转换。它支持 Contains、Exact match 和 Regex 模式,并从上到下依次运行。因此,如果一个短语的预期输出事先已知,尤其是文件路径或口述分隔符,格式化规则才是合适的处理层。格式化规则文档也明确把多词替换、数字、正则表达式和语音命令归入这一层。
改进后的测试删除了两个相互竞争的 staging 条目,只保留 6 个词典词条,并用 5 条按顺序执行的规则处理识别本身无法解决的问题:
- 将
key reuse替换为Kieirra uses。 - 用 1 条不区分大小写的正则表达式,把口述斜杠和点号序列转换为
/opt/NovusFlow/releases/v3/worker.py。 - 将
PostgreSQL SQL替换为PostgreSQL。 - 将
staging dash west替换为staging-west。 - 将
staging dash east替换为staging-east。
最终转写结果为:
Project Kieirra uses the NovusFlow adapter. Open /opt/NovusFlow/releases/v3/worker.py. Update the Kubernetes namespace, the PostgreSQL schema, and the Pydantic validator. Replace staging-west with staging-east
预期的技术术语、环境名称和路径全部出现,与目标相比唯一的文本差异是缺少最后的句号。从第一条日志到得到转写,处理时间依然约为 4 秒。
这并不意味着每个错误都值得建立永久规则。“Key reuse”是合成发音造成的现象,真实用户只有在自己的录音中复现该错误后,才应该添加这条替换。真正可复用的经验,是明确分工:让词典影响识别,再用按顺序执行的规则编码精确输出。
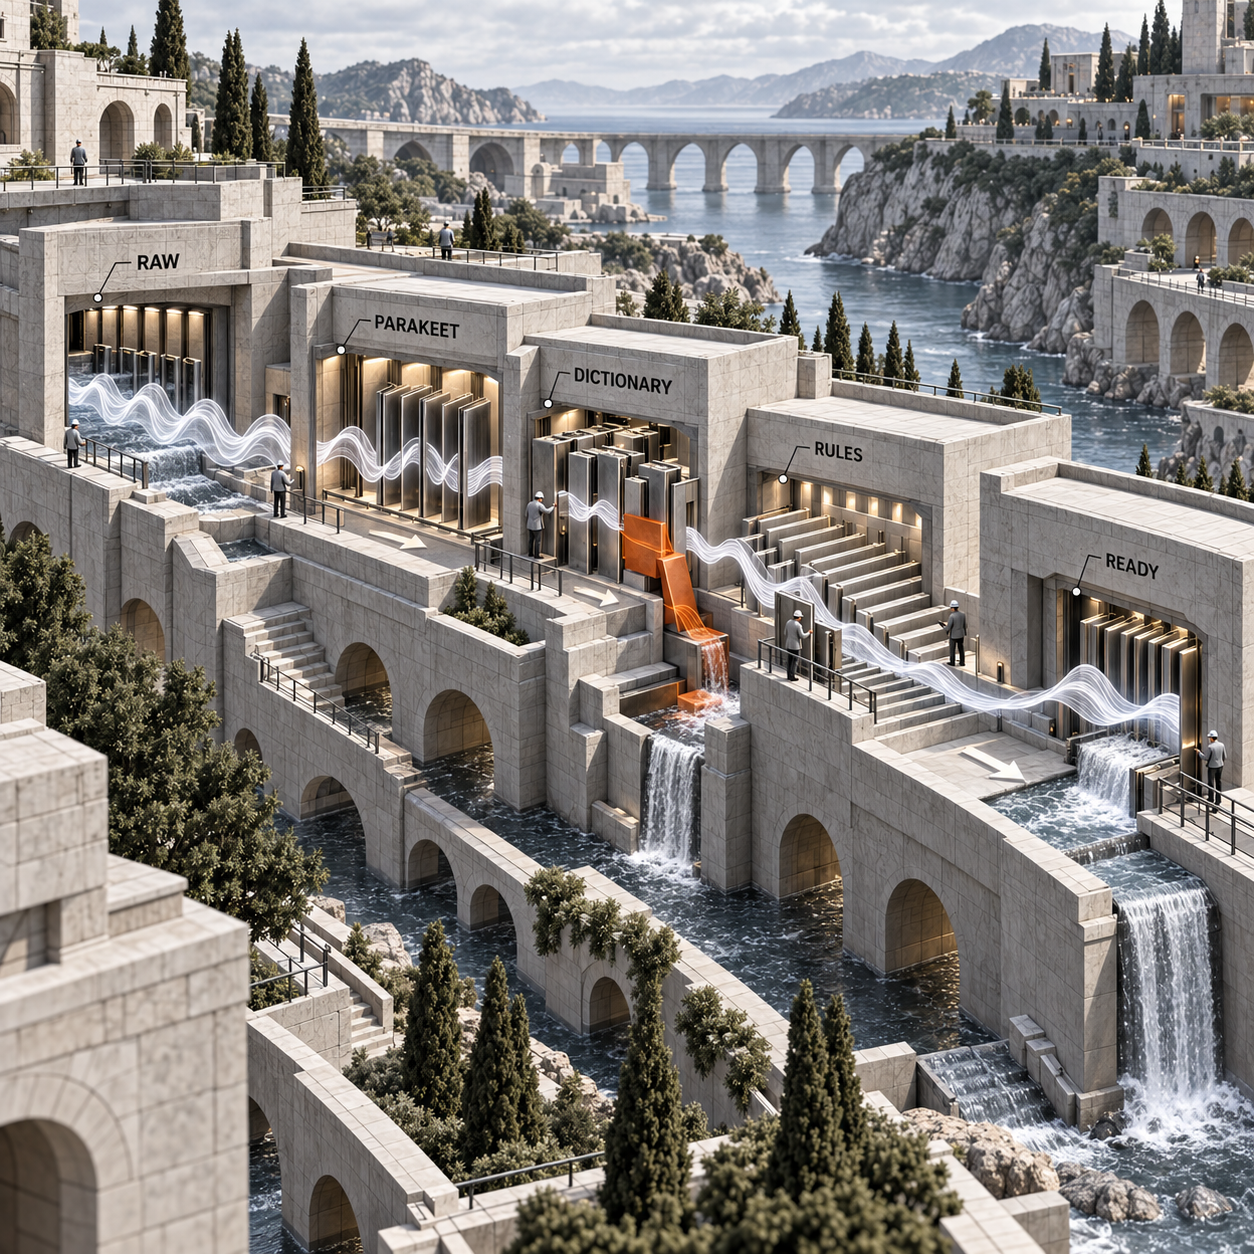
录制一条高难度基准样本
使用固定样本,覆盖实际工作中重要的名称、路径、数字和纠错项。启用任何清理功能前,先保存原始输出。
只添加反复出错的名称
把多次识别失败的简短专有名词和技术词元放进词典。用同一份样本重跑时,不仅要看哪些词修好了,也要检查是否出现新的误判。
让精确输出变得可重复
口述分隔符、完整路径、数字和已知的多词替换应使用按顺序执行的格式化规则。再运行一次,并逐字符对照目标文本。
最后再接入 LLM
只有在确定性链路已经摸清后,才让可选模型处理灵活改写。这样既保留干净的基准,也便于定位回归问题。
Murmure 离线语音转文字:哪些数据留在本地
Murmure 的核心音频链路留在桌面端:先录制 WAV,再由 Parakeet 在 CPU 上运行,应用本地纠错后插入结果。厂商称音频会立即删除,转写不会写入日志;最近 5 条历史记录只存于 RAM,并在应用退出时消失。它无需账号,也没有遥测。入门指南展示了焦点应用工作流和不同插入方式。
对本地语音识别来说,它的最低硬件要求格外亲民。Murmure 建议至少有 2 GB 可用内存和 1 GB 磁盘空间,并表示不需要 GPU。可选的本地 LLM 则是另一项负载:其文档根据模型大小依次建议 4 GB、7 GB 或 8 GB 显存,同时提醒仅用 CPU 推理可能很慢。
“本地”并不代表可以跳过平台层面的安装评估。私有模型不会消除操作系统权限、快捷键冲突或粘贴行为等问题。
Windows 配置有一项少见的系统风险
Windows 版 Murmure 支持 Windows 10 或更高版本,并要求安装 Visual C++ Redistributable。全局快捷键监听器可能触发杀毒软件审查;厂商还记录了一项尚未解决的问题:应用运行时,监听器可能阻止 Windows 进入睡眠或休眠。Windows 安装页面列出了这两项限制。
在问题解决或组织接受临时应对方案之前,这种睡眠异常足以成为在受管笔记本上放弃 Murmure 的理由。它比安装时多点几下更值得重视。
macOS 配置需要 3 项权限
Murmure 同时提供 Apple Silicon 和 Intel 版 macOS 应用。安装后需要授予 Microphone、Accessibility 和 Input Monitoring 权限,再重启应用。默认 Ctrl+Space 与 macOS 输入法切换快捷键冲突;包含 Space 或数字键的快捷键还可能把字符泄漏到当前应用。macOS 安装页面建议改用 Ctrl+Option+M、功能键或鼠标按键。
对个人 Mac 而言,这只是一次性设置;对设备群来说,权限和快捷键策略都会变成部署工作,而这些成本不会体现在 $0 的价格里。
Linux 在 X11 上最完整,在 Wayland 上更依赖手动配置
Murmure 完整支持 Linux X11。使用 Wayland 时,用户必须创建调用二进制文件的操作系统快捷键,而且只能切换录音状态,无法按住说话,因为这些快捷键不会暴露按键释放事件。Debian 软件包基于 Ubuntu 24.04 构建,要求 GLIBC 2.38 或更高版本;对于较旧的 Ubuntu,厂商建议使用 AppImage。Linux 安装页面给出了不同软件包的命令和已知问题。
如果你在 Wayland 上必须使用按住说话,这就是应当跳过的硬性限制。如果切换模式可以接受,那么 CLI 集成步骤很明确,配置后重启也会保留。
Murmure 本地 LLM 与远程 LLM 的区别
Murmure LLM Connect 是转写完成、插入之前的可选文本处理环节,并不属于核心语音识别。它可以调用本地 Ollama,也可以连接兼容 OpenAI 的服务器。4 个已保存模式可分别设置不同的提供商、模型、system prompt 和 user prompt,内置 Translation、Medical、Development 与 Voice Dictation 预设。LLM Connect 文档还支持把已保存模式应用到选中的文字。
隐私上的区别很清楚:
- 不使用 LLM: 音频与转写处理都留在本机。
- 本地 Ollama: Murmure 将转写文本发送给本机或由你控制的本地网络端点上的模型服务器。
- 远程提供商: 核心音频识别仍在本地,但转写文本和提示词会发送到所配置的服务器。此时必须考虑该服务器的数据保留、计费、访问控制和司法管辖区。
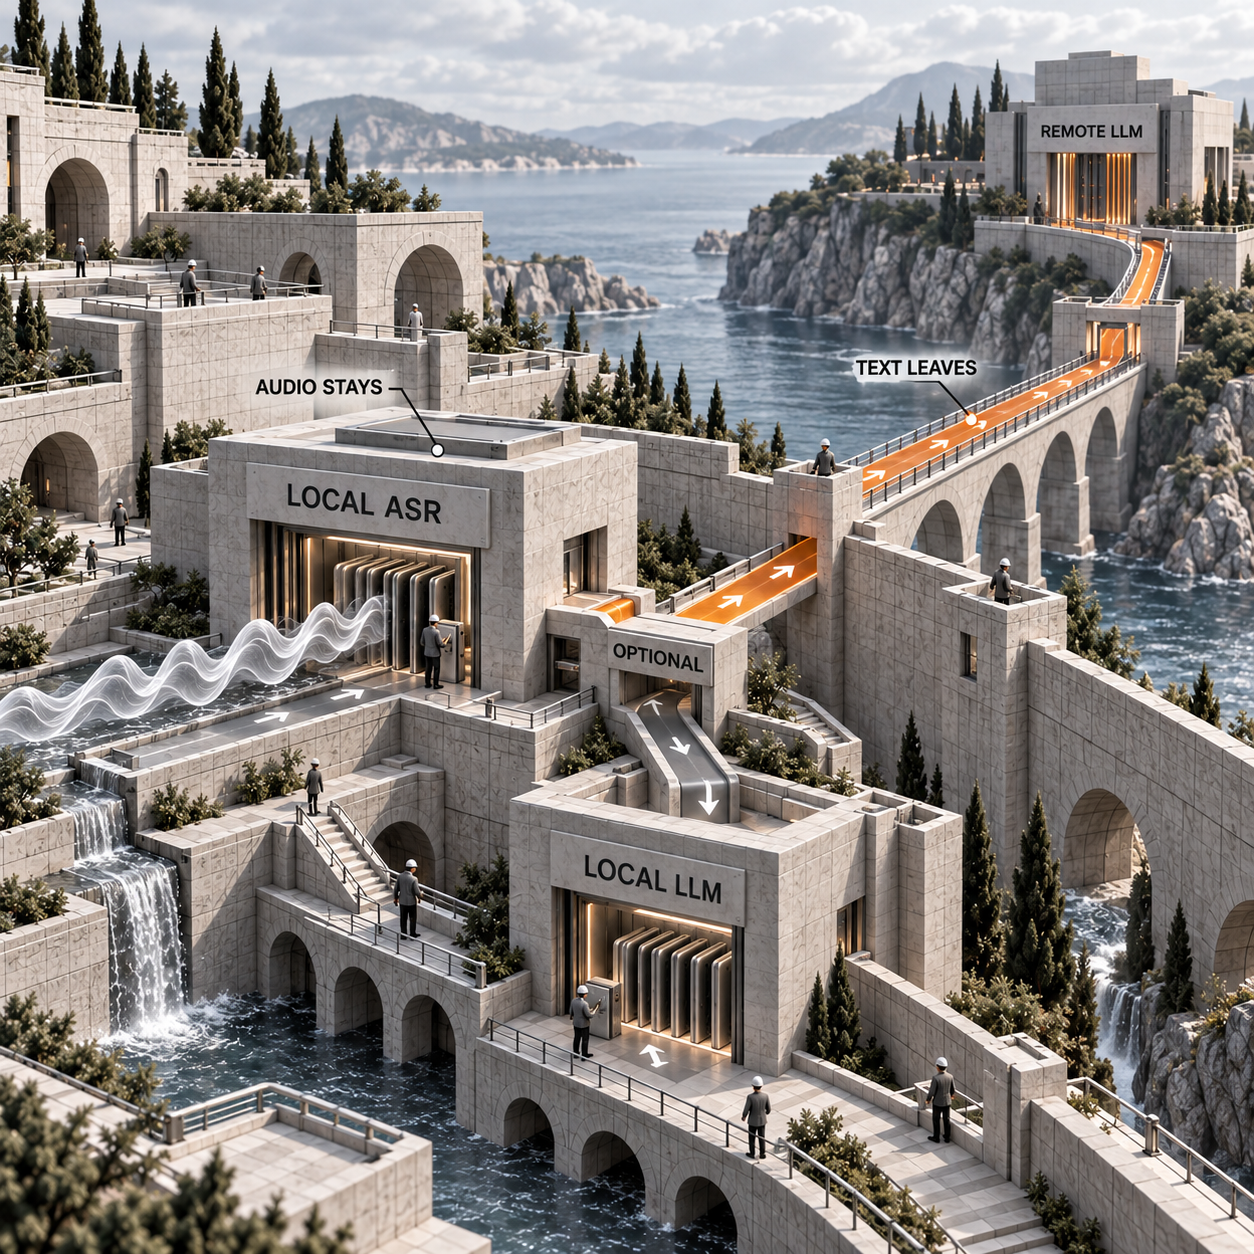
可选模型测试刻意把各处理层拆开。首先,基准转写被直接发送到 Ollama 0.34.0,模型为 qwen3.5:0.8b,关闭 thinking,并把 temperature 设为 0。Ollama 报告 CPU 总耗时 5.005 秒。模型修正了完整文件路径、PostgreSQL、Pydantic 和两个 staging 环境,却没有处理“key reuse”和首次出现的小写“novusflow”。因此,对这批固定词汇而言,确定性规则链路给出的结果更好。
兼容 OpenAI 的路径暴露了另一项取舍。Murmure 把选中的转写文本发送到原版 Ollama 的兼容端点,但这个小模型持续运行了 32.323 秒,最终以 HTTP 500 结束,没有返回替换文本。把同一个 Murmure 请求经由 loopback 兼容桥接层转发,并在其中关闭 thinking、将 temperature 设为 0 后,触发 4.769 秒便返回了部分纠错结果。
这个桥接层只用于诊断,不是推荐的生产组件。它证明远程协议路径确实被调用,也说明服务器默认设置能够改变结果;但它不能证明所有兼容 OpenAI 的提供商都会失败,也不能证明每个端点都需要这些设置。测试没有把文字发送给外部提供商,因此没有验证外部延迟、成本、数据保留和保密性。在无头 X11 测试环境中,返回文字被粘贴到光标处,而不是替换选中内容,所以本次测试也不主张 Transform 日常界面工作流已经成功。
对于输出可预测的技术词汇,规则更可靠。只有当任务确实需要灵活改写、翻译或重组时,才值得使用 LLM;同时要接受它可能漏改、添加多余包装文字,或让数据跨越新的边界。
Local API 有用,但边界很窄
Murmure 提供一个实验性 HTTP 端点,可在应用打开时自动转写文件。它默认监听 localhost:4800,并通过 POST /api/transcribe 接收 multipart WAV 上传。Local API 文档包含 curl、JavaScript 和 Python 示例。
这些限制决定了它只是工作站集成,而不是共享转写服务:仅支持 WAV,文件上限为 100 MB,不支持流式处理,请求按顺序执行,只能使用 localhost 或 127.0.0.1,且 CORS 已禁用。词典会自动应用,语言仍由系统自动检测。
这些能力足够让本地脚本把会议片段或语音笔记送入同一条纠错链路,却不足以服务并发用户、浏览器、远程员工或实时字幕。围绕它补齐这些能力,会改变整个系统的安全和运维模型。
Murmure 价格:唯一档位就是 $0
截至 2026 年 9 月 14 日,Murmure 只有一个档位:免费开源应用。厂商页面没有付费方案、账号、用量额度、试用倒计时,也没有单独收费的商业功能层级。
按软件本身计算,每席位每年成本是 $0,每 1,000 个听写单词也是 $0。这些数值在数学上完全准确,却没有覆盖真实经济成本。即使是 10 人部署,仍要投入权限配置、快捷键策略、词汇维护、端点测试和用户支持。Murmure 并未暗藏订阅费,而是把购买决策从许可证价格转移到了自行承担运维。
Murmure 本身没有可计算的订阅盈亏平衡点,真正值得算的是时间:如果一个小词典和几条规则能消除反复修改,前期配置就能回本;如果每个说话者、项目和环境都需要不同规则,即使软件价格是 $0,持续维护成本也可能超过省下的键盘输入时间。
真正会影响选择的限制
Murmure 有 8 项足以影响购买决策的限制。
1. 词典可能让转写变得更差
加入 8 个条目的测试修正了若干术语,却把两个“staging dash”短语变成 staging-east west 和 staging-east east。文档提醒词典可能误判,本次测试也复现了这一点。发音相近的条目应逐个加入,并始终用同一份样本验证。
2. 大词典会失去一道纠错环节
词条超过 100 个后,Murmure 会禁用拼写纠正,不过完全匹配的词仍保留大小写。这意味着词典不适合容纳完整的组织级词汇表。开发团队需要的是筛选规则,而不是批量导入习惯。
3. 无法强制指定识别语言
Parakeet 会在 25 种受支持的欧洲语言中自动检测。文档称目前无法强制指定其中一种。对于短音频、代码切换或听起来像另一种语言的录音,用户因此少了一个有效的恢复手段。
4. 桌面集成受不同平台限制
Wayland 无法按住说话,macOS 需要 3 项权限和更安全的快捷键,Windows 则可能在应用运行时无法进入睡眠。这些差异并非无关紧要,它们直接决定软件适合个人工作站、受严格管理的企业笔记本,还是两者都不适合。
5. 文档对录音时长的说法不一致
转写页面仍写着最长 5 分钟并会自动停止;1.10.1 版本说明却称旧的 5 分钟限制已经移除,而当前 API 页面表示,除了 100 MB 文件上限外没有时长限制。较新的版本说明和 API 文档证据更强,但旧说法仍未撤下,用户只能自行比对官方页面。
6. 可选 LLM 带来不确定性和新的信任边界
Murmure 的本地路径明确面向 Ollama,远程模式则把具体行为交给兼容 OpenAI 的端点。测试中,一种原版端点配置明确失败;在生成设置受控后,得到的也只是部分纠错。与此同时,任何外部服务器都会收到转写文本。远程 LLM 可以有用,但它既不是免费的准确率升级,也不属于基础隐私承诺。
7. 没有付费运维层
厂商没有提供付费方案、托管支持层、管理控制台或服务级别协议。对于免费、采用 AGPL-3.0 许可证的桌面应用,这很合理;但如果组织需要合同支持、设备群策略或明确的升级渠道,这也是应当跳过它的理由。
8. API 有意限制为本地串行使用
这项实验性 API 在 localhost 上接收排队处理的单个 WAV 工作流,不支持流式传输,也无法服务远程浏览器或多个并发用户。它是实用的集成接口,不是生产级语音基础设施。
结论:当规则比便利更重要时,选择 Murmure
如果你注重隐私、在桌面端反复使用固定词汇,并愿意投入时间配置,Murmure 值得推荐。1.11.3 版在 CPU 上快速处理了可重复的技术样本;与可选的小型 LLM 相比,能影响解码的词典条目加上按顺序执行的格式化规则,更可靠地还原了预期名称、环境和完整路径。
判断是否安装 Murmure,可以看下面 3 项是否全部成立。
- 操作系统和快捷键机制适合这台工作站。
- 基准音频和文字应留在本地。
- 反复出现的纠错项足够少,便于编码和维护。
只要硬性需求指向相反方向,就应跳过:移动端听写、零配置、强制指定识别语言、Wayland 上按住说话、合同支持、并发 API 服务,或在无权发送转写文本的情况下使用远程清理。
最稳妥的配置恰恰最简单:先用本地 Parakeet,再用小词典,然后添加按顺序执行的规则;除非灵活转换有明确用途,否则不要接入 LLM。这样既能让错误保持可见,也容易解释隐私边界。
常见问题
哪款 AI 听写软件最好?
最佳选择取决于你的约束。Murmure 适合支持自定义规则的本地跨应用桌面听写;Dictare 适合用语音控制终端编程智能体;如果只是偶尔使用且希望少配置,Windows 或 Apple 内置听写更合适。
最好的医疗听写软件是什么?
应选择临床词汇、EHR 工作流、安全文档、支持与合规条款都符合组织要求的软件。Murmure 提供 Medical 词典和提示词预设,但这些预设本身不能证明经过临床验证;Dragon Medical One 是值得评估的一款专业产品。
哪款免费在线听写工具最好?
在当前版本的 Chrome、Edge 和 Safari 中,Google Docs voice typing 是一种浏览器方案。Murmure 虽然免费,却是离线桌面应用,并非在线听写网站。
哪款免费听写 App 最好?
如果本地处理和可重复的自定义纠错很重要,Murmure 是更合适的免费选择。如果优先考虑使用操作系统已有功能,Windows voice typing 或 Apple Dictation 更简单。
Windows 11 自带听写软件吗?
有。在文本框中按 Windows+H 即可启动 Windows voice typing。Microsoft 表示该功能使用在线 Azure 语音识别并且需要联网;Windows voice access 则是另一项离线、在设备端运行的控制功能。
怎样用语音输入代替打字?
把光标放进文本框,再按对应快捷键。Windows 使用 Windows+H;Apple Dictation 使用已配置的听写快捷键或麦克风键;Murmure 使用可配置的全局快捷键,然后把结果插入当前获得焦点的应用。
iPhone 上哪款听写 App 最好?
Murmure 不支持 iPhone。可以先用 Apple 内置 Dictation,它在任何能输入文字的地方都可使用;只有在内置词汇和工作流不够用时,再评估专业移动应用。
Google Docs voice typing 免费吗?
Google 的功能说明没有把语音输入列为单独收费的附加功能。该功能可在受支持的浏览器中使用,不过组织管理员可以将其禁用。
练习听写的最佳方法是什么?
准备一份固定脚本,加入实际工作中的难读名称、路径、标点和纠错项。每次都将输出与目标文字对照,一次只改一个词典条目或规则;再用自然语音重复测试,之后才可信任这套配置。
Murmur 离线语音转文字
这个搜索词可能指向多个互不相关的产品。本文评测的是 murmure.app 上的 Murmure,也就是使用本地 Parakeet 转写的免费桌面应用,而非 Microsoft Store 上的 Murmur 或其他名称相近的服务。
领取 AI 业务工作流审计清单,判断自动化中的哪些环节应留在本地,哪些可以跨越提供商边界。
- 最近更新
- 2026年9月14日
- 分类
- Build
在 Google 中优先显示本站


把 omidsaffari.com 设为优先来源,Google 会在 Top Stories、AI Overviews 和 AI Mode 中为您优先展示。
RenderIO FFmpeg API 定价拆解:套餐、积分与升级临界点
RenderIO FFmpeg API 每月 $12 起。本文完整拆解 Starter、Growth 与 Business 的命令积分、链式任务、视频下载计费、运行时、存储及 webhook 限制,并算清 838、2,201 等关键升级临界点,帮助你判断何时继续支付超额费、何时换档更省钱。2026年9月14日Build
Dictare 价格拆解:这款语音转文字软件真的零成本吗?
Dictare 是面向编程智能体的免费本地语音转文字软件。本文拆解其 $0 定价、安装与硬件隐性成本,并与 Spokenly 和 Wispr Flow 的免费及付费方案逐项比较,还提供一套可直接套用的成本公式,帮你判断本地运行的所有权成本与托管订阅的跨平台便利,哪一个更适合你的开发工作流。2026年9月13日Build
Claude Code 插件评测实战:用原生 Evals 验证行为变化
Claude Code 2.1.269 已原生支持插件评测。本文从创建行为用例、配置确定性 grader、读取 WITH/W/OUT/Δ 报告,到故意制造回归、控制成本并接入 CI,完整演示如何证明插件确实改变了 Claude 的行为,而不只是通过文件校验,并给出最值得优先测试的场景和两类产品机会。2026年9月12日Build
Cloudflare 语音代理延迟排查:用 turnmetrics 找到真正卡点
Cloudflare 的 turnmetrics 能把每轮语音与文本交互拆成可定位的阶段,并标记 completed、no_output 等结果。本文详解如何读取重叠 timing、设计受控测试,并判断延迟来自转写、模型、TTS 还是浏览器播放,避免凭感觉更换供应商或购买超出需求的语音 QA 工具。2026年9月12日Build
SRT字幕烧录实战:用 Rendi 自动生成带字幕 MP4
用 Rendi 把审核通过的 SRT字幕永久烧录进 MP4。本文从 FFmpeg API 提交、字幕样式和异步任务状态讲到输出验收与字节计费,解释硬字幕与可选字幕轨该怎么选,并给出可直接运行的 Node.js 示例、轮询与 webhook 做法,以及批量处理前的必做检查,适合把字幕渲染接入自动化流程的内容团队与机构。2026年9月11日Build
OpenAI Agent SDK 与 Agents API 怎么选:控制权、成本与迁移
OpenAI Agent SDK 和托管式 Agents API 到底该选哪个?本文从会话归属、运行时控制、沙箱成本、数据驻留、故障恢复与迁移工作量逐项比较,并用统一的成本模型拆解两条路线。你将看清精简平台团队、受监管企业和已有成熟基础设施的开发者分别适合哪一种方案,以及什么时候不该迁移。2026年9月11日Build
Rendi 定价详解(2026):先算处理字节,再选套餐
全面拆解 Rendi 定价:Free 与 $25 起的 Pro 套餐如何按输入加输出字节计费,存储、命令时长和 vCPU 又怎样限制选档;并用同一工作负载对比 Very Good FFmpeg 与 RenderIO,帮你找出自动化视频管线真正需要的最低套餐,避免只看视频时长或标价而多花钱。2026年9月11日Build