Claude Sonnet API und App: So nutzen Sie Version 5.5
So nutzen Sie Claude Sonnet 5.5 in App und API, wählen den passenden Effort und vermeiden Fehler bei Thinking, Tool-Aufrufen und der Migration.



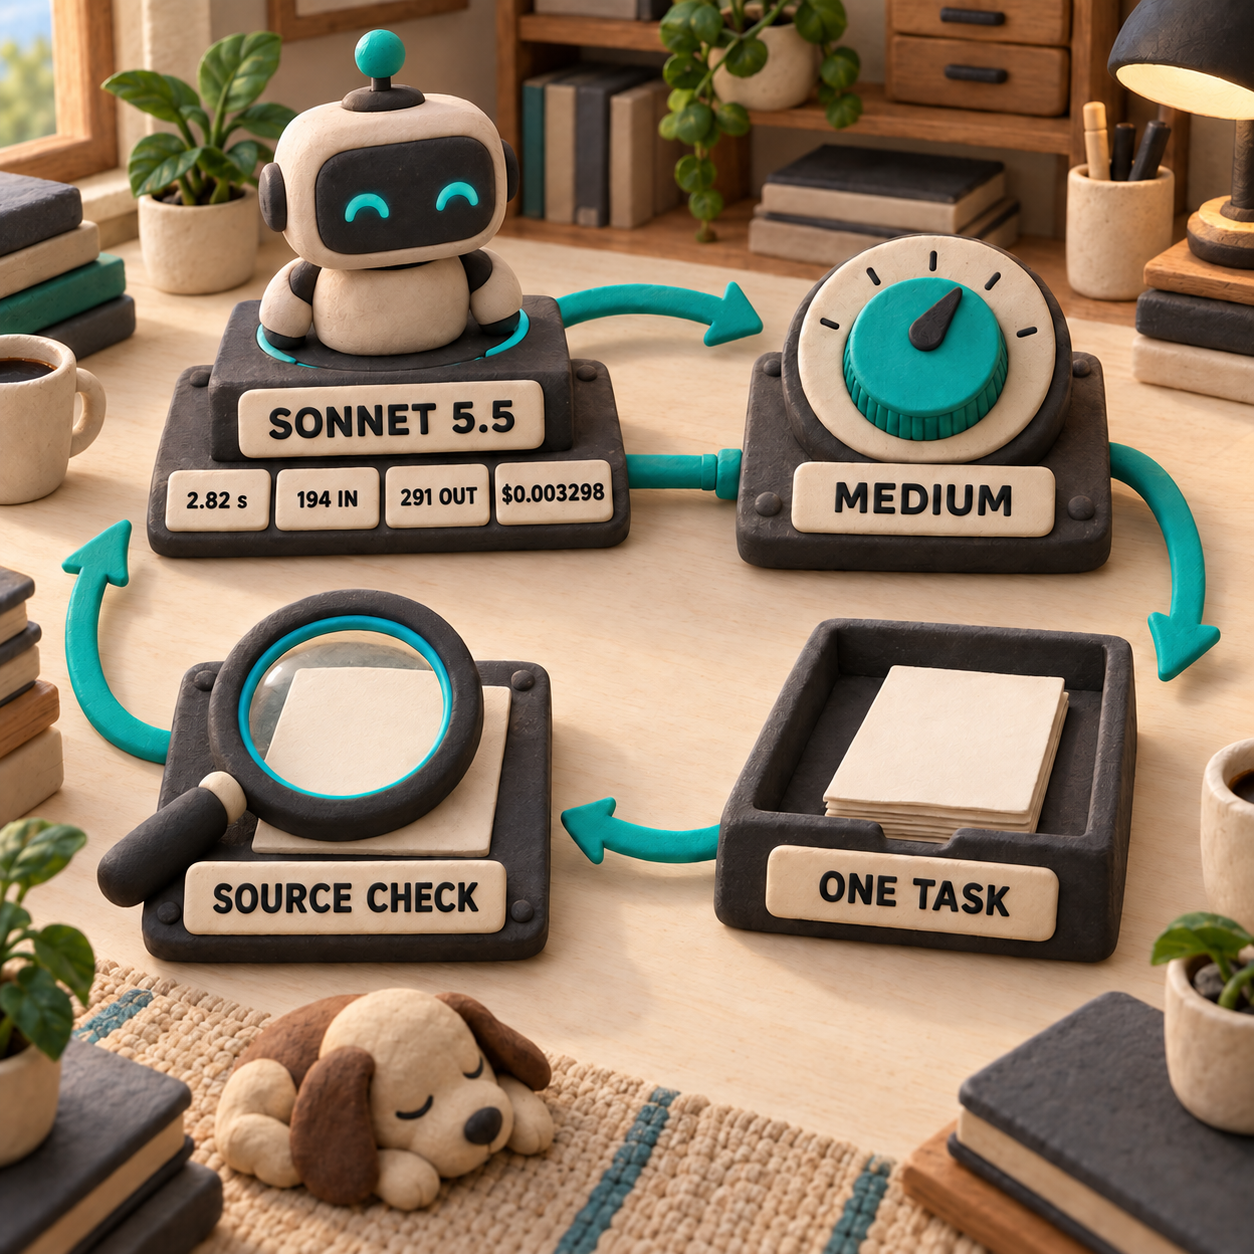
Ob in der App oder über die Claude Sonnet API: Testen Sie Claude Sonnet 5.5 zunächst bei Medium Effort mit genau einer klar begrenzten, prüfbaren Aufgabe – etwa einer Support-Ticket-Zusammenfassung oder einem Kundenbriefing. In meinem lokalen synthetischen Support-Test antwortete das Modell in 2.82 Sekunden, verwendete 194 Eingabe- und 291 Ausgabe-Token und kostete $0.003298. Die zentralen Ticketfakten blieben erhalten; zugleich ergänzte das Modell plausible Annahmen zur Behebung, die nicht in der Quelle standen. Die praktische Lehre: Sonnet 5.5 macht den Entwurf extrem günstig, doch die Prüfung bleibt Teil der Arbeit.
Mit einer Aufgabe bei Medium Effort starten
Am schnellsten gelingt ein aussagekräftiger Test in der Claude-App. Sonnet 5.5 auswählen, Medium Effort bestätigen, genau ein Quellenpaket übergeben und eine Ausgabe verlangen, die sich Zeile für Zeile prüfen lässt.
Anthropic setzt Medium in seinen Apps und in Claude Code als Standard. Auf der Claude Platform ist hingegen High voreingestellt, weshalb API-Nutzer die Stufe ausdrücklich festlegen sollten. Für Support-Zusammenfassungen, Kundenbriefings, Routineanalysen und klar umrissene Tool-Aufgaben ist Medium der richtige Einstieg: Die Rückkopplung bleibt schnell, ohne direkt auf die niedrigste Stufe zu wechseln.
Sonnet 5.5 auswählen
Einen neuen Claude-Chat öffnen. Neben der Senden-Schaltfläche auf den Modellnamen klicken, Sonnet 5.5 auswählen und anschließend das Effort-Menü öffnen. Falls das Modell nicht in der ersten Liste erscheint, auf „More models“ klicken. Enterprise-Administratoren können einschränken, welche Modelle und Effort-Stufen verfügbar sind.
Den ersten Durchlauf bei Medium belassen
Für eine begrenzte geschäftliche Aufgabe zunächst Medium verwenden. High ist erst sinnvoll, wenn tiefere Abwägungen, eine längere Arbeitskette oder strengere Prüfungen nötig sind. Low kommt infrage, sobald eigene Tests zeigen, dass die Qualität trotzdem stabil bleibt.
Quelle und Ausgabeformat vorgeben
Ein Ticket, ein Gesprächstranskript oder einen Dokumentensatz einfügen. Zielgruppe und Pflichtfelder nennen. Bei einem Support-Ticket genau vier Stichpunkte anfordern: Problem, Auswirkung, Beleg und nächste Maßnahme. Ergänzen: „Keine Fakten erfinden. Jede Schlussfolgerung kennzeichnen.“
Aussagen mit der Quelle abgleichen
Jeden Namen, jede Zahl, Ursache, Zusage und empfohlene Maßnahme mit der Eingabe vergleichen. Nicht belegte Ratschläge löschen, auch wenn sie plausibel klingen. Den Prompt erst speichern, nachdem er diese Prüfung an mehreren Beispielen aus dem eigenen Workflow bestanden hat.
Das synthetische Ticket in meinem Test beschrieb sechs ausgesperrte Support-Mitarbeiter nach einer Änderung der Anmeldedomain, zwei weiterhin angemeldete Mitarbeiter, die Fehlermeldung „Invalid organization“ und Benutzerdatensätze, in denen die neue Domain bereits hinterlegt war. Sonnet 5.5 bewahrte diese Details und hielt das Format mit vier Stichpunkten ein. Zusätzlich vermutete es, dass die Organisationszuordnung wahrscheinlich noch auf die alte Domain verwies, und bezeichnete eine Lösung als weniger störend. Beides stand nicht im Ticket.
Die reine Modellrechnung ist unkompliziert. Nach Anthropics veröffentlichtem Tarif kosten 194 Eingabe-Token $0.000388 und 291 Ausgabe-Token $0.00291, zusammen also $0.003298. Hätten 10,000 Aufrufe exakt diese Token-Struktur, lägen die reinen Modellkosten bei $32.98. Das sind nicht die Kosten für 10,000 gelöste Tickets. Abrufsysteme, Integrationen, Wiederholungsversuche, Speicherung, Monitoring und menschliche Prüfung kommen rund um den Modellaufruf hinzu.
Was Claude Sonnet 5.5 tatsächlich ist
Sonnet 5.5 ist das schnelle Allzweckmodell in Anthropics 5.5-Familie. Es eignet sich als Arbeitsmodell für klar definierte Aufgaben; Opus 5.5 ist dagegen der erfahrene Spezialist für offene Probleme, bei denen besonders viel Urteilsvermögen gefragt ist.
Die Veröffentlichung ist nicht mit Sonnet 5 identisch. Die direkte Claude-API-ID lautet claude-sonnet-5-5 und enthält kein Datumssuffix. Das Modell akzeptiert Text und Bilder, gibt Text aus, bietet ein Kontextfenster von 1 Million Token und kann bis zu 128,000 Ausgabe-Token erzeugen. Preise und Tokenizer-Kontext des Vorgängers behandelt der Test zu Claude Sonnet 5 separat.
Anthropic zufolge erzeugt Sonnet 5.5 Ausgaben mehr als 30% schneller als Sonnet 5 und kostet in den eigenen Tests bis zu 30% weniger pro abgeschlossener Aufgabe. Die zweite Aussage bezieht sich darauf, dass für die Erledigung weniger Token benötigt werden – nicht auf einen günstigeren Token-Tarif. Die Preise sind gegenüber Sonnet 5 unverändert.
Auch die Benchmark-Angaben stammen von Anthropic. Das Unternehmen nennt für Sonnet 5.5 70.6% gegenüber 10.3% für Sonnet 5 in Terminal-Bench 4.0 sowie 55.5% gegenüber 34.1% in CursorBench 4.0. Diese Werte sprechen dafür, das neue Modell zu testen. Ob jedoch die eigene Ticket-Richtlinie, Codebasis oder Dokumentvorlage die Prüfung besteht, lässt sich daraus nicht ableiten. Anthropics Veröffentlichungsbericht unterscheidet ebenfalls zwischen Benchmark-Ergebnissen und dauerhaft verlässlichem Urteilsvermögen bei offenen Aufgaben.
Effort nach den Folgen eines Fehlers wählen
Effort steuert Qualität, Latenz und Token-Verbrauch – nicht die Textlänge. Eine höhere Stufe gibt dem Modell mehr Raum zum Denken und Prüfen, kann aber auch Wartezeit und Kosten erhöhen. Wenn eine kurze Antwort wichtig ist, muss dies zusätzlich im Prompt stehen.
Anthropic hat diese Stufen für Sonnet 5.5 neu kalibriert. Medium bedeutet bei diesem Modell daher nicht denselben Denkaufwand wie Medium bei Sonnet 5. Führen Sie mit eigenen Beispielen eine neue Testreihe durch. Eine Einstellung sollte nicht allein deshalb übernommen werden, weil ihre Bezeichnung gleich geblieben ist.
Sieben nützliche Workflows nach kurzfristigem Nutzen
Die besten Einsatzfälle haben drei Eigenschaften gemeinsam: Die Eingabe liegt vor, die gewünschte Ausgabe folgt einer klaren Form, und ein Mensch oder eine Regel kann das Ergebnis prüfen.
1. Support-Tickets priorisieren
Eine Support-Leitung kann Kundennachricht, Kontostatus, jüngere Ticket-Historie und Eskalationsrichtlinie zusammenführen. Sonnet 5.5 kann Problem, Auswirkung, Belege, fehlende Fakten und die nächste zulässige Maßnahme ausgeben. Der Nutzen: weniger erneutes Lesen vor Weiterleitung oder Übergabe. Empfehlungen mit Kontoauswirkungen, Erstattungen, Zusagen und Aussagen zur Ursache müssen weiterhin von einem Menschen geprüft werden.
Dies ist der stärkste erste Workflow, weil sich jede Ausgabe auf ein konkretes Quellenfeld zurückführen lässt. Zudem werden Modellfehler schnell sichtbar. Kann eine Zusammenfassung nicht zeigen, woher eine Aussage stammt, darf sie keine Aktion auslösen.
2. Kundenbriefings vor Gesprächen
Ein Account-Team kann das neueste Gesprächstranskript, die Leistungsbeschreibung, offene Aufgaben und Verlängerungsnotizen bereitstellen. Gefordert wird eine Seite mit Entscheidungen, Zusagen, Risiken, ungeklärten Fragen und der Agenda für das nächste Gespräch. So entsteht ein wiederholbares Briefing-Format, statt vor jedem Termin mit einer leeren Seite zu beginnen.
„Bestätigt“ und „abgeleitet“ gehören in getrennte Abschnitte. Allein diese Unterscheidung verhindert, dass eine plausible Modellinterpretation zur Kundenzusage wird.
3. Pull Requests prüfen
Eine technische Leitung kann dem Modell ein Code-Diff, die Konventionen des Repositorys sowie eine Checkliste für Sicherheit, Tests und Rückwärtskompatibilität geben. Sonnet 5.5 erstellt daraus eine erste, nach Risiken geordnete Prüfung und schlägt Tests vor. Der Gewinn liegt in der schnelleren Orientierung für Reviewer, nicht in einer automatischen Freigabe. Ob die Änderung zusammengeführt wird, entscheidet weiterhin eine für das System verantwortliche Person.
4. Klar begrenzte Fehler beheben
Bei einem reproduzierbaren Fehler kann ein Produktentwicklungsteam das fehlerhafte Verhalten, relevante Dateien und Abnahmekriterien bereitstellen. Für eine präzise beschriebene Korrektur ist Medium Effort ein sinnvoller Start. High ist angebracht, wenn das Problem mehrere Dienste betrifft oder der erste Durchlauf die Prüfung auslässt. Kürzere Implementierungs- und Testschleifen sind der Nutzen; die Abnahmekriterien verhindern, dass sich die Aufgabe unkontrolliert ausweitet.
5. Betriebsberichte und Vorlagen für den Vorstand
Ein Finanz- oder Betriebsteam kann Quellenmaterial sowie eine freigegebene Präsentations- oder Dokumentvorlage bereitstellen. Sonnet 5.5 kann einen strukturierten Bericht entwerfen, Lücken aufzeigen und eine erste Fassung formatieren. Anthropic positioniert das Modell ausdrücklich für ausgearbeitete Dokumente, Präsentationen und Tabellen. Der Zusammenstellungsaufwand sinkt, doch jede finanzielle Aussage braucht weiterhin eine Quellzelle oder Dokumentreferenz.
6. Störungsberichte
Eine Einsatzleitung kann dem Modell den Ereignisverlauf, Warnmeldungen, Maßnahmen und Notizen der Verantwortlichen übergeben. Bestätigte Ereignisse, Hypothesen, Kundenauswirkungen, offene Fragen und Folgemaßnahmen sollten in getrennten Blöcken ausgegeben werden. Das erleichtert Übergabe und Nachbericht. Eine Korrelation darf vom Modell nicht zur Ursache erklärt werden.
7. Visuelle Qualitätssicherung und Oberflächenpolitur
Ein Produktdesign- oder Frontend-Team kann einen Screenshot mit Markenregeln und Abnahmecheckliste kombinieren. Sonnet 5.5 erkennt Unstimmigkeiten, priorisiert Korrekturen und hilft bei einer klar abgegrenzten Umsetzung. Sichtbare Mängel lassen sich dadurch schneller bearbeiten. Geschmack, Barrierefreiheitstests und das abschließende Produkturteil bleiben menschliche Aufgaben.
Drei Produkte, deren Entwicklung sich lohnt
Der bloße Modellzugang ist noch kein Geschäftsmodell. Ein verkaufbares Produkt ergänzt eigenen Kontext, einen kontrollierten Workflow, Belege und eine Stelle, an der ein Mensch die endgültige Entscheidung trifft.
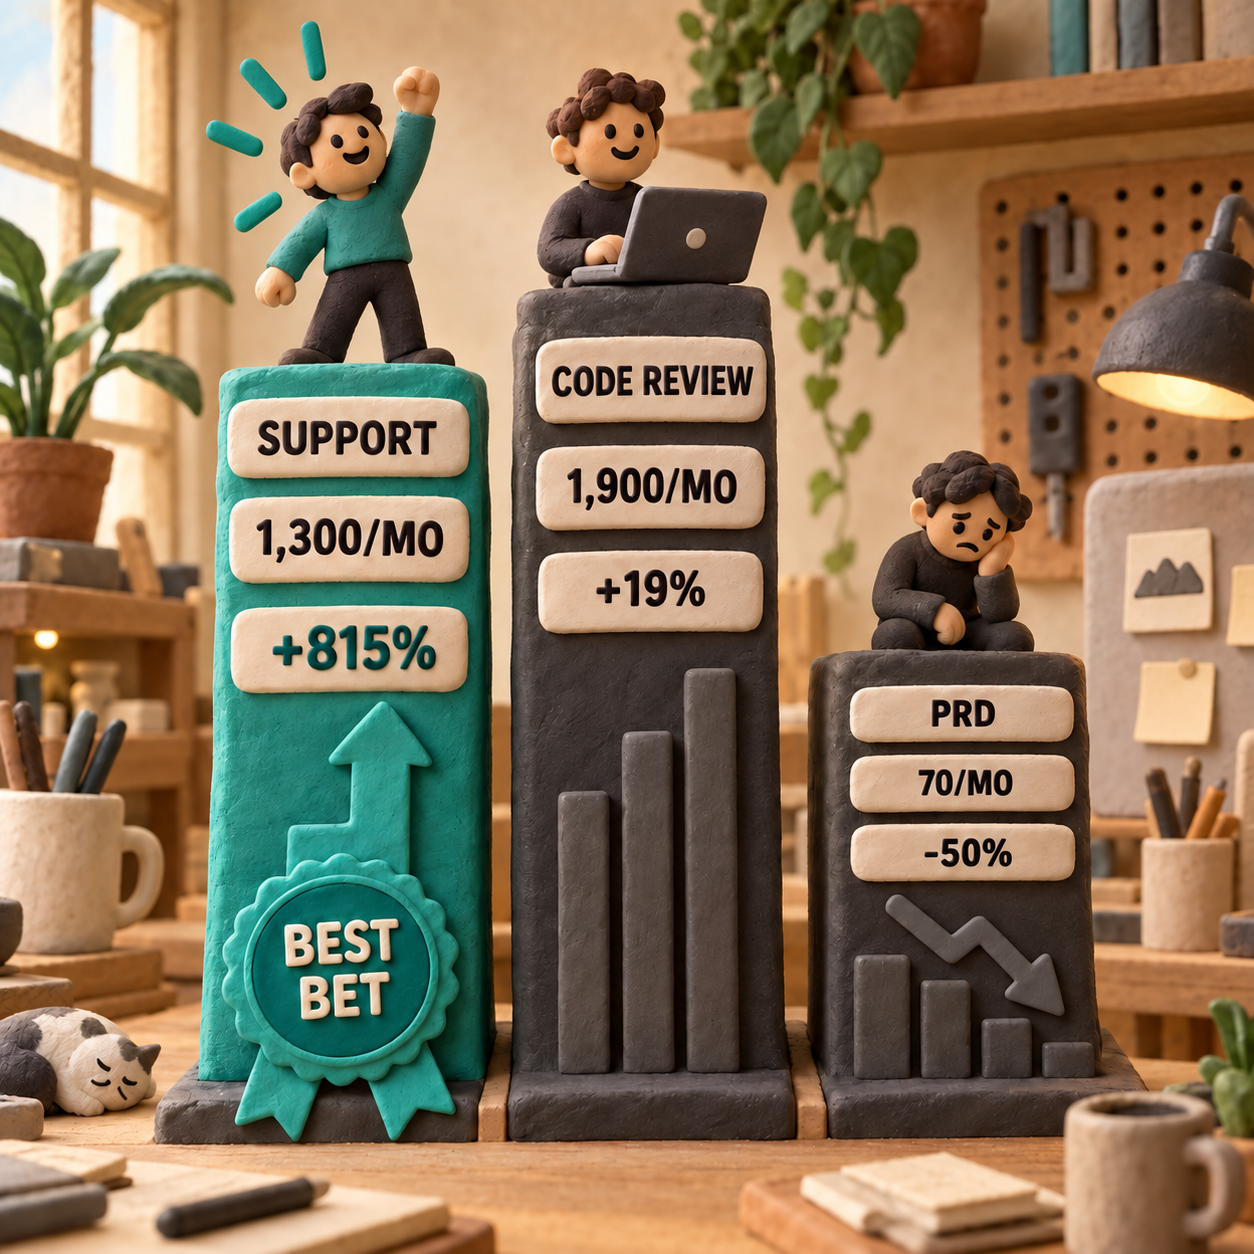
1. Beleggestützte Support-Priorisierung – die stärkste Chance
Ein Support-Copilot kann Ticket und Kontodatensatz in eine strukturierte Zusammenfassung überführen, jede Aussage mit einer Quelle verknüpfen, die vorgeschlagene Maßnahme an der Richtlinie prüfen und den Entwurf zur Freigabe einstellen. Support-Leitungen und ausgelagerte Serviceteams würden für eine schnellere, einheitlichere Weiterleitung zahlen.
Die Nachfrage ist sichtbar: ai customer service agent verzeichnet in den zugrunde liegenden Keyword-Daten monatlich 1,300 US-Suchanfragen, kommerzielle Suchabsicht und 815% Wachstum im Jahresvergleich. Intercom berechnet für Fin $0.99 pro Ergebnis. Das ist mit einem Zusammenfassungsaufruf nicht direkt vergleichbar, weil ein gelöstes Anliegen eine umfangreichere Leistung ist. Es zeigt jedoch, dass Käufer nutzungsabhängige Support-Automatisierung bereits akzeptieren.
Die kleinste verkaufbare Version benötigt einen Posteingangs-Connector, einen Connector für Kontodaten, die Zusammenfassung mit vier Feldern, Quellenangaben, eine Richtlinienprüfung sowie Schaltflächen zum Genehmigen oder Ablehnen. Die Hürden sind Integration und Vertrauen. Wenn nicht belegt werden kann, woher eine Empfehlung stammt, behalten Kunden ihren bestehenden Workflow.
2. Eine richtliniengestützte Ebene für Code-Reviews
Eine GitHub-App kann ein Diff zusammen mit den Regeln des jeweiligen Teams lesen und anschließend eine nach Risiken geordnete Prüfung, Testlücken und eine kurze Merge-Zusammenfassung liefern. Zielgruppe sind technische Leitungen und Plattformteams.
ai powered code review platform erreicht monatlich 1,900 US-Suchanfragen und 19% Wachstum im Jahresvergleich. Die öffentlichen Preise von CodeRabbit beginnen bei jährlicher Abrechnung bei $24 pro Entwickler und Monat; höhere Tarife liegen bei $48 und $72. Das MVP umfasst einen Repository-Anbieter, Pull-Request-Webhooks, eigene Prüfregeln, eine Kommentaransicht und einen Audit-Trail, der für jeden Befund die auslösende Regel zeigt.
Die Schwierigkeit ist der dichte Markt. Ein generischer Reviewer besitzt keinen verteidigbaren Vorsprung. Sinnvoller ist eine schmerzhafte Nische, etwa regulierte Freigabeprüfungen, Sicherheit bei Datenmigrationen oder ein bestimmtes Framework. Falsch positive Befunde müssen dabei ebenso sorgfältig gemessen werden wie übersehene Fehler.
3. Ein vertikales Tool vom Briefing zum PRD – aber kein generisches
Ein enger Workflow kann Gespräche, Einschränkungen und frühere Entscheidungen in ein Produktbriefing mit Abnahmekriterien und offenen Fragen überführen. Eine Produktberatung oder ein vertikales Softwareteam kommt als Käufer infrage, wenn die Vorlage genau zur eigenen Arbeit passt.
Die exakte Suchanfrage ai product requirements document generator erreicht nur 70 US-Suchanfragen im Monat und ist im Jahresvergleich um 50% gefallen. Das ist eine Warnung, kein Verkaufsargument. Ein eigenständiger generischer PRD-Generator ist hier die schwächste Chance. Tragfähig ist eher eine Ergänzung innerhalb eines wertvolleren Workflows, etwa für Agentur-Discovery, Implementierungen im Gesundheitswesen oder betriebliche Änderungskontrolle.
Das MVP besteht aus einem festen Quellenpaket, einer klar positionierten Vorlage, nachvollziehbaren Entscheidungen und dem Export in das bestehende System des Käufers. Die Hürden sind geringe Nachfrage und leichte Kopierbarkeit. Ohne bestehende Kundenbeziehung oder Zugang zu vertikalen Daten sollte dieses Produkt nicht gebaut werden.
Die Claude Sonnet Kosten bleiben gleich, die Workflow-Kosten könnten sinken
Sonnet 5.5 kostet $2 pro Million Eingabe-Token, $10 pro Million Ausgabe-Token und $0.20 pro Million Cache-Lese-Token. Das sind dieselben veröffentlichten Preise wie bei Sonnet 5. Anthropics Aussage zu geringeren Kosten beruht darauf, dass Aufgaben mit weniger Token abgeschlossen werden.
Für eine Kalkulation ist dieser Unterschied entscheidend. Eine kürzere Modellspur kann Latenz und Token-Kosten senken, obwohl sich die Preisliste nicht ändert. Die gesamten Produktkosten können dennoch nahezu gleich bleiben, wenn Abrufsysteme, Drittanbieter-Tools, Wiederholungsversuche und menschliche Prüfung dominieren. Gemessen werden sollten die Kosten pro akzeptierter Ausgabe, nicht pro Aufruf.
Claude-App-Abonnements und API-Nutzung sind getrennte Produkte. Ein kostenpflichtiger Pro-, Max-, Team- oder Enterprise-Tarif enthält weder Claude Console noch API-Nutzung. Der Ratgeber zu den Claude-Tarifen erklärt die allgemeinen Tarifgrenzen; ein API-Workflow benötigt einen eigenen Console-Zugang und nutzungsabhängige Abrechnung.
Die Claude Sonnet API erst nach bestandenem Aufgabentest migrieren
Die sicherste Reihenfolge für die Migration ist einfach: Den Prompt zunächst mit repräsentativen Beispielen belegen, dann die neue Modell-ID festschreiben, Effort ausdrücklich setzen und schließlich den Vertrag für Thinking und Tool-Aufrufe korrigieren, bevor produktiver Traffic umgestellt wird.
Für eine einfache Anfrage mit Adaptive Thinking bleibt das Feld thinking weg; Textblöcke werden anhand ihres Typs ausgelesen:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    output_config={"effort": "medium"},
    messages=[{
        "role": "user",
        "content": "Summarize this ticket as Issue, Impact, Evidence, and Next action.",
    }],
)

for block in response.content:
    if block.type == "text":
        print(block.text)
Vier Änderungen bei der Migration verdienen eine gezielte Prüfung.
thinking: {"type": "disabled"}wird von Anthropics direkter Claude API nicht mehr akzeptiert. Verwenden Siethinking: {"type": "between_tools"}, wenn vorab kein Thinking gewünscht ist. Dies funktioniert bei Low, Medium und High, aber nicht bei Xhigh oder Max.- Erzwungene
tool_choice-Werte vom Typanyund benanntestoolwerden von der direkten API nicht mehr akzeptiert. Verwenden Sieauto, gestalten Sie das Schema – sofern unterstützt – strikt und schreiben Sie in den Prompt, wann das Tool ausgeführt werden soll. - Eine Antwort kann mit einem
thinking-Block beginnen. Jeder Inhaltsblock muss nachtypeverarbeitet werden; verlassen Sie sich nie darauf, dasscontent[0].textvorhanden ist. - Thinking-Blöcke müssen in einer Tool-Schleife unverändert zurückgegeben werden. Sie enthalten Signaturen, die an den bisherigen Gesprächsverlauf gebunden sind. Deshalb sollte der Nachrichtenverlauf nur ergänzt werden.
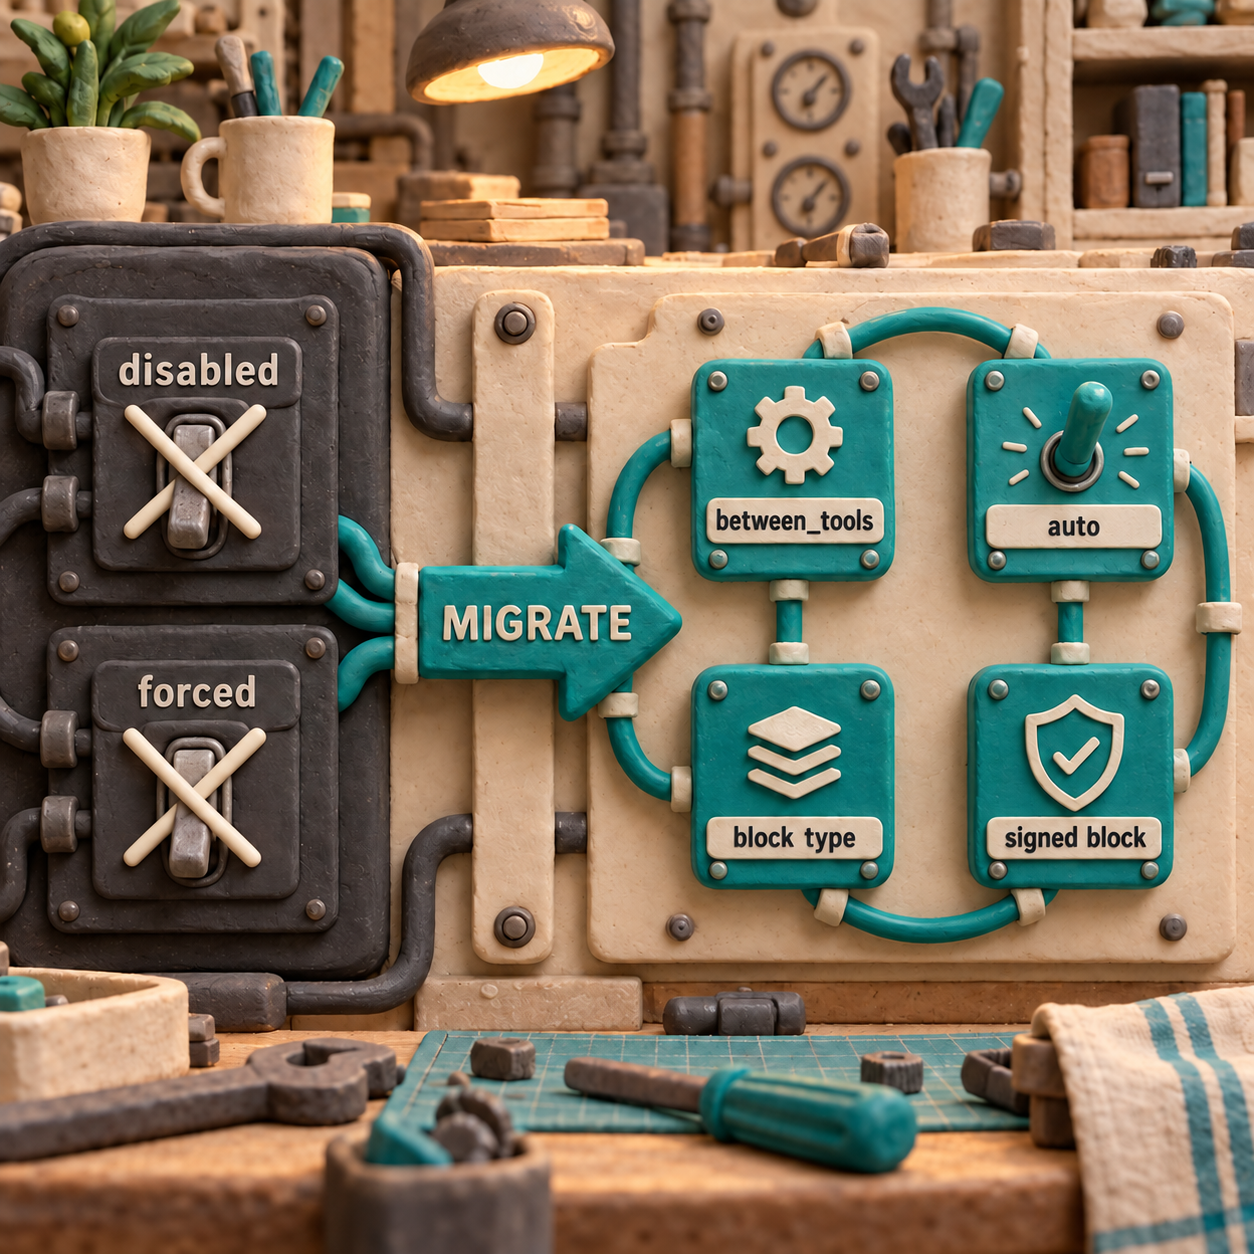
Dieses Minimalbeispiel verwendet between_tools, belässt die Tool-Auswahl auf auto und bewahrt die vollständige Assistant-Antwort:
tools = [{
    "name": "lookup_ticket",
    "description": "Look up a support ticket",
    "strict": True,
    "input_schema": {
        "type": "object",
        "properties": {"ticket_id": {"type": "string"}},
        "required": ["ticket_id"],
        "additionalProperties": False,
    },
}]

messages = [{"role": "user", "content": "Use lookup_ticket for T-42."}]
response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    thinking={"type": "between_tools"},
    output_config={"effort": "medium"},
    tools=tools,
    tool_choice={"type": "auto"},
    messages=messages,
)

# Keep every block, including signed thinking blocks, exactly as returned.
messages.append({
    "role": "assistant",
    "content": [block.model_dump() for block in response.content],
})

tool_call = next(block for block in response.content if block.type == "tool_use")
messages.append({
    "role": "user",
    "content": [{
        "type": "tool_result",
        "tool_use_id": tool_call.id,
        "content": "Ticket T-42 is open and assigned to Support Ops.",
    }],
})

follow_up = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    thinking={"type": "between_tools"},
    output_config={"effort": "medium"},
    tools=tools,
    tool_choice={"type": "auto"},
    messages=messages,
)
Anthropics Migrationsleitfaden für Sonnet 5.5 dokumentiert die 400-Fehler der direkten API und die entsprechenden Ersatzfelder. Meine lokale Medium-Anfrage mit between_tools lieferte in 1.35 Sekunden HTTP 200. Eine separate adaptive Tool-Schleife erzeugte einen signierten Thinking-Block; die unveränderte Rückgabe des vollständigen Blocks war im nächsten Durchlauf erfolgreich.
Eine wichtige Besonderheit bleibt: Meine Aufrufe liefen über ein KI-Gateway. Diese Kompatibilitätsschicht antwortete mit HTTP 200, als ich absichtlich den alten Thinking-Wert disabled und die erzwungene Einstellung tool_choice: any sendete – obwohl Anthropic beides als Fehler der direkten API dokumentiert. Die Annahme durch Middleware beweist daher nicht, dass eine direkte Integration kompatibel ist. Prüfen Sie vor der Umstellung die unverarbeitete Anfrage in Anthropics Playground oder testen Sie den direkten Endpunkt.
Was Sonnet 5.5 nicht löst
Eine unbelegte Schlussfolgerung wird durch das Modell nicht zur Tatsache. Der lokale Support-Test zeigte das deutlich. Für folgenreiche Aussagen sind Quellenverweise erforderlich; Freigaben bleiben bei Erstattungen, Kontoänderungen, rechtlichen Zusagen, medizinischen Entscheidungen und Sicherheitsmaßnahmen bestehen.
Auch wird nicht jede Aufgabe durch das Modell zur Medium-Aufgabe. Erhöhen Sie Effort, wenn eigene Beispiele Denkfehler oder unvollständige Arbeit zeigen. Für offene Aufgaben, die dauerhaftes Urteilsvermögen verlangen, ist Opus vorgesehen; der Vergleich zu Opus 5.5 zeigt, wo diese höhere Stufe sinnvoll ist.
Ebenso wenig macht der reine Modellaufruf bereits ein Produkt aus. Connectoren, Berechtigungen, Richtlinienprüfungen, Evaluationen, Beobachtbarkeit, Fallback-Verhalten und eine brauchbare Prüfoberfläche verursachen den Großteil der Produktionsarbeit.
Aktuelle Quellen bleiben ebenfalls notwendig. Wenn eine Support- oder Rechercheantwort davon abhängt, was derzeit erlaubt, vorgeschrieben oder kostenpflichtig ist, braucht das Modell ein Such- oder Wissens-Tool und die klare Anweisung, dort nachzusehen.
Der erste Schritt am Montag
Wählen Sie eine Warteschlange mit eindeutiger Datenquelle. Nehmen Sie am Montag 20 aktuelle Beispiele, entfernen Sie nicht benötigte private Daten und führen Sie Sonnet 5.5 bei Medium mit einem festen Ausgabeschema aus. Bewerten Sie faktische Richtigkeit, unbelegte Schlussfolgerungen, Vollständigkeit, Laufzeit und Token-Verbrauch. Erst wenn der Prompt diese Prüfung besteht, sollte die Modell-ID einer bestehenden API geändert und sollten die obigen Migrationsprüfungen durchgeführt werden.
Wie lässt sich Claude Sonnet nutzen?
In der Claude-App neben der Senden-Schaltfläche auf den Modellnamen klicken, Sonnet 5.5 und Medium Effort auswählen und mit einer klar begrenzten Aufgabe beginnen, deren Ergebnis sich prüfen lässt. In Claude Code /model ausführen und Sonnet 5.5 wählen oder eine Sitzung mit claude --model claude-sonnet-5-5 starten.
Wofür eignet sich Claude Sonnet 5 am besten?
Bei der aktuellen Version Sonnet 5.5 empfiehlt sich der Einstieg mit klar umrissener Alltagsarbeit: Support-Zusammenfassungen, Kundenbriefings, Fehlerbehebungen, Code-Reviews und ausgearbeitete Geschäftsdokumente. Für offene Aufgaben mit hohen Folgen subtiler Fehler ist eine höhere Effort-Stufe oder Opus geeigneter.
Ist Claude Sonnet kostenlos?
Verfügbarkeit und Grenzen hängen vom Claude-Tarif und den Einstellungen der Organisation ab. App-Zugang und API-Abrechnung sind getrennt; ein kostenpflichtiges Claude-Abonnement enthält daher keine API-Nutzung. Die verlinkte Tarifübersicht erklärt die aktuellen Grenzen.
Was kostet Claude Sonnet 5?
Claude Sonnet 5.5 kostet $2 pro Million Eingabe-Token, $10 pro Million Ausgabe-Token und $0.20 pro Million Cache-Lese-Token. Anthropic zufolge kann eine abgeschlossene Aufgabe günstiger sein als mit Sonnet 5, weil weniger Token benötigt werden – nicht weil diese Preise niedriger wären.
Wenn ein quellenbasiertes Claude-System für Ihr Unternehmen entstehen soll, finden Sie hier weitere Informationen zu KI-Produktionssystemen.
- Zuletzt aktualisiert
- 28. Sept. 2026
- Kategorie
- AI
Diese Seite in Google bevorzugen


Markieren Sie omidsaffari.com als bevorzugte Quelle, und Google hebt die Seite für Sie in Top Stories, AI Overviews und AI Mode hervor.

GLM Flash oder Jev: Welches Entscheidungsmodell passt?
GLM Flash oder Jev? Der Vergleich zeigt Kosten, Bildverarbeitung, Latenz und Einsatzgrenzen – plus einen fairen Testplan für die eigene Entscheidung.27. Sept. 2026AI
Claude Opus 5.5 Vergleich: Lohnt sich der Wechsel von Opus 5?
Der Claude Opus 5.5 Vergleich zeigt Preise, Cache-Vorteile, Coding-Leistung und API-Änderungen, die vor einem Wechsel von Opus 5 zu prüfen sind.23. Sept. 2026AI
GPT-6 Sol oder Luna: Welches Modell passt zu welchem Job?
GPT-6 Sol oder Luna? Der Vergleich zeigt Preise, Stärken und Einsatzgebiete – und wann Sol den 20× höheren Tokenpreis gegenüber Luna wirklich rechtfertigt.23. Sept. 2026AI
Ist GPT-6 Luna kostenlos? Pläne, Limits und API-Kosten
Ist GPT-6 Luna kostenlos? Der Überblick zeigt Gratiszugang, nötige Tarife, separate API-Kosten und die bislang nicht veröffentlichten Nutzungslimits.22. Sept. 2026AI
Xiaomi MiMo nutzen: V2.6 vom Prompt bis zur API
Xiaomi MiMo V2.6 praxisnah einrichten: Prompt in Studio testen, passenden API-Schlüssel wählen und Flash, Pro oder UltraSpeed gezielt einsetzen.22. Sept. 2026AI
Xiaomi MiMo V2.6: Wann Flash, wann Pro?
Xiaomi MiMo V2.6 im Kostenvergleich: Warum Flash meist genügt, wann Pro den Aufpreis verdient und wie ein belastbarer Drei-Aufgaben-Test entscheidet.22. Sept. 2026AI
MiMo V2.6 kostenlos nutzen: Was wirklich gratis ist
MiMo V2.6 Flash ist vorübergehend kostenlos. So unterscheiden sich OpenCode-Aktion, MIT-Downloads, kostenpflichtige API und Desktop-Angebote.22. Sept. 2026AI