Claude Sonnet 5.5: guía práctica de uso, API y costos
Aprende a usar Claude Sonnet 5.5 con el nivel de esfuerzo adecuado, flujos verificables y una migración de API segura, sin perder el control de los costos.



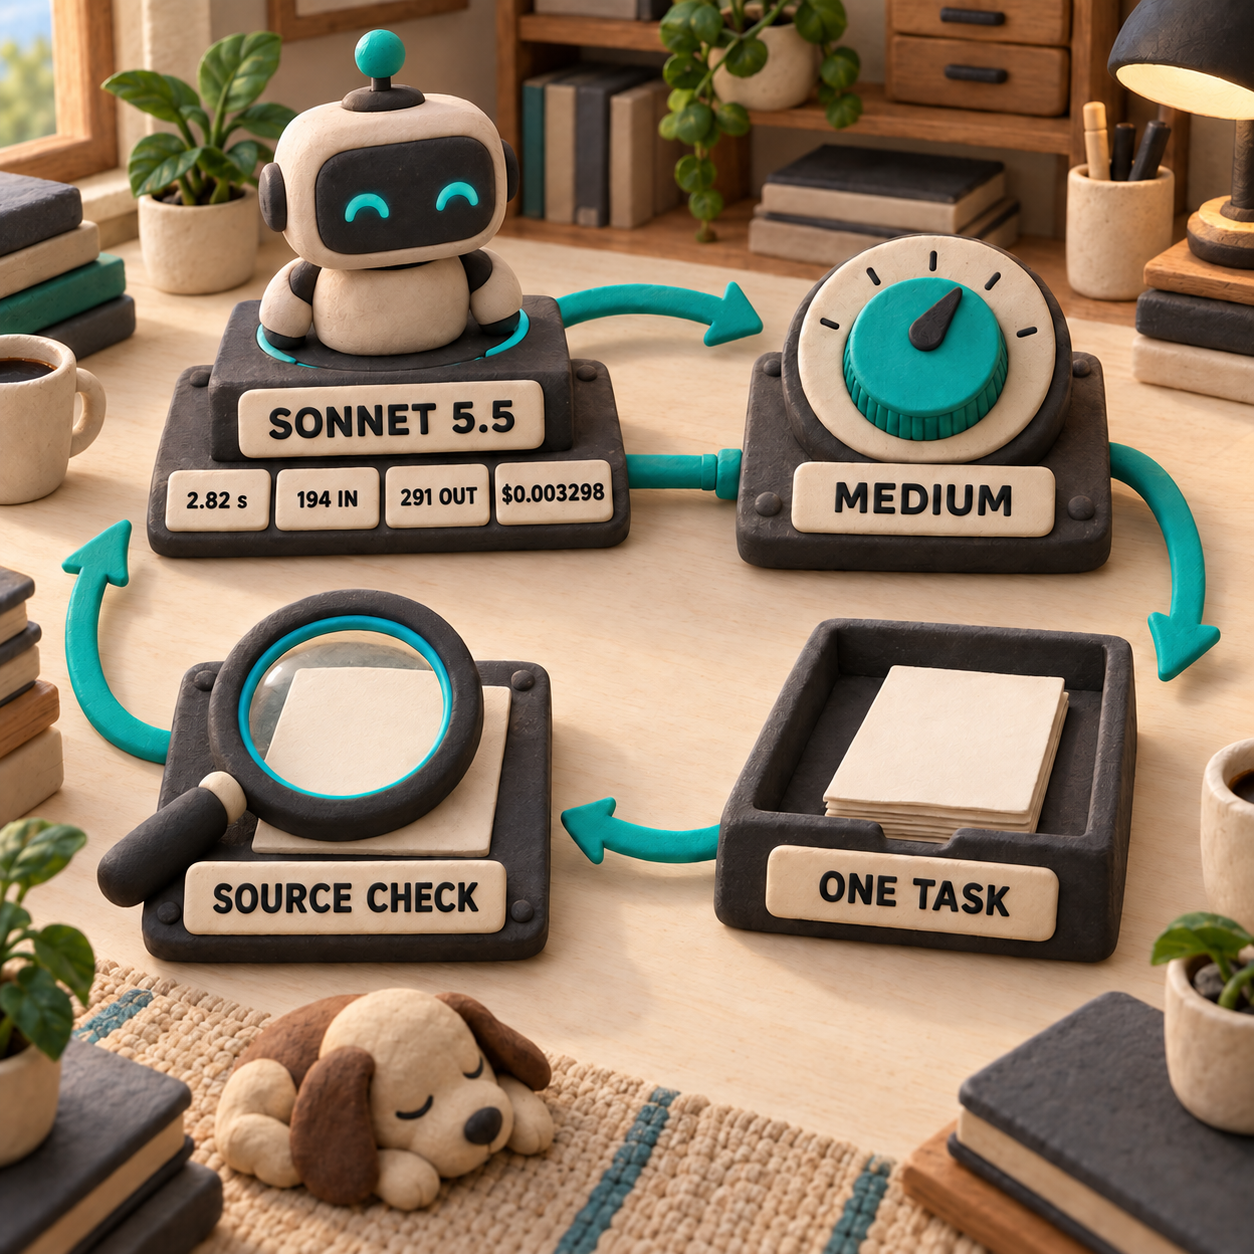
Empieza a usar Claude Sonnet 5.5 con una sola tarea acotada y fácil de revisar, en Medium: por ejemplo, resumir un ticket de soporte o preparar un briefing para un cliente. En mi prueba local con un caso sintético de soporte, el modelo respondió en 2.82 segundos, consumió 194 tokens de entrada y 291 de salida, y costó $0.003298. Conservó los datos esenciales del ticket, pero también añadió supuestos plausibles sobre cómo resolverlo que no figuraban en la fuente. Esa es la lección práctica: Sonnet 5.5 puede generar un borrador a un costo ínfimo, pero verificarlo sigue siendo parte del trabajo.
Empieza con una sola tarea en Medium
La forma más rápida de obtener un resultado útil es comenzar en la aplicación de Claude. Elige Sonnet 5.5, confirma que el esfuerzo esté en Medium, proporciona un único paquete de fuentes y pide una respuesta que puedas comprobar línea por línea.
Anthropic establece Medium como valor predeterminado en sus aplicaciones y en Claude Code. Claude Platform usa High de forma predeterminada, por lo que quienes trabajan con la API deben indicar el nivel expresamente. Medium es el mejor punto de partida para resúmenes de soporte, briefings de clientes, análisis rutinarios y tareas con herramientas bien definidas: mantiene ágil el ciclo de revisión sin bajar hasta el nivel mínimo.
Elige Sonnet 5.5
Abre un chat nuevo en Claude. Haz clic en el nombre del modelo, junto al botón de enviar, selecciona Sonnet 5.5 y abre el menú Effort. Si el modelo no aparece en la primera lista, haz clic en More models. Los administradores de Enterprise pueden limitar qué modelos y niveles de esfuerzo se muestran.
Mantén la primera prueba en Medium
Deja el esfuerzo en Medium para una tarea empresarial acotada. Pasa a High solo si el trabajo exige más criterio, una cadena de pasos más larga o una verificación más estricta. Low resulta útil cuando tus propias comprobaciones ya demuestran que la calidad se mantiene.
Dale una fuente y un formato
Pega un ticket, la transcripción de una llamada o un conjunto de documentos. Indica quién leerá el resultado y qué campos necesitas. Para un ticket de soporte, pide exactamente cuatro viñetas: Problema, Impacto, Evidencia y Próxima acción. Añade: «No inventes datos. Marca cada inferencia».
Contrasta las afirmaciones con la fuente
Compara con la entrada cada nombre, cifra, causa, compromiso y acción recomendada. Elimina los consejos sin respaldo, aunque suenen razonables. Guarda el prompt únicamente después de que supere esta revisión con varios ejemplos de tu propio flujo de trabajo.
El ticket sintético de mi prueba describía a seis agentes de soporte bloqueados tras un cambio en el dominio de inicio de sesión, dos agentes cuya sesión seguía abierta, un error «Invalid organization» y registros de usuario que ya contenían el dominio nuevo. Sonnet 5.5 conservó esos datos y respetó el formato de cuatro viñetas. También sugirió que el mapeo de la organización probablemente seguía apuntando al dominio anterior y calificó una de las soluciones como menos disruptiva. Ninguna de esas dos ideas aparecía en el ticket.
El cálculo puro del modelo es sencillo. Con la tarifa publicada por Anthropic, 194 tokens de entrada cuestan $0.000388 y 291 tokens de salida, $0.00291: $0.003298 en total. Si 10,000 llamadas tuvieran exactamente ese mismo volumen de tokens, el gasto bruto del modelo sería de $32.98. Eso no equivale al costo de resolver 10,000 tickets. Alrededor de la llamada al modelo siguen estando la recuperación de información, las integraciones, los reintentos, el almacenamiento, la supervisión y la revisión humana.
Qué es realmente Claude Sonnet 5.5
Sonnet 5.5 es el modelo rápido y de propósito general de la familia 5.5 de Anthropic. Conviene verlo como el modelo operativo para trabajos bien definidos, mientras que Opus 5.5 es el especialista sénior al que se recurre cuando el problema es abierto y exige mucho criterio.
Esta versión no es Sonnet 5. El identificador para la Claude API directa es claude-sonnet-5-5, sin sufijo de fecha. Acepta texto e imágenes, devuelve texto, ofrece una ventana de contexto de 1 millón de tokens y puede generar hasta 128,000 tokens de salida. Para consultar los precios y el contexto del tokenizador del modelo anterior, la reseña de Claude Sonnet 5 analiza esa versión por separado.
Anthropic afirma que Sonnet 5.5 genera respuestas más de un 30% más rápido que Sonnet 5 y que, en sus pruebas, cuesta hasta un 30% menos por tarea terminada. Esta segunda afirmación se refiere a que necesita menos tokens para completar el trabajo, no a una tarifa por token más baja. Los precios no cambiaron frente a Sonnet 5.
Los resultados de benchmarks también proceden de Anthropic. La empresa informa un 70.6% para Sonnet 5.5 frente a un 10.3% para Sonnet 5 en Terminal-Bench 4.0, y un 55.5% frente a un 34.1% en CursorBench 4.0. Estas cifras justifican probar el modelo nuevo, pero no revelan si cumplirá con la política de tickets, el código o la plantilla documental de tu organización. El informe de lanzamiento de Anthropic establece la misma diferencia entre las puntuaciones de benchmark y el criterio sostenido en trabajos abiertos.
Elige el esfuerzo según el costo de equivocarte
El nivel de esfuerzo controla la calidad, la latencia y el consumo de tokens; no determina la extensión del texto. Un nivel superior da más margen al modelo para razonar y comprobar su trabajo, pero también puede aumentar la espera y la factura. Si necesitas brevedad, pídela por separado en el prompt.
Anthropic recalibró estos niveles para Sonnet 5.5, así que Medium no representa el mismo volumen de razonamiento que Medium en Sonnet 5. Haz una evaluación nueva con tus propios ejemplos. No conserves un ajuste solo porque la etiqueta coincida.
Siete flujos útiles, ordenados por su impacto inmediato
Los mejores casos de uso comparten tres rasgos: la información de entrada está disponible, el resultado esperado tiene una estructura clara y una persona o una regla puede comprobarlo.
1. Clasificación de tickets de soporte
Un responsable de operaciones de soporte puede reunir el mensaje del cliente, el estado de la cuenta, el historial reciente de tickets y la política de escalamiento. Sonnet 5.5 puede devolver el problema, el impacto, las evidencias, los datos que faltan y la siguiente acción permitida. La ventaja es reducir la relectura antes de asignar o transferir el caso. Una persona debe seguir revisando cualquier consejo que cambie una cuenta, reembolso, promesa o afirmación sobre la causa raíz.
Es el mejor flujo para empezar porque cada parte de la respuesta puede enlazarse con un campo concreto de la fuente. Además, deja al descubierto los errores del modelo enseguida. Si un resumen no puede demostrar de dónde sale una afirmación, aún no debe activar ninguna acción.
2. Briefings antes de una llamada con un cliente
Un director de cuentas puede proporcionar la última transcripción, el alcance del trabajo, las tareas abiertas y las notas de renovación. Pide una página que reúna decisiones, compromisos, riesgos, preguntas pendientes y la agenda de la próxima reunión. Así se obtiene un formato de preparación repetible, en lugar de empezar desde una página en blanco antes de cada llamada.
Separa en apartados distintos lo «confirmado» y lo «inferido». Esa única distinción evita que una interpretación plausible del modelo termine convertida en un compromiso con el cliente.
3. Revisión de pull requests
Un responsable de ingeniería puede entregar al modelo el diff del código, las convenciones del repositorio y una lista de control de seguridad, pruebas y compatibilidad con versiones anteriores. Sonnet 5.5 puede hacer una primera revisión ordenada por riesgo y proponer pruebas. El beneficio es que el revisor se orienta más rápido, no que la aprobación sea automática. La decisión de integrar el cambio debe seguir en manos de una persona responsable del sistema.
4. Corrección de errores acotados
Un ingeniero de producto con un error reproducible puede aportar el comportamiento que falla, los archivos relevantes y los criterios de aceptación. Medium es un punto de partida razonable para una corrección bien especificada. Sube a High cuando el problema atraviese varios servicios o la primera ejecución omita la verificación. El resultado son ciclos de implementación y pruebas más cortos, mientras los criterios de aceptación evitan que la tarea se desborde.
5. Revisiones operativas y borradores para el consejo
Un equipo de finanzas u operaciones puede proporcionar los materiales fuente y una plantilla aprobada para presentaciones o documentos. Sonnet 5.5 puede preparar una revisión estructurada, detectar vacíos y dar formato al primer borrador. Anthropic lo posiciona expresamente para producir documentos, presentaciones y hojas de cálculo pulidos. Se ahorra trabajo de montaje, pero cada afirmación financiera sigue necesitando una celda o un documento de referencia.
6. Resúmenes de incidentes
Un responsable de incidentes puede alimentar el modelo con la cronología, las alertas, las acciones y las notas de las personas responsables. Pide bloques separados para los hechos confirmados, las hipótesis, el impacto en clientes, las preguntas pendientes y las acciones posteriores. El beneficio es un traspaso más claro y un primer borrador del informe posterior al incidente. No permitas que el modelo eleve una correlación a causa raíz.
7. Control visual de calidad y pulido de interfaces
Un diseñador de producto o ingeniero de front-end puede combinar una captura de pantalla con las normas de marca y una lista de criterios de aceptación. Sonnet 5.5 puede detectar inconsistencias, priorizar correcciones y ayudar a implementar una iteración acotada. Así se acelera la mejora de defectos visibles. El criterio estético, las pruebas de accesibilidad y la decisión final sobre el producto siguen siendo responsabilidad humana.
Tres productos que sí vale la pena construir
El acceso directo al modelo no constituye un negocio. Un producto vendible añade contexto propio, un flujo controlado, evidencias y un punto donde una persona toma la decisión final.
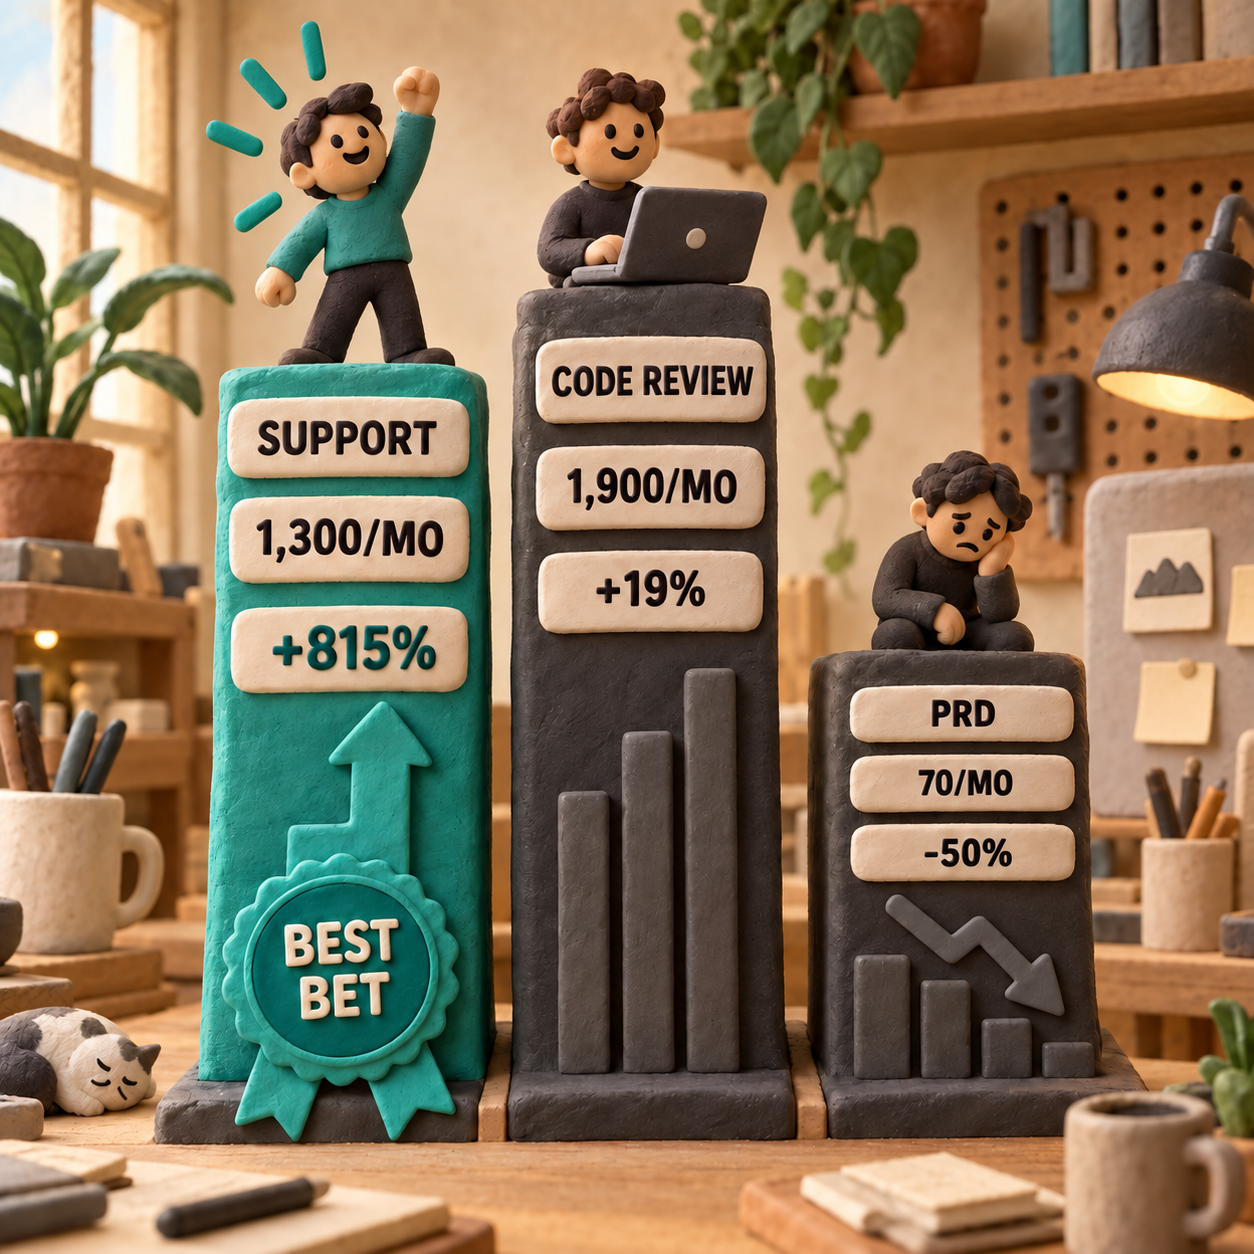
1. Clasificación de soporte con evidencias, la mejor oportunidad
Crea un copiloto de soporte que convierta un ticket y el registro de la cuenta en un resumen estructurado, adjunte a cada afirmación un enlace a su fuente, contraste la acción propuesta con las políticas y deje el borrador en una cola de aprobación. Los responsables de soporte y los proveedores externos de servicio pagarían por asignar casos con más rapidez y consistencia.
La demanda es visible: ai customer service agent registra 1,300 búsquedas mensuales en Estados Unidos, intención comercial y un crecimiento interanual del 815% según los datos de palabras clave de esta prueba. Intercom cobra $0.99 por resultado con Fin. No es una comparación directa con una llamada de resumen, porque resolver un caso es una tarea más amplia, pero demuestra que los compradores ya aceptan pagar el soporte automatizado por uso.
La versión vendible más pequeña necesita un conector de bandeja de entrada, otro para los datos de la cuenta, el resumen de cuatro campos, citas de las fuentes, una comprobación de políticas y controles para aprobar o rechazar. La dificultad está en la integración y la confianza. Si no puedes demostrar de dónde sale una recomendación, los clientes conservarán su flujo actual.
2. Una capa de revisión de código que conozca las políticas
Crea una aplicación para GitHub que lea un diff junto con las reglas de cada equipo y devuelva una revisión ordenada por riesgo, los vacíos de pruebas y un breve resumen para integrar el cambio. Los compradores son los responsables de ingeniería y los equipos de plataforma.
ai powered code review platform registra 1,900 búsquedas mensuales en Estados Unidos y un crecimiento interanual del 19%. Los precios públicos de CodeRabbit parten de $24 por desarrollador al mes con facturación anual, y ofrece planes superiores de $48 y $72. El MVP requiere un proveedor de repositorios, webhooks para pull requests, comprobaciones personalizadas, una vista de comentarios y un registro de auditoría que muestre qué regla activó cada hallazgo.
El problema es que se trata de un mercado saturado. Un revisor genérico no tiene una ventaja defendible. Elige un nicho doloroso, como verificaciones para lanzamientos regulados, seguridad en migraciones de datos o un framework concreto, y mide los falsos positivos con el mismo cuidado que los defectos omitidos.
3. Una herramienta vertical que convierta briefings en PRD, pero no una genérica
Crea un flujo específico que transforme llamadas, restricciones y decisiones anteriores en un briefing de producto con criterios de aceptación y preguntas pendientes. Una consultora de producto o un equipo de software especializado podría comprarlo si la plantilla encaja con su forma de trabajar.
La consulta exacta ai product requirements document generator apenas registra 70 búsquedas mensuales en Estados Unidos y ha caído un 50% interanual. Es una advertencia, no un argumento de venta. Un generador genérico e independiente de PRD es la oportunidad más débil de las tres. La versión viable sería un complemento dentro de un flujo de mayor valor, como el descubrimiento para agencias, la implementación en salud o el control de cambios empresarial.
El MVP consiste en un paquete de fuentes fijo, una única plantilla con criterio propio, trazabilidad de decisiones y exportación al sistema que el comprador ya utiliza. El problema es la escasa demanda y lo fácil que resulta copiarlo. No lo construyas salvo que ya tengas la relación con los clientes o un canal de datos vertical.
El precio no cambió, pero el flujo puede costar menos
Sonnet 5.5 cuesta $2 por millón de tokens de entrada, $10 por millón de tokens de salida y $0.20 por millón de tokens leídos desde caché. Son las mismas tarifas publicadas para Sonnet 5. La afirmación de Anthropic sobre el menor costo se debe a que completa las tareas con menos tokens.
Esta diferencia importa al hacer previsiones. Una traza más corta del modelo puede reducir la latencia y el gasto en tokens aunque el tarifario no cambie. También puede dejar prácticamente igual el costo total del producto si predominan la recuperación de información, las herramientas de terceros, los reintentos y la revisión humana. Mide el costo por resultado aceptado, no por llamada.
Las suscripciones a la aplicación de Claude y el uso de la API son productos separados. Pagar Pro, Max, Team o Enterprise no incluye Claude Console ni el consumo de la API. La guía de planes de Claude explica los límites generales de cada plan; un flujo con la API requiere su propio acceso a Console y facturación por consumo.
Migra el flujo de Claude API cuando la tarea ya funcione
El orden de migración más seguro es sencillo: valida el prompt con ejemplos representativos, fija el ID del modelo nuevo, establece el esfuerzo de forma explícita y después corrige el contrato de razonamiento y llamadas a herramientas antes de enviar tráfico de producción.
Para una solicitud sencilla con razonamiento adaptativo, omite el campo thinking y lee los bloques de texto según su tipo:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    output_config={"effort": "medium"},
    messages=[{
        "role": "user",
        "content": "Summarize this ticket as Issue, Impact, Evidence, and Next action.",
    }],
)

for block in response.content:
    if block.type == "text":
        print(block.text)
Hay cuatro cambios de migración que conviene revisar de forma deliberada.
thinking: {"type": "disabled"}ya no se acepta en la Claude API directa de Anthropic. Usathinking: {"type": "between_tools"}cuando no quieras razonamiento inicial. Funciona con Low, Medium y High, pero no con Xhigh ni Max.- Los valores forzados
anyytoolcon nombre paratool_choiceya no se aceptan en la API directa. Usaauto, haz estricto el esquema cuando sea compatible e indica en el prompt cuándo debe ejecutarse la herramienta. - Una respuesta puede comenzar con un bloque
thinking. Procesa cada bloque de contenido según sutype; nunca des por hecho que existecontent[0].text. - En un bucle de herramientas, devuelve los bloques de razonamiento sin modificarlos. Contienen firmas vinculadas a la conversación anterior, así que mantén el historial de mensajes como un registro al que solo se añaden elementos.
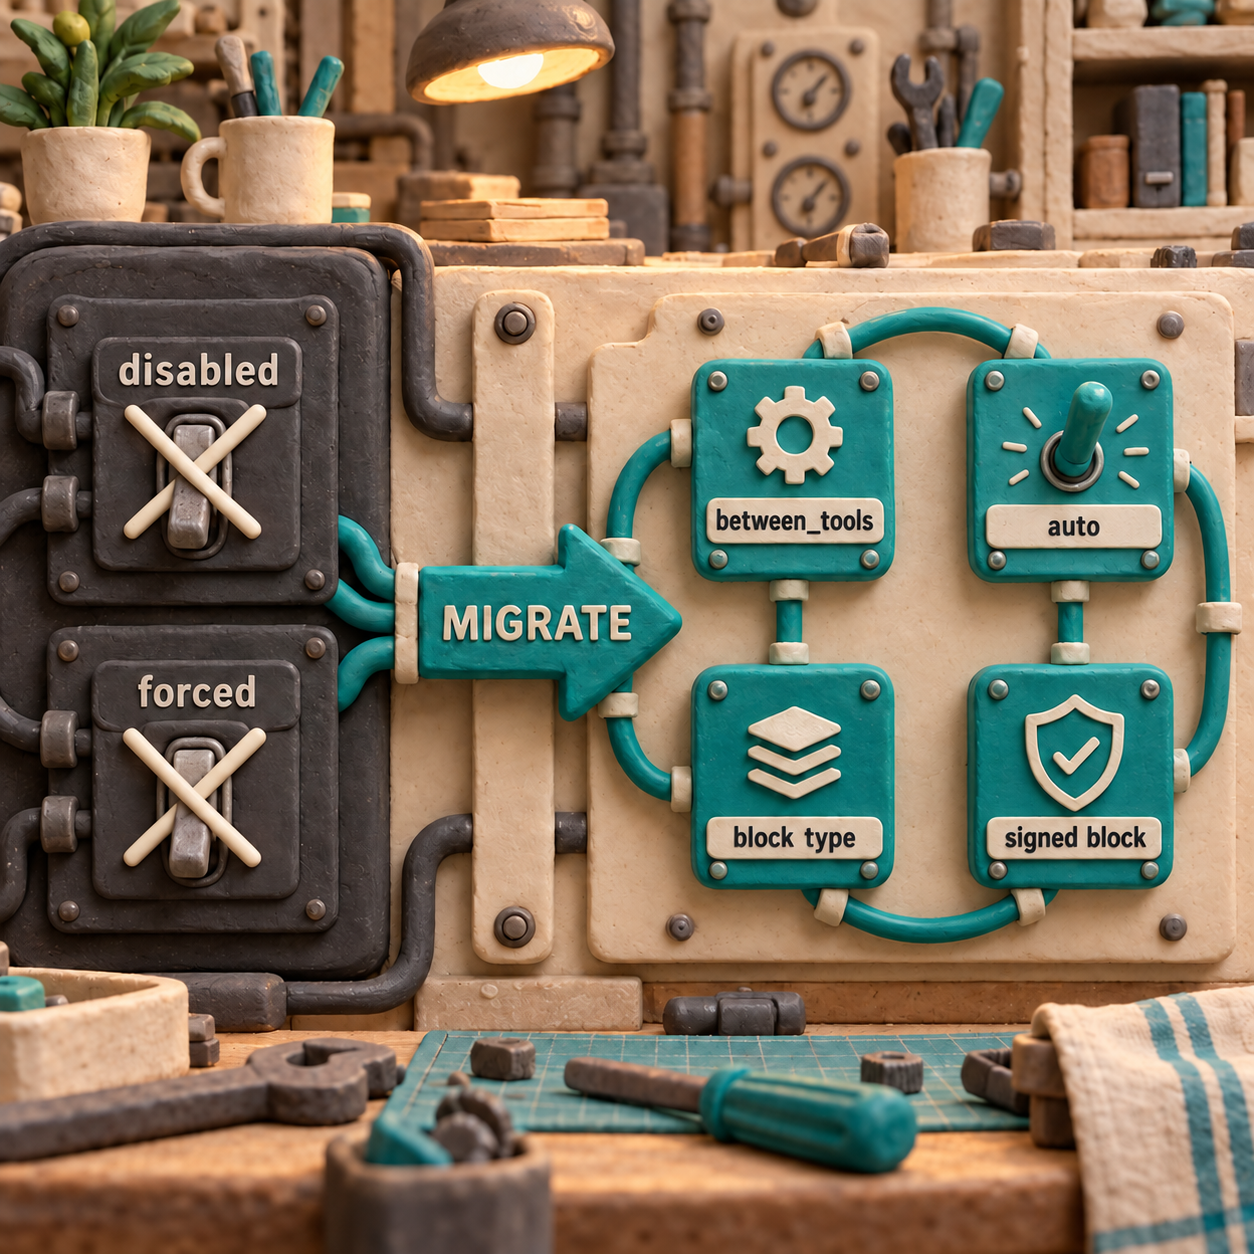
Este patrón mínimo usa between_tools, mantiene la selección de herramientas en auto y conserva completo el turno del asistente:
tools = [{
    "name": "lookup_ticket",
    "description": "Look up a support ticket",
    "strict": True,
    "input_schema": {
        "type": "object",
        "properties": {"ticket_id": {"type": "string"}},
        "required": ["ticket_id"],
        "additionalProperties": False,
    },
}]

messages = [{"role": "user", "content": "Use lookup_ticket for T-42."}]
response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    thinking={"type": "between_tools"},
    output_config={"effort": "medium"},
    tools=tools,
    tool_choice={"type": "auto"},
    messages=messages,
)

# Keep every block, including signed thinking blocks, exactly as returned.
messages.append({
    "role": "assistant",
    "content": [block.model_dump() for block in response.content],
})

tool_call = next(block for block in response.content if block.type == "tool_use")
messages.append({
    "role": "user",
    "content": [{
        "type": "tool_result",
        "tool_use_id": tool_call.id,
        "content": "Ticket T-42 is open and assigned to Support Ops.",
    }],
})

follow_up = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    thinking={"type": "between_tools"},
    output_config={"effort": "medium"},
    tools=tools,
    tool_choice={"type": "auto"},
    messages=messages,
)
La guía de migración de Sonnet 5.5 de Anthropic documenta los errores 400 de la API directa y los campos que los sustituyen. Mi solicitud local con between_tools en Medium devolvió HTTP 200 en 1.35 segundos. Otro bucle de herramientas con razonamiento adaptativo generó un bloque de razonamiento firmado, y devolver el bloque completo sin cambios permitió completar correctamente el turno siguiente.
Hay un matiz importante: mis llamadas pasaron por un gateway de IA. Esa capa de compatibilidad devolvió HTTP 200 cuando envié a propósito el antiguo valor de razonamiento disabled y forcé tool_choice: any, aunque Anthropic documenta ambos como errores de su API directa. No interpretes que el middleware los acepte como prueba de compatibilidad de tu integración directa. Inspecciona la solicitud sin procesar en el Playground de Anthropic o prueba el endpoint directo antes del cambio.
Lo que Sonnet 5.5 no resuelve
No convierte una inferencia sin respaldo en un hecho. La prueba local de soporte lo dejó claro. Exige referencias a la fuente para las afirmaciones de alto impacto y conserva las aprobaciones para reembolsos, cambios en cuentas, compromisos legales, decisiones médicas y acciones de seguridad.
Tampoco convierte todas las tareas en tareas para Medium. Aumenta el esfuerzo cuando tus propios ejemplos muestren fallos de razonamiento o trabajos incompletos. Usa Opus para trabajos abiertos que exijan criterio sostenido; la comparativa de Opus 5.5 explica dónde encaja ese nivel superior.
No convierte una simple llamada al modelo en un producto. Conectores, permisos, controles de políticas, evaluaciones, observabilidad, mecanismos de respaldo y una interfaz de revisión útil concentran la mayor parte del trabajo de producción.
Tampoco elimina la necesidad de fuentes actuales. Si una respuesta de soporte o investigación depende de lo que hoy se permite, se exige o se cobra, proporciona al modelo una herramienta de búsqueda o conocimiento e indícale que lo compruebe.
Lo que debes hacer el lunes
Elige una cola con una fuente de verdad clara. El lunes, toma 20 ejemplos recientes, elimina los datos privados innecesarios y ejecuta Sonnet 5.5 en Medium con un único esquema de salida fijo. Evalúa precisión factual, inferencias sin respaldo, integridad, tiempo transcurrido y consumo de tokens. Solo cuando el prompt supere esa prueba deberías cambiar el ID del modelo en una API existente y realizar las comprobaciones de migración anteriores.
¿Cómo se usa Claude Sonnet?
En la aplicación de Claude, haz clic en el nombre del modelo junto al botón de enviar, elige Sonnet 5.5, selecciona el esfuerzo Medium y comienza con una tarea acotada cuyo resultado puedas comprobar. En Claude Code, ejecuta /model y selecciona Sonnet 5.5, o inicia una sesión con claude --model claude-sonnet-5-5.
¿Para qué sirve Claude Sonnet 5?
Con la versión actual Sonnet 5.5, empieza por trabajos cotidianos bien definidos: resúmenes de soporte, briefings de clientes, corrección de errores, revisión de código y documentos empresariales pulidos. Usa un nivel de esfuerzo más alto u Opus cuando el trabajo sea abierto y el costo de un error sutil resulte elevado.
¿Claude Sonnet es gratis?
La disponibilidad y los límites dependen del plan de Claude y de la configuración de la organización. El acceso a la aplicación y la facturación de la API son independientes, por lo que una suscripción de pago a Claude no incluye el uso de la API. Consulta la guía enlazada sobre planes de Claude para conocer los límites vigentes.
¿Cuánto cuesta Claude Sonnet 5?
Claude Sonnet 5.5 cuesta $2 por millón de tokens de entrada, $10 por millón de tokens de salida y $0.20 por millón de tokens leídos desde caché. Anthropic afirma que puede costar menos por tarea completada que Sonnet 5 porque utiliza menos tokens, no porque esas tarifas sean inferiores.
Si quieres un flujo de Claude basado en fuentes y adaptado a tu empresa, consulta sistemas de IA para producción.
- Última actualización
- 28 sept 2026
- Categoría
- AI
Prefiera este sitio en Google


Marque omidsaffari.com como fuente preferida y Google lo destacará para usted en Top Stories, AI Overviews y AI Mode.

GLM-5.3-Flash vs Jev: cuál elegir para decisiones con IA
Compara GLM-5.3-Flash y Jev en precio, entradas, latencia y portabilidad. Descubre cuál conviene para enrutar texto o clasificar documentos con IA.27 sept 2026AI
Claude Opus 5 vs Opus 5.5: qué cambia y cuándo migrar
Claude Opus 5 frente a Opus 5.5: comparamos precio, programación y cambios de API para saber cuándo migrar y cuándo mantener el modelo anterior.23 sept 2026AI
Comparativa GPT-6 Sol vs Luna: cuál elegir
Compara GPT-6 Sol y Luna en precio, capacidad y programación. Descubre cuándo conviene empezar con Luna y qué tareas justifican pagar más por Sol.23 sept 2026AI
GPT-6 Luna gratis: acceso, límites y precio real
GPT-6 Luna se puede probar gratis en la app de escritorio. Conoce qué planes permiten usarlo, cuáles son sus límites y cuánto cuesta la API.22 sept 2026AI
Xiaomi MiMo API: cómo usar MiMo V2.6 paso a paso
Aprende a configurar Xiaomi MiMo API en Studio y Python, elegir la clave y el modelo correctos, y validar tu primer flujo empresarial con controles claros.22 sept 2026AI
Xiaomi MiMo V2.6: Pro o Flash, ¿cuál conviene?
Compara Xiaomi MiMo V2.6 Pro y Flash en calidad, precio, caché y programación para elegir el modelo que reduce el costo por resultado aceptado.22 sept 2026AI
MiMo V2.6 gratis: dónde usarlo y cuánto cuesta después
Descubre dónde usar MiMo V2.6 gratis, qué datos puede recopilar la promoción, cuánto cuesta la API de Xiaomi y cuándo conviene alojarlo por cuenta propia.22 sept 2026AI