Claude Opus 5 vs Opus 5.5: qué cambia y cuándo migrar
Claude Opus 5 frente a Opus 5.5: comparamos precio, programación y cambios de API para saber cuándo migrar y cuándo mantener el modelo anterior.


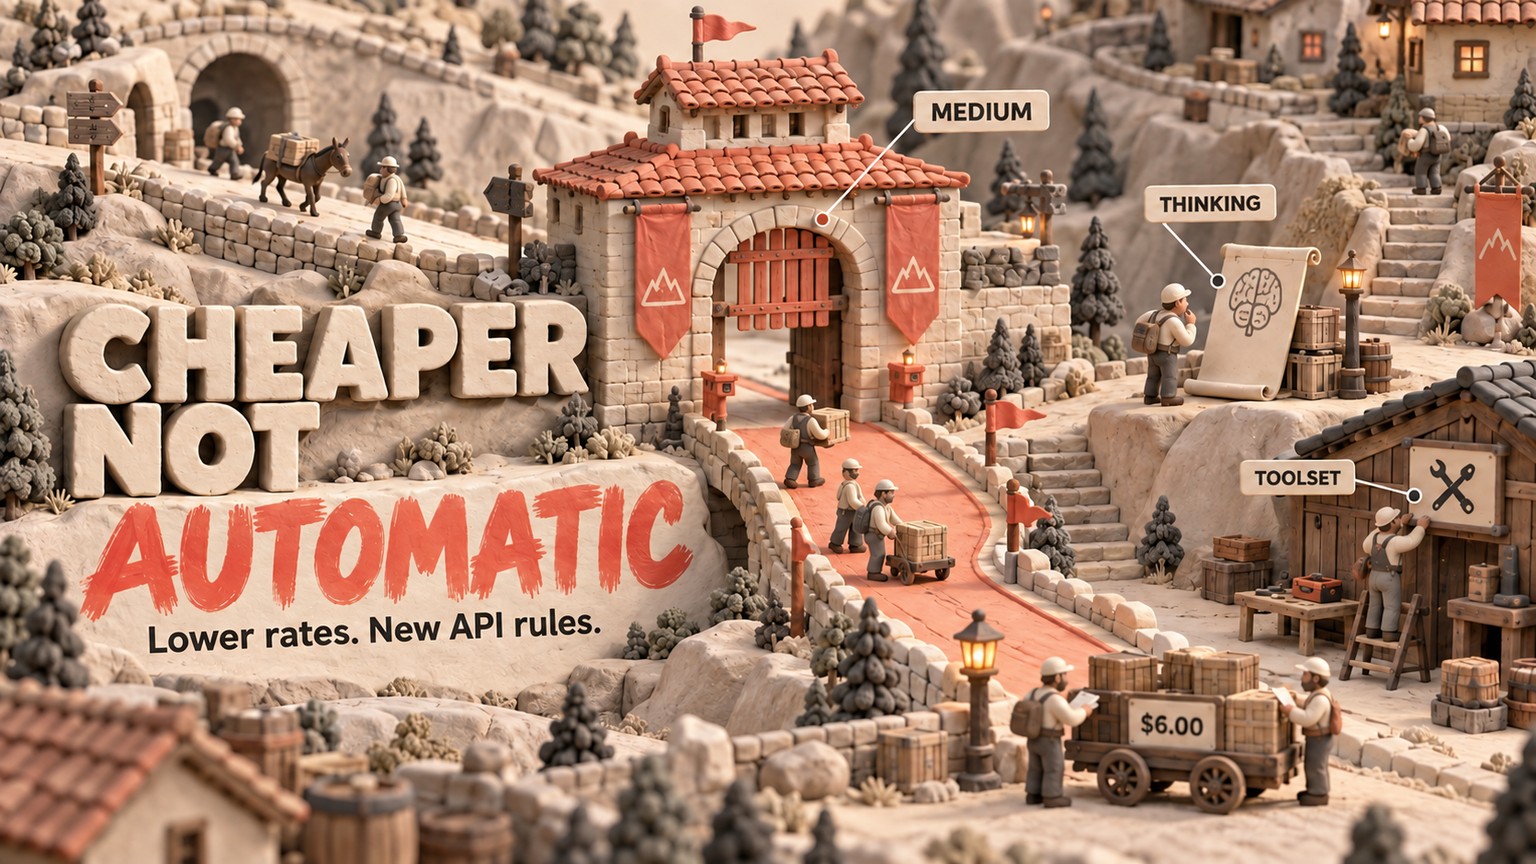
Claude Opus 5.5 es la actualización que conviene probar para la mayoría de las cargas de trabajo de Opus 5: 1 millón de tokens de entrada sin caché más 100,000 tokens de salida facturados cuestan $6.00 en lugar de $7.50. La decisión entre Claude Opus 5.5 y Opus 5 aún depende de cinco cambios de integración, porque el modelo más barato no sirve como sustituto directo en todos los agentes.
Claude Opus 5 vs Opus 5.5: ¿cuál conviene elegir?
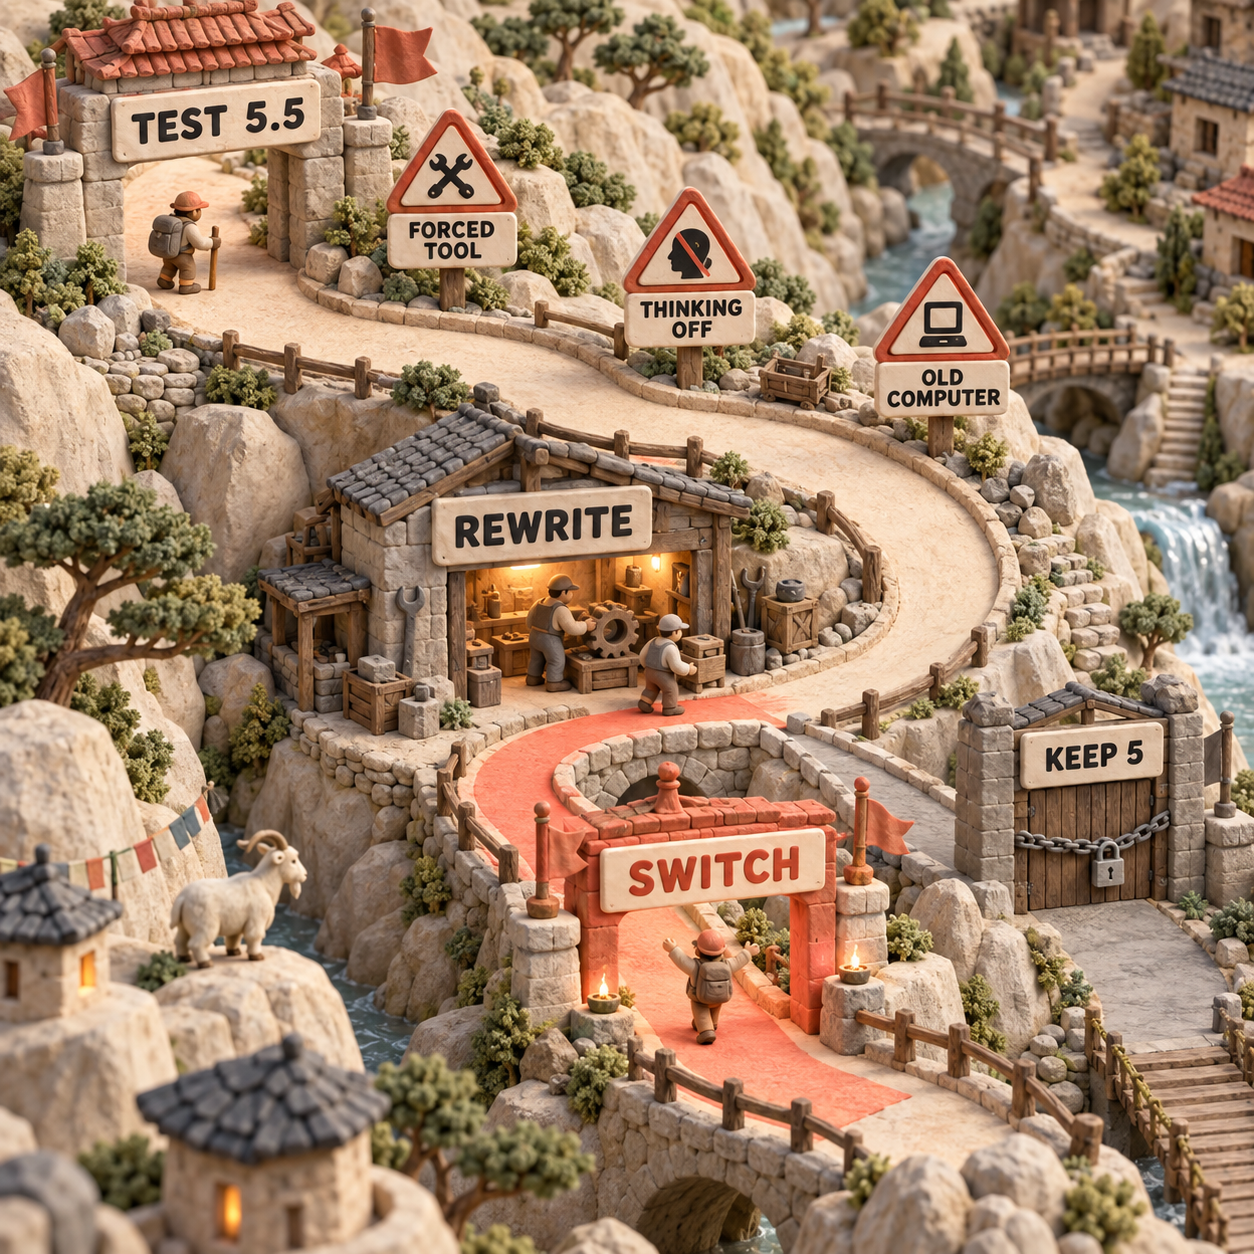
Para nuevos trabajos premium, conviene elegir Claude Opus 5.5 y probarlo como sustituto en la mayoría de las rutas que hoy usan Opus 5. Es mejor mantener Opus 5 de forma temporal si la integración desactiva el razonamiento, obliga a usar una herramienta específica o todavía utiliza la herramienta de computadora anterior en Claude API o Google Cloud. Son decisiones sobre rutas de código, no simples diferencias de preferencia entre modelos.
Claude Opus 5.5 gana para un fundador con capital cuyo agente de programación consume lo suficiente como para que importen las lecturas de caché y los reintentos. Un CTO de una empresa mediana también debería preferirlo, pero solo después de que el equipo de plataforma resuelva los cambios en la forma de las solicitudes. Un responsable sénior que ejecute extracciones acotadas debería comprobar primero si Claude Sonnet 5 ya supera el umbral de aceptación a una tarifa menor. Un profesional técnico independiente debería reservar 5.5 para el trabajo difícil en repositorios y mantener las tareas más baratas fuera de Opus.
La decisión vuelve a favorecer a Opus 5 cuando el trabajo de migración cuesta más que el ahorro previsto y la ruta anterior ya es fiable. Esa es una ventaja temporal de compatibilidad, no un motivo para iniciar desarrollos nuevos sobre el modelo anterior.
Anthropic lanzó Opus 5.5 el 22 de septiembre de 2026. Su propia guía de modelos ahora recomienda que un desarrollador indeciso empiece con Opus 5.5 para la mayoría de las cargas de trabajo, mientras que el modelo anterior sigue siendo útil como opción de reversión durante la migración.
Precio de Claude Opus 5.5 vs Claude Opus 5
Claude Opus 5.5 es más barato con cualquier cantidad idéntica de tokens estándar. Los precios verificados en la documentación de precios vigente de Anthropic el 23 de septiembre de 2026 son $4 por millón de tokens de entrada y $20 por millón de tokens de salida para 5.5, frente a $5 y $25 para Opus 5. Esto supone una reducción del 20% en la tarifa de lista. Una lectura de caché reutiliza contenido del prompt; su tarifa baja de $0.50 a $0.20 por millón, una reducción del 60%.
En una unidad menor, 1,000 tokens de entrada sin caché cuestan $0.004 con 5.5 frente a $0.005 con 5. La salida cuesta $0.020 frente a $0.025 por cada 1,000 tokens. Ninguno de los dos modelos tiene un punto de cruce por asiento al mes ni un precio fijo por imagen en esta comparación de API. La factura depende de los tokens, por lo que 5.5 nunca resulta más caro si la distribución de tokens facturados es idéntica.
La cuenta sin caché es directa: Opus 5 cuesta $5 por la entrada más $2.50 por la salida. Opus 5.5 cuesta $4 más $2. La cuenta con caché caliente cobra 100,000 tokens de entrada sin caché, 900,000 tokens leídos de la caché y 100,000 tokens de salida. Excluye deliberadamente la creación de caché, las herramientas, los reintentos, los descuentos por lotes, el modo rápido y los multiplicadores por residencia de datos.
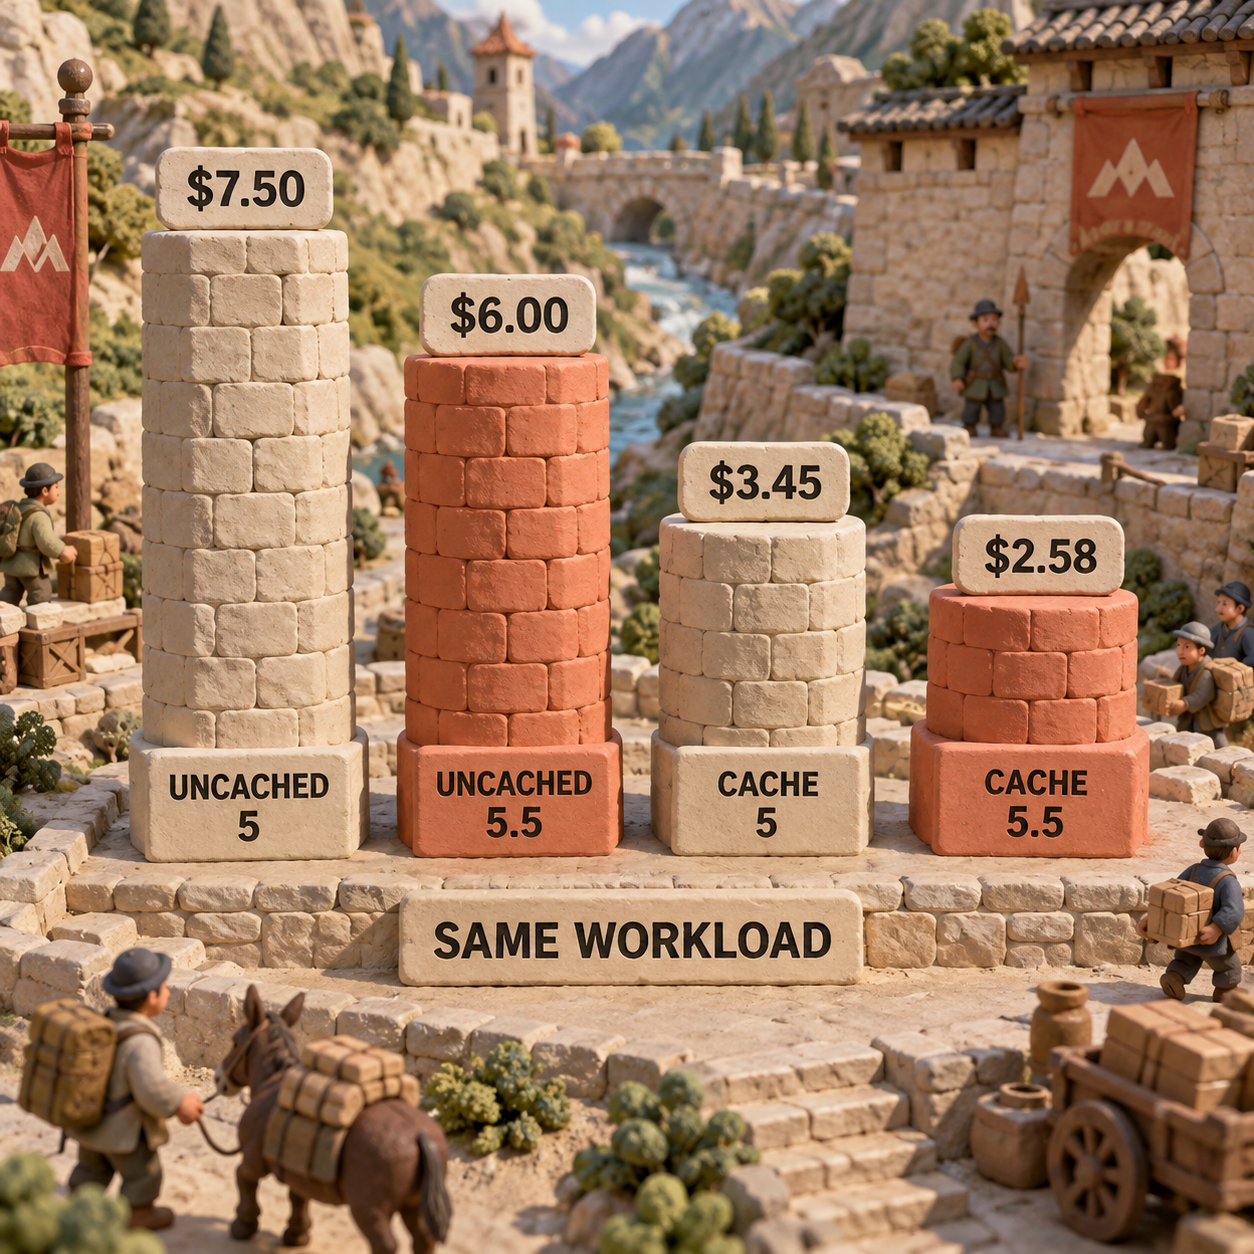
La afirmación de Anthropic de que 5.5 cuesta 40% menos en cargas de trabajo habituales corresponde a una medición del proveedor, no a otro cálculo de precios de lista. Anthropic sostiene que el modelo combina tarifas más bajas con menos tokens por tarea en la configuración predeterminada. Conviene mantener esa afirmación separada de las cuentas con tokens fijos, en vez de aplicar un descuento del 40% a todas las estimaciones.
El punto de cruce útil está en el comportamiento de los tokens. En la cuenta sin caché, 5.5 podría generar 175,000 tokens de salida, un 75% más que la referencia de 100,000 tokens de Opus 5, antes de que su factura alcanzara los mismos $7.50. En el caso con caché caliente, podría llegar a 143,500 tokens de salida, un 43.5% más, antes de igualar los $3.45. Si una migración supera esos límites sin mejorar la aceptación, la tarifa más baja ha dejado de aportar valor.
Ganador en precio: Claude Opus 5.5. Su ventaja tarifaria es incondicional cuando el uso es igual. La ventaja en una carga de trabajo aún debe sostenerse al medir el consumo de tokens y los reintentos.
Claude Opus 5.5 para programación: qué respalda la evidencia publicada
Claude Opus 5.5 presenta el caso documentado más sólido para programación, pero en esta comparación no se ejecutó ninguna prueba de modelos. No había credenciales de ejecución disponibles, por lo que aquí no se afirma que durante este análisis se haya realizado una reparación de repositorio o una tarea de extracción, ni que se hayan obtenido un ID de modelo, una latencia o un resultado de validación.
Análisis de Claude Opus 5.5 vs Opus 5: dónde termina la evidencia
En las evaluaciones de lanzamiento de Anthropic, Opus 5.5 con su esfuerzo medium predeterminado obtuvo 52.5% en CursorBench 4.0, una prueba de tareas ambiguas de programación en varios archivos extraídas de sesiones de Cursor, mientras que Opus 5 con max obtuvo 46.6%. Anthropic también informa que la generación de salida es más de 30% más rápida. Estas cifras justifican una evaluación, pero las configuraciones de esfuerzo son distintas y la comparación fue realizada por el proveedor.
AutomationBench aporta una señal medida por separado. La nota al pie del lanzamiento de Anthropic indica que Zapier ejecutó y reportó el benchmark: Opus 5.5 obtuvo 40.0% y Opus 5, 26.9%. La prueba trata sobre flujos de trabajo entre aplicaciones conectadas, no sobre todos los repositorios o procesos empresariales, y no permite saber cómo se comportarán su modelo de permisos, sus herramientas o su validador.
Para un agente de programación, defina la aceptación antes de ejecutar la prueba: las pruebas deben pasar, el diff debe mantenerse dentro del alcance y la revisión no debe encontrar trabajo correctivo. Para una extracción, exija un esquema exacto, valores respaldados por la fuente y un validador determinista. Después registre los tokens de entrada, los tokens de caché, los tokens de salida, la latencia, las llamadas a herramientas, los reintentos y los fallos. Una puntuación de benchmark más alta no compensa el costo si el entorno de evaluación genera más trabajo rechazado.
Ganador según la evidencia documentada de programación: Claude Opus 5.5. El nivel de confianza basta para justificar una evaluación controlada, no un cambio ciego en producción.
Cambios de la API de Opus 5.5 que pueden impedir una sustitución directa
Cinco comprobaciones de integración importan más que cambiar el identificador del modelo. La documentación vigente sobre los cambios de Opus 5.5 de Anthropic describe cuatro cambios que pueden romper una solicitud y otro cambio en la forma de la respuesta que puede fallar silenciosamente en la interfaz.
1. El razonamiento no puede desactivarse
Opus 5.5 siempre usa razonamiento adaptativo. Una solicitud con thinking:{"type":"disabled"} devuelve HTTP 400, al igual que un presupuesto manual de razonamiento con thinking:{"type":"enabled","budget_tokens":N}. Omita el campo o envíe razonamiento adaptativo y controle la profundidad con output_config.effort.
Opus 5 admitía desactivar el razonamiento con un esfuerzo high o inferior. Por tanto, una ruta estable de baja latencia construida alrededor de esa opción necesita un rediseño, no solo un nuevo ID de modelo.
2. Forzar una herramienta devuelve un error
Opus 5.5 rechaza tool_choice cuando se establece en any o en una tool específica, también con HTTP 400. auto y none siguen siendo compatibles. Para obtener salidas que cumplan un esquema, Anthropic recomienda el uso estricto de herramientas con auto o salidas estructuradas.
Es un cambio de contrato relevante. Pedirle al modelo en el prompt que llame a una herramienta no ofrece el mismo mecanismo de cumplimiento que forzar la elección desde la API. Si un flujo de trabajo depende de que se ejecute exactamente una función, valide la ruta de reemplazo antes de cambiar el tráfico.
3. Los bloques de razonamiento quedan vinculados al modelo y a la conversación
Los bloques de razonamiento son registros de respuesta que conservan el razonamiento del modelo entre turnos de uso de herramientas. Opus 5.5 puede leer bloques generados por Opus 5, de modo que un historial al que solo se añaden mensajes puede avanzar sin descartar ese razonamiento previo. La limitación es que 5.5 no puede leer los bloques de todos los modelos, y las modificaciones posteriores del prompt del sistema, las herramientas o los mensajes anteriores pueden invalidar sus propios bloques conservados.
Para las cuentas de API creadas el 31 de agosto de 2026 a las 00:00 UTC o después, reproducir un bloque vinculado tras cambiar ese prefijo devuelve HTTP 400 de forma predeterminada. Mantenga el historial en modo de solo adición. Si la aplicación modifica turnos anteriores o sustituye definiciones de herramientas dentro del mismo historial, use los controles de vinculación documentados por Anthropic y pruebe de manera explícita cómo se descartan los bloques.
4. El uso de computadora varía según la plataforma
En Claude API y Google Cloud, Opus 5.5 rechaza la herramienta anterior computer_20251124 y exige computer_toolset_20260801. La migración cambia algo más que la cadena del tipo: el bucle del agente debe gestionar los bloques tool_use de las herramientas incluidas, las acciones por lotes y toolset_name en los resultados. La documentación sobre uso de computadora de Anthropic señala que Amazon Bedrock sigue aceptando la herramienta anterior con 5.5.
Esa diferencia entre plataformas puede hacer que un despliegue multinube funcione en un proveedor y devuelva un error en otro. Revise conjuntamente el proveedor y el cuerpo de la solicitud.
5. El texto de progreso puede desaparecer sin producir un error
Opus 5.5 devuelve notas breves entre llamadas a herramientas como bloques thinking de actualización de progreso, en vez de bloques text ordinarios. Con el valor predeterminado display:"omitted", el texto de razonamiento está vacío. Una interfaz que utilizaba esos bloques de texto para mostrar el progreso puede quedarse en silencio aunque las solicitudes y las llamadas a herramientas sigan ejecutándose correctamente.
Ganador en compatibilidad de integración: Claude Opus 5. El código existente para Opus 5 requiere menos cambios. Opus 5.5 gana una vez que esos cambios se implementan y validan.
Razonamiento en Opus 5.5: recalibre el esfuerzo, los tokens y la interfaz
La comparación más segura establece el esfuerzo de forma explícita porque los valores predeterminados cambiaron. Opus 5.5 usa medium de forma predeterminada; Opus 5 usaba high. Anthropic también afirma que 5.5 tiende a razonar más en cada turno con el mismo esfuerzo, sobre todo en xhigh y max. Una prueba con los valores predeterminados de ambos modelos mide la experiencia ofrecida de fábrica. Una prueba high frente a high aísla mejor la diferencia entre los modelos.
El modelo tiene una ventana de contexto de 1 millón de tokens y un máximo de salida de 128,000 tokens, según la descripción general de modelos de Anthropic. El razonamiento y el texto visible comparten el presupuesto de respuesta, así que deje margen suficiente para completar la tarea y registre la salida facturada en vez de tratar la etiqueta de esfuerzo como si fuera un presupuesto.
Uso de Opus 5.5 vs Opus 5
Capture el objeto de uso completo, no solo la longitud de la respuesta visible. Como mínimo, conserve la entrada sin caché, la creación de caché, las lecturas de caché, la salida, la latencia, las llamadas a herramientas, los reintentos, el motivo de finalización y el resultado del validador. Separe los valores predeterminados del esfuerzo igualado, porque mezclar medium y high puede hacer que un ahorro parezca una mejora pura de capacidad.
El análisis del control de esfuerzo de Opus 5 anterior sigue siendo un contexto histórico útil para entender qué significan los niveles. La lección para la migración es más concreta: no herede un nivel anterior ni una configuración omitida sin volver a ejecutar la carga de trabajo.
Ganador en control del gasto: decisión dividida. Opus 5 permite desactivar el razonamiento de forma explícita. Opus 5.5 ofrece un esfuerzo predeterminado menor y tarifas unitarias más bajas, pero el razonamiento siempre está presente y debe medirse.
Migración a Opus 5.5: cuál es el costo real del cambio
El costo de migración está en el trabajo que rodea la llamada al modelo: auditorías de solicitudes, cambios en el bucle del agente, reglas para conservar el contexto, renderizado del streaming, evaluación y reversión. Cambiar solo el identificador del modelo basta únicamente cuando la ruta ya usa razonamiento adaptativo, selección automática de herramientas, un conjunto de herramientas de computadora compatible, un historial de solo adición y un analizador de streaming que distingue los tipos.
No cambie todavía si se cumple alguna de estas condiciones:
- Se debe forzar una herramienta específica desde la API y el flujo de trabajo no puede pasar a herramientas estrictas o salidas estructuradas.
- El contrato de la ruta exige desactivar el razonamiento.
- Un agente de computadora de Claude API o Google Cloud todavía usa
computer_20251124y su bucle aún no puede gestionar el conjunto de herramientas. - La aplicación reescribe mensajes anteriores o definiciones de herramientas mientras reproduce bloques de razonamiento conservados.
- No existe una referencia de aceptación, por lo que no es posible distinguir una factura más barata de un trabajo de menor calidad.
Inventaríe todas las formas de solicitud de Opus 5
Busque en la configuración y en los generadores de solicitudes el ID del modelo,
thinking,output_config.effort,tool_choice, los bloques de razonamiento conservados y los tipos de herramientas de computadora. Revise cada proveedor de nube por separado. Registre qué ruta controla la reversión.Ejecute dos tareas con el mismo esfuerzo
Use una reparación acotada de código público con tests ejecutables y una extracción sintética con un validador de esquema determinista. Envíe a ambos modelos el mismo prompt, las mismas herramientas, el mismo contexto, un esfuerzo
highexplícito y un límite de salida explícito. Guarde los ID de modelo devueltos, el uso completo, la latencia, los resultados de validación y todos los fallos.Compare por separado los valores predeterminados
Repita la prueba omitiendo el esfuerzo. Así se compara de forma aislada Opus 5.5 con su valor
mediumpredeterminado frente a Opus 5 con su valorhighpredeterminado, y se observa el efecto en producción que provocaría un simple cambio de ID de modelo.Corrija las rutas incompatibles
Elimine el razonamiento desactivado o con presupuesto manual, sustituya la selección forzada de herramientas, migre la herramienta de computadora anterior donde corresponda, mantenga un historial de solo adición y pruebe el renderizado del progreso. Haga que cada cambio sea visible durante la revisión en lugar de ocultarlo dentro de la actualización del modelo.
Pruebe en staging, mida y promueva
Dirija a 5.5 una proporción acotada de trabajo representativo. Compare el costo por resultado aceptado, no solo el precio por token. Promueva una clase de tareas únicamente cuando la aceptación se mantenga o mejore y el costo total disminuya; conserve Opus 5 como opción de reversión hasta que termine el periodo de observación.
Un fundador con capital puede ejecutar este sistema de evaluación antes del próximo lanzamiento de su agente. Un CTO debería tratarlo como un cambio en la capa de modelos, con responsables de API, observabilidad e interfaz de producto. Un responsable sénior debería añadir revisión humana a las acciones irreversibles, sin importar qué modelo gane. Un profesional independiente debería mantener la evaluación pequeña, pero aun así guardar el uso y el resultado del validador para que la decisión se base en evidencia y no en impresiones.
Su próximo paso el lunes
El próximo lunes, tome una tarea costosa y repetible de Opus 5 y cree una ruta paralela hacia claude-opus-5-5. Ejecute primero ambos modelos con un esfuerzo high explícito y después compare los valores predeterminados que cambiaron. No modifique producción hasta que estén en verde las comprobaciones de herramientas forzadas, razonamiento, computadora, contexto conservado y streaming de progreso.
La decisión final es sencilla: adopte 5.5 cuando el resultado aceptado cueste menos y se mantenga el contrato de integración. Conserve Opus 5 solo por una incompatibilidad concreta o una regresión medida. Una preferencia imprecisa por lo conocido no es un requisito de producción.
¿Qué versión de Claude Opus es mejor?
Claude Opus 5.5 es el mejor punto de partida para nuevos trabajos porque sus tarifas estándar y sus lecturas de caché son más bajas, y sus evaluaciones publicadas son superiores. Use Opus 5 como ruta temporal de compatibilidad o reversión cuando aún no se haya migrado una configuración incompatible.
¿Claude Opus 5 es mejor que GPT 5.6 Sol?
Esta comparación de migración entre dos modelos no permite afirmarlo. Una decisión entre proveedores exige el mismo sistema de evaluación, las mismas herramientas, los mismos controles de esfuerzo, los mismos precios y la misma regla de aceptación para ambos, en vez de copiar una puntuación de la página de lanzamiento de uno de ellos.
¿Claude Opus 5 es mejor?
Opus 5 no es la mejor opción predeterminada frente a Opus 5.5 por precio ni según las comparaciones publicadas por Anthropic. Solo es la mejor alternativa temporal cuando resulta imprescindible desactivar el razonamiento, forzar la selección de herramientas o mantener sin cambios una integración de computadora.
¿Hay algo mejor que Claude Opus?
Anthropic presenta Claude Fable 5.1 como el modelo al que escalar para razonamientos exigentes o trabajos prolongados que siguen fallando las evaluaciones de Opus 5.5 con un esfuerzo mayor. Cuesta $10 por millón de tokens de entrada y $50 por millón de tokens de salida, así que debería reservarse para resolver un fallo medido en vez de sustituir a Opus de forma predeterminada.
¿Por qué Claude Opus es tan caro?
Opus es la categoría premium de Anthropic para tareas profesionales, por lo que la factura solo se justifica cuando evita suficientes intentos fallidos, errores de herramientas o revisión humana como para superar el costo por resultado aceptado de un modelo más barato. Opus 5.5 reduce ese sobreprecio, pero no elimina la necesidad de asignar las tareas sencillas a otros modelos.
¿Fable es realmente mejor que Opus?
No para todas las cargas de trabajo. Fable es una vía de escalamiento para una tarea que no alcanza su umbral de aceptación con Opus 5.5; el mayor precio unitario debe traducirse en una mejora medible en esa tarea.
¿Cuál es la diferencia de precio entre Opus 5 y Fable 5?
Claude Opus 5 cuesta $5 por millón de tokens de entrada y $25 por millón de tokens de salida. Claude Fable 5 cuesta $10 y $50, exactamente el doble de esas tarifas estándar.
¿Cuál es la diferencia entre Opus 5 y Fable 5?
Opus 5 es el modelo premium de menor costo para tareas profesionales, mientras que Fable 5 es el nivel de escalamiento más caro para las tareas más difíciles. La diferencia práctica es si Fable supera una prueba de aceptación que Opus no logra por un margen suficiente para cubrir tarifas por token 2x más altas.
¿Opus 5 usa más tokens?
No existe una proporción universal de tokens. Anthropic afirma que Opus 5.5 usa menos tokens por tarea habitual, pero puede razonar más en cada turno con el mismo esfuerzo y el razonamiento no puede desactivarse. Mida todo el uso facturado con la misma carga de trabajo aceptada.
¿Necesita una lista depurada de modelos antes de invertir una semana en evaluaciones? Obtenga el Mapa de herramientas de IA para dueños de empresas.
- Última actualización
- 23 sept 2026
- Categoría
- AI
Prefiera este sitio en Google


Marque omidsaffari.com como fuente preferida y Google lo destacará para usted en Top Stories, AI Overviews y AI Mode.

Comparativa GPT-6 Sol vs Luna: cuál elegir
Compara GPT-6 Sol y Luna en precio, capacidad y programación. Descubre cuándo conviene empezar con Luna y qué tareas justifican pagar más por Sol.23 sept 2026AI
GPT-6 Luna gratis: acceso, límites y precio real
GPT-6 Luna se puede probar gratis en la app de escritorio. Conoce qué planes permiten usarlo, cuáles son sus límites y cuánto cuesta la API.22 sept 2026AI
Xiaomi MiMo API: cómo usar MiMo V2.6 paso a paso
Aprende a configurar Xiaomi MiMo API en Studio y Python, elegir la clave y el modelo correctos, y validar tu primer flujo empresarial con controles claros.22 sept 2026AI
Xiaomi MiMo V2.6: Pro o Flash, ¿cuál conviene?
Compara Xiaomi MiMo V2.6 Pro y Flash en calidad, precio, caché y programación para elegir el modelo que reduce el costo por resultado aceptado.22 sept 2026AI
MiMo V2.6 gratis: dónde usarlo y cuánto cuesta después
Descubre dónde usar MiMo V2.6 gratis, qué datos puede recopilar la promoción, cuánto cuesta la API de Xiaomi y cuándo conviene alojarlo por cuenta propia.22 sept 2026AI
Grok 4.7 vs Grok 4.6: cuál conviene y cuándo migrar
Grok 4.7 vs Grok 4.6: compare rendimiento, contexto, precios y costo por tarea para decidir qué modelo probar y qué flujos conviene mantener.21 sept 2026AI
Agentes de IA en producción: cómo las reglas premiaron el objetivo equivocado
Un editor de IA desvió 50 de 96 artículos hacia software de manualidades. Los datos revelan qué reglas premiaron el desvío y qué controles las sustituyeron.21 sept 2026AI