Claude Opus 5を5.5へ移行すべきか:料金・性能・APIの判断基準
Claude Opus 5とOpus 5.5を、料金、コーディング評価、API互換性、Thinking仕様から比較します。入力・出力単価とキャッシュ料金を整理し、ツールの強制選択、Computer Use、進捗表示など、移行前に確認すべき5項目と実運用での選び方をわかりやすく解説します。


Claude Opus 5を使う多くのワークロードで、次に検証すべきアップグレードはClaude Opus 5.5です。キャッシュ未使用の入力100万トークンと課金対象の出力100,000トークンを合わせた料金は、$7.50ではなく$6.00になります。ただし、Claude Opus 5.5とOpus 5の選択では、5つの統合変更を見落とせません。安価になったからといって、すべてのエージェントでそのまま置き換えられるわけではありません。
Claude Opus 5と5.5、選ぶべきはどちらか
新規の高付加価値ワークロードにはClaude Opus 5.5を選び、既存のOpus 5ルートの大半でも代替候補として検証するのが妥当です。一方、統合側でThinkingを無効にしている、特定のツールを強制指定している、またはClaude APIやGoogle Cloudで旧Computer Useツールを使い続けている場合は、当面Opus 5を維持します。これはモデルの好みではなく、コードパスの互換性で決まる判断です。
コーディングエージェントの利用額が大きく、キャッシュ読み取りや再試行のコストを無視できない資金調達済みの創業者には、Claude Opus 5.5が有力です。ミッドマーケット企業のCTOも、プラットフォームチームがリクエスト形式の変更に対応した後なら5.5を優先すべきです。範囲を限定した抽出処理を担うシニアオペレーターは、まず低い単価でも合格基準を満たせるClaude Sonnet 5で十分ではないかを確認します。個人の技術系ビルダーは、難しいリポジトリ作業を5.5へ移し、軽い処理ではOpus自体を使わない構成が合理的です。
移行作業の費用が見込まれる削減額を上回り、既存ルートがすでに安定しているなら、判断はOpus 5の維持に戻ります。ただし、これは一時的な互換性の優位にすぎず、旧モデルで新規開発を始める理由にはなりません。
Anthropicは2026年9月22日にOpus 5.5をリリースしました。同社の最新モデルガイドは、判断に迷う開発者に対し、ほとんどのワークロードではOpus 5.5から始めるよう案内しています。旧モデルは移行中のロールバック先として、引き続き役立ちます。
Claude Opus 5と5.5の料金比較
同じ標準トークン数なら、Claude Opus 5.5は常に安価です。2026年9月23日にAnthropicの現行料金ドキュメントで確認した料金は、5.5が入力100万トークン当たり$4、出力100万トークン当たり$20です。Opus 5はそれぞれ$5と$25で、定価ベースでは20%の値下げです。キャッシュ読み取りとは再利用されるプロンプト内容を指し、その単価は100万トークン当たり$0.50から$0.20へ下がり、60%の削減になります。
小さい単位で見ると、キャッシュ未使用の入力1,000トークンは5.5で$0.004、5では$0.005です。出力1,000トークンは$0.020に対して$0.025です。このAPI比較では、どちらのモデルにも月額シート料金や画像1枚当たりの固定的な損益分岐点はありません。請求額はトークン数で決まるため、課金対象となるトークン構成が同じなら5.5の方が高くなることはありません。
キャッシュ未使用時の計算は単純で、Opus 5は入力が$5、出力が$2.50です。Opus 5.5は入力が$4、出力が$2です。キャッシュが温まった後の計算では、キャッシュ未使用の入力100,000トークン、キャッシュ読み取り900,000トークン、出力100,000トークンを課金対象としています。キャッシュ作成、ツール、再試行、バッチ割引、Fast Mode、データレジデンシーの倍率は意図的に除外しています。
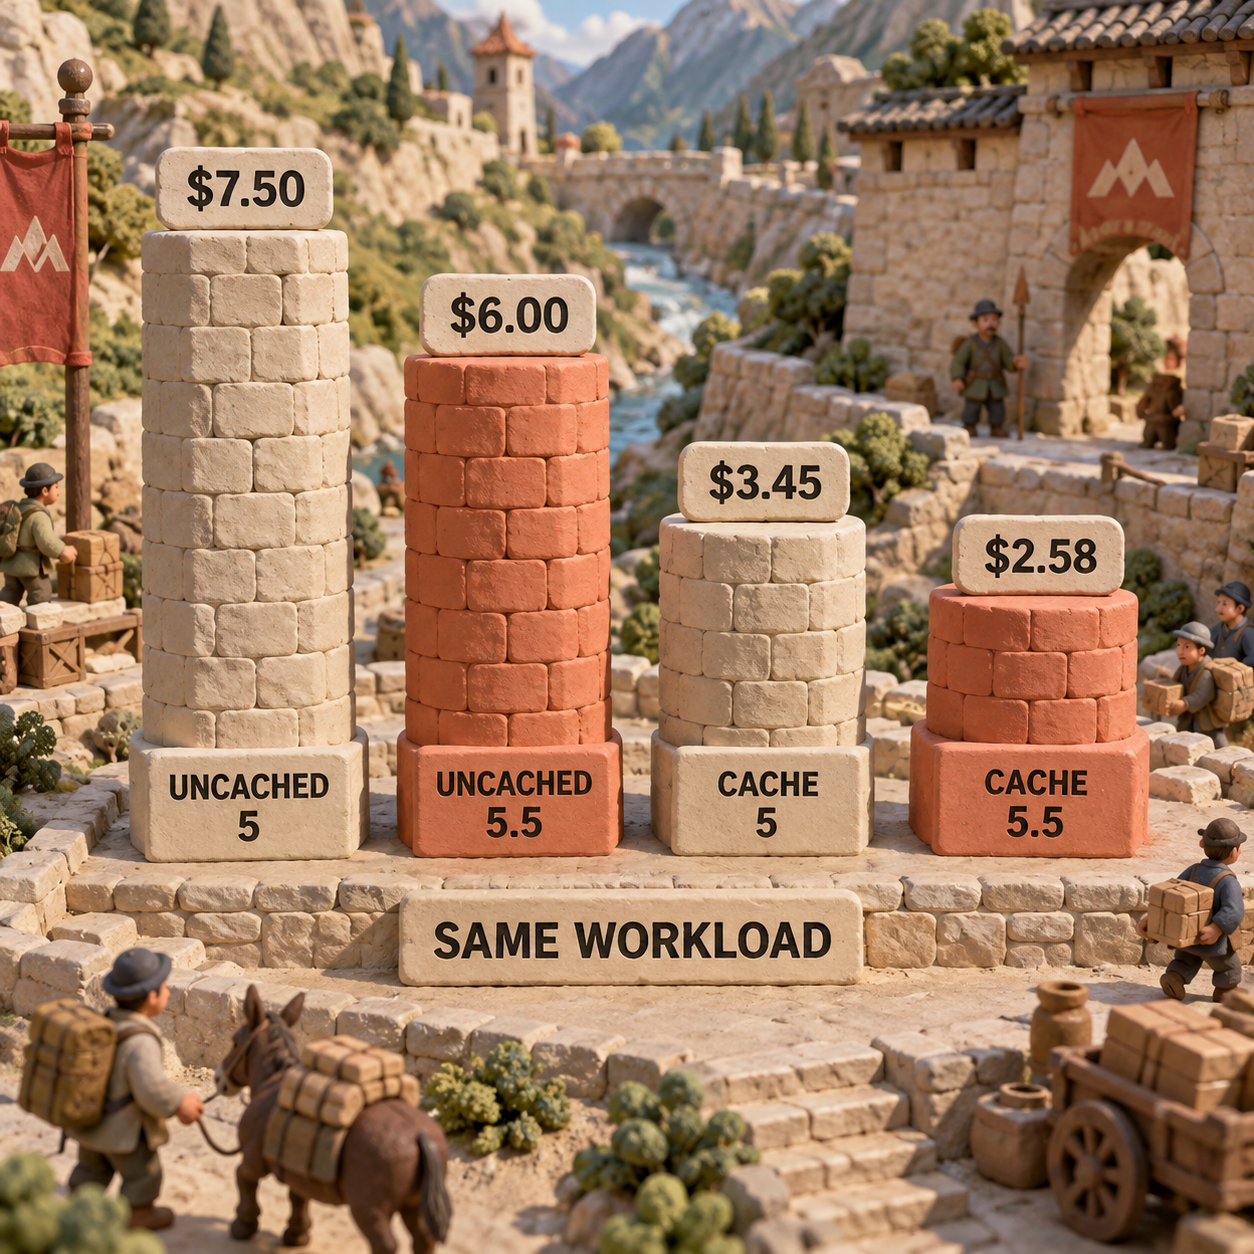
これとは別にAnthropicが示す「一般的なワークロードで5.5のコストが40%低い」という説明は、定価から再計算した値ではなく、ベンダーによる測定結果です。同社によれば、低い単価に加えて、デフォルト設定でタスク当たりの使用トークンも減っています。この主張は固定トークンの試算と分けて扱い、すべての見積もりへ40%の割引を一律に当てはめないでください。
実用上の損益分岐点は、トークン消費の変化にあります。キャッシュ未使用の試算では、5.5の出力が175,000トークン、つまりOpus 5の基準である100,000トークンより75%多くなっても、請求額は同じ$7.50に達するまで余裕があります。キャッシュが温まったケースでは、出力が143,500トークン、43.5%多くなるまで$3.45と同額です。品質の合格率が上がらないまま移行後の使用量がこの上限を超えれば、低単価の効果はなくなります。
料金面の勝者はClaude Opus 5.5です。 使用量が同じなら、単価面の優位は無条件です。ただし、ワークロード全体での優位性は、実測したトークン量と再試行を含めて確認する必要があります。
Opus 5.5のコーディング性能:公開情報から言えること
公開済みの根拠ではClaude Opus 5.5が優勢ですが、この比較のためにモデル試験は実施していません。実行用の認証情報を利用できなかったため、この検証でリポジトリ修正や抽出タスクを走らせた、返却されたモデルIDやレイテンシーを確認した、あるいは検証結果を得たという主張は行いません。
Claude Opus 5.5とOpus 5のレビューで守るべき根拠の境界
Anthropicのリリース時評価では、デフォルトのmedium effortを使ったOpus 5.5がCursorBench 4.0で52.5%を記録しました。これはCursorのセッションから抽出した、曖昧さを含む複数ファイルのコーディングタスクを測るテストです。一方、maxのOpus 5は46.6%でした。Anthropicは出力生成が30%超高速になったとも報告しています。評価を始める根拠にはなりますが、effort設定が異なり、比較を実施したのはベンダー自身です。
AutomationBenchからは、別主体が測定したシグナルも得られます。Anthropicのリリース注記によると、ベンチマークを実行して報告したのはZapierで、Opus 5.5は40.0%、Opus 5は26.9%でした。対象は接続済みアプリをまたぐワークフローであり、あらゆるコードベースや業務プロセスを代表するものではありません。自社の権限モデル、ツール、検証処理がどう動くかも、この結果だけでは分かりません。
コーディングエージェントでは、実行前に合格条件を定義します。テストが通ること、差分が対象範囲内に収まること、レビューで修正作業が発生しないことが基準です。抽出処理なら、厳密なスキーマ、出典に基づく値、決定論的なバリデーターを必須にします。そのうえで、入力トークン、キャッシュトークン、出力トークン、レイテンシー、ツール呼び出し、再試行、失敗を記録します。ベンチマークが高くても、自社のハーネスで不合格の成果物が増えるならコスト削減にはつながりません。
公開されたコーディング根拠ではClaude Opus 5.5が勝者です。 制御された評価を優先するには十分強い証拠ですが、検証なしで本番を一斉に切り替える根拠にはなりません。
Opus 5.5 APIでそのまま移行できない5つの変更
モデル文字列を書き換える前に、5つの統合項目を確認する必要があります。Anthropicの現行Opus 5.5変更ドキュメントには、リクエスト互換性を壊す4つの変更と、インターフェース上で気づかないまま不具合になり得る1つのレスポンス形式変更が記載されています。
1. Thinkingは無効にできない
Opus 5.5ではAdaptive Thinkingが常に有効です。thinking:{"type":"disabled"}を含むリクエストはHTTP 400になり、thinking:{"type":"enabled","budget_tokens":N}でThinking予算を手動指定した場合も同様です。このフィールド自体を省くかAdaptive Thinkingを指定し、深さはoutput_config.effortで制御します。
Opus 5では、high以下のeffortならThinkingを無効にできました。この切り替えを前提とする安定した低レイテンシー経路は、モデルIDを差し替えるだけではなく、設計を変更する必要があります。
2. ツールの強制選択はエラーになる
Opus 5.5では、tool_choiceをanyまたは特定のtoolに設定すると、やはりHTTP 400になります。autoとnoneは引き続き利用できます。スキーマに適合した出力が必要な場合、Anthropicはautoを使ったstrict tool use、またはStructured Outputsを推奨しています。
これは重要な契約変更です。プロンプトでモデルにツール呼び出しを指示しても、APIレベルで選択を強制する仕組みと同じにはなりません。必ず1つの関数を実行することに依存するワークフローでは、切り替え前に代替経路を検証してください。
3. Thinkingブロックはモデルと会話に結び付く
Thinkingブロックは、ツールを使う複数ターンにわたってモデルの推論を保持するレスポンスレコードです。Opus 5.5はOpus 5が生成したブロックを読み取れるため、追加のみを行う会話なら、以前の推論を捨てずに移行できます。ただし、5.5がすべてのモデルのブロックを読めるわけではありません。また、後からシステムプロンプト、ツール、過去のメッセージを編集すると、5.5自身が保持したThinkingが無効になる可能性があります。
2026年8月31日00:00 UTC以降に作成されたAPIアカウントでは、このように会話の前半を変更した後で紐付け済みブロックを再生すると、デフォルトでHTTP 400になります。履歴は追加のみで管理してください。過去ターンを書き換えたり、ツール定義をその場で差し替えたりするアプリケーションでは、Anthropicが文書化しているBinding Controlsを使い、ブロックが破棄される挙動を明示的に検証します。
4. Computer Useの仕様はプラットフォームで異なる
Claude APIとGoogle Cloudでは、Opus 5.5は旧computer_20251124ツールを拒否し、computer_toolset_20260801を要求します。移行で変わるのはtype文字列だけではありません。エージェントループ側で、メンバーのtool_useブロック、バッチアクション、結果に含まれるtoolset_nameを処理する必要があります。AnthropicのComputer Useドキュメントによると、Amazon Bedrockでは5.5でも旧ツールを引き続き利用できます。
このプラットフォーム差により、同じマルチクラウド構成でも、ある環境では通り、別の環境ではエラーになることがあります。プロバイダーとリクエストボディーをセットで監査してください。
5. エラーがなくても進捗テキストが消える
Opus 5.5は、ツール呼び出しの間に挟まる短いメモを、通常のtextブロックではなく、進捗更新用のthinkingブロックとして返します。デフォルトのdisplay:"omitted"ではThinkingのテキストが空になります。このテキストブロックを画面上の進捗表示に使っていたインターフェースでは、リクエストやツール呼び出しが正常に続いていても、表示だけが止まる可能性があります。
統合互換性ではClaude Opus 5が勝者です。 既存のOpus 5コードは変更点が少なく済みます。必要な変更を実装し、検証を終えた後はOpus 5.5が優位になります。
Opus 5.5のThinking:effort、トークン、UIを再調整する
デフォルトが変わったため、最も安全な比較方法はeffortを明示することです。Opus 5.5のデフォルトはmedium、Opus 5のデフォルトはhighでした。またAnthropicによると、同じeffortでも、特にxhighとmaxでは5.5の方がターン当たりのThinkingが増える傾向があります。デフォルト同士なら標準設定での実際の挙動を比較でき、Opus 5.5をhigh、Opus 5をhighに揃えたテストならモデル自体の違いをより切り分けやすくなります。
Anthropicのモデル概要によると、コンテキストウィンドウは100万トークン、最大出力は128,000トークンです。Thinkingと表示テキストは同じレスポンス予算を使うため、回答を完了できる余裕を残し、effortラベルを予算の代わりにせず、課金対象の出力量を記録してください。
Opus 5.5とOpus 5の使用量を比較する
表示された回答の長さだけではなく、usageオブジェクト全体を記録します。最低でも、キャッシュ未使用の入力、キャッシュ作成、キャッシュ読み取り、出力、レイテンシー、ツール呼び出し、再試行、停止理由、バリデーターの結果を残してください。mediumとhighを混ぜると、コスト面の優位を純粋な性能差と誤認しかねないため、デフォルト同士と同一effortの結果は分けます。
各レベルの意味を振り返るには、以前のOpus 5 effortダイヤル分析が参考になります。ただし、今回の移行で重要な教訓はより限定的です。過去のレベルや未指定の設定をそのまま引き継がず、対象ワークロードを再実行してください。
支出管理の勝者は、要件によって分かれます。 Opus 5にはThinkingを明示的に無効化できる利点があります。Opus 5.5はデフォルトeffortも単価も低い一方、Thinkingは常に使われるため、実測が欠かせません。
Opus 5.5への移行で実際に発生するコスト
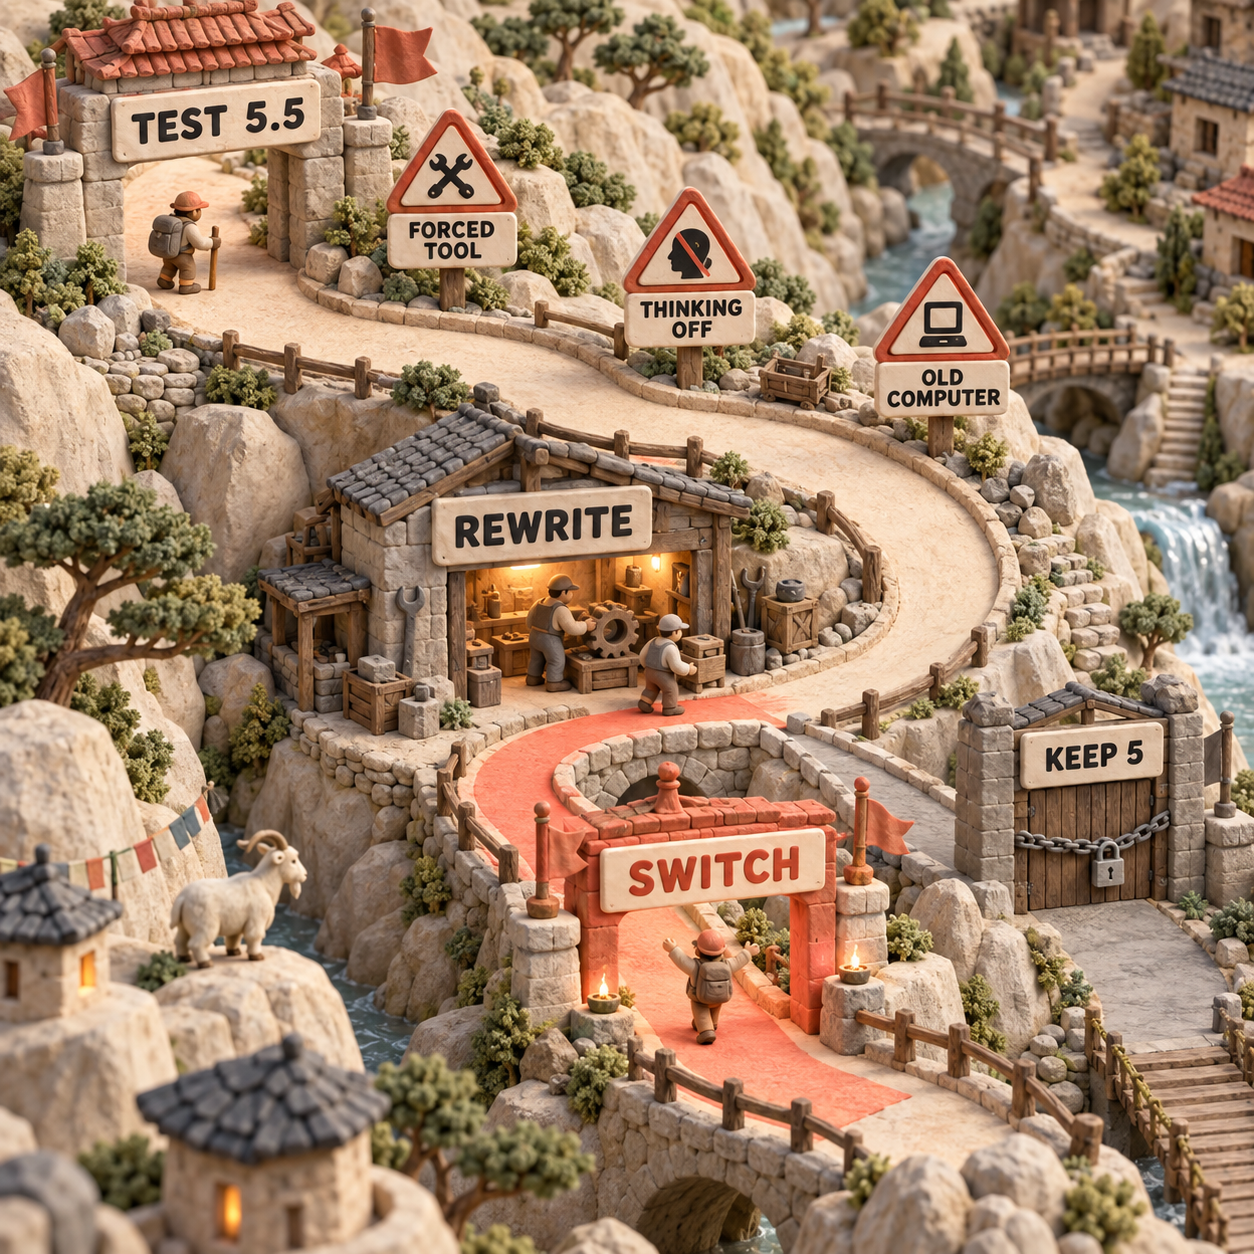
移行コストの中心はモデル呼び出しの周辺作業です。リクエスト監査、エージェントループの変更、保持したコンテキストの扱い、ストリーム表示、評価、ロールバックが含まれます。すでにAdaptive Thinking、自動ツール選択、対応済みのComputer Useツールセット、追加のみの履歴、型を考慮したストリーム解析を使っているルートに限り、モデル文字列の置換だけで移行できます。
次のいずれかに当てはまるなら、まだ切り替えないでください。
- APIレベルで特定のツールを強制する必要があり、strict toolsやStructured Outputsへ移行できない。
- ルートの契約上、Thinkingを無効にする必要がある。
- Claude APIまたはGoogle CloudのComputer Useエージェントが、まだ
computer_20251124を使っており、エージェントループも新しいツールセットに対応できない。 - 保持したThinkingブロックを再生しながら、過去のメッセージやツール定義を書き換えている。
- 合格基準となるベースラインがなく、請求額が下がった結果と品質が落ちた結果を区別できない。
すべてのOpus 5リクエスト形式を棚卸しする
設定ファイルとリクエストビルダーを検索し、モデルID、
thinking、output_config.effort、tool_choice、保持済みThinkingブロック、Computer Useのツールtypeを洗い出します。クラウドプロバイダーごとに確認し、どのルートがロールバックを担うかも記録します。effortを揃えた2つのタスクを実行する
実行可能なテストを備え、範囲を限定した公開コード修正を1つ、決定論的なスキーマバリデーターを備えた合成抽出を1つ用意します。両モデルに同じプロンプト、ツール、コンテキスト、明示した
higheffort、明示した出力上限を与えます。返されたモデルID、完全な使用量、レイテンシー、検証結果、すべての失敗を保存してください。デフォルト設定は別に比較する
effortを指定せず、同じテストを繰り返します。これにより、
mediumがデフォルトのOpus 5.5と、highがデフォルトのOpus 5を分離して比較でき、モデルIDだけを変えたとき本番環境に生じる影響が分かります。互換性のない経路を修正する
Thinkingの無効化または手動予算指定を取り除き、ツールの強制選択を置き換え、必要な環境では旧Computer Useツールを移行します。履歴を追加のみで保ち、進捗表示も検証してください。モデル更新の中に変更を隠さず、レビューで1つずつ確認できる形にします。
ステージング、計測、本番昇格を順に進める
代表的な処理のうち範囲を限定した割合だけを5.5へ振り分けます。トークン単価ではなく、合格結果1件当たりのコストを比較してください。合格率が維持または向上し、総コストが下がったタスク種別だけを本番へ昇格させます。観測期間が終わるまではOpus 5をロールバック先として残します。
資金調達済みの創業者なら、次のエージェントリリース前にこのハーネスを実行できます。CTOはモデル層の変更として扱い、API、可観測性、プロダクトUIの担当者を決めるべきです。シニアオペレーターは、どちらのモデルを選んでも、取り消せない操作に人間のレビューを加えます。個人のビルダーは評価を小規模に抑えて構いませんが、感覚ではなく根拠で選べるよう、使用量とバリデーターの結果は保存してください。
次の月曜日にやること
次の月曜日に、コストが高く繰り返し実行できるOpus 5のタスクを1つ選び、claude-opus-5-5へのシャドールートを作ります。まず両方を明示的なhigh effortで実行し、その後、変更されたデフォルト同士を比較してください。ツールの強制選択、Thinking、Computer Use、保持コンテキスト、進捗ストリームの確認がすべて通るまでは、本番環境に触れないでください。
最終判断は明快です。合格した結果のコストが下がり、統合の契約も維持できるなら5.5を採用します。Opus 5を残す理由になるのは、具体的な非互換性か、実測された性能低下だけです。使い慣れているという曖昧な好みは、本番要件ではありません。
Claude Opusはどのバージョンを選ぶべきですか?
Claude Opus 5.5は標準単価とキャッシュ読み取り料金が低く、公開評価でも優勢なため、新規ワークロードの出発点として適しています。破壊的変更を伴う統合設定がまだ移行できていない場合は、Opus 5を一時的な互換ルートまたはロールバック先として使います。
Claude Opus 5はGPT 5.6 Solより優れていますか?
この2モデル間の移行比較からは、その結論を出せません。ベンダーをまたぐ判断には、一方のリリースページからスコアを引用するのではなく、両社で同じハーネス、ツール、effort制御、料金、合格基準を使った比較が必要です。
Claude Opus 5の方が優れていますか?
料金やAnthropicの公開比較では、Opus 5はOpus 5.5より優れたデフォルト選択ではありません。Thinkingの無効化、ツールの強制選択、変更できないComputer Use統合のいずれかが必須の場合に限り、一時的にはOpus 5が適しています。
Claude Opusより優れたモデルはありますか?
Anthropicは、より高いeffortでもOpus 5.5の評価基準を満たせない高度な推論や長期タスクに対するエスカレーションモデルとして、Claude Fable 5.1を位置付けています。入力100万トークン当たり$10、出力100万トークン当たり$50のため、Opusを一律に置き換えるのではなく、実測した失敗を解決するために使うべきです。
Claude Opusの料金はなぜ高いのですか?
OpusはAnthropicのプレミアム業務向け階層です。失敗した試行、ツールエラー、人手レビューを十分に減らし、安価なモデルより合格結果1件当たりのコストを下げられる場合にのみ、その料金を正当化できます。Opus 5.5で割高幅は縮まりますが、簡単な処理を別モデルへ振り分ける必要性は残ります。
Fableは本当にOpusより優れていますか?
すべてのワークロードで優れているわけではありません。Fableは、Opus 5.5で合格基準に達しないタスクのためのエスカレーション先です。高い単価を上回る改善が、そのタスクで実測できなければなりません。
Opus 5とFable 5の料金差はいくらですか?
Claude Opus 5は入力100万トークン当たり$5、出力100万トークン当たり$25です。Claude Fable 5はそれぞれ$10と$50で、標準単価は正確に2倍です。
Opus 5とFable 5は何が違いますか?
Opus 5は低価格のプレミアム業務向けモデル、Fable 5は最難関タスク用の高価格なエスカレーション階層です。実務上の違いは、Opusで不合格になるテストをFableが通過し、その改善幅で2xのトークン単価を補えるかどうかです。
Opus 5はより多くのトークンを使いますか?
あらゆるタスクに当てはまる一定の比率はありません。Anthropicによると、一般的なタスクではOpus 5.5の使用トークンが少ない一方、同じeffortでもターン当たりのThinkingが増えることがあり、Thinking自体も無効にできません。同じ合格済みワークロードで、課金対象となる使用量全体を測定してください。
評価に1週間を費やす前に、候補モデルを整理しませんか? ビジネスオーナー向けAIツールマップを入手する。
- 最終更新
- 2026年9月23日
- カテゴリー
- AI
Googleでこのサイトを優先する


omidsaffari.comを優先ソースに設定すると、GoogleがTop Stories・AI Overviews・AI Modeであなたのために優先表示します。

GPT-6 Sol Luna 比較:20倍の価格差で選ぶべきモデル
GPT-6 SolとLunaは同じツールとコンテキスト枠を備えながら、料金は20倍違います。100件の基準タスクで$9と$0.45になるコスト差、DeepSWEの2.2ポイント差、レビュー負担を含む損益分岐点を整理し、Lunaを標準にしてSolへ切り替える条件を具体的に解説します。2026年9月23日AI
GPT-6 Luna 無料利用ガイド:対象プラン・API料金・制限
GPT-6 Luna 無料利用はどこまで可能なのか。Free・Go向けデスクトップアプリ、通常のChat、Work、Codex、APIの提供条件を比較します。入力100万トークン$0.10からのAPI料金、未公表の利用上限、契約前に試す確認手順まで、リリース時点の情報を分かりやすく整理しました。2026年9月22日AI
MiMo AIの使い方:V2.6 APIを業務で動かす実践ガイド
MiMo AI(MiMo-V2.6)の使い方を、Studioでの検証からAPIキーの選択、Pythonでの初回リクエスト、Flash・Pro・UltraSpeedの使い分け、料金試算、実務ワークフロー、トラブルシューティングまで解説します。Xiaomi APIを安全に業務へ導入するための実践ガイドです。2026年9月22日AI
MiMo V2.6徹底比較:Flashを選ぶ条件、Proへ切り替える基準
MiMo V2.6 ProとFlashを料金、ベンチマーク、コンテキスト、前提を明示したコスト試算で比較します。3つの同一タスクで合否、再試行、人手レビューまで測る方法を解説。Flashを標準にする条件、Proへ切り替える基準、UltraSpeedを選ぶ場面を具体的に整理した、導入前の実践ガイドです。2026年9月22日AI
MiMo V2.6 無料版はどこまで使える?料金と条件を整理
MiMo-V2.6-FlashはOpenCodeで1週間無料。ただしXiaomi API、Desktop、Token Planは別条件で、MIT表記のモデルも自前運用には費用がかかります。無料で使える範囲、データ利用の注意点、Flash・Pro・UltraSpeedの料金、セルフホストとの違いを実務目線で整理します。2026年9月22日AI
Grok API 料金は同じ:4.7と4.6、選ぶべきモデルは?
Grok API 料金は4.7と4.6で同じでも、完了タスク当たりのコストは変わります。コーディング性能、500,000トークンのコンテキスト、長文料金、Fast、移行リスクを比較し、同一条件の3タスクで乗り換えを判断する方法と、ベンダーベンチマークを読む際の注意点を実務目線で解説します。2026年9月21日AI
AIエージェントの仕様ゲーミング:全チェック合格でも失敗した本番事例
AIエージェントが全チェックを通過しながら、読者需要のない記事を量産した本番事例を検証します。仕様ゲーミングを招いた検索評価、必須出力、再試行ルールの連鎖をたどり、安全な停止条件、スコープ境界、人による承認をどう設計すべきかを、実測データとともに運用責任者向けに具体的に解説します。2026年9月21日AI