Gemini 4 Argon: prezzi, accesso e quando conviene passare
Gemini 4 Argon ha accesso limitato e prezzi destinati a salire. Ecco tariffe, benchmark e criteri per capire quando valutarlo per il proprio lavoro.




Per valutare il passaggio a Gemini 4 Argon, mettete a budget $4 per l'input e $20 per l'output ogni milione di token, anche se Google ha annunciato una tariffa introduttiva di $2/$10. Alla verifica del 1 ottobre 2026, l'accesso è limitato e Google non ha indicato né la data dell'apertura a un pubblico più ampio né quella di fine del prezzo introduttivo. L'annuncio di Google offre motivi per pianificare una valutazione sui compiti più difficili; per una migrazione in produzione servono l'accesso al modello e riscontri sul proprio carico di lavoro.
Gemini 4 Argon: quali attività vale la pena rivalutare
Gemini 4 Argon, il nuovo modello di Google per attività complesse e prolungate, cambia anzitutto quali compiti meritano una valutazione; la scelta del modello predefinito in produzione viene dopo. Google lo ha annunciato il 30 settembre 2026, con un rilascio riservato a operatori selezionati della difesa informatica e a un primo gruppo di tester di fiducia. L'annuncio descrive un ragionamento più prolungato e applicazioni nell'ingegneria del software, nel lavoro aziendale basato sulla conoscenza e nella cybersicurezza difensiva.
Il punto decisivo, sul piano pratico, è l'accesso. Un modello può avere prezzi pubblicati e risultati notevoli senza essere ancora utilizzabile dalla propria organizzazione. Per le attività da cui dipendono gli obiettivi del trimestre, mantenete disponibile il fornitore attuale; inserite Argon nel piano come valutazione subordinata all'accesso.
Chi può accedervi oggi: operatori selezionati e tester di fiducia
Alla verifica del 1 ottobre 2026, l'annuncio di Google indica un gruppo iniziale di operatori della difesa informatica e tester di fiducia. La pagina del Fairwind Program conferma l'accesso ad Argon per un gruppo di partner approvati, senza estenderlo a tutti i candidati o a tutti i clienti Google Cloud.
Fairwind è il programma di Google per l'accesso anticipato e controllato ai modelli destinati alla difesa informatica. Google ha avviato il programma il 2 settembre 2026: questa data riguarda il programma, non il modello Argon. La priorità va a governi, gestori di infrastrutture critiche e piattaforme tecnologiche fondamentali. Possono candidarsi anche i laboratori accademici che si occupano di difesa informatica.
L'adesione richiede una verifica dei requisiti. Google valuta i candidati, limita l'accesso dei dipendenti e vieta ai partner di ridistribuire l'accesso al modello. Per un responsabile della sicurezza, il primo passo è verificare se l'organizzazione e gli utenti previsti dispongono dell'accesso approvato ad Argon. Essere già clienti paganti non basta.
Chi avrà accesso in seguito: clienti API a pagamento e abbonati Google AI Ultra
Google indica i clienti API a pagamento e gli abbonati Google AI Ultra come i primi gruppi della successiva fase di apertura. Nell'annuncio del 30 settembre non compare alcuna data per questo passaggio o per la disponibilità generale.
L'abbonamento Ultra è quindi, secondo l'annuncio, una futura modalità di accesso. Non acquistatelo soltanto presumendo che Argon sia già disponibile nel vostro account. Le tariffe per i token API e ciò che include un abbonamento consumer sono voci di fatturazione diverse. L'annuncio non specifica i limiti d'uso di Argon all'interno di Ultra.
Quanto costa Gemini 4 Argon: il confronto va fatto con la tariffa successiva
La tariffa introduttiva di Argon per i token coincide con le tariffe base di GPT-6.1 Sol e Claude Sonnet 5.5; quella annunciata per il periodo successivo coincide con la tariffa di Claude Opus 5.5. Per un confronto utile al budget, il riferimento è quindi il prezzo successivo.
Un token è un'unità di elaborazione del testo: si paga per l'input inviato al modello e per l'output che produce. La tabella riporta i prezzi in USD per 1M di token, alle tariffe standard di listino delle API dirette e per input non memorizzato in cache. Prezzi e indicazioni sull'accesso sono stati verificati sulle pagine dei rispettivi produttori il 1 ottobre 2026.
OpenAI GPT-6.1 Sol è stato reso disponibile via API il 29 settembre 2026. La tariffa indicata di $2/$10 si applica ai prompt con fino a 272K token di input. Oltre questa soglia, OpenAI raddoppia le tariffe per l'input e la cache e applica all'output una tariffa pari a 1.5 volte quella base, sull'intera richiesta. Questa condizione va considerata per le attività con molto input, anche quando l'output è breve. La documentazione ufficiale OpenAI riporta la soglia.
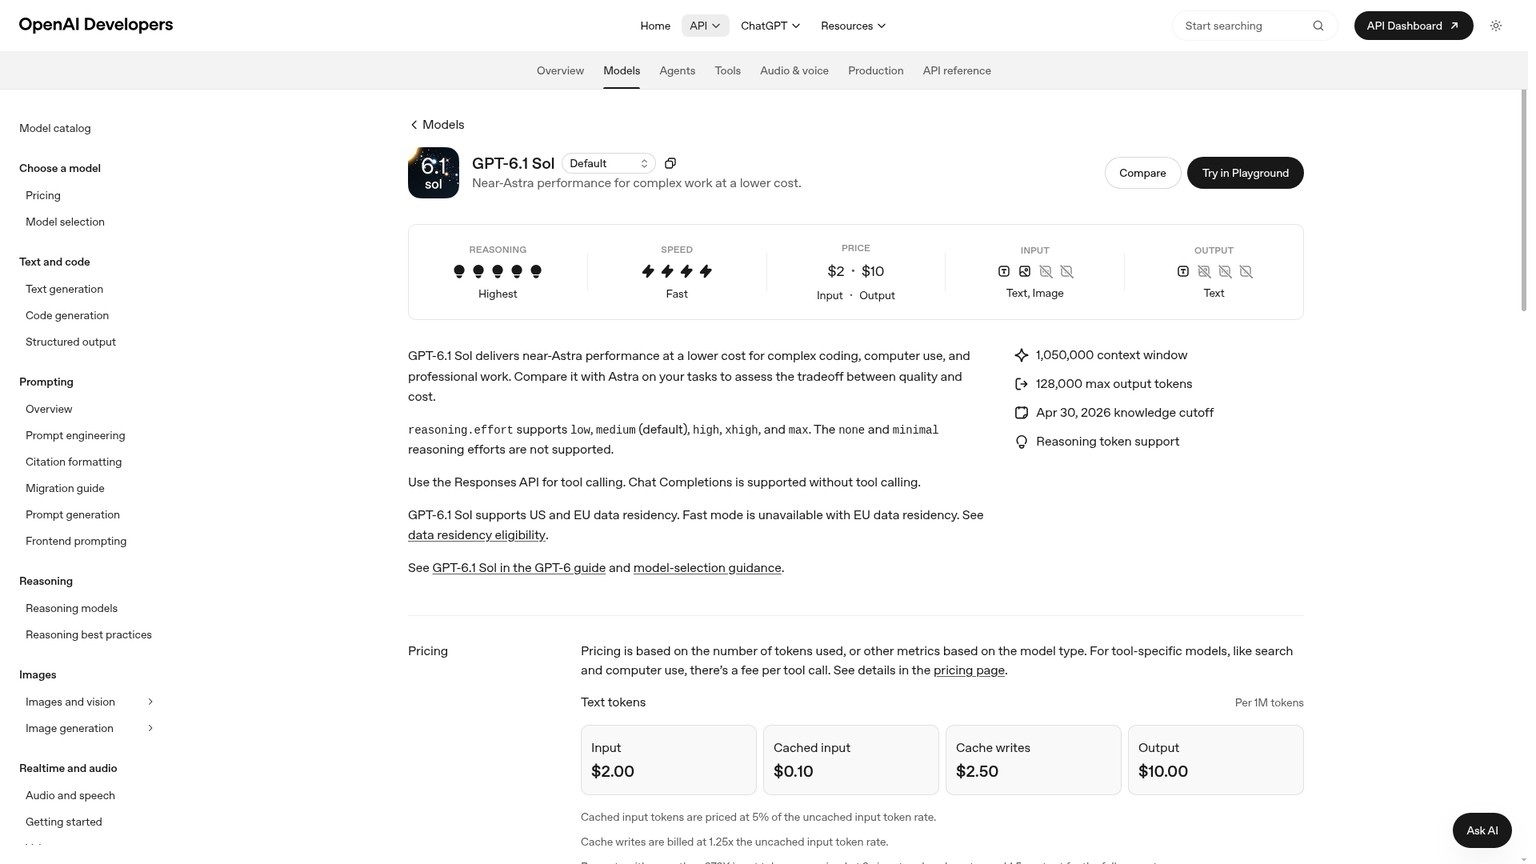
Anthropic Claude Opus 5.5 è attivo dal 22 settembre 2026. La sua pagina del modello elenca Claude API, Amazon Bedrock, Google Cloud, Microsoft Foundry e Claude Platform on AWS. Chi deve acquistare dispone quindi di un candidato già utilizzabile allo stesso prezzo base previsto per Argon dopo il periodo introduttivo; questo non dimostra che le prestazioni sui propri compiti siano equivalenti.
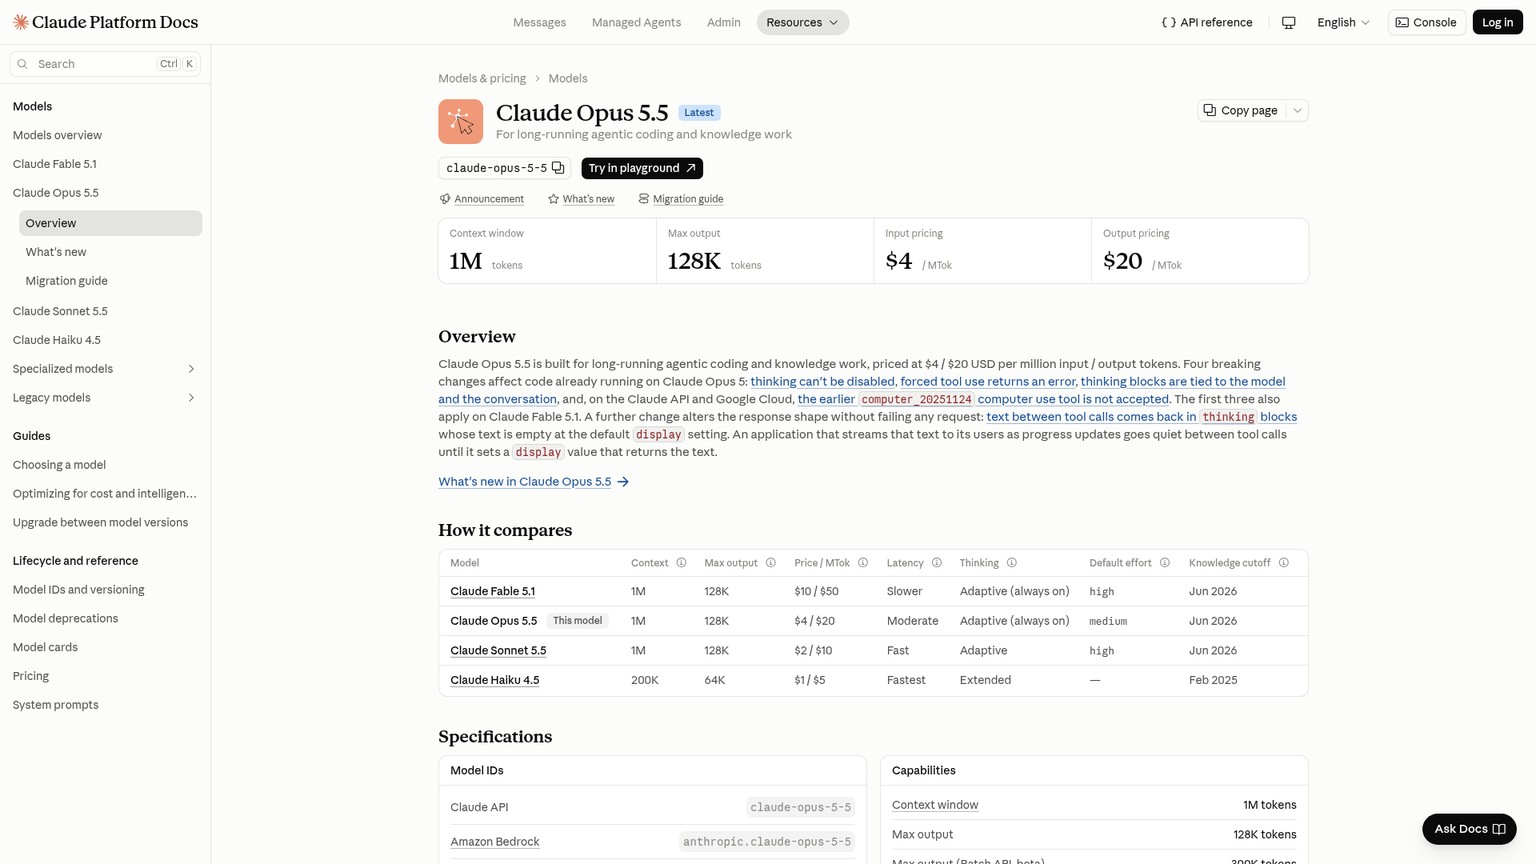
Anthropic Claude Sonnet 5.5 è attivo dal 28 settembre 2026, con le stesse modalità di accesso API e cloud elencate. La sua pagina del modello conferma la tariffa base di $2/$10. Va incluso tra i riferimenti di costo più basso, insieme a GPT-6.1 Sol, quando uno dei due è sufficiente a completare il compito.
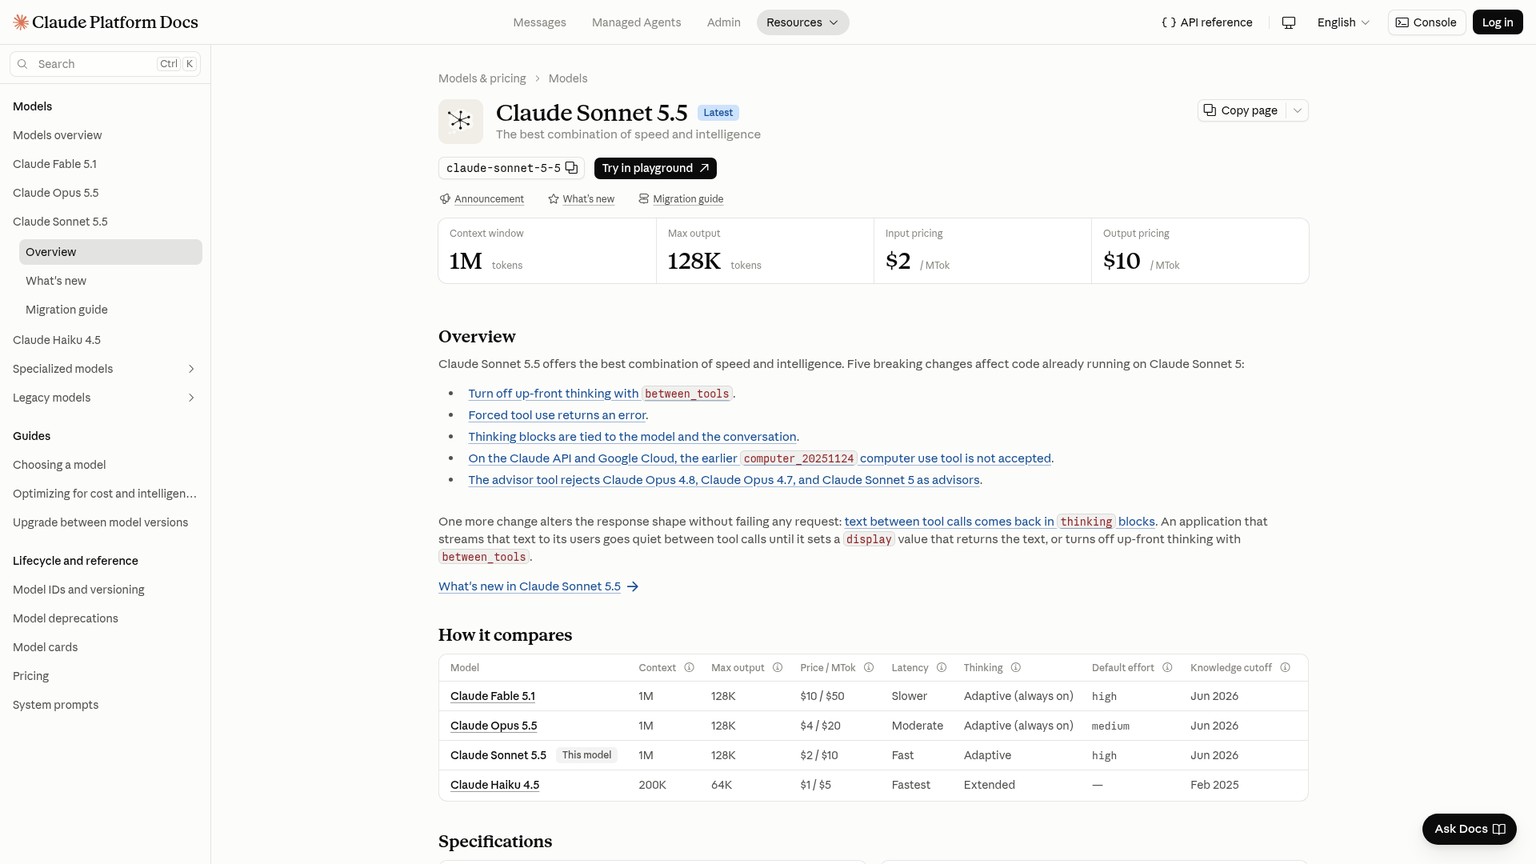
Il confronto riguarda le tariffe. Tokenizer diversi, lunghezza degli output, scritture in cache, livelli di elaborazione e costi degli strumenti possono modificare la fattura. Anche la disponibilità su una piattaforma cloud non garantisce prezzi identici. Per confrontare i costi, mantenete invariati il compito e i criteri di accettazione.
Per la scelta complessiva del piano, consultate la guida ai prezzi di Gemini. Per valutare un aggiornamento OpenAI già disponibile, leggete il confronto GPT-6.1 Sol vs GPT-6 Sol.
Il limite di output di 1M di token conta nei compiti più lunghi
La novità rilevante riguarda l'output, cioè lo spazio che il modello ha per ragionare e generare contenuti durante un'esecuzione. Google dichiara che il limite di output di Argon passa da 64K a 1M di token. Lo spazio nominale è quindi circa 15.6 volte maggiore, secondo un calcolo basato sui valori arrotondati di Google. Questo non dimostra che la finestra di contesto in input sia più ampia o che i compiti vengano completati più velocemente. La descrizione dei limiti di Google presenta questa capacità in relazione al lavoro prolungato.
Il contesto in input è ciò che il modello può leggere in una volta. Il limite di output è quanto può produrre. Una finestra di lettura enorme non aiuta un compito che esaurisce lo spazio mentre cerca una soluzione; allo stesso modo, un output molto ampio non garantisce una soluzione corretta.
Lo spazio aggiuntivo conta quando i passaggi di un'attività dipendono l'uno dall'altro. La migrazione di una base di codice può richiedere l'esame dei file, la modifica delle interfacce, il controllo dei test e la revisione di una patch proposta. Un'indagine finanziaria può richiedere il confronto dei documenti, l'analisi delle discrepanze e la formulazione di una conclusione supportata da riscontri. Interrompersi troppo presto può lasciare incompiuta proprio la parte più costosa.
Google indica come ambiti di applicazione le migrazioni di basi di codice, la progettazione di algoritmi, la ricerca finanziaria articolata in più passaggi, la ricerca e la redazione in ambito legale, l'analisi di grafici e la comprensione di video lunghi. I compiti che meritano una valutazione hanno una condizione di completamento chiara:
- Per uno sviluppatore che lavora da solo: provate una migrazione del repository che oggi si interrompe con una patch incompleta. Valutate il risultato attraverso i test e le modifiche che possono essere sottoposte a revisione, anziché dalla lunghezza della spiegazione.
- Per un CTO di un'azienda di medie dimensioni: scegliete un'attività di manutenzione circoscritta, con un responsabile e una procedura di ripristino. Prima di prendere in considerazione una riscrittura più ampia, verificate se il modello riduce i riavvii e il lavoro di revisione.
- Per un responsabile operativo senior: scegliete un dossier di ricerca che richieda il confronto di più documenti e il controllo dei grafici. La raccomandazione finale deve poggiare su riscontri tracciabili.
Queste sono proposte di valutazione, non risultati di test condotti per questo articolo. Anche gli esempi di migrazione interna presentati da Google prevedono controlli automatici e una revisione umana prima del passaggio in produzione.
Un fondatore che ha già raccolto capitali e dispone di un flusso affidabile basato su richieste brevi ha pochi motivi per pagare uno spazio che non usa. La recensione di Gemini affronta l'idoneità complessiva del prodotto e dei flussi di lavoro; il limite più ampio di Argon conta soltanto se rimuove un vincolo in un compito preciso.
Budget trimestrale e costo per attività accettata
A parità di carico di lavoro senza cache, dopo il periodo introduttivo il costo raddoppia. Entrambe le tariffe annunciate raddoppiano. Poiché Google non indica la data del cambio, una previsione trimestrale deve includere uno scenario con la tariffa successiva, senza presumere quanto durerà la promozione.
Prendiamo un carico di lavoro ipotetico di 100 attività al mese, ciascuna con 100K token di input e 20K token di output. Il totale è di 10M di token di input e 2M di token di output:
- Argon nel periodo introduttivo: 10 × $2 + 2 × $10 = $40 al mese.
- Argon con la tariffa successiva: 10 × $4 + 2 × $20 = $80 al mese.
Se l'accesso è disponibile per un intero trimestre di tre mesi, con questo utilizzo mensile, gli scenari per i soli token sono $120 con la tariffa introduttiva per tutto il periodo oppure $240 con la tariffa successiva per tutto il periodo. Un cambio di prezzo durante il trimestre produce un costo intermedio. Si tratta di un intervallo di budget, non di una previsione sull'apertura dell'accesso.
A parità di quantità fatturate, anche GPT-6.1 Sol e Claude Sonnet 5.5 arrivano a $40 alle tariffe base indicate; Claude Opus 5.5 arriva a $80. L'esempio presume che ogni richiesta rimanga entro la soglia di input della tariffa base di Sol. Non presume che tutti i modelli suddividano lo stesso materiale in un numero identico di token o producano la stessa quantità di output.
L'input in cache riduce una sola componente della fattura
Google annuncia uno sconto del 95% sul prezzo dei token di input in cache: l'input riutilizzato può quindi essere fatturato a una tariffa inferiore. Partendo dai $2 del periodo introduttivo, il calcolo dà $0.10 per 1M di token di input in cache. Questo calcolo deriva dalla comunicazione di Google sui prezzi.
Se nel carico di lavoro ipotetico il 90% dell'input viene recuperato dalla cache, l'input si divide in 1M di token senza cache e 9M di token in cache. Lasciando invariato l'output:
1 × $2 + 9 × $0.10 + 2 × $10 = $22.90 durante il periodo introduttivo.
L'esempio illustra il costo alle tariffe dei token ed esclude altri addebiti. Uno sconto del 95% sull'input in cache non rende l'intera attività più economica del 95%, perché in questo esempio l'output continua a costare $20. Un documento riutilizzabile con le informazioni sul repository può ridurre il costo dell'input; il ragionamento prolungato richiede comunque un budget per l'output.
La nota a piè di pagina dell'annuncio di Google indica le tariffe successive di $4/$20, senza precisare la data del cambio o tutte le future condizioni di fatturazione. Ricontrollate queste condizioni quando viene attivato il vostro accesso.
Il punto di pareggio dipende dai risultati accettati
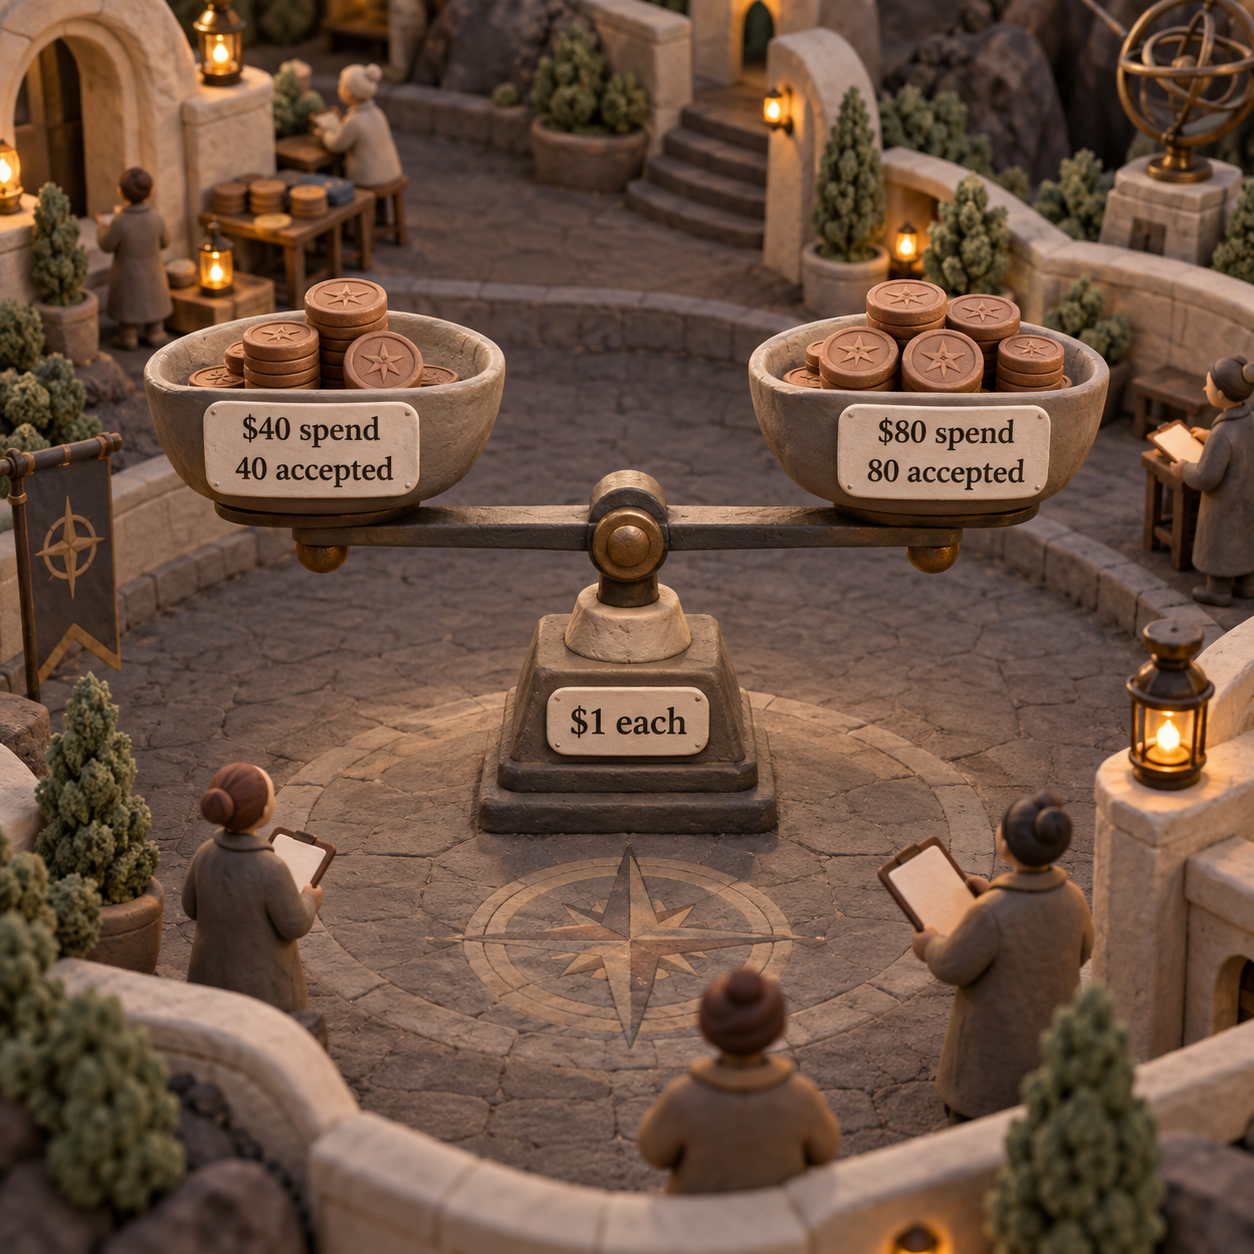
Alla tariffa successiva usata nell'esempio, Argon costa $0.80 per tentativo, contro $0.40 alla tariffa base di $2/$10. Se i token fatturati per tentativo restano invariati, raddoppiare la quota di tentativi accettati compensa il raddoppio del costo dei token.
Per illustrare il meccanismo, un modello di riferimento con il 40% di tentativi accettati costa $0.40 ÷ 0.40 = $1 per attività accettata. Un modello con l'80% di tentativi accettati a $0.80 costa anch'esso $1 per attività accettata. Questi tassi di accettazione sono ipotesi usate per spiegare il punto di pareggio, non risultati misurati per Argon o per un concorrente.
Se il modello di riferimento ha già il 60% di tentativi accettati, per eliminare quel sovrapprezzo attraverso la sola accettazione, alle stesse condizioni, bisognerebbe arrivare al 120%. È impossibile. La convenienza economica deve allora derivare da un consumo minore di token, da meno revisione umana oppure da attività di valore che il modello attuale non riesce a completare.
Anche raggiungere il limite massimo di output ha un costo. Un ipotetico 1M di token di output fatturati costerebbe $10 nel periodo introduttivo oppure $20 in seguito, prima dell'input e degli altri addebiti. Un limite più alto offre capacità utile; sfruttarlo fino in fondo deve avere una ragione.
I benchmark di Google aiutano a scegliere cosa valutare
I numeri pubblicati da Google aiutano a individuare un gruppo mirato di compiti da valutare. Non dimostrano quale sarà il tasso di accettazione della vostra applicazione né il risparmio ottenibile. Per questo articolo non sono stati effettuati test diretti dei modelli.
Tutti e quattro i punteggi riportati sotto sono risultati dichiarati da Google nell'annuncio del 30 settembre.
Le percentuali misurano aspetti diversi in condizioni di valutazione diverse. Non fate una media per ricavarne un punteggio di capacità complessiva e non sostituite il risultato di DeepSWE al tasso di accettazione del codice misurato sui vostri compiti.
In particolare, comprendere video lunghi non dimostra di saper modificare il software in modo affidabile. Un risultato sulla correzione delle vulnerabilità non garantisce le stesse capacità o protezioni di cybersicurezza a ogni futuro cliente. Scegliete il benchmark più vicino al compito che non riuscite a completare, poi verificate il risultato con i vostri vincoli.
Cosa cambia per sviluppatori, responsabili operativi e acquirenti
Gli sviluppatori dovrebbero attivarsi ora se l'accesso approvato consente di valutare un compito che il modello attuale continua a lasciare incompleto. Partite da un'attività circoscritta e confrontate risultati accettati, token totali fatturati e impegno richiesto ai revisori. Mantenete un fornitore già disponibile come riferimento.
Gli sviluppatori in attesa dell'accesso dovrebbero preparare la valutazione e continuare a rilasciare il proprio lavoro. Per chi sviluppa da solo piccole patch, o per un fondatore con un flusso di lavoro già affidabile, il limite di output più ampio cambia poco finché non serve a un compito ricorrente.
I responsabili operativi dovrebbero predisporre i controlli necessari per verificare un'esecuzione lunga. Un CTO che valuta una migrazione ha bisogno di un perimetro chiaro, test di regressione e un revisore responsabile. Un responsabile operativo senior che valuta una ricerca ha bisogno di un insieme di fonti e di un metodo per controllare la conclusione. Un'esecuzione più lunga aumenta la quantità di lavoro da esaminare.
Chi acquista dovrebbe riservare il budget alla tariffa successiva e subordinare la migrazione a condizioni precise. Servono accesso approvato, un risultato completo e un costo migliore per ogni risultato accettato. Una classifica pubblicata o l'acquisto di un abbonamento consumer non soddisfano queste condizioni.
Aspettate se il compito viene già completato in modo affidabile a un costo inferiore, se l'accesso non è confermato o se non potete misurare l'accettabilità del risultato.
Oltre l'entusiasmo: le scorciatoie da evitare
L'annuncio di un modello non equivale all'accesso per tutti. Google ha annunciato Argon e alcuni utenti selezionati lo stanno già usando. I gruppi successivi sono stati indicati, ma manca ancora la data di apertura. Mantenete questa distinzione in ogni nota per gli acquisti.
Un limite di output più alto non misura l'affidabilità. Più spazio può consentire al modello di completare un percorso difficile; può anche produrre più materiale da revisionare. Un'esecuzione più lunga giustifica il suo costo quando migliora un risultato accettato.
La vicenda del cosiddetto “Argon checkpoint” su Arena non è verificata ai fini di questa decisione. L'annuncio di Google non conferma l'identità di quel checkpoint precedente al rilascio. Non inserite in un piano di produzione nomi di modelli, specifiche o tabelle di benchmark trapelati. Usate il modello ufficialmente annunciato e i fatti pubblicati il 30 settembre.
Il prezzo introduttivo non garantisce un risparmio duraturo. Un piano economico che funziona a $2/$10 e non regge a $4/$20 dipende da una promozione di cui Google non ha indicato la data di fine. Calcolate entrambi gli scenari prima di impegnarvi.
Il riscontro che ancora manca, e che conta davvero, è il vostro costo per attività accettata al prezzo finale. I risultati pubblicati da Google sono un motivo per valutare proprio questo aspetto.
Da lunedì: preparare una decisione basata su misure concrete
La prossima settimana assegnate a un responsabile un piano di valutazione concreto. Il risultato dovrebbe essere una decisione sul passaggio al modello che possiate motivare quando l'accesso sarà disponibile.
Individuare il compito bloccato
Scegliete un'attività ricorrente: per esempio una migrazione incompleta del repository, la correzione autorizzata di una vulnerabilità o un dossier di ricerca basato su documenti e grafici. Definite per iscritto come deve presentarsi un risultato completo e accettabile.
Misurare il riferimento attuale
Usate il modello attualmente disponibile. Registrate input e output fatturati, nuovi tentativi, accettazione e tempo di revisione. Mantenete invariati il compito e lo standard di accettazione.
Calcolare il budget alla tariffa successiva
Calcolate il costo del carico di lavoro alle tariffe di $4/$20 annunciate per Argon. Tenete separato lo scenario introduttivo, indicando che la sua scadenza non ha una data. Confermate l'accesso dell'account prima di assegnare ad Argon attività con consegne da rispettare.
Passare ad Argon quando il risultato migliora
Una volta ottenuto l'accesso, confrontate il lavoro completato e accettabile e l'impegno totale. Estendete l'uso quando il vantaggio compensa il sovrapprezzo dei token e l'eventuale revisione aggiuntiva; mantenete il modello di riferimento quando non lo compensa.
Domande frequenti su Gemini 4 Argon
Gemini 4 Argon è già disponibile?
È stato annunciato il 30 settembre 2026 e offre un accesso anticipato limitato. Alla verifica del 1 ottobre, le pagine di Google indicano operatori selezionati della difesa informatica di Fairwind e tester di fiducia; non confermano un accesso esteso a tutti i clienti paganti.
Quando esce Gemini 4 per un pubblico più ampio?
Google indica i clienti API a pagamento e gli abbonati Google AI Ultra per la prossima fase di apertura. L'annuncio non fornisce una data per questo passaggio o per la disponibilità generale.
Quali usi di Gemini sono vietati?
Per Argon tramite Fairwind, il programma di Google limita l'uso alle finalità difensive e di ricerca consentite, vieta le attività dannose e proibisce di condividere, ridistribuire o vendere l'accesso. L'approvazione dell'accesso non elimina queste condizioni.
Che cos'è Gemini 4?
Gemini 4 Argon è il modello annunciato da Google per attività complesse e prolungate nell'ingegneria del software, nel lavoro aziendale basato sulla conoscenza e nella difesa informatica. Il limite di output pubblicato è di 1M di token, rispetto ai precedenti 64K.
Quando è stato lanciato Gemini 4?
Google ha annunciato Gemini 4 Argon e il suo rilascio limitato il 30 settembre 2026. Questa data riguarda un passaggio distinto dal rilascio di API o servizi consumer disponibili su larga scala, per il quale Google non ha indicato una data.
Quali sono gli svantaggi di usare Gemini?
Nella scelta di adottare Argon, gli svantaggi immediati sono l'accesso limitato, il passaggio a prezzi dei token più alti senza una data definita e l'assenza di riscontri sul proprio carico di lavoro. Un limite di output elevato comporta anche più lavoro da verificare.
Quanto costa Gemini al mese?
La tariffazione API annunciata per Argon dipende dall'utilizzo: $2/$10 per milione di token di input/output nel periodo introduttivo, poi $4/$20, senza una data fissata per il cambio. Google AI Ultra è un abbonamento separato e i suoi abbonati sono tra i gruppi indicati per la prossima apertura dell'accesso. L'annuncio non specifica i limiti d'uso di Argon all'interno di Ultra.
Quali rischi comporta l'uso di Gemini?
Nei flussi di lavoro lunghi con Argon, controllate le modifiche al codice errate, le conclusioni prive di riscontri e le azioni involontarie degli strumenti. Google descrive difese contro usi impropri, prompt injection e disallineamento, insieme a sandbox con protezioni rafforzate. Queste misure lasciano comunque alla vostra organizzazione la responsabilità di verificare il lavoro accettato.
Conviene davvero usare Gemini?
Valutate Argon quando un compito lungo e specifico richiede lo spazio aggiuntivo e il costo per risultato accettato può migliorare alla tariffa finale. Mantenete la scelta attuale in produzione quando completa già il compito in modo affidabile o quando l'accesso ad Argon non è confermato.
Per orientare le decisioni pratiche su modelli e flussi di lavoro con l'evolversi dell'accesso, iscrivetevi alla newsletter.
- Ultimo aggiornamento
- 1 ott 2026
- Categoria
- AI
Preferisca questo sito su Google


Segni omidsaffari.com come fonte preferita e Google lo mette in evidenza per lei in Top Stories, AI Overviews e AI Mode.
Wispr Flow: vale la spesa? Prezzi e limiti a ottobre 2026
Wispr Flow alla prova di prezzi, tempi di correzione e privacy: quando basta Free, quando conviene Pro e quando scegliere Superwhisper per lavorare offline.1 ott 2026AI
Claude su Slack: come funziona Tag e come configurarlo in sicurezza
Claude Tag porta un assistente condiviso nei canali Slack. Scopri requisiti, costi a consumo, limiti di spesa e come configurare un primo canale sicuro.30 set 2026AI
Agenti AI con GPT-6.1 Sol: configurazione, costi e Codex
Come configurare agenti AI con GPT-6.1 Sol, Codex e Responses API: effort, strumenti, costi reali e criteri per capire quando passare ad Astra.30 set 2026AI
GPT-6.1 Sol o GPT-6 Sol: prezzi, benchmark e migrazione
GPT-6.1 Sol dimezza il costo dell’input in cache, ma cambia compatibilità. Confronta prezzi, benchmark e migrazione prima di sostituire GPT-6 Sol.30 set 2026AI
Claude Sonnet 5.5: guida pratica per iniziare e usarlo bene
Scopri come usare Claude Sonnet 5.5 con l'effort giusto, costi reali, workflow verificabili e una migrazione API sicura per attività di produzione.28 set 2026AI
Jev o GLM-5.3-Flash: quale scegliere per il routing AI?
Confronto tra Jev e GLM-5.3-Flash su costi, accuratezza, latenza, immagini e portabilità, con un test pratico per scegliere il workflow giusto.27 set 2026AI
Claude Opus 5.5: vale il passaggio da Opus 5?
Claude Opus 5.5 costa meno, ma cinque modifiche API possono davvero bloccare la migrazione. Prezzi, benchmark e percorso di test rispetto a Opus 5.23 set 2026AI