GPT-6.1 Sol o GPT-6 Sol: prezzi, benchmark e migrazione
GPT-6.1 Sol dimezza il costo dell’input in cache, ma cambia compatibilità. Confronta prezzi, benchmark e migrazione prima di sostituire GPT-6 Sol.



Il confronto tra GPT-6.1 Sol e GPT-6 Sol va affrontato partendo dai test: conviene spostare su GPT-6.1 Sol gli agenti basati sulla Responses API che fanno largo uso della cache, ma è meglio mantenere GPT-6 Sol finché la migrazione resta bloccata da un tool caller su Chat Completions o dal reasoning none. Entrambi costano $2 in input e $10 in output per milione di token; cambia solo l’input in cache, che scende da $0.20 a $0.10.
GPT-6.1 Sol o GPT-6 Sol: quale scegliere?
GPT-6.1 Sol è la scelta da provare per un carico compatibile con la Responses API che riutilizza prefissi di prompt lunghi o richiede un candidato più forte per coding, computer use, documenti e attività aziendali in più passaggi. GPT-6 Sol resta invece la soluzione giusta finché l’applicazione dipende dal function calling di Chat Completions o da reasoning_effort: none. Non sono semplici differenze di configurazione: segnano il confine tra cambiare l’ID del modello e dover modificare il percorso della richiesta.
La decisione si può dividere chiaramente per scenario:
- Agente esistente su Responses API con effort medium o superiore: prova subito GPT-6.1 Sol. Offre una tariffa più bassa per le letture dalla cache e, al lancio, segnali di capacità più solidi.
- Function caller su Chat Completions: non partire dalla sostituzione dell’ID del modello. Sposta il flusso dei tool su Responses, esegui i test di regressione e solo dopo confronta i modelli.
- Carico che usa il reasoning
none: resta su GPT-6 Sol finché non puoi accettare almenolow; su GPT-6.1 Sol l’impostazione predefinita èmedium. - Carico composto soprattutto da input nuovo e output: non c’è alcun risparmio sul prezzo dei token. I due modelli applicano le stesse tariffe all’input nuovo, alla scrittura della cache e all’output, quindi il passaggio deve essere giustificato dalle capacità.
La regola è semplice: passa a GPT-6.1 Sol solo se migliora il lavoro accettato dopo che il caller ha superato la verifica di compatibilità. Una tariffa più bassa per la cache è utile, ma basta una chiamata tool fallita, un diverso livello minimo di reasoning o un tentativo in più per consumare rapidamente il risparmio.
Prezzi di GPT-6.1 Sol e GPT-6 Sol
Sul prezzo, GPT-6.1 Sol vince solo quando le richieste generano letture dalla cache. Le tariffe per input nuovo, scrittura della cache e output non cambiano.
Ho verificato le tariffe sulle pagine live di OpenAI dedicate a GPT-6.1 Sol e GPT-6 Sol il 30 settembre 2026.
Se normalizzate per 1,000 token, le tariffe di entrambi i modelli sono $0.002 per l’input nuovo, $0.0025 per la scrittura della cache e $0.01 per l’output. Una lettura dalla cache costa $0.0001 con GPT-6.1 Sol e $0.0002 con GPT-6 Sol. A queste tariffe non esiste un volume che renda GPT-6 Sol più economico: ogni token letto dalla cache sposta la spesa verso GPT-6.1 Sol, mentre senza letture dalla cache si resta in parità.
Prezzo della cache di GPT-6.1 Sol
La tariffa dell’input in cache è inferiore del 50%, ma il costo complessivo dell’attività diminuisce meno perché è cambiata una sola componente. Per input in cache si intende un prefisso di prompt invariato che il modello può riutilizzare. La guida di OpenAI al prompt caching indica che, per GPT-5.6 e i modelli successivi, il prefisso deve raggiungere 1,024 token di input visibili; mantenere una sessione non garantisce un cache hit.
Anche la voce relativa alla scrittura della cache va letta con attenzione. È una tariffa alternativa per i token di input, non un costo aggiuntivo applicato sopra un’altra tariffa di input. Per entrambi i modelli, un milione di token scritti costa $2.50. GPT-6.1 Sol modifica il prezzo delle letture successive, non il costo per creare il prefisso riutilizzabile.
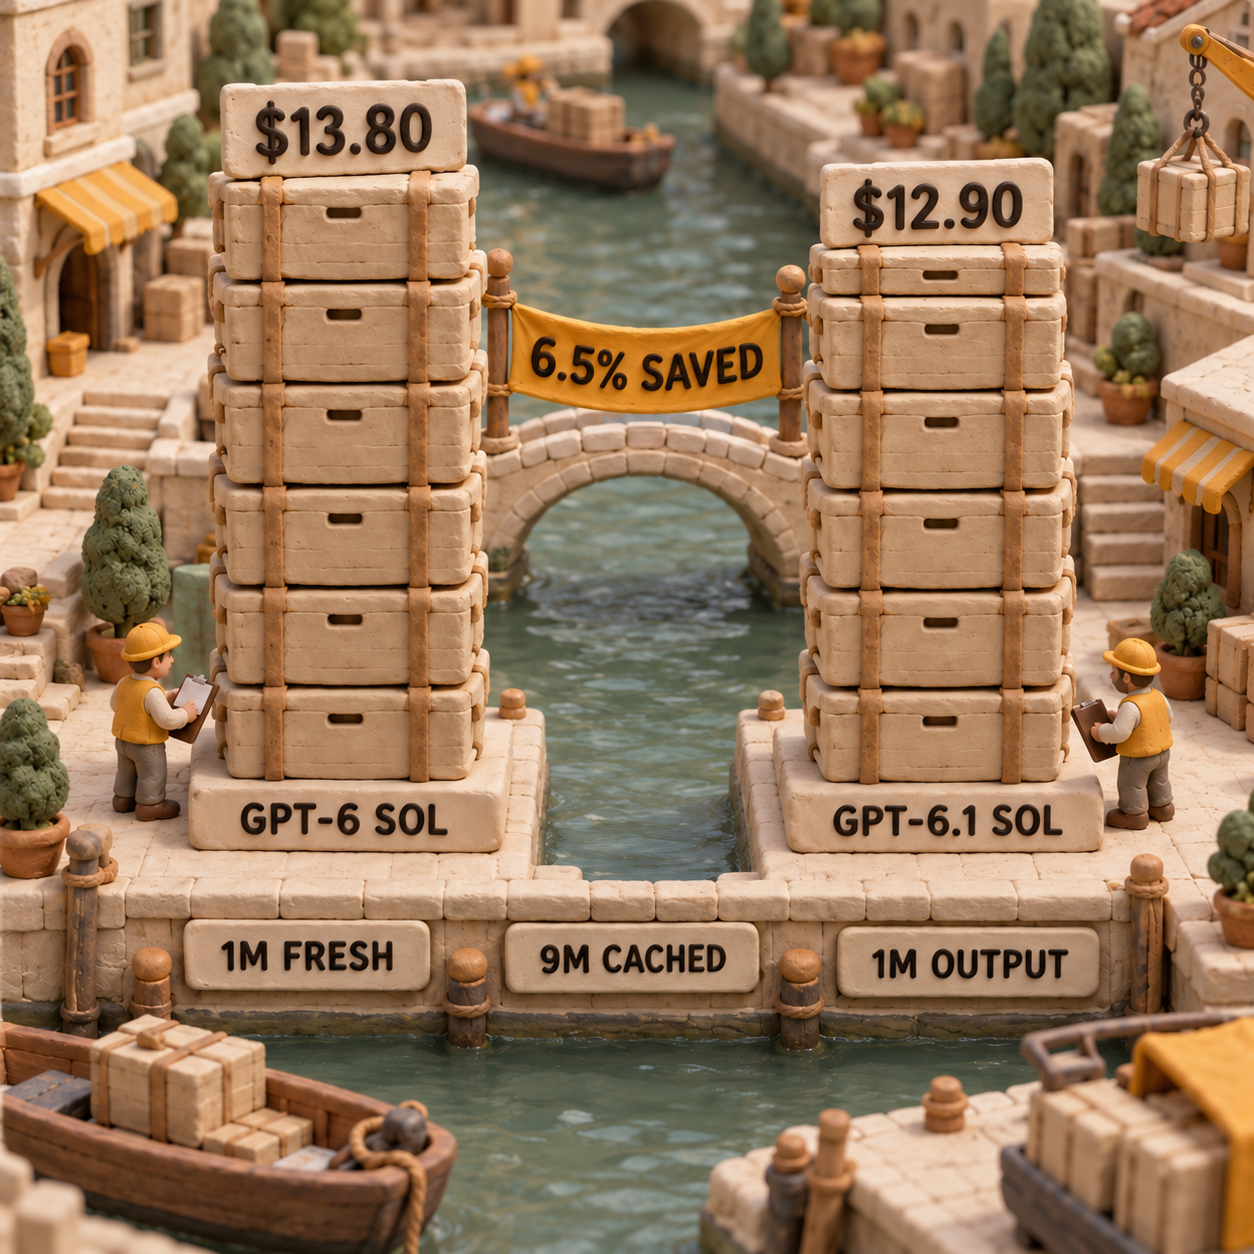
Consideriamo un batch a contesto breve con 1 milione di token di input nuovi, 9 milioni di token di input in cache e 1 milione di token di output:
- GPT-6 Sol: (1 x $2.00) + (9 x $0.20) + (1 x $10.00) = $13.80
- GPT-6.1 Sol: (1 x $2.00) + (9 x $0.10) + (1 x $10.00) = $12.90
Il risparmio è di $0.90, pari al 6.5%, prima delle scritture della cache e dei costi dei tool. Si tratta di un calcolo teorico, non di un carico eseguito né di un importo riscontrato in fattura.
L’esempio presuppone inoltre che ogni richiesta resti pari o inferiore a 272,000 token di input. Oltre questa soglia, le pagine di entrambi i modelli indicano che l’intera richiesta viene fatturata a 2x per input e cache e a 1.5x per l’output. Un batch può totalizzare milioni di token senza superare la soglia se è composto da richieste più piccole: il limite si applica alla singola richiesta.
Per un agente esistente, conviene partire misurando cached_tokens e i token di scrittura della cache, invece di stimarli dalla lunghezza del prompt. La guida alla diagnostica del prompt caching di GPT-6 spiega come distinguere un cache-hit rate basso da un problema di prezzo del modello.
Vincitore: GPT-6.1 Sol per i carichi che usano molto la cache. Parità per quelli senza letture dalla cache.
Benchmark di GPT-6.1 Sol
GPT-6.1 Sol prevale per le capacità mostrate al lancio, ma le evidenze provengono da OpenAI e non da un confronto indipendente diretto. È una distinzione importante: system prompt, accesso ai tool, livello di reasoning e criteri per i nuovi tentativi possono cambiare sia il risultato sia il costo.
Il report di lancio di OpenAI offre cinque indicazioni utili rispetto a GPT-6 Sol:
- Coding: GPT-6.1 Sol ha superato di 6.4 punti percentuali il miglior punteggio di GPT-6 Sol su DeepSWE v1.1, con un livello di reasoning e un costo inferiori.
- Workflow aziendali: ha ottenuto 4.8 punti percentuali in più su AutomationBench 1.0.6 con la stessa configurazione.
- Computer use: sul set offline OSWorld 2.0 ha guadagnato 7 punti al livello massimo di reasoning, con meno della metà del costo per attività.
- Workflow scientifici: al livello massimo di reasoning ha più che raddoppiato il punteggio di GPT-6 Sol su Terminal-Bench Science 0.1, ancora una volta con meno della metà del costo per attività.
- Accuratezza fattuale: su prompt volutamente difficili e con effort low, le risposte contenenti almeno un errore fattuale sono scese dall’11.4% al 7.7%, con una riduzione relativa di circa il 32%.
Sono differenze promettenti, non una percentuale di miglioramento universale. OpenAI precisa che le valutazioni GPT sono state eseguite nel proprio ambiente di ricerca o tramite API e possono discostarsi da ChatGPT in produzione, perché prompt, tool e impostazioni di effort possono variare. Al 30 settembre 2026 non era disponibile alcun benchmark indipendente e comparabile per questi due ID esatti, quindi un punteggio esterno non dovrebbe sostituire una verifica sul carico reale.
La rilevanza di ciascun benchmark per chi acquista è più circoscritta di quanto suggeriscano i titoli. DeepSWE è pertinente per un team che assegna a un agente lavori di lunga durata su un repository. AutomationBench interessa chi collega tool di vendita, marketing, assistenza, finanza o risorse umane. OSWorld conta quando il modello controlla applicazioni sul computer. Nessuno di questi benchmark dimostra un miglioramento per un classificatore di assistenza a due passaggi, un breve intervento di copy editing o il proprio codebase privato.
Vincitore: GPT-6.1 Sol sulla base delle evidenze attuali. Livello di fiducia: dati del fornitore, in attesa di risultati indipendenti sulla coppia esatta.
Specifiche: GPT-6.1 Sol vs GPT-6 Sol
I due modelli condividono quasi tutto il profilo operativo. Entrambi dichiarano una finestra di contesto da 1,050,000 token, un output massimo di 128,000 token, input di testo e immagini, output di testo, structured outputs, streaming e la stessa gamma di tool su Responses. Le pagine dei modelli non indicano il supporto per input audio o video, né il fine-tuning.
GPT-6.1 Sol sposta il knowledge cutoff documentato dal 20 aprile al 30 aprile 2026. Dieci giorni non sono una ragione sufficiente per migrare. Nella maggior parte dei sistemi in produzione, la qualità del retrieval, il contesto privato e l’affidabilità dei tool avranno un peso ben maggiore di questa piccola differenza di data.
GPT-6.1 Sol: il nuovo candidato predefinito
GPT-6.1 Sol è il nuovo modello di OpenAI per attività complesse, disponibile con l’ID API esatto gpt-6.1-sol. Supporta i livelli di reasoning low, medium, high, xhigh e max, con medium come impostazione predefinita. Le tariffe standard per milione di token sono $2 per l’input nuovo, $0.10 per l’input in cache, $2.50 per la scrittura della cache e $10 per l’output.
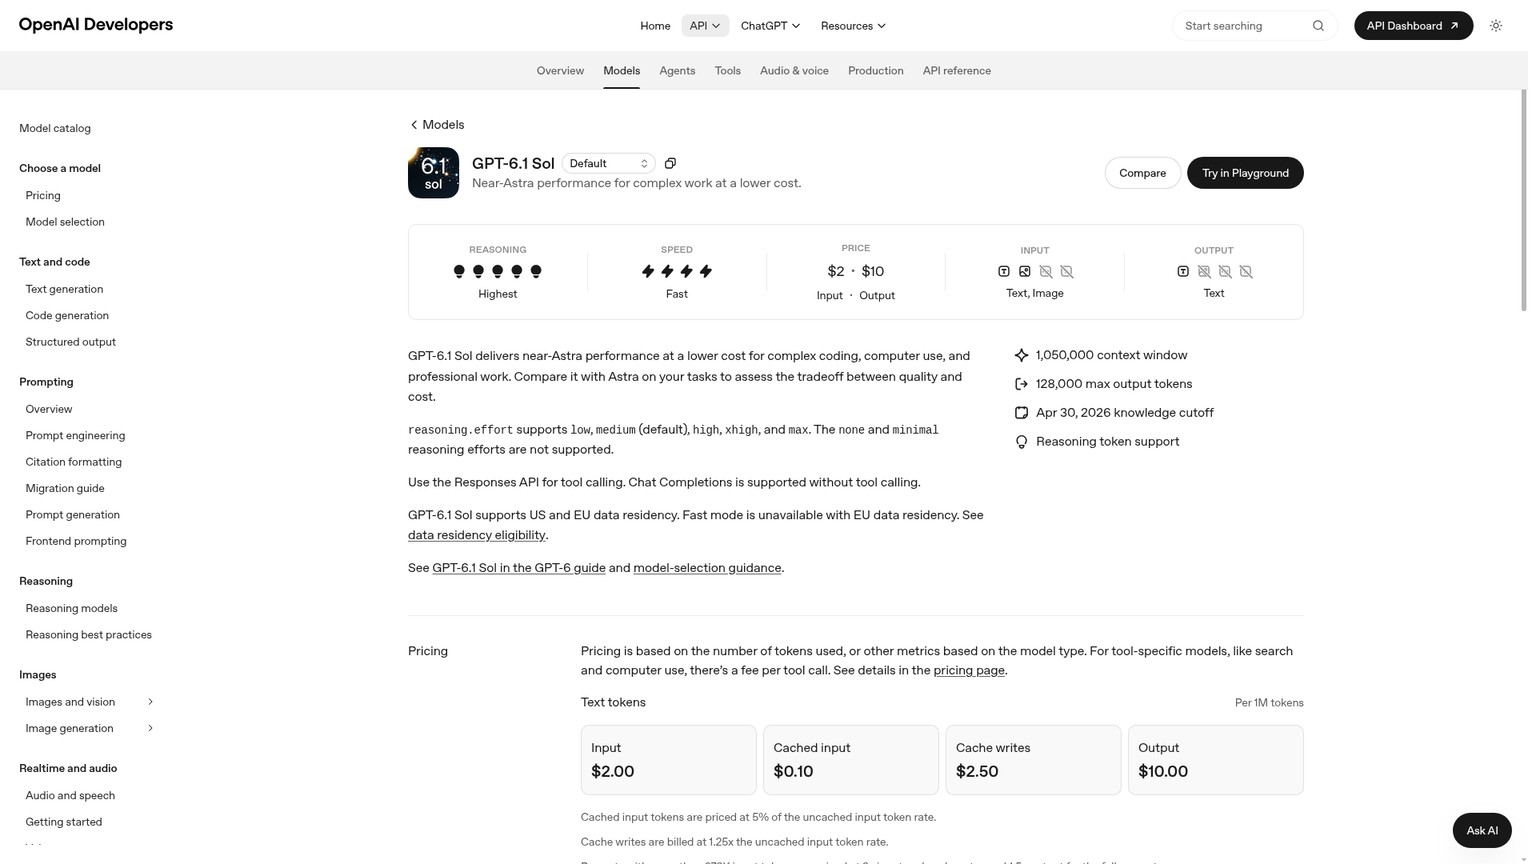
La pagina del modello elenca web search, file search, image generation, code interpreter, hosted shell, apply patch, skills, computer use, MCP e tool search tramite Responses. Sceglilo quando questo percorso API è già adatto e l’attività assomiglia ai casi in cui emergono segnali più forti: coding, documenti, computer use o workflow. Rimanda invece il cambio del modello predefinito se serve ancora un test di accettazione indipendente o se il flusso dipende da un livello di reasoning rimosso.
GPT-6 Sol: la scelta per mantenere la compatibilità
GPT-6 Sol resta disponibile con l’ID gpt-6-sol. Supporta i livelli di reasoning none, low, medium, high, xhigh e max. Le tariffe standard restano $2 per l’input nuovo, $0.20 per l’input in cache, $2.50 per la scrittura della cache e $10 per l’output per milione di token.
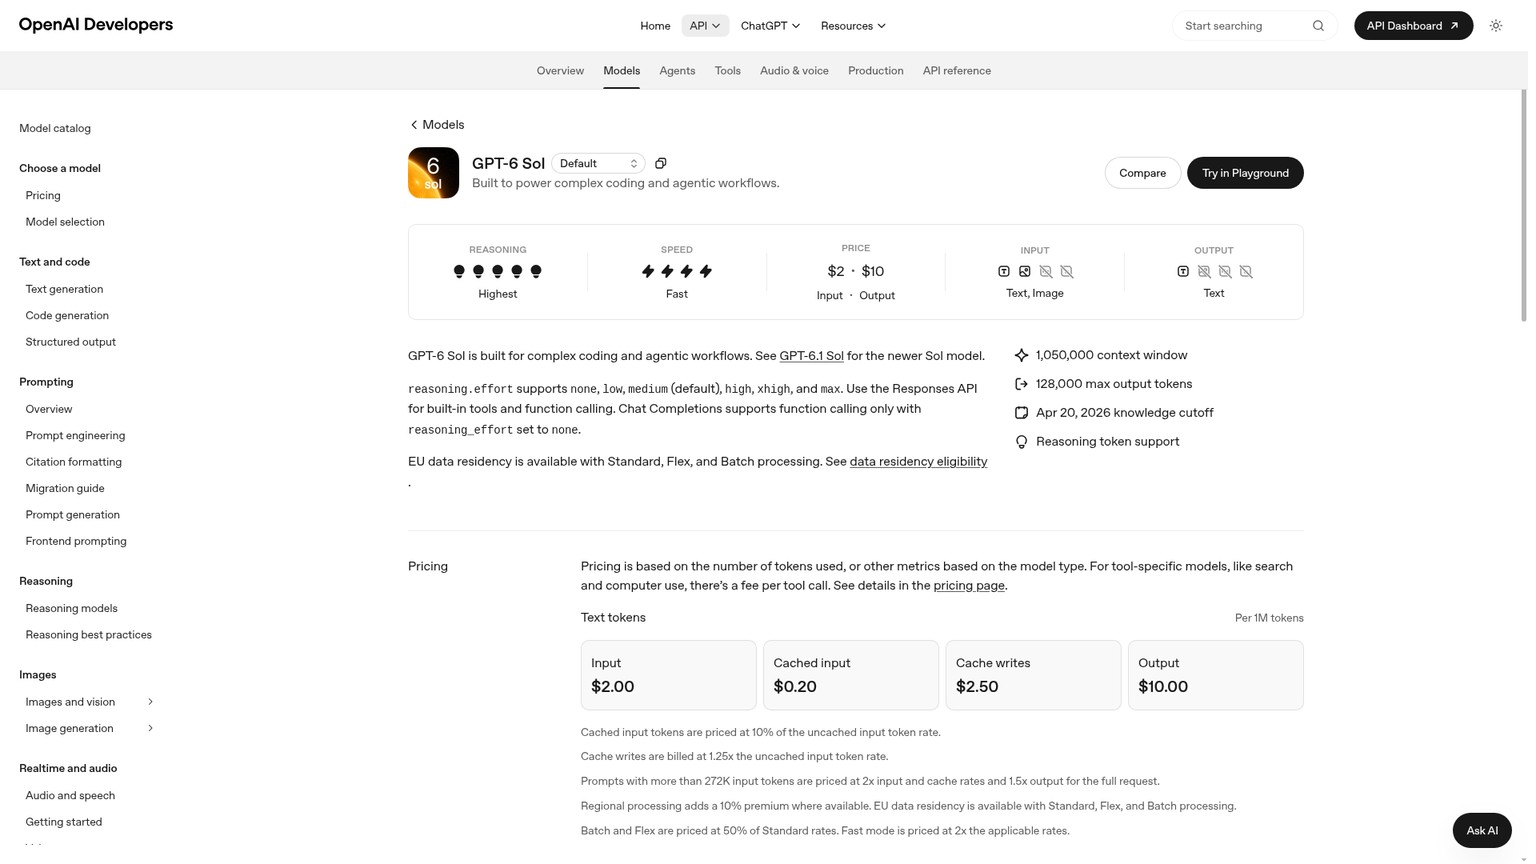
La gamma di tool su Responses coincide con l’elenco documentato per il modello più recente. La differenza pratica è la via d’uscita per i sistemi legacy: Chat Completions può chiamare le functions quando il reasoning effort è impostato su none. Questo rende GPT-6 Sol il vincitore temporaneo per un’applicazione stabile che non ha ancora spostato il proprio ciclo di tool su Responses. Non è invece il modello più economico quando entrano in gioco le letture dalla cache.
Vincitore: parità per contesto, limite di output, modalità e tool Responses documentati. GPT-6.1 Sol vince per recenza; GPT-6 Sol per compatibilità legacy.
Upgrade a GPT-6.1 Sol: prima viene la compatibilità
L’upgrade a GPT-6.1 Sol può ridursi al cambio di una riga solo se il caller usa già Responses, evita none e minimal e considera l’output del modello un comportamento da validare, non un contratto drop-in. In tutti gli altri casi, occorre migrare prima di valutare il modello.
Tool calling con GPT-6.1 Sol
Per il tool calling, GPT-6.1 Sol richiede la Responses API. Chat Completions resta disponibile per le normali chiamate al modello, ma non per il tool calling. GPT-6 Sol si comporta diversamente: la pagina del modello consente il function calling su Chat Completions soltanto con reasoning_effort impostato su none.
Prima di cambiare l’ID del modello, esamina ogni function caller esistente su Chat Completions. Il costo della migrazione può comprendere la costruzione delle richieste, lo stato della conversazione, la gestione dei risultati dei tool, il parsing delle risposte, la logica dei nuovi tentativi, il tracing e la stabilità del prefisso in cache. Un wrapper che nasconde l’endpoint non elimina queste differenze: sposta soltanto il punto in cui occorre testarle.
Anche il reasoning costituisce un contratto. GPT-6.1 Sol non supporta none né minimal. Se una route di produzione usa none per ridurre la latenza, rendere più deterministica la selezione dei tool o controllare i costi, l’impostazione valida più vicina non è automaticamente equivalente nel comportamento. Sposta la route su un livello supportato ed esegui le stesse verifiche di accettazione prima di confrontare velocità o spesa.
Chi non dovrebbe ancora effettuare il passaggio
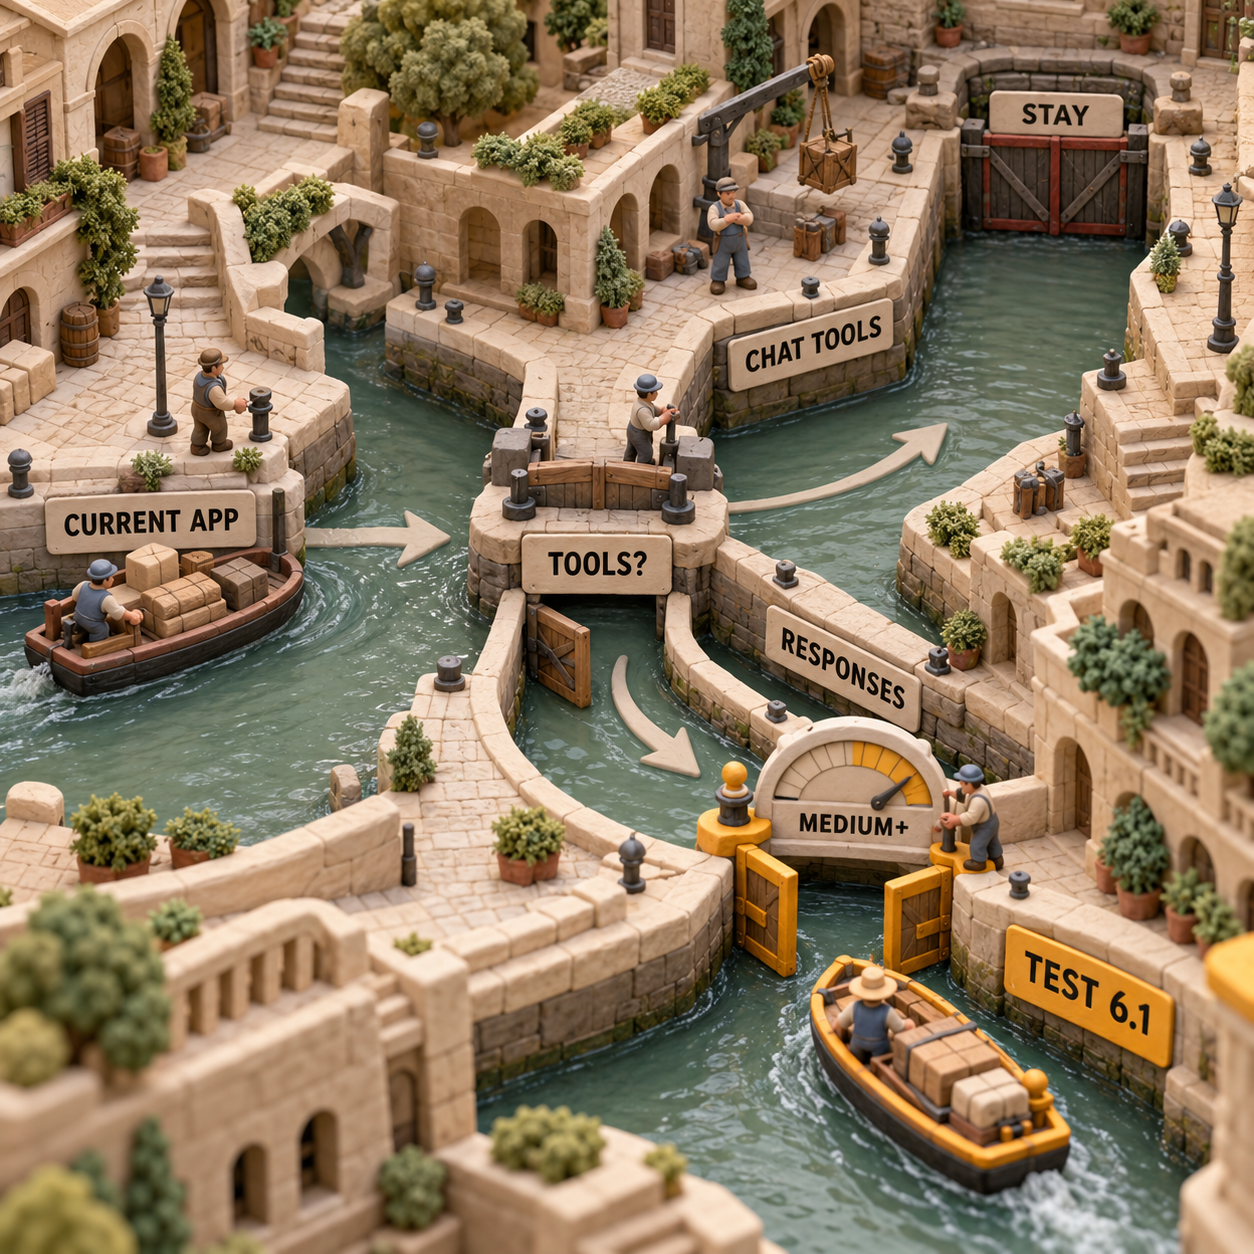
Non cambiare ancora il modello predefinito se si verifica una di queste condizioni:
- Le chiamate ai tool passano ancora da Chat Completions.
- Una route usa esplicitamente il reasoning
noneominimal. - La maggior parte dei token fatturati appartiene a input nuovo e output, quindi il risparmio della cache è trascurabile.
- Il modello attuale supera già i controlli di accettazione aziendali e non è stato misurato alcun vantaggio di GPT-6.1 Sol sugli stessi casi di test.
- Un deployment regolamentato richiede una revisione separata della modalità di elaborazione, della residenza dei dati, dei log e del diverso comportamento del modello.
Si tratta di dipendenza dal workflow, non di un vendor lock-in permanente. I nomi dei modelli sono simili, ma il caller può essere legato a un endpoint, a un livello minimo di reasoning, al formato della risposta e al ciclo dei tool. Il costo di questa validazione va incluso nell’upgrade.
Vincitore: GPT-6 Sol per un caller oggi incompatibile. GPT-6.1 Sol dopo il superamento dei controlli sul caller e sui casi di test.
Esegui cinque casi di test fissi prima di cambiare il modello predefinito
Esegui cinque casi di test fissi su entrambi gli ID esatti con effort medium, usando gli stessi prompt, tool, contesto, limiti di output e controlli di accettazione. È un metodo di valutazione proposto, non un benchmark eseguito per questo articolo.
Correggere un bug in un repository
Fornisci a entrambi i modelli lo stesso test che fallisce, lo stesso stato del repository e gli stessi tool consentiti. Accetta soltanto una patch che risolva il problema indicato senza compromettere la suite esistente.
Eseguire un refactoring su più file
Usa una modifica circoscritta che coinvolga più file, con controlli di build, lint e test. Se il repository non supera le verifiche, rifiuta anche una spiegazione impeccabile.
Instradare una richiesta di assistenza
Fornisci la stessa policy, lo stesso messaggio del cliente e gli stessi tool di routing. Richiedi la coda e la priorità corrette, campi strutturati esatti e nessuna azione non supportata.
Rispondere sulla base delle policy
Chiedi una risposta per il cliente basata sullo stesso insieme di documenti. Accetta soltanto la conclusione richiesta, le evidenze citate e il corretto comportamento di escalation.
Completare un workflow aziendale
Usa la stessa attività in più passaggi, che preveda una ricerca, un aggiornamento e un limite di autorizzazione. Richiedi la corretta sequenza dei tool, lo stato finale previsto e il rifiuto di ogni passaggio non autorizzato.
Registra gli output accettati, la latenza end-to-end, i token di input nuovi, in cache, di reasoning e di output, i costi dei tool e i nuovi tentativi. Poi calcola il costo totale per risultato accettato, non quello della prima risposta:
effective cost per accepted result = total model, retry, and tool spend / accepted outputs
Il denominatore può ribaltare il confronto basato sul prezzo dei token. Un modello che fa risparmiare $0.90 su un batch con molto uso della cache può costare di più se introduce anche una sola esecuzione aggiuntiva e fallita di un tool. Un modello con lo stesso costo per i token nuovi può invece diventare la scelta più economica in produzione se elimina i nuovi tentativi.
La disponibilità varia tra API, Work, Codex e Chat
GPT-6.1 Sol è disponibile tramite API come gpt-6.1-sol e, secondo l’annuncio di lancio di OpenAI, in ChatGPT Work e Codex per gli utenti Plus, Pro, Business, Enterprise ed Edu. Al lancio non era disponibile nella normale esperienza Chat.
OpenAI afferma inoltre che GPT-6.1 Sol Ultrafast arriverà prossimamente, con una velocità di generazione dei token fino a 8x quella standard in Codex. L’annuncio non pubblica un prezzo per Ultrafast, quindi non è possibile costruire una previsione di costo partendo da un moltiplicatore non ufficiale.
L’utilizzo dell’API viene fatturato separatamente dall’abbonamento ChatGPT. L’accesso tramite Work o Codex non trasforma le tariffe API di $2 e $10 in una quota inclusa per un’applicazione in produzione.
Domande frequenti
Che cos’è GPT-6 SOL?
GPT-6 Sol è il modello di OpenAI per coding complesso e workflow agentici, con ID API gpt-6-sol. GPT-6.1 Sol è l’aggiornamento del 29 settembre 2026, con una tariffa inferiore per l’input in cache e un diverso profilo di compatibilità per reasoning e tool calling.
Quanto è migliore GPT Sol?
Non esiste un’unica percentuale attendibile. In specifiche configurazioni, OpenAI segnala per GPT-6.1 Sol vantaggi di 6.4 punti percentuali su DeepSWE, 4.8 punti su AutomationBench e 7 punti su OSWorld rispetto a GPT-6 Sol. Spetta a un test fisso sul proprio carico verificare se questi progressi si trasferiscono.
Quale versione di GPT è migliore?
GPT-6.1 Sol è il modello più promettente da testare per attività compatibili di coding e agenti aziendali. GPT-6 Sol è il runtime temporaneo più adatto quando servono ancora chiamate tool tramite Chat Completions o il reasoning none.
Quali sono funzionalità e prezzi dei nuovi modelli GPT-6 Sol e Luna di OpenAI?
Questa domanda riguarda la scelta precedente all’interno della famiglia. Il confronto tra GPT-6 Sol e Luna analizza i rispettivi ruoli di routing e l’attuale economia dei token; questa pagina si concentra invece sull’opportunità di spostare un carico Sol esistente su GPT-6.1 Sol.
Qual è il GPT migliore tra Sol, Terra e Luna?
Non esiste un vincitore universale nella famiglia. Occorre abbinare il modello alla difficoltà dell’attività, alla latenza e al costo per risultato accettato, quindi valutare gli ID esatti che verranno distribuiti. Questo confronto serve a decidere un upgrade da Sol a Sol, non a stabilire un verdetto su Terra o Luna.
GPT-6 Sol costa meno?
No, non alle tariffe Standard documentate. GPT-6 Sol e GPT-6.1 Sol costano uguale per input nuovo, scritture della cache e output, mentre GPT-6.1 Sol è più economico per l’input in cache: $0.10 contro $0.20 per milione di token.
Vale la pena pagare $20 per ChatGPT?
È una scelta relativa a un abbonamento consumer, non al confronto dei prezzi dei modelli API. Al lancio GPT-6.1 Sol era disponibile in Work e Codex con i piani a pagamento elencati, ma non nella normale esperienza Chat; l’uso dell’API viene fatturato separatamente.
GPT-5.6 Sol è migliore di GPT-5?
Quel confronto precedente non determina questo upgrade. Per un deployment attuale, valuta GPT-6.1 Sol e GPT-6 Sol usando esattamente il percorso API, il livello di reasoning, i tool e i controlli di accettazione dell’applicazione.
Quanto è valido GPT-6?
Le capacità di GPT-6 variano in base a modello, attività, effort e configurazione dei tool. Rispetto a GPT-6 Sol, GPT-6.1 Sol presenta evidenze del fornitore più solide in diverse valutazioni difficili, ma per la produzione la risposta deve arrivare da un eval privato e fisso.
Peso di GPT-6.1 Sol rispetto a GPT-6 Sol
Le pagine live di OpenAI non pubblicano il numero di parametri né pesi scaricabili per nessuno dei due modelli. Il confronto va basato su limiti e prezzi documentati, comportamento dell’API e risultati misurati sulle attività.
Cosa fare lunedì
Parti dal caller, non dal selettore del modello. Cerca nel codice e nella configurazione del workflow le chiamate di funzione tramite Chat Completions e i valori none o minimal per reasoning_effort. Se trovi uno dei due, definisci prima l’ambito della migrazione e solo dopo modifica il modello predefinito.
Quindi esegui i cinque casi fissi su gpt-6-sol e gpt-6.1-sol con effort medium, mantenendo invariati tool e controlli. Confronta costo per risultato accettato, latenza, uso della cache e nuovi tentativi. Promuovi GPT-6.1 Sol sulle route in cui vince; lascia le altre su GPT-6 Sol finché non si chiude il divario di compatibilità o di risultato.
Scarica la checklist per configurare Claude Code e Codex prima di cambiare la route di un modello in produzione.
- Ultimo aggiornamento
- 30 set 2026
- Categoria
- AI
Preferisca questo sito su Google


Segni omidsaffari.com come fonte preferita e Google lo mette in evidenza per lei in Top Stories, AI Overviews e AI Mode.

Claude Sonnet 5.5: guida pratica per iniziare e usarlo bene
Scopri come usare Claude Sonnet 5.5 con l'effort giusto, costi reali, workflow verificabili e una migrazione API sicura per attività di produzione.28 set 2026AI
Jev o GLM-5.3-Flash: quale scegliere per il routing AI?
Confronto tra Jev e GLM-5.3-Flash su costi, accuratezza, latenza, immagini e portabilità, con un test pratico per scegliere il workflow giusto.27 set 2026AI
Claude Opus 5.5: vale il passaggio da Opus 5?
Claude Opus 5.5 costa meno, ma cinque modifiche API possono davvero bloccare la migrazione. Prezzi, benchmark e percorso di test rispetto a Opus 5.23 set 2026AI
Quale modello GPT-6 scegliere: Sol o Luna?
Confronta GPT-6 Sol e Luna per prezzi API, qualità nel coding e costi di revisione. Scopri quando conviene partire da Luna e quando passare a Sol.23 set 2026AI
GPT-6 Luna gratis: dove usarlo e quanto costa davvero
GPT-6 Luna è gratis nell’app desktop per gli utenti Free e Go. Scopri dove funziona, quali piani lo includono e quanto costa davvero usare l’API.22 set 2026AI
MiMo AI V2.6: dalla prova in Studio alla prima API
Scopri come provare MiMo AI V2.6 in Studio, configurare chiavi e API corrette e portare in produzione un primo flusso di lavoro verificabile.22 set 2026AI
AI per programmare: MiMo V2.6 Pro o Flash?
Confronto tra MiMo V2.6 Pro e Flash per coding, agenti e UI: prezzi, benchmark e una regola pratica per scegliere il modello più conveniente.22 set 2026AI