Claude Sonnet 5.5: guida pratica per iniziare e usarlo bene
Scopri come usare Claude Sonnet 5.5 con l'effort giusto, costi reali, workflow verificabili e una migrazione API sicura per attività di produzione.



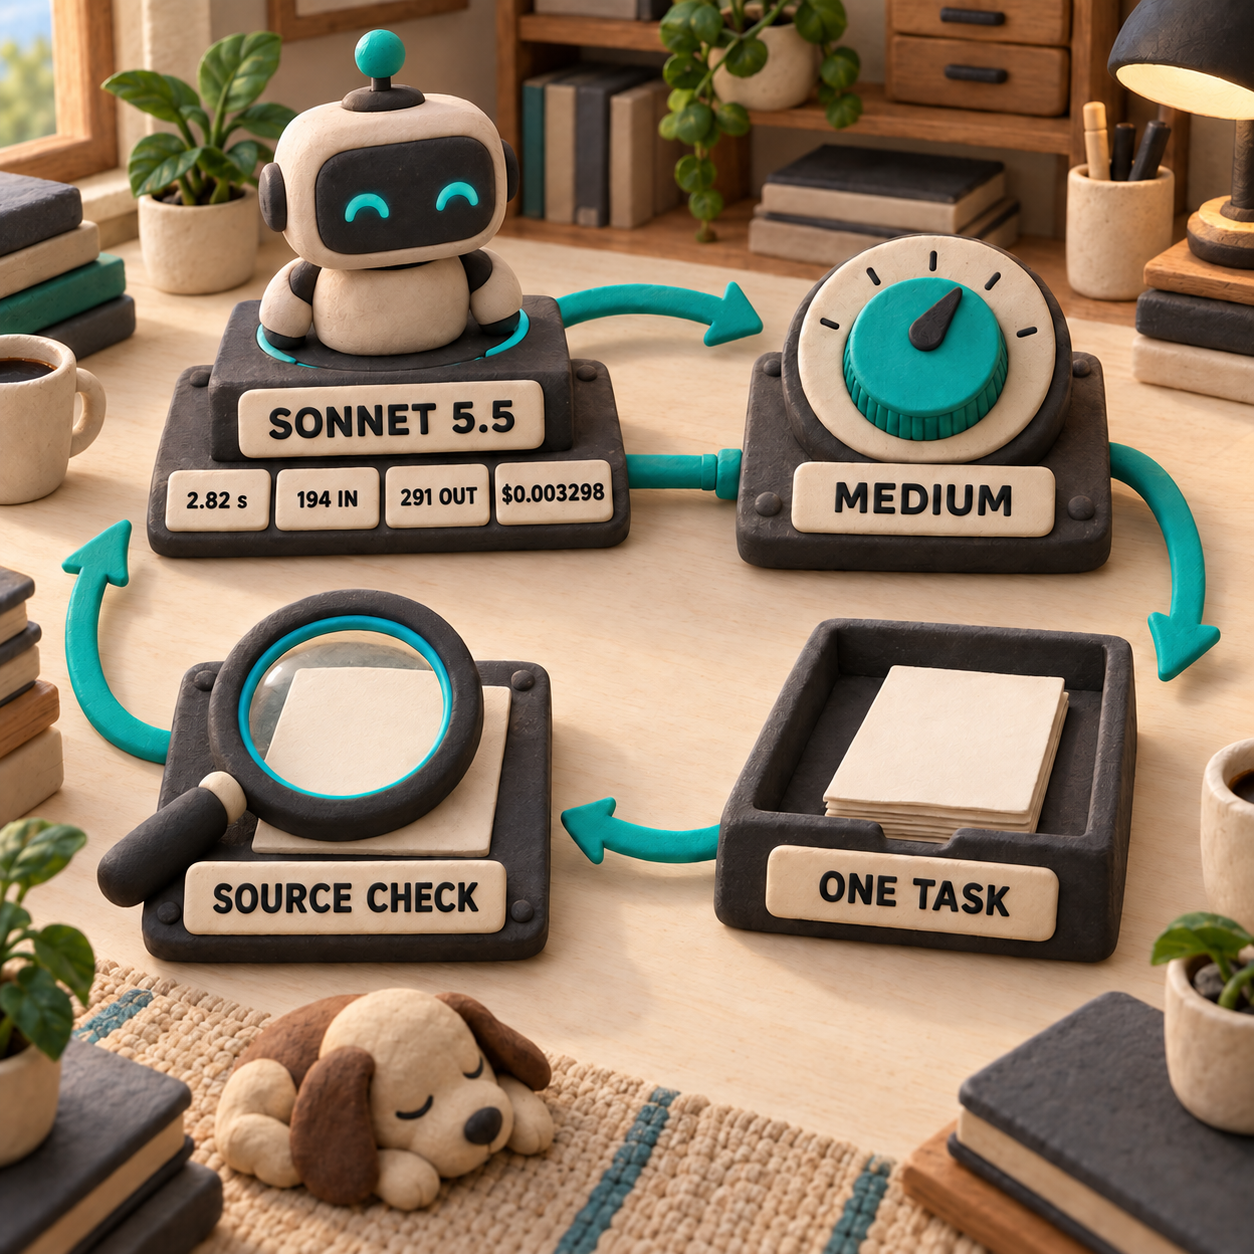
Per iniziare con Claude Sonnet 5.5, scegli un'attività circoscritta e facile da controllare, con effort Medium: per esempio il riepilogo di un ticket di assistenza o un briefing per un cliente. Nel mio test locale sintetico sul supporto, il modello ha risposto in 2.82 secondi, usando 194 token di input e 291 di output, per un costo di $0.003298. Ha conservato i fatti essenziali del ticket, ma ha anche aggiunto ipotesi plausibili sugli interventi da eseguire che non comparivano nella fonte. La lezione pratica è questa: Claude Sonnet 5.5 può rendere la prima bozza estremamente economica, ma la verifica resta parte integrante del lavoro.
Come iniziare con Claude Sonnet a effort Medium
La configurazione più rapida e utile si trova nell'app Claude. Seleziona Sonnet 5.5, verifica che l'effort sia impostato su Medium, fornisci un unico pacchetto di fonti e chiedi un risultato che si possa controllare riga per riga.
Nelle sue app e in Claude Code, Anthropic imposta Medium come valore predefinito. Claude Platform parte invece da High, quindi chi usa le API dovrebbe indicare esplicitamente il livello. Medium è il punto di partenza più sensato per riepiloghi di assistenza, briefing per clienti, analisi di routine e attività ben definite che richiedono tool: mantiene rapido il ciclo di feedback senza scendere fino all'impostazione minima.
Seleziona Sonnet 5.5
Apri una nuova chat in Claude. Fai clic sul nome del modello accanto al pulsante di invio, scegli Sonnet 5.5 e poi apri il menu Effort. Se il modello non compare nel primo elenco, fai clic su More models. Gli amministratori Enterprise possono limitare i modelli e i livelli di effort disponibili.
Mantieni Medium per il primo test
Per un'attività aziendale ben delimitata, lascia l'effort su Medium. Passa a High solo quando servono valutazioni più approfondite, una sequenza di lavoro più lunga o verifiche più rigorose. Low diventa utile dopo che i tuoi controlli hanno dimostrato che la qualità rimane adeguata.
Fornisci una fonte e una struttura
Incolla un ticket, la trascrizione di una chiamata o un insieme di documenti. Specifica chi leggerà il risultato e quali campi sono obbligatori. Per un ticket di assistenza, richiedi esattamente quattro punti: Problema, Impatto, Evidenze e Prossima azione. Aggiungi: “Non inventare fatti. Segnala ogni inferenza”.
Verifica le affermazioni sulla fonte
Confronta con l'input ogni nome, numero, causa, impegno e azione consigliata. Elimina i suggerimenti non supportati, anche quando sembrano ragionevoli. Salva il prompt soltanto dopo che ha superato questo controllo su più esempi del tuo flusso di lavoro.
Il ticket sintetico del mio test descriveva sei operatori dell'assistenza rimasti bloccati fuori dal sistema dopo la modifica del dominio di accesso, due operatori ancora connessi, l'errore “Invalid organization” e record utente già aggiornati con il nuovo dominio. Sonnet 5.5 ha mantenuto questi dettagli e rispettato il formato in quattro punti. Ha però anche ipotizzato che la mappatura dell'organizzazione puntasse ancora al vecchio dominio e definito una delle correzioni meno invasiva. Nessuna delle due informazioni era presente nel ticket.
Il calcolo del puro costo del modello è semplice. Alla tariffa pubblicata da Anthropic, 194 token di input costano $0.000388 e 291 token di output costano $0.00291, per un totale di $0.003298. Se 10,000 chiamate avessero esattamente questa distribuzione di token, la spesa lorda per il modello sarebbe di $32.98. Non è però il costo di 10,000 ticket risolti: recupero dei dati, integrazioni, nuovi tentativi, archiviazione, monitoraggio e revisione umana si aggiungono comunque alla chiamata del modello.
Che cos'è davvero Claude Sonnet 5.5
Sonnet 5.5 è il modello veloce e generalista della famiglia 5.5 di Anthropic. Può essere considerato il modello operativo per attività ben definite; Opus 5.5 è invece lo specialista senior da coinvolgere quando il problema è aperto e richiede molta capacità di giudizio.
Questa release è distinta da Sonnet 5. L'ID per l'API Claude diretta è claude-sonnet-5-5, senza suffisso con la data. Accetta testo e immagini, restituisce testo, dispone di una finestra di contesto da 1 milione di token e può generare fino a 128,000 token di output. Per prezzi e contesto del tokenizer del modello precedente, la recensione di Claude Sonnet 5 tratta quella release separatamente.
Secondo Anthropic, Sonnet 5.5 genera l'output oltre il 30% più velocemente di Sonnet 5 e, nei suoi test, costa fino al 30% in meno per attività completata. La seconda affermazione riguarda il minor numero di token necessari per portare a termine il lavoro, non una tariffa per token più bassa. I prezzi non sono cambiati rispetto a Sonnet 5.
Anche i risultati dei benchmark provengono da Anthropic. L'azienda riporta un punteggio del 70.6% per Sonnet 5.5 contro il 10.3% di Sonnet 5 su Terminal-Bench 4.0, e del 55.5% contro il 34.1% su CursorBench 4.0. Sono dati che giustificano un test del nuovo modello, ma non dicono se le regole dei tuoi ticket, il tuo codebase o il tuo modello di documento supereranno la prova. Nel suo report di lancio, Anthropic distingue allo stesso modo i punteggi dei benchmark dalla capacità di giudizio mantenuta nel tempo sui lavori aperti.
Scegli l'effort in base al costo di un errore
L'effort regola qualità, latenza e consumo di token; non determina la lunghezza del testo. Un livello superiore concede al modello più spazio per ragionare e controllare, ma può anche aumentare attesa e costo. Se serve una risposta breve, richiedila separatamente nel prompt.
Anthropic ha ricalibrato questi livelli per Sonnet 5.5: Medium su questo modello non corrisponde quindi allo stesso volume di ragionamento di Medium su Sonnet 5. Esegui una nuova serie di test sui tuoi esempi. Non mantenere un'impostazione solo perché l'etichetta è identica.
Sette flussi di lavoro utili, ordinati per ritorno immediato
I casi d'uso migliori hanno tre caratteristiche in comune: l'input è disponibile, il risultato desiderato ha una struttura chiara e una persona o una regola può verificarlo.
1. Smistamento dei ticket di assistenza
Chi guida le operazioni di supporto può riunire il messaggio del cliente, lo stato dell'account, la cronologia recente dei ticket e le regole di escalation. Sonnet 5.5 può restituire problema, impatto, evidenze, informazioni mancanti e prossima azione consentita. Il vantaggio è dover rileggere meno prima dell'assegnazione o del passaggio di consegne. Una persona deve comunque verificare i consigli che modificano l'account, i rimborsi, le promesse e le conclusioni sulla causa principale.
È il flusso migliore da cui partire perché ogni elemento del risultato può rimandare a un campo preciso della fonte. Inoltre, fa emergere rapidamente gli errori del modello. Se un riepilogo non sa indicare l'origine di un'affermazione, non è pronto ad attivare un'azione.
2. Briefing prima delle chiamate con i clienti
Un account director può fornire la trascrizione dell'ultima chiamata, lo statement of work, le attività aperte e le note sul rinnovo. Chiedi una pagina che raccolga decisioni, impegni, rischi, domande irrisolte e ordine del giorno del prossimo incontro. Il vantaggio è un formato di briefing ripetibile, al posto di una pagina bianca da ricominciare prima di ogni chiamata.
Mantieni “confermato” e “dedotto” in sezioni separate. Questa sola distinzione impedisce che un'interpretazione plausibile del modello si trasformi in un impegno verso il cliente.
3. Revisione delle pull request
Un responsabile tecnico può passare al modello un diff del codice, le convenzioni del repository e una checklist per sicurezza, test e compatibilità con le versioni precedenti. Sonnet 5.5 può produrre una prima analisi ordinata per rischio e proporre test. Il vantaggio è orientare più rapidamente chi esegue la revisione, non approvare automaticamente la modifica. La decisione sul merge deve restare a chi è responsabile del sistema.
4. Correzione di bug circoscritti
Uno sviluppatore di prodotto con un bug riproducibile può fornire il comportamento errato, i file pertinenti e i controlli di accettazione. Medium è un punto di partenza ragionevole per una correzione ben specificata. Passa a High quando il problema attraversa più servizi o il primo tentativo salta la verifica. Il vantaggio è accorciare i cicli di implementazione e test, mentre i criteri di accettazione impediscono all'attività di allargarsi.
5. Revisioni operative e bozze per il consiglio di amministrazione
Un team finanziario o operativo può fornire i materiali di partenza insieme a un modello approvato per slide o documenti. Sonnet 5.5 può preparare una revisione strutturata, mettere in evidenza le lacune e impaginare una prima versione. Anthropic lo posiziona espressamente per documenti, presentazioni e fogli di calcolo rifiniti. Il vantaggio è ridurre il lavoro di assemblaggio, ma ogni affermazione finanziaria deve comunque rimandare a una cella o a un documento di origine.
6. Riepiloghi degli incidenti
Chi coordina un incidente può fornire al modello la cronologia degli eventi, gli avvisi, le azioni e le note dei responsabili. Chiedi blocchi separati per eventi confermati, ipotesi, impatto sui clienti, domande aperte e attività successive. Il vantaggio è un passaggio di consegne più chiaro e una prima bozza del resoconto. Non consentire al modello di trasformare una correlazione in causa principale.
7. Controllo visivo e rifinitura dell'interfaccia
Un product designer o uno sviluppatore front-end può affiancare a uno screenshot le linee guida del brand e una checklist di accettazione. Sonnet 5.5 può individuare incoerenze, stabilire le priorità degli interventi e contribuire a realizzare una revisione circoscritta. Il vantaggio è iterare più velocemente sui difetti visibili. Gusto, test di accessibilità e giudizio finale sul prodotto restano responsabilità umane.
Tre prodotti che vale la pena costruire
L'accesso diretto al modello non è un'attività commerciale. Un prodotto vendibile aggiunge contesto proprietario, un flusso controllato, evidenze e uno spazio in cui una persona possa prendere la decisione finale.
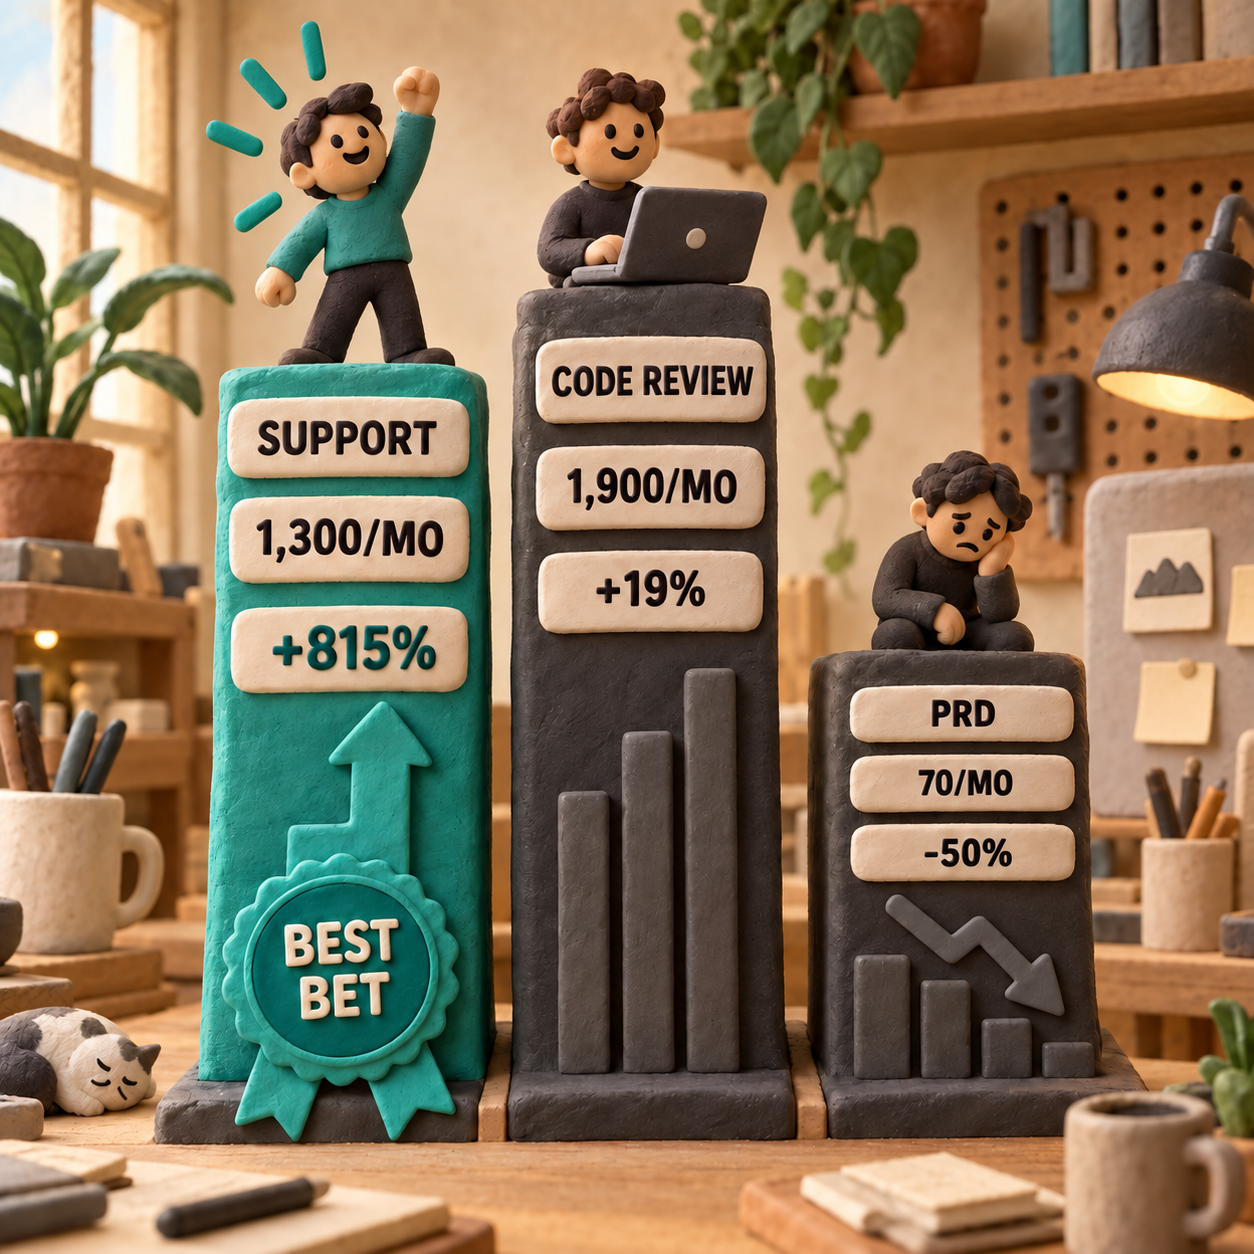
1. Smistamento dell'assistenza con evidenze: l'opportunità migliore
Crea un copilota per il supporto che trasformi ticket e dati dell'account in un riepilogo strutturato, associ ogni affermazione a un link verso la fonte, verifichi l'azione proposta rispetto alle regole e metta la bozza in coda per l'approvazione. I responsabili dell'assistenza e i fornitori di servizi esternalizzati pagherebbero per assegnazioni più rapide e coerenti.
La domanda è visibile: ai customer service agent registra 1,300 ricerche mensili negli Stati Uniti, intento commerciale e una crescita annua dell'815% nei dati sulle keyword di questa analisi. Intercom offre Fin a $0.99 per risultato. Il confronto con il riepilogo di una singola chiamata non è diretto, perché la risoluzione di un caso è un lavoro più ampio, ma dimostra che gli acquirenti accettano già l'automazione dell'assistenza basata sull'utilizzo.
La versione minima vendibile richiede un connettore per la casella di posta, uno per i dati dell'account, il riepilogo in quattro campi, citazioni delle fonti, un controllo delle regole e comandi per approvare o rifiutare. Il nodo è la fiducia, insieme all'integrazione. Se non puoi dimostrare da dove arriva una raccomandazione, i clienti manterranno il flusso attuale.
2. Un livello di code review che conosce le regole interne
Crea un'app GitHub che legga un diff insieme alle regole specifiche del team, quindi restituisca una revisione ordinata per rischio, le lacune nei test e un breve riepilogo per il merge. Gli acquirenti sono engineering manager e platform team.
ai powered code review platform registra 1,900 ricerche mensili negli Stati Uniti e una crescita annua del 19%. Il prezzo pubblico di CodeRabbit parte da $24 al mese per sviluppatore con fatturazione annuale; i piani superiori costano $48 e $72. L'MVP comprende un solo provider di repository, webhook per le pull request, controlli personalizzati, una vista per i commenti e un audit trail che mostri quale regola ha generato ogni rilievo.
Il mercato, però, è affollato. Un revisore generico non ha alcun vantaggio difendibile. Scegli una nicchia problematica, come i controlli sui rilasci regolamentati, la sicurezza delle migrazioni di dati o un framework specifico, e misura i falsi positivi con la stessa attenzione riservata ai difetti non rilevati.
3. Da briefing a PRD, purché sia verticale
Crea un flusso mirato che trasformi chiamate, vincoli e decisioni precedenti in un brief di prodotto con criteri di accettazione e questioni irrisolte. Una società di consulenza di prodotto o il team di un software verticale potrebbe acquistarlo, se il modello corrisponde al proprio modo di lavorare.
La query esatta ai product requirements document generator totalizza appena 70 ricerche mensili negli Stati Uniti ed è in calo del 50% su base annua. È un avvertimento, non un argomento di vendita. Un generatore di PRD generico e autonomo è l'opportunità più debole tra queste. La versione sostenibile è un componente inserito in un flusso di maggior valore, per esempio l'analisi iniziale di un'agenzia, un'implementazione in ambito sanitario o la gestione dei cambiamenti in azienda.
L'MVP parte da un pacchetto di fonti fisso, un unico modello ben caratterizzato, la tracciabilità delle decisioni e l'esportazione verso il sistema già usato dall'acquirente. Il limite è una domanda ridotta e un prodotto facile da copiare. Non costruirlo se non possiedi già la relazione con il cliente o un canale di dati verticale.
Il prezzo non cambia, ma il flusso può costare meno
Sonnet 5.5 costa $2 per milione di token di input, $10 per milione di token di output e $0.20 per milione di token letti dalla cache. Sono le stesse tariffe pubblicate per Sonnet 5. L'affermazione di Anthropic sul costo inferiore deriva dal minor numero di token impiegati per completare le attività.
La distinzione conta in una previsione. Una traccia più breve del modello può ridurre sia la latenza sia la spesa per i token anche se il listino resta invariato. Allo stesso tempo, il costo complessivo del prodotto può rimanere quasi identico se recupero dei dati, tool di terze parti, nuovi tentativi e revisione umana pesano più del modello. Misura il costo per risultato accettato, non quello per chiamata.
Gli abbonamenti all'app Claude e l'uso delle API sono prodotti separati. Il pagamento di Pro, Max, Team o Enterprise non include Claude Console né il consumo delle API. La guida ai piani Claude descrive i confini generali dei piani; un flusso basato sulle API richiede un proprio accesso alla Console e una fatturazione a consumo.
Migra il flusso Claude API solo dopo aver validato l'attività
L'ordine più sicuro per la migrazione è lineare: valida il prompt su esempi rappresentativi, fissa il nuovo ID del modello, imposta esplicitamente l'effort e solo dopo adegua il contratto per ragionamento e chiamate ai tool, prima di inviare traffico di produzione.
Per una richiesta semplice con adaptive thinking, ometti il campo thinking e leggi i blocchi di testo in base al tipo:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    output_config={"effort": "medium"},
    messages=[{
        "role": "user",
        "content": "Summarize this ticket as Issue, Impact, Evidence, and Next action.",
    }],
)

for block in response.content:
    if block.type == "text":
        print(block.text)
Quattro modifiche della migrazione richiedono un controllo esplicito.
thinking: {"type": "disabled"}non è più accettato dall'API Claude diretta di Anthropic. Usathinking: {"type": "between_tools"}quando non vuoi una fase di ragionamento iniziale. Funziona con Low, Medium e High, ma non con Xhigh o Max.- I valori forzati
anyetoolpertool_choicenon sono più accettati dall'API diretta. Usaauto, rendi rigoroso lo schema dove possibile e specifica nel prompt quando il tool deve essere eseguito. - Una risposta può iniziare con un blocco
thinking. Analizza ogni blocco di contenuto in base altype; non presumere mai checontent[0].textesista. - In un ciclo di tool, restituisci i blocchi di ragionamento senza modificarli. Contengono firme legate alla conversazione precedente, quindi mantieni la cronologia dei messaggi in sola append.
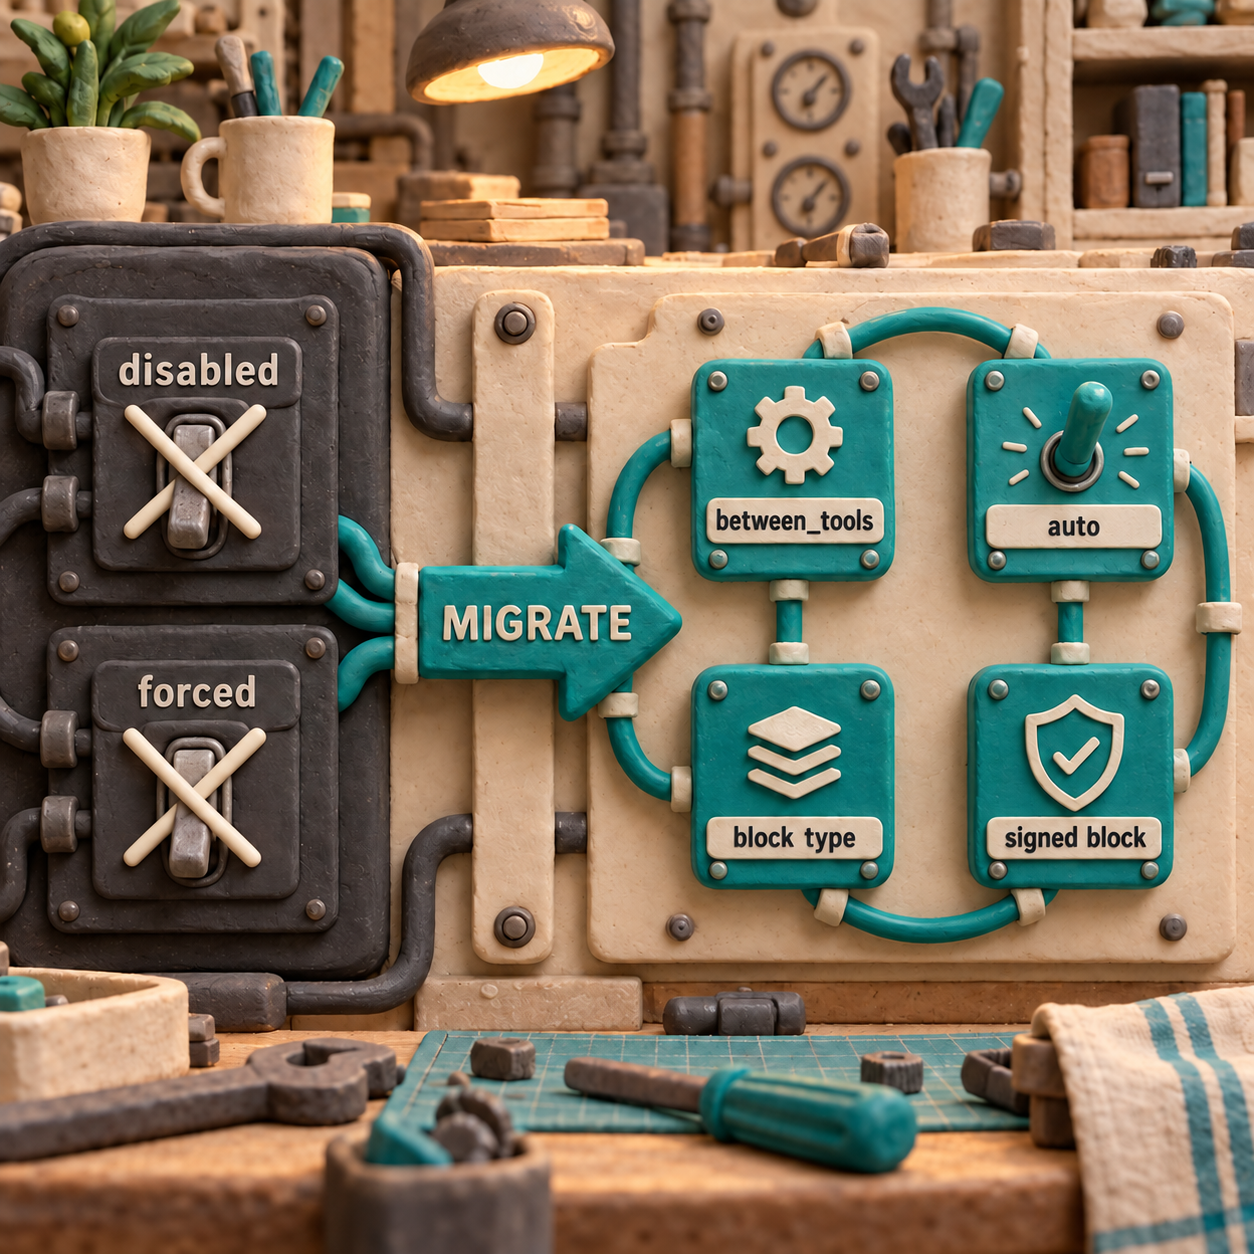
Questo schema minimo usa between_tools, mantiene tool_choice su auto e conserva per intero il turno dell'assistente:
tools = [{
    "name": "lookup_ticket",
    "description": "Look up a support ticket",
    "strict": True,
    "input_schema": {
        "type": "object",
        "properties": {"ticket_id": {"type": "string"}},
        "required": ["ticket_id"],
        "additionalProperties": False,
    },
}]

messages = [{"role": "user", "content": "Use lookup_ticket for T-42."}]
response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    thinking={"type": "between_tools"},
    output_config={"effort": "medium"},
    tools=tools,
    tool_choice={"type": "auto"},
    messages=messages,
)

# Keep every block, including signed thinking blocks, exactly as returned.
messages.append({
    "role": "assistant",
    "content": [block.model_dump() for block in response.content],
})

tool_call = next(block for block in response.content if block.type == "tool_use")
messages.append({
    "role": "user",
    "content": [{
        "type": "tool_result",
        "tool_use_id": tool_call.id,
        "content": "Ticket T-42 is open and assigned to Support Ops.",
    }],
})

follow_up = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    thinking={"type": "between_tools"},
    output_config={"effort": "medium"},
    tools=tools,
    tool_choice={"type": "auto"},
    messages=messages,
)
La guida alla migrazione di Sonnet 5.5 di Anthropic documenta gli errori 400 dell'API diretta e i campi sostitutivi. La mia richiesta locale con between_tools e Medium ha restituito HTTP 200 in 1.35 secondi. Un ciclo separato con adaptive thinking e tool ha prodotto un blocco di ragionamento firmato; il turno successivo è riuscito dopo averlo reinviato per intero e senza modifiche.
C'è un dettaglio importante. Le mie chiamate sono passate attraverso un gateway AI. Questo livello di compatibilità ha restituito HTTP 200 quando ho inviato intenzionalmente il vecchio valore disabled per il ragionamento e il valore forzato any per tool_choice, nonostante Anthropic documenti entrambi come errori dell'API diretta. L'accettazione da parte di un middleware non dimostra che l'integrazione diretta sia compatibile. Prima del passaggio, controlla la richiesta grezza nel Playground di Anthropic oppure esegui un test sull'endpoint diretto.
Cosa non risolve Sonnet 5.5
Non trasforma un'inferenza priva di riscontri in un fatto. Il test locale sull'assistenza lo ha dimostrato chiaramente. Pretendi riferimenti alle fonti per le affermazioni ad alto impatto e mantieni un passaggio di approvazione per rimborsi, modifiche agli account, impegni legali, decisioni mediche e interventi di sicurezza.
Non rende ogni attività adatta a Medium. Aumenta l'effort quando i tuoi esempi mostrano ragionamenti mancanti o lavori incompleti. Per attività aperte che richiedono capacità di giudizio prolungata, usa Opus; il confronto con Opus 5.5 spiega dove si colloca il modello di fascia superiore.
Non trasforma la semplice chiamata al modello in un prodotto. Connettori, autorizzazioni, controlli delle regole, valutazioni, osservabilità, comportamenti di fallback e un'interfaccia di revisione utile assorbono gran parte del lavoro necessario per arrivare in produzione.
Non elimina neppure la necessità di fonti aggiornate. Se una risposta di assistenza o ricerca dipende da ciò che oggi è consentito, obbligatorio o a pagamento, fornisci al modello un tool di ricerca o una base di conoscenza e chiedigli di controllare.
L'azione da fare lunedì
Scegli una coda con una fonte attendibile e ben definita. Lunedì, prendi 20 esempi recenti, rimuovi i dati privati non necessari ed esegui Sonnet 5.5 con effort Medium e un unico schema di output fisso. Valuta accuratezza fattuale, inferenze non supportate, completezza, tempo trascorso e consumo di token. Solo dopo che il prompt ha superato questa prova dovresti cambiare l'ID del modello in un'API esistente ed eseguire i controlli di migrazione descritti sopra.
Come si usa Claude Sonnet?
Nell'app Claude, fai clic sul nome del modello accanto al pulsante di invio, scegli Sonnet 5.5, seleziona l'effort Medium e parti da un'attività circoscritta il cui risultato sia verificabile. In Claude Code, esegui /model e scegli Sonnet 5.5, oppure avvia una sessione con claude --model claude-sonnet-5-5.
Per quali attività è più indicato Claude Sonnet 5?
Con l'attuale release Sonnet 5.5, inizia da lavori quotidiani ben definiti: riepiloghi di assistenza, briefing per clienti, correzioni di bug, code review e documenti aziendali rifiniti. Scegli un effort più alto o Opus quando l'attività è aperta e un errore sottile avrebbe conseguenze rilevanti.
Claude Sonnet è gratis?
Disponibilità e limiti dipendono dal piano Claude e dalle impostazioni dell'organizzazione. L'accesso all'app e la fatturazione delle API sono separati, quindi un abbonamento Claude a pagamento non include l'uso delle API. Consulta la guida ai piani collegata per conoscere i limiti attuali.
Quanto costa Claude Sonnet 5?
Claude Sonnet 5.5 costa $2 per milione di token di input, $10 per milione di token di output e $0.20 per milione di token letti dalla cache. Secondo Anthropic, può costare meno per attività completata rispetto a Sonnet 5 perché utilizza meno token, non perché le tariffe siano inferiori.
Se vuoi realizzare per la tua azienda un flusso Claude fondato su fonti verificabili, scopri i sistemi di AI per la produzione.
- Ultimo aggiornamento
- 28 set 2026
- Categoria
- AI
Preferisca questo sito su Google


Segni omidsaffari.com come fonte preferita e Google lo mette in evidenza per lei in Top Stories, AI Overviews e AI Mode.

Jev o GLM-5.3-Flash: quale scegliere per il routing AI?
Confronto tra Jev e GLM-5.3-Flash su costi, accuratezza, latenza, immagini e portabilità, con un test pratico per scegliere il workflow giusto.27 set 2026AI
Claude Opus 5.5: vale il passaggio da Opus 5?
Claude Opus 5.5 costa meno, ma cinque modifiche API possono davvero bloccare la migrazione. Prezzi, benchmark e percorso di test rispetto a Opus 5.23 set 2026AI
Quale modello GPT-6 scegliere: Sol o Luna?
Confronta GPT-6 Sol e Luna per prezzi API, qualità nel coding e costi di revisione. Scopri quando conviene partire da Luna e quando passare a Sol.23 set 2026AI
GPT-6 Luna gratis: dove usarlo e quanto costa davvero
GPT-6 Luna è gratis nell’app desktop per gli utenti Free e Go. Scopri dove funziona, quali piani lo includono e quanto costa davvero usare l’API.22 set 2026AI
MiMo AI V2.6: dalla prova in Studio alla prima API
Scopri come provare MiMo AI V2.6 in Studio, configurare chiavi e API corrette e portare in produzione un primo flusso di lavoro verificabile.22 set 2026AI
AI per programmare: MiMo V2.6 Pro o Flash?
Confronto tra MiMo V2.6 Pro e Flash per coding, agenti e UI: prezzi, benchmark e una regola pratica per scegliere il modello più conveniente.22 set 2026AI
MiMo V2.6 gratis? Accessi, licenza e costi reali
MiMo V2.6 è gratis solo in alcuni casi: ecco cosa offre OpenCode, cosa copre la licenza MIT e quanto costano le API Flash, Pro e UltraSpeed.22 set 2026AI