Claude Code 插件评测实战:用原生 Evals 验证行为变化
Claude Code 2.1.269 已原生支持插件评测。本文从创建行为用例、配置确定性 grader、读取 WITH/W/OUT/Δ 报告,到故意制造回归、控制成本并接入 CI,完整演示如何证明插件确实改变了 Claude 的行为,而不只是通过文件校验,并给出最值得优先测试的场景和两类产品机会。


现在,你可以通过 Claude Code 插件评测证明某个插件确实改变了 Claude Code 中 Claude 的行为,而不只是验证文件是否合规。原生 claude plugin eval 命令会让启用插件和未启用插件的两组会话处理同一个真实请求,分别评分并展示差异。这样一来,“这个 skill 好像触发了”不再是模糊的主观判断,而会变成一项有时间、轮次和用量预算依据的发布决策。
现在正是采用它的好时机。Claude Code 2.1.269 于 2026 年 9 月 11 日加入了插件 evals。目前,这个搜索主题下排在前列、带日期的教程仍在介绍自建 Python runner。如果你正在维护本地插件,最短路径已经变成原生流程:先初始化一个行为用例,分别对插件组和对照组运行,检查报告,再让 CI 拒绝你刚刚故意制造出的同类回归。
Claude Code 插件评测究竟测什么
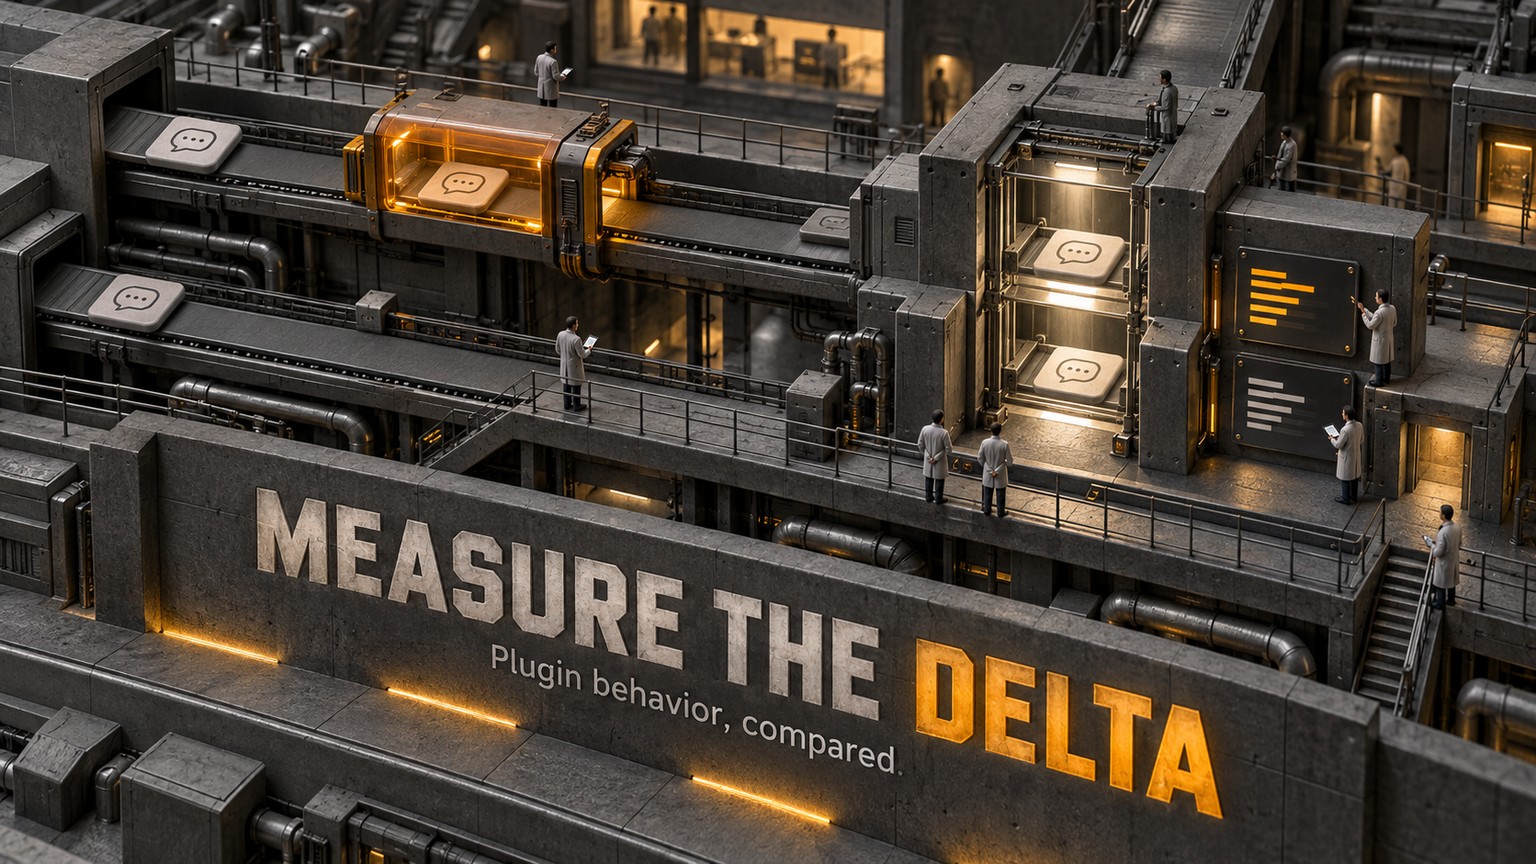
插件 eval 本质上是一次针对 Agent 行为的 A/B 测试。可以把它想成两个完全相同的工作间,同时收到同一张任务单:其中一个装有你的插件,另一个没有。Claude Code 会在两边重复执行任务、给结果打分,并报告 WITH、W/OUT 和 Δ;其中 Δ 等于启用插件后的得分减去未启用插件时的得分。
真正值得关注的是这个差值。两组都拿到 1.0 看似很理想,但这也说明,即使没有插件,Claude 本来就能完成任务。正 delta 代表插件带来了可测量的贡献;负 delta 则说明,插件反而让被测行为变差了。
默认情况下,一个用例会分别新建三次启用插件的会话和三次未启用插件的会话。每次会话都有相互隔离的 home、工作目录和 Claude Code 配置。你的个人设置、项目 CLAUDE.md、其他插件、memory 以及个人 MCP server 都不会被带入。隔离让比较更干净,也意味着暗中依赖你本机环境的插件会以合理的方式失败。Anthropic 的插件 eval 文档完整说明了隔离与安全约束。
先准备一个可正常运行的本地插件
行为 eval 是第二道检查,不是第一道。插件目录中必须有 plugin.json、.claude-plugin/plugin.json,或符合要求的 skills 目录结构。文件或 schema 有问题时,使用 claude plugin validate;要回答“这个 skill 能否在自然请求下触发,并按团队格式输出”之类的问题,则使用 claude plugin eval。
你还需要 Claude Code v2.1.269 或更高版本,以及日常会话所使用的同一套身份验证。Eval 会话、judge grader 和交互式初始化器都会消耗套餐额度或产生 API 费用。如果整套 Claude Code 环境还在搭建阶段,建议先从基础本地工作流开始,再添加发布门禁。
在可信插件的根目录中,先检查版本并创建一个空白用例:
claude --version
claude plugin eval init --bare release-note
也可以使用交互式命令 claude plugin eval init。它会读取插件,询问什么样的结果才算合格,生成用例和 grader,试跑一次,然后写入整套测试。若想先弄清文件约定,--bare 更合适,因为它只创建文件,不执行任何测试。
从一个容易看懂的行为用例开始
假设这个可用插件里有一个名为 release-notes 的 skill。它的价值不只是写出一段文案,还应该能识别自然语言描述的产品变更请求,并按团队规定的三段式结构输出:Summary、Impact 和 Risk。
把用户的真实请求写进 prompt.md,然后分别为结果和执行机制添加一个确定性 grader。所谓“确定性”,是指 CLI 直接检查 trace 或文本,不会调用 judge 模型。
# evals/release-note/prompt.md
---
name: release-note
tags: [smoke]
runs: 3
max_turns: 8
timeout_seconds: 180
allowed_tools: [Skill]
---

Turn this change into a customer-facing release note: checkout now retries a failed payment once before showing an error.

# evals/release-note/graders/format.md
---
type: regex
target: last_message
pattern: 'Summary[\s\S]*Impact[\s\S]*Risk'
flags: i
---

# evals/release-note/graders/skill-fired.md
---
type: tool_used
tool: Skill
input_match: '"skill"\s*:\s*"(?:[\w-]+:)?release-notes"'
---
请把 release-notes 替换为该 skill 的 SKILL.md 中实际填写的 name。这里的 prompt 有意不点名 skill,也不直接要求三个标题;这样才能检验插件是否会识别任务并主动贡献规定格式。如果 prompt 已经把所有答案都写明,未启用插件的对照组也可能通过,此时 delta 只会告诉你插件的增益很小。
这段 frontmatter 就是当前的原生 schema。在 prompt.md 中,runs、max_turns、timeout_seconds、model、tags 和 allowed_tools 等字段都放在顶层。如果需要 fixture、对话历史或目录,则添加 case.yaml;这个文件必须包含 schema_version: "1.1" 和 name,并把执行字段移到 execution: 下。
运行测试并读懂报告
在插件根目录运行 claude plugin eval .。对于这个单一用例,命令会启动三次启用插件的会话,以及三次 baseline 会话。每次会话结束后,进度行都会显示 grader 结果;最后的摘要会给出 WITH、W/OUT、Δ、RUNS、COST 和 NOTES。
建议按以下顺序阅读:
WITH:启用插件的会话是否满足 grader。W/OUT:Claude 在没有插件时,有多大概率也能达到同一结果。Δ:插件贡献了多少。正值有意义,接近零就要继续排查,负值代表回归。COST:按标价计算的估算值,不一定等于订阅方案下实际收取的金额。NOTES:指向启用插件分支里权重最高的失败项或运行错误。
只要 suite 至少包含一个用例,就会在带时间戳的结果目录中写出 aggregate-result.json 和一份可独立打开的 report.html。HTML 报告可以逐次查看运行记录、每个 grader 的判定和解释,还能对照 prompt、grader 定义与 Claude 的实际执行。JSON 则提供适合 CI 稳定读取的字段,包括总分、通过的用例数、平均 delta、partial 状态、成本估算、耗时和 Claude Code 版本。
先制造一次回归,再相信这套测试
现在要证明这套测试真的会失败。暂时把 release-notes skill 的描述改成一段模糊文字,不再说明它应该识别的任务。不要修改 eval 用例。重新运行同一条命令,检查新报告,然后恢复原本的描述。
你要观察的是行为层面的失败:Skill grader 不再通过,预期格式变得不稳定,或者启用插件后的优势缩小。不要预设具体分数,因为 Agent 每次运行都会波动。如果在默认的三次运行中,故意破坏后的报告几乎毫无变化,说明这个用例还保护不了插件。可以把请求改得更贴近真实场景、收紧结果 grader,或者补一个不得触发该 skill 的负向用例。
这种故意破坏就像按下烟雾报警器的测试键。只有确认相关故障确实能让面板转红,持续显示绿色才有意义。
增加用例前,先算清循环预算
一个默认用例已经会创建六次 Agent 会话。再加一个 LLM grader,同一用例还会新增十八次 judge 投票,也就是六次会话各投三票。会话本身又可能持续多个轮次,因此,一套看似很小的 suite,实际用量也可能远高于用例数量给人的直觉。
可以用三档预算分别服务三类决策:
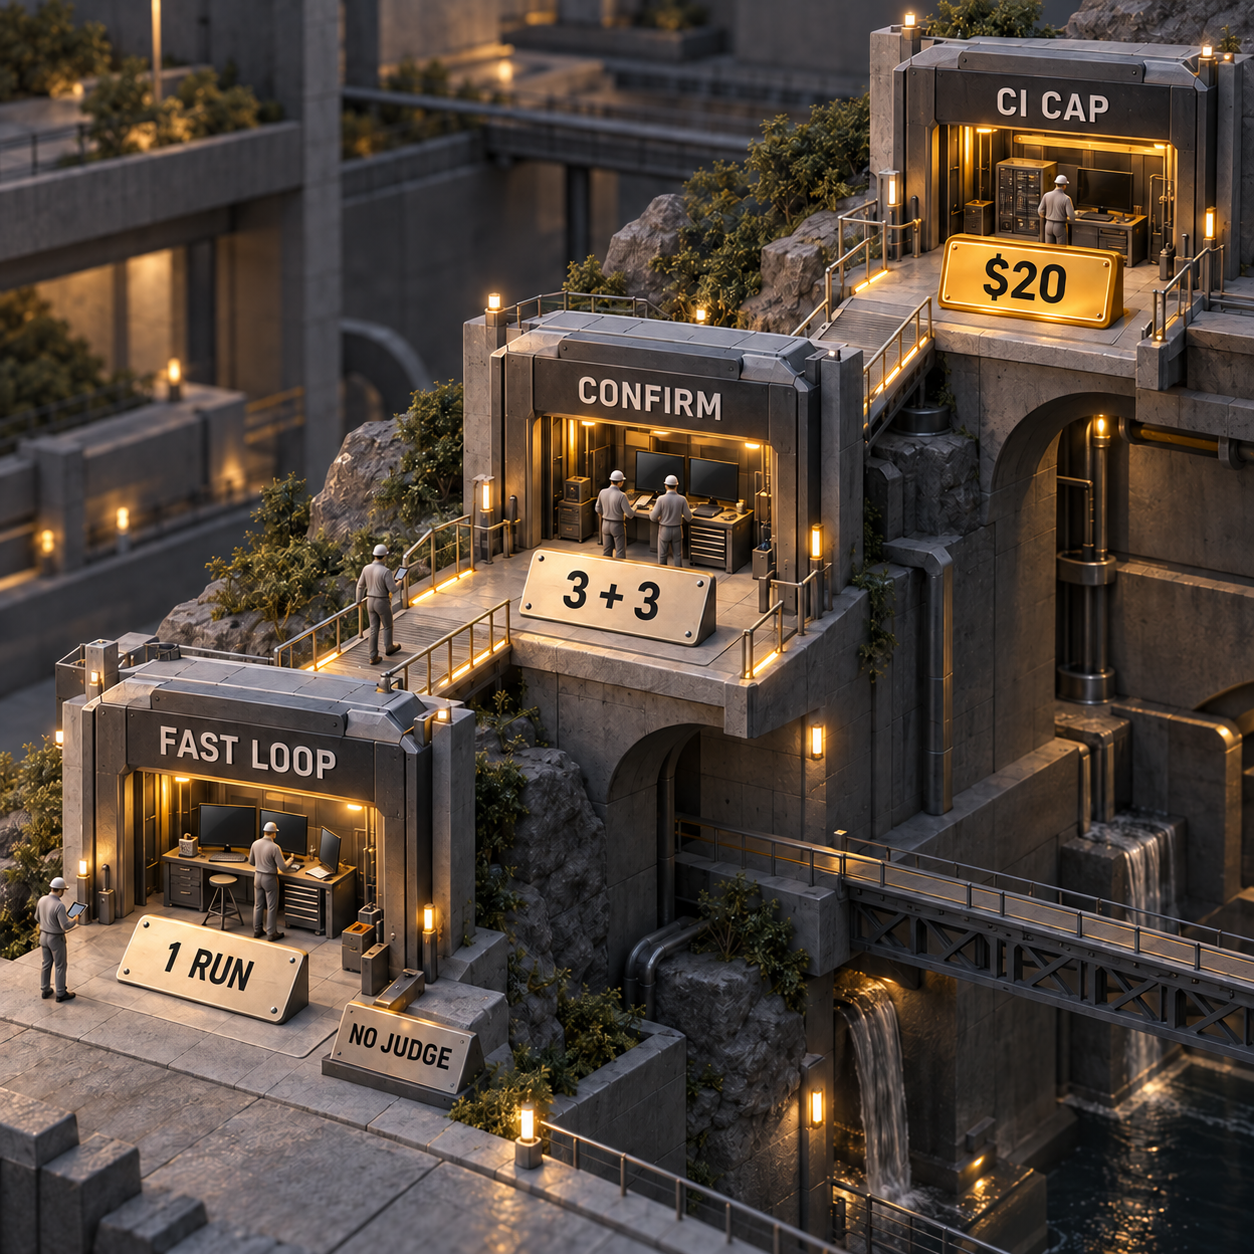
单次运行的循环天生噪声较大。可以用它发现明显错误,但在接受变更前,仍应按默认值运行三次进行确认。频繁检查时优先使用 regex、tool_used、tool_order 和 file_exists,因为这些 grader 不会增加 judge 调用。只有在质量无法用稳定规则表达时,才值得为简短结果使用 LLM grader。
成本参数还需要特别说明。--max-cost-usd 会在每次运行开始前,按 CLI 的标价估算值限制支出。已经开始的运行仍会完成,因此最终报告的估算值可能超过上限。触及上限会留下 partial 结果,并以退出码 2 结束。它是一道护栏,不是预付钱包。
把回归检查交给 CI
确认故意制造的回归能被发现、恢复后的插件可以通过后,就把同一套 suite 纳入版本控制。Anthropic 的 CI 示例会固定 Agent 与 judge 模型,把结果写入 results.json,使用 0.8 的 threshold,把报告留在本地,并设置 $20 的估算成本上限。示例还传入了 --trust-plugin;只有当检出的插件和 suite 都是你本来就愿意运行的代码时,这样做才合适。
完整的交接命令是 claude plugin eval . --trust-plugin --json results.json --threshold 0.8 --model claude-sonnet-5 --judge-model claude-haiku-4-5 --no-publish --max-cost-usd 20。安装 Claude Code 并完成身份验证后,把这条命令放进 CI job,再归档两个结果文件。
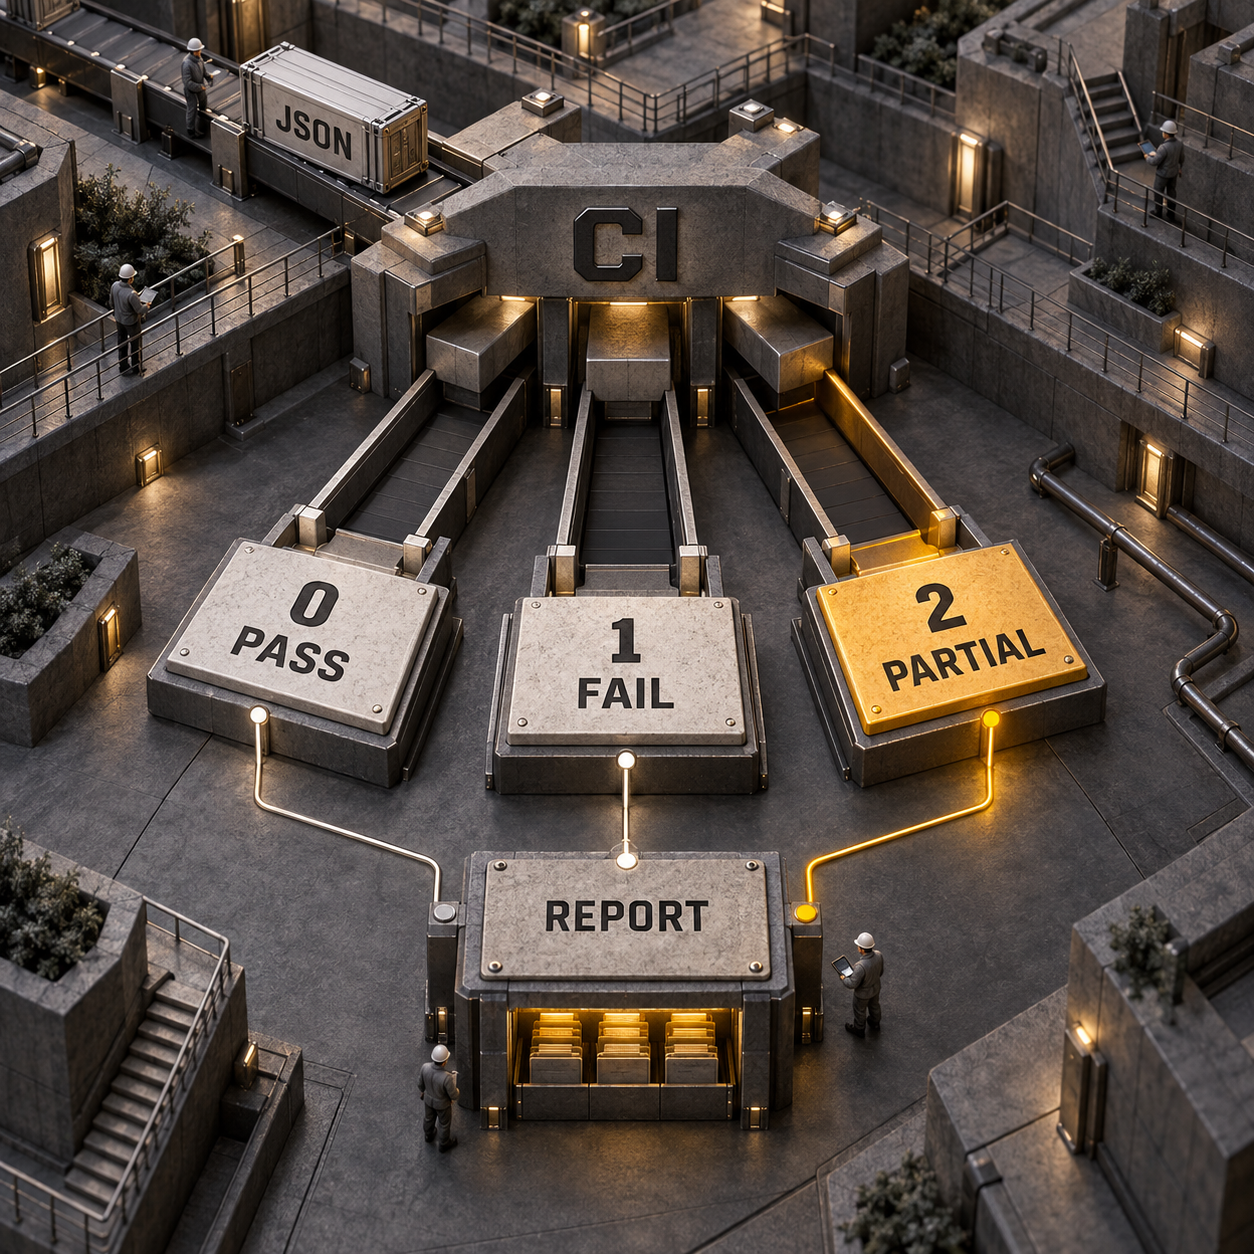
命令的退出状态足以充当构建门禁。退出码 0 表示所有用例都已加载并达到 threshold;退出码 1 既可能代表得分低于 threshold,也涵盖若干设置错误;退出码 2 则表示成本上限造成了 partial 运行,或首次凭证校验被拒绝。即使失败,也要归档 results.json 和 report.html,这样作者才能分清是插件回归、运行超时,还是预算中止。
固定模型很重要,否则一次模型更新也可能看起来像插件回归。推理支出同样要分开管理:应当把测试质量和 effort 拆成两条轨道,避免成本变化混进行为得分。
最值得优先测试的七类插件行为
收益最高的是那些向其他人分发插件的团队。私人助手尚可容忍手动检查;但对于 marketplace 或组织级插件,一条薄弱的描述、一次错误的工具授权或一项输出变化,都会持续转化为支持成本。
先从两项“一旦消失,用户最容易察觉”的行为开始。十个模糊用例,不如一个能复现缺陷的触发测试加一个结果测试。
围绕原生插件 eval,最值得做的两类产品
1. 最有机会的是拉取请求 delta 门禁
可以做一款轻量 CI 产品:运行原生命令,读取 aggregate-result.json,然后在拉取请求中发布一条 review,集中展示得分变化、delta、成本、失败的 grader,以及已归档报告的链接。插件团队和 marketplace 维护者愿意付费的是决策层,而不是又一套 evaluator。
这个需求仍处于早期,但商业信号很明确。claude code evals 在美国每月约有 50 次搜索,同比上涨 600%,CPC 为 $17.61。更广义的评估平台也证明了市场确实存在质量预算:Braintrust 的 Pro 方案定价为每月 $249。这是品类价格锚点,并不等于插件封装层的定价建议。
最小可售版本可以是一项 GitHub Action 加一条拉取请求评论。它接收插件路径、threshold、固定模型和估算成本上限,上传原生 JSON 与 HTML,并区分退出码 1 和代表 partial 的退出码 2。需要警惕的是平台风险:Anthropic 完全可能加入第一方拉取请求报告。真正具备防御力的部分,是跨仓库策略、历史对比和审批规则,而不是给原生报告换一层更漂亮的界面。
2. 精选 eval 套件可以服务 skill 作者
还可以为代码审查、changelog 编写、事故分诊和安全工具选择等常见插件任务,销售持续维护的用例包。一个 pack 就是普通的 evals/ 目录,其中包含真实的正向与负向 prompt,以及确定性 grader;团队可以基于它调整,而不必从零发明质量标准。
精准关键词 claude code skill evals 在美国每月约有 10 次搜索。这个量很小,因此它更适合做专注的附加产品,而非独立的风险投资型市场。MVP 应该只针对一个高价值插件品类,提供一套出色的 pack:随 Claude Code 版本维护,并附上一份简短的校准指南。挑战同样清楚:claude plugin eval init 已经能提出并试跑用例。只有当 pack 的领域场景和失败标准优于通用生成时,它才有胜算。
这条命令解决不了什么
原生 eval 无法证明一个插件在所有情况下都足够好。它只能证明:在你选定的 prompt、环境、模型、工具授权和 grader 条件下,插件表现如何。薄弱的 prompt 会制造讨喜的高分;regex 可能奖励正确的标题,却忽略错误的内容;LLM judge 本身会波动,而且每个 grader、每次运行都要增加三次投票。
隔离也是一项必须正视的约束。每次运行都会从干净环境开始,因此项目文件、用户设置、hook 和个人 server 都不存在。这非常利于复现,却会让忘记声明 fixture 的用例无法运行。只读工具集之外的工具,需要通过命令行显式授权。真实的插件 MCP server 还要额外 opt-in 和授权;hook 与真实 server 可能在 Agent sandbox 之外执行,因此更适合放在隔离 runner 中。
最后,不要把 max_turns 或 timeout_seconds 压缩到正常任务也会撞上上限。运行一旦超时或达到轮次限制,就会被记作错误,通常还会拉低分数。先为目标任务留出足够空间,再用估算成本上限控制整套 suite。
如何用 evals 测试 Claude Code 插件?
在 Claude Code v2.1.269 或更高版本中,进入一个可正常运行的插件根目录,执行 claude plugin eval init 生成 suite,或用 claude plugin eval init --bare <name> 创建空白用例。把真实 prompt 和 grader 放到 evals/ 下,再运行 claude plugin eval .,并在摘要与报告中比较 WITH、W/OUT 和 Δ。
Claude Code evals 是什么?
它们是一组重复执行、相互隔离的 Claude Code 会话,结果由确定性 grader 或模型 judge 评分。插件 eval 默认还会加入未启用插件的对照组,因此,你衡量的是插件是否改善了结果,而不只是 Claude 最终有没有完成任务。
Claude Code skill evals 如何工作?
先用用户日常会说的话写 prompt,再同时检查结果,以及 Skill 工具是否调用了目标 skill。如果 skill 触发但结果失败,说明它的指令需要改进;如果没有插件也能取得同样结果,这个 skill 在该用例中的可测量增益可能很小。
下周一,一位插件维护者可以先添加一个触发用例,故意让它失败,再恢复插件,并在 CI 中为这项检查设置上限。如果你希望在团队的所有插件中搭建这套发布体系,我可以帮你设计生产级门禁。
- 最近更新
- 2026年9月12日
- 分类
- Build
在 Google 中优先显示本站


把 omidsaffari.com 设为优先来源,Google 会在 Top Stories、AI Overviews 和 AI Mode 中为您优先展示。
AI Agent 怎么选?2026 年 8 款无代码智能体工具对比
2026 年 AI Agent 怎么选?对比 Gumloop、MindStudio、Lindy、n8n 等 8 款平台的适用任务、入门价格、免费方案与计费方式,分清席位、积分和执行次数的差别,说明团队协作、审批和 Zapier 迁移的限制,以及何时需要 API 或代码,帮助创业者按连接能力、权限与维护责任选工具。2026年10月1日Build
Lovable pricing 价格详解:套餐、点数与月度预算怎么算
Lovable pricing 怎么算才不超预算?拆解 Free、Pro 与 Business 的月费、年付费用、每日构建额度、Cloud 与应用内 AI 用量,解释共享点数、充值价格和到期规则。用采购工具的月度预算看何时能以 $25 完成构建和运行、何时需要 $50 的 Business,以及何时升级点数档位更划算。2026年10月1日Build
Codex CLI 安全扫描指南:打通 Cloud、PR 审查与 CI
Codex CLI 如何接入代码安全扫描?本文串起 Security Cloud 仓库扫描、PR 安全审查、本地提交前检查与 CI 的配置流程,列明五人 Business 团队的 USD 成本、Gogs 漏洞研判案例、SARIF 报告和退出码,并说明扫描用量、覆盖范围及依赖、密钥检查和人工审查仍需如何安排。2026年9月30日Build
LearnWorlds pricing 2026:Pro 方案何时更省钱
LearnWorlds pricing 从每月 $29 起。本文按学员、报名费、访问权限和 AI 积分,计算 Starter、Pro Trainer 与 Learning Center 的真实成本,找出私密培训、50 人入职学院和每月 20 个付费报名分别该选哪档,并给出试用期测算人工审核成本的方法。2026年9月30日Build
Notion AI 与 ChatGPT Space 怎么选:协作文档还是项目系统
Notion AI 与 ChatGPT Space 该怎么选?本文从共享文档、项目数据库、智能代理、权限、迁移成本和团队定价逐项拆解,说明两者在移动端编辑、导出、结构化字段与协作交接上的差异,帮助团队判断该把 Space 当作文档层,还是继续用 Notion 作为项目事实来源,再通过可回退的发布简报实测后决定是否迁移。2026年9月30日Build
Kitesurf WebMCP 实战指南:连接、执行与验证
这份 Kitesurf WebMCP 使用指南讲清如何通过 Chrome DevTools MCP 连接 Cloudflare Browser Run,发现并执行网页工具,再用页面状态验证结果;同时梳理 iframe、弹窗、人工确认等关键限制,并给出生产环境必需的备用路由、安全检查和可重复测试记录方法。2026年9月30日Build
OpenAI Dots 免费吗?套餐价格、试用规则与真实成本
OpenAI Dots 免费吗?本文梳理 ChatGPT 各套餐的 Dots 使用资格、Pro 100 每月 $100 的个人起步价、Business Premium 团队成本、上线后一个月的用量豁免、地区与桌面端限制,并解释为何 OpenAI 尚未公布优惠期后的用量条款,帮助个人与团队判断现在试用还是继续等待。2026年9月29日Build