GPT-6.1 Sol Vergleich: Lohnt sich das Upgrade?
Der GPT-6.1 Sol Vergleich zeigt Preise, Benchmarks und API-Unterschiede – und wann sich das Upgrade gegenüber GPT-6 Sol für produktive Workflows lohnt.



Der GPT-6.1 Sol Vergleich mit GPT-6 Sol zeigt ein Upgrade, das zuerst getestet werden sollte: Cache-intensive Agenten auf Basis der Responses API können zu GPT-6.1 Sol wechseln. GPT-6 Sol bleibt sinnvoll, solange Tool-Calling über Chat Completions oder die Reasoning-Stufe none eine Migration verhindert. Beide kosten $2 für Eingaben und $10 für Ausgaben je Million Token; lediglich gecachte Eingaben werden günstiger, von $0.20 auf $0.10.
GPT-6.1 Sol Vergleich: Welches Modell passt?
GPT-6.1 Sol ist die bessere Wahl für kompatible Workloads mit der Responses API, die lange Prompt-Präfixe wiederverwenden oder ein leistungsfähigeres Modell für Programmierung, Computernutzung, Dokumentenarbeit und mehrstufige Geschäftsprozesse benötigen. GPT-6 Sol sollte bleiben, wenn die Anwendung auf Function Calling über Chat Completions oder reasoning_effort: none angewiesen ist. Das sind keine nebensächlichen Konfigurationsdetails. Sie entscheiden darüber, ob nur eine Modell-ID oder der gesamte Anfragepfad geändert werden muss.
Je nach Ausgangslage fällt die Entscheidung eindeutig aus:
- Bestehender Responses-API-Agent mit mindestens mittlerer Reasoning-Stufe: GPT-6.1 Sol jetzt testen. Das Modell bietet den niedrigeren Preis für Cache-Lesezugriffe und zum Start die stärkeren Leistungssignale.
- Function Calling über Chat Completions: Nicht einfach zuerst die Modell-ID austauschen. Zunächst den Tool-Pfad auf Responses umstellen, Regressionstests durchführen und anschließend die Modelle vergleichen.
- Workload mit Reasoning-Stufe
none: Bei GPT-6 Sol bleiben, bis mindestenslowakzeptabel ist; bei GPT-6.1 Sol istmediumdie Standardeinstellung. - Überwiegend neue Eingaben und Ausgaben: Bei den Token-Preisen gibt es keine Ersparnis. Beide Modelle verlangen für neue Eingaben, Cache-Schreibvorgänge und Ausgaben dieselben Preise. Der Wechsel muss sich daher durch bessere Ergebnisse rechtfertigen.
Die Entscheidungsregel ist einfach: Nur dann wechseln, wenn GPT-6.1 Sol nach bestandener Kompatibilitätsprüfung mehr akzeptierte Ergebnisse liefert. Ein niedrigerer Cache-Preis ist nützlich. Ein fehlgeschlagener Tool-Aufruf, eine veränderte Mindeststufe beim Reasoning oder ein zusätzlicher Versuch kann die Ersparnis jedoch schnell aufzehren.
GPT-6 Sol vs. 6.1 Sol: Preise im Vergleich
Beim Preis liegt GPT-6.1 Sol nur dann vorn, wenn Anfragen tatsächlich Cache-Lesezugriffe erzeugen. Die Preise für neue Eingaben, Cache-Schreibvorgänge und Ausgaben bleiben unverändert.
Die Preise wurden am 30. September 2026 mit den aktuellen Modellseiten von OpenAI für GPT-6.1 Sol und GPT-6 Sol abgeglichen.
Auf 1,000 Token heruntergerechnet kosten bei beiden Modellen neue Eingaben $0.002, Cache-Schreibvorgänge $0.0025 und Ausgaben $0.01. Ein Cache-Lesezugriff kostet bei GPT-6.1 Sol $0.0001 und bei GPT-6 Sol $0.0002. Bei diesen Preisen gibt es kein Volumen, ab dem GPT-6 Sol günstiger wird: Jeder Cache-Lesezugriff verschiebt die Token-Rechnung zugunsten von GPT-6.1 Sol. Ohne gecachte Eingaben herrscht Gleichstand.
Cache-Preise von GPT-6.1 Sol
Der Preis für gecachte Eingaben ist 50% niedriger. Die Gesamtkosten einer Aufgabe sinken aber weniger stark, weil sich nur eine Kostenkomponente ändert. Eine gecachte Eingabe ist ein unverändertes Prompt-Präfix, das das Modell wiederverwenden kann. Laut OpenAI-Leitfaden zum Prompt-Caching muss dieses Präfix bei GPT-5.6 und neueren Modellen mindestens 1,024 sichtbare Eingabe-Token umfassen. Eine fortlaufende Sitzung garantiert noch keinen Cache-Treffer.
Auch der Preis für Cache-Schreibvorgänge ist genau zu lesen. Er ist ein alternativer Preis für Eingabe-Token und keine zusätzliche Gebühr, die auf einen weiteren Eingabepreis aufgeschlagen wird. Beide Modelle berechnen $2.50 je Million geschriebener Token. GPT-6.1 Sol ändert den Preis für spätere Lesezugriffe, nicht die Kosten für das Anlegen des wiederverwendbaren Präfixes.
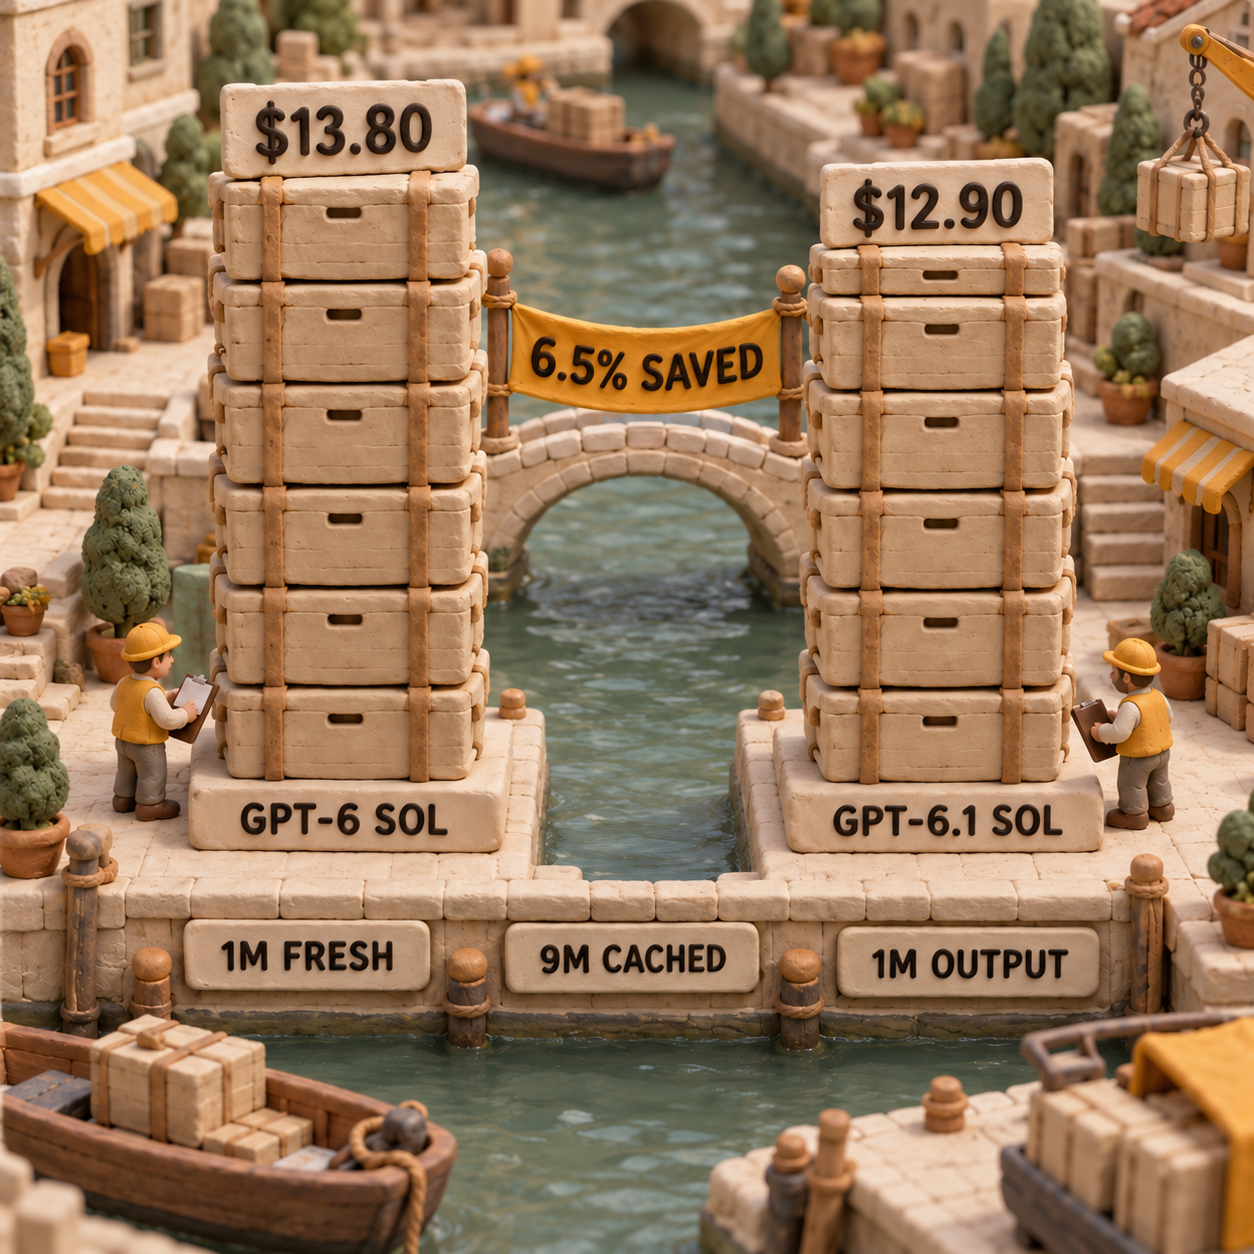
Ein Beispiel: ein Batch mit kurzem Kontext, 1 Million neuen Eingabe-Token, 9 Millionen gecachten Eingabe-Token und 1 Million Ausgabe-Token:
- GPT-6 Sol: (1 x $2.00) + (9 x $0.20) + (1 x $10.00) = $13.80
- GPT-6.1 Sol: (1 x $2.00) + (9 x $0.10) + (1 x $10.00) = $12.90
Das entspricht einer Ersparnis von $0.90 beziehungsweise 6.5%, bevor Cache-Schreibvorgänge und Tool-Gebühren berücksichtigt werden. Es handelt sich um eine Preisberechnung, nicht um einen ausgeführten Workload oder eine tatsächlich beobachtete Rechnung.
Die Beispielrechnung setzt außerdem voraus, dass jede Anfrage höchstens 272,000 Eingabe-Token umfasst. Oberhalb dieser Schwelle wird laut beiden Modellseiten die gesamte Anfrage mit 2x Eingabe- und Cache-Preis sowie 1.5x Ausgabepreis abgerechnet. Ein Batch kann insgesamt Millionen Token enthalten, ohne die Schwelle zu überschreiten, wenn er aus kleineren Anfragen besteht. Entscheidend ist jede einzelne Anfrage.
Bei einem vorhandenen Agenten sollten zunächst cached_tokens und die Token für Cache-Schreibvorgänge gemessen werden, statt sie aus der Prompt-Länge zu schätzen. Der Leitfaden zur Diagnose des Prompt-Cachings bei GPT-6 zeigt, wie eine geringe Cache-Trefferrate von einem Modellpreisproblem unterschieden wird.
Sieger: GPT-6.1 Sol bei Cache-intensiven Workloads. Gleichstand bei Workloads ohne Cache-Lesezugriffe.
GPT-6.1 Sol Benchmarks
Bei der zum Start belegten Leistungsfähigkeit liegt GPT-6.1 Sol vorn. Allerdings stammen die Nachweise von OpenAI und nicht aus einem unabhängigen Direktvergleich. Dieser Unterschied ist wichtig, denn System-Prompts, Tool-Zugriff, Reasoning-Stufe und Wiederholungsstrategie können sowohl das Ergebnis als auch dessen Kosten verändern.
Der Startbericht von OpenAI nennt fünf aussagekräftige Signale im Vergleich zu GPT-6 Sol:
- Programmierung: GPT-6.1 Sol übertraf den besten DeepSWE-v1.1-Wert von GPT-6 Sol bei geringerer Reasoning-Stufe und niedrigeren Kosten um 6.4 Prozentpunkte.
- Geschäftsprozesse: Bei AutomationBench 1.0.6 erzielte es unter derselben Einstellung 4.8 Prozentpunkte mehr.
- Computernutzung: Im Offline-Datensatz von OSWorld 2.0 legte es bei maximaler Reasoning-Stufe um 7 Prozentpunkte zu, bei weniger als der Hälfte der Kosten je Aufgabe.
- Wissenschaftliche Workflows: Bei maximaler Reasoning-Stufe erreichte es in Terminal-Bench Science 0.1 mehr als das Doppelte des Werts von GPT-6 Sol, ebenfalls bei weniger als der Hälfte der Kosten je Aufgabe.
- Faktentreue: Bei bewusst schwierigen Prompts und niedriger Reasoning-Stufe sank der Anteil der Antworten mit mindestens einem sachlichen Fehler von 11.4% auf 7.7%. Das entspricht einer relativen Verringerung um rund 32%.
Das sind vielversprechende Unterschiede, aber keine pauschale prozentuale Verbesserung. OpenAI weist darauf hin, dass die GPT-Evaluierungen in der eigenen Forschungsumgebung oder über die eigene API liefen und von Ergebnissen im produktiven ChatGPT abweichen können, weil Prompts, Tools und Reasoning-Stufen unterschiedlich sein können. Am 30. September 2026 lag kein unabhängiger, direkt vergleichbarer Benchmark für beide exakten Modell-IDs vor. Ein externer Wert sollte daher keine Workload-spezifische Freigabeprüfung ersetzen.
Die Aussagekraft eines Benchmarks hängt stärker vom Einsatzzweck ab, als eine Überschrift vermuten lässt. DeepSWE ist für Teams relevant, die einem Agenten lang laufende Aufgaben in einem Repository übertragen. AutomationBench betrifft Betreiber, die Tools für Vertrieb, Marketing, Support, Finanzen oder Personalwesen verketten. OSWorld zählt, wenn das Modell Computeranwendungen steuert. Keiner dieser Benchmarks belegt eine Verbesserung bei einem zweistufigen Support-Klassifikator, einem kurzen Textlektorat oder einer privaten Codebasis.
Sieger: GPT-6.1 Sol nach der aktuell verfügbaren Leistungsbewertung. Vertrauensniveau: Herstellerangaben, bis unabhängige Ergebnisse für genau dieses Modellpaar vorliegen.
GPT-6.1 Sol vs. GPT-6 Sol: Technische Daten
Der operative Rahmen ist bei beiden Modellen fast identisch. Beide bieten ein Kontextfenster mit 1,050,000 Token, maximal 128,000 Ausgabe-Token, Text- und Bildeingaben, Textausgaben, strukturierte Ausgaben, Streaming und dieselbe Tool-Oberfläche in Responses. Laut den Modellseiten unterstützt keines der Modelle Audio- oder Videoeingaben; auch Fine-Tuning wird nicht unterstützt.
Bei GPT-6.1 Sol verschiebt sich der dokumentierte Wissensstichtag vom 20. auf den 30. April 2026. Zehn Tage sind kein Grund für eine Migration. In den meisten Produktivsystemen sind die Qualität des Retrievals, privater Kontext und korrekte Tools deutlich wichtiger als dieser kleine Datumsunterschied.
GPT-6.1 Sol: Der neue Standardkandidat
GPT-6.1 Sol ist das neuere OpenAI-Modell für komplexe Aufgaben und trägt die exakte API-ID gpt-6.1-sol. Es unterstützt die Reasoning-Stufen low, medium, high, xhigh und max; medium ist die Standardeinstellung. Die Standardpreise je Million Token betragen $2 für neue Eingaben, $0.10 für gecachte Eingaben, $2.50 für Cache-Schreibvorgänge und $10 für Ausgaben.
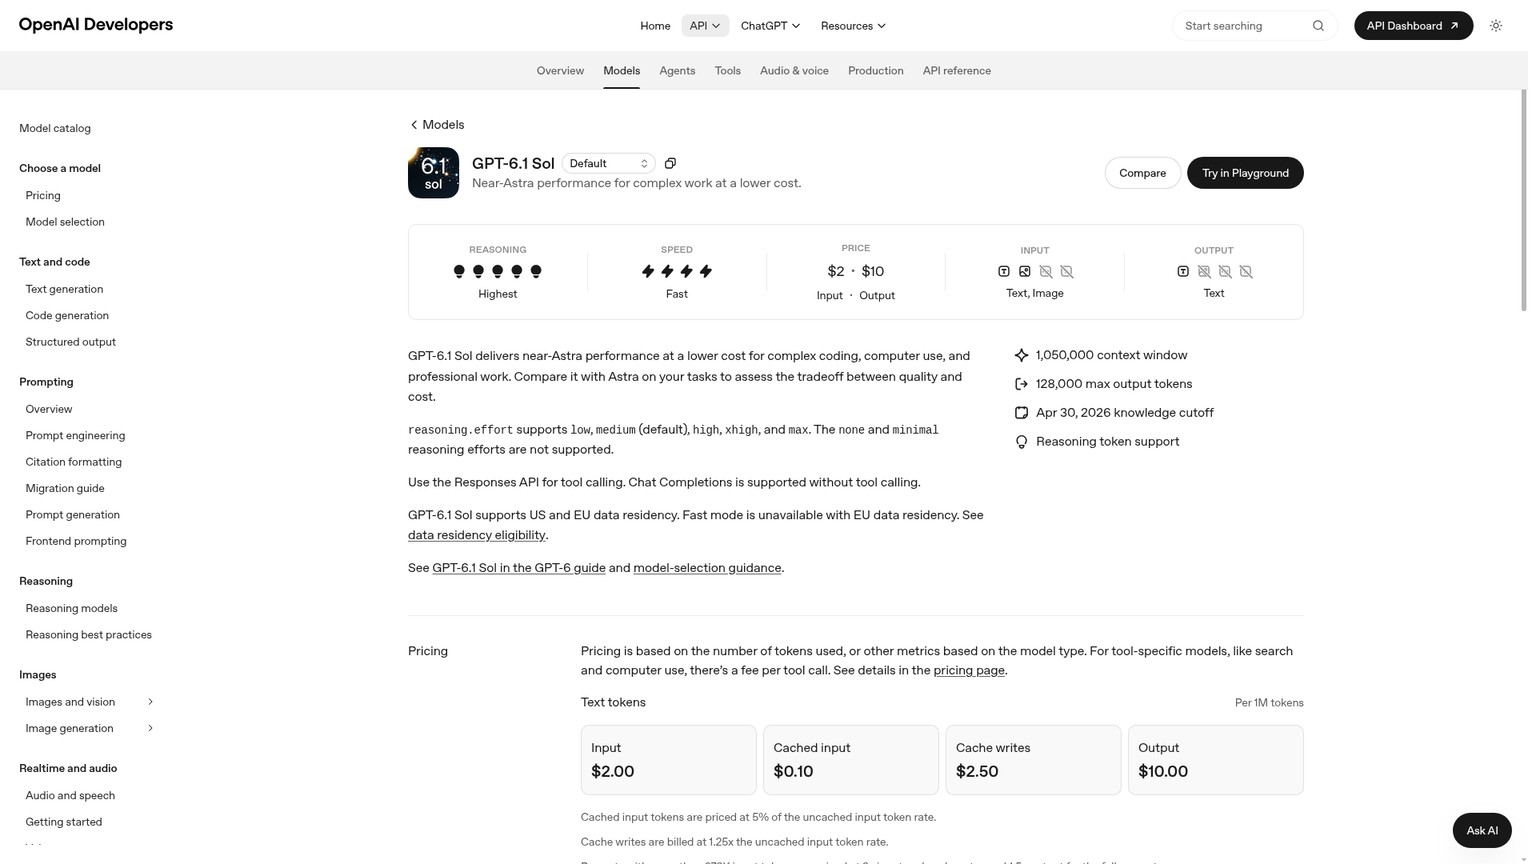
Die Modellseite nennt Websuche, Dateisuche, Bilderzeugung, Code Interpreter, Hosted Shell, Apply Patch, Skills, Computernutzung, MCP und Tool Search über Responses. Das Modell passt, wenn dieser API-Pfad bereits eingesetzt wird und die Aufgabe den stärkeren Signalen bei Programmierung, Dokumentenarbeit, Computernutzung oder Workflows ähnelt. Von einem sofortigen Wechsel des Standardmodells ist abzusehen, wenn noch ein unabhängiger Akzeptanztest fehlt oder eine nicht mehr unterstützte Reasoning-Stufe benötigt wird.
GPT-6 Sol: Die kompatible Übergangslösung
GPT-6 Sol bleibt unter gpt-6-sol verfügbar. Es unterstützt die Reasoning-Stufen none, low, medium, high, xhigh und max. Die Standardpreise je Million Token bleiben bei $2 für neue Eingaben, $0.20 für gecachte Eingaben, $2.50 für Cache-Schreibvorgänge und $10 für Ausgaben.
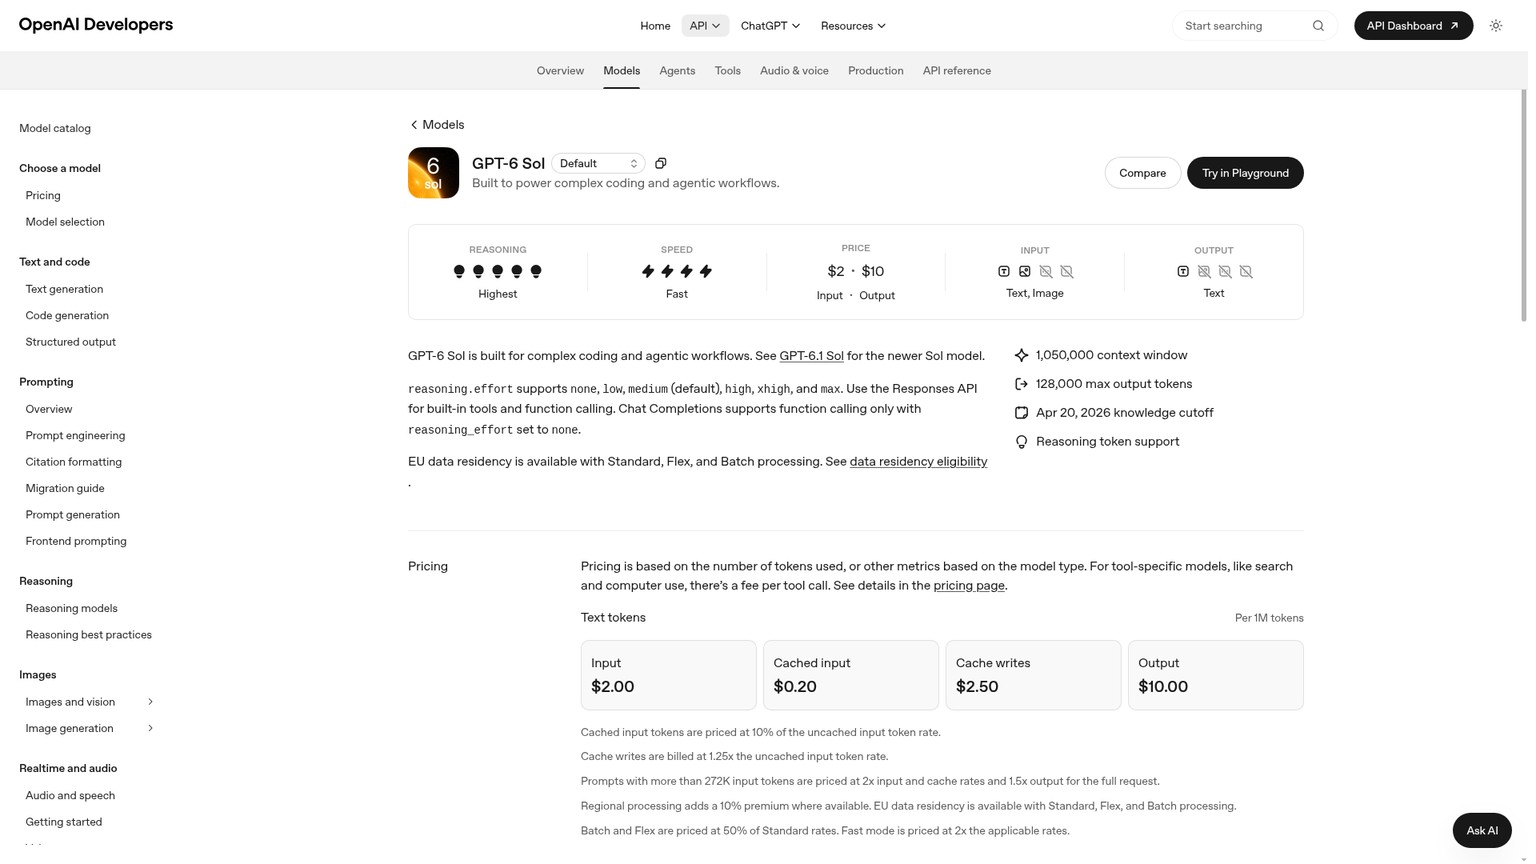
Die dokumentierte Tool-Oberfläche in Responses entspricht der des neueren Modells. Der praktische Unterschied ist der Rückweg für bestehende Anwendungen: Chat Completions kann Funktionen aufrufen, wenn die Reasoning-Stufe none verwendet wird. Damit ist GPT-6 Sol vorübergehend die bessere Wahl für eine stabile Anwendung, die ihre Tool-Schleife noch nicht auf Responses umgestellt hat. Sobald Cache-Lesezugriffe anfallen, ist es jedoch nicht das günstigere Modell.
Sieger: Gleichstand bei Kontext, Ausgabelimit, Modalitäten und dokumentierten Responses-Tools. GPT-6.1 Sol gewinnt bei der Aktualität, GPT-6 Sol bei der Legacy-Kompatibilität.
GPT-6.1 Sol Upgrade: Erst die Kompatibilität prüfen
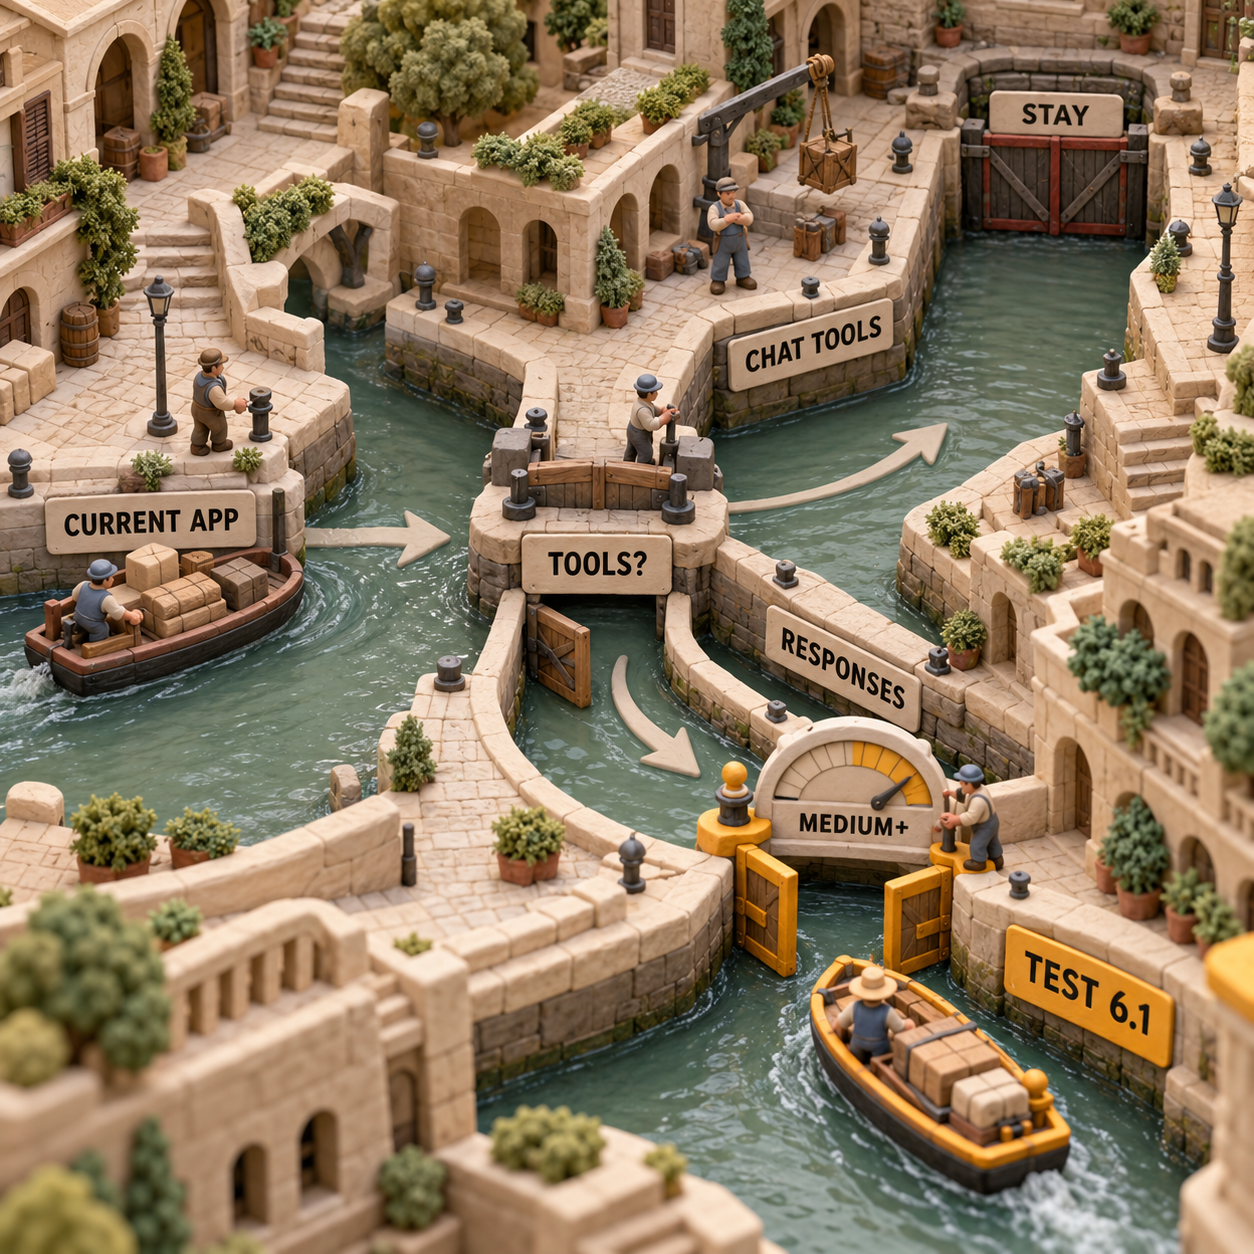
Ein GPT-6.1 Sol Upgrade kann nur dann aus einer einzigen geänderten Modell-ID bestehen, wenn der Caller bereits Responses nutzt, none und minimal vermeidet und Modellausgaben als zu prüfendes Verhalten statt als unveränderlichen Vertrag behandelt. In allen anderen Fällen ist vor der Modellbewertung Migrationsarbeit nötig.
Tool-Calling mit GPT-6.1 Sol
Tool-Calling mit GPT-6.1 Sol erfordert die Responses API. Chat Completions bleibt für reine Modellaufrufe verfügbar, aber nicht für Tool-Calling. Bei GPT-6 Sol ist das anders: Laut Modellseite ist Function Calling mit Chat Completions nur erlaubt, wenn reasoning_effort auf none gesetzt ist.
Vor einer Änderung der Modell-ID muss jeder bestehende Function Caller mit Chat Completions geprüft werden. Zum Migrationsaufwand können die Konstruktion der Anfrage, der Konversationszustand, die Verarbeitung von Tool-Ergebnissen, das Parsen von Antworten, die Wiederholungslogik, Tracing und die Stabilität des Cache-Präfixes gehören. Ein Wrapper, der den Endpunkt verbirgt, beseitigt diese Unterschiede nicht. Er verschiebt lediglich die Stelle, an der getestet werden muss.
Reasoning ist ein zweiter Vertrag. GPT-6.1 Sol unterstützt weder none noch minimal. Wenn eine produktive Route none für geringere Latenz, deterministische Tool-Auswahl oder Kostenkontrolle nutzt, ist die ähnlichste gültige Einstellung nicht automatisch verhaltensgleich. Die Route sollte auf eine unterstützte Stufe umgestellt und denselben Akzeptanzprüfungen unterzogen werden, bevor Geschwindigkeit oder Kosten verglichen werden.
Wer noch nicht wechseln sollte
Das Standardmodell sollte noch nicht gewechselt werden, wenn einer dieser Punkte zutrifft:
- Tool-Aufrufe laufen weiterhin über Chat Completions.
- Eine Route verwendet ausdrücklich die Reasoning-Stufe
noneoderminimal. - Der Großteil der abgerechneten Token entfällt auf neue Eingaben und Ausgaben, sodass die Cache-Ersparnis kaum ins Gewicht fällt.
- Das aktuelle Modell besteht die geschäftlichen Akzeptanzprüfungen bereits, während für GPT-6.1 Sol noch kein Leistungsgewinn mit denselben Testfällen gemessen wurde.
- Ein regulierter Einsatz erfordert eine separate Prüfung von Verarbeitungsmodus, Datenresidenz, Protokollen und verändertem Modellverhalten.
Das ist eine Bindung an den Workflow, keine dauerhafte Bindung an einen Anbieter. Die Modellnamen ähneln sich, der Caller kann jedoch an einen Endpunkt, eine Mindeststufe beim Reasoning, eine Antwortstruktur und eine Tool-Schleife gekoppelt sein. Dieser Validierungsaufwand gehört in die Kostenrechnung des Upgrades.
Sieger: GPT-6 Sol bei einem heute inkompatiblen Caller. GPT-6.1 Sol, sobald Caller und Testfälle bestanden haben.
Vor dem Wechsel des Standardmodells fünf feste Testfälle ausführen
Beide exakten Modell-IDs sollten mit fünf festen Testfällen bei Reasoning-Stufe medium geprüft werden – mit identischen Prompts, Tools, Kontexten, Ausgabelimits und Akzeptanzkriterien. Das ist ein vorgeschlagenes Evaluierungsdesign und kein für diesen Artikel ausgeführter Benchmark.
Einen Fehler im Repository beheben
Beide Modelle erhalten denselben fehlgeschlagenen Test, denselben Repository-Zustand und dieselben erlaubten Tools. Akzeptiert wird nur ein Patch, der den Zielfehler behebt, ohne die vorhandene Testsuite zu beschädigen.
Über mehrere Dateien refaktorieren
Verwendet wird eine klar begrenzte, dateiübergreifende Änderung mit Build-, Lint- und Testprüfung. Eine überzeugende Erklärung reicht nicht aus, wenn die Repository-Prüfung fehlschlägt.
Einen Supportfall weiterleiten
Beide Modelle erhalten dieselbe Richtlinie, Kundennachricht und dieselben Routing-Tools. Gefordert sind die richtige Warteschlange, Priorität und strukturierten Felder, ohne eine nicht erlaubte Aktion auszuführen.
Mit Belegen aus der Richtlinie antworten
Gefordert ist eine kundenorientierte Antwort auf Grundlage desselben Dokumentensatzes. Akzeptiert werden nur die erforderliche Schlussfolgerung, belegte Nachweise und das richtige Eskalationsverhalten.
Einen Geschäftsprozess abschließen
Beide Modelle bearbeiten dieselbe mehrstufige Such- und Aktualisierungsaufgabe mit einer Berechtigungsgrenze. Gefordert sind die korrekte Tool-Reihenfolge, der richtige Endzustand und die Ablehnung jedes nicht autorisierten Schritts.
Zu erfassen sind akzeptierte Ausgaben, Ende-zu-Ende-Latenz, neue Eingabe-Token, gecachte Eingabe-Token, Reasoning- und Ausgabe-Token, Tool-Gebühren sowie Wiederholungsversuche. Anschließend zählen die Gesamtkosten je akzeptiertem Ergebnis, nicht die Kosten der ersten Antwort:
effective cost per accepted result = total model, retry, and tool spend / accepted outputs
Dieser Nenner kann die Aussage der Token-Preise umkehren. Ein Modell, das bei einem Cache-intensiven Batch $0.90 spart, aber einen zusätzlichen fehlgeschlagenen Tool-Lauf verursacht, kann insgesamt teurer sein. Ein Modell mit denselben Preisen für neue Token kann günstiger im Produktivbetrieb sein, wenn es Wiederholungsversuche vermeidet.
Verfügbarkeit unterscheidet sich in API, Work, Codex und Chat
GPT-6.1 Sol ist über die API als gpt-6.1-sol verfügbar und laut Startankündigung von OpenAI auch in ChatGPT Work und Codex für Nutzer der Tarife Plus, Pro, Business, Enterprise und Edu. Im gewöhnlichen Chat war das Modell zum Start nicht verfügbar.
OpenAI kündigt zudem GPT-6.1 Sol Ultrafast an, das in Codex eine bis zu 8x schnellere Token-Generierung als die Standardgeschwindigkeit bieten soll. Die Ankündigung nennt keinen Preis für Ultrafast. Eine Kostenprognose sollte daher nicht auf einem inoffiziellen Multiplikator beruhen.
Die API-Nutzung wird getrennt von einem ChatGPT-Abonnement abgerechnet. Der Zugang in Work oder Codex macht die API-Preise von $2 und $10 nicht zu einem enthaltenen Kontingent für eine produktive Anwendung.
Häufig gestellte Fragen
Was ist GPT-6 Sol?
GPT-6 Sol ist das OpenAI-Modell für komplexe Programmieraufgaben und agentische Workflows mit der API-ID gpt-6-sol. GPT-6.1 Sol ist das Upgrade vom 29. September 2026 mit einem niedrigeren Preis für gecachte Eingaben und anderen Kompatibilitätsbedingungen für Reasoning und Tool-Calling.
Wie viel besser ist GPT Sol?
Eine einzelne, seriöse Prozentangabe gibt es nicht. OpenAI meldet gegenüber GPT-6 Sol für GPT-6.1 Sol in bestimmten Einstellungen einen Vorsprung von 6.4 Prozentpunkten bei DeepSWE, 4.8 Punkten bei AutomationBench und 7 Punkten bei OSWorld. Ob sich diese Vorteile übertragen lassen, muss der eigene feste Workload zeigen.
Welche GPT-Version ist besser?
Für kompatible Programmier- und Business-Agenten ist GPT-6.1 Sol das bessere Testmodell. GPT-6 Sol ist vorübergehend die bessere Laufzeitumgebung, wenn weiterhin Tool-Aufrufe über Chat Completions oder die Reasoning-Stufe none erforderlich sind.
Welche Funktionen und Preise bieten die neuen Modelle GPT-6 Sol und Luna von OpenAI?
Dabei geht es um die frühere Entscheidung innerhalb der Modellfamilie. Der Vergleich von GPT-6 Sol und Luna behandelt ihre Einsatzbereiche und die aktuelle Token-Kostenstruktur. Diese Seite konzentriert sich darauf, ob ein bestehender Sol-Workload auf GPT-6.1 Sol umgestellt werden sollte.
Welches GPT ist besser: Sol, Terra oder Luna?
In dieser Modellfamilie gibt es keinen universellen Sieger. Das Modell muss zu Aufgabenschwierigkeit, Latenz und Kosten je akzeptiertem Ergebnis passen; anschließend sind die tatsächlich vorgesehenen Modell-IDs zu evaluieren. Dieser Vergleich hilft bei einem Sol-zu-Sol-Upgrade, nicht bei der Wahl zwischen Terra und Luna.
Ist GPT-6 Sol günstiger?
Bei den dokumentierten Standardpreisen nicht. Für neue Eingaben, Cache-Schreibvorgänge und Ausgaben kostet GPT-6 Sol genauso viel wie GPT-6.1 Sol. Gecachte Eingaben sind bei GPT-6.1 Sol mit $0.10 statt $0.20 je Million Token günstiger.
Lohnt es sich, $20 für ChatGPT zu bezahlen?
Das ist eine Entscheidung über ein Endkundenabonnement und kein Vergleich der API-Modellpreise. GPT-6.1 Sol war zum Start in Work und Codex in den genannten kostenpflichtigen Tarifen verfügbar, aber nicht im gewöhnlichen Chat. Die API-Nutzung wird separat abgerechnet.
Ist GPT-5.6 Sol besser als GPT-5?
Dieser ältere Vergleich entscheidet nicht über das aktuelle Upgrade. Für einen heutigen Einsatz müssen GPT-6.1 Sol und GPT-6 Sol mit genau dem API-Pfad, der Reasoning-Stufe, den Tools und den Akzeptanzprüfungen verglichen werden, die die Anwendung tatsächlich nutzt.
Wie gut ist GPT-6?
Die Leistungsfähigkeit von GPT-6 hängt von Modell, Aufgabe, Reasoning-Stufe und Tool-Konfiguration ab. Bei mehreren schwierigen Evaluierungen weist GPT-6.1 Sol stärkere Herstellerangaben als GPT-6 Sol auf. Für den Produktiveinsatz liefert jedoch ein fester interner Eval die entscheidende Antwort.
GPT-6.1 Sol vs. GPT-6 Sol: Wie groß sind die Modellgewichte?
Die aktuellen Modellseiten von OpenAI veröffentlichen weder Parameterzahlen noch herunterladbare Gewichte für eines der beiden Modelle. Entscheidend sind stattdessen die dokumentierten Limits, Preise, das API-Verhalten und die gemessenen Ergebnisse der eigenen Aufgaben.
Der nächste Schritt am Montag
Der erste Blick gilt dem Caller, nicht der Modellauswahl. Im Code und in der Workflow-Konfiguration sollte nach Function Calls über Chat Completions sowie nach reasoning_effort mit den Werten none oder minimal gesucht werden. Taucht eines davon auf, ist zunächst die Migration zu planen, bevor das Standardmodell geändert wird.
Anschließend werden die fünf festen Testfälle für gpt-6-sol und gpt-6.1-sol bei mittlerer Reasoning-Stufe mit denselben Tools und Prüfungen ausgeführt. Verglichen werden Kosten je akzeptiertem Ergebnis, Latenz, Cache-Nutzung und Wiederholungsversuche. GPT-6.1 Sol wird auf den Routen eingesetzt, auf denen es gewinnt; alle übrigen bleiben bei GPT-6 Sol, bis die Kompatibilitäts- oder Ergebnislücke geschlossen ist.
Checkliste für die Einrichtung von Claude Code und Codex herunterladen, bevor eine produktive Modellroute geändert wird.
- Zuletzt aktualisiert
- 30. Sept. 2026
- Kategorie
- AI
Diese Seite in Google bevorzugen


Markieren Sie omidsaffari.com als bevorzugte Quelle, und Google hebt die Seite für Sie in Top Stories, AI Overviews und AI Mode hervor.

Claude Sonnet API und App: So nutzen Sie Version 5.5
So nutzen Sie Claude Sonnet 5.5 in App und API, wählen den passenden Effort und vermeiden Fehler bei Thinking, Tool-Aufrufen und der Migration.28. Sept. 2026AI
GLM Flash oder Jev: Welches Entscheidungsmodell passt?
GLM Flash oder Jev? Der Vergleich zeigt Kosten, Bildverarbeitung, Latenz und Einsatzgrenzen – plus einen fairen Testplan für die eigene Entscheidung.27. Sept. 2026AI
Claude Opus 5.5 Vergleich: Lohnt sich der Wechsel von Opus 5?
Der Claude Opus 5.5 Vergleich zeigt Preise, Cache-Vorteile, Coding-Leistung und API-Änderungen, die vor einem Wechsel von Opus 5 zu prüfen sind.23. Sept. 2026AI
GPT-6 Sol oder Luna: Welches Modell passt zu welchem Job?
GPT-6 Sol oder Luna? Der Vergleich zeigt Preise, Stärken und Einsatzgebiete – und wann Sol den 20× höheren Tokenpreis gegenüber Luna wirklich rechtfertigt.23. Sept. 2026AI
Ist GPT-6 Luna kostenlos? Pläne, Limits und API-Kosten
Ist GPT-6 Luna kostenlos? Der Überblick zeigt Gratiszugang, nötige Tarife, separate API-Kosten und die bislang nicht veröffentlichten Nutzungslimits.22. Sept. 2026AI
Xiaomi MiMo nutzen: V2.6 vom Prompt bis zur API
Xiaomi MiMo V2.6 praxisnah einrichten: Prompt in Studio testen, passenden API-Schlüssel wählen und Flash, Pro oder UltraSpeed gezielt einsetzen.22. Sept. 2026AI
Xiaomi MiMo V2.6: Wann Flash, wann Pro?
Xiaomi MiMo V2.6 im Kostenvergleich: Warum Flash meist genügt, wann Pro den Aufpreis verdient und wie ein belastbarer Drei-Aufgaben-Test entscheidet.22. Sept. 2026AI