OpenAI API Pricing 2026: cuánto gastar con GPT-6.1 Sol
Tarifas de OpenAI API y tres presupuestos con GPT-6.1 Sol, Luna y Astra. Calcula el gasto en tokens, voz, imágenes, búsquedas y contenedores.



Con las tarifas de OpenAI API Pricing, GPT-6.1 Sol es un punto de partida razonable para el agente de programación de un equipo pequeño: $2 por millón de tokens de entrada, $0.10 por la entrada en caché y $10 por la salida. En los presupuestos mensuales de ejemplo que se detallan más abajo, asignar a GPT-6 Luna el soporte acotado y los resúmenes por lotes, y mantener la programación en Sol, supone $159.40 por el uso de la API especificado. Conviene elegir GPT-6 Astra cuando el trabajo que ahorra compensa su factura más alta.
Tarifas verificadas en la página de precios vigente de la API de OpenAI el 3 de octubre de 2026. Todas las tarifas del proveedor que aparecen a continuación proceden de esa página. Los volúmenes de trabajo son supuestos explícitos; los cálculos se basan en esas tarifas.
La API de OpenAI es la interfaz que utiliza tu aplicación y que se factura por consumo. El importe depende de lo que recibe el modelo, de lo que genera y de las herramientas de pago que usa la aplicación.
OpenAI API Pricing: tarifas actuales por modelo
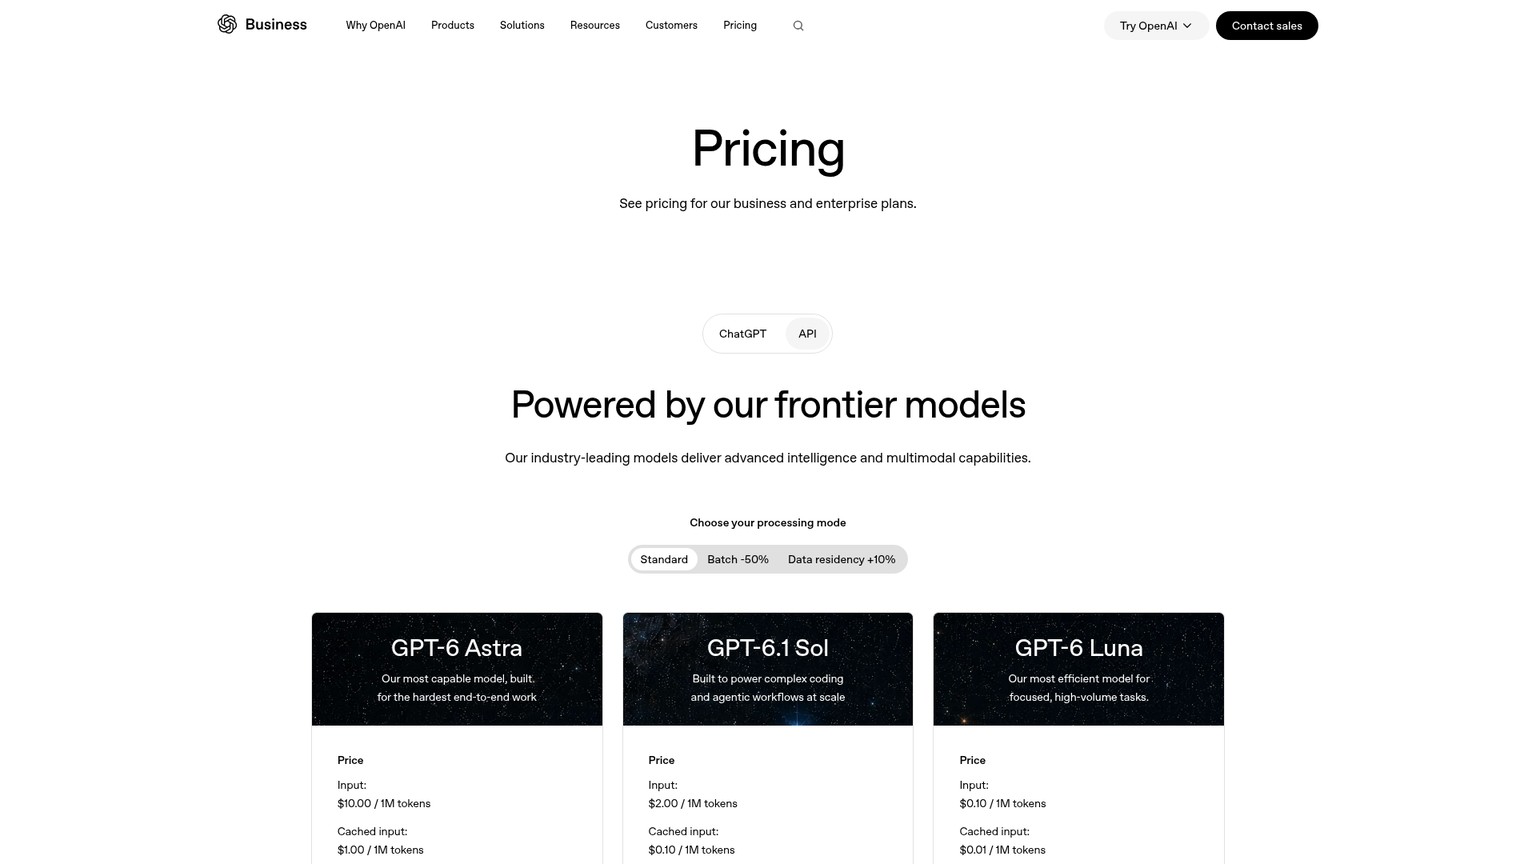
GPT-6.1 Sol cuesta $2 por la entrada, $0.10 por la entrada en caché y $10 por la salida, por millón de tokens. OpenAI lo orienta a la programación compleja y a los flujos de trabajo con agentes. GPT-6 Luna se dirige a tareas acotadas de gran volumen, mientras que GPT-6 Astra está pensado para resolver de principio a fin los trabajos más difíciles.
La siguiente tabla reúne todos los modelos destacados en la pestaña de precios de la API consultada; no es un catálogo histórico. Las filas de tokens muestran precios en USD por 1M de tokens. Las filas que se facturan por tiempo indican expresamente minutos y segundos. Las tarifas de los tres modelos principales de texto corresponden al procesamiento Standard para contextos inferiores a 272K, es decir, la cantidad de material que contiene una solicitud individual. Esa condición marca un límite de tarificación, no el contexto máximo de los modelos.
Fuente: precios de la API de OpenAI, verificados en octubre de 2026. «No se indica» significa que la fuente no facilita esa tarifa; no implica una cantidad gratuita de tokens de salida. «No se desglosa» significa que el precio publicado se basa en el tiempo y no separa los tokens de entrada y salida.
GPT-6 Sol no aparece en las filas de precios de la API de esta página. Su nombre es distinto del de GPT-6.1 Sol, por lo que esta revisión no le asigna un precio al modelo anterior ni le atribuye las tarifas del nuevo. Los modelos y conceptos de facturación que no figuran en la fuente, incluidas las tarifas de embeddings, quedan fuera de esta relación de precios.
¿Con qué modelo debería empezar un equipo pequeño?
Empieza con GPT-6.1 Sol para un agente de programación o una aplicación de propósito general, y justifica cada cambio con resultados de trabajo terminado. La recomendación se basa en cómo presenta el proveedor sus modelos y en los cálculos de presupuesto, no en una clasificación de rendimiento medida de forma independiente.
Las tarifas de entrada sin caché y de salida de Sol son una quinta parte de las de Astra. La tarifa de entrada en caché es una décima parte. Para un equipo pequeño que todavía está descubriendo cuánto contexto necesita un agente, Sol ofrece una base práctica: permite evaluar el trabajo antes de pagar el sobreprecio de Astra en todas las solicitudes.
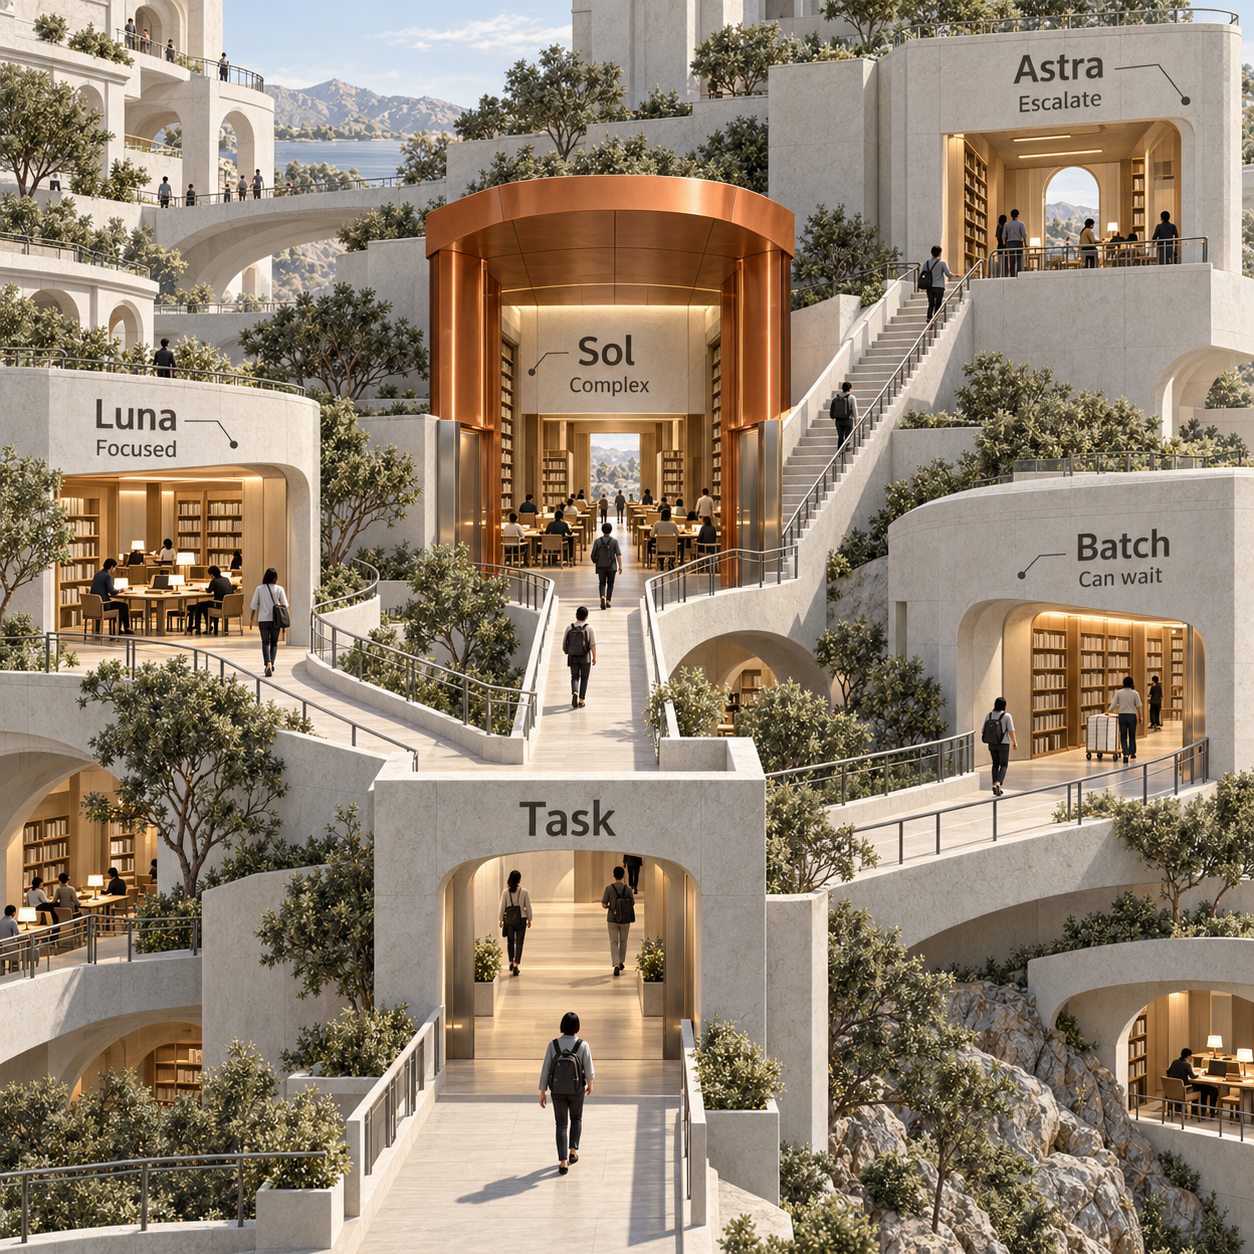
Usa Luna para una tarea acotada con criterios claros de aceptación. Un clasificador de soporte que elige una categoría conocida o un generador de resúmenes que se pueden contrastar con la fuente encaja mejor que una tarea de programación abierta. Son propuestas de uso, no afirmaciones de que alguno de los modelos haya superado tus pruebas. La tarifa baja de Luna deja de ser útil cuando el trabajo fallido cuesta más que el ahorro en tokens.
Reserva Astra para los trabajos en los que los errores salen caros. En el ejemplo de programación de abajo, elegir Astra en lugar de Sol añade $410 al mes con el mismo consumo facturado. El cambio compensa si evita correcciones por un valor superior a esa cantidad. Un precio alto, por sí solo, no demuestra que vaya a conseguirlo.
Si el equipo ya utiliza GPT-6 Sol, mantén su presupuesto actual hasta poder comparar el consumo realmente facturado y los resultados aceptados con los de GPT-6.1 Sol. Esta página no ofrece una tarifa del Sol anterior con la que calcular el ahorro de una migración.
¿Cuánto cuesta un millón de tokens?
No hay un precio único para un millón de tokens de OpenAI. Un token es una unidad del material que procesa el modelo. La entrada es el material que se envía; la salida es el material generado que se factura. La entrada en caché es entrada reutilizada que la API cobra a una tarifa reducida.
Un millón de tokens de entrada sin caché más un millón de tokens de salida cuestan $60 con Astra, $12 con Sol o $0.60 con Luna. Son dos millones de tokens facturados. Un millón de tokens en total, repartido por igual entre entrada sin caché y salida, cuesta $30, $6 o $0.30, respectivamente.
Para calcular la factura de un modelo de texto, separa la entrada nueva de la entrada en caché:
Costo de tokens = entrada nueva / 1M × tarifa de entrada + entrada en caché / 1M × tarifa de caché + salida / 1M × tarifa de salida.
Si el registro de uso muestra la entrada total y la entrada en caché, la entrada nueva es la diferencia entre ambas. Cobrar toda la entrada a la tarifa de entrada nueva y sumar después la entrada en caché equivale a contar esta última dos veces.
En Sol, la entrada en caché es un 95% más barata que la entrada sin caché. Aun así, un millón de tokens de salida cuesta tanto como 100 millones de tokens de entrada en caché. Un gran ahorro por caché no justifica generar material sin límite. Cuenta toda la salida facturada durante la tarea del agente, en lugar de presupuestar solo la respuesta final que ve el usuario.
Calcula el gasto en la API de OpenAI: tres presupuestos mensuales
Las tres cargas de trabajo cuestan $159.40 al mes con la asignación de modelos propuesta. Es un ejemplo de planificación para quien gestiona una aplicación pequeña, no una factura de producción medida ni una promesa de que los modelos ofrecen resultados de la misma calidad.
Se supone que cada solicitud individual cumple la condición de contexto inferior a 272K de las tarifas Standard de la fuente. Los volúmenes de caché corresponden a aciertos de caché realmente facturados. Los volúmenes de salida incluyen toda la salida facturada en todas las llamadas. El uso de herramientas se incluye donde se indica; las suscripciones, el alojamiento y los demás conceptos no especificados quedan fuera de estos totales. Los cálculos utilizan las tarifas actuales de OpenAI.
Bot de soporte: $13.90 con Luna
Supongamos 10,000 conversaciones al mes. Para el conjunto de llamadas de cada conversación, se presupuestan 1,000 tokens de entrada nueva, 4,000 de entrada en caché y 500 de salida. Los totales mensuales son 10M de entrada nueva, 40M de entrada en caché y 5M de salida. Se añaden otras 1,000 llamadas de búsqueda web durante el mes.
Con Luna, el costo de los tokens es:
10 × $0.10 + 40 × $0.01 + 5 × $0.50 = $3.90.
Las búsquedas añaden $10, de modo que el total es $13.90, o $1.39 por 1,000 conversaciones. Con el mismo consumo, Sol cuesta $74 en tokens más $10 de búsquedas: $84. Astra cuesta $390 en tokens más $10 de búsquedas: $400.
Luna es la opción económica si el bot se limita a una función de soporte acotada y sus respuestas superan tus criterios de aceptación. El cálculo supone que el material reutilizable cumple los requisitos para facturarse como entrada en caché. Si no hay aciertos de caché, los 50M de tokens de entrada se facturan como entrada nueva: el subtotal de tokens de Luna pasa a $7.50 y el total a $17.50. Conviene registrar esa variación antes de dar por hecho el ahorro de un acierto de caché previsto.
Agente de programación: $140 con Sol
Supongamos 1,000 tareas de programación al mes. Para todas las interacciones de cada tarea, se presupuestan 15,000 tokens de entrada nueva, 100,000 de entrada en caché y 5,000 de salida. El mes consume, por tanto, 15M de entrada nueva, 100M de entrada en caché y 5M de salida. Una tarea puede incluir varias solicitudes; estas cifras son totales por tarea.
Se suponen también 2,000 llamadas de búsqueda web y 1,000 sesiones de contenedor, cada una con 1 GB y la unidad de sesión de 20 minutos que indica la fuente.
La factura de tokens de Sol es:
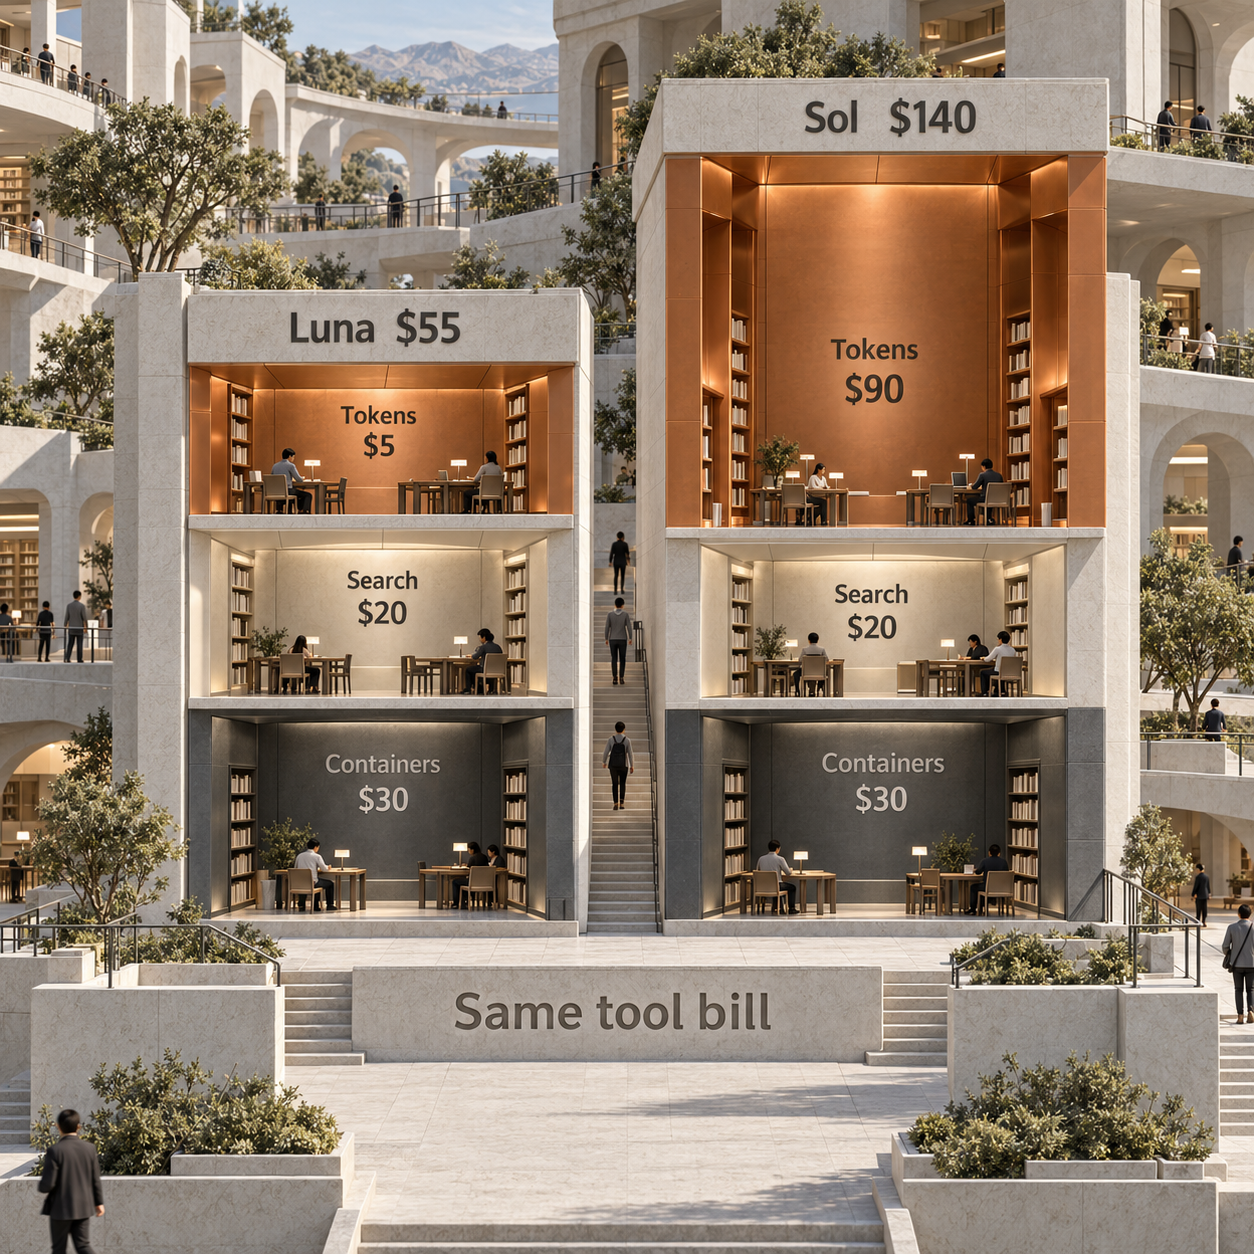
15 × $2 + 100 × $0.10 + 5 × $10 = $90.
Las búsquedas cuestan $20 y los contenedores 1,000 × $0.03 = $30. El total es $140 al mes, o $0.14 por tarea.
Con los mismos volúmenes facturados, Astra cuesta $500 en tokens más los mismos $50 en herramientas: $550 en total. Luna cuesta $5 en tokens más $50 en herramientas: $55 en total.
El modelo más barato no elimina la factura de las herramientas. Pasar de Sol a Luna ahorra $85 al mes en este ejemplo. Si el trabajo de programación resultante obliga a dedicar más de $85 a correcciones adicionales, el ahorro desaparece. Para pasar a Astra hace falta demostrar lo contrario: que las correcciones evitadas justifican sus $410 de sobreprecio. Una comparación basada solo en tokens no permite tomar esa decisión.
Resúmenes por lotes: $5.50 con Luna
Supongamos 20,000 documentos al mes, cada uno con 4,000 tokens de entrada sin caché y 300 de salida. El resultado es 80M de tokens de entrada y 6M de salida. No se suponen aciertos de caché ni cargos por herramientas, y los resúmenes se pueden procesar de forma asíncrona dentro del plazo de 24 horas de la Batch API.
El costo de tokens de Luna con Standard sería 80 × $0.10 + 6 × $0.50 = $11. Al aplicar el descuento de Batch del 50% que indica la fuente, queda en $5.50 al mes, o $0.275 por 1,000 resúmenes.
Los mismos volúmenes con Batch cuestan $110 con Sol y $550 con Astra. Usa el modelo más barato cuando los resúmenes cumplan el nivel exigido; envía los documentos difíciles a un modelo más potente cuando el costo de corregirlos lo justifique. Una consulta de un cliente que espera respuesta inmediata es otro tipo de trabajo y no debe presupuestarse como procesamiento asíncrono con Batch.
El presupuesto mensual completo
La asignación propuesta suma $13.90 de soporte con Luna + $140 de programación con Sol + $5.50 de resúmenes con Luna y Batch = $159.40.
Usar Sol para las tres cargas cuesta $334. Usar Astra para las tres cuesta $1,500. Usar Luna para las tres cuesta $74.40, siempre que el trabajo sea aceptable. Estas comparaciones mantienen constantes los volúmenes facturados de tokens y herramientas; no suponen que los modelos necesiten el mismo número de intentos en la práctica.
Esa diferencia determina la factura de quien gestiona una aplicación. Un modelo que necesita más interacciones puede consumir más entrada, salida, búsquedas y sesiones. Compara el costo por conversación aceptada, tarea de programación terminada o resumen utilizable antes de aplicar la tarifa más baja a todo el producto.
Precios de OpenAI Batch API y residencia de datos
Batch reduce un 50% los cargos publicados de entrada y salida; la residencia de datos añade un recargo del 10%. La página de precios de OpenAI presenta estas opciones de procesamiento por separado de las tarifas Standard.
Batch procesa el trabajo de forma asíncrona durante un plazo de 24 horas. Encaja con los resúmenes de documentos que se ejecutan durante la noche, la clasificación y otras tareas cuyo plazo admite esa espera. El ejemplo de resúmenes aplica el descuento solo a la entrada nueva y a la salida, sin suponer descuentos en la tarifa de caché ni en los cargos por herramientas.
Si el subtotal de tokens del modelo es $90, aplicar el recargo por residencia de datos da $99, es decir, $9 adicionales. El ejemplo no establece si las búsquedas o los contenedores reciben el mismo tratamiento, ni cómo se combina la residencia de datos con otras modalidades. La pestaña de precios no ofrece suficiente detalle para calcular aquí esas combinaciones.
La página también describe el modo Fast y el procesamiento Flex. Fast ofrece más velocidad con pago por uso; Flex reduce el costo a cambio de respuestas más lentas y falta de disponibilidad ocasional. La pestaña no facilita tarifas exactas para ninguno de los dos, por lo que estos presupuestos no les atribuyen multiplicadores inventados.
Las herramientas pueden fijar el gasto mínimo
Cuenta las llamadas de búsqueda y las sesiones de contenedor por separado de los tokens del modelo. La estimación de tokens puede ser correcta y, aun así, el presupuesto mensual quedarse corto porque una tarea recurre a otros recursos de pago.
¿Cuánto cuesta la búsqueda web de la API de OpenAI?
La búsqueda web cuesta $10 por 1,000 llamadas, y la página indica que los tokens del contenido de las búsquedas son gratuitos. Son $0.01 por llamada: 100 llamadas cuestan $1; 10,000 cuestan $100. El trabajo del modelo que se factura por separado sigue formando parte del total de tokens. Fuente: precios de la API de OpenAI.
En el ejemplo de soporte, 1,000 búsquedas cuestan más que todo el subtotal de tokens de Luna. Decide expresamente con qué frecuencia buscará el producto. Una respuesta que necesita información actual puede justificar una búsqueda; una respuesta basada en una política de soporte ya facilitada no debería llevar automáticamente un presupuesto de búsqueda.
Contenedores: se factura cada sesión
Los contenedores, entornos de ejecución que se utilizan junto con los modelos, cuestan $0.03 con 1 GB o $1.92 con 64 GB, por cada sesión de 20 minutos y por contenedor. La página de precios fecha esa facturación por sesiones el 31 de marzo de 2026, una fecha ya pasada en esta revisión de octubre. La antigua etiqueta «Now» de la página no justifica suponer un único pago permanente por contenedor. Fuente: precios de la API de OpenAI.
El ejemplo de programación supone expresamente 1,000 sesiones de un GB. No afirma que cada tarea de programación consuma exactamente una sesión. Cuenta las sesiones como un concepto de facturación independiente, sobre todo cuando una tarea utiliza varios contenedores o abarca varias unidades de sesión.
Con la tarifa publicada de 64 GB, esas 1,000 sesiones costarían $1,920. Manteniendo los mismos tokens de Sol y las mismas búsquedas, el gasto mensual de programación subiría de $140 a $2,030. La tarifa por sesión del contenedor grande es 64 veces la del pequeño. La página no facilita precios para tamaños intermedios, por lo que aquí no se calculan por interpolación.
Precios de OpenAI Realtime API
GPT-Realtime-2.1 tiene tarifas distintas para audio, texto y entrada de imágenes. Los tokens de audio son una unidad de facturación de voz; no deben tratarse como tokens de texto ni convertirse a minutos mediante una regla sin respaldo.
Un millón de tokens de entrada de audio sin caché más un millón de tokens de salida de audio cuestan $32 + $64 = $96 con GPT-Realtime-2.1. Los mismos volúmenes cuestan $10 + $20 = $30 con GPT-Realtime-2.1 mini. Las entradas de texto e imagen tienen sus propias filas en la tabla. Fuente: precios de la API de OpenAI.
Para los trabajos facturados por tiempo, GPT-Live-1 es el modelo de conversación, GPT-Live-Transcribe convierte voz en texto en directo, GPT-Transcribe realiza transcripciones asíncronas y GPT-Realtime-Translate traduce en tiempo real. Con las tarifas por minuto publicadas, 1,000 minutos cuestan $50, $17, $4.50 o $34, respectivamente. Son tareas distintas, no planes de voz intercambiables. La página no facilita una conversión que permita expresar el ejemplo de tokens de audio de Realtime en un número equivalente de minutos.
Precios de la API de imágenes de OpenAI
GPT-Image-2.5 Sunburst y GPT-Image-2.5 Flare tienen las mismas tarifas de tokens publicadas. Ambos cobran $8 por la entrada de imágenes, $2 por la entrada de imágenes en caché y $30 por la salida de imágenes, por millón de tokens; los prompts de texto cuestan $5 de entrada o $1.25 de entrada en caché. OpenAI destaca la precisión de edición de Sunburst y la velocidad de Flare para generar imágenes de uso cotidiano. Fuente: precios de la API de OpenAI.
Suponer un millón de tokens de imágenes generadas más un millón de tokens de prompts de texto sin caché da un costo de $30 + $5 = $35 con cualquiera de los dos modelos. Eso no equivale a un millón de imágenes. La página de precios indica que las imágenes se convierten en tokens, pero no establece una cantidad fija de tokens por imagen generada para este cálculo.
Presupuesta el trabajo con imágenes a partir del consumo realmente facturado de imagen y texto. Evita prometer un precio fijo por imagen a partir de una tarifa por token, o elegir entre estos modelos por una diferencia de precio que la página no muestra.
Suscripciones, acceso gratuito y otras dudas de facturación
Una suscripción a ChatGPT no paga la factura de la API de tu aplicación. OpenAI separa expresamente la facturación de la API de ChatGPT Plus, Business, Enterprise y Edu. Consulta la guía de precios de ChatGPT para decidir sobre la suscripción y presupuesta aparte el consumo de la aplicación.
¿Cómo se calcula el gasto de Codex con la API?
Codex es el producto de programación de OpenAI; lo relevante aquí es cómo se paga su uso. Para presupuestar actividad de la API facturada por separado, utiliza los modelos y los conceptos de tokens y herramientas descritos arriba. El uso incluido en los planes del producto es una compra distinta. La guía de precios de Codex explica esa decisión de suscripción.
Comprar una licencia para un desarrollador no convierte el bot de soporte, la carga de programación automatizada ni el generador de resúmenes por lotes en consumo de aplicación prepagado. Mantén el gasto en suscripciones del producto y el consumo de la API de la aplicación en partidas presupuestarias separadas.
¿La API de OpenAI tiene un nivel gratuito?
La página de precios consultada no indica una cantidad general de tokens gratuitos para la API. Señala expresamente que el uso de Playground, la interfaz del navegador para probar solicitudes, se factura igual que el uso habitual de la API. No presupuestes las pruebas como gratuitas solo porque se hacen fuera de tu aplicación.
Quien utiliza únicamente la versión gratuita de ChatGPT quizá nunca necesite comprar consumo de la API. Pero, en cuanto una aplicación hace solicitudes de pago a la API, elegir la aplicación gratuita no permite asumir un presupuesto de producción gratuito.
Esta fuente no establece un descuento universal para estudiantes en la API, una política de reembolsos de la API, la caducidad de los créditos ni un compromiso anual sobre el precio de los tokens. Esas omisiones no demuestran que no existan ofertas específicas para una cuenta o políticas independientes. Significan que esta revisión de precios no puede prometerlas. En particular, no traslades las condiciones de reembolso o facturación anual de una suscripción al presupuesto de la API.
Presupuesta la próxima semana a partir del trabajo terminado
Empieza con Sol y mide la tarea completa antes de optimizar la tarifa del modelo. El siguiente presupuesto debe basarse en el consumo facturado observado, no en la cantidad de palabras de la respuesta final.
Registra un punto de partida
Para trabajos representativos, registra la entrada nueva, la entrada en caché, la salida facturada, las búsquedas y las sesiones de contenedor a lo largo de todas las interacciones. Guarda el resultado de aceptación de cada tarea junto con su costo.
Asigna las tareas acotadas al modelo adecuado
Prueba Luna con tareas concretas cuyos resultados se puedan comprobar. Envía a Batch el trabajo que pueda esperar. Mantén esa asignación solo si el resultado cumple los criterios de aceptación.
Compara el sobreprecio con las correcciones evitadas
Para las tareas difíciles, compara el costo adicional de Astra en la API con el valor de las correcciones que evita. Usa los intentos y el consumo real de herramientas, sin suponer que todos los modelos consumen los mismos tokens.
Las preguntas frecuentes de precios de OpenAI advierten que la aplicación de los límites del presupuesto mensual puede retrasarse y que el usuario sigue siendo responsable del gasto que los exceda. Utiliza el presupuesto configurado como un control de gasto con esa limitación y vigila el consumo real. Para organizar los proyectos y los procesos de recuperación, consulta la guía de controles de presupuesto de la API.
Preguntas frecuentes
¿Cuánto cuesta OpenAI?
El uso de la API de OpenAI se factura según el modelo, los tokens y las herramientas. Para solicitudes Standard por debajo del límite de contexto indicado, Sol cuesta $2 de entrada, $0.10 de entrada en caché y $10 de salida, por millón de tokens. Esta relación de precios de la API no establece una cuota mensual única para toda la aplicación.
¿La API de ChatGPT es más barata que ChatGPT Plus?
Depende del consumo y de lo que necesites. La factura de la API de una aplicación puede ser pequeña, pero paga solicitudes de la aplicación facturadas por uso, no la experiencia del producto de suscripción. OpenAI indica que el consumo de la API se factura por separado de las suscripciones a ChatGPT.
¿Cómo se comparan los precios de las distintas API de LLM?
Antes de comparar proveedores, aplica el mismo criterio a la entrada, la entrada en caché, la salida, el uso de herramientas y la finalización satisfactoria del trabajo. El escenario de programación de OpenAI de este artículo, con el mismo consumo, cuesta $55 con Luna, $140 con Sol y $550 con Astra, siempre con la calidad como condición de aceptación. Esta revisión no incluye precios verificados de otros proveedores.
¿Vale la pena pagar por OpenAI?
Compensa cuando el trabajo aceptado ahorra más de lo que cuestan el uso de la API y las correcciones resultantes. Empieza la carga de programación con Sol; pasa a Astra si las correcciones evitadas justifican el costo adicional, y utiliza Luna cuando su trabajo supere los mismos criterios exigidos.
¿Vale la pena pagar $20 por ChatGPT?
Paga una suscripción a ChatGPT cuando sus funciones y el tiempo que ahorra justifiquen la cuota. No cubre el consumo de la aplicación calculado aquí, por lo que ese gasto en la API sigue siendo una decisión aparte.
¿La API de OpenAI es gratuita o de pago?
La página publica tarifas de pago para los modelos y las herramientas, sin una cantidad general de uso gratuito de la API. También indica que las solicitudes de Playground se facturan como las solicitudes habituales de la API. La versión gratuita de ChatGPT no implica acceso gratuito a la API.
¿Es cara la API de OpenAI?
Depende del trabajo y de las herramientas que utiliza. El mes hipotético de soporte cuesta $13.90 con Luna, mientras que el de programación con Sol cuesta $140. Ambas cifras dependen de los volúmenes facturados especificados; una tarifa baja de tokens no elimina los cargos por búsquedas ni por contenedores.
¿Cuáles son las mejores API de IA gratuitas?
Esta página de precios no publica una cantidad general de uso gratuito de la API de OpenAI. Luna es una opción de pago económica para tareas acotadas cuyos resultados superen tus criterios. Antes de incluir el uso gratuito de la API de un proveedor en un presupuesto de producción, hay que verificar sus condiciones actuales por separado.
¿Cuánto cuesta 1 millón de tokens de OpenAI?
Un millón de tokens de entrada sin caché cuesta $10 con Astra, $2 con Sol y $0.10 con Luna. Un millón de tokens de salida cuesta $50, $10 y $0.50. Un millón de entrada más un millón de salida son dos millones de tokens facturados, con un total de $60, $12 o $0.60.
¿OpenAI ofrece un descuento para estudiantes en la API?
La página de precios verificada para este artículo no establece un descuento universal para estudiantes en la API. No cuentes una oferta estudiantil de otro producto de OpenAI como crédito para la API, salvo que sus propias condiciones incluyan expresamente ese beneficio.
¿Cuál es la política de reembolsos de la API de OpenAI?
La página de precios verificada no establece una política de reembolsos de la API. Por eso, este artículo no promete reembolsos ni aplica las reglas de las suscripciones de ChatGPT a las compras de la API.
¿Han cambiado los precios de la API de OpenAI en 2026?
La página actual fecha expresamente la facturación de contenedores por sesiones de 20 minutos el 31 de marzo de 2026. No ofrece una serie histórica de precios de modelos, por lo que esta revisión de octubre no afirma cuándo cambiaron las tarifas de tokens ni cita precios anteriores.
Define las tareas y sus criterios de aceptación antes de elegir otro plan. Recibe la lista de verificación para auditar los flujos de trabajo con IA de tu negocio al suscribirte al boletín.
- Última actualización
- 3 oct 2026
- Categoría
- Build
Prefiera este sitio en Google


Marque omidsaffari.com como fuente preferida y Google lo destacará para usted en Top Stories, AI Overviews y AI Mode.
Pi: un asistente de programación con IA a tu medida
Configura Pi 1.0 con tu cuenta de modelos, añade AGENTS.md y completa una primera tarea. Con precios de proveedores y límites explicados sin rodeos.3 oct 2026Build
Agentes de IA sin programar: qué plataforma elegir en 2026
Compara 8 plataformas para crear agentes de IA sin programar. Precios, límites y permisos de Gumloop, MindStudio, n8n y más para elegir según tu trabajo.1 oct 2026Build
Lovable Pricing (2026): cuánto cuesta crear y mantener tu app
Consulta los precios de Lovable, sus créditos y recargas. Compara Pro y Business y calcula cuánto cuesta crear y mantener una herramienta interna.1 oct 2026Build
Codex CLI y Security Cloud: configura escaneos y revisiones
Configura Codex Security Cloud, las revisiones de PR y Codex CLI: costos para equipos, hallazgos reales de Gogs, SARIF en CI y controles que debes conservar.30 sept 2026Build
LearnWorlds pricing: qué plan conviene según el uso
LearnWorlds cuesta desde $29 al mes, pero Starter deja de ser el plan más barato con 15 inscripciones. Compara planes, comisiones, IA y costo total.30 sept 2026Build
Alternativas a Notion: cuándo conviene usar ChatGPT Space
Compara ChatGPT Space y Notion en precio, flujos, bases de datos, permisos y migración para decidir qué opción encaja mejor con tu equipo y tu proyecto.30 sept 2026Build
Automatización web con Kitesurf WebMCP: guía práctica
Aprende a conectar Kitesurf WebMCP, descubrir acciones de una página, ejecutarlas con seguridad y verificar cada resultado con una ruta alternativa.30 sept 2026Build