OpenAI API pricing 2026: tre budget per scegliere il modello
Quanto costano le API OpenAI? Prezzi di GPT-6.1 Sol, Luna e Astra, tre budget mensili e costi di ricerca, container, voce e immagini, tutti in USD.



Il listino OpenAI API pricing rende GPT-6.1 Sol una scelta sensata da cui partire per l'agente di coding di un piccolo team: $2 per milione di token di input, $0.10 per l'input in cache e $10 per l'output. Nei budget mensili esemplificativi qui sotto, affidare a GPT-6 Luna le attività di assistenza circoscritte e i riepiloghi in batch, mantenendo il coding su Sol, costa $159.40 per l'utilizzo API indicato. GPT-6 Astra conviene quando il lavoro che permette di risparmiare giustifica una spesa maggiore.
Tariffe verificate sulla pagina ufficiale dei prezzi API di OpenAI il 3 ottobre 2026. Tutte le tariffe del fornitore riportate sotto provengono da quella pagina. I volumi di lavoro sono ipotesi esplicite; i calcoli applicano a quei volumi le tariffe indicate.
OpenAI API è l'interfaccia che l'applicazione chiama e paga a consumo. La fattura dipende da ciò che viene inviato al modello, da ciò che il modello genera e dagli strumenti a pagamento usati dall'applicazione.
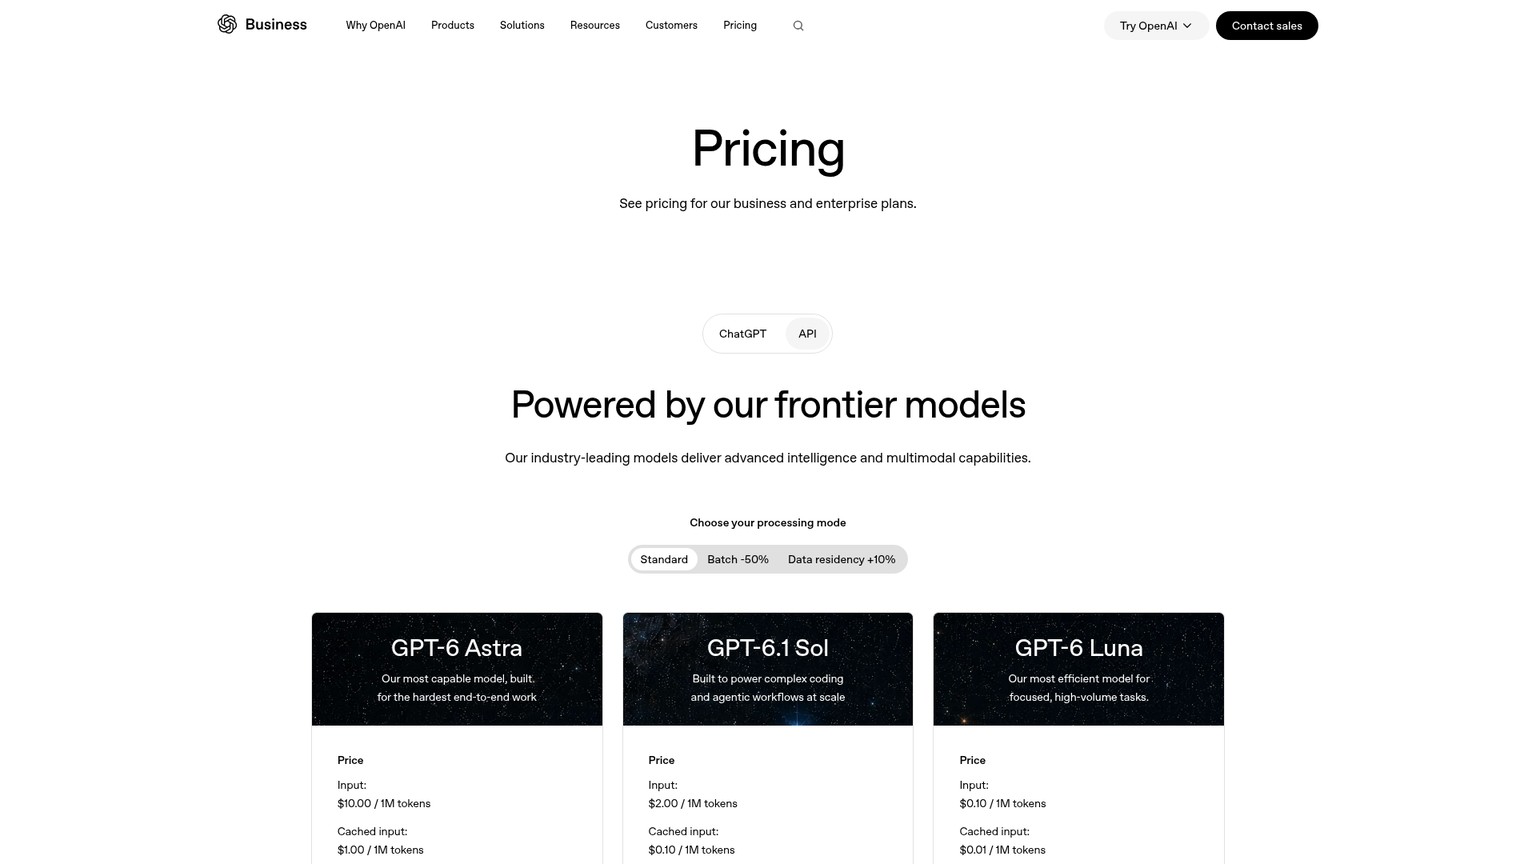
OpenAI API pricing: le tariffe attuali dei modelli
GPT-6.1 Sol costa $2 per l'input, $0.10 per l'input in cache e $10 per l'output, per milione di token. OpenAI lo propone per il coding complesso e i flussi di lavoro con agenti. GPT-6 Luna è pensato per attività mirate ad alto volume, mentre GPT-6 Astra si rivolge ai compiti più difficili da svolgere dall'inizio alla fine.
La tabella raccoglie tutti i modelli presenti nella scheda dei prezzi API consultata: non è un catalogo storico. Le righe basate sui token esprimono prezzi in USD per 1M di token. Le righe basate sul tempo indicano esplicitamente minuti e secondi. Le tariffe dei tre modelli di punta per il testo si riferiscono all'elaborazione Standard con un contesto inferiore a 272K, cioè alla quantità di materiale contenuta in una singola richiesta. È una soglia tariffaria, non un'indicazione del contesto massimo dei modelli.
Fonte: prezzi delle API OpenAI, verificati a ottobre 2026. «Non indicata» significa che la fonte non riporta quella tariffa, non che sia prevista una quota di output gratuita. «Non separato» indica un prezzo basato sul tempo, anziché suddiviso tra input e output.
GPT-6 Sol non compare nelle righe dei prezzi API di questa pagina. Il nome è diverso da GPT-6.1 Sol: questa rilevazione non assegna quindi un prezzo al modello precedente, né gli attribuisce implicitamente le tariffe di quello più recente. I modelli e le unità di fatturazione assenti dalla fonte, comprese le tariffe degli embedding, restano fuori da questo listino.
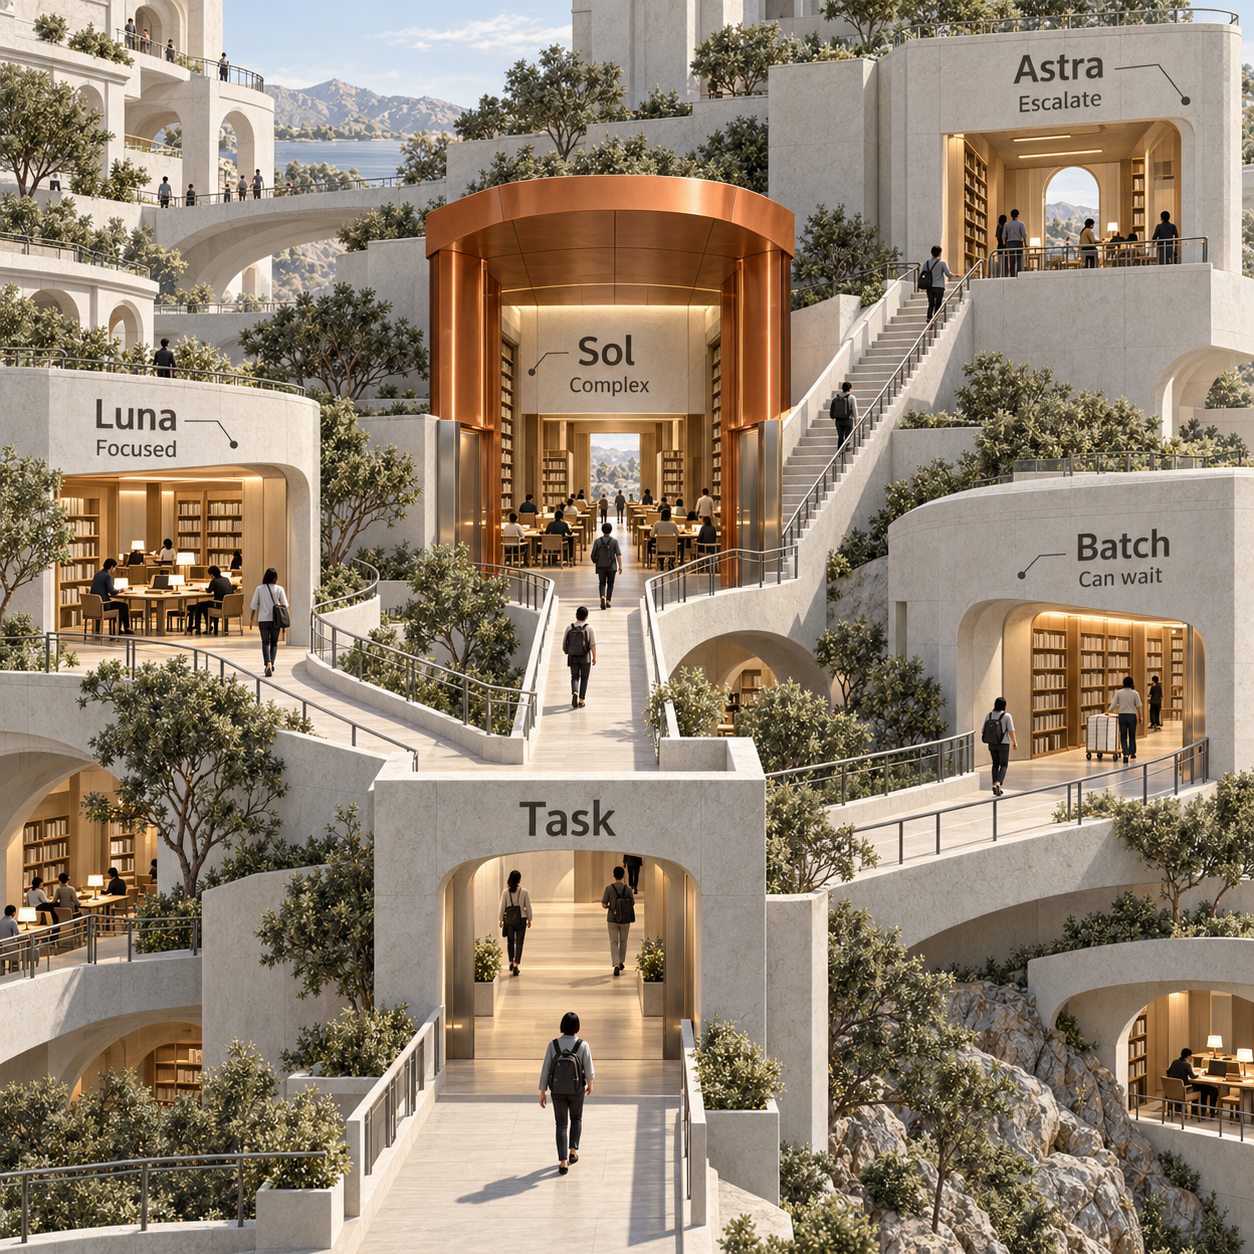
Da quale modello dovrebbe partire un piccolo team?
Per un agente di coding o un'applicazione a uso generale, parti da GPT-6.1 Sol e giustifica ogni cambio con i risultati del lavoro completato. È una raccomandazione basata sul posizionamento del fornitore e sui calcoli di budget, non su una classifica di prestazioni misurate in modo indipendente.
Le tariffe di Sol per input non in cache e output sono un quinto di quelle di Astra. L'input in cache costa un decimo. Per un piccolo team che sta ancora capendo quanto contesto serva a un agente, Sol è quindi una base pratica: permette di valutare il lavoro prima di pagare il sovrapprezzo di Astra su ogni richiesta.
Usa Luna per un compito circoscritto, con criteri di accettazione chiari. Un classificatore di richieste di assistenza che sceglie tra categorie note, oppure un sistema di riepilogo il cui testo può essere verificato sulla fonte, è un candidato più adatto di un'attività di coding aperta. Sono possibili modalità di impiego, non affermazioni secondo cui questi modelli abbiano già superato le tue verifiche. La tariffa bassa di Luna perde utilità quando il costo del lavoro da rifare supera il risparmio sui token.
Tieni Astra disponibile per le attività in cui gli errori costano caro. Nell'esempio di coding qui sotto, scegliere Astra anziché Sol aggiunge $410 al mese a parità di utilizzo fatturato. Il passaggio si ripaga se evita un costo di rilavorazione superiore a quella cifra. Il prezzo elevato, da solo, non dimostra che ci riuscirà.
Se il team usa già GPT-6 Sol, mantieni il budget esistente finché non puoi confrontare l'utilizzo effettivamente fatturato e i risultati accettati con quelli di GPT-6.1 Sol. Questa pagina non offre una tariffa del vecchio Sol da cui calcolare un risparmio di migrazione.
Quanto costa un milione di token?
Non esiste un prezzo unico per un milione di token OpenAI. Il token è un'unità del materiale elaborato dal modello. L'input è il materiale inviato; l'output è quello generato e fatturato. L'input in cache è materiale riutilizzato che l'API addebita alla tariffa ridotta prevista per la cache.
Un milione di token di input non in cache più un milione di token di output costa $60 su Astra, $12 su Sol o $0.60 su Luna. Sono due milioni di token fatturati. Un milione di token totali, ripartiti in parti uguali tra input non in cache e output, costa rispettivamente $30, $6 o $0.30.
Per calcolare il costo di un modello testuale, separa l'input nuovo da quello in cache:
Costo dei token = input nuovo / 1M × tariffa di input + input in cache / 1M × tariffa della cache + output / 1M × tariffa di output.
Se il registro di utilizzo riporta input totale e input in cache, l'input nuovo è la differenza tra i due. Applicare la tariffa ordinaria all'intero input e aggiungere poi quello in cache significa conteggiarlo due volte.
Su Sol, l'input in cache costa il 95% in meno di quello non in cache. Un milione di token di output, però, costa comunque quanto 100 milioni di token di input in cache. Un forte risparmio grazie alla cache non giustifica una quantità illimitata di testo generato. Conta tutto l'output fatturato nell'intera attività dell'agente, anziché stimare soltanto la risposta finale visibile all'utente.
Calcolare il costo delle API OpenAI: tre carichi di lavoro mensili
I tre carichi di lavoro costano $159.40 al mese con la ripartizione suggerita. È un esempio di pianificazione per chi gestisce una piccola app, non una fattura misurata in produzione né una promessa di risultati equivalenti tra modelli.
Si assume che ogni singola richiesta rientri nella condizione Standard della fonte, con contesto inferiore a 272K. I volumi in cache rappresentano effettivi utilizzi della cache fatturati come tali. I volumi di output comprendono tutto l'output fatturato di tutte le chiamate. Le attività degli strumenti sono incluse dove indicato; abbonamenti, hosting e altre voci non specificate restano fuori dai totali. I calcoli usano le tariffe attuali di OpenAI.
Bot di assistenza: $13.90 con Luna
Ipotizziamo 10,000 conversazioni al mese. Sommando le chiamate di ogni conversazione, il budget prevede 1,000 token di input nuovo, 4,000 token di input in cache e 500 token di output. I totali mensili sono 10M di input nuovo, 40M di input in cache e 5M di output. Ipotizziamo inoltre 1,000 chiamate di ricerca web nel mese.
Con Luna, i token costano:
10 × $0.10 + 40 × $0.01 + 5 × $0.50 = $3.90.
Le ricerche aggiungono $10, portando il totale a $13.90, ossia $1.39 per 1,000 conversazioni. Con lo stesso utilizzo, Sol costa $74 di token più $10 di ricerca, per un totale di $84. Astra costa $390 di token più $10 di ricerca, per un totale di $400.
Luna è il candidato economico se il bot svolge un'attività di assistenza ben delimitata e le risposte superano le verifiche di accettazione. Il calcolo presume che il materiale riutilizzabile abbia i requisiti per la fatturazione in cache. Senza utilizzi della cache, tutti i 50M di token di input sono nuovi: il subtotale dei token di Luna sale a $7.50 e il totale a $17.50. Registra quanto il costo cambia in questo scenario prima di considerare un utilizzo atteso della cache come un risparmio acquisito.
Agente di coding: $140 con Sol
Ipotizziamo 1,000 attività di coding al mese. Sommando tutti i turni di ogni attività, il budget prevede 15,000 token di input nuovo, 100,000 token di input in cache e 5,000 token di output. Il mese usa quindi 15M di input nuovo, 100M di input in cache e 5M di output. Un'attività può comprendere più richieste: questi sono i totali dell'attività.
Ipotizziamo anche 2,000 chiamate di ricerca web e 1,000 sessioni di container, ciascuna con 1 GB e l'unità di sessione di 20 minuti indicata dalla fonte.
Il costo dei token di Sol è:
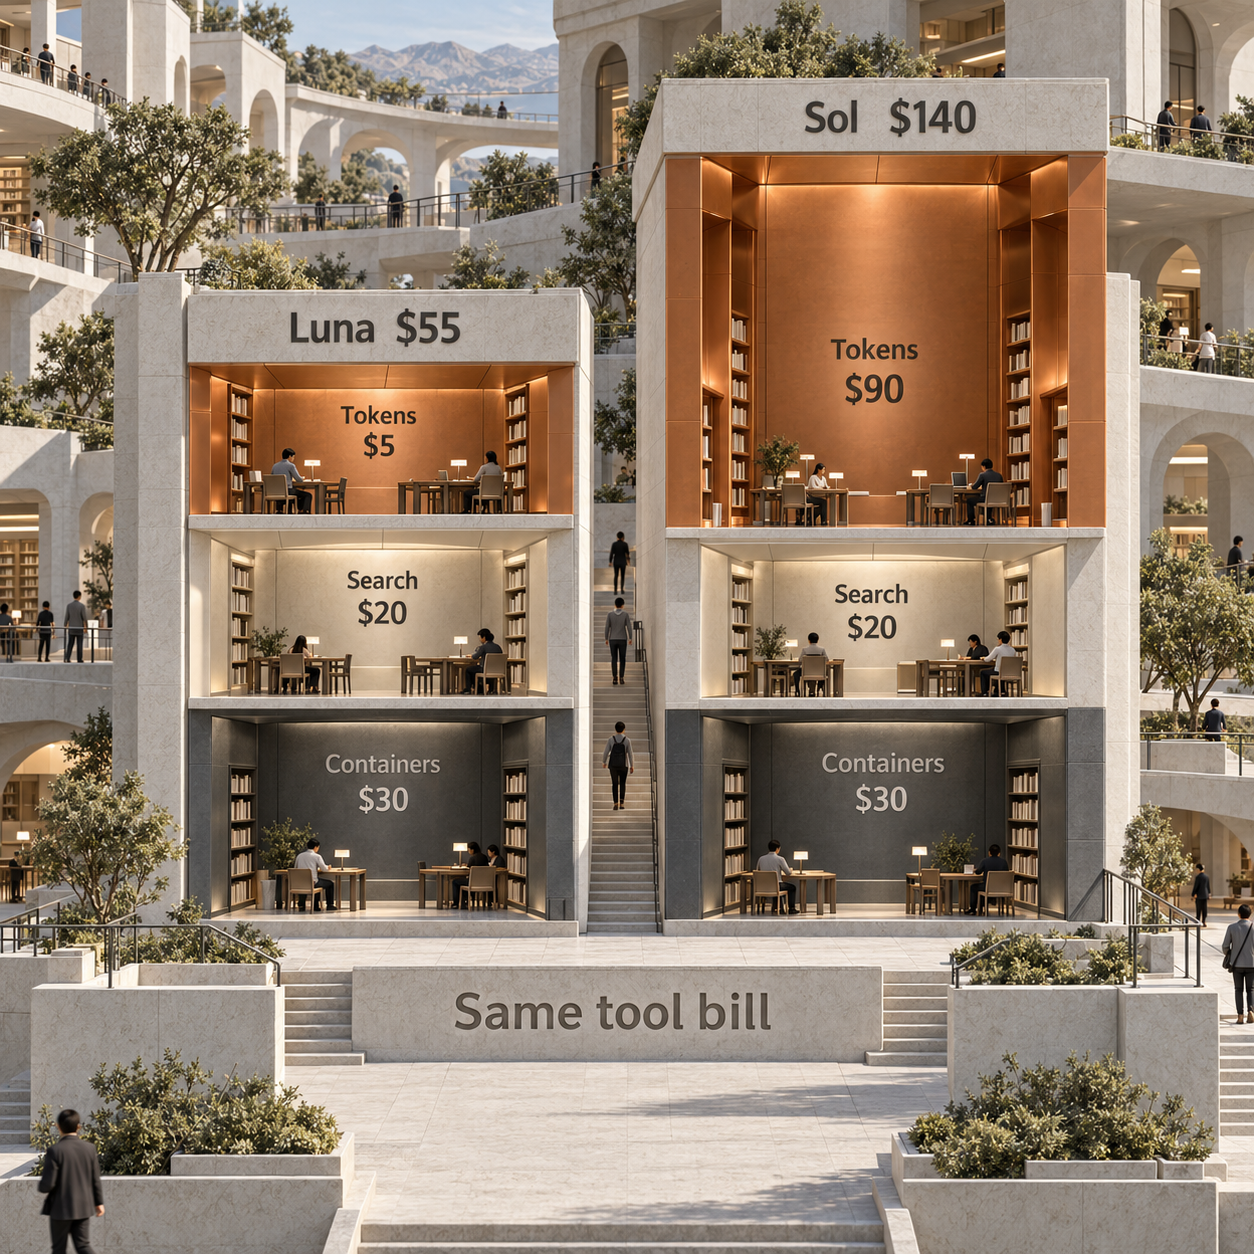
15 × $2 + 100 × $0.10 + 5 × $10 = $90.
La ricerca costa $20 e i container costano 1,000 × $0.03 = $30. Il totale è $140 al mese, ossia $0.14 per attività.
A parità di volumi fatturati, Astra costa $500 di token più gli stessi $50 di strumenti, per un totale di $550. Luna costa $5 di token più $50 di strumenti, per un totale di $55.
Il modello più economico non elimina il costo degli strumenti. Passare da Sol a Luna fa risparmiare $85 al mese in questo esempio. Se il codice prodotto richiede più di $85 di lavoro aggiuntivo per essere corretto, il risparmio svanisce. Il passaggio ad Astra richiede una prova di segno opposto: abbastanza lavoro da rifare evitato da giustificare il sovrapprezzo di $410. È il criterio che un confronto basato soltanto sui token non può fornire.
Riepiloghi in batch: $5.50 con Luna
Ipotizziamo 20,000 documenti al mese, ciascuno con 4,000 token di input non in cache e 300 token di output. Il risultato è 80M di token di input e 6M di output. Non si ipotizzano utilizzi della cache né costi degli strumenti, e i riepiloghi possono essere elaborati in modo asincrono nella finestra di 24 ore della Batch API.
Il costo Standard dei token di Luna sarebbe 80 × $0.10 + 6 × $0.50 = $11. Applicando lo sconto Batch del 50% indicato dalla fonte, si ottengono $5.50 al mese, ossia $0.275 per 1,000 riepiloghi.
Gli stessi volumi in Batch costano $110 su Sol e $550 su Astra. Usa il modello più economico quando i riepiloghi rispettano lo standard richiesto; affida i singoli documenti difficili a un modello più capace quando il costo delle correzioni lo giustifica. Un cliente che attende una risposta immediata rappresenta un carico di lavoro diverso e non va preventivato come elaborazione Batch asincrona.
Il budget mensile complessivo
La ripartizione suggerita dà un totale di $13.90 per l'assistenza con Luna + $140 per il coding con Sol + $5.50 per i riepiloghi Batch con Luna = $159.40.
Usare Sol per tutte e tre le attività costa $334. Usare sempre Astra costa $1,500. Usare sempre Luna costa $74.40, purché il lavoro sia accettabile. Questi confronti mantengono costanti i volumi fatturati di token e strumenti; non presumono che, nella pratica, i modelli richiedano lo stesso numero di tentativi.
Per chi gestisce un'app, questa differenza determina la fattura. Un modello che richiede più turni può consumare più input, output, chiamate di ricerca e sessioni. Confronta il costo per conversazione accettata, attività di coding completata o riepilogo utilizzabile prima di applicare la tariffa più bassa a tutto il prodotto.
Prezzi della OpenAI Batch API e residenza dei dati
Batch riduce del 50% le tariffe indicate per input e output; la residenza dei dati aggiunge un sovrapprezzo del 10%. La pagina dei prezzi di OpenAI presenta queste opzioni di elaborazione separatamente dalle tariffe Standard.
Batch esegue il lavoro in modo asincrono nell'arco di 24 ore. È adatto a riepiloghi di documenti da produrre durante la notte, classificazioni e altri compiti la cui scadenza consente quella finestra. Nell'esempio dei riepiloghi, lo sconto si applica soltanto all'input nuovo e all'output: non si fanno quindi ipotesi su sconti per l'input in cache o sugli strumenti.
Su un subtotale di $90 per i token del modello, il sovrapprezzo per la residenza dei dati porta il costo a $99, con $9 aggiuntivi. L'esempio non stabilisce se ricerca e container ricevano lo stesso trattamento, né come la residenza dei dati si combini con le altre modalità. La scheda dei prezzi non offre dettagli sufficienti per calcolare qui queste combinazioni.
La pagina descrive anche la modalità Fast e l'elaborazione Flex. Fast è un'opzione a consumo per ottenere maggiore velocità; Flex offre un costo inferiore in cambio di risposte più lente e possibili indisponibilità occasionali. La scheda non riporta tariffe esatte per nessuna delle due, quindi questi budget non applicano moltiplicatori inventati.
Gli strumenti possono fissare il costo minimo
Conta le chiamate di ricerca e le sessioni dei container separatamente dai token del modello. La stima dei token può essere corretta mentre il budget mensile resta troppo basso, perché un'attività usa altre risorse a pagamento.
Quanto costa la ricerca web nelle API OpenAI?
La ricerca web costa $10 per 1,000 chiamate e la pagina indica che i token dei contenuti di ricerca sono gratuiti. Sono $0.01 a chiamata: 100 chiamate costano $1; 10,000 costano $100. Il lavoro del modello, fatturato separatamente, va comunque incluso nel totale dei token. Fonte: prezzi delle API OpenAI.
Nell'esempio dell'assistenza, 1,000 ricerche costano più dell'intero subtotale dei token di Luna. La frequenza delle ricerche deve essere una scelta consapevole di prodotto. Una risposta che richiede informazioni aggiornate può giustificare una ricerca; una risposta basata su una procedura di assistenza già fornita non dovrebbe comportare automaticamente un costo di ricerca.
Container: si paga per sessione
I container, gli ambienti di esecuzione usati insieme ai modelli, costano $0.03 per 1 GB oppure $1.92 per 64 GB, per ogni sessione di 20 minuti e per ciascun container. La pagina dei prezzi fa partire questa fatturazione a sessione dal 31 marzo 2026, una data già trascorsa in questa rilevazione di ottobre. La vecchia dicitura «Now» non giustifica l'ipotesi di un unico costo permanente per container. Fonte: prezzi delle API OpenAI.
L'esempio di coding assume esplicitamente 1,000 sessioni da un GB. Non afferma che ogni attività di coding consumi esattamente una sessione. Conta le sessioni come voce autonoma, soprattutto quando le attività usano più container o si estendono su più unità di sessione.
Alla tariffa indicata per 64 GB, quelle 1,000 sessioni costerebbero $1,920. Mantenendo invariati i token di Sol e le chiamate di ricerca, il mese di coding passerebbe da $140 a $2,030. La tariffa a sessione del container più grande è 64 volte quella del più piccolo. La pagina non fornisce prezzi per dimensioni intermedie, quindi qui non vengono ricavati per interpolazione.
Prezzi della OpenAI Realtime API
GPT-Realtime-2.1 applica prezzi diversi agli input audio, testuali e di immagini. I token audio sono un'unità di fatturazione della voce: non vanno trattati come token di testo né convertiti in minuti con una regola priva di riscontro.
Un milione di token di input audio non in cache più un milione di token di output audio costa $32 + $64 = $96 su GPT-Realtime-2.1. Gli stessi volumi di token costano $10 + $20 = $30 su GPT-Realtime-2.1 mini. Gli input testuali e di immagini seguono le rispettive righe della tabella. Fonte: prezzi delle API OpenAI.
Per le attività fatturate a tempo, GPT-Live-1 è il modello per le conversazioni, GPT-Live-Transcribe si occupa della trascrizione in diretta, GPT-Transcribe della trascrizione asincrona e GPT-Realtime-Translate della traduzione in tempo reale. Applicando le tariffe al minuto indicate, 1,000 minuti costano rispettivamente $50, $17, $4.50 o $34. Sono attività diverse, non piani vocali intercambiabili. La pagina non offre una conversione che permetta di esprimere l'esempio dei token audio Realtime in un numero equivalente di minuti.
Prezzi delle API OpenAI per le immagini
GPT-Image-2.5 Sunburst e GPT-Image-2.5 Flare hanno le stesse tariffe per token nel listino. Entrambi costano $8 per l'input di immagini, $2 per l'input di immagini in cache e $30 per l'output di immagini, per milione di token; i prompt testuali costano $5 per l'input o $1.25 per l'input in cache. OpenAI presenta Sunburst puntando sulla precisione delle modifiche e Flare sulla velocità nella generazione quotidiana. Fonte: prezzi delle API OpenAI.
Ipotizzando un milione di token di immagini generate più un milione di token di prompt testuale non in cache, il costo è $30 + $5 = $35 con entrambi i modelli. Non significa un milione di immagini. La pagina dei prezzi spiega che le immagini vengono convertite in token, ma non stabilisce un numero fisso di token per immagine generata da usare in questo calcolo.
Stima il budget delle immagini partendo dai consumi effettivamente fatturati per immagini e testo. Evita di promettere un costo fisso per immagine sulla base di una tariffa per token, o di scegliere tra questi modelli per una differenza di prezzo che la pagina non mostra.
Abbonamenti, accesso gratuito e altri dubbi sulla fatturazione
Un abbonamento a ChatGPT non copre la fattura API dell'applicazione. OpenAI separa esplicitamente la fatturazione API da ChatGPT Plus, Business, Enterprise ed Edu. Consulta la guida ai prezzi di ChatGPT per scegliere l'abbonamento e prevedi separatamente il budget di utilizzo dell'app.
OpenAI Codex: come calcolare i costi API
Codex è il prodotto di OpenAI per il coding; la distinzione rilevante riguarda come ne paghi l'utilizzo. Per stimare le attività API fatturate separatamente, usa le voci di modello, token e strumenti riportate sopra. Le quote incluse nei piani del prodotto sono un acquisto diverso. La guida ai prezzi di Codex tratta la scelta dell'abbonamento.
Acquistare una licenza per uno sviluppatore non rende prepagato l'utilizzo dell'app per il bot di assistenza, il coding automatizzato o i riepiloghi in batch. Mantieni separate nel budget la spesa per gli abbonamenti ai prodotti e quella a consumo per le API dell'applicazione.
OpenAI API gratis: è prevista una quota gratuita?
La pagina dei prezzi consultata non indica alcuna quota generale di token API gratuiti. Specifica che l'utilizzo di Playground, l'interfaccia nel browser per provare le richieste, viene fatturato come il normale utilizzo API. Non considerare gratuita la sperimentazione soltanto perché avviene fuori dall'app.
Chi usa esclusivamente ChatGPT nella versione gratuita potrebbe non avere mai bisogno di acquistare utilizzo API. Quando però l'app effettua richieste API a pagamento, la scelta dell'app gratuita non giustifica un budget di produzione a costo zero.
Questa fonte non indica uno sconto API universale per studenti, una politica di rimborso API, la scadenza dei crediti o un impegno annuale sui prezzi dei token. Queste omissioni non dimostrano che non esistano offerte specifiche per account o politiche separate. Significano che questa rilevazione dei prezzi non può prometterle. In particolare, non applicare a un budget API le condizioni di rimborso o di fatturazione annuale di un abbonamento.
Imposta il budget della prossima settimana sul lavoro completato
Parti da Sol e misura l'intera attività prima di ottimizzare la tariffa del modello. Il prossimo budget dovrebbe basarsi sull'utilizzo fatturato osservato, non sul numero di parole della risposta finale.
Registra un punto di partenza
Su attività rappresentative, registra input nuovo, input in cache, output fatturato, ricerche e sessioni dei container lungo tutti i turni. Affianca al costo il risultato della verifica di accettazione dell'attività.
Assegna le attività circoscritte al modello adatto
Prova Luna per compiti mirati i cui risultati possono essere verificati. Sposta in Batch il lavoro che può attendere. Mantieni questa ripartizione soltanto quando l'output soddisfa i criteri di accettazione.
Confronta il sovrapprezzo con il costo del lavoro da rifare
Per i compiti difficili, confronta il costo API aggiuntivo di Astra con il valore delle correzioni che evita. Usa il numero effettivo di tentativi e l'utilizzo reale degli strumenti, anziché presumere che ogni modello consumi gli stessi token.
Le FAQ sui prezzi di OpenAI avvertono che l'applicazione del limite di budget mensile può subire ritardi e che l'utente resta responsabile degli importi eccedenti. Considera quindi il budget configurato uno strumento di controllo della spesa con questa limitazione dichiarata, e monitora l'utilizzo effettivo. Per l'organizzazione dei progetti e le procedure di ripristino, consulta la guida ai controlli del budget API.
Domande frequenti
Quanto costa OpenAI?
L'utilizzo delle API OpenAI viene fatturato in base a modello, token e strumenti. Per le richieste Standard sotto la soglia di contesto indicata, Sol costa $2 per l'input, $0.10 per l'input in cache e $10 per l'output, per milione di token. Questo listino API non prevede un prezzo mensile unico per l'intera app.
L'API di ChatGPT costa meno di ChatGPT Plus?
Dipende dall'utilizzo e dalle esigenze. La fattura API di un'app può essere contenuta, ma paga richieste dell'applicazione a consumo, mentre l'abbonamento offre l'esperienza del prodotto. OpenAI dichiara che l'utilizzo API viene fatturato separatamente dagli abbonamenti ChatGPT.
Come confrontare prezzi e costi delle diverse API LLM?
Prima di confrontare i fornitori, metti sullo stesso piano input, input in cache, output, uso degli strumenti e completamento con successo. A parità di utilizzo, lo scenario di coding OpenAI qui descritto costa $55 su Luna, $140 su Sol e $550 su Astra, mantenendo la qualità come condizione di accettazione. Questa rilevazione non contiene prezzi verificati di altri fornitori.
Vale la pena pagare per OpenAI?
Conviene quando il lavoro accettato fa risparmiare più del costo dell'utilizzo API e del lavoro da rifare che ne deriva. Parti da Sol per il coding; passa ad Astra quando il costo aggiuntivo è giustificato dalle correzioni evitate e usa Luna dove il suo lavoro supera le stesse verifiche richieste.
Vale la pena pagare $20 per ChatGPT?
Un abbonamento a ChatGPT conviene quando le funzionalità e il tempo risparmiato ne giustificano il costo. Non copre l'utilizzo dell'app calcolato qui, quindi la spesa API resta una decisione separata.
Le API OpenAI sono gratuite o a pagamento?
La pagina riporta l'utilizzo a pagamento di modelli e strumenti e non indica una quota API gratuita generale. Specifica anche che le richieste Playground sono fatturate come normali richieste API. Usare ChatGPT gratuitamente non implica un utilizzo API gratuito.
Le API OpenAI costano molto?
Dipende dal compito e dall'uso degli strumenti. Il mese ipotetico di assistenza costa $13.90 con Luna, mentre quello di coding con Sol costa $140. Entrambe le cifre dipendono dai volumi fatturati indicati; una tariffa bassa per i token non elimina i costi di ricerca o dei container.
Quali sono le migliori API AI gratuite?
La pagina dei prezzi non indica una quota generale di utilizzo gratuito delle API OpenAI. Luna è un'opzione a pagamento dal costo contenuto per attività mirate i cui risultati superano le tue verifiche. Prima di inserire nel budget di produzione la quota API gratuita di un fornitore, occorre verificarne separatamente le condizioni aggiornate.
Quanto costa 1 milione di token OpenAI?
Per un milione di token di input non in cache, Astra costa $10, Sol $2 e Luna $0.10. Per un milione di token di output, i prezzi sono $50, $10 e $0.50. Un milione di token di input più un milione di output significa due milioni di token fatturati, per totali di $60, $12 o $0.60.
OpenAI offre uno sconto API per studenti?
La pagina dei prezzi verificata per questo articolo non indica uno sconto API universale per studenti. Non considerare un'offerta studenti per un altro prodotto OpenAI come credito API, a meno che le sue condizioni non prevedano esplicitamente quel beneficio.
Qual è la politica di rimborso delle API OpenAI?
La pagina dei prezzi verificata non riporta una politica di rimborso API. Questo articolo non promette quindi rimborsi e non applica agli acquisti API le regole degli abbonamenti ChatGPT.
I prezzi delle API OpenAI sono cambiati nel 2026?
La pagina attuale fa partire esplicitamente dal 31 marzo 2026 la fatturazione dei container per sessioni di 20 minuti. Non fornisce una serie storica dei prezzi dei modelli: questa rilevazione di ottobre non afferma quindi quando siano cambiati i prezzi dei token, né cita tariffe precedenti.
Definisci le attività e le verifiche di accettazione prima di scegliere un altro piano. Ricevi la checklist per l'audit dei flussi di lavoro aziendali con l'AI quando ti iscrivi alla newsletter.
- Ultimo aggiornamento
- 3 ott 2026
- Categoria
- Build
Preferisca questo sito su Google


Segni omidsaffari.com come fonte preferita e Google lo mette in evidenza per lei in Top Stories, AI Overviews e AI Mode.
Pi Coding Agent: installazione e prima prova con Pi 1.0
Configura Pi 1.0, collega il modello che già usi e completa una prima attività. Guida a installazione, AGENTS.md, costi dei provider e limiti pratici.3 ott 2026Build
Agenti AI senza codice: 8 piattaforme a confronto nel 2026
Confronta 8 piattaforme per creare agenti AI senza codice: prezzi, crediti, integrazioni e limiti per scegliere lo strumento adatto al tuo lavoro.1 ott 2026Build
Lovable pricing: piani, crediti e budget mensile nel 2026
Scopri quanto costa Lovable: piani Free, Pro e Business, crediti, ricariche, scadenze e costi Cloud e AI, con un budget per una piccola app interna.1 ott 2026Build
Codex CLI e Security Cloud: configurazione, costi e CI
Configura Codex Security dopo DevDay: scansioni Cloud, review delle pull request e CLI in CI. Costi per cinque persone, limiti e controllo umano.30 set 2026Build
LearnWorlds Pricing 2026: costi reali e piano più conveniente
Scopri prezzi, commissioni e crediti AI di LearnWorlds: il confronto tra Starter, Pro Trainer e Learning Center per scegliere il piano più conveniente.30 set 2026Build
Notion AI vs ChatGPT Space: quale conviene scegliere?
Notion AI vs ChatGPT Space: confronto su prezzi, database, permessi e migrazione per scegliere lo spazio di lavoro giusto per il tuo progetto.30 set 2026Build
Chrome DevTools MCP con Kitesurf WebMCP: guida pratica
Scopri come collegare Chrome DevTools MCP a Kitesurf WebMCP, eseguire azioni strutturate, verificarne l'esito e predisporre un fallback sicuro.30 set 2026Build