Claude Code プラグインのeval入門:効果を差分で検証する
Claude Code 2.1.269で追加されたネイティブplugin evalを使い、プラグインあり・なしの実行を比較する方法を解説します。ケースとgraderの設計、WITH・W/OUT・Δの読み方、意図的な回帰テスト、コスト管理、CIゲートへの組み込みまで、再現可能なリリース判定を具体例とともに整理します。


Claude Code プラグインは、ファイルが正しいだけでなく、Claudeの振る舞いを本当に変えたのかまで検証できるようになりました。ネイティブのclaude plugin evalコマンドは、プラグインあり・なしの両条件で同じ現実的なリクエストを実行し、それぞれを採点して差を示します。「スキルが動いたように見える」という曖昧な確認を、時間・ターン数・利用量の予算を伴うリリース判断へ変えられます。
この機能が加わったタイミングは重要です。Claude Code 2.1.269では、2026年9月11日にplugin evalが追加されました。この検索テーマで現在上位にある日付付きチュートリアルは、まだ独自のPythonランナーを前提にしています。ローカルプラグインを保守しているなら、いま最短の手順はネイティブ機能です。振る舞いを確かめるケースを1つ作り、コントロール群と比較してレポートを確認し、最後に意図的に起こした回帰をCIで拒否できるようにします。
Claude Code プラグインのevalは何を測るのか
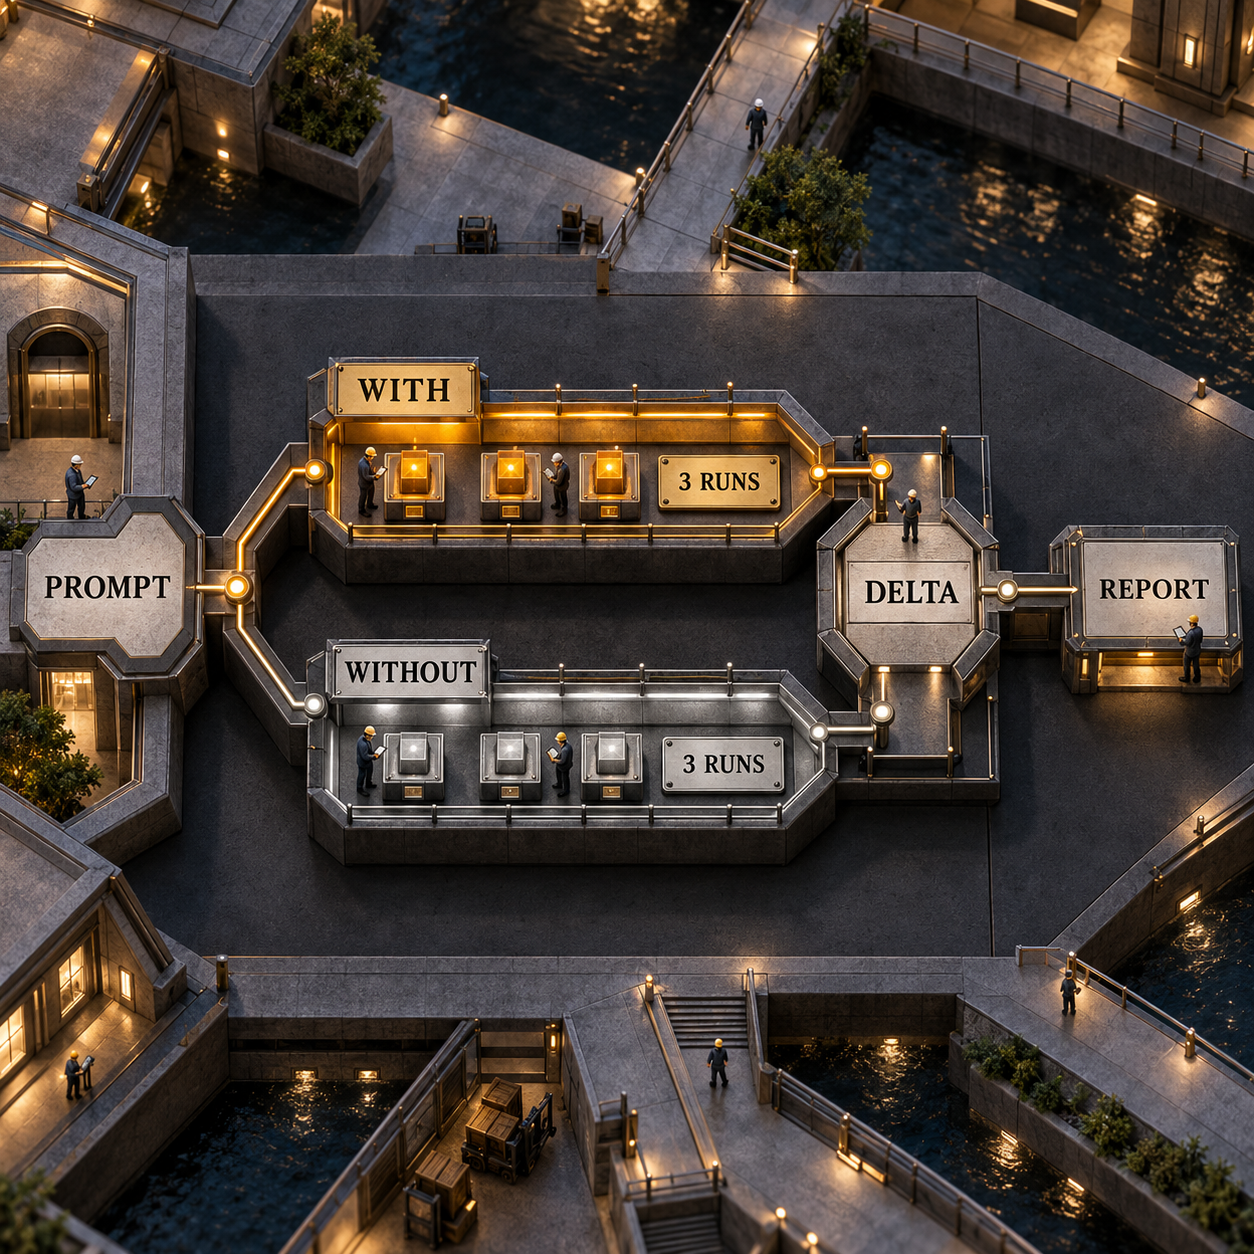
plugin evalは、エージェントの振る舞いを対象にしたA/Bテストです。同じ作業指示書を渡された、まったく同じ2つの工房を想像してください。一方にはプラグインが入り、もう一方には入っていません。Claude Codeは両方で作業を繰り返して成果を採点し、WITH、W/OUT、Δを報告します。Δは、プラグインありのスコアから、なしのスコアを引いた値です。
見るべき数字は、この差分です。両方が1.0なら優秀に見えますが、Claudeはプラグインがなくてもタスクを完了できたことになります。プラスの差分は、プラグインの貢献が測定できたことを示します。マイナスなら、テストした振る舞いをプラグインが悪化させています。
デフォルトでは、1ケースにつきプラグインありの新規セッションを3回、なしの新規セッションを3回実行します。各セッションには、隔離されたホーム、作業ディレクトリ、Claude Code設定が用意されます。個人設定、プロジェクトのCLAUDE.md、ほかのプラグイン、メモリ、個人用MCPサーバーは引き継がれません。この隔離によって比較は明快になります。一方、手元のPC環境へ暗黙に依存しているプラグインは、まさに検出すべき理由で失敗します。隔離とセキュリティの詳しい仕様は、Anthropicのplugin evalドキュメントで確認できます。
まず動作するローカルプラグインを用意する
振る舞いのevalは2番目の確認であり、最初ではありません。プラグインのディレクトリには、plugin.json、.claude-plugin/plugin.json、または有効なskillsディレクトリ構成が必要です。ファイルやスキーマの問題はclaude plugin validateで検証します。claude plugin evalが答えるのは、「自然な依頼でスキルが起動したか」「決められた社内フォーマットで出力したか」といった問いです。
Claude Code v2.1.269以降と、通常のセッションで使っているものと同じ認証も必要です。evalセッション、judge graderによる採点、対話式イニシャライザーは、いずれもプランの利用枠またはAPI課金を消費します。Claude Code全体のセットアップにまだ慣れていない場合は、リリースゲートを加える前に基本的なローカルワークフローから始めてください。
信頼できるプラグインのルートで、バージョンを確認して空のケースを作成します。
claude --version
claude plugin eval init --bare release-note対話式で進めるならclaude plugin eval initを使います。プラグインを読み込み、良い結果の条件を尋ね、ケースとgraderを提案し、一度試験実行してからスイートを書き出します。仕様を理解するには--bareのほうが適しています。実行せず、必要なファイルだけを生成するためです。
理解できる振る舞いを1ケースだけ作る
動作中のプラグインにrelease-notesというスキルがあるとします。その価値は、文章を生成することだけではありません。自然な製品変更の依頼を認識し、チーム所定の3部構成、Summary、Impact、Riskでリリースノートを返す必要があります。
ユーザーが実際に入力しそうな依頼をprompt.mdへ置きます。次に、結果を確認する決定論的graderと、処理経路を確認する決定論的graderを1つずつ追加します。「決定論的」とは、CLIがトレースまたはテキストを直接確認し、judgeモデルを呼び出さないという意味です。
# evals/release-note/prompt.md
---
name: release-note
tags: [smoke]
runs: 3
max_turns: 8
timeout_seconds: 180
allowed_tools: [Skill]
---

Turn this change into a customer-facing release note: checkout now retries a failed payment once before showing an error.

# evals/release-note/graders/format.md
---
type: regex
target: last_message
pattern: 'Summary[\s\S]*Impact[\s\S]*Risk'
flags: i
---

# evals/release-note/graders/skill-fired.md
---
type: tool_used
tool: Skill
input_match: '"skill"\s*:\s*"(?:[\w-]+:)?release-notes"'
---release-notesは、実際のスキルのSKILL.mdにあるnameへ置き換えてください。このプロンプトでは、あえてスキル名も3つの見出しも指定していません。プラグインが依頼内容を見分け、独自のフォーマットを提供できるかを確かめるためです。プロンプト側に答えをすべて書いてしまうと、プラグインなしの群も合格できるため、差分からは貢献がほとんど読み取れません。
このフロントマターが、現在のネイティブスキーマです。prompt.mdでは、runs、max_turns、timeout_seconds、model、tags、allowed_toolsなどのフィールドをトップレベルに置きます。フィクスチャ、会話履歴、ディレクトリが必要ならcase.yamlを追加します。このファイルにはschema_version: "1.1"とnameが必須で、実行関連のフィールドはexecution:以下へ移します。
evalを実行し、レポートを読む
プラグインのルートからclaude plugin eval .を実行します。この1ケースだけなら、プラグインありのセッション3回と、ベースラインのセッション3回が起動します。各セッションが終わるたびに、進行状況の行へgraderの結果が表示されます。最後のサマリーにはWITH、W/OUT、Δ、RUNS、COST、NOTESが並びます。
次の順番で読みます。
WITHは、プラグインありのセッションがgraderの条件を満たしたかを示します。W/OUTは、プラグインなしでもClaudeが同じ結果をどの程度出せたかを示します。Δは、プラグインの貢献度です。プラスなら有効、ゼロ付近なら要調査、マイナスなら回帰です。COSTは定価ベースの見積もりであり、サブスクリプションで実際に請求される金額とは限りません。NOTESには、プラグインありの群で最も重みの高い失敗、または実行エラーが示されます。
ケースが1つ以上あるスイートは、タイムスタンプ付きの結果ディレクトリへaggregate-result.jsonと自己完結型のreport.htmlを必ず書き出します。HTMLレポートでは各実行を開き、graderごとの判定と説明を確認し、プロンプトやgraderの定義とClaudeの実際の処理を比較できます。JSONには、全体スコア、合格ケース、平均差分、部分実行の状態、コスト見積もり、所要時間、Claude Codeのバージョンなど、CIで安定して扱えるフィールドが入ります。
テストを信頼する前に、意図的に回帰を起こす
次に、このテストが本当に失敗できることを証明します。release-notesスキルのdescriptionを一時的に、対象の仕事が分からない曖昧な文へ置き換えてください。evalケースは変更しません。同じコマンドをもう一度実行し、新しいレポートを確認したら、本来のdescriptionへ戻します。
確認したいのは、振る舞いの失敗です。Skill graderが合格しなくなる、期待したフォーマットの再現性が落ちる、あるいはプラグインありの優位性が縮む、といった変化です。正確なスコアを予想してはいけません。エージェントの実行結果にはばらつきがあります。デフォルトの3回でも、意図的な破壊の前後でレポートがほとんど変わらないなら、そのケースはまだプラグインを守れていません。依頼をより現実的にする、結果用graderを厳密にする、またはスキルが起動してはいけないネガティブケースを追加してください。
これは、煙探知機のテストボタンを押す作業に相当します。関係する欠陥で赤に変わると確認できない限り、緑色のダッシュボードには価値がありません。
ケースを増やす前に、実行予算を決める
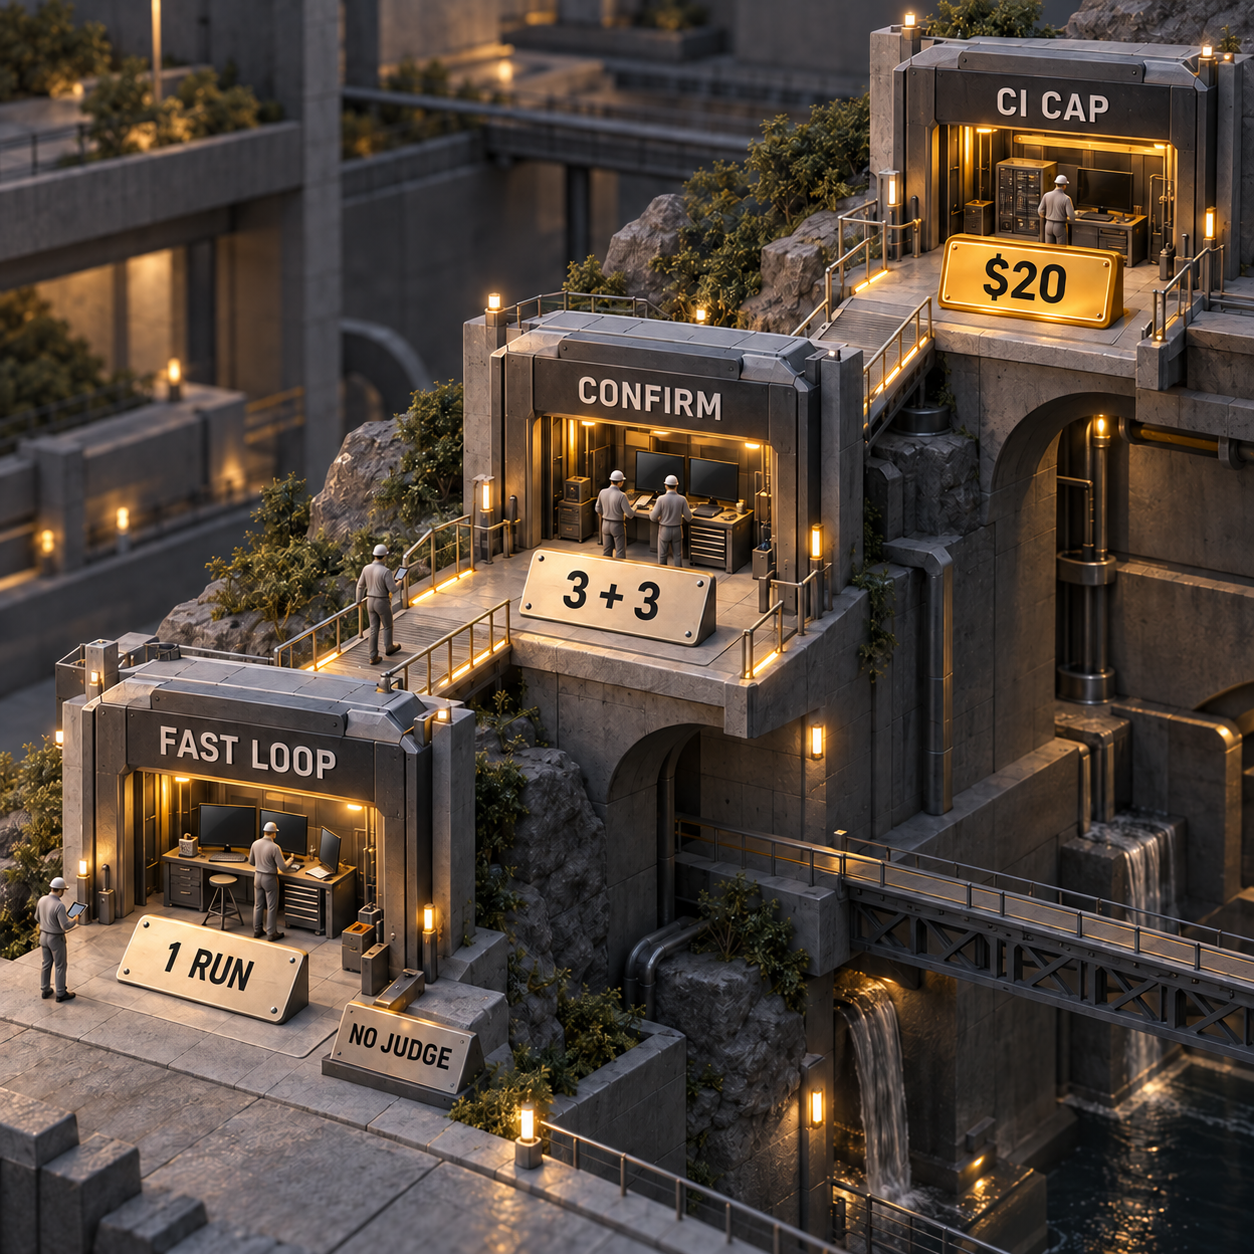
デフォルトの1ケースだけでも、エージェントセッションは6回発生します。同じケースへLLM graderを1つ加えると、judgeの投票は18票増えます。6セッションそれぞれに3票です。各セッション自体も複数ターンに及ぶ場合があります。小さなスイートでも、ケース数から想像する以上の利用量になり得るのはこのためです。
判断の段階に応じて、3種類の予算を使い分けます。
1回だけのループは、意図的にばらつきを許容しています。明らかなミスを見つけるために使い、変更を受け入れる前にはデフォルトの3回で確認してください。頻繁に回す確認にはregex、tool_used、tool_order、file_existsを優先します。judgeの呼び出しが増えないためです。安定したルールで表せない短い成果だけに、LLM graderを使います。
コスト上限のフラグには注意点があります。--max-cost-usdは、各実行を始める前にCLIの定価ベース見積もりへ上限を設けます。すでに進行中の実行は完了するため、レポート上の見積もりが上限を超える場合があります。上限に達すると部分的な結果を残し、終了コード2で終了します。これは安全策であり、前払い式のウォレットではありません。
回帰チェックをCIへ引き渡す
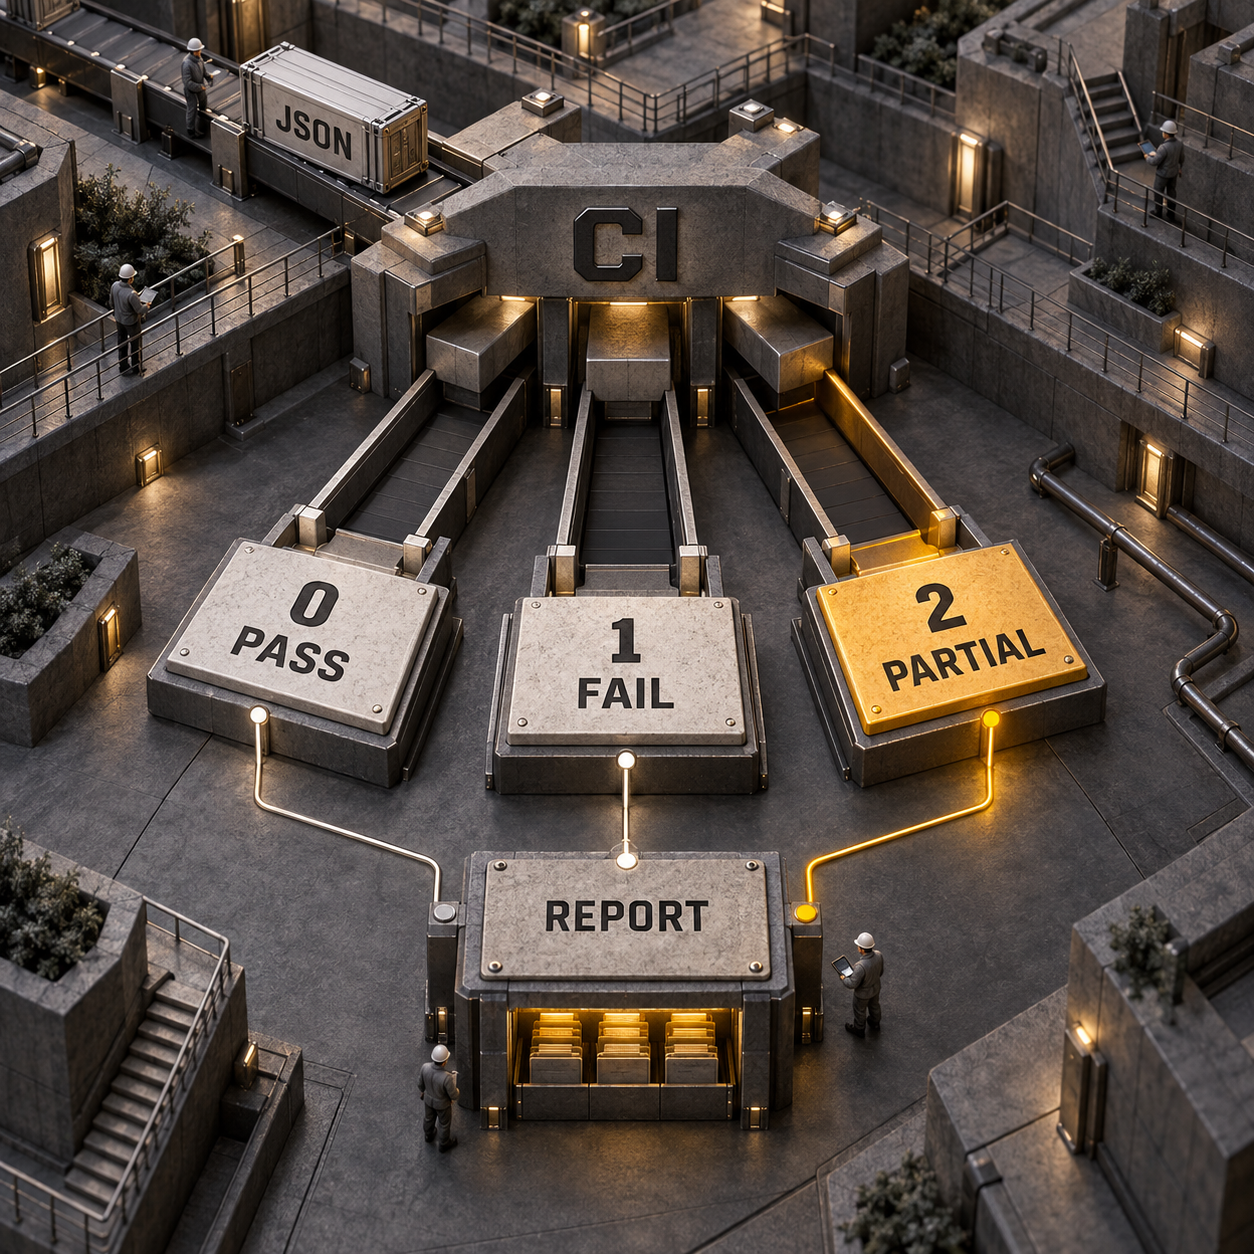
意図的な回帰がレポートに表れ、復元したプラグインが合格したら、同じスイートをバージョン管理へ移します。AnthropicのCI例では、エージェントとjudgeのモデルを固定し、results.jsonを書き出し、しきい値を0.8に設定し、レポートをローカルに保持し、推定コストの上限を$20にしています。--trust-pluginも渡しますが、これはチェックアウトしたプラグインとスイートを自分で実行してもよい場合に限り適切です。
引き渡すコマンドは、正確にはclaude plugin eval . --trust-plugin --json results.json --threshold 0.8 --model claude-sonnet-5 --judge-model claude-haiku-4-5 --no-publish --max-cost-usd 20です。Claude Codeのインストールと認証のあとにこのコマンドをジョブへ置き、2つの結果ファイルを保存します。
ビルドのゲートには、コマンドの終了ステータスだけで十分です。終了コード0は、すべてのケースを読み込み、しきい値を満たしたことを意味します。終了コード1は、しきい値未満のスコアと、いくつかのセットアップエラーに対応します。終了コード2は、コスト上限による部分実行、または最初の認証拒否を示します。失敗時もresults.jsonとreport.htmlを保存してください。そうすれば、プラグインの回帰、タイムアウト、予算による停止のどれだったかを作者が確認できます。
モデルの固定は重要です。固定しなければ、モデルのロールアウトがプラグインの回帰に見える可能性があります。推論コストにも同じ規律を適用してください。品質とeffortを別々の軸でテストし、コストの変化が振る舞いのスコアへ紛れ込まないようにします。
最初にテストしたい7つのプラグイン動作
最も大きな効果を得られるのは、ほかの利用者へプラグインを提供するチームです。個人用の補助ツールなら手動確認でも許容できます。一方、マーケットプレイスや組織向けのプラグインでは、弱いdescription、ツール権限、出力変更の1つ1つが、繰り返し発生するサポート業務につながります。
まず、消えたときにユーザーが気づく振る舞いを2つ選んでください。曖昧なケースを10件並べるより、再現できる欠陥を露出させる起動テスト1件と結果テスト1件のほうが有用です。
ネイティブplugin evalを軸に作れる2つの製品
1. 最有力はプルリクエストの差分ゲート
ネイティブコマンドを実行し、aggregate-result.jsonを読み取り、スコアの変化、差分、コスト、失敗したgrader、保存したレポートへのリンクを1件のレビューとして投稿する軽量なCI製品を作ります。プラグインチームやマーケットプレイスの保守担当者が対価を払うのは、別の評価器ではなく判断レイヤーです。
需要は初期段階ですが、商用意図は明確です。claude code evalsは米国で月間約50回検索され、前年比600%増、CPCは$17.61です。より広い評価プラットフォームにも品質予算が存在し、Braintrustは月額$249のProプランを掲載しています。これはカテゴリの基準点であり、プラグインラッパーの価格提案ではありません。
販売可能な最小構成は、GitHub ActionとPRコメントです。プラグインのパス、しきい値、固定するモデル、推定コスト上限を受け取り、ネイティブのJSONとHTMLをアップロードし、終了コード1とpartialの終了コード2を区別します。ただし、プラットフォーム依存のリスクがあります。AnthropicがファーストパーティのPRレポートを追加する可能性があるためです。防御力になるのは、複数リポジトリをまたぐポリシー、履歴比較、承認ルールであり、ネイティブレポートを見栄えよく複製することではありません。
2. スキル作者には厳選したevalパックを提供できる
コードレビュー、変更履歴の作成、インシデント対応、適切なツール選択といった一般的なプラグイン業務向けに、保守されたケースパックを販売します。パックの実体は、現実的な正例・負例のプロンプトと決定論的graderを備えた通常のevals/ディレクトリです。チームは品質基準をゼロから作る代わりに、自分たち向けに調整できます。
直接的なキーワードであるclaude code skill evalsの米国での検索は月間約10回です。非常に小さいため、単独でベンチャー規模を狙う市場ではなく、焦点を絞ったアドオン向けです。MVPは、価値の高いプラグインカテゴリを1つ選び、そのカテゴリに特化した優れたパックを1つ作ることです。Claude Codeのリリースに合わせてバージョン管理し、短いキャリブレーションガイドを添えます。課題も明確です。claude plugin eval initは、すでにケースを提案し、試験実行まで行います。パックが勝つには、その分野のシナリオと失敗基準が汎用生成より優れていなければなりません。
このコマンドだけでは解決しないこと
ネイティブevalは、プラグインがあらゆる状況で優れているとは証明しません。証明できるのは、選んだプロンプト、環境、モデル、ツール権限、graderのもとでどう振る舞ったかです。弱いプロンプトは都合のよいスコアを生みます。regexなら、内容が誤っていても見出しだけで加点する可能性があります。LLM judgeにはばらつきがあり、graderごと、実行ごとに3票が追加されます。
隔離にも、把握しておくべき制約があります。実行のたびにクリーンな状態から始まるため、プロジェクトファイル、ユーザー設定、フック、個人用サーバーは存在しません。再現性には理想的ですが、フィクスチャの宣言を忘れたケースには不向きです。読み取り専用の標準セットを超えるツールには、明示的なコマンドライン権限が必要です。実物のプラグインMCPサーバーには追加のオプトインと権限が必要であり、フックや実サーバーはエージェントのサンドボックス外で動作できるため、隔離されたランナーで扱うべきです。
最後に、正当な処理が上限へ達するほどmax_turnsやtimeout_secondsを切り詰めないでください。タイムアウトまたはターン数上限に達した実行はエラーとして記録され、通常はスコアを下げます。意図した仕事に十分な余裕を持たせたうえで、推定コスト上限を使ってスイート全体を管理します。
Claude Code プラグインをevalでテストするには?
Claude Code v2.1.269以降を使い、動作するプラグインのルートからclaude plugin eval initを実行してスイートを生成するか、claude plugin eval init --bare <name>で空のケースを作ります。evals/以下へ現実的なプロンプトとgraderを置き、claude plugin eval .を実行したら、サマリーとレポートのWITH、W/OUT、Δを比較します。
Claude Code evalとは?
決定論的graderまたはモデルが判定するgraderで採点する、反復型かつ隔離されたClaude Codeセッションです。plugin evalにはデフォルトでプラグインなしのコントロール群が加わるため、Claudeが単にタスクを完了したかではなく、プラグインが結果を改善したかを測れます。
Claude Codeのskill evalはどう動く?
ユーザーが普段使う自然な言葉でプロンプトを書き、結果と、Skillツールが対象スキルを呼び出したかの両方を採点します。スキルが起動して結果が不合格なら、instructionsの改善が必要です。プラグインなしでも同程度に合格するなら、そのケースではスキルが測定可能な価値を加えていない可能性があります。
月曜日には、プラグイン保守担当者が起動テストを1件追加し、意図的に失敗させ、プラグインを元に戻したうえで、そのテストにCIのコスト上限を設定してください。チーム全体のプラグインへこのリリース判定を導入したい場合は、本番向けゲートの設計を支援できます。
- 最終更新
- 2026年9月12日
- カテゴリー
- Build
Googleでこのサイトを優先する


omidsaffari.comを優先ソースに設定すると、GoogleがTop Stories・AI Overviews・AI Modeであなたのために優先表示します。
AIエージェントの作り方と選び方:ノーコード8ツールを料金・運用で比較【2026年】
AIエージェントの作り方を、ノーコード8ツールの比較から解説します。Gumloop、MindStudio、Lindy、n8nなどの料金、課金単位、連携先、承認設定、無料プランを整理。1人で構築する場合からチームで共有する場合まで、誰が運用を担い、どこからコードが必要になるのかを確認し、業務に合う選択肢を見極めます。2026年10月1日Build
Lovable 料金ガイド(2026年):月額$25でどこまで作れる?
Lovableの料金をFree・Pro・Businessで比較。月額$25のProと月額$50のBusinessの違いに加え、年払い、クレジットの追加購入と有効期限、Cloudとアプリ内AIの費用を整理します。社内ツールの予算例で、付与枠を使った後に残る負担と、実際に支払う月額を確認できます。2026年10月1日Build
脆弱性診断ツールCodex Securityの導入ガイド:Cloud・PRレビュー・CLI
脆弱性診断ツールCodex Securityをチームに導入するための実践ガイドです。Cloudの接続、PRの自動レビュー、CLIとCIでのSARIF保存を解説。5人分のBusiness料金と別途かかる利用料、Gogsの公開事例から学ぶ検出結果の判断、既存の依存関係チェックや人によるレビューを続ける理由も整理します。2026年9月30日Build
LearnWorlds pricing 徹底比較:料金プランと損益分岐点
LearnWorlds pricingを2026年の実価格で比較。StarterとPro Trainerの損益分岐点、年間払い、取引手数料、AIクレジット、非公開研修に必要なプランまで、実際の運用負荷を基準に解説します。50人の社内オンボーディングと月20件の有料登録を例に、総コストで最適な選択肢を判断できます。2026年9月30日Build
Notion AIとChatGPT Spaceを比較:チームに合うのはどちら?
Notion AIとChatGPT Spaceを料金、共同編集、データベース、権限、移行性で比較します。年払いのBusinessはどちらも1席あたり月額$20。AIと育てる共有ブリーフにはSpace、担当者・期限・ステータスを管理する業務基盤にはNotionが向く理由と、導入前のテスト手順を解説します。2026年9月30日Build
MCP サーバーで動かすKitesurf WebMCP:接続・実行・検証ガイド
Kitesurf WebMCPをMCP サーバーから接続し、Webサイトのツールを検出・実行・検証する手順を解説します。Cloudflare Radarを使った安全なテストから、iframeや承認操作のフォールバック、本番導入前に比較すべき保守コストまで、開発チーム向けに具体的に整理しました。2026年9月30日Build
ChatGPT エージェント 料金を検証:OpenAI Dotsの無料範囲と対応プラン
OpenAI DotsはChatGPT FreeやPlusでは利用できません。個人向けの最低条件は月額$100のPro 100です。対象プランでは今後1カ月の利用量が枠に算入されませんが、その後の料金は未公表です。対応プラン、地域制限、Business Premiumの費用、1カ月で見極める実践テストまで整理します。2026年9月29日Build