Claude Sonnet 5.5: como usar na prática
Aprenda a usar o Claude Sonnet 5.5 com o nível de esforço certo, um fluxo verificável e ajustes de API para obter respostas rápidas sem perder o controle.



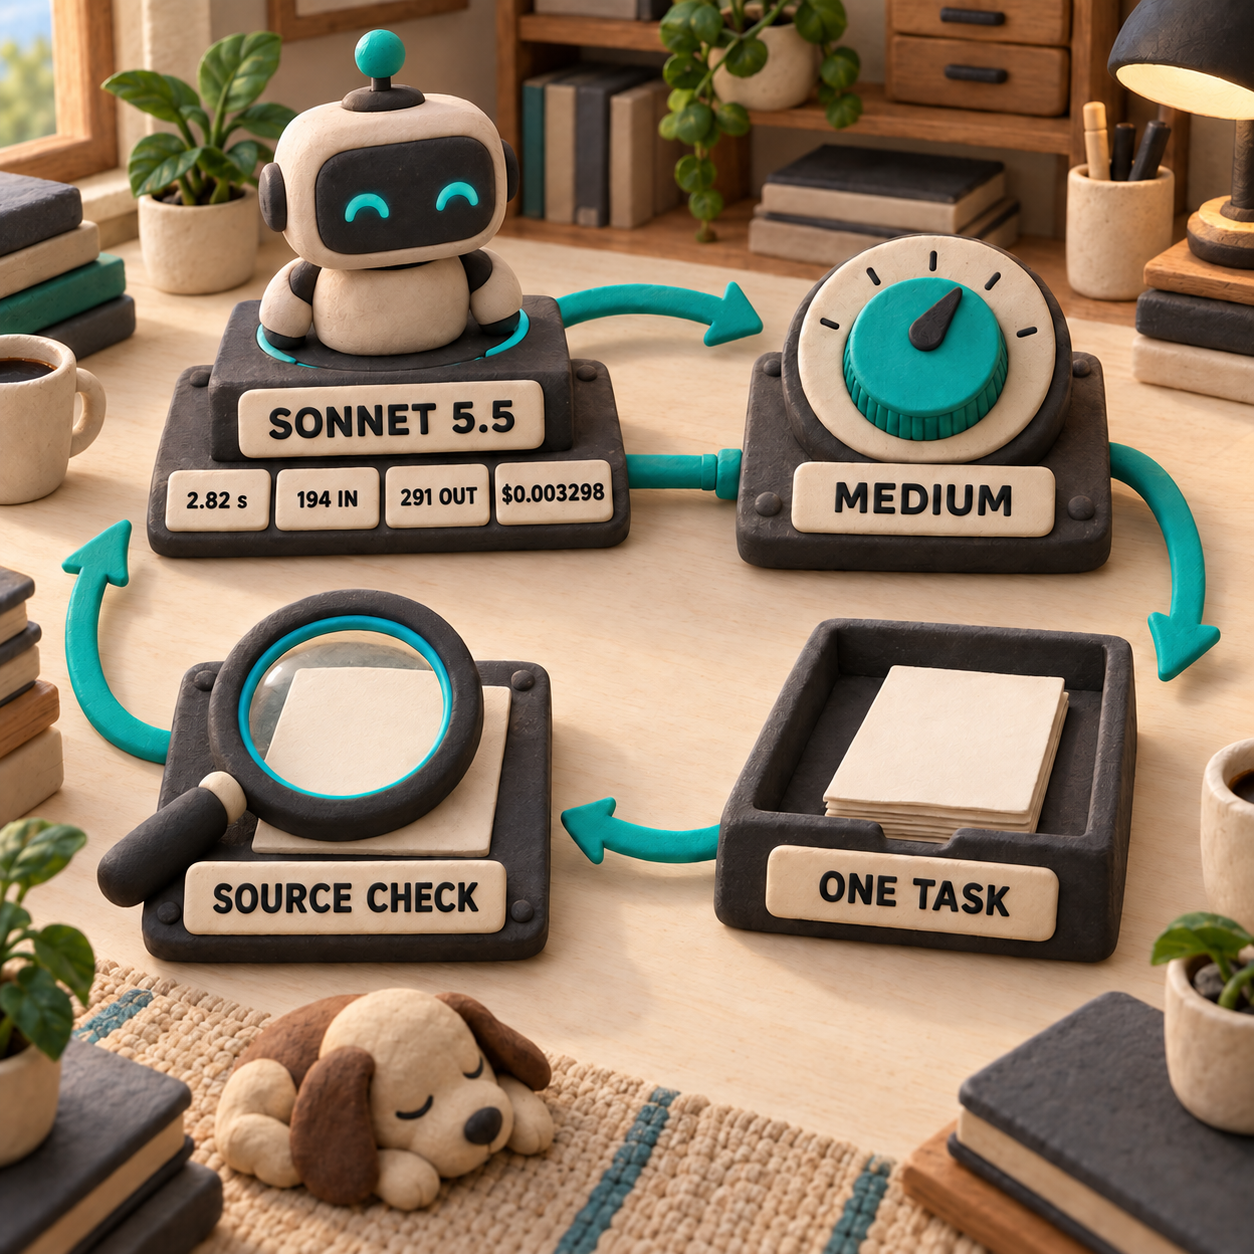
Comece usando o Claude Sonnet 5.5 em uma única tarefa delimitada e fácil de revisar, com esforço Medium: resumir um chamado de suporte ou preparar um briefing de cliente, por exemplo. No meu teste local com um chamado sintético, o modelo respondeu em 2.82 segundos, consumiu 194 tokens de entrada e 291 de saída e custou $0.003298. Ele preservou os fatos centrais do chamado, mas também acrescentou suposições plausíveis sobre a solução que não estavam na fonte. Essa é a lição prática: o Sonnet 5.5 pode tornar o rascunho extremamente barato, mas a verificação continua fazendo parte do trabalho.
Como usar Claude Sonnet com esforço Medium
O jeito mais rápido de começar é pelo aplicativo Claude. Selecione o Sonnet 5.5, confirme o esforço Medium, forneça um único conjunto de fontes e peça um resultado que possa ser conferido linha por linha.
A Anthropic define Medium como padrão em seus aplicativos e no Claude Code. Na Claude Platform, o padrão é High; portanto, quem usa a API deve escolher o nível explicitamente. Medium é o melhor ponto de partida para resumos de suporte, briefings de clientes, análises de rotina e tarefas bem especificadas com ferramentas: o ciclo de feedback continua rápido, sem cair direto para a configuração mais baixa.
Selecione o Sonnet 5.5
Abra uma nova conversa no Claude. Clique no nome do modelo ao lado do botão de envio, escolha Sonnet 5.5 e abra o menu Effort. Se o modelo não aparecer na primeira lista, clique em More models. Administradores de contas Enterprise podem limitar quais modelos e níveis de esforço ficam disponíveis.
Mantenha o primeiro teste em Medium
Para uma tarefa de negócio delimitada, deixe o esforço em Medium. Passe para High somente quando o trabalho exigir mais julgamento, uma sequência mais longa de etapas ou uma verificação mais rigorosa. Low pode ser útil depois que seus próprios testes mostrarem que a qualidade se mantém.
Forneça uma fonte e defina o formato
Cole um chamado, a transcrição de uma reunião ou um conjunto de documentos. Diga quem vai ler e quais campos são obrigatórios. Para um chamado de suporte, peça exatamente quatro tópicos: Problema, Impacto, Evidências e Próxima ação. Acrescente: “Não invente fatos. Sinalize toda inferência.”
Confira as afirmações na fonte
Compare cada nome, número, causa, compromisso e ação recomendada com o material de entrada. Exclua orientações sem respaldo, mesmo quando pareçam sensatas. Só salve o prompt depois que ele passar por essa checagem em vários exemplos do seu próprio fluxo de trabalho.
O chamado sintético do meu teste descrevia seis agentes de suporte sem acesso após uma mudança no domínio de login, dois agentes que continuavam conectados, o erro “Invalid organization” e registros de usuários que já continham o novo domínio. O Sonnet 5.5 preservou esses detalhes e respeitou o formato de quatro tópicos. Porém, também sugeriu que o mapeamento da organização provavelmente ainda apontava para o domínio antigo e classificou uma das correções como menos disruptiva. Nenhuma dessas duas informações constava no chamado.
A conta bruta do modelo é simples. Pela tarifa publicada pela Anthropic, 194 tokens de entrada custam $0.000388 e 291 tokens de saída custam $0.00291, totalizando $0.003298. Se 10,000 chamadas tivessem exatamente esse mesmo volume de tokens, o gasto bruto com o modelo seria $32.98. Isso não equivale ao custo de 10,000 chamados resolvidos. Recuperação de dados, integrações, novas tentativas, armazenamento, monitoramento e revisão humana continuam existindo ao redor da chamada ao modelo.
O que é o Claude Sonnet 5.5, na prática
O Sonnet 5.5 é o modelo rápido e de uso geral da família 5.5 da Anthropic. Pense nele como o modelo operacional para trabalhos bem definidos; o Opus 5.5 entra como especialista sênior quando o problema é aberto e exige mais julgamento.
Esse lançamento não é o mesmo que o Sonnet 5. O ID direto na Claude API é claude-sonnet-5-5, sem sufixo de data. O modelo aceita texto e imagens, responde em texto, oferece uma janela de contexto de 1 milhão de tokens e gera até 128,000 tokens de saída. Para consultar os preços e o contexto de tokenização do modelo anterior, veja a análise do Claude Sonnet 5, que trata daquele lançamento separadamente.
Segundo a Anthropic, o Sonnet 5.5 gera respostas mais de 30% mais rápido que o Sonnet 5 e, nos testes da empresa, custa até 30% menos por tarefa concluída. A segunda afirmação se refere à redução no número de tokens necessários para finalizar o trabalho, não a uma tarifa menor por token. Os preços permanecem iguais aos do Sonnet 5.
Os resultados de benchmarks também são afirmações da Anthropic. A empresa informa 70.6% para o Sonnet 5.5 contra 10.3% para o Sonnet 5 no Terminal-Bench 4.0, além de 55.5% contra 34.1% no CursorBench 4.0. Esses números justificam testar o novo modelo, mas não dizem se a política de atendimento, a base de código ou o modelo de documento da sua empresa serão aprovados. O relatório de lançamento da Anthropic faz a mesma distinção entre notas de benchmark e julgamento consistente em trabalhos abertos.
Escolha o esforço pelo custo de errar
Effort controla qualidade, latência e consumo de tokens; não define o tamanho do texto. Um nível mais alto dá ao modelo mais espaço para raciocinar e revisar, mas também pode aumentar a espera e a conta. Se a resposta precisa ser curta, peça concisão separadamente no prompt.
A Anthropic recalibrou esses níveis no Sonnet 5.5. Por isso, Medium neste modelo não representa o mesmo volume de raciocínio que Medium no Sonnet 5. Faça uma nova bateria de testes com seus próprios exemplos. Não mantenha uma configuração apenas porque o rótulo continua igual.
Sete fluxos úteis, do maior para o menor retorno imediato
Os melhores casos de uso têm três características em comum: a entrada está disponível, o resultado esperado tem um formato claro e uma pessoa ou regra consegue verificá-lo.
1. Triagem de chamados de suporte
Uma liderança de operações de suporte pode reunir a mensagem do cliente, o estado da conta, o histórico recente de chamados e a política de escalonamento. O Sonnet 5.5 pode devolver problema, impacto, evidências, dados ausentes e a próxima ação permitida. O ganho está em reler menos antes de encaminhar ou transferir o caso. Ainda cabe a uma pessoa conferir orientações que alterem contas, reembolsos, promessas e afirmações sobre a causa raiz.
Este é o melhor primeiro fluxo porque cada parte da resposta pode apontar para um campo específico da fonte. Ele também expõe rapidamente os erros do modelo. Se o resumo não mostra de onde veio uma afirmação, ainda não está pronto para acionar nada.
2. Briefings antes de reuniões com clientes
Uma diretoria de contas pode fornecer a transcrição da reunião mais recente, o escopo de trabalho, as tarefas em aberto e as anotações de renovação. Peça uma página com decisões, compromissos, riscos, dúvidas pendentes e a pauta da próxima reunião. O ganho é ter um formato de briefing reproduzível, em vez de encarar uma página em branco antes de cada conversa.
Separe “confirmado” e “inferido” em seções diferentes. Essa distinção simples impede que uma interpretação plausível do modelo se transforme em compromisso com o cliente.
3. Revisão de pull requests
Uma liderança de engenharia pode fornecer ao modelo o diff do código, as convenções do repositório e uma lista de verificação de segurança, testes e compatibilidade com versões anteriores. O Sonnet 5.5 consegue produzir uma primeira análise ordenada por risco e sugerir testes. O ganho é acelerar a orientação inicial de quem revisa, não aprovar mudanças automaticamente. A decisão sobre o merge continua com uma pessoa responsável pelo sistema.
4. Correções de bugs bem delimitadas
Uma pessoa de engenharia de produto com um bug reproduzível pode fornecer o comportamento que falha, os arquivos relevantes e os critérios de aceitação. Medium é um bom começo para uma correção bem especificada. Passe para High quando o problema atravessar vários serviços ou a primeira execução pular a verificação. O ganho está em encurtar os ciclos de implementação e teste, enquanto os critérios de aceitação impedem que a tarefa se espalhe.
5. Revisões operacionais e rascunhos para o conselho
Uma equipe financeira ou de operações pode reunir as fontes e um modelo aprovado de apresentação ou documento. O Sonnet 5.5 consegue estruturar uma revisão, revelar lacunas e formatar a primeira versão. A Anthropic o posiciona especificamente para documentos, apresentações e planilhas bem-acabados. O ganho é reduzir o trabalho de montagem, mas toda afirmação financeira ainda precisa apontar para uma célula ou referência documental.
6. Resumos de incidentes
Quem coordena um incidente pode fornecer a linha do tempo, os alertas, as ações executadas e as anotações das pessoas responsáveis. Peça blocos separados para eventos confirmados, hipóteses, impacto nos clientes, questões pendentes e acompanhamentos. O ganho é uma passagem de bastão mais clara e um primeiro rascunho do pós-incidente. Não permita que o modelo promova uma correlação a causa raiz.
7. QA visual e refinamento de interfaces
Uma pessoa de design de produto ou engenharia front-end pode combinar uma captura de tela com as regras da marca e uma lista de critérios de aceitação. O Sonnet 5.5 consegue identificar inconsistências, priorizar correções e ajudar a implementar uma rodada delimitada. O ganho é acelerar a iteração sobre defeitos visíveis. Bom gosto, testes de acessibilidade e a decisão final de produto continuam sendo responsabilidades humanas.
Três produtos que vale a pena criar
Acesso puro ao modelo não é um negócio. Um produto vendável acrescenta contexto proprietário, um fluxo controlado, evidências e um ponto em que uma pessoa toma a decisão final.
1. Triagem de suporte ligada a evidências: a melhor oportunidade
Crie um copiloto de suporte que transforme um chamado e o registro da conta em um resumo estruturado, associe um link de origem a cada afirmação, confronte a ação sugerida com a política e coloque o rascunho em uma fila de aprovação. Lideranças de suporte e prestadores terceirizados pagariam por um encaminhamento mais rápido e consistente.
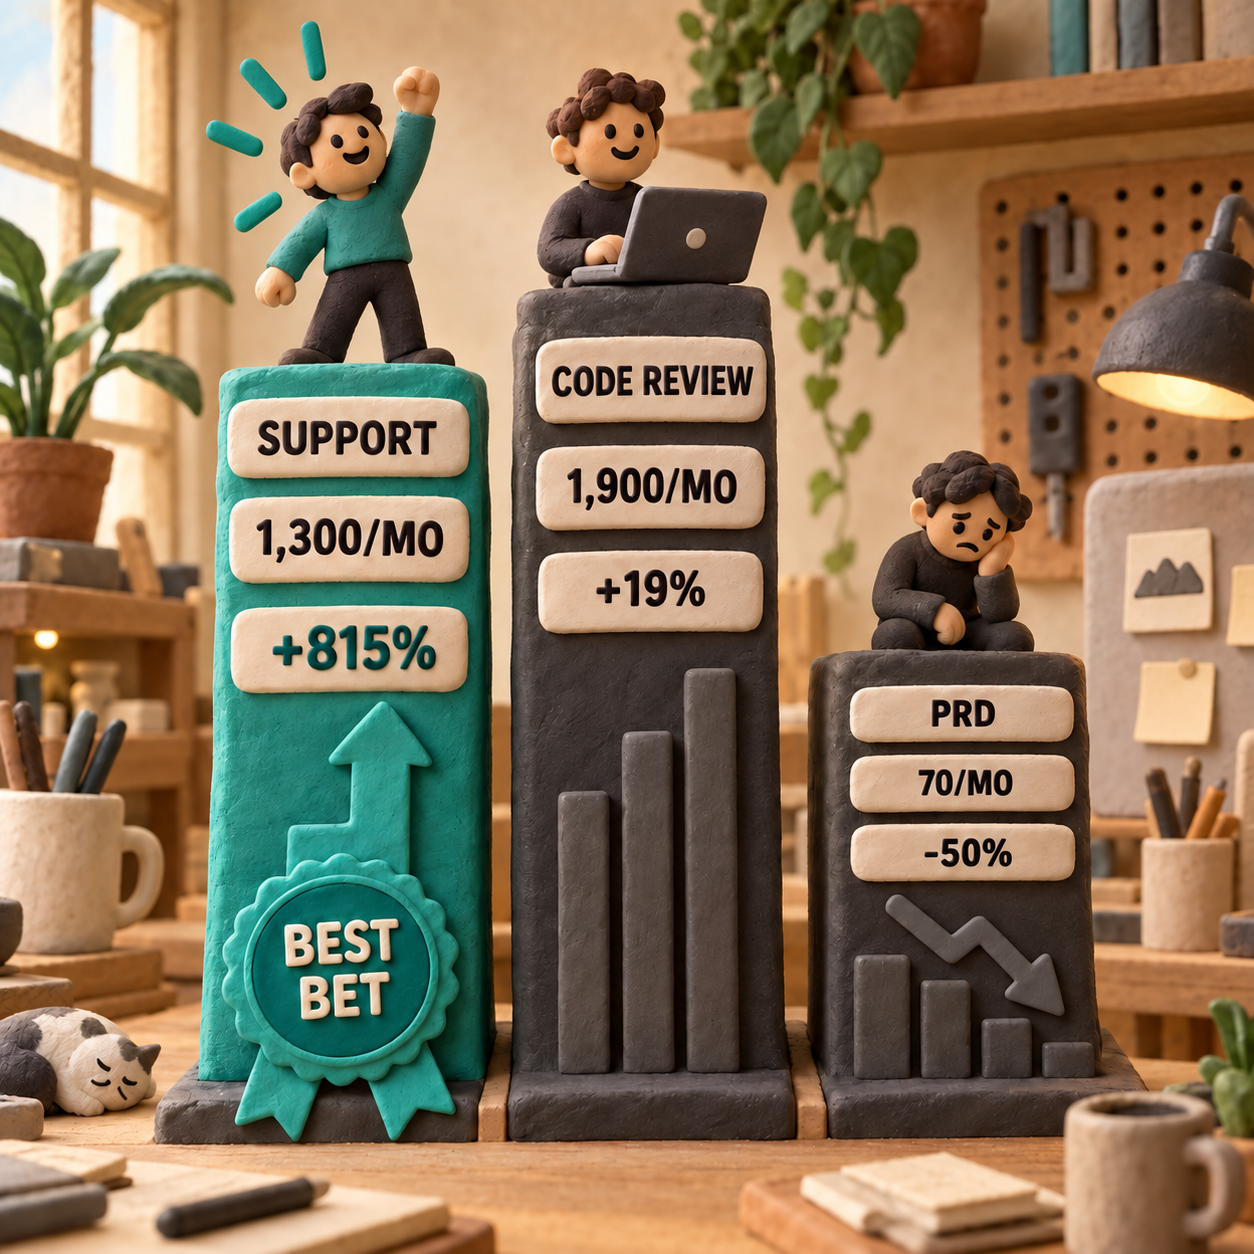
A demanda é visível: ai customer service agent registra 1,300 buscas mensais nos EUA, intenção comercial e crescimento anual de 815% nos dados de palavras-chave desta análise. A Intercom cobra $0.99 por resultado do Fin. Não é uma comparação direta com uma chamada de resumo, pois resolver um caso é um trabalho maior, mas demonstra que compradores já aceitam pagar pelo uso de automação no suporte.
A menor versão comercial precisa de um conector para a caixa de entrada, um para os dados da conta, o resumo de quatro campos, citações das fontes, uma verificação de política e controles para aprovar ou rejeitar. O obstáculo é integração e confiança. Se não for possível provar de onde veio uma recomendação, o cliente manterá o fluxo atual.
2. Uma camada de revisão de código que entende as políticas da equipe
Crie um aplicativo para GitHub que leia o diff e as regras de cada equipe e, em seguida, devolva uma revisão ordenada por risco, as lacunas de testes e um resumo curto para o merge. O público comprador são gestores de engenharia e equipes de plataforma.
ai powered code review platform registra 1,900 buscas mensais nos EUA e crescimento anual de 19%. O preço público do CodeRabbit começa em $24 por pessoa desenvolvedora ao mês no plano anual, com planos superiores de $48 e $72. O MVP precisa de um provedor de repositório, webhooks de pull requests, verificações personalizadas, uma visualização de comentários e um histórico de auditoria que mostre qual regra acionou cada apontamento.
O problema é a concorrência intensa. Um revisor genérico não tem vantagem defensável. Escolha um nicho doloroso — verificações de releases regulados, segurança em migrações de dados ou um framework específico — e meça falsos positivos com o mesmo rigor usado para defeitos não detectados.
3. Uma ferramenta vertical que transforma briefing em PRD, não uma solução genérica
Crie um fluxo especializado que converta reuniões, restrições e decisões anteriores em um briefing de produto com critérios de aceitação e questões em aberto. Uma consultoria de produto ou equipe de software vertical pode comprar a solução quando o modelo de documento refletir seu modo de trabalhar.
A busca exata ai product requirements document generator soma apenas 70 pesquisas mensais nos EUA e caiu 50% em relação ao ano anterior. Isso é um alerta, não um argumento de venda. Um gerador genérico e independente de PRDs é a oportunidade mais fraca desta lista. A versão viável entra como complemento de um fluxo de maior valor, como descoberta em agências, implementação na área da saúde ou controle de mudanças corporativas.
O MVP reúne um pacote de fontes fixo, um modelo opinativo, rastreabilidade das decisões e exportação para o sistema que o comprador já utiliza. O problema é a demanda pequena e a facilidade de cópia. Não crie esse produto sem já ter a relação com o cliente ou acesso a um canal de dados vertical.
O preço não mudou, mas o custo do fluxo pode cair
O Sonnet 5.5 custa $2 por milhão de tokens de entrada, $10 por milhão de tokens de saída e $0.20 por milhão de tokens lidos do cache. São as mesmas tarifas publicadas para o Sonnet 5. A redução de custo anunciada pela Anthropic vem da conclusão de tarefas com menos tokens.
Essa distinção importa na projeção financeira. Um rastro mais curto do modelo pode reduzir tanto a latência quanto o gasto com tokens, mesmo sem alteração da tabela de preços. O custo total do produto também pode permanecer quase igual quando recuperação de dados, ferramentas de terceiros, novas tentativas e revisão humana dominam a conta. Meça o custo por resultado aceito, não por chamada.
As assinaturas do aplicativo Claude e o uso da API são produtos separados. Pagar pelos planos Pro, Max, Team ou Enterprise não inclui Claude Console nem uso da API. O guia de planos do Claude explica os limites gerais; um fluxo via API precisa de acesso próprio ao Console e cobrança por consumo.
Migre o fluxo da API somente depois de aprovar a tarefa
A ordem mais segura para a migração é direta: valide o prompt com exemplos representativos, fixe o ID do novo modelo, defina explicitamente o esforço e, então, ajuste o contrato de raciocínio e chamadas de ferramentas antes de enviar tráfego de produção.
Em uma requisição simples com adaptive thinking, omita o campo thinking e leia os blocos de texto pelo tipo:
from anthropic import Anthropic

client = Anthropic()
response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    output_config={"effort": "medium"},
    messages=[{
        "role": "user",
        "content": "Summarize this ticket as Issue, Impact, Evidence, and Next action.",
    }],
)

for block in response.content:
    if block.type == "text":
        print(block.text)
Quatro mudanças da migração merecem uma checagem cuidadosa.
thinking: {"type": "disabled"}deixou de ser aceito pela Claude API direta da Anthropic. Usethinking: {"type": "between_tools"}quando quiser eliminar o raciocínio inicial. A opção funciona com Low, Medium e High, mas não com Xhigh ou Max.- Os valores forçados
anyetoolnomeado detool_choicedeixaram de ser aceitos pela API direta. Useauto, aplique um schema estrito quando houver suporte e diga no prompt quando a ferramenta deve ser executada. - Uma resposta pode começar com um bloco
thinking. Leia cada bloco de conteúdo de acordo com otype; nunca pressuponha quecontent[0].textexiste. - Em um loop de ferramentas, devolva os blocos de raciocínio sem nenhuma alteração. Eles carregam assinaturas vinculadas à conversa anterior, portanto mantenha o histórico de mensagens somente para acréscimos.
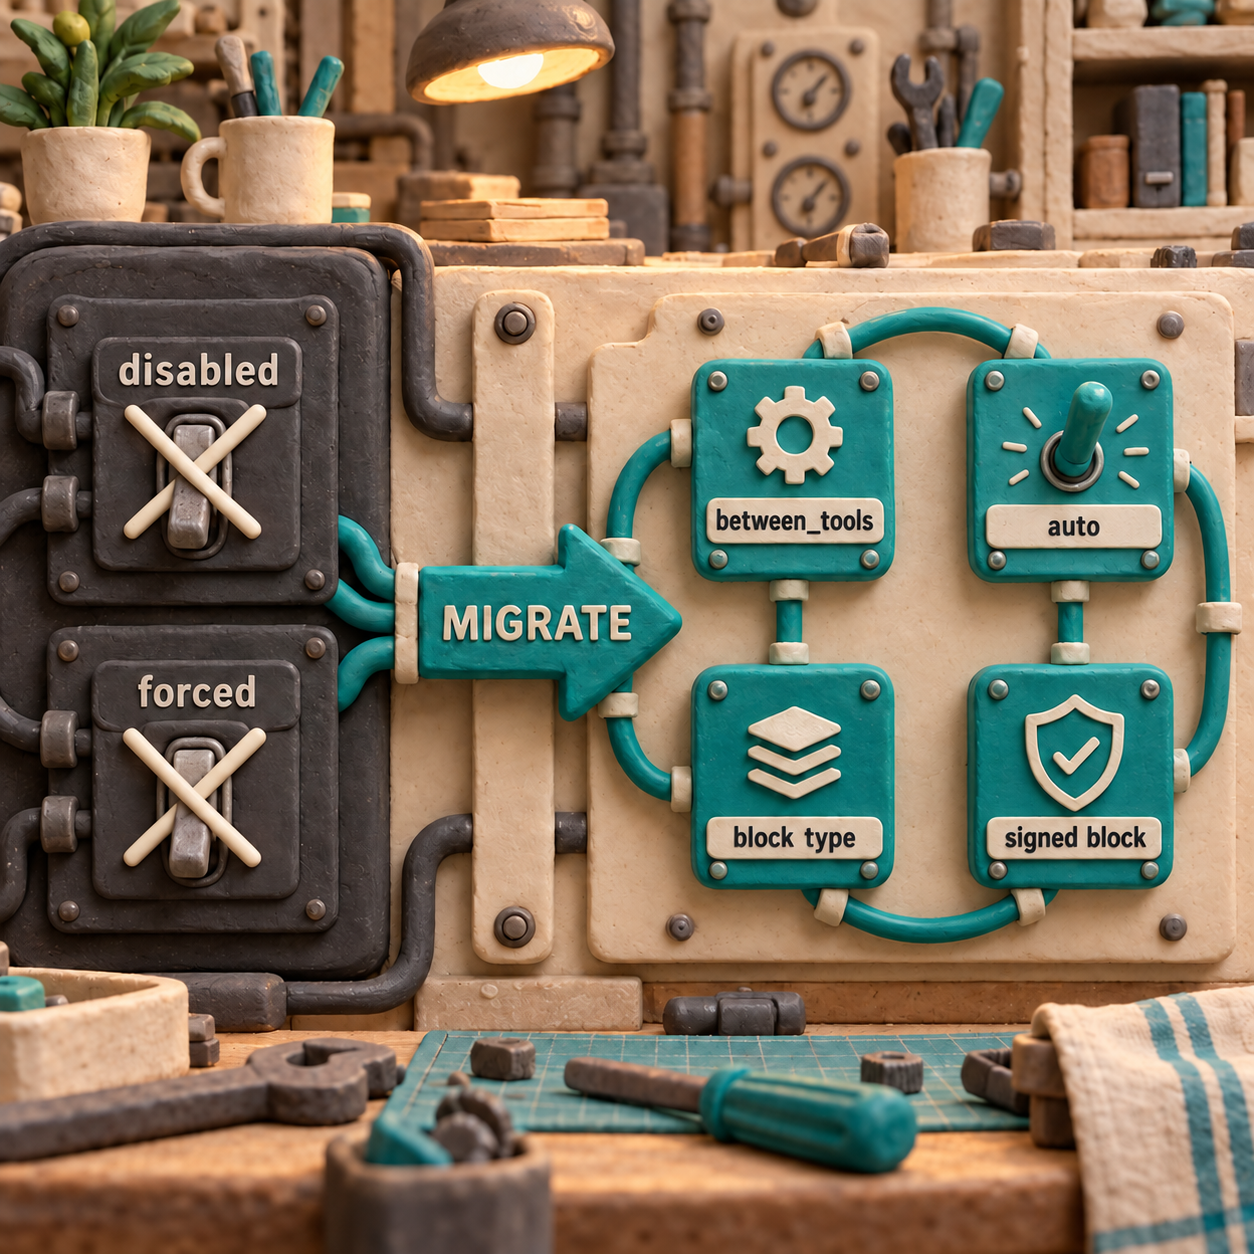
Este padrão mínimo usa between_tools, mantém a escolha de ferramentas em auto e preserva a resposta completa do assistente:
tools = [{
    "name": "lookup_ticket",
    "description": "Look up a support ticket",
    "strict": True,
    "input_schema": {
        "type": "object",
        "properties": {"ticket_id": {"type": "string"}},
        "required": ["ticket_id"],
        "additionalProperties": False,
    },
}]

messages = [{"role": "user", "content": "Use lookup_ticket for T-42."}]
response = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    thinking={"type": "between_tools"},
    output_config={"effort": "medium"},
    tools=tools,
    tool_choice={"type": "auto"},
    messages=messages,
)

# Keep every block, including signed thinking blocks, exactly as returned.
messages.append({
    "role": "assistant",
    "content": [block.model_dump() for block in response.content],
})

tool_call = next(block for block in response.content if block.type == "tool_use")
messages.append({
    "role": "user",
    "content": [{
        "type": "tool_result",
        "tool_use_id": tool_call.id,
        "content": "Ticket T-42 is open and assigned to Support Ops.",
    }],
})

follow_up = client.messages.create(
    model="claude-sonnet-5-5",
    max_tokens=4096,
    thinking={"type": "between_tools"},
    output_config={"effort": "medium"},
    tools=tools,
    tool_choice={"type": "auto"},
    messages=messages,
)
O guia de migração do Sonnet 5.5 documenta os erros 400 da API direta e os campos substitutos. Minha requisição local em Medium com between_tools retornou HTTP 200 em 1.35 segundos. Em outro loop adaptativo com ferramentas, recebi um bloco de raciocínio assinado; ao reenviar o bloco completo sem alterações, a etapa seguinte foi concluída com sucesso.
Há uma ressalva importante. Minhas chamadas passaram por um gateway de IA. Essa camada de compatibilidade retornou HTTP 200 quando enviei de propósito o antigo valor disabled para thinking e forcei tool_choice: any, embora a documentação da Anthropic diga que ambos geram erros na API direta. Não confunda a aceitação do middleware com compatibilidade comprovada da integração direta. Inspecione a requisição bruta no Playground da Anthropic ou teste o endpoint direto antes da troca.
O que o Sonnet 5.5 não resolve
Ele não transforma uma inferência sem respaldo em fato. O teste local de suporte deixou isso claro. Exija referências às fontes para afirmações de alto impacto e mantenha aprovações humanas para reembolsos, alterações de conta, compromissos jurídicos, decisões médicas e ações de segurança.
Também não transforma toda tarefa em uma tarefa Medium. Aumente o esforço quando seus próprios exemplos revelarem falhas de raciocínio ou trabalho incompleto. Recorra ao Opus em trabalhos abertos que exijam julgamento contínuo; a comparação com o Opus 5.5 explica quando esse nível superior faz sentido.
O modelo puro tampouco vira produto por conta própria. Conectores, permissões, checagens de políticas, avaliações, observabilidade, mecanismos de contingência e uma boa interface de revisão concentram a maior parte do trabalho em produção.
Ele também não elimina a necessidade de fontes atuais. Se uma resposta de suporte ou pesquisa depender do que é permitido, obrigatório ou cobrado agora, dê ao modelo uma ferramenta de busca ou base de conhecimento e instrua-o a consultá-la.
O que fazer na segunda-feira
Escolha uma fila que tenha uma fonte da verdade clara. Na segunda-feira, separe 20 exemplos recentes, remova os dados privados desnecessários e execute o Sonnet 5.5 em Medium com um único schema de saída. Avalie precisão factual, inferências sem respaldo, completude, tempo decorrido e uso de tokens. Só depois que o prompt passar nesse teste altere o ID do modelo em uma API existente e execute as verificações de migração descritas acima.
Como usar o Claude Sonnet?
No aplicativo Claude, clique no nome do modelo ao lado do botão de envio, selecione Sonnet 5.5, escolha o esforço Medium e comece por uma tarefa delimitada cujo resultado possa ser verificado. No Claude Code, execute /model e escolha Sonnet 5.5 ou inicie uma sessão com claude --model claude-sonnet-5-5.
Para que o Claude Sonnet 5 é mais indicado?
Na versão atual, Sonnet 5.5, comece por trabalhos cotidianos bem delimitados: resumos de suporte, briefings de clientes, correções de bugs, revisão de código e documentos empresariais bem-acabados. Use um nível de esforço maior ou o Opus quando o trabalho for aberto e o custo de um erro sutil for alto.
O Claude Sonnet é gratuito?
A disponibilidade e os limites dependem do plano Claude e das configurações da organização. O acesso pelo aplicativo e a cobrança da API são separados; portanto, uma assinatura paga do Claude não inclui o uso da API. Consulte o guia de planos indicado acima para verificar os limites atuais.
Quanto custa o Claude Sonnet 5?
O Claude Sonnet 5.5 custa $2 por milhão de tokens de entrada, $10 por milhão de tokens de saída e $0.20 por milhão de tokens lidos do cache. Segundo a Anthropic, o custo por tarefa concluída pode ser menor que no Sonnet 5 porque o modelo usa menos tokens, não porque essas tarifas tenham caído.
Se você quer um fluxo com Claude baseado em fontes e adaptado à sua empresa, conheça os sistemas de IA para produção.
- Última atualização
- 28 de set. de 2026
- Categoria
- AI
Prefira este site no Google


Marque omidsaffari.com como fonte preferida e o Google destaca o site para você em Top Stories, AI Overviews e AI Mode.

GLM-5.3-Flash ou Jev: qual escolher para decisões de IA?
Compare Jev e GLM-5.3-Flash em preço, imagens, latência e privacidade para escolher a melhor opção em roteamento de tickets e triagem de documentos.27 de set. de 2026AI
Claude Opus 5.5 vs Opus 5: qual vale mais a pena?
Claude Opus 5.5 reduz preços e avança nos benchmarks publicados, mas traz mudanças na API. Compare custos, desempenho e riscos antes de migrar.23 de set. de 2026AI
GPT-6 Sol ou Luna: qual escolher e quando pagar mais
Compare GPT-6 Sol e Luna em preço, programação e adequação à tarefa — e veja quando a qualidade do Sol realmente compensa o custo 20× maior.23 de set. de 2026AI
GPT-6 Luna grátis: onde usar e quanto custa
O GPT-6 Luna é grátis no app para desktop, mas Work, Codex e API seguem regras diferentes. Veja acesso, preços, limites e quando vale pagar.22 de set. de 2026AI
Xiaomi MiMo: como usar o MiMo-V2.6 na prática
Aprenda a testar o Xiaomi MiMo no Studio, configurar a API do MiMo-V2.6, escolher entre Flash e Pro e levar o fluxo à produção com segurança.22 de set. de 2026AI
Xiaomi MiMo V2.6: Pro ou Flash? O custo decide
Compare Xiaomi MiMo V2.6 Pro e Flash em preço, benchmarks, cache e qualidade. Veja quando pagar pelo Pro e quando manter o Flash como padrão.22 de set. de 2026AI
MiMo V2.6 grátis: o que custa zero e o que é pago
Entenda onde o MiMo V2.6 é grátis, quando a promoção termina, o que a licença MIT cobre e quanto custam as APIs Flash, Pro e UltraSpeed na prática.22 de set. de 2026AI