Comparação GPT-6.1 Sol vs GPT-6 Sol: qual escolher?
Comparação GPT-6.1 Sol vs GPT-6 Sol em preços, benchmarks, cache e compatibilidade de API para decidir se a migração vale a pena na prática.



A comparação GPT-6.1 Sol vs GPT-6 Sol é um upgrade que deve começar por testes: migre para o GPT-6.1 Sol os agentes da Responses API que reutilizam muito cache, mas mantenha o GPT-6 Sol enquanto a migração estiver bloqueada por uma integração de ferramentas via Chat Completions ou pelo raciocínio none. Os dois custam $2 por milhão de tokens de entrada e $10 por milhão de tokens de saída; apenas a entrada em cache cai, de $0.20 para $0.10.
Comparação GPT-6.1 Sol vs GPT-6 Sol: qual escolher?
Escolha o GPT-6.1 Sol para uma carga compatível com a Responses API que reutilize prefixos longos de prompt ou precise de um candidato mais forte para programação, uso do computador, trabalho com documentos e tarefas empresariais em várias etapas. Continue com o GPT-6 Sol enquanto a aplicação depender de chamadas de função pela Chat Completions ou de reasoning_effort: none. Essas não são pequenas diferenças de configuração. Elas determinam se basta trocar o ID do modelo ou se também será necessário mudar o fluxo de requisições.
A decisão fica clara quando separada por cenário:
- Agente existente na Responses API com esforço medium ou superior: teste o GPT-6.1 Sol agora. Ele oferece uma tarifa menor para leituras em cache e um sinal de capacidade mais forte no lançamento.
- Integração que chama funções pela Chat Completions: não comece trocando o ID do modelo. Primeiro leve o fluxo de ferramentas para a Responses, faça testes de regressão e só então compare os modelos.
- Carga que usa raciocínio
none: permaneça no GPT-6 Sol até ser possível adotar pelo menoslow; no GPT-6.1 Sol, o padrão émedium. - Predomínio de entrada nova e saída: não há economia no preço dos tokens. Os dois modelos cobram as mesmas tarifas de entrada nova, gravação de cache e saída, então a mudança precisa se justificar pela capacidade.
A regra de decisão é simples: só faça a troca quando o GPT-6.1 Sol melhorar o trabalho aceito depois que a integração passar na verificação de compatibilidade. Uma tarifa de cache menor ajuda, mas uma chamada de ferramenta com falha, uma mudança no nível mínimo de raciocínio ou uma nova tentativa extra pode consumir rapidamente essa economia.
Preços do GPT-6 Sol e do GPT-6.1 Sol
O GPT-6.1 Sol só vence em preço quando as requisições geram leituras em cache. Os valores de entrada nova, gravação de cache e saída não mudaram.
Conferi as tarifas nas páginas oficiais da OpenAI, tanto a do GPT-6.1 Sol quanto a do GPT-6 Sol, em 30 de setembro de 2026.
Normalizando por 1,000 tokens, qualquer um dos modelos custa $0.002 para entrada nova, $0.0025 para uma gravação de cache e $0.01 para saída. Uma leitura em cache custa $0.0001 no GPT-6.1 Sol e $0.0002 no GPT-6 Sol. Com essas tarifas, não existe um volume em que o GPT-6 Sol passe a ser mais barato: qualquer quantidade de tokens lidos do cache favorece a conta do GPT-6.1 Sol, enquanto nenhuma leitura em cache resulta em empate.
Preço do cache no GPT-6.1 Sol
A tarifa de entrada em cache é 50% menor, mas o custo total da tarefa cai menos porque apenas um componente mudou. Entrada em cache é um prefixo de prompt inalterado que o modelo consegue reutilizar. O guia de cache de prompts da OpenAI informa que o prefixo precisa chegar a 1,024 tokens de entrada visíveis no GPT-5.6 e modelos posteriores, e que manter uma sessão não garante um acerto de cache.
A linha de gravação do cache também exige atenção. A gravação é uma cobrança alternativa pelos tokens de entrada, não uma taxa adicional aplicada sobre outra cobrança de entrada. Os dois modelos cobram $2.50 por milhão de tokens gravados. O GPT-6.1 Sol muda o preço da leitura posterior, não o custo de criar o prefixo reutilizável.
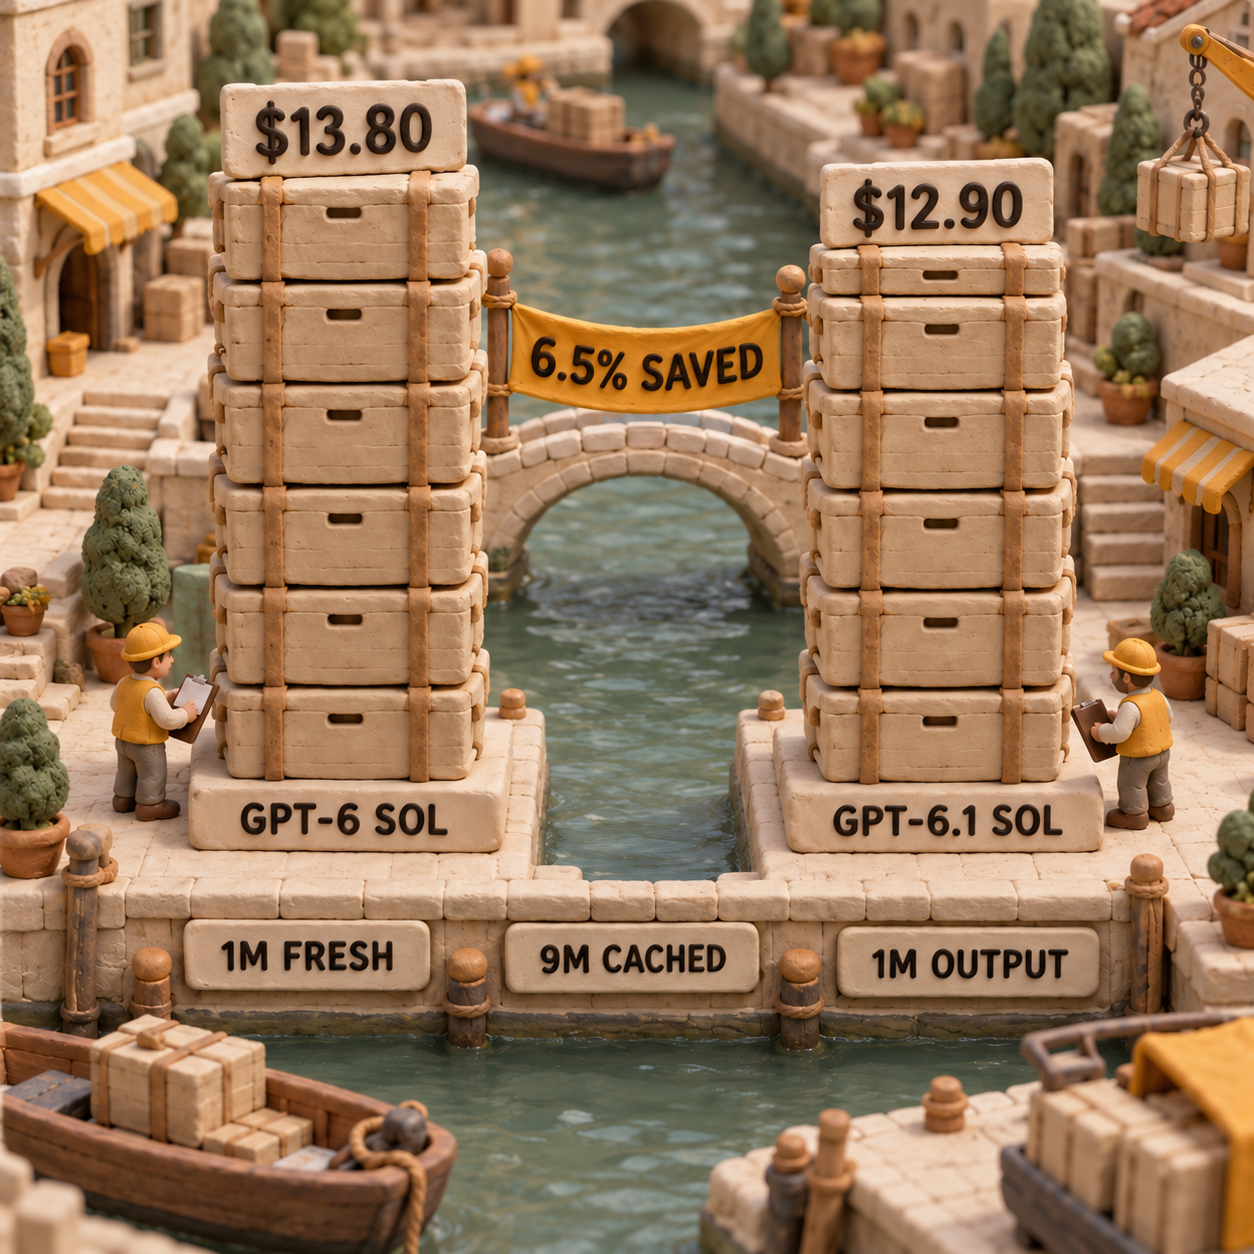
Considere um lote de contexto curto com 1 milhão de tokens de entrada nova, 9 milhões de tokens de entrada em cache e 1 milhão de tokens de saída:
- GPT-6 Sol: (1 x $2.00) + (9 x $0.20) + (1 x $10.00) = $13.80
- GPT-6.1 Sol: (1 x $2.00) + (9 x $0.10) + (1 x $10.00) = $12.90
Isso representa uma economia de $0.90, ou 6.5%, antes das gravações de cache e das cobranças por ferramentas. O valor vem de um cálculo de preços, não de uma carga executada nem de uma fatura observada.
O exemplo também pressupõe que cada requisição tenha no máximo 272,000 tokens de entrada. Acima desse limite, as páginas dos dois modelos informam que toda a requisição é cobrada a 2x nas tarifas de entrada e cache e a 1.5x na saída. Um lote pode somar milhões de tokens sem cruzar o limite quando é formado por requisições menores; o limite vale por requisição.
Em um agente existente, comece medindo cached_tokens e os tokens de gravação de cache, em vez de estimá-los pelo tamanho do prompt. O guia de diagnóstico do cache de prompts do GPT-6 mostra como distinguir uma taxa baixa de acertos de cache de um problema de preço do modelo.
Vencedor: GPT-6.1 Sol para cargas com uso intenso de cache. Empate para cargas sem leituras em cache.
Benchmarks do GPT-6.1 Sol
O GPT-6.1 Sol vence em capacidade com as evidências disponíveis no lançamento, mas os dados são da OpenAI, não de um comparativo independente. Essa distinção importa porque prompt de sistema, acesso a ferramentas, esforço de raciocínio e política de novas tentativas podem alterar tanto o resultado quanto o custo.
O relatório de lançamento da OpenAI traz cinco sinais úteis na comparação com o GPT-6 Sol:
- Programação: o GPT-6.1 Sol superou a melhor pontuação do GPT-6 Sol no DeepSWE v1.1 em 6.4 pontos percentuais, com menor esforço de raciocínio e menor custo.
- Workflows empresariais: alcançou 4.8 pontos percentuais a mais no AutomationBench 1.0.6 sob a mesma configuração.
- Uso do computador: avançou 7 pontos percentuais no conjunto offline do OSWorld 2.0 com esforço máximo, por menos da metade do custo por tarefa.
- Workflows científicos: mais que dobrou a pontuação do GPT-6 Sol no Terminal-Bench Science 0.1 com esforço máximo, novamente por menos da metade do custo por tarefa.
- Factualidade: em prompts deliberadamente difíceis com baixo esforço, as respostas que continham pelo menos um erro factual caíram de 11.4% para 7.7%, uma redução relativa de aproximadamente 32%.
São diferenças promissoras, não uma porcentagem universal de melhoria. A OpenAI observa que suas avaliações de GPT foram executadas no ambiente de pesquisa da empresa ou por sua API e podem divergir do ChatGPT em produção, já que prompts, ferramentas e configurações de esforço também podem ser diferentes. Em 30 de setembro de 2026, não havia benchmark independente comparável entre esses dois IDs exatos; portanto, uma pontuação externa não deve substituir um critério específico para a sua carga.
A relação entre benchmark e comprador é mais estreita do que sugere a manchete. O DeepSWE é relevante para equipes que entregam a um agente trabalhos longos em repositórios. O AutomationBench interessa a quem encadeia ferramentas de vendas, marketing, suporte, finanças ou RH. O OSWorld importa quando o modelo controla aplicativos no computador. Nenhum deles prova que um classificador de suporte em duas etapas, uma revisão curta de texto ou sua base de código privada ficará melhor.
Vencedor: GPT-6.1 Sol nas evidências atuais de capacidade. Confiança: dados do fornecedor até surgirem resultados independentes para esse par exato.
Especificações do GPT-6.1 Sol vs GPT-6 Sol
Os modelos compartilham quase todo o perfil operacional. Ambos oferecem janela de contexto de 1,050,000 tokens, saída máxima de 128,000 tokens, entrada de texto e imagem, saída de texto, outputs estruturados, streaming e a mesma superfície de ferramentas na Responses. Nenhum dos dois aceita entrada de áudio ou vídeo nas páginas desses modelos, e nenhum oferece fine-tuning.
O GPT-6.1 Sol avança o corte de conhecimento documentado de 20 de abril para 30 de abril de 2026. Dez dias não justificam uma migração. Na maioria dos sistemas em produção, a qualidade da recuperação, o contexto privado e o funcionamento correto das ferramentas terão muito mais peso do que essa pequena diferença de data.
GPT-6.1 Sol: o novo candidato padrão
O GPT-6.1 Sol é o modelo mais recente da OpenAI para trabalhos complexos, sob o ID exato de API gpt-6.1-sol. Ele aceita raciocínio low, medium, high, xhigh e max, com medium como padrão. As tarifas padrão são $2 para entrada nova, $0.10 para entrada em cache, $2.50 para gravação de cache e $10 para saída por milhão de tokens.
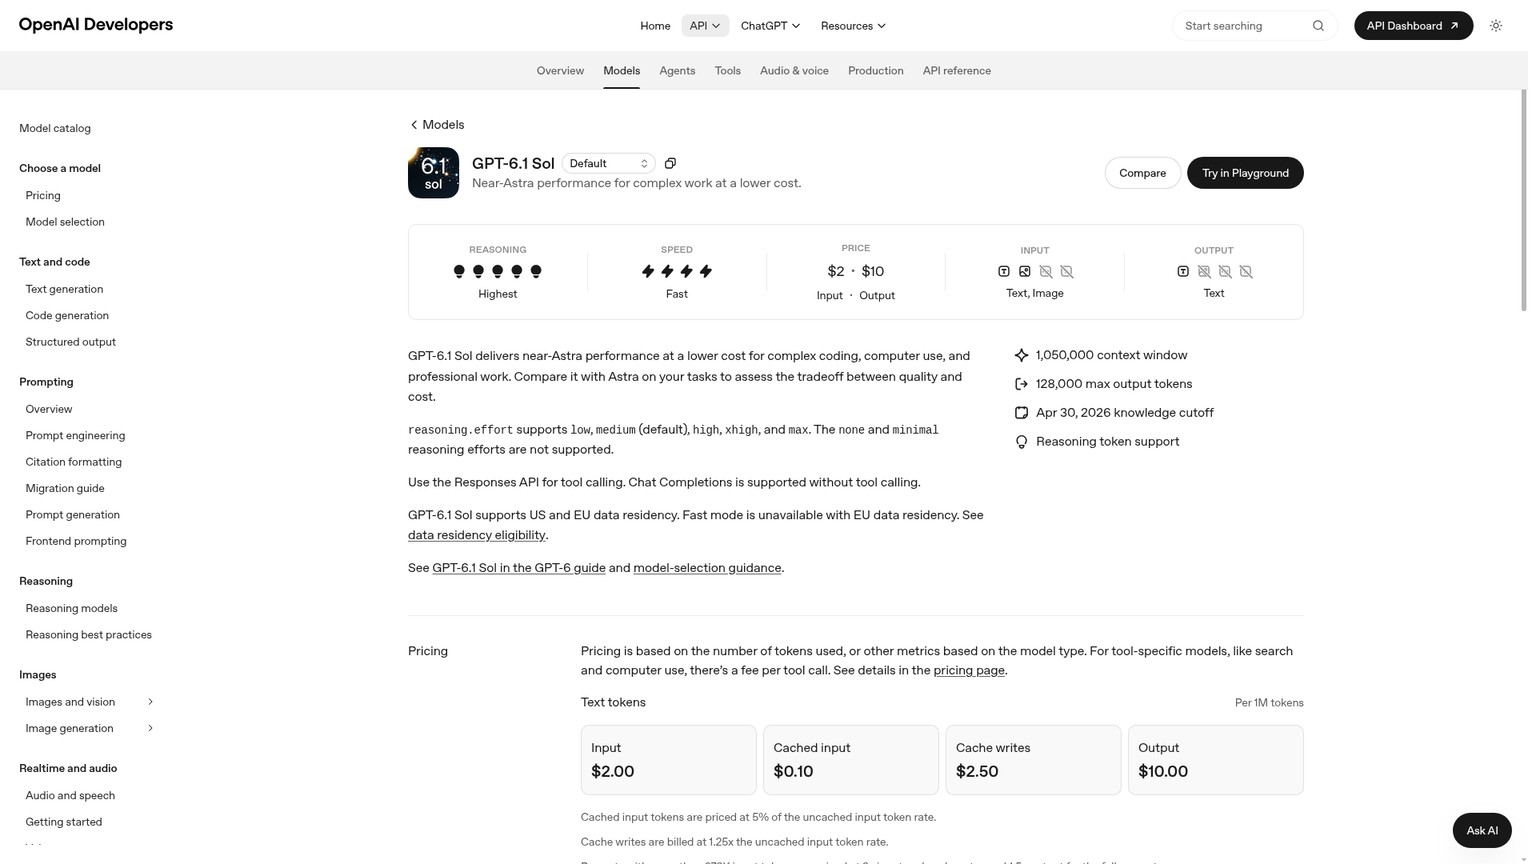
A página do modelo lista busca na web, busca em arquivos, geração de imagens, interpretador de código, shell hospedado, aplicação de patches, skills, uso do computador, MCP e busca de ferramentas pela Responses. Prefira-o quando esse caminho de API já for adequado e a tarefa se parecer com os sinais mais fortes de programação, documentos, uso do computador ou workflows. Não mude o padrão imediatamente se ainda faltar um teste independente de aceitação ou se a aplicação depender de uma configuração de raciocínio removida.
GPT-6 Sol: a escolha pela compatibilidade
O GPT-6 Sol continua disponível como gpt-6-sol. Ele aceita raciocínio none, low, medium, high, xhigh e max. Suas tarifas padrão permanecem em $2 para entrada nova, $0.20 para entrada em cache, $2.50 para gravação de cache e $10 para saída por milhão de tokens.
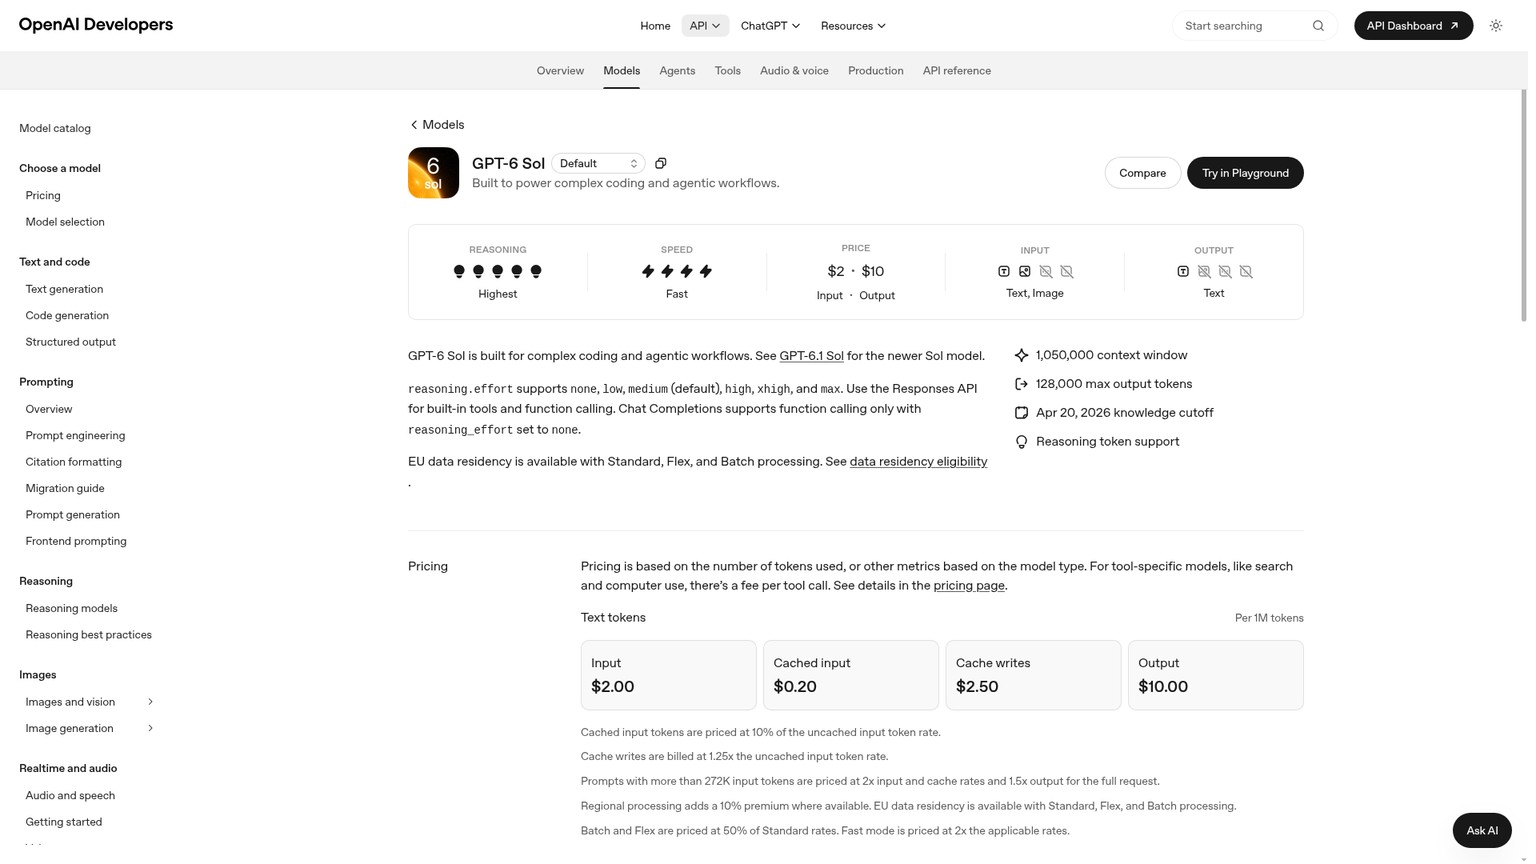
A superfície de ferramentas pela Responses coincide com a lista documentada do modelo mais novo. A diferença prática está na saída de emergência para sistemas legados: a Chat Completions pode chamar funções quando o esforço de raciocínio está em none. Isso torna o GPT-6 Sol o vencedor temporário para uma aplicação estável que ainda não migrou seu loop de ferramentas para a Responses. Assim que surgem leituras em cache, porém, ele deixa de ser o modelo mais barato.
Vencedor: empate em contexto, limite de saída, modalidades e ferramentas documentadas da Responses. O GPT-6.1 Sol vence em recência; o GPT-6 Sol, em compatibilidade com sistemas legados.
Upgrade para GPT-6.1 Sol: verifique primeiro a compatibilidade
O upgrade para o GPT-6.1 Sol pode se resumir à troca do modelo em uma linha somente quando a integração já usa Responses, não depende de none nem minimal e trata a saída do modelo como um comportamento a validar, não como um contrato intercambiável. Nos demais casos, há trabalho de migração antes mesmo de avaliar o modelo.
Chamadas de ferramentas no GPT-6.1 Sol
As chamadas de ferramentas do GPT-6.1 Sol exigem a Responses API. A Chat Completions continua disponível para chamadas simples ao modelo, mas não para ferramentas. No GPT-6 Sol é diferente: a página do modelo permite chamadas de função pela Chat Completions apenas com reasoning_effort definido como none.
Revise todas as integrações existentes que chamam funções pela Chat Completions antes de mudar o ID do modelo. O custo da migração pode incluir a montagem da requisição, o estado da conversa, o tratamento de resultados das ferramentas, a análise da resposta, a lógica de novas tentativas, o rastreamento e a estabilidade do prefixo de cache. Uma camada que oculta o endpoint não elimina essas diferenças; apenas muda o lugar em que elas precisam ser testadas.
O raciocínio é um segundo contrato. O GPT-6.1 Sol não aceita none nem minimal. Se uma rota de produção usa none para reduzir latência, tornar a seleção de ferramentas determinística ou controlar custos, a configuração válida mais próxima não terá necessariamente comportamento equivalente. Leve a rota para um nível de esforço compatível e execute as mesmas verificações de aceitação antes de comparar velocidade ou gasto.
Quem ainda não deve fazer a troca
Não altere o modelo padrão agora se qualquer uma destas condições for verdadeira:
- As chamadas de ferramentas ainda passam pela Chat Completions.
- Uma rota usa explicitamente o raciocínio
noneouminimal. - A maioria dos tokens cobrados vem de entrada nova e saída, tornando irrelevante a economia com cache.
- O modelo atual já passa nas verificações de aceitação do negócio, e nenhum ganho do GPT-6.1 Sol foi medido com os mesmos cenários.
- Uma implantação regulada exige uma análise separada do modo de processamento, da residência dos dados, dos logs e da mudança de comportamento do modelo.
Trata-se de dependência do workflow, não de aprisionamento permanente a um fornecedor. Os nomes dos modelos são parecidos, mas a integração pode estar presa a um endpoint, a um nível mínimo de raciocínio, ao formato da resposta e ao loop de ferramentas. Inclua esse trabalho de validação no custo do upgrade.
Vencedor: GPT-6 Sol para uma integração incompatível hoje. GPT-6.1 Sol depois que a integração e os cenários forem aprovados.
Execute cinco cenários fixos antes de mudar o padrão
Use cinco cenários fixos nos dois IDs exatos de modelo com esforço medium, prompts, ferramentas, contexto, limites de saída e verificações de aceitação idênticos. Este é um desenho de avaliação proposto, não um benchmark executado para este artigo.
Corrija um bug no repositório
Forneça aos dois modelos o mesmo teste com falha, o mesmo estado do repositório e as mesmas ferramentas permitidas. Aceite apenas um patch que corrija a falha-alvo sem quebrar a suíte existente.
Refatore vários arquivos
Use uma alteração limitada que atravesse vários arquivos, com etapas obrigatórias de build, lint e testes. Rejeite uma explicação bem escrita se a verificação do repositório falhar.
Encaminhe um caso de suporte
Forneça a mesma política, a mesma mensagem do cliente e as mesmas ferramentas de encaminhamento. Exija fila, prioridade e campos estruturados corretos, sem nenhuma ação sem respaldo.
Responda com evidências da política
Peça uma resposta ao cliente fundamentada no mesmo conjunto de documentos. Aceite apenas a conclusão exigida, as evidências citadas e o comportamento correto de escalonamento.
Conclua um workflow empresarial
Use a mesma tarefa de consulta e atualização em várias etapas, com um limite de permissão. Exija a sequência correta de ferramentas, o estado final esperado e a recusa de qualquer etapa não autorizada.
Registre as saídas aceitas, a latência de ponta a ponta, os tokens de entrada nova, entrada em cache, raciocínio e saída, além das cobranças por ferramentas e novas tentativas. Depois, calcule o custo total por resultado aceito, e não o custo da primeira resposta:
effective cost per accepted result = total model, retry, and tool spend / accepted outputs
Esse denominador pode inverter a conclusão baseada apenas no preço dos tokens. Um modelo que economiza $0.90 em um lote com uso intenso de cache pode sair mais caro se provocar uma execução extra com falha. Um modelo que custa o mesmo em tokens novos, mas elimina novas tentativas, pode ser a opção mais barata em produção.
A disponibilidade varia entre API, Work, Codex e Chat
O GPT-6.1 Sol está disponível pela API como gpt-6.1-sol e, segundo o anúncio de lançamento da OpenAI, no ChatGPT Work e no Codex para usuários Plus, Pro, Business, Enterprise e Edu. No lançamento, ele não estava disponível no Chat comum.
A OpenAI também afirma que o GPT-6.1 Sol Ultrafast será lançado futuramente, com geração de tokens até 8x mais rápida que a velocidade padrão no Codex. O anúncio não divulga o preço do Ultrafast, então não monte uma projeção de custos a partir de um multiplicador não oficial.
O uso da API é cobrado separadamente da assinatura do ChatGPT. Ter acesso pelo Work ou Codex não transforma as tarifas de $2 e $10 da API em uma franquia incluída para aplicações em produção.
Perguntas frequentes
O que é o GPT-6 SOL?
O GPT-6 Sol é o modelo da OpenAI para programação complexa e workflows com agentes, sob o ID de API gpt-6-sol. O GPT-6.1 Sol é o upgrade de 29 de setembro de 2026, com tarifa menor para entrada em cache e condições diferentes de compatibilidade para raciocínio e chamadas de ferramentas.
O GPT Sol é quanto melhor?
Não existe uma única porcentagem honesta. A OpenAI relata ganhos do GPT-6.1 Sol de 6.4 pontos percentuais no DeepSWE, 4.8 pontos no AutomationBench e 7 pontos no OSWorld sobre o GPT-6 Sol em configurações específicas. Sua carga fixa deve mostrar se esses ganhos se transferem para o seu caso.
Qual versão do GPT é melhor?
O GPT-6.1 Sol é o melhor modelo para testar em trabalhos compatíveis de programação e agentes empresariais. O GPT-6 Sol é o melhor runtime temporário quando ainda são necessárias chamadas de ferramentas pela Chat Completions ou raciocínio none.
Quais são os recursos e preços dos novos modelos GPT-6 Sol e Luna da OpenAI?
Essa é a decisão anterior dentro da família. A comparação entre GPT-6 Sol e Luna cobre os papéis de cada modelo e a economia atual dos tokens; esta página se concentra em saber se uma carga existente no Sol deve migrar para o GPT-6.1 Sol.
Qual GPT é melhor: Sol, Terra ou Luna?
Não existe um vencedor universal na família. Combine o modelo com a dificuldade da tarefa, a latência e o custo por resultado aceito; depois, avalie os IDs exatos que pretende implantar. Esta comparação ajuda na decisão de upgrade entre modelos Sol, não em um veredito sobre Terra ou Luna.
O GPT-6 Sol é mais barato?
Não nas tarifas Standard documentadas. O GPT-6 Sol empata com o GPT-6.1 Sol em entrada nova, gravações de cache e saída, enquanto o GPT-6.1 Sol é mais barato na entrada em cache: $0.10 contra $0.20 por milhão de tokens.
Vale a pena pagar $20 pelo ChatGPT?
Essa é uma decisão sobre assinatura para consumidores, não uma comparação de preços de modelos na API. No lançamento, o GPT-6.1 Sol estava disponível no Work e no Codex nos planos pagos listados, mas não no Chat comum; o uso da API é cobrado separadamente.
O GPT-5.6 Sol é melhor que o GPT-5?
Essa comparação anterior não determina este upgrade. Para uma implantação atual, avalie o GPT-6.1 Sol e o GPT-6 Sol usando exatamente o caminho de API, o esforço de raciocínio, as ferramentas e as verificações de aceitação da aplicação.
O GPT-6 é bom?
A capacidade do GPT-6 varia conforme o modelo, a tarefa, o esforço e a configuração das ferramentas. O GPT-6.1 Sol tem evidências mais fortes relatadas pelo fornecedor do que o GPT-6 Sol em várias avaliações difíceis, mas uma avaliação privada e fixa é a resposta para produção.
GPT-6.1 Sol vs GPT-6 Sol: qual é o tamanho dos modelos?
As páginas oficiais dos modelos não divulgam a quantidade de parâmetros nem pesos para download de nenhum deles. Compare limites, preços e comportamento de API documentados, além dos resultados medidos nas tarefas.
O que fazer na segunda-feira
Comece pela integração, não pelo seletor de modelos. Procure no código e na configuração do workflow por chamadas de função via Chat Completions e valores none ou minimal em reasoning_effort. Se qualquer um deles aparecer, dimensione essa migração antes de mudar o padrão.
Depois, execute os cinco cenários fixos com gpt-6-sol e gpt-6.1-sol, usando esforço medium e as mesmas ferramentas e verificações. Compare custo por resultado aceito, latência, uso de cache e novas tentativas. Adote o GPT-6.1 Sol nas rotas em que ele vencer; mantenha as demais no GPT-6 Sol até que a lacuna de compatibilidade ou resultados seja fechada.
Baixe o checklist de configuração do Claude Code e do Codex antes de alterar a rota de um modelo em produção.
- Última atualização
- 30 de set. de 2026
- Categoria
- AI
Prefira este site no Google


Marque omidsaffari.com como fonte preferida e o Google destaca o site para você em Top Stories, AI Overviews e AI Mode.

Claude Sonnet 5.5: como usar na prática
Aprenda a usar o Claude Sonnet 5.5 com o nível de esforço certo, um fluxo verificável e ajustes de API para obter respostas rápidas sem perder o controle.28 de set. de 2026AI
GLM-5.3-Flash ou Jev: qual escolher para decisões de IA?
Compare Jev e GLM-5.3-Flash em preço, imagens, latência e privacidade para escolher a melhor opção em roteamento de tickets e triagem de documentos.27 de set. de 2026AI
Claude Opus 5.5 vs Opus 5: qual vale mais a pena?
Claude Opus 5.5 reduz preços e avança nos benchmarks publicados, mas traz mudanças na API. Compare custos, desempenho e riscos antes de migrar.23 de set. de 2026AI
GPT-6 Sol ou Luna: qual escolher e quando pagar mais
Compare GPT-6 Sol e Luna em preço, programação e adequação à tarefa — e veja quando a qualidade do Sol realmente compensa o custo 20× maior.23 de set. de 2026AI
GPT-6 Luna grátis: onde usar e quanto custa
O GPT-6 Luna é grátis no app para desktop, mas Work, Codex e API seguem regras diferentes. Veja acesso, preços, limites e quando vale pagar.22 de set. de 2026AI
Xiaomi MiMo: como usar o MiMo-V2.6 na prática
Aprenda a testar o Xiaomi MiMo no Studio, configurar a API do MiMo-V2.6, escolher entre Flash e Pro e levar o fluxo à produção com segurança.22 de set. de 2026AI
Xiaomi MiMo V2.6: Pro ou Flash? O custo decide
Compare Xiaomi MiMo V2.6 Pro e Flash em preço, benchmarks, cache e qualidade. Veja quando pagar pelo Pro e quando manter o Flash como padrão.22 de set. de 2026AI