Codex CLI mit GPT-6.1 Sol: KI-Agenten richtig einrichten
Codex CLI mit GPT-6.1 Sol richtig einrichten – der Praxisleitfaden zu Responses API, Reasoning-Aufwand, Tool-Auswahl, Tests und laufenden Kosten.



Für anspruchsvolle, wiederkehrende Aufgaben ist GPT-6.1 Sol die richtige Basis. Solche Aufgaben überfordern ein Leichtgewicht, fallen aber zu häufig an, um jeden Lauf ungeprüft an Astra zu geben. Wer dafür die Codex CLI oder einen eigenen KI-Agenten einrichten will, braucht nur einen klaren Startpunkt: gpt-6.1-sol über die Responses API nutzen, mit medium beginnen, ausschließlich die tatsächlich benötigten Tools freigeben und das Modell erst nach bestandenen, fest definierten Abnahmetests produktiv schalten. Ein neuer Codex-Lauf für diesen Leitfaden erstellte ein kleines JavaScript-Hilfsprogramm, schrieb vier Tests und bestand alle vier. Das reine API-Tokenäquivalent lag bei $0.02816.
Die Entscheidung in einer Minute
GPT-6.1 Sol steht für API-Agenten, Codex und kostenpflichtige ChatGPT Work-Tarife bereit. Im regulären Chat ist das Modell noch nicht verfügbar. Ultrafast wurde für GPT-6.1 Sol zwar angekündigt, ist aber noch nicht freigeschaltet.
Der Standard-API-Preis beträgt $2 pro Million Eingabetoken und $10 pro Million Ausgabetoken. Bei GPT-6 Astra sind es $10 beziehungsweise $50. Die Ankündigung zur Einführung von OpenAI bestätigt die Produktverfügbarkeit. Einen ausführlicheren Vergleich von Zugang und Preisen bietet GPT-6.1 Sol vs GPT-6 Sol; hier geht es gezielt um Einrichtung und Betriebsentscheidungen.
Was GPT-6.1 Sol tatsächlich ist
Die GPT-6-Familie lässt sich am besten als eingespieltes Einsatzteam verstehen. Astra ist der Spezialist für besonders schwierige Streitfälle. GPT-6.1 Sol übernimmt anspruchsvolle Aufgaben, die regelmäßig anfallen. GPT-6 Sol bleibt die kompatible Option für ältere Tool-Routen. Diese Rollenverteilung ist nützlicher, als das neue Modell pauschal zum Standard für alles zu erklären.
GPT-6.1 Sol verarbeitet Text und Bilder, gibt Text aus und bietet ein Kontextfenster von 1,050,000 Token sowie bis zu 128,000 Ausgabetoken. Für Agenten zählt vor allem die Tool-Auswahl. Über Responses unterstützt das Modell Websuche, Dateisuche, Bildgenerierung, Code Interpreter, Hosted Shell, Apply Patch, Skills, Computer Use, MCP, Tool Search und eigene Funktionen. Der Leitfaden zu Responses-Tools zeigt, wie die API das Modell in einer agentischen Schleife hält, während es jeweils das nächste erlaubte Tool auswählt.
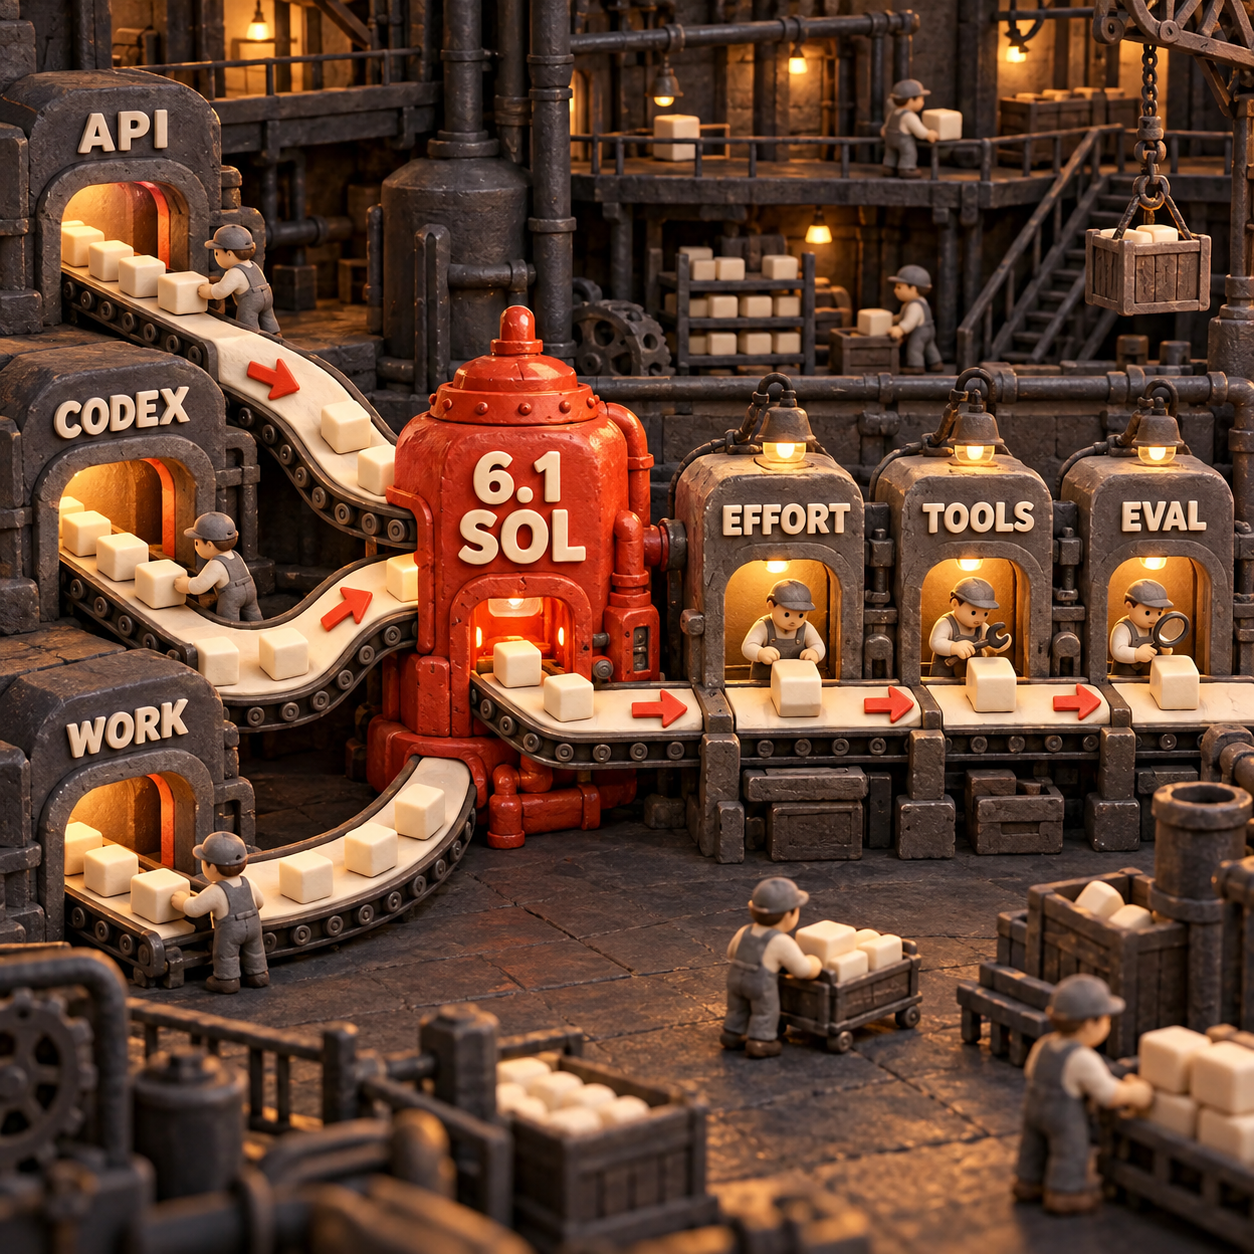
Ebenso wichtig ist die Einschränkung: GPT-6.1 Sol kann Tools ausschließlich über Responses verwenden. Chat Completions akzeptiert weiterhin einfache Anfragen, aber keine Anfragen mit Tool-Aufrufen. Ruft ein bestehender Agent Funktionen über Chat Completions auf, reicht der bloße Austausch der Modell-ID für die Migration nicht aus.
Codex CLI mit GPT-6.1 Sol und der Responses API einrichten
Am Anfang stehen eine Route und ein Abnahmekriterium. Es ist nicht sinnvoll, jedes auf der Modellseite aufgeführte Tool freizugeben. Ein Recherche-Agent benötigt vielleicht Web- und Dateisuche. Für Arbeit an einem Repository können Shell- und Patch-Zugriff nötig sein. Ein operativer Agent kommt womöglich mit zwei Funktionen und einer Freigabegrenze aus.
Dies ist die kleinste sinnvolle JavaScript-Anfrage:
import OpenAI from "openai";

const client = new OpenAI();

const response = await client.responses.create({
  model: "gpt-6.1-sol",
  reasoning: { effort: "medium" },
  tools: [{ type: "web_search" }],
  input: "Find today's source for our target metric, cite it, and return one sentence."
});

console.log(response.output_text);
Die Modell-ID wählt Sol aus. Das Objekt reasoning legt fest, wie viel Rechenaufwand das Modell für die Problemlösung einsetzen darf. Das Array tools erteilt eine Berechtigung, ist aber noch kein Auftrag, das Tool tatsächlich zu verwenden. Der Prompt muss weiterhin Ergebnis, Beleganforderung und Abbruchbedingung festlegen.
Bei einem bestehenden Chat-Completions-Agenten umfasst der Wechsel drei Änderungen: die Anfrage an Responses senden, die typisierten Elemente in output auswerten und festlegen, wie der Gesprächszustand fortgeführt wird. Der Migrationsleitfaden für Astra und die Responses API erläutert diese technische Umstellung ausführlicher.
Fünf echte Aufgaben festschreiben
Aus dem Workflow bereits akzeptierte Beispiele auswählen, darunter einen Fehlerfall. Prompt, Eingaben, Berechtigungen und Erfolgskriterien unverändert sichern.
Mit medium beginnen
Zunächst den Standardaufwand verwenden. Immer nur eine Variable ändern, damit ein Modellvorteil nicht mit einer Änderung an Prompt oder Tools verwechselt wird.
Nur die nötigen Tools freigeben
Ausschließlich jene Such-, Datei-, Funktions-, Shell- oder Computerzugriffe bereitstellen, die diese Route wirklich braucht. Schreibaktionen bleiben durch klare Richtlinien und Freigabegrenzen geschützt.
Kosten pro akzeptiertem Ergebnis erfassen
Neue Eingabetoken, Cache-Eingaben, Ausgaben, Wiederholungen, Tool-Gebühren und den bestandenen oder verfehlten Endzustand dokumentieren. Ein günstiger Fehlversuch spart nichts.
Nach Belegen routen
Sol dort einsetzen, wo es die Tests besteht. Nur die schwierigen Restfälle an Astra eskalieren. Inkompatible Routen bleiben auf GPT-6 Sol, bis ihr Aufrufer umgestellt ist.
Reasoning-Aufwand passend zur Aufgabe wählen
Für die meisten Agentenaufgaben ist medium der beste Ausgangspunkt. GPT-6.1 Sol unterstützt außerdem low, high, xhigh und max. none und minimal werden abgelehnt; bestehende Routen mit einer dieser Einstellungen benötigen deshalb gezielte Tests für Verhalten und Latenz. Der Leitfaden zum Reasoning-Aufwand von OpenAI beschreibt dieselbe Abstufung von effizienter Ausführung bis zu maximaler Denktiefe.
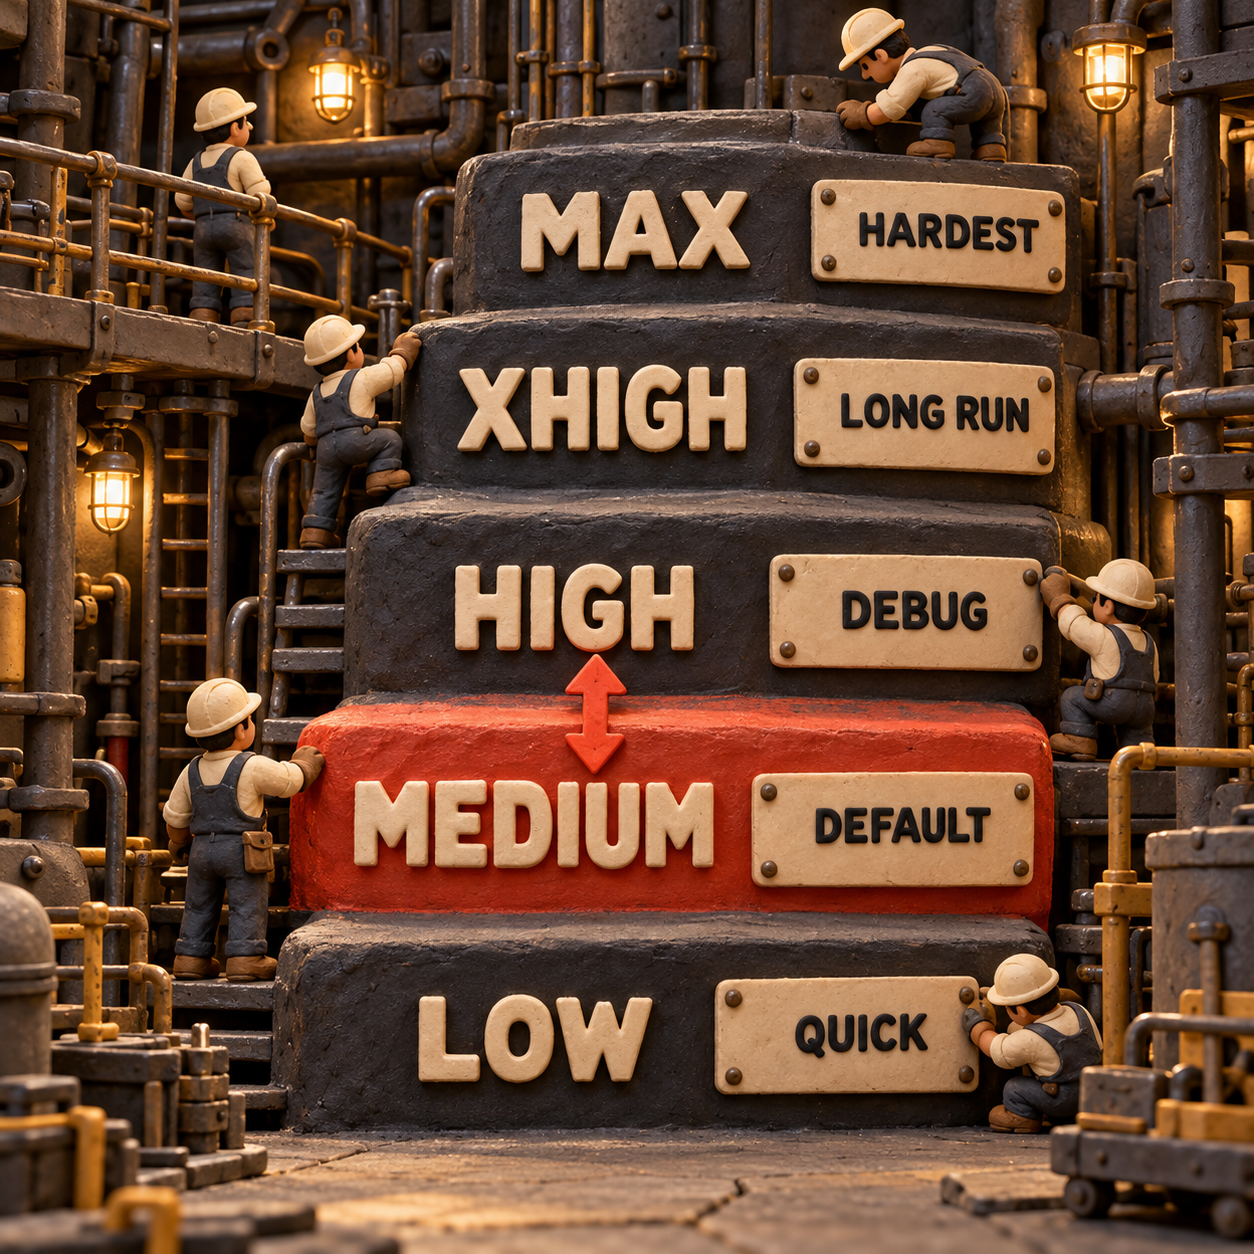
Drei ähnlich klingende Begriffe bezeichnen unterschiedliche Steuerungen. max ist ein Reasoning-Aufwand der API. Ultra ist in Codex ein Multi-Agenten-Modus, der Arbeit auf Subagenten verteilt. Ultrafast ist ein Geschwindigkeitsmodus, dessen Unterstützung für GPT-6.1 Sol noch aussteht. Ein Budget oder Einführungsplan für Ultrafast darf daher nicht von einer bereits verfügbaren Funktion ausgehen.
Ein echter Lauf mit GPT-6.1 Sol und seine Tokenkosten
Ein kleiner Praxistest zeigt die Wirtschaftlichkeit besser als ein Listenpreis. GPT-6.1 Sol erhielt in Codex bei low folgende Aufgabe: eine JavaScript-Funktion slugify ohne Abhängigkeiten erstellen, genau vier node:test-Fälle für Trimmen, Leerraum, Satzzeichen und gemischte Groß- und Kleinschreibung ergänzen, die Tests ausführen und mögliche Fehler beheben.
Das Modell erstellte slugify.js und slugify.test.js und führte anschließend node --test slugify.test.js aus. Das Ergebnis: 4 bestanden, 0 fehlgeschlagen. Erfasst wurden 57,578 Eingabetoken, davon 48,640 aus dem Cache, sowie 542 Ausgabetoken. Damit wurden lediglich 8,938 Eingabetoken zum Tarif für neue Eingaben abgerechnet.
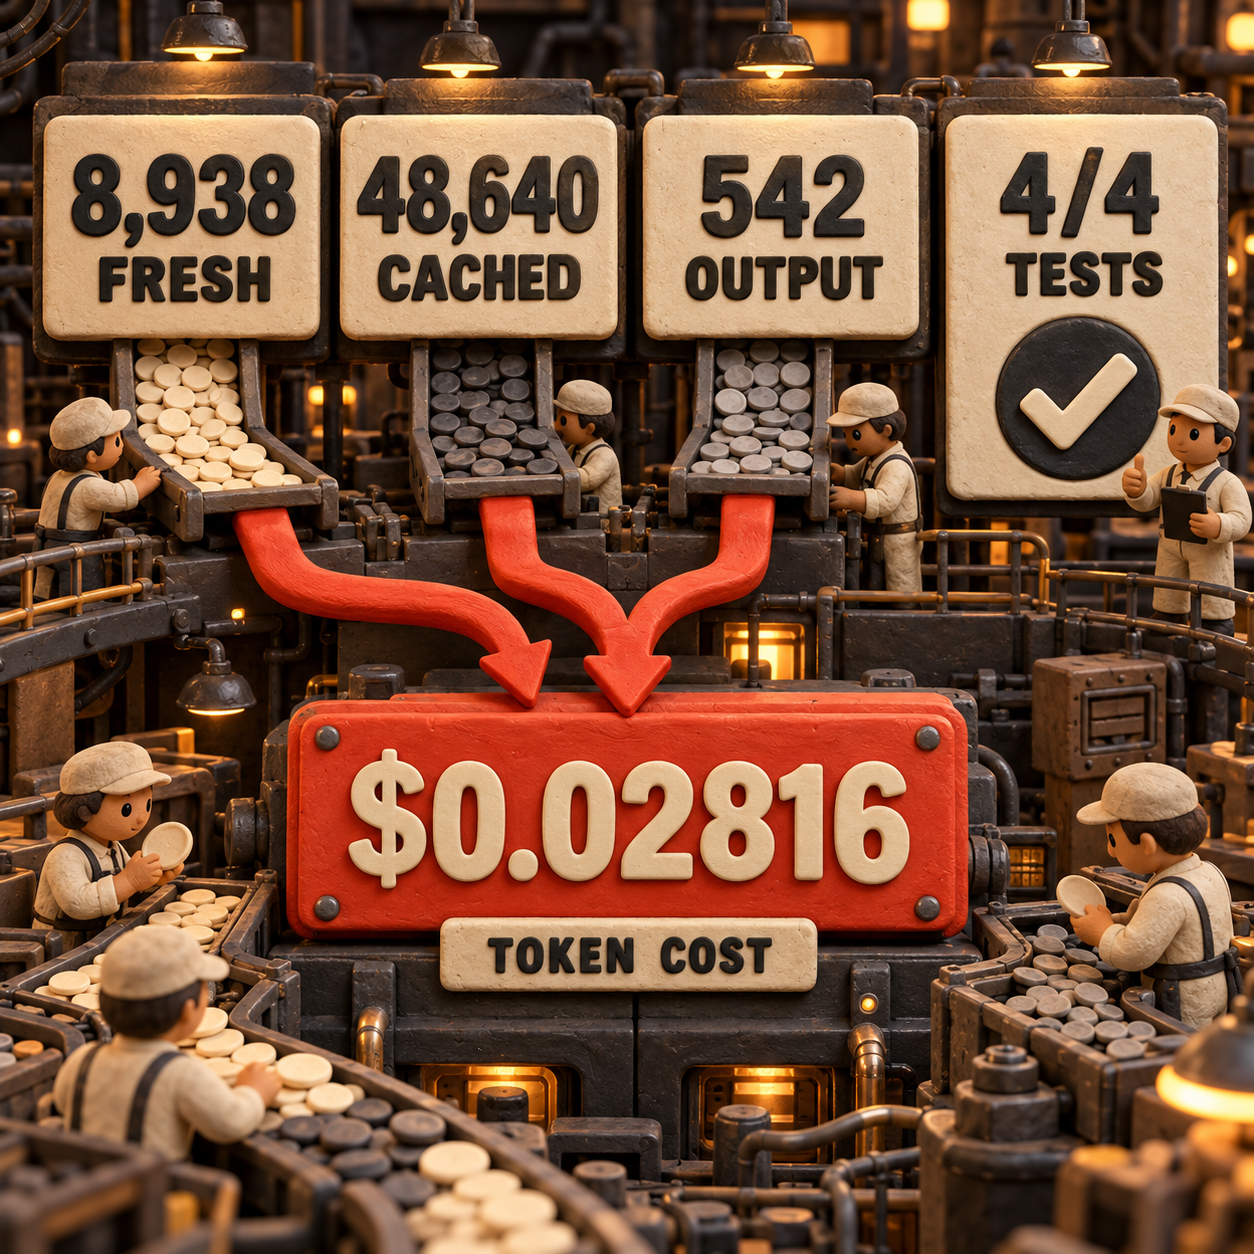
Da dies ein echter Codex-Lauf war, lief er über den Tarifzugang und erzeugte keine API-Rechnung. Die $0.02816 bilden exakt diesen Tokenmix zu den veröffentlichten Standard-API-Tarifen von GPT-6.1 Sol ab. Kostenpflichtige Hosted Tools sind darin nicht enthalten. Bei 10,000 identischen Läufen würde dieser Mix $281.60 an Modell-Token kosten. Bei unverändertem Tokenmix ergäben die Astra-Tarife $1,651.20. Dieser Astra-Vergleich ist reine Tarifarithmetik und keine Behauptung, Astra würde dieselbe Tokenmenge verbrauchen.
Die Aussage lautet nicht, dass jeder kleine Patch drei Cent kostet. Agenten-Runtime, Tool-Definitionen, Anweisungen und Verlauf können umfangreicher sein als die sichtbare Anfrage. Gemessen werden muss der gesamte akzeptierte Lauf, einschließlich Cache-Kontext und Wiederholungen.
Sieben Aufgaben, für die Sol besonders sinnvoll ist
Den größten Nutzen haben Teams mit schwieriger Arbeit, die regelmäßig wiederkehrt. Nach dem wahrscheinlichen betrieblichen Wert geordnet:
Sol ersetzt weder eine durchdachte Freigabelogik noch deterministische Prüfungen oder Observability. Das Modell gibt diesen Systemen jedoch einen leistungsfähigeren Mitarbeiter zu einem niedrigeren Tokentarif als Astra.
Drei Produkte, deren Entwicklung sich lohnt
1. Eine Sol-Migrationstestbank für Programmieragenten
Hier liegt die größte Chance. Rund 8,100 Suchanfragen pro Monat in den USA entfallen auf ai powered coding agent, verbunden mit kommerzieller Suchabsicht. Teams brauchen keine weitere vage Modellrangliste. Sie müssen wissen, ob ihre Repository-Aufgaben mit gpt-6-sol, gpt-6.1-sol und Astra unter identischen Prompts, Tools und Prüfungen bestehen.
Die kleinste verkaufsfähige Version besteht aus einer CLI und einer CI-Action. Das Team liefert fünf JSON-Fixtures, einen Prüfbefehl und die erlaubten Tools. Die Testbank führt jedes Modell aus, protokolliert akzeptierte Ergebnisse, Latenz, neue und gecachte Token, Wiederholungen und Kosten und gibt anschließend eine Entscheidung zur Produktivschaltung aus. Der Haken: Generische Eval-Runner sind leicht zu kopieren. Einen dauerhaften Vorsprung schafft erst eine Bibliothek praxistauglicher Programmier-Fixtures, Integrationen und hilfreicher Fehlerdiagnosen.
2. Ein Aufwand- und Kostenrouter für operative KI-Agenten
Rund 1,000 Suchanfragen pro Monat in den USA zielen auf ai workflow automation; die Suchabsicht ist kommerziell, der CPC liegt bei $37.80. Dieser Markt sucht erledigte Arbeit, nicht noch ein Chatfenster. Ein Router könnte klar begrenzte Fälle an low, normale mehrstufige Aufgaben an medium, schwierige Fehler an high und ausschließlich die ungelösten Restfälle an Astra senden.
Ein MVP benötigt eine Warteschlange, drei Aufwandsrichtlinien, eine Abnahmefunktion und ein Kosten-Dashboard. Zielgruppe sind Operations-Teams, die bereits für mehrere Automatisierungen zahlen. Das Risiko ist falsche Sicherheit: Ein günstiger Router, der auch nur einen folgenreichen Fall falsch einstuft, kann seine gesamten Einsparungen zunichtemachen. Deshalb braucht das Produkt vom ersten Tag an wiederholbare Fixtures und eine manuelle Übersteuerung.
3. Eine Abnahmeschicht für Dokumentenagenten
ai document analysis erreicht rund 1,000 Suchanfragen pro Monat in den USA und einen CPC von $10.44. Das Produkt ist keine weitere Oberfläche zum Hochladen und Zusammenfassen. Es ist eine Prüfschicht, die feststellt, ob ein Dokumentenagent alle Pflichtfelder gefunden, Quellenangaben beibehalten, Summen abgeglichen und Unsicherheiten eskaliert hat.
Die kleinste Version unterstützt ein regelmäßig wiederkehrendes Paket, etwa Lieferantenverträge oder monatliche Finanz-PDFs, mit festem Schema und Ausnahmewarteschlange. GPT-6.1 Sol übernimmt die wiederkehrende Analyse; nur strittige oder unvollständige Fälle gehen an Astra. Der Haken ist die notwendige Branchenspezialisierung. Ein breit angelegtes horizontales Produkt wirkt beliebig, während ein eng umrissenes Paket mit glaubwürdigen Prüfungen Vertrauen gewinnen kann.
Wann GPT-6 Sol bleiben sollte – und wann sich Astra lohnt
GPT-6 Sol bleibt die richtige Wahl, wenn Kompatibilität den Ausschlag gibt. Es akzeptiert weiterhin den Reasoning-Aufwand none und kann Funktionen über Chat Completions aufrufen, sofern reasoning_effort auf none steht. GPT-6.1 Sol kann beides nicht. Eine stabile Route, die auf dieses Verhalten angewiesen ist, sollte zunächst ihren API-Pfad umstellen und Regressionstests bestehen, bevor das Modell wechselt.
GPT-6 Astra lohnt sich, wenn das bestmögliche Ergebnis wichtiger ist als die Tokenrechnung. OpenAI beschreibt Astra als leistungsfähigstes Modell für besonders anspruchsvolles Reasoning, Programmieren, Computer Use, Recherche und Dokumentenerstellung. Es gehört in die wenigen mehrdeutigen Fälle mit hohem Wert – dorthin, wo eine feste Evaluierung einen deutlichen Vorteil zeigt. Bei Standardtarifen kostet Astra $10 für Eingabe- und $50 für Ausgabetoken pro Million, gegenüber $2 und $10 bei GPT-6.1 Sol.
GPT-6.1 Sol ist für die breite Mitte gedacht: anspruchsvolle, wiederkehrende Arbeit über Responses mit messbarem Erfolgskriterium. In den von OpenAI veröffentlichten Evaluierungen zur Einführung schneidet es bei mehreren schwierigen Aufgaben besser ab als GPT-6 Sol. Da diese Ergebnisse vom Anbieter stammen, bleibt die eigene Quote akzeptierter Resultate das entscheidende Freigabekriterium.
Grenzen, die den Aufbau beeinflussen
GPT-6.1 Sol ersetzt nicht jede bestehende Route. Das Modell bietet weder none noch minimal als Reasoning-Aufwand, keine Tool-Aufrufe über Chat Completions, kein Fine-Tuning, keine Audio- oder Videoeingabe und zum Start keinen Zugang im regulären Chat. Für kostenpflichtige Tools fallen eigene Gebühren an. Bei mehr als 272,000 Eingabetoken wird zudem die gesamte Anfrage nach den höheren Tarifen für lange Kontexte abgerechnet. Ein Kontextfenster von 1,050,000 Token ist daher kein kostenloser Arbeitsraum.
Auch Ultrafast ist eine reale Einschränkung. OpenAI hat eine bis zu 8x schnellere Tokengenerierung als bei Standardgeschwindigkeit in Codex angekündigt, die Funktion aber als künftig verfügbar beschrieben. Bis sie für das jeweilige Konto und den verwendeten Client erscheint, sollte die Planung auf Standard oder Fast beruhen und die tatsächlich erzielte Latenz messen.
Der konkrete Schritt für Montag
Fünf Aufträge auswählen, die der aktuelle Agent kürzlich bearbeitet hat: einen einfachen Erfolg, zwei normale Aufgaben, eine Aufgabe mit intensiver Tool-Nutzung und einen bekannten Fehlerfall. Dieselben Fixtures mit GPT-6.1 Sol bei medium ausführen, ohne Prompts oder Berechtigungen zu verändern. Für jeden Lauf werden Ergebnis (bestanden oder nicht bestanden), Laufzeit, neue Eingabetoken, Cache-Eingaben, Ausgabe, Wiederholungen und Tool-Gebühren erfasst.
Danach wird geroutet, nicht pauschal ein Sieger ausgerufen. Klar begrenzte Arbeit kann auf low wechseln, sofern sie weiterhin besteht. high kommt nur für Fehlerfälle infrage, die tieferes Reasoning erfordern. Aufrufer mit Kompatibilitätsabhängigkeiten bleiben bei GPT-6 Sol. Die teuren Restfälle gehen nur dann an Astra, wenn der Zugewinn bei akzeptierten Ergebnissen den Preis rechtfertigt. So entsteht noch in dieser Woche eine Produktionsentscheidung statt einer bloßen Modellmeinung.
Häufig gestellte Fragen
Was ist GPT-6.1 Sol?
GPT-6.1 Sol ist das kostengünstigere OpenAI-Modell für komplexe Programmieraufgaben, Computer Use und professionelle Arbeit. Die API-ID lautet gpt-6.1-sol; Tool-Aufrufe laufen über die Responses API.
Was sind KI-Agenten für die Softwareentwicklung?
KI-Agenten für die Softwareentwicklung können ein Repository untersuchen, Dateien bearbeiten, Befehle und Tests ausführen und innerhalb festgelegter Berechtigungen ein Ergebnis liefern. Entscheidend ist das getestete Resultat, nicht bloß erzeugter Code.
Hat ChatGPT einen Programmieragenten?
Ja. Codex ist der Programmieragent von OpenAI, und GPT-6.1 Sol ist im Rollout für kostenpflichtige Tarife verfügbar. Das Modell gehört außerdem zu ChatGPT Work, ist im regulären Chat aber noch nicht verfügbar.
Ist GPT-6 Sol günstiger?
Nicht bei neuen Eingabe- oder Ausgabetoken: Beide Sol-Modelle kosten im Standardtarif $2 für Eingabe und $10 für Ausgabe pro Million Token. GPT-6.1 Sol bietet den niedrigeren Tarif für Cache-Eingaben. Der ausführliche Sol-Vergleich erläutert Preise und Kompatibilitätsunterschiede.
Wenn eine dieser Agentenrouten für Ihr Unternehmen konzipiert, getestet und produktiv umgesetzt werden soll, finden Sie weitere Informationen unter KI-Produktionssysteme.
- Zuletzt aktualisiert
- 30. Sept. 2026
- Kategorie
- AI
Diese Seite in Google bevorzugen


Markieren Sie omidsaffari.com als bevorzugte Quelle, und Google hebt die Seite für Sie in Top Stories, AI Overviews und AI Mode hervor.
GPT-6.1 Sol Vergleich: Lohnt sich das Upgrade?
Der GPT-6.1 Sol Vergleich zeigt Preise, Benchmarks und API-Unterschiede – und wann sich das Upgrade gegenüber GPT-6 Sol für produktive Workflows lohnt.30. Sept. 2026AI
Claude Sonnet API und App: So nutzen Sie Version 5.5
So nutzen Sie Claude Sonnet 5.5 in App und API, wählen den passenden Effort und vermeiden Fehler bei Thinking, Tool-Aufrufen und der Migration.28. Sept. 2026AI
GLM Flash oder Jev: Welches Entscheidungsmodell passt?
GLM Flash oder Jev? Der Vergleich zeigt Kosten, Bildverarbeitung, Latenz und Einsatzgrenzen – plus einen fairen Testplan für die eigene Entscheidung.27. Sept. 2026AI
Claude Opus 5.5 Vergleich: Lohnt sich der Wechsel von Opus 5?
Der Claude Opus 5.5 Vergleich zeigt Preise, Cache-Vorteile, Coding-Leistung und API-Änderungen, die vor einem Wechsel von Opus 5 zu prüfen sind.23. Sept. 2026AI
GPT-6 Sol oder Luna: Welches Modell passt zu welchem Job?
GPT-6 Sol oder Luna? Der Vergleich zeigt Preise, Stärken und Einsatzgebiete – und wann Sol den 20× höheren Tokenpreis gegenüber Luna wirklich rechtfertigt.23. Sept. 2026AI
Ist GPT-6 Luna kostenlos? Pläne, Limits und API-Kosten
Ist GPT-6 Luna kostenlos? Der Überblick zeigt Gratiszugang, nötige Tarife, separate API-Kosten und die bislang nicht veröffentlichten Nutzungslimits.22. Sept. 2026AI
Xiaomi MiMo nutzen: V2.6 vom Prompt bis zur API
Xiaomi MiMo V2.6 praxisnah einrichten: Prompt in Studio testen, passenden API-Schlüssel wählen und Flash, Pro oder UltraSpeed gezielt einsetzen.22. Sept. 2026AI