KI-Agenten: Drei Monatsbudgets und oft übersehene Kosten
Was KI-Agenten im Betrieb kosten: drei Monatsbudgets für Support-E-Mails, Tarife für fertige Assistenten, n8n und APIs sowie oft übersehene Zusatzkosten.
Bei 1,000 Support-E-Mails im Monat ergeben die folgenden Beispielrechnungen für KI-Agenten reine Softwarekosten von $82 für einen fertigen Assistenten, umgerechnet $25.50 pro Monat für einen gehosteten Baukasten mit Jahresabrechnung und $10.50 für einen eigenen API-Workflow. In allen Fällen braucht es weiterhin menschliche Kontrolle, ein E-Mail-Postfach und jemanden, der bei Fehlern die Verantwortung übernimmt. Entscheidend sind die monatlichen Kosten je akzeptierter Antwort.
KI-Agenten: Drei Abrechnungsmodelle für dieselbe Aufgabe
Ein KI-Agent nutzt ein Modell, um eine Aufgabe zu bearbeiten und Aktionen in angebundenen Tools auszuführen. Im Support könnte er etwa eine E-Mail lesen, die passende Richtlinie heraussuchen und eine Antwort vorbereiten. Wer nur das Modell einkauft, hat damit noch keine Postfachanbindung, keinen Freigabeprozess und keinen fertigen Supportdienst.
Die Rechnung hängt davon ab, wie viel von diesem System bereits fertig eingekauft wird:
- Ein fertiger Agent: Ein einsatzbereiter Assistent wird meist per Abonnement oder Nutzerlizenz bezahlt. Eine Nutzerlizenz entspricht einem bezahlten Benutzerkonto. Zusätzlich können innerhalb des Abonnements Nutzungskontingente gelten.
- Ein No-Code-Baukasten: Die einzelnen Schritte werden selbst verknüpft; abgerechnet werden Credits, Aufgaben oder Workflow-Ausführungen. Eine Ausführung ist ein vollständiger Durchlauf. Ein Credit ist die anbietereigene Einheit für gemessene Arbeit.
- Ein eigener API-Workflow: Die eigene Software ruft ein Modell über eine API auf, also eine Schnittstelle, über die Programme Arbeit anfordern. Bezahlt werden Tokens – die Textbausteine, die das Modell liest und erzeugt – sowie Hosting und gegebenenfalls kostenpflichtige Tools.
Alle drei Wege lösen dieselbe Aufgabe, verteilen aber die Verantwortung unterschiedlich. Ein Gründer kann fertige Antwortentwürfe für sein Postfach einkaufen. Wer den operativen Betrieb verantwortet, kann den Workflow zusammenstellen. Ein Backend-Team kann die ausführende Software selbst betreiben.
Die hier genannten Preise wurden am 7. Oktober 2026 auf den Seiten der Anbieter geprüft. Sämtliche Dollarbeträge sind USD. Jahrespreise sind als solche gekennzeichnet. Die Beispielbudgets beruhen auf ausdrücklich genannten Annahmen und sind keine Leistungstests. Der Zeitaufwand für die Einrichtung sollte getrennt von den laufenden Kosten erfasst werden.
Welche Preise verlangen die Anbieter – und wofür?
Die Modellpreise gelten ohne Caching, Batch-Rabatte oder Aufpreise für höhere Geschwindigkeit. Dieselbe E-Mail kann je nach Modell unterschiedliche Tokenmengen und unterschiedlich gute Antworten erzeugen. Ein günstigerer Tarif lohnt sich nur, wenn die Antworten den Anforderungen des Supports entsprechen.
Auch bei den übrigen Angeboten kommt es auf die Abrechnungsdetails an. Der Einstiegspreis von Lindy garantiert keine 1,000 Antworten: Das Erstellen von Entwürfen fällt in eine breite Spanne von 2 bis 250 Credits für alltägliche Aufgaben. Zum Versenden einer E-Mail ist eine Freigabe nötig. Weitere aktive Nutzer bedeuten weitere bezahlte Nutzerlizenzen. Lindys Regeln zu Nutzung und Freigaben.
Die Credits von Gumloop decken mehr als Textverarbeitung ab. Nach den aktuellen nutzungsabhängigen Regeln entspricht ein Credit $0.005. Berechnet werden mindestens 1 Credit pro erfolgreichem Connector-Aufruf und 5 Credits pro aktiver Sitzungsminute, jeweils vor der regulären Orchestrierungsgebühr von 8%. Die vollständige Credit-Abrechnung von Gumloop.
Mit einem eigenen API-Schlüssel für das Modell bleiben Tool- und Rechenkosten bestehen. Die Agentengebühr steigt nach der aktuellen nutzungsabhängigen Regelung auf 16%; für ältere Konten können frühere Regeln gelten. Bemessungsgrundlage ist, was der vollständige Durchlauf gekostet hätte, einschließlich der Modellnutzung, die nun beim eigenen Anbieter abgerechnet wird. Die Gebühr darf daher nicht allein auf die verbleibenden Tool-Kosten berechnet werden.
Das Rechenbeispiel: 1,000 Support-E-Mails im Monat
Die Aufgabe lässt sich klar eingrenzen: Ein kleines Unternehmen erhält 1,000 einzelne Support-E-Mails, die sich anhand seiner bestehenden Richtlinien beantworten lassen. Der Workflow erstellt Antwortentwürfe. Eine Person prüft sie und versendet die akzeptierten Antworten.
Eingeplant sind 100 zusätzliche Entwurfsversuche, also insgesamt 1,100 Versuche. Dieser Aufschlag von 10% ist eine Planungsannahme und keine Aussage über die Wiederholungsrate eines Produkts. Die Beispiele enthalten keine Anhänge, Internetsuchen oder kostenpflichtige Datenanreicherung. Das vorhandene Postfach bleibt außerhalb der Zwischensumme für die neue Software.
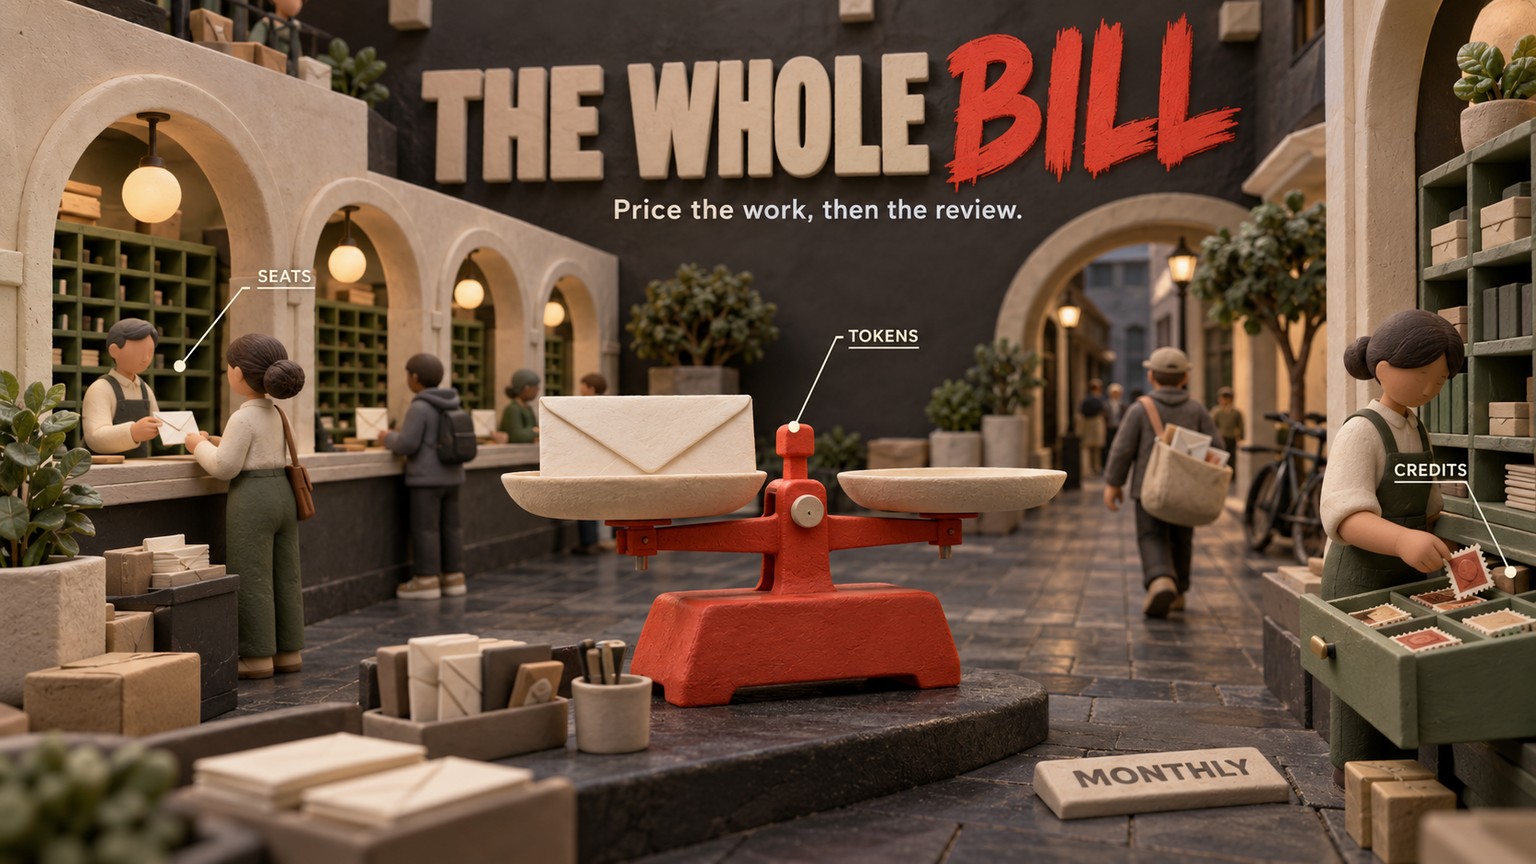
Für Baukasten und API werden 3,000 Eingabe-Tokens und 400 abgerechnete Ausgabe-Tokens je vollständigem Versuch angenommen. Das entspricht einem einzelnen Modellaufruf. Bei mehreren Aufrufen pro Workflow muss deren gesamte Nutzung berücksichtigt werden. Der fertige Dienst legt seine interne Modellnutzung selbst fest; hier zählt deshalb die veröffentlichte Abrechnung je Aufgabe.
Variante 1: Marblism kostet für die integrierten Antwortentwürfe $82/Monat
Ein SaaS-Gründer, der Eva von Marblism nutzt, bezahlt aus einem gemeinsamen Stundenkontingent. Es handelt sich um feste Abrechnungswerte pro Aufgabe, nicht um die gemessene Laufzeit der KI: Das Sortieren einer neuen E-Mail verbraucht 20 Sekunden, ein Antwortentwurf 5 Minuten. Marblisms Abrechnungswerte und Kapazitätsstufen.
Für diese Aufgabe ergibt sich:
- 1,000 neue E-Mails sortieren: 1,000 × 20 Sekunden = 5.56 Stunden.
- 1,100 Antwortentwürfe einschließlich der zusätzlichen Versuche anfordern: 1,100 × 5 Minuten = 91.67 Stunden.
- Insgesamt abgerechnete Arbeit: 97.22 Stunden.
Das passt in den 100-Stunden-Tarif für $82 bei monatlicher Abrechnung. Der Basistarif mit 50 Stunden für $44 reicht nicht aus. Bei Jahresabrechnung kostet die Stufe mit 100 Stunden $45/Monat. Alle anderen KI-Aufgaben des Kontos greifen auf dasselbe Kontingent zu.
Eva legt Entwürfe im Postfach an; ein Mensch prüft sie und klickt auf „Senden“. Dieses Budget kauft somit Unterstützung beim Beantworten von Supportanfragen. Die Freigabearbeit bleibt beim Unternehmen. Wie Eva Antworten vorbereitet.
Bei der Kapazität gibt es eine weitere Stolperfalle. Marblism berechnet eine Aktion über eine App-Integration oder einen Automatisierungsdurchlauf separat mit 25 Sekunden. Kommt pro Versuch eine solche Aktion hinzu, entstehen weitere 7.64 Stunden. Die Summe steigt auf 104.86 Stunden; nötig wäre dann die 150-Stunden-Stufe für $120/Monat. Die Schätzung von $82 deckt nur das integrierte Sortieren und Erstellen von Entwürfen ab. Vor zusätzlichen Aktionen sollte die Nutzungsaufschlüsselung geprüft werden.
Variante 2: n8n mit Claude kostet umgerechnet $25.50/Monat
Wer den operativen E-Commerce-Betrieb verantwortet, kann eingehende Support-E-Mails, die passende Richtlinie und einen Modellaufruf verknüpfen und anschließend einen Entwurf zur Prüfung speichern. Die Gmail-Integration von n8n unterstützt das Lesen von Nachrichten und das Anlegen von Entwürfen. Die Anthropic-Integration lässt sich mit einem eigenen API-Schlüssel nutzen. Gmail-Funktionen, Anthropic-Zugangsdaten.
Angenommen, die Konfiguration erzeugt je Versuch eine vollständige Workflow-Ausführung. 1,100 Ausführungen liegen innerhalb des Starter-Kontingents von 2,500 Ausführungen. Die Schritte eines Durchlaufs zählen nicht jeweils als weitere Ausführung. Zusätzlich ausgelöste Durchläufe müssen aber ebenfalls ins Kontingent passen. Wie n8n Ausführungen zählt und abrechnet.
Bei einem eigenen Anthropic-Schlüssel wird die Modellnutzung separat abgerechnet:
1,100 × 3,000 = 3.3 Millionen Eingabe-Tokens.
1,100 × 400 = 0.44 Millionen Ausgabe-Tokens.
Mit den geprüften Haiku-Tarifen ergibt sich 3.3 × $1 + 0.44 × $5 = $5.50. Hinzu kommen $20/Monat als umgerechneter Preis des Jahrestarifs. Das Softwarebudget beträgt damit umgerechnet $25.50/Monat. n8n hostet Starter; ein separates Hosting-Abonnement kommt in diesem Beispiel nicht hinzu.
Auch die beiden Credit-Guthaben von n8n sollten auseinandergehalten werden. Assistant Credits bezahlen Unterstützung beim Aufbau von Workflows und bei der Fehlersuche. Gateway Credits bezahlen Modelle, die während der Workflow-Ausführung aufgerufen werden. Dieses Beispiel nutzt statt Gateway Credits einen eigenen Anthropic-Schlüssel. Ein Assistant-Kontingent deckt diese Modellrechnung nicht ab. Die beiden Credit-Systeme.
Variante 3: Ein eigener Claude-API-Workflow mit Hosting kostet $10.50/Monat
Ein Backend-Team kann denselben klar begrenzten Workflow in einer eigenen Anwendung betreiben: E-Mail entgegennehmen, Richtlinie bereitstellen, Entwurf anfordern und zur menschlichen Prüfung speichern. Bei den gleichen angenommenen Tokenmengen kostet Haiku weiterhin $5.50/Monat.
Als konkrete Hosting-Position dient Cloudflare Workers Paid ab $5 pro Konto und Monat, einschließlich 10 Millionen Anfragen und 30 Millionen CPU-Millisekunden. Das Beispiel setzt voraus, dass die Anwendung und ihr kleiner Datenspeicher innerhalb der enthaltenen Kontingente bleiben. Preise für Workers und die enthaltenen Datendienste.
Die Software-Zwischensumme beträgt $5.50 + $5 = $10.50/Monat. Vorausgesetzt sind ein vorhandenes Postfach, keine optionalen kostenpflichtigen Tools und keine weiteren Aufgaben, die das Kontingent des Kontos beanspruchen. Workers bietet auch einen Free-Tarif. Ob dessen Grenzen zur eigenen Umsetzung passen, muss gesondert geprüft werden.
Bei unveränderten Tokenmengen würde Sonnet $11 für Tokens beziehungsweise $16 einschließlich dieses Hostings kosten. Bei GPT-6 Luna wären es $0.55 für Tokens beziehungsweise $5.55 mit Hosting. Das sind Tarifvergleiche. Sie belegen nicht, dass alle drei Modelle die E-Mails gleich gut bearbeiten.
Die niedrige API-Zwischensumme bringt eigene Verantwortung mit sich: Das Team wartet die Postfachanbindung, die Speicherung der Entwürfe, die Fehlerbehandlung und das Modellverhalten. Der Leitfaden zu den Preisen der Claude API behandelt Modelltarife, Caching und Batch-Verarbeitung ausführlicher, sobald Messwerte zur eigenen Nutzung vorliegen.
Wie lässt sich der Tokenbedarf einer Aufgabe schätzen?
Ausgangspunkt ist alles, was das Modell erhält, nicht nur die E-Mail des Kunden. Anweisungen, frühere Nachrichten, Richtlinienauszüge, Tool-Beschreibungen und Tool-Ergebnisse können Eingabe-Tokens verursachen. Bei jedem weiteren Modellaufruf wird ein Teil dieses Materials möglicherweise erneut verarbeitet. Claudes Token-Abrechnung bei Tool-Nutzung.
Für eine erste Tabellenkalkulation sei angenommen: 800 Tokens für die Anweisungen, 400 für die E-Mail samt Verlauf und 1,800 für die passende Richtlinie. Das ergibt 3,000 Eingabe-Tokens. Für den Entwurf werden 400 abgerechnete Ausgabe-Tokens angesetzt. Diese Planungswerte müssen durch Messungen ersetzt werden; sie sind keine vom Anbieter zugesagten typischen Mengen.
Die vollständige Eingabe für das gewählte Modell zählen
Die komplette Anfrage wird an den Token-Zählendpunkt des Modells geschickt. Der Zähler von Claude ist kostenlos und modellspezifisch, liefert aber eine Schätzung. Für Anfragen mit den meisten gehosteten Tools oder externen Tool-Verbindungen müssen stattdessen die tatsächlichen Nutzungswerte aus der Antwort herangezogen werden. Eine Schätzung anhand der Wortzahl reicht nicht aus, um den Rechnungsbetrag zu bestimmen. Tokenzählung bei Claude.
Die gesamte erledigte Aufgabe messen
Repräsentative E-Mails werden durch die tatsächliche Konfiguration geschickt. Zu erfassen sind die abgerechneten Eingabe- und Ausgabe-Tokens aller Modellaufrufe, einschließlich zusätzlicher Entwürfe und Wiederholungen. Bei aktiviertem Cache wird dessen Nutzung separat erfasst. Bei einem Credit-Baukasten zählt die vollständige Aufgabenaufschlüsselung: In Gumloop öffnet der Credit-Zähler im Chat-Kopfbereich die Detailansicht. Gumloops Kostenaufschlüsselung.
Versuche hochrechnen und feste Kosten ergänzen
Kosten je Versuch = (Eingabe-Tokens × Eingabepreis + Ausgabe-Tokens × Ausgabepreis) ÷ 1,000,000. Monatliche Tokenkosten = Kosten je Versuch × monatliche Versuche. Hinzu kommen die Plattform- oder Hostinggebühr und separat abgerechnete Tools.
Für Haiku ergibt sich (3,000 × $1 + 400 × $5) ÷ 1,000,000 = $0.005 je Versuch. Bei 1,100 Versuchen sind das die oben angesetzten $5.50. Braucht eine Aufgabe mehrere Aufrufe, werden deren Kosten zuerst addiert und dann mit der Zahl der monatlichen Aufgaben multipliziert. Nur den letzten Entwurf einzupreisen wäre unvollständig.
Welche Kosten werden leicht übersehen?
Menschliche Prüfung und Korrekturen. Bei angenommenen 30 Sekunden je akzeptierter E-Mail dauert die Prüfung von 1,000 Antworten 500 Minuten beziehungsweise 8.33 Stunden. Bei einer Minute pro Antwort sind es 16.67 Stunden. Die gemessenen Stunden für Prüfung, Korrekturen und Übergaben werden mit dem eigenen Vollkostensatz pro Arbeitsstunde multipliziert, einschließlich der Personalnebenkosten. Anschließend lässt sich vergleichen, wie viel Zeit dieselben Anfragen zuvor beansprucht haben.
Wiederholungen und zusätzliche Entscheidungen. Die Beispiele planen 100 weitere Versuche ein. Ein Agent kann die Anfrage aber auch klassifizieren, Informationen abrufen und seinen Entwurf mit separaten Modellaufrufen prüfen. Diese Aufrufe und erfolglose Arbeit gehören in die monatliche Rechnung, selbst wenn als Ergebnis nur die akzeptierte Antwort zählt.
Tool-Aufrufe. Eine niedrige Tokenrechnung deckt nicht jedes Tool ab. Die Websuche von Claude kostet $10 pro 1,000 Suchanfragen, zuzüglich der Tokens für die Ergebnisse. Eine Suche pro Versuch würde in diesem Beispiel $11 Suchgebühren und weitere Eingabe-Tokens verursachen. Ein Supportagent, der ausschließlich anhand der eigenen Richtlinien antwortet, braucht möglicherweise keine Suche. Claudes Preise für die Websuche.
Daten und weitere APIs. Zu prüfen sind Postfach, Helpdesk, CRM, Datenbank, Dokumentenspeicher und Dienste zur Datenanreicherung, die der Workflow nutzt. Ein enthaltener Connector stellt eine Verbindung bereit. Er übernimmt nicht automatisch die Abonnement- oder Nutzungskosten des angebundenen Dienstes. Bestehende und neue Kosten sollten sichtbar bleiben, damit sich sowohl das gesamte Betriebsbudget als auch die durch den Agenten entstehenden Mehrausgaben berechnen lassen.
Wartung und Kapazität. Jemand muss weiterhin Probleme mit Zugangsdaten beheben, veraltete Richtliniendokumente aktualisieren und auf verändertes Verhalten reagieren. Diese Arbeitszeit gehört in die Erfassung. Auch Abonnementkontingente sind begrenzt: Andere Aufgaben können dieselben Stunden oder Credits verbrauchen und einen höheren Tarif nötig machen.
Für Helpdesk-Agenten, die nach abgeschlossenen Problemlösungen abgerechnet werden, behandelt der Leitfaden zum Eigenbetrieb oder Einkauf im Kundenservice diese gesonderte Kaufentscheidung. Dessen Projektwirtschaftlichkeit sollte getrennt von der hier berechneten laufenden Softwareprognose betrachtet werden.
Was sollte in den ersten 30 Tagen gemessen werden?
- Ergebnisse: eingegangene E-Mails, akzeptierte Antworten, erneut geöffnete Anliegen und an Menschen übergebene Fälle.
- Alle Abrechnungseinheiten: bezahlte Nutzer, Stunden, Credits, Ausführungen, Eingabe- und Ausgabe-Tokens sowie kostenpflichtige Tool-Aufrufe.
- Zusätzliche Arbeit: Versuche je akzeptierter Antwort, Korrekturen und wiederholte Durchläufe.
- Menschliche Arbeitszeit: Prüfung, Übergaben und Wartung im Vergleich zum bisherigen Ablauf.
- Weitere Gebühren: Hosting, Speicher, angebundene APIs und die nächste Kapazitätsstufe.
- Kosten je akzeptierter Antwort: sämtliche zurechenbaren Software-, Tool- und Personalkosten geteilt durch die Zahl der akzeptierten Antworten. Wer abgeschlossene Anliegen misst, sollte die Kosten je Problemlösung separat erfassen.
Welches Abrechnungsmodell passt zum eigenen Betrieb?
Ein SaaS-Gründer, der noch diese Woche Entwürfe im Postfach braucht, kann mit einem fertigen Assistenten beginnen. Vor dem Kauf sollte das Kontingent gegen das gesamte Anfragevolumen geprüft und die prüfende Person festgelegt werden. Der Vorteil ist eine einsatzbereite Arbeitsoberfläche. Die entscheidende Kennzahl sind akzeptierte Antworten je bezahltem Monat.
Verantwortliche im E-Commerce-Betrieb, die E-Mails, Richtlinien und Bestelldaten zusammenführen müssen, können einen Baukasten nutzen. Dafür wird der vollständige Workflow im Pilotbetrieb getestet und seine Ausführungs- oder Credit-Abrechnung geprüft. Kostenpflichtige Abfragen von Bestelldaten gehören ins Budget, bevor die Rechnung mit einem einfacheren Dienst für Antwortentwürfe verglichen wird.
Wer ein Backend-Team leitet und jemanden für die Wartung des Workflows zur Verfügung hat, kann den API-Weg wählen. Der Einstieg sollte eine klar begrenzte Supportaufgabe sein. Zu prüfen ist das günstigste Modell, das die Qualitätsanforderungen an Antworten erfüllt. Die Tokenersparnis hilft nur, wenn auch der laufende Entwicklungsaufwand und die Prüfzeit ins Budget passen.
Die Methode lässt sich übertragen. Eine Vertriebsleitung sollte jede Nachfassnachricht und jede Aktion zur Datenanreicherung zählen, nicht nur kontaktierte Leads. Im Finanzbereich zählen bei jedem planmäßig erstellten Bericht die Datenabrufe, Modellaufrufe und die Prüfung. Anschließend wird der akzeptierte Bericht mit dem manuellen Zeitaufwand verglichen, den er ersetzt.
Eine breit angelegte autonome Einführung sollte warten, solange unklar ist, wie ein korrektes Ergebnis aussieht oder wer sich um Ausnahmen kümmert. Erledigt der bestehende regelbasierte Workflow die Aufgabe bereits zuverlässig, verursacht ein Modell neue Kosten, ohne dass sein Nutzen feststeht.
Weitere praktische Analysen zu Tools und Budgets gibt es im Newsletter.
- Zuletzt aktualisiert
- 7. Okt. 2026
- Kategorie
- Explained
Diese Seite in Google bevorzugen


Markieren Sie omidsaffari.com als bevorzugte Quelle, und Google hebt die Seite für Sie in Top Stories, AI Overviews und AI Mode hervor.

Audio transkribieren mit Grok Voice Transcribe 2.0: Gleiche Kosten, neues Standardmodell
Grok Voice Transcribe 2.0 bleibt bei $0.10 pro Batch-Stunde und $0.20 im Streaming. Was der neue Standard für API-Aufrufe und Workflows bedeutet.20. Sept. 2026Explained
Puppeteer Debugging mit Cloudflare: Erst prüfen, dann neu starten
Cloudflares Inspect-Panel zeigt Logs, Netzwerkspuren und den finalen DOM eines fehlgeschlagenen Browser Runs – noch vor einem weiteren Diagnoselauf.19. Sept. 2026Explained
Private npm Registry in v0: Eigene Komponenten wiederverwenden
So bindet v0 eine private npm Registry sicher ein, schützt Tokens vor Modell und Sandbox und reduziert den Komponententausch beim Übergang in die Produktion.19. Sept. 2026Explained
Claude Code Kosten: Wann Auto Mode Classifier-Gebühren spart
Claude Code 2.1.278 kann separate Classifier-Gebühren im Auto Mode vermeiden. Entscheidend ist, ob Server, Region und Gateway den neuen Pfad unterstützen.19. Sept. 2026Explained
Vercel-Build-Kosten: Turbo gezielt pro Deployment aktivieren
Vercel Turbo lässt sich jetzt für ein einzelnes Deployment aktivieren. So kalkulieren Pro- und Enterprise-Teams den Aufpreis und prüfen, ob er sich lohnt.18. Sept. 2026Explained
ChatGPT Word: Dokumente bearbeiten, ohne ständig zu kopieren
Mit ChatGPT Word entstehen Entwürfe und Überarbeitungen direkt im Dokument. Der Leitfaden erklärt Zugriff, Nutzungslimits und einen sicheren Workflow.18. Sept. 2026Explained
Google Antigravity: So migrieren lokale Jobs rechtzeitig
Google Antigravity stellt am 5. Oktober den Mai-Agenten ab. Welche Jobs nur eine neue Agent-ID brauchen – und wann der Tool-Adapter angepasst werden muss.18. Sept. 2026Explained