AgentRun im Test: KI-Workflow-Automatisierung mit klaren Grenzen
AgentRun im Praxistest: Wie der TypeScript-Interpreter KI-Workflows strukturiert, Agentenaufrufe begrenzt – und wann eine einfache Funktion besser ist.

- AAgentRun
- Lllama.cpp

Bei der KI-Workflow-Automatisierung verdient AgentRun dann einen Platz, wenn wiederkehrende Abläufe sichtbare Verzweigungen, schemageprüfte Zustände und eine harte Obergrenze für Agentenaufrufe brauchen. Im Test erledigte 0.1.0-beta.4 die beiden einfachen Supportfälle ohne Agentenaufruf, nutzte für die beiden Untersuchungsfälle jeweils einen Aufruf und eskalierte den ungelösten Fall mit Exit-Code 2. In puncto Einfachheit blieb eine feste Funktion mit 31 Zeilen dennoch vorn.
KI-Workflow-Automatisierung mit AgentRun: Was steckt dahinter?
AgentRun ist Parchas TypeScript-Workflow-Interpreter. Er gibt Tools, eng umrissenen Modellentscheidungen und Agentenaufrufen eine deterministische Struktur. Parcha hat das Projekt am 23. September 2026 als Open Source veröffentlicht. Ein Workflow-Dokument definiert Zustandsverträge, Schritte, Verzweigungen, Grenzen und den Eskalationspfad. Die Anwendung selbst stellt Tools, Modellzugriff, Berechtigungen, Speicher und Auslieferung bereit. Gemeint ist weder das gleichnamige Produkt von Alibaba Cloud noch das ältere Python-Paket zur Ausführung von modellgeneriertem Code oder das Mobile Game von 2014, das weiterhin in Suchergebnissen auftaucht. Das aktuelle Kernpaket ist @parcha/agentrun-dsl in Version 0.1.0-beta.4 und steht unter Apache-2.0.
Für wen eignet sich Parcha AgentRun – und wer sollte darauf verzichten?
AgentRun richtet sich an TypeScript-Teams, die bereits eine Agenten-Runtime betreiben und einen wiederkehrenden Ablauf benennen können, dessen gewöhnlicher Code kaum noch zu überblicken ist. Die Support-Triage passt gut: zuerst suchen, dann die Antwortqualität bewerten, nur bei echtem Untersuchungsbedarf einen Agentenaufruf ausgeben und anschließend antworten oder an einen Menschen übergeben. Evidenzprüfung, Freigaberouting und Recherchepipelines folgen demselben Muster. Am größten ist der Nutzen, wenn Verantwortliche aus Produkt, Betrieb oder Risikomanagement den Kontrollfluss verstehen müssen, ohne ein Geflecht aus Callbacks nachzuverfolgen.
Nicht sinnvoll ist AgentRun für eine feste Funktion mit zwei oder drei offensichtlichen Verzweigungen. Die für diesen Test geschriebene Kontrollimplementierung bildete alle vier Supportergebnisse mit einem Funktionskörper von 31 Zeilen ab. Die AgentRun-Beispieldatei umfasst dagegen schon vor der Host-Integration 93 Zeilen. Bei reiner Kürze gewinnt die Funktion.
Zu LangGraph.js sollte greifen, wer vor allem einen langlebigen, zustandsbehafteten Agenten mit Persistenz, Streaming und menschlichen Eingriffen benötigt. Temporal ist die bessere Wahl, wenn eine Anwendung Abstürze, Netzwerkausfälle und lange Wartezeiten zuverlässig überdauern muss. AgentRun stellt zwar Recovery-Hooks bereit, bringt aber keinen dauerhaften Scheduler mit. Auch für Teams, die Python, Browserausführung, ein gehostetes Dashboard oder ein Produktions-SLA brauchen, ist beta.4 die falsche Kaufentscheidung: Nichts davon gehört zu diesem Release.
AgentRun-DSL, Stärke 1: Typisierte Zustände erkennen Vertragsabweichungen
Der erste Pluspunkt der AgentRun-DSL: Ein Endwert, der nicht mehr zum deklarierten Vertrag passt, wird abgelehnt. Das klingt banal, bis ein Workflow Suchergebnis, semantische Entscheidung und Agenteneinreichung zusammenführt. Ohne abschließende Validierung kann eine Formänderung in einem beliebigen Zweig beim Aufrufer als vermeintlicher Teilerfolg ankommen.
Der Support-Workflow unterscheidet zwischen einem lockeren Candidate und dem endgültigen Answer. Die Suche darf leeren Text oder gar keine Quellen liefern, weil genau das eine Untersuchung auslösen kann. Für den Abschluss gelten strengere Regeln: Die finale Antwort benötigt nicht leeren Text und mindestens eine Quelle. Laut Authoring Guide werden außerdem die deklarierten Ein- und Ausgabeverträge validiert; Pfade im Zwischenzustand prüft die Runtime während der Ausführung.
Im Vertragstest wurde ein Pflichtfeld ergänzt, ohne die Fixture-Ausgabe anzupassen:
schemaWorkflow.schemas.Answer.properties.resolutionCode = {
  type: 'string',
  minLength: 1,
};
schemaWorkflow.schemas.Answer.required.push('resolutionCode');
Der Passwortpfad führte weiterhin die Hilfesuche und die erste Entscheidung aus. Beim Abschluss folgte jedoch ein WorkflowOutputInvalidError mit dem Code output_invalid, weil resolutionCode fehlte. Eine ungültige Antwort wurde nicht zurückgegeben. Genau so sollte ein System scheitern: Es stoppt an seiner Grenze, statt ein semantisch plausibles Objekt als vertraglich vollständiges Ergebnis zu behandeln.
Der Schutz hat eine klar definierte Grenze. Ein gültiger text-String und ein gültiges sources-Array können inhaltlich trotzdem falsch sein. Die Schemavalidierung belegt, dass nachgelagerter Code den Wert verarbeiten kann – nicht, dass Kundinnen und Kunden ihm vertrauen sollten. Der ergänzende Test zum Routing von Supporttickets mit Jev behandelt diese Entscheidungsebene: Auch Wahrscheinlichkeiten und typisierte Ausgaben brauchen gelabelte Fälle und eine menschliche Rückfallebene.
AgentRun-Workflow, Stärke 2: Verzweigungen begrenzen Agentenaufrufe
Die Workflow-Steuerung von AgentRun tat in vier Supportfällen genau das, was der Graph vorgab: Zwei Anfragen endeten nach Suche und einer Entscheidung, zwei weitere durchliefen eine begrenzte Untersuchung und eine zweite Entscheidung. Die entscheidende Einheit ist kein autonomer Agent, sondern ein deterministischer Pfad mit genau einer Stelle, an der ein Agent aufgerufen werden darf.
Jeder direkte Fixture-Lauf endete wie dokumentiert. Passwort, Rechnung und fehlgeschlagene Zahlung lieferten Code 0. Die ungeklärte Zahlung lieferte Code 2 mit der Begründung, dass die Antwort nach einer Untersuchung weiterhin unzureichend oder unsicher war. In allen vier Fällen wurden null Byte nach stderr geschrieben. Auch die fokussierte Support-Testsuite des Repositorys bestand alle 31 Tests in 2.92 Sekunden, einschließlich ungültiger Einreichungen, Entscheidungen mit niedriger Konfidenz, Abbrüchen und Adapterfehlern.
Diese Ergebnisse belegen Aufrufdisziplin, nicht Supportqualität. Suchantworten, Jev-Entscheidungen und Untersuchungsergebnisse stammten aus festen Fixtures. Eine Prompt-Änderung macht sie nicht anpassungsfähig, und es wird keine echte Kundenantwort verschickt. Der Nachweis ist enger, aber nützlich: Besteht die erste Antwort, verbraucht der Interpreter keinen Agentenaufruf. Fällt sie durch, erlaubt er genau eine Untersuchung. Scheitert auch die zweite Prüfung, wird der Fall nicht als abgeschlossen durchgewinkt.
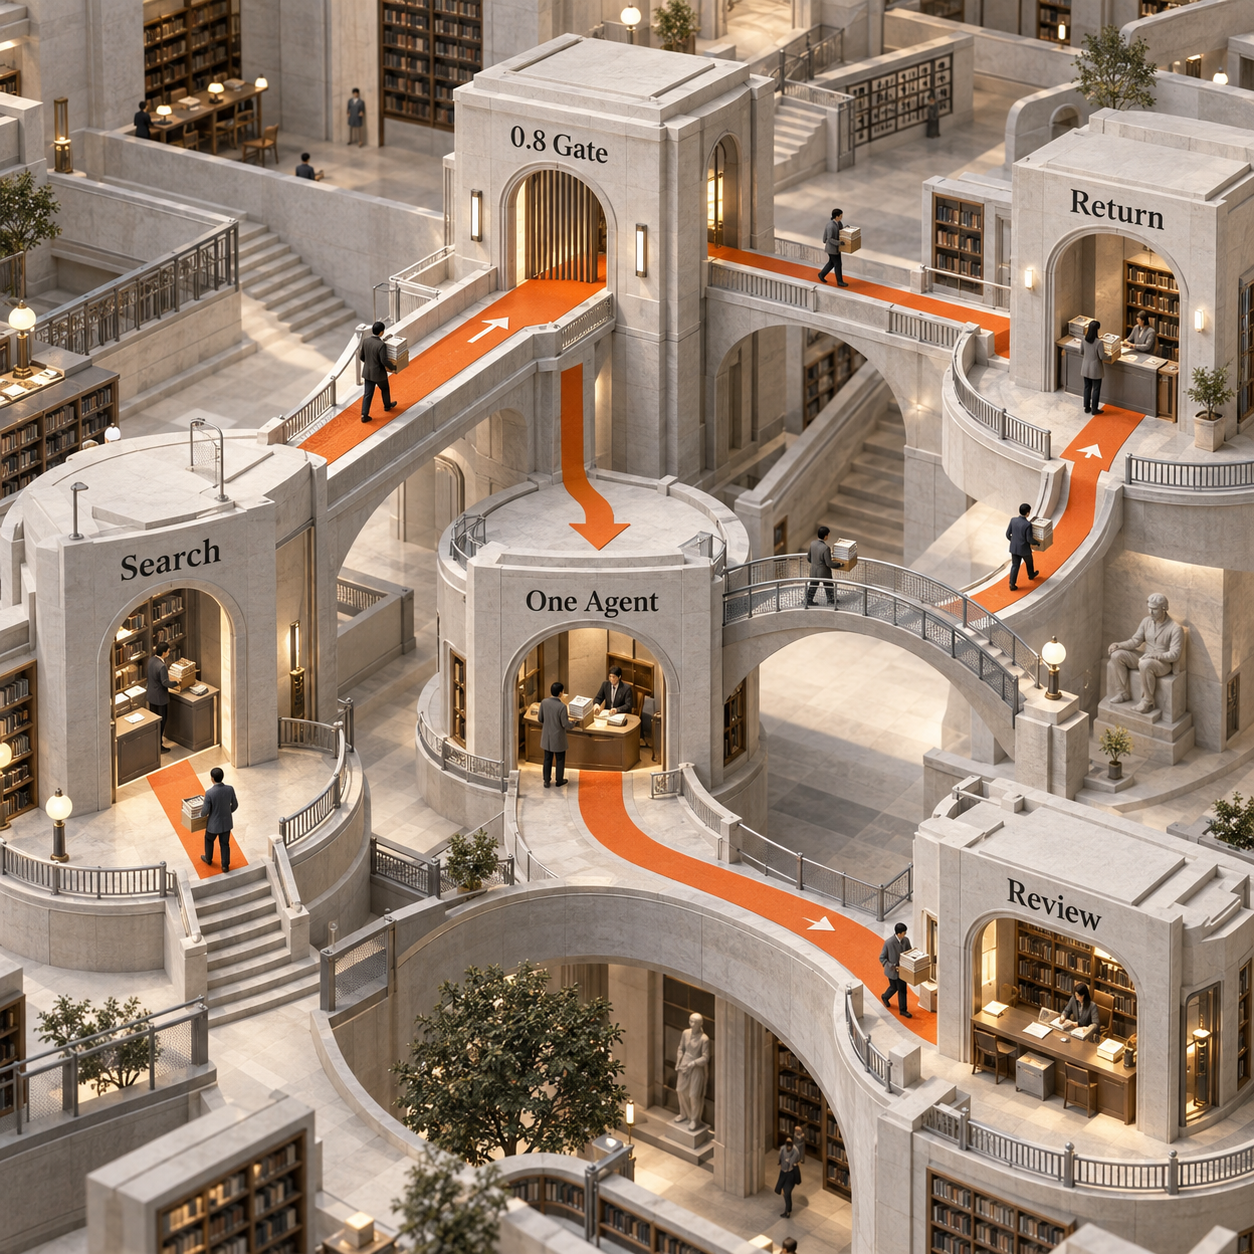
Das ist der stärkste Grund für den Einsatz der Runtime. Eine allgemeine Agentenschleife kann erneut suchen, nochmals überarbeiten oder ein weiteres Tool aufrufen, weil die Unterhaltung noch unfertig wirkt. AgentRun schreibt die zulässige Arbeit direkt im Workflow endlich fest. So erhalten Betreiber ein vor der Ausführung prüfbares Aufrufbudget – auch wenn der Host weiterhin Anbieterkosten und Tool-Berechtigungen durchsetzen muss.
Stärke 3: Eskalation ist Code, kein Wunsch im Prompt
AgentRun bildet eine Eskalation als zurückgegebenen Runtime-Zustand samt Begründung ab, nicht als versteckten Satz in einem Agenten-Prompt. Der getestete Workflow akzeptiert eine Antwort nur, wenn die Entscheidung yes lautet, die Antwort ihren Vertrag erfüllt und die Konfidenz 0.8 erreicht. Andernfalls öffnet er eine Warteschlange mit null oder einer Untersuchung, prüft das Ergebnis erneut und eskaliert, wenn dieselbe Schwelle wieder verfehlt wird.
Um zu prüfen, ob die Zahl das Verhalten tatsächlich steuert, wurden beide Vergleiche von 0.8 auf 0.98 angehoben. Die geskriptete Entscheidung der Passwort-Fixture blieb bei yes mit 0.97. Im ursprünglichen Workflow wurde der Fall sofort und ohne Agentenaufruf abgeschlossen. Mit der strengeren Fassung startete eine Untersuchung, dieselbe gültige Antwort kam zurück, erneut folgte yes mit 0.97 – und nach einem Agentenaufruf sowie zwei Entscheidungen eskalierte der Fall.
Diese kleine Änderung leitete den Zweig um, ohne Prompt, Fixture-Antwort oder Adapter anzutasten. Darin liegt der praktische Vorteil einer Konfidenzregel im Code. Ein Team kann die Schwellenänderung wie jede andere Verhaltensänderung prüfen, gelabelte Fälle dagegen laufen lassen und die daraus resultierende Übergabequote vor dem Release nachvollziehen.
Auch die Auslieferung bleibt von der Eskalation getrennt. Die Runtime gibt complete oder escalated zurück. Der Host entscheidet, ob ein Supportticket eröffnet, ein Mensch alarmiert oder nichts unternommen wird. Diese Trennung verhindert, dass sich ein Workflow-Dokument selbst die Berechtigung erteilt, Kundinnen und Kunden zu kontaktieren oder ein Konto zu verändern.
Stärke 4: Die Inspektion hilft, die Integration bleibt Eigenarbeit
Mit AgentRuns Inspektionsfunktion wird der Workflow lesbar, bevor Code läuft. Die Anwendungsarbeit rundherum entfällt dadurch nicht. Beim generierten Triage-Beispiel lieferte agentrun inspect einen Workflow-Digest, die Knoten judge, escalate und code, den erforderlichen Adapter runJudge sowie executableCode: true. validate meldete ok: true. Auch dry-run lieferte ok: true, wies jedoch klar darauf hin, dass der synthetische Eskalationspfad übersprungen wurde.
Dieses Überspringen ist wichtig. Ein grüner Dry Run belegt die Verdrahtung, nicht die Zweigabdeckung. Den Verhaltensnachweis lieferten die vier Support-Fixtures, weil sie Rückgabe, Untersuchung und Prüfung bewusst auslösten. In CI sollte diese Trennung erhalten bleiben: Inspektion prüft die Struktur, Validierung die Verträge und feste Fälle das Verhalten.
Für die Integration werden drei zentrale Adapter benötigt. runEffect dispatcht Tools und andere Effekte. runJudge liefert typisierte Entscheidungen, optional über Jev. runNode bindet die Agenten-Runtime an und muss Schema, Tools, Abbruchsignal und sämtliche Review-Callbacks weiterreichen. Zuständig bleibt der Host außerdem für Authentifizierung, Secrets, Modellwahl, Zuggrenzen, Budgets, Logs, Schwärzung, Auslieferung und dauerhafte Belege.
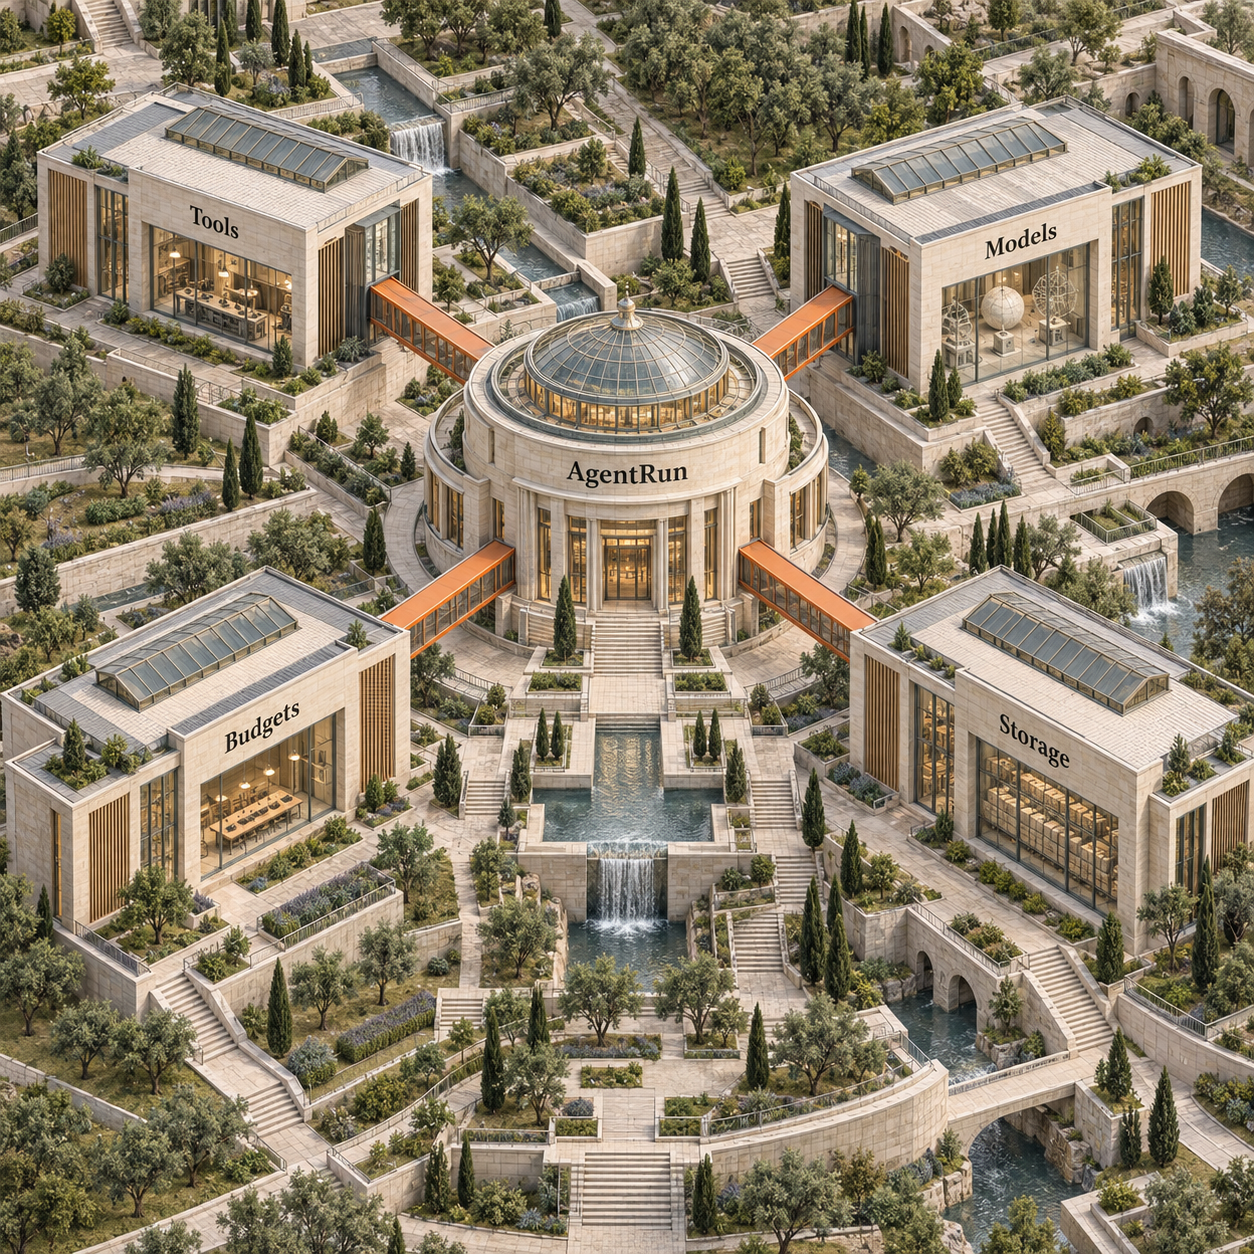
Die schlichte Kontrollfunktion macht den Kompromiss deutlich. Ihr 31 Zeilen langer Funktionskörper nutzte dieselben geskripteten Adapter und erreichte bei jedem Basisfall denselben Status und dieselbe Aufrufzahl. Für eine einzelne Supportroute ist diese Funktion leichter zu lesen und auszuliefern. Die zusätzlichen 62 Zeilen der AgentRun-Workflow-Datei erkaufen ein wiederverwendbares Dokument, generische Inspektion, gemeinsame Knotensemantik, Ausgabeverträge, strukturierte Eskalation und eine Oberfläche, die ein Authoring-Agent erzeugen kann. Weniger Code gibt es nicht automatisch.
Interpreter und Dokument festschreiben
Die Paketversion gehört neben den Workflow-Digest. Ein Dokument mit
v: 2identifiziert weder Interpreter noch Adapter, Tools oder Host-Regeln, die es ausgeführt haben.Jeden Endpfad nachweisen
Feste Fälle für sofortigen Abschluss, den teuren Zweig, die Eskalation und ungültige Ausgaben anlegen. Übersprungene Pfade im Dry Run sind noch abzudeckende Arbeit, kein bestandener Test.
Host-Grenzen anbinden
Tools, Entscheidungen, Agentenaufrufe, Abbruch, Schwärzung und Auslieferung im Anwendungscode implementieren. Berechtigungen und Akzeptanzregeln bleiben außerhalb des Workflow-Dokuments.
Erst nach dem zweiten Workflow einführen
Die Abstraktion zahlt sich aus, wenn Adapter, Inspektion und Regressionsmuster wiederverwendet werden. Für einen stabilen Einzelpfad bleibt es bei der Funktion.
Dieselbe Grenze prägt die umfassendere Build-or-buy-Entscheidung für interne Agenten-Workflows: Gemeinsame Infrastruktur lohnt sich, wenn der wiederkehrende Betriebsaufwand die Pflegekosten übersteigt.
AgentRun-Beta: Der Interpreter ist kostenlos, die Runtime nicht
AgentRun beta hat genau einen Softwarepreis: $0 für den Apache-2.0-Code. In beta.4 gibt es weder einen kostenpflichtigen AgentRun-Tarif noch eine gehostete AgentRun-Runtime. Das npm-Paket, der Quellcode, die CLI, der Workflow-Interpreter und die Beispiele bilden das Produkt. Modell-Tokens, Tool-Ausführung, Speicher, Observability oder Produktionssupport bündelt Parcha nicht in diese Lizenz.
Jev verursacht als separates, optionales Entscheidungsmodell eigene Kosten. Am 24. September 2026 wurde auf der Live-Modellseite von TypeSafe verifiziert: Jev 1.13 kostet $0.042 je Million Input-Tokens, Output-Tokens sind kostenlos. Unter der angegebenen Annahme von 500 Input-Tokens pro Entscheidung kostet eine Prüfung $0.000021, zwei Prüfungen kosten $0.000042. Über 100,000 Fälle summieren sich diese Entscheidungsaufrufe auf $2.10 beziehungsweise $4.20.
Nicht enthalten ist die Agentenuntersuchung. AgentRun kann sich mit jeder vom Host bereitgestellten Agenten-Runtime verbinden, deshalb gibt es keinen seriösen universellen Preis pro Fall. Ein Supportfall, der nach einer Jev-Prüfung endet, hat ein anderes Kostenprofil als ein Fall mit Agent, Tools, zweiter Prüfung, Speicher, Logs und menschlichem Review. Im geskripteten Test gab es keine Live-Modellaufrufe. Die beobachteten Inferenzkosten betrugen damit $0 – und die Aussagekraft zu Produktionskosten ebenfalls null.
Temporal zeigt, warum dauerhaftes Hosting ein eigener Einkauf ist. Temporal Cloud beginnt derzeit bei $50 pro Million Actions, hinzu kommen Speicherkosten; für 90 Tage gibt es $150 Guthaben. AgentRun erhebt keine solche Plattformgebühr, weil es keine vergleichbare gehostete Ausführungsschicht bereitstellt.
Die tatsächlichen Grenzen von AgentRun
Die Einschränkungen von AgentRun wiegen schwer genug, dass die Beta zunächst nur in einem klar begrenzten Workflow eingesetzt werden sollte – nicht als Standardarchitektur.
1. Die Release-Artefakte widersprechen sich bei der eigenen Version
Das veröffentlichte Paketmanifest weist das installierte Paket als 0.1.0-beta.4 aus, doch das mitgelieferte README nennt Beta: 0.1.0-beta.3. Auch das Root-README des beta.4-Tags bezeichnet den Release als beta.3, während das Changelog beta.4 als unveröffentlicht aufführt. Im aktuellen main ist das Root-README auf beta.4 korrigiert. Wer jedoch den veröffentlichten Tag festschreibt, sieht widersprüchliche Statusangaben.
Der Interpreter funktioniert deshalb nicht schlechter. Für ein Workflow-System, in dem Versionsherkunft zählt, ist der Widerspruch dennoch relevant. Die npm-Version festschreiben, den Workflow-Digest speichern sowie Adapter- und Regelversionen getrennt erfassen. Ein Text-Badge reicht nicht, um einen Produktionslauf zu rekonstruieren.
2. Die Host-Arbeit ist die Produktgrenze
AgentRun liefert Kontrollfluss, kein fertiges Supportsystem. Nötig bleiben authentifizierte Tools, ein Agentenadapter, bei Bedarf Jev-Zugriff, Secrets, Budgetdurchsetzung, Abbruchlogik, private Diagnosedaten, Regeln für Kundendaten, Auslieferung, Monitoring und die Behandlung menschlicher Prüfungen. Die 30.48 Sekunden für die Source-Einrichtung sagen über diesen Integrationsaufwand nichts aus.
3. Recovery-Hooks sind keine dauerhafte Ausführung
Die Runtime stellt Schnittstellen für Checkpoints, Memos, Belege und Wiederherstellung bereit; Speicher und Abgleich implementiert jedoch der Host. Ein Idempotenzschlüssel hilft beim Deduplizieren, garantiert aber keine Exactly-once-Auslieferung. Ein externer Effekt kann trotz Timeout noch erfolgreich enden. Vor einem erneuten Versuch muss der Host daher dessen späteren Ausgang prüfen. Ist Crash-Recovery die Hauptanforderung, ist Temporal die richtige Wahl. Stehen persistente, zustandsbehaftete Agentengraphen im Mittelpunkt, sollte LangGraph.js geprüft werden.
4. Vertrauenswürdiges JavaScript ist eine harte Sicherheitsgrenze
Code-Knoten führen JavaScript mit Prozessrechten aus; auch die Validierung kann Probes ausführen. Das CLI-Flag --trusted ist ein Hinweis darauf, keine Sandbox. Wer Workflows von Nutzern, generierte Artefakte oder Inhalte aus einer anderen Vertrauensdomäne annimmt, muss sie mit hostseitig kontrollierten Prozess-, Dateisystem-, Netzwerk- und Zugangsdaten-Grenzen isolieren.
5. Typisierte Ergebnisse können trotzdem selbstbewusst falsch sein
Der Schematest scheiterte genau richtig, kann aber keine wohlgeformte falsche Antwort erkennen. Auch eine yes-Entscheidung mit hoher Konfidenz bleibt ein Modellergebnis. Der Workflow braucht gelabelte Fälle, aufgabenspezifische Schwellen, Produktionsmonitoring und einen Prüfpfad. Die 31 bestandenen Supporttests validieren die bereitgestellten Szenarien, nicht die Genauigkeit von Jev im Live-Betrieb.
6. Plattform- und Supportoptionen sind begrenzt
beta.4 ist eine Node.js-ESM-Bibliothek mit Node 22.19 als Untergrenze sowie TypeScript 5.4 als Untergrenze für TypeScript-Nutzer. Python, Browserausführung und eine gehostete Runtime liegen außerhalb des Umfangs. Für die Beta gibt es kein Produktionssupport-SLA; API- oder Ausführungsänderungen können zwischen Beta-Releases eine Migration erforderlich machen.
7. Erstaunlich oft bleibt eine feste Funktion die bessere Abstraktion
Die Kontrollfunktion mit 31 Zeilen ist kein konstruiertes Gegenbeispiel. Sie entsprach dem Workflow in allen vier geskripteten Fällen. Besteht die Aufgabe aus einer Suche, einer Bedingung, einem optionalen Agentenaufruf und einer Übergabe unter Verantwortung eines Teams, bietet eine Funktion mehr Lokalität und weniger Konzepte. AgentRun lohnt sich, wenn der Workflow selbst unabhängig von der umgebenden Anwendung inspiziert, generiert, versioniert, zusammengesetzt oder evaluiert werden soll.
Zur betrieblichen Einführung gehört ein Plan für Fehlerbelege. Der Leitfaden zu Tools für die Fehleranalyse von KI-Agenten behandelt die Logs und Traces, die nötig werden, sobald der Happy-Path-Graph nicht mehr ausreicht.
Fazit: Wann sich AgentRun für KI-Workflow-Automatisierung lohnt
AgentRun ist eine glaubwürdige Beta, um den wiederholbaren Mittelteil einer Agentenaufgabe in explizite Software zu überführen. Der Interpreter ließ sich einfach installieren, der Supportgraph folgte jedem begrenzten Zweig, der Ausgabevertrag brach sicher ab und die Schwelle verhielt sich wie Code. Das Projekt benennt ungewöhnlich klar, was außerhalb der Bibliothek bleibt.
Das Urteil bleibt an Bedingungen geknüpft. AgentRun ist nur dann die richtige Wahl, wenn alle vier Aussagen zutreffen: Der Workflow wiederholt sich; mindestens ein Modell- oder Agentenzweig braucht eine sichtbare Begrenzung; mehr als eine Person oder ein System muss den Workflow inspizieren oder generieren; und der Host kann Adapter, Berechtigungen, Wiederherstellung, Evaluation und Auslieferung übernehmen. Trifft auch nur eine Bedingung nicht zu, ist eine TypeScript-Funktion der bessere Startpunkt.
LangGraph.js passt, wenn das Produkt im Kern ein persistenter Agentengraph ist. Temporal passt, wenn der Workflow im Kern ein dauerhafter verteilter Prozess ist. AgentRun liegt zwischen diesen Lösungen und einer Funktion: schmaler als beide Runtimes, aber strukturierter als handgeschriebener Kontrollcode.
Der nächste Schritt am Montag ist konkret: Einen vorhandenen Agentenablauf nehmen und jeden Schritt als deterministischen Code, typisierte Entscheidung, Agentenuntersuchung oder menschliche Prüfung markieren. Ergibt das Diagramm eine feste Linie, bleibt es bei der Funktion. Enthält es eine wiederkehrende Verzweigung, deren Agentenkosten oder Eskalationsregeln geprüft werden müssen, genau diesen Pfad in AgentRun abbilden, beta.4 festschreiben und vier Fixtures erstellen, bevor Live-Modelle angebunden werden.
AgentRun FAQ
Lohnt sich AgentRun?
AgentRun lohnt sich, wenn ein wiederkehrender Workflow inspizierbare Verzweigungen, schemageprüfte Grenzen, begrenzte Agentenaufrufe und einen expliziten Prüfzustand braucht. Für einen festen Ablauf, den eine kleine Funktion klar ausdrückt, lohnt sich die zusätzliche Abstraktion nicht.
Wie gut ist AgentRun?
AgentRun beta.4 führte den geskripteten Supportgraphen in diesem Test sauber aus: Alle vier Ergebnisse stimmten, der ungeklärte Pfad endete mit Code 2 und alle 31 fokussierten Supporttests bestanden. Das belegt das Verhalten des Interpreters, nicht die Genauigkeit eines Live-Modells, Verfügbarkeit oder Einsparungen im Produktionsbetrieb.
Was sind die besten Alternativen zu AgentRun?
Plain TypeScript eignet sich für einen kurzen, festen Workflow, LangGraph.js für langlebige zustandsbehaftete Agentengraphen mit Persistenz und Temporal für dauerhafte Anwendungsworkflows, die sich nach Infrastrukturfehlern fortsetzen müssen. Entscheidend ist, ob Codeklarheit, Agentenzustand oder betriebliche Dauerhaftigkeit das eigentliche Problem ist.
Wie verwaltet AgentRun den Zustand während der Verarbeitung?
AgentRun hält strukturierte Zustände im Workflow, validiert deklarierte Verträge, kopiert Verzweigungs- und Map-Zustände und erkennt kollidierende parallele Schreibvorgänge. Dauerhafte Checkpoints, Speicher, Aufbewahrung, Zugriffskontrolle und Wiederherstellung bleiben Aufgaben des Hosts. Das Workflow-Dokument ist daher weder Datenbank noch Verwahrungsschicht.
- Zuletzt aktualisiert
- 24. Sept. 2026
- Kategorie
- Build
Diese Seite in Google bevorzugen


Markieren Sie omidsaffari.com als bevorzugte Quelle, und Google hebt die Seite für Sie in Top Stories, AI Overviews und AI Mode hervor.

Perplexity Suchmaschine: Fast Search oder Web?
Perplexity Suchmaschine im Vergleich: Fast Search oder Web? Preise, Tempo, Quellenabdeckung und die passende API-Einstellung für KI-Agenten.24. Sept. 2026Build
KI-Agenten-Kosten: Wie Fallbacks das Budget leeren
Ein blockierter Datei-Upload machte den bezahlten Fallback zum Standard. So liefen KI-Agenten-Kosten aus dem Ruder, obwohl Jobs weiter „done“ meldeten.24. Sept. 2026Build
Cursor Rollouts kostenlos? Was Zugang und Nutzung kosten
Ist Cursor Rollouts kostenlos? Nur Teams und Enterprise erhalten Zugang. Was die 10-Tage-Credits abdecken und welche Kosten danach offenbleiben.24. Sept. 2026Build
KI Agenten mit Unreal Agent ausführen: Praxisleitfaden
So lassen sich KI Agenten mit Unreal Agent testen: Runner einrichten, Repository absichern, JSONL-Spuren auswerten und Kosten belastbar vergleichen.24. Sept. 2026Build
JetBrains Air einrichten: Sicher mit Coding-Agenten starten
JetBrains Air installieren, Coding-Agenten sicher verbinden und Änderungen im IDE-Diff prüfen: So gelingt der erste kleine, testbare Workflow.23. Sept. 2026Build
JetBrains Air: Was kostenlos ist – und wer die Nutzung bezahlt
JetBrains Air kostet als Plugin $0. Welche Kosten für IDE, Agenten, API und JetBrains AI trotzdem entstehen und welcher Zugang sich wirklich lohnt.23. Sept. 2026Build
Firecrawl Docker selbst hosten: Setup, Belege und echte Kosten
Firecrawl mit Docker selbst hosten: versioniertes Setup, belastbare Scrape-Prüfung und ein 30-Tage-Kostenvergleich mit Firecrawl Cloud im Detail.22. Sept. 2026Build