AgentRun レビュー:beta.4を実測、導入価値と限界を検証
AgentRun レビューとしてbeta.4をサポート業務で実測。分岐制御、型付き状態、エスカレーション、料金、LangGraph.jsやTemporalとの違いを検証し、31行のTypeScript関数より導入価値が出る条件、ホスト側に残る実装負担、採用前に確認すべき制約まで具体的なテスト結果から解説します。

- AAgentRun
- Lllama.cpp

このAgentRun レビューで見えてきたのは、分岐を可視化し、スキーマで状態を検証し、エージェント呼び出しに明確な上限を設けたい反復業務にこそAgentRunが向いているということです。0.1.0-beta.4は、単純な2件のサポートケースをエージェント呼び出しなしで完了し、調査が必要な2件ではそれぞれ1回だけエージェントを呼び出しました。未解決のケースは終了コード2でエスカレーションしています。ただし、シンプルさでは固定の31行関数に軍配が上がりました。
AgentRun レビュー:実際には何ができるのか
AgentRunはParchaが開発したTypeScript製のワークフローインタープリターです。ツール、用途を絞ったモデル判断、エージェント呼び出しを、決定論的な構造の中で実行できます。Parchaは2026年9月23日にオープンソース化しました。ワークフロードキュメントには、状態の契約、ステップ、分岐、上限、エスカレーション経路を記述します。一方、ツール、モデルへのアクセス、権限、ストレージ、配信はアプリケーション側で用意します。Alibaba Cloudの同名製品でも、モデルが生成したコードを実行する従来のPythonパッケージでも、検索結果に今も出てくる2014年のモバイルゲームでもありません。現行のコアパッケージは、Apache-2.0で公開されている@parcha/agentrun-dslバージョン0.1.0-beta.4です。
Parcha AgentRunが向くチーム、見送るべきチーム
AgentRunが向くのは、すでにエージェントランタイムを持ち、通常のコードでは見通しが悪くなった反復業務を特定できるTypeScriptチームです。たとえばサポートのトリアージなら、まず検索し、回答が十分かを判断し、調査が必要な場合だけエージェントを1回呼び出し、最後に回答するか担当者へ引き継ぎます。エビデンスのスクリーニング、承認ルーティング、リサーチパイプラインも同じ構造です。プロダクト、オペレーション、リスクの責任者が、コールバックの連鎖をたどらずに制御フローを確認したい場合に最も価値が出ます。
処理が固定された1つの関数で、分岐が2つか3つしかないならAgentRunは不要です。このレビューで比較用に使った実装は、31行の関数本体だけで4件すべてのサポート結果を再現しました。一方、AgentRunのサンプルワークフローファイルは、ホスト統合前の段階で93行あります。純粋な短さでは関数が優位です。
長時間動作し、永続化、ストリーミング、人による中断が中心要件となるステートフルなエージェントなら、代わりにLangGraph.jsを選ぶべきです。クラッシュ、ネットワーク障害、長い待機時間をまたぐアプリケーション実行が絶対条件ならTemporalが適しています。AgentRunには復旧用のフックがありますが、耐久性のあるスケジューラーが同梱されているわけではありません。Python、ブラウザ実行、ホスト型ダッシュボード、本番向けサポートSLAが必要なチームにとっても、それらを備えていないbeta.4は適切な選択ではありません。
AgentRun DSLの機能1:型付き状態で契約のずれを検出
AgentRun DSLの第一の利点は、宣言した契約に一致しなくなった最終値を受け入れないことです。基本的に見える仕組みですが、検索結果、意味に基づく判断、エージェントの提出結果を1つのワークフローで扱うと重要性が増します。最終バリデーターがなければ、どこかの分岐で形状が変わっただけで、不完全な成功結果が呼び出し元へ届きかねません。
サポート用ワークフローでは、制約の緩いCandidateと最終的なAnswerを分けています。検索結果は、調査へ進む条件として空のテキストや情報源なしを許容します。完了条件はより厳格で、最終回答には空でないテキストと1件以上の情報源が必要です。オーサリングガイドでは、宣言した入力・出力契約も検証し、実行中には中間状態のパスをチェックします。
契約のテストでは、フィクスチャの出力を変えずに必須フィールドを1つ追加しました。
schemaWorkflow.schemas.Answer.properties.resolutionCode = {
  type: 'string',
  minLength: 1,
};
schemaWorkflow.schemas.Answer.required.push('resolutionCode');パスワードの経路では、従来どおりヘルプ検索と最初の判断が実行されました。しかし、完了時にはresolutionCodeがないため、コードoutput_invalidのWorkflowOutputInvalidErrorで失敗しました。不正な回答は返されていません。これは望ましい失敗の仕方です。意味上もっともらしいオブジェクトを契約上の完成品として扱わず、システム境界で停止できています。
ただし、この保護には明確な限界があります。有効なtext文字列とsources配列でも、回答内容が間違っている可能性は残ります。スキーマ検証で保証できるのは、下流のコードがその値を処理できることまでであり、顧客が内容を信頼できることではありません。判断レイヤーについては、Jevによるサポートチケットのルーティングのレビューでも扱っています。確率や型付き出力を使っても、ラベル付きケースと人へのフォールバックは必要です。
AgentRun ワークフローの機能2:分岐制御でエージェント呼び出しを制限
AgentRunのワークフロー制御は、4件のサポートケースすべてでグラフどおりに動作しました。2件は検索と1回の判断で終了し、残る2件は上限付きの調査を1回実行してから、2回目の判断へ進みました。重要な単位は自律エージェントではありません。エージェントを呼び出せる場所が1か所に限定された、決定論的な経路です。
各フィクスチャを直接実行したところ、記載どおりの終了結果になりました。パスワード、請求書、支払い失敗はコード0を返しました。未解決の支払いはコード2を返し、1回の調査後も回答が不十分または不確実だったことを理由に示しました。4件ともstderrへの書き込みはゼロバイトです。リポジトリ内のサポート用テストスイートでも、無効な提出、信頼度の低い判断、キャンセル、アダプターエラーを含む31件すべてが2.92秒で成功しました。
この結果が示すのは呼び出し規律であり、カスタマーサポートの品質ではありません。検索回答、Jevの判断、調査結果はいずれも固定フィクスチャです。プロンプトを変えても適応するわけではなく、実際の顧客への返信も送信していません。この検証で確認できたのは、より限定的ながら実用的な点です。最初の回答が基準を満たせばエージェント呼び出しを消費せず、満たさなければ調査をちょうど1回だけ許可し、2回目の確認にも失敗すれば完了扱いで通過させません。
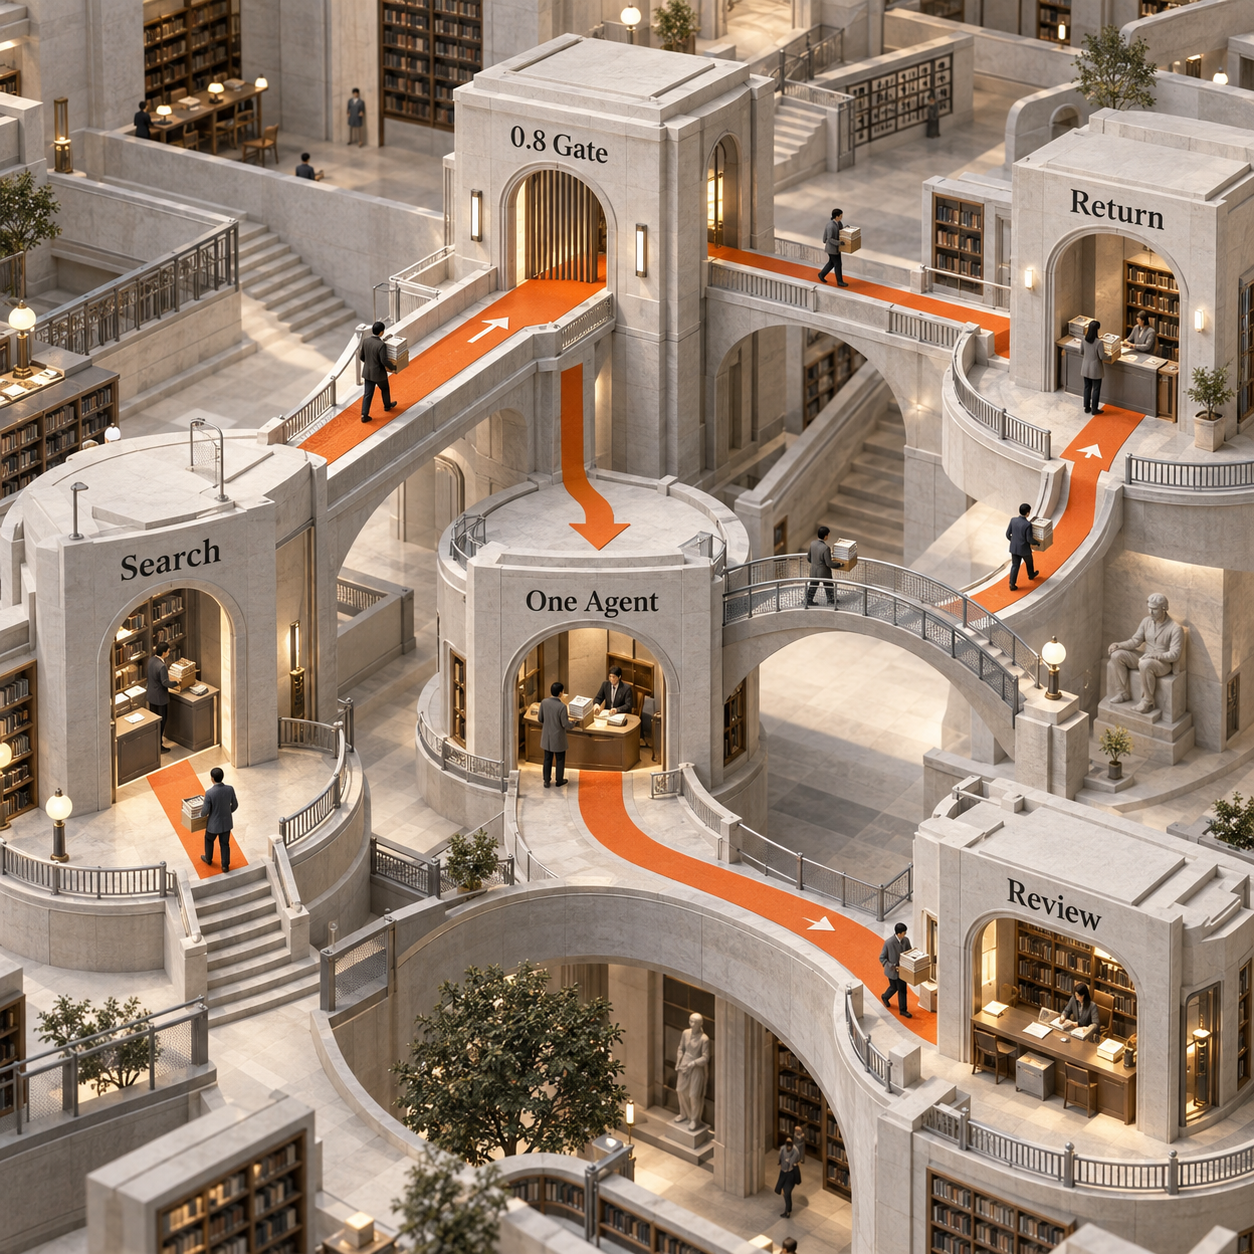
ランタイムを採用する最大の理由がここにあります。汎用的なエージェントループでは、会話がまだ完了していないように見えるという理由で、再検索、再修正、別ツールの呼び出しを選ぶ可能性があります。AgentRunでは、許可する処理の有限範囲をワークフロー自体に定義します。ホスト側でプロバイダー費用とツール権限を強制する必要は残るものの、運用担当者は実行前に呼び出し予算を確認できます。
機能3:エスカレーションをプロンプト任せにせずコード化
AgentRunでは、エスカレーションをエージェントのプロンプト内に埋もれた一文ではなく、理由を伴うランタイム状態として返します。検証したワークフローが回答を受け入れるのは、判断がyesで、回答が契約を満たし、信頼度が0.8以上の場合だけです。それ以外では0回または1回の調査キューを開き、結果を再確認し、同じ基準を満たさなければエスカレーションします。
この数値が本当に挙動を制御するか確かめるため、2か所の比較値を0.8から0.98に引き上げました。パスワード用フィクスチャのスクリプト判断は、yesかつ0.97のままです。元のワークフローでは、エージェントを呼び出さず即座に完了しました。基準を厳しくしたワークフローでは調査へ進み、同じ有効な回答を受け取り、再びyesかつ0.97が返された後、1回のエージェント呼び出しと2回の判断を経てエスカレーションしました。
この小さな編集だけで、プロンプト、フィクスチャの回答、アダプターを一切変えずに分岐が変わりました。信頼度ポリシーをコードに置く実務上の利点です。チームはこのしきい値変更をほかの挙動変更と同じようにレビューし、ラベル付きケースで検証し、リリース前に引き継ぎ率への影響を確認できます。
エスカレーションは配信処理からも切り離されています。ランタイムが返すのはcompleteまたはescalatedであり、サポートチケットを作成するか、担当者へ通知するか、何もしないかはホストが決めます。この分離により、ワークフロードキュメントが顧客への連絡やアカウント変更の権限を自ら得ることを防げます。
機能4:インスペクションは有用、統合は引き続き自前
AgentRunのインスペクションを使えば、コードを実行する前にワークフローを読み解けます。ただし、周辺のアプリケーション実装まで不要になるわけではありません。生成したトリアージ例に対してagentrun inspectを実行すると、ワークフローダイジェスト、judge、escalate、codeの各ノード、必須のrunJudgeアダプター、executableCode: trueが返されました。validateの結果はok: trueでした。dry-runもok: trueを返しましたが、合成されたエスカレーション経路をスキップしたことも明記しています。
重要なのは、このスキップです。dry runが成功しても、配線を確認できたにすぎず、分岐を網羅した証拠にはなりません。4件のサポートフィクスチャでは、回答、調査、レビューを意図的に通したため、挙動を実証できました。CIでもこの違いを保つ必要があります。インスペクションは構造、バリデーションは契約、固定ケースは挙動を確認します。
統合には主に3つのアダプターが必要です。runEffectはツールなどのエフェクトをディスパッチします。runJudgeは型付き判断を提供し、必要に応じてJevを利用します。runNodeはエージェントランタイムを接続し、スキーマ、ツール、キャンセルシグナル、レビュー用コールバックを確実に転送しなければなりません。認証、シークレット、モデル選定、ターン上限、予算、ログ、秘匿化、配信、永続化された実行記録もホスト側の責任です。
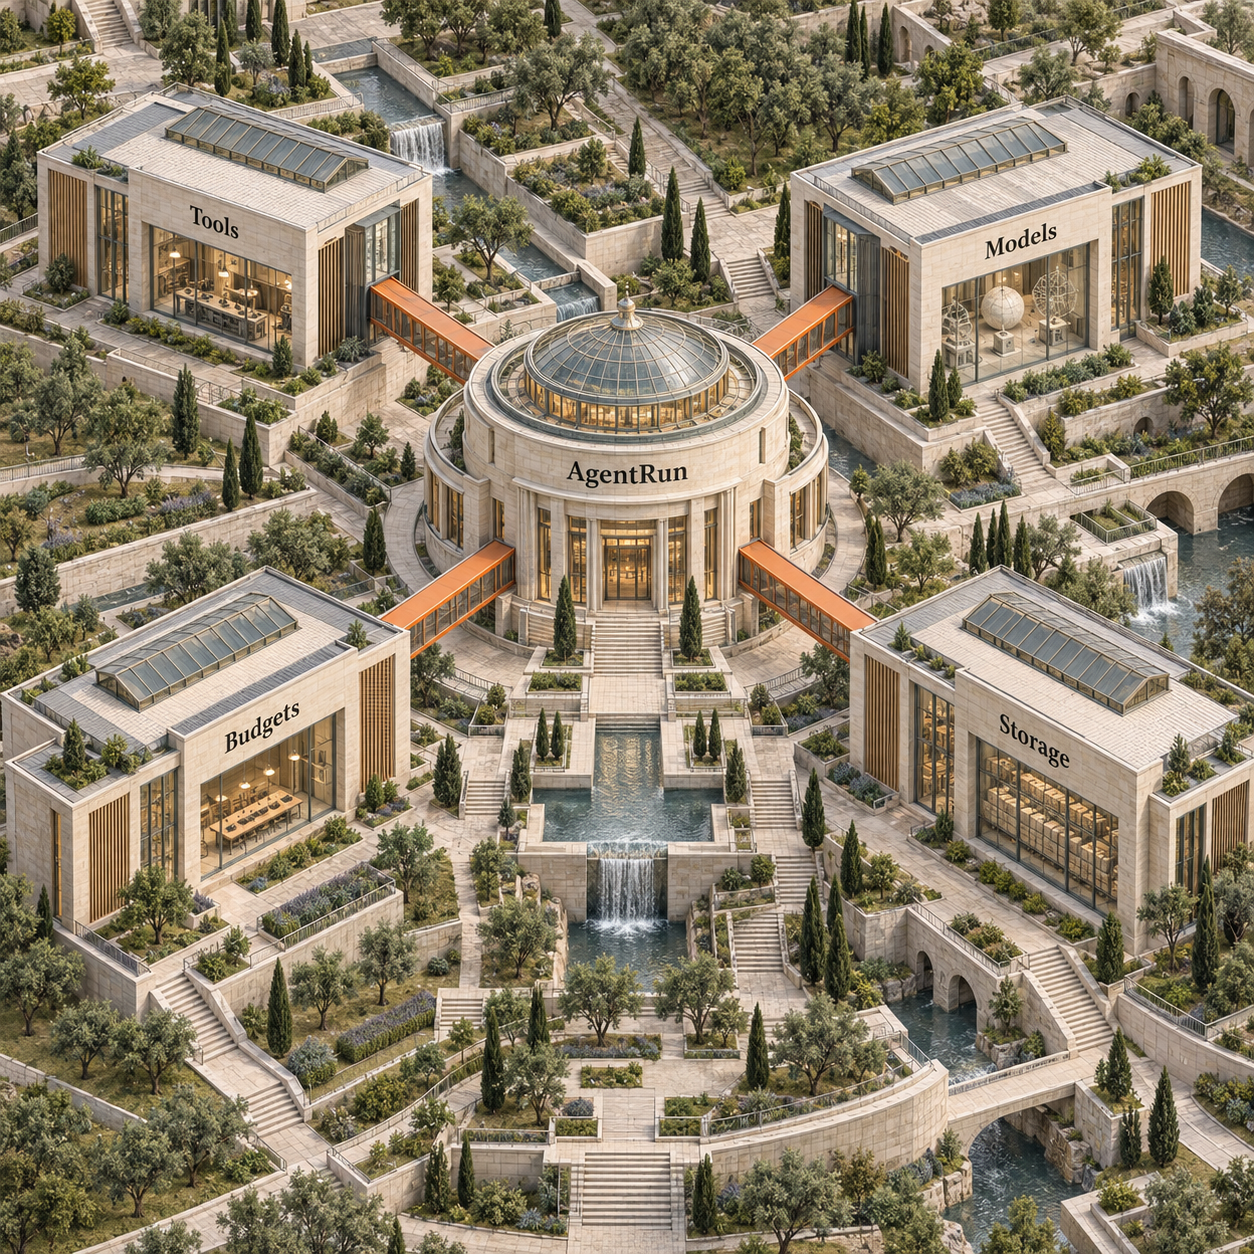
素の関数と比べると、トレードオフがさらに明確になります。31行の関数本体は同じスクリプト済みアダプターを使い、すべての基準ケースでステータスと呼び出し回数を一致させました。1つのサポート経路だけなら、その関数のほうが読みやすく、リリースもしやすいでしょう。AgentRunで増える62行のワークフローファイルによって得られるのは、再利用可能なドキュメント、汎用的なインスペクション、共通のノードセマンティクス、出力契約、構造化されたエスカレーション、オーサリングエージェントが生成できる共通形式です。標準でコード量が減るわけではありません。
インタープリターとドキュメントを固定する
パッケージのバージョンをワークフローダイジェストと並べて保存します。
v: 2のドキュメントだけでは、それを実行したインタープリター、アダプター、ツール、ホストポリシーを特定できません。すべての終端経路を実証する
即時完了、コストの高い分岐、エスカレーション、不正な出力について固定ケースを作ります。dry-runでスキップされた経路は、合格ではなく、追加で網羅すべき作業として扱います。
ホスト側の境界を接続する
ツール、判断、エージェント呼び出し、キャンセル、秘匿化、配信をアプリケーションコードで実装します。権限と受け入れ基準はワークフロードキュメントの外に置きます。
2本目のワークフローから採用する
アダプター、インスペクション、回帰テストのパターンを再利用すると、抽象化の投資を回収し始めます。安定した経路が1つだけなら、関数のままにします。
これは、より広い意味での社内エージェントワークフローにおける内製か購入かの判断にも通じる境界です。反復する運用作業の負担が、共通基盤の保守コストを上回るときに採用すべきです。
AgentRun betaの料金:インタープリターは無料、実行環境は別
AgentRun betaのソフトウェア価格は、Apache-2.0のコードに対する$0だけです。有料のAgentRunプランも、beta.4のホスト型AgentRunランタイムもありません。製品として提供されるのはnpmパッケージ、ソース、CLI、ワークフローインタープリター、サンプルです。モデルのトークン、ツール実行、ストレージ、オブザーバビリティ、本番サポートはParchaのライセンスに含まれません。
Jevは別料金の任意の判断モデルです。2026年9月24日にTypeSafeの公開モデルページで確認したところ、Jev 1.13の料金は入力100万トークンあたり$0.042で、出力トークンは無料です。判断1回あたり入力500トークンという前提では、1回の確認が$0.000021、2回なら$0.000042です。100,000件では、判断呼び出しの合計はそれぞれ$2.10または$4.20になります。
この計算にはエージェント調査を含めていません。AgentRunはホストが用意した任意のエージェントランタイムに接続できるため、ケースごとの費用を一律に示すことはできません。Jevの確認1回で終了するサポートケースと、エージェント、ツール、2回目の確認、ストレージ、ログ、人によるレビューまで使うケースでは、コスト構造が異なります。このレビューではスクリプト済みの応答を使い、実際のモデル呼び出しを行っていないため、観測した推論費用は$0であり、本番コストを示すエビデンスも同じくゼロです。
耐久性のあるホスティングが別の購入対象になる理由は、Temporalとの比較で分かります。Temporal Cloudの現行料金は100万アクションあたり$50からで、別途ストレージ料金がかかり、90日間に$150のクレジットが付きます。AgentRunに同種のプラットフォーム料金がないのは、比較可能なホスト型実行レイヤーを提供していないためです。
AgentRunの実質的な制約
AgentRunの制約は軽視できません。betaを標準アーキテクチャに据えるのではなく、範囲を限定した1つのワークフローから導入すべきです。
1. リリース成果物でバージョン表記が一致しない
公開されたパッケージマニフェストでは、インストール済みパッケージを0.1.0-beta.4と記載しています。しかし、同梱のREADMEにはBeta: 0.1.0-beta.3と書かれています。beta.4タグのルートREADMEもbeta.3と呼び、changelogではbeta.4を未リリース扱いにしています。現在のmainではルートREADMEがbeta.4に修正されていますが、公開済みタグを固定する購入者には矛盾したステータス表記が見えます。
インタープリターが壊れる問題ではありませんが、バージョンの来歴が重要なワークフローシステムでは無視できません。npmバージョンを固定し、ワークフローダイジェストを保存し、アダプターとポリシーのバージョンも別途記録してください。本番実行を再現するとき、説明文のバッジだけを頼りにしてはいけません。
2. ホスト側の負担が製品の境界になる
AgentRunが提供するのは制御フローであり、完成したサポートシステムではありません。認証済みツール、エージェントアダプター、必要に応じたJevへのアクセス、シークレット、予算の強制、キャンセル、非公開の診断情報、顧客データのポリシー、配信、監視、人によるレビューの処理は、すべて別途必要です。ソースのセットアップにかかった30.48秒から、こうした統合作業の工数は分かりません。
3. 復旧フックは耐久性のある実行ではない
ランタイムはcheckpoint、memo、receipt、recoveryのインターフェースを公開していますが、ストレージと照合処理を実装するのはホストです。冪等性キーは重複排除に役立ちますが、exactly-onceの配信を保証しません。タイムアウトした外部エフェクトが後から完了する可能性もあるため、再試行前に最終的な処理結果をホスト側で確認する必要があります。クラッシュからの復旧が第一の要件ならTemporalを、ステートフルなエージェントグラフの永続化が第一ならLangGraph.jsを評価してください。
4. 信頼済みJavaScriptが厳格なセキュリティ境界になる
コードノードはプロセス権限でJavaScriptを実行し、バリデーションでもプローブが実行される場合があります。CLIの--trustedフラグは、その事実を認識させるものであり、サンドボックスではありません。ユーザー、生成物、別の信頼ドメインからワークフローを受け入れるチームは、ホスト側でプロセス、ファイルシステム、ネットワーク、認証情報の境界を設けて隔離しなければなりません。
5. 型付きの結果でも確信を持って間違える
スキーマテストは期待どおりに失敗しましたが、形式上正しい誤答は検出できません。信頼度の高いyesもモデルの出力にすぎません。ワークフローにはラベル付きケース、タスク固有のしきい値、本番監視、レビュー経路が必要です。成功した31件のサポートテストが検証するのは用意されたシナリオであり、実環境におけるJevの精度ではありません。
6. 対応プラットフォームとサポートの選択肢が限られる
beta.4はNode.js ESMライブラリです。Nodeは22.19以上、TypeScript利用者はTypeScript 5.4以上が必要です。Python、ブラウザ実行、ホスト型ランタイムは対象外です。betaには本番サポートSLAがなく、betaリリース間でAPIや実行方法が変われば移行作業が必要になる可能性があります。
7. 固定関数が最適な抽象化である場面は意外に多い
31行の比較用関数は、単なるおもちゃの例ではありません。スクリプト化した4件すべてでワークフローと同じ結果を出しました。検索が1回、条件が1つ、任意のエージェント呼び出しが1回、1チームが担う引き継ぎが1つだけなら、関数のほうが局所性に優れ、理解すべき概念も少なくなります。AgentRunが妥当になるのは、ワークフロー自体を周辺アプリケーションから独立してインスペクション、生成、バージョン管理、合成、評価する必要がある場合です。
運用導入では、このレビューとあわせて失敗時のエビデンス計画も用意してください。AIエージェントの障害分析ツールガイドでは、正常系のグラフだけでは足りなくなった後に必要なログとトレースを解説しています。
結論:AgentRunを選ぶべき条件
AgentRunは、エージェント業務のうち繰り返し可能な中間部分を明示的なソフトウェアへ変える、信頼できるbeta版です。インタープリターは容易にインストールでき、サポートグラフは上限付きの各分岐を正確にたどり、出力契約は安全側に倒れて失敗し、しきい値はコードとして機能しました。ライブラリ外に残る責任も、プロジェクト側が非常に率直に示しています。
ただし、結論には条件が付きます。次の4点をすべて満たす場合に限り、AgentRunを選ぶべきです。 ワークフローを繰り返し実行すること。少なくとも1つのモデルまたはエージェント分岐に目で確認できる上限が必要なこと。複数の人またはシステムがワークフローを確認または生成すること。そして、ホスト側でアダプター、権限、復旧、評価、配信を担えることです。1つでも満たさないなら、まずTypeScriptの関数から始めてください。
製品の本質が永続的なエージェントグラフならLangGraph.js、耐久性のある分散プロセスならTemporalを使います。AgentRunの位置付けは、その2つと関数の中間です。どちらのランタイムより対象は狭いものの、手書きの制御コードより構造化されています。
週明けに取り組むべき作業は明確です。既存のエージェント業務を1つ選び、各ステップを決定論的コード、型付き判断、エージェント調査、人によるレビューに分類します。図が1本の固定線になるなら関数のままにします。繰り返し現れる分岐があり、エージェント費用やエスカレーションポリシーのレビューが必要なら、その経路1つだけをAgentRunで記述し、beta.4に固定し、実際のモデルへ接続する前に4件のフィクスチャを作ってください。
AgentRun FAQ
AgentRunを導入する価値はありますか?
反復ワークフローに、確認可能な分岐、スキーマ検証済みの境界、上限付きのエージェント呼び出し、明示的なレビュー状態が必要なら、AgentRunには導入価値があります。小さな関数で明快に表現できる固定処理が1つだけなら、抽象化を増やす価値はありません。
AgentRunの完成度はどの程度ですか?
今回のレビューでは、AgentRun beta.4がスクリプト化されたサポートグラフを問題なく実行しました。4件すべてが想定どおりの結果となり、未解決経路はコード2で終了し、対象を絞った31件のサポートテストもすべて成功しました。ただし、この結果が示すのはインタープリターの挙動であり、実環境でのモデル精度、稼働率、本番運用時の削減効果ではありません。
AgentRunの代替として何を選べばよいですか?
小さな固定ワークフローには素のTypeScript、永続化が必要な長時間動作のステートフルなエージェントグラフにはLangGraph.js、基盤障害後も再開すべき耐久性のあるアプリケーションワークフローにはTemporalが適しています。コードの明快さ、エージェントの状態、運用上の耐久性のどれが課題かによって、最適な代替は変わります。
AgentRunは処理中の状態をどのように管理しますか?
AgentRunはワークフロー内で構造化された状態を保持し、宣言済みの契約を検証し、分岐とmapの状態をコピーし、並列書き込みの競合を検出します。耐久性のあるcheckpoint、ストレージ、保持期間、アクセス制御、復旧はホスト側の責任です。そのため、ワークフロードキュメントはデータベースでも保管レイヤーでもありません。
- 最終更新
- 2026年9月24日
- カテゴリー
- Build
Googleでこのサイトを優先する


omidsaffari.comを優先ソースに設定すると、GoogleがTop Stories・AI Overviews・AI Modeであなたのために優先表示します。

Perplexity APIのFast Searchと標準webを比較:料金・速度・検索品質
Perplexity APIのFast Searchと標準webを、料金、レイテンシ、検索品質、情報源の網羅性で比較。10,000回の検索費用は$10対$50です。反復的な検索にはfast、曖昧で網羅性が重要な調査にはwebを使い分ける判断基準と、本番導入前に確認すべき検証手順を実務目線で解説します。2026年9月24日Build
AIエージェント コストの盲点:有料フォールバックが既定経路になった日
AIエージェント コストの盲点を、実際の公開障害から読み解きます。画像ファイルの受け渡しが止まり、有料フォールバックが既定経路となり、共有残高は$8.30から$0へ。カバーや埋め込みが欠けてもジョブはdoneのままでした。サンドボックス境界、認証情報の所有、完了条件、従量課金の監視をどう設計し直すべきかを解説します。2026年9月24日Build
Cursor 料金を検証:Rolloutsは無料で使えるのか
Cursor Rolloutsは無料ではなく、Teamsは1ユーザー月額$40、Enterpriseは個別見積もりです。10日間のローンチクレジットでTeamsは約50件、Enterpriseは約500件の変更を試せますが、その後の単価は未公表。料金の仕組みと導入判断を整理します。2026年9月24日Build
AIエージェント基盤「Unreal Agent」を実務で評価する方法
AIエージェント実行基盤「Unreal Agent」をコマンドラインで安全に試す手順を解説します。リリース、モデル、推論レベルを固定し、JSONL、実行時間、終了ステータス、トークン使用量、差分を記録して、既存エージェントとの品質・コスト比較や、ランナーとGoライブラリの選び分けまで判断できる実践ガイドです。2026年9月24日Build
JetBrains Airの使い方:Alphaプラグイン導入・設定・レビュー手順
JetBrains Airの使い方を、Air Alphaの導入からエージェント接続、@file:でのコンテキスト指定、差分レビュー、テスト、元に戻す判断まで実践的に解説します。Standard Accessで小さな修正から安全に始める手順に加え、料金、互換性、具体的な活用例も分かりやすくまとめました。2026年9月23日Build
JetBrains Airは無料?料金の仕組みと支払元を徹底整理
JetBrains AirのAir Alphaプラグインは無料ですが、IDE本体や接続するAIエージェント、API利用料まで無料とは限りません。Junie Lite、既存アカウント、APIキー、JetBrains AIという4つの認証経路ごとに、誰が料金を負担するのかを公開情報と具体的な料金比較で整理します。2026年9月23日Build
Firecrawl APIをセルフホストする方法:Docker導入と料金比較
Firecrawl APIをセルフホストする手順を、v2.11.162への固定、実スクレイプと再起動後の検証、証跡保存まで詳しく解説します。さらにFirecrawl Cloudとの機能差と30日間の費用を比較し、セルフホストを選ぶべき条件、運用負荷、導入前に確認すべきセキュリティと本番要件を整理します。2026年9月22日Build