AgentRun : test d’un framework agent IA TypeScript
AgentRun encadre les workflows d’agents IA en TypeScript. Test des branches, schémas, escalades, coûts et limites face à LangGraph.js et Temporal.

- AAgentRun
- Lllama.cpp

AgentRun est un framework agent IA qui trouve sa place lorsqu’une tâche récurrente exige des embranchements visibles, un état validé par schéma et une limite stricte sur les appels à l’agent. Lors de ce test, 0.1.0-beta.4 a traité les deux cas simples de support sans appel à l’agent, utilisé un seul appel pour chacun des deux cas nécessitant une investigation, puis transmis le cas non résolu avec le code de sortie 2. Une fonction figée de 31 lignes reste toutefois plus simple.
AgentRun : que fait exactement ce framework agent IA ?
AgentRun est l’interpréteur de workflows TypeScript de Parcha. Il apporte une structure déterministe autour des outils, des décisions ciblées prises par un modèle et des appels à un agent. Parcha l’a publié en open source le 23 septembre 2026. Le document de workflow définit les contrats d’état, les étapes, les embranchements, les limites et le chemin d’escalade ; l’application fournit les outils, l’accès aux modèles, les permissions, le stockage et la livraison. Il ne faut pas le confondre avec le produit homonyme d’Alibaba Cloud, l’ancien package Python qui exécute du code généré par un modèle, ni le jeu mobile de 2014 encore présent dans les résultats de recherche. Le package principal actuel est @parcha/agentrun-dsl version 0.1.0-beta.4, sous licence Apache-2.0.
À qui s’adresse ce workflow agent IA, et qui devrait s’en passer ?
AgentRun vise les équipes TypeScript qui disposent déjà d’un runtime d’agent et peuvent désigner une tâche récurrente devenue difficile à inspecter dans du code classique. Le triage du support s’y prête bien : lancer d’abord une recherche, juger si la réponse suffit, ne dépenser un appel à l’agent que si une investigation s’impose, puis répondre ou transmettre le dossier à une personne. Le filtrage de preuves, les circuits d’approbation et les pipelines de recherche suivent la même logique. L’intérêt est maximal lorsqu’un responsable produit, opérations ou risques doit comprendre le flux de contrôle sans remonter un enchevêtrement de callbacks.
Mieux vaut ignorer AgentRun si le travail tient dans une fonction fixe avec deux ou trois embranchements évidents. L’implémentation témoin de ce test a reproduit les quatre résultats du support dans une fonction de 31 lignes, alors que le fichier de workflow AgentRun en compte 93 avant même l’intégration à l’hôte. Sur le seul critère de la concision, la fonction l’emporte.
Choisissez plutôt LangGraph.js si le véritable enjeu est un agent persistant, avec état, streaming et interruption humaine. Préférez Temporal lorsque l’exigence non négociable est la continuité de l’application malgré les crashs, les pannes réseau et les longues attentes. AgentRun expose des hooks de reprise, mais ne fournit pas de planificateur durable intégré. Si l’équipe a besoin de Python, d’une exécution dans le navigateur, d’un tableau de bord hébergé ou d’un SLA de support en production, beta.4 constitue également un mauvais choix : cette version n’inclut rien de tout cela.
Capacité 1 du DSL AgentRun : un état typé détecte les ruptures de contrat
Le DSL AgentRun marque un premier point en refusant toute valeur finale qui ne respecte plus le contrat déclaré. Cela peut sembler élémentaire, jusqu’à ce qu’un workflow combine un résultat de recherche, une décision sémantique et la soumission d’un agent. Sans validation finale commune, une modification de structure sur n’importe quelle branche peut remonter à l’appelant sous la forme d’un succès incomplet.
Le workflow de support distingue un Candidate permissif de l’Answer final. La recherche peut produire un texte vide ou aucune source, puisque cette situation est précisément autorisée à déclencher une investigation. La fin du workflow est plus stricte : la réponse finale doit contenir un texte non vide et au moins une source. Le guide de création valide aussi les contrats d’entrée et de sortie déclarés, tandis que les chemins de l’état intermédiaire sont contrôlés pendant l’exécution.
Le test de contrat a ajouté un champ obligatoire sans modifier la sortie du fixture :
schemaWorkflow.schemas.Answer.properties.resolutionCode = {
  type: 'string',
  minLength: 1,
};
schemaWorkflow.schemas.Answer.required.push('resolutionCode');
Le parcours de réinitialisation du mot de passe a tout de même effectué sa recherche d’aide et sa première décision. La finalisation a ensuite échoué avec WorkflowOutputInvalidError, code output_invalid, car resolutionCode était absent. Aucune réponse invalide n’a été renvoyée. C’est le bon mode d’échec : le système s’arrête à sa frontière au lieu de considérer un objet sémantiquement plausible comme un résultat conforme au contrat.
Cette protection possède une limite précise. Une chaîne text valide et un tableau sources valide peuvent toujours contenir une mauvaise réponse. La validation du schéma prouve que le système en aval saura consommer la valeur, pas qu’un client peut s’y fier. L’analyse complémentaire du routage des tickets de support avec Jev couvre cette couche de décision : même des probabilités et des sorties typées exigent des cas labellisés et une solution de repli humaine.
Capacité 2 du workflow AgentRun : borner les appels à l’agent
Le contrôle du workflow AgentRun a suivi exactement le graphe prévu sur quatre cas de support : deux requêtes se sont arrêtées après la recherche et une décision, tandis que les deux autres ont déclenché une investigation bornée puis une seconde décision. L’unité utile n’est donc pas un agent autonome, mais un chemin déterministe qui ne comporte qu’un seul point d’appel possible à l’agent.
Chaque fixture lancé directement a renvoyé le code documenté. Les cas du mot de passe, de la facture et du paiement échoué ont produit le code 0. Le paiement non résolu a renvoyé le code 2, avec pour motif que la réponse restait insuffisante ou incertaine après une investigation. Les quatre cas ont écrit zéro octet dans stderr. La suite de tests ciblée du dépôt pour le support a elle aussi réussi ses 31 tests en 2.92 secondes, y compris les soumissions invalides, les décisions à faible confiance, les annulations et les erreurs d’adaptateur.
Ces résultats démontrent la maîtrise des appels, pas la qualité du support client. Les réponses de recherche, les décisions de Jev et les sorties d’investigation provenaient de fixtures fixes. Modifier un prompt ne les rend pas adaptatives, et aucune réponse n’est envoyée à un vrai client. La preuve apportée par l’exécution est plus étroite, mais utile : si la première réponse est acceptée, l’interpréteur ne dépense aucun appel à l’agent ; si elle échoue, il autorise exactement une investigation ; si le second contrôle échoue, le dossier ne peut pas passer pour terminé.
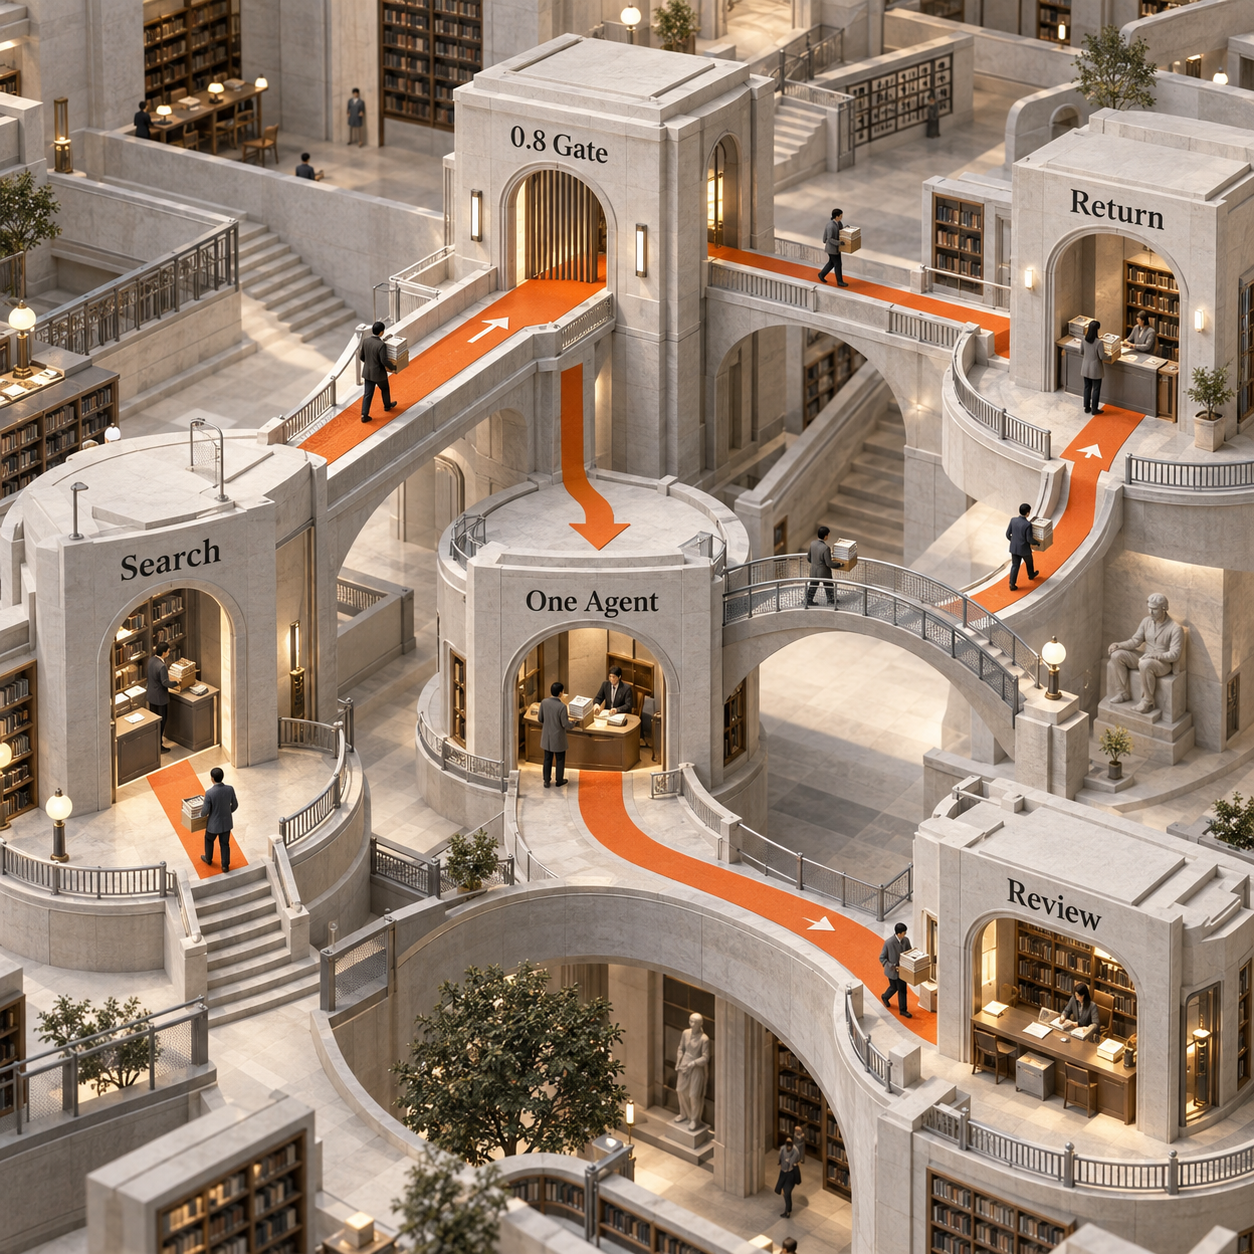
C’est la principale raison d’adopter ce runtime. Une boucle d’agent générique peut décider de relancer une recherche, de réviser encore sa réponse ou d’appeler un autre outil parce que la conversation semble inachevée. AgentRun inscrit directement dans le workflow un volume de travail fini. L’opérateur dispose ainsi d’un budget d’appels qu’il peut inspecter avant l’exécution, même si l’hôte doit toujours faire respecter les dépenses fournisseur et les permissions des outils.
Capacité 3 : l’escalade relève du code, pas d’un vœu dans le prompt
Avec AgentRun, l’escalade devient un état renvoyé par le runtime avec un motif, et non une phrase enfouie dans le prompt de l’agent. Le workflow testé n’accepte une réponse que si la décision vaut yes, si la réponse respecte son contrat et si le niveau de confiance atteint 0.8. Sinon, il ouvre une file autorisant zéro ou une investigation, contrôle de nouveau le résultat, puis transmet le dossier si le même seuil échoue encore.
Pour vérifier que la valeur pilotait réellement le comportement, les deux comparaisons sont passées de 0.8 à 0.98. La décision scriptée du fixture de mot de passe est restée yes à 0.97. Avec le workflow d’origine, ce cas se terminait immédiatement, sans appel à l’agent. Avec le workflow plus strict, il passait par l’investigation, recevait la même réponse valide, produisait un nouveau yes à 0.97, puis était transmis après un appel à l’agent et deux décisions.
Cette petite modification change la branche sans toucher au prompt, à la réponse du fixture ni à l’adaptateur. C’est tout l’intérêt de conserver la politique de confiance dans le code. Une équipe peut examiner le changement de seuil comme n’importe quelle évolution fonctionnelle, le tester sur des cas labellisés et observer le taux de transmission obtenu avant la mise en production.
L’escalade reste également distincte de la livraison. Le runtime renvoie complete ou escalated ; l’hôte décide ensuite d’ouvrir un ticket de support, d’alerter une personne ou de ne rien faire. Cette séparation empêche un document de workflow de s’accorder lui-même le droit de contacter un client ou de modifier un compte.
Capacité 4 : une inspection utile, mais une intégration à votre charge
L’inspection d’AgentRun rend le workflow lisible avant l’exécution du code, sans supprimer le travail d’intégration autour de celui-ci. Sur l’exemple de triage généré, agentrun inspect a renvoyé un digest du workflow, les nœuds judge, escalate et code, l’adaptateur runJudge requis, ainsi que executableCode: true. validate a répondu ok: true. dry-run a lui aussi renvoyé ok: true, tout en signalant clairement que le chemin d’escalade synthétique avait été ignoré.
Ce saut est important. Un dry run au vert prouve le câblage, pas la couverture des branches. Les quatre fixtures du support ont apporté la preuve comportementale, puisqu’ils ont volontairement exercé la réponse, l’investigation et la revue. Conservez cette distinction dans la CI : l’inspection contrôle la structure, la validation vérifie les contrats et les cas fixes testent le comportement.
L’intégration réclame trois adaptateurs principaux. runEffect distribue les outils et les autres effets. runJudge fournit des décisions typées, éventuellement via Jev. runNode relie le runtime d’agent et doit transmettre le schéma, les outils, le signal d’annulation et tout callback de revue. L’hôte demeure aussi responsable de l’authentification, des secrets, du choix des modèles, des limites de tours, des budgets, des logs, du masquage des données sensibles, de la livraison et des reçus durables.
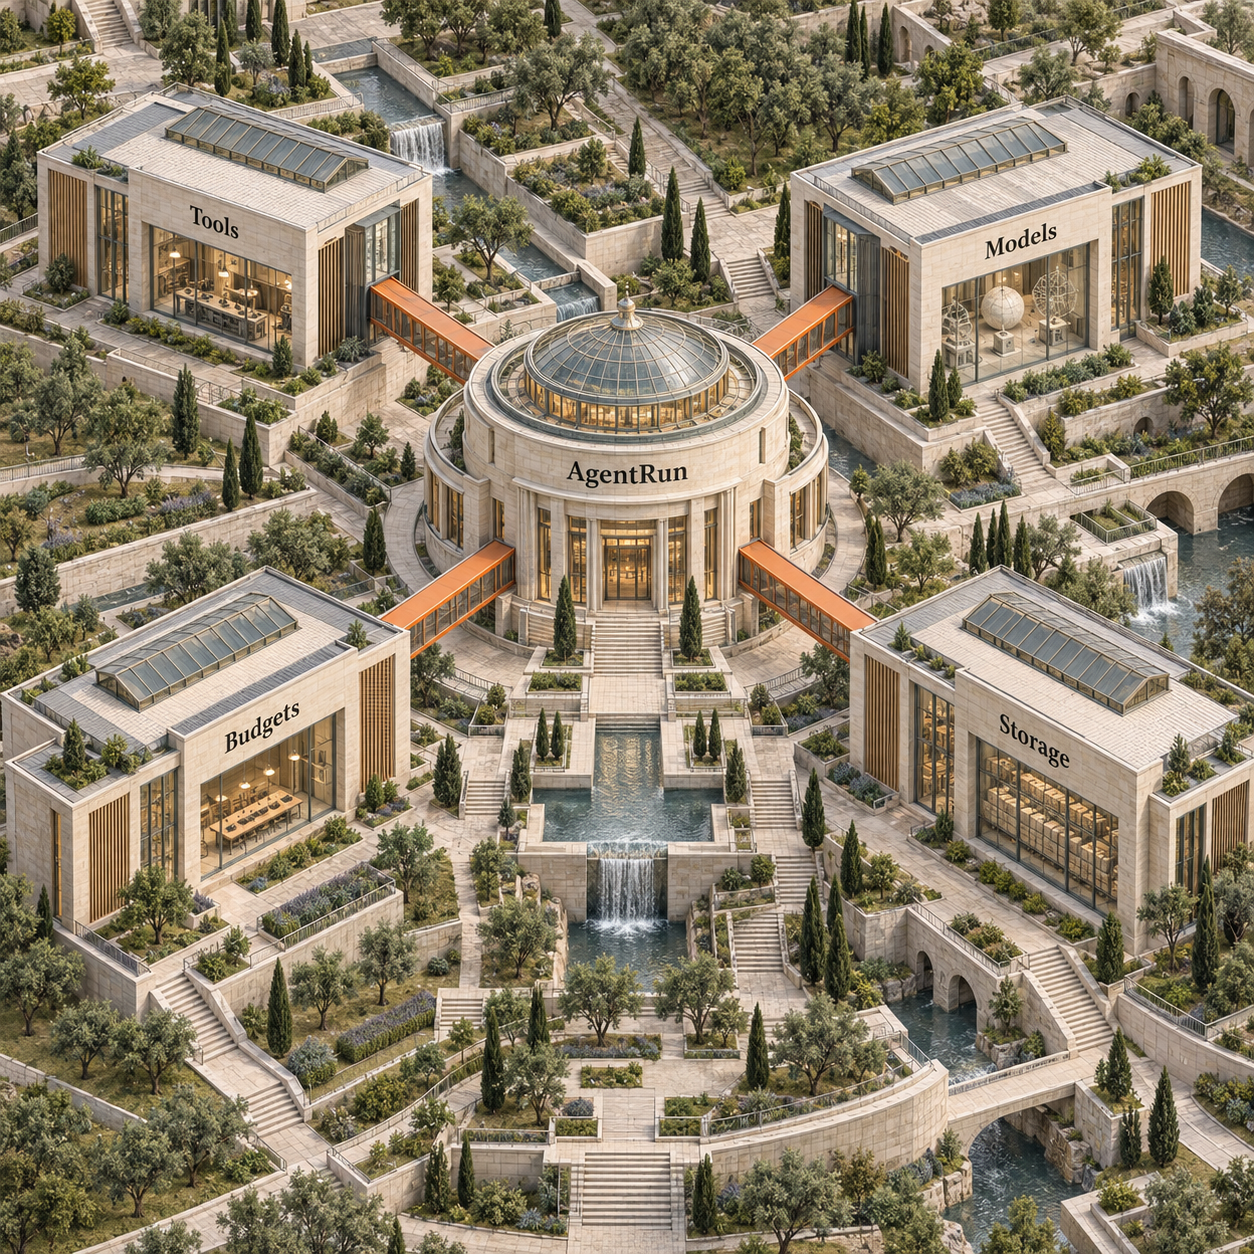
La fonction témoin clarifie le compromis. Son corps de 31 lignes s’appuyait sur les mêmes adaptateurs scriptés et reproduisait chaque statut ainsi que chaque nombre d’appels de référence. Pour un seul parcours de support, cette fonction est plus facile à lire et à livrer. Les 62 lignes supplémentaires du fichier de workflow AgentRun achètent un document réutilisable, une inspection générique, une sémantique partagée pour les nœuds, des contrats de sortie, une escalade structurée et un support qu’un agent auteur peut générer. Elles ne réduisent pas le code par défaut.
Épinglez l’interpréteur et le document
Stockez la version du package avec le digest du workflow. Un document
v: 2n’identifie ni l’interpréteur, ni les adaptateurs, ni les outils, ni les politiques de l’hôte qui l’ont exécuté.Prouvez chaque chemin terminal
Créez des cas fixes pour la fin immédiate, la branche coûteuse, l’escalade et la sortie invalide. Considérez les chemins ignorés par le dry run comme des scénarios restant à couvrir, pas comme une réussite.
Raccordez les frontières de l’hôte
Implémentez les outils, les décisions, les appels à l’agent, l’annulation, la rédaction et la livraison dans le code de l’application. Conservez les permissions et les règles d’acceptation hors du document de workflow.
N’adoptez la couche qu’au deuxième workflow
L’abstraction commence à être rentable lorsque les adaptateurs, l’inspection et les modèles de régression sont réutilisés. Pour un seul chemin stable, gardez la fonction.
C’est la même frontière que dans la réflexion plus large sur le choix entre développer ou acheter des agents de code pour les workflows internes : adoptez une mécanique commune lorsque le travail opérationnel récurrent dépasse son coût de maintenance.
Prix d’AgentRun beta : l’interpréteur est gratuit, pas le runtime
AgentRun beta ne possède qu’un prix logiciel : $0 pour le code sous licence Apache-2.0. Il n’existe ni offre AgentRun payante ni runtime AgentRun hébergé dans beta.4. Le package npm, le code source, le CLI, l’interpréteur de workflow et les exemples constituent le produit. Parcha n’intègre à cette licence ni les tokens des modèles, ni l’exécution des outils, ni le stockage, ni l’observabilité, ni le support en production.
Jev représente un coût distinct et facultatif pour le modèle de décision. D’après la page des modèles de TypeSafe, vérifiée en direct le 24 septembre 2026, Jev 1.13 coûte $0.042 par million de tokens en entrée, tandis que les tokens de sortie sont gratuits. En retenant l’hypothèse annoncée de 500 tokens d’entrée par décision, un contrôle coûte $0.000021 et deux contrôles $0.000042. Sur 100,000 cas, ces appels de décision reviendraient respectivement à $2.10 ou $4.20.
Ce calcul exclut l’investigation menée par l’agent. AgentRun peut se connecter au runtime d’agent fourni par l’hôte ; il n’existe donc aucun coût universel honnête par dossier. Un cas de support qui s’arrête après un contrôle Jev n’a pas le même profil de coût qu’un cas faisant intervenir un agent, des outils, un second contrôle, du stockage, des logs et une revue humaine. Le test scripté n’a effectué aucun appel réel à un modèle : ses dépenses d’inférence observées s’élèvent donc à $0, tout comme les éléments qu’il apporte sur les coûts de production.
Temporal illustre pourquoi l’hébergement durable constitue un achat séparé. Temporal Cloud démarre actuellement à $50 par million d’actions, hors stockage, avec $150 de crédits pendant 90 jours. AgentRun ne facture pas ces frais de plateforme parce qu’il ne fournit pas de couche d’exécution hébergée comparable.
Les vraies limites d’AgentRun
Les limites d’AgentRun sont suffisamment importantes pour que la beta commence par un seul workflow borné, au lieu de devenir l’architecture par défaut.
1. Les artefacts de la version ne s’accordent pas sur leur propre numéro
Le manifeste du package publié identifie le package installé comme 0.1.0-beta.4, mais son README intégré annonce Beta: 0.1.0-beta.3. Le README à la racine du tag beta.4 présente lui aussi la version comme beta.3, tandis que le changelog décrit beta.4 comme non publiée. Le README racine de main corrige désormais le numéro en beta.4, mais un acheteur qui épingle le tag publié se retrouve face à des indications contradictoires.
Cela ne casse pas l’interpréteur, mais reste significatif dans un système de workflow où la provenance des versions compte. Épinglez la version npm, stockez le digest du workflow et consignez séparément les versions des adaptateurs et des politiques. Ne comptez pas sur un badge rédigé en prose pour reconstituer une exécution en production.
2. La charge de l’hôte définit la frontière du produit
AgentRun fournit le flux de contrôle, pas un système de support prêt à l’emploi. Il faut encore gérer des outils authentifiés, un adaptateur d’agent, l’accès à Jev s’il est utilisé, les secrets, l’application des budgets, l’annulation, les diagnostics privés, la politique sur les données client, la livraison, le monitoring et la revue humaine. Les 30.48 secondes d’installation depuis le code source ne disent rien de cet effort d’intégration.
3. Des hooks de reprise ne valent pas une exécution durable
Le runtime expose des interfaces de checkpoint, de mémo, de reçu et de reprise, mais le stockage et la réconciliation relèvent de l’hôte. Une clé d’idempotence aide à dédupliquer ; elle ne garantit pas une livraison exactement une fois. Un effet externe arrivé à expiration peut tout de même se terminer, et l’hôte doit vérifier son état final avant de réessayer. Si la reprise après crash est la priorité, utilisez Temporal. Si les graphes d’agents persistants avec état dominent, évaluez LangGraph.js.
4. Le JavaScript de confiance constitue une frontière de sécurité stricte
Les nœuds de code exécutent du JavaScript avec les privilèges du processus, et la validation peut lancer des sondes. Le flag --trusted du CLI constitue un avertissement, pas une sandbox. Une équipe qui accepte des workflows issus d’utilisateurs, d’artefacts générés ou d’un autre domaine de confiance doit les isoler avec des frontières contrôlées par l’hôte pour les processus, le système de fichiers, le réseau et les identifiants.
5. Un résultat typé peut toujours être faux avec assurance
Le test de schéma a échoué exactement comme prévu, mais il ne peut pas détecter une mauvaise réponse bien formée. Une décision yes à forte confiance reste le résultat d’un modèle. Le workflow exige des cas labellisés, des seuils adaptés à la tâche, un monitoring en production et un chemin de revue. Les 31 tests de support réussis valident les scénarios fournis, pas la précision réelle de Jev.
6. Les plateformes et les options de support restent limitées
Beta.4 est une bibliothèque ESM pour Node.js qui exige au minimum Node 22.19, ainsi que TypeScript 5.4 pour les utilisateurs de TypeScript. Python, l’exécution dans un navigateur et un runtime hébergé sont hors périmètre. La beta ne comporte aucun SLA de support en production, et les changements d’API ou d’exécution peuvent imposer une migration entre deux versions beta.
7. Une fonction fixe reste étonnamment souvent la meilleure abstraction
La fonction témoin de 31 lignes n’est pas un contre-exemple artificiel. Elle a reproduit le workflow sur les quatre cas scriptés. Si la tâche comporte une recherche, une condition, un éventuel appel à l’agent et une transmission gérée par une seule équipe, une fonction offre une meilleure localité et moins de concepts. AgentRun se justifie lorsque le workflow lui-même doit pouvoir être inspecté, généré, versionné, composé ou évalué indépendamment de l’application qui l’entoure.
Pour préparer l’adoption opérationnelle, ajoutez à ce test un plan de collecte des preuves d’échec. Le guide des outils d’analyse des échecs d’agents IA détaille les logs et les traces nécessaires lorsque le graphe nominal ne suffit plus.
Verdict : quand ce framework agent IA mérite sa place
AgentRun est une beta crédible pour transformer la partie répétable d’une tâche d’agent en logiciel explicite. Son interpréteur s’installe facilement, son graphe de support a respecté chaque branche bornée, son contrat de sortie a échoué de façon sûre et son seuil s’est comporté comme du code. Le projet expose avec une franchise inhabituelle tout ce qui reste hors de la bibliothèque.
Le verdict demeure conditionnel. Ne choisissez AgentRun que si ces quatre affirmations sont vraies : le workflow se répète ; au moins une branche de modèle ou d’agent doit être visiblement bornée ; plusieurs personnes ou systèmes doivent pouvoir inspecter ou générer le workflow ; et l’hôte peut prendre en charge les adaptateurs, les permissions, la reprise, l’évaluation et la livraison. Si l’une d’elles est fausse, commencez par une fonction TypeScript.
Utilisez LangGraph.js quand le produit est avant tout un graphe d’agent persistant. Choisissez Temporal lorsque le workflow est d’abord un processus distribué durable. AgentRun se place entre ces solutions et une fonction : plus ciblé que l’un ou l’autre runtime, mais plus structuré qu’un flux de contrôle écrit à la main.
La prochaine action est concrète. Prenez une tâche d’agent existante et classez chaque étape comme code déterministe, décision typée, investigation par l’agent ou revue humaine. Si le schéma ne comporte qu’une ligne fixe, gardez la fonction. S’il contient une branche récurrente dont la dépense d’agent ou la politique d’escalade doit être examinée, encodez uniquement ce parcours dans AgentRun, épinglez beta.4 et construisez quatre fixtures avant de connecter de vrais modèles.
FAQ sur AgentRun
AgentRun vaut-il le coup ?
AgentRun vaut le coup lorsqu’un workflow récurrent exige des embranchements inspectables, des frontières validées par schéma, des appels à l’agent bornés et un état de revue explicite. L’abstraction ne se justifie pas pour une séquence fixe qu’une petite fonction exprime clairement.
AgentRun est-il efficace ?
AgentRun beta.4 a exécuté proprement le graphe de support scripté de ce test : les quatre résultats correspondaient aux attentes, le parcours non résolu s’est terminé avec le code 2 et les 31 tests de support ciblés ont réussi. Ces résultats établissent le comportement de l’interpréteur, pas la précision d’un modèle réel, la disponibilité ni les économies en production.
Quelles sont les meilleures alternatives à AgentRun ?
Utilisez du TypeScript classique pour un petit workflow fixe, LangGraph.js pour les graphes d’agents persistants avec état, et Temporal pour les workflows applicatifs durables qui doivent reprendre après une panne d’infrastructure. Le bon choix dépend du problème dominant : lisibilité du code, état de l’agent ou robustesse opérationnelle.
Comment AgentRun gère-t-il l’état ?
AgentRun conserve un état structuré dans le workflow, valide les contrats déclarés, copie l’état des branches et des maps, puis détecte les écritures parallèles conflictuelles. Les checkpoints durables, le stockage, la rétention, le contrôle d’accès et la reprise restent à la charge de l’hôte : le document de workflow n’est ni une base de données ni une couche de conservation.
- Dernière mise à jour
- 24 sept. 2026
- Catégorie
- Build
Préférez ce site dans Google


Marquez omidsaffari.com comme source préférée et Google le met en avant pour vous dans Top Stories, AI Overviews et AI Mode.

Perplexity Search API : Fast Search ou mode web par défaut ?
Fast Search coûte cinq fois moins cher, mais le mode web couvre mieux les requêtes complexes. Voici comment router chaque recherche dans Perplexity Search API.24 sept. 2026Build
Agent IA : le coût caché d’un fallback mal conçu
Un agent IA peut faire exploser les coûts lorsqu’un fallback payant devient le chemin par défaut. Voici les signaux de la panne et le correctif durable.24 sept. 2026Build
Cursor gratuit ? Rollouts reste payant après les crédits
Cursor Rollouts n’est pas gratuit : accès dès Teams à $40 par utilisateur, crédits de 10 jours et tarif d’usage encore non publié. Voici quoi vérifier.24 sept. 2026Build
Unreal Agent : mettre un agent IA open source à l’épreuve
Installez et évaluez Unreal Agent, un agent IA open source en Go, sur une tâche de dépôt ciblée avant de l’intégrer à vos workflows de développement.24 sept. 2026Build
JetBrains Air : prendre en main le plugin Alpha pas à pas
Découvrez comment installer JetBrains Air Alpha, connecter un agent de codage, cibler le bon contexte et valider chaque modification dans votre IDE.23 sept. 2026Build
JetBrains Air à $0 : qui paie vraiment les agents ?
Le plugin JetBrains Air est gratuit, mais chaque agent suit sa propre facturation. Comparez Junie Lite, abonnements, API et crédits JetBrains AI.23 sept. 2026Build
Firecrawl Docker : auto-hébergement, vérification et coûts réels
Déployez Firecrawl avec Docker, validez un vrai scrape et comparez sur 30 jours le coût réel de l’auto-hébergement à celui de Firecrawl Cloud.22 sept. 2026Build