Workflow AI sotto controllo: AgentRun alla prova
AgentRun mette confini espliciti ai workflow AI: la prova di stato tipizzato, chiamate agli agenti, escalation, costi e limiti della beta.4.

- AAgentRun
- Lllama.cpp

AgentRun merita attenzione quando un workflow AI ricorrente richiede diramazioni visibili, uno stato verificato tramite schema e un limite invalicabile alle chiamate degli agenti. In questa recensione, 0.1.0-beta.4 ha risolto i due casi di assistenza più semplici senza chiamare alcun agente, ha usato una chiamata per ciascuno dei due casi di indagine e ha passato a un operatore il caso irrisolto con codice di uscita 2; per semplicità, però, ha prevalso ancora una funzione fissa di 31 righe.
Recensione di AgentRun: che cos’è davvero questo interprete di workflow AI
AgentRun è l’interprete di workflow TypeScript di Parcha: serve a dare una struttura deterministica a strumenti, decisioni circoscritte dei modelli e chiamate agli agenti. Parcha lo ha reso open source il 23 settembre 2026. Un documento di workflow definisce contratti di stato, passaggi, diramazioni, limiti e percorso di escalation; l’applicazione fornisce strumenti, accesso ai modelli, autorizzazioni, archiviazione e consegna. Non va confuso con l’omonimo prodotto di Alibaba Cloud, con il precedente pacchetto Python che esegue codice generato dai modelli o con il gioco mobile del 2014 ancora presente nei risultati di ricerca. Il pacchetto principale attuale è @parcha/agentrun-dsl versione 0.1.0-beta.4, distribuito con licenza Apache-2.0.
A chi serve Parcha AgentRun e chi dovrebbe evitarlo
AgentRun è pensato per un team TypeScript che dispone già di un runtime per agenti e sa indicare almeno un’attività ricorrente in cui il codice ordinario è diventato difficile da ispezionare. Lo smistamento delle richieste di assistenza è un buon esempio: prima si cerca, poi si valuta se la risposta è sufficiente, si spende una sola chiamata a un agente esclusivamente quando serve un’indagine e infine si risponde oppure si affida il caso a una persona. Lo stesso schema ricorre nella selezione delle evidenze, nei flussi di approvazione e nelle pipeline di ricerca. Il vantaggio emerge soprattutto quando chi gestisce prodotto, operazioni o rischio deve poter leggere il flusso di controllo senza inseguire una rete di callback.
Meglio evitare AgentRun quando il lavoro consiste in una funzione fissa con due o tre diramazioni evidenti. L’implementazione di controllo usata per questa recensione ha riprodotto tutti e quattro gli esiti dell’assistenza con un corpo funzione di 31 righe, mentre il file di workflow dell’esempio AgentRun ne conta 93 prima ancora dell’integrazione con l’host. Sul piano della pura concisione vince la funzione.
LangGraph.js è la scelta più adatta quando il problema centrale è un agente stateful e di lunga durata, con persistenza, streaming e intervento umano. Temporal è invece indicato quando il requisito inderogabile è mantenere l’esecuzione dell’applicazione attraverso crash, problemi di rete e lunghe attese. AgentRun espone hook di ripristino, ma non include uno scheduler durevole. Anche chi necessita di Python, esecuzione nel browser, una dashboard gestita o un SLA di assistenza per la produzione dovrebbe escludere beta.4, perché questa versione non offre nessuno di questi elementi.
Funzionalità 1 di AgentRun DSL: lo stato tipizzato intercetta le derive del contratto
AgentRun DSL guadagna il primo punto quando rifiuta un valore finale che non rispetta più il contratto dichiarato. Può sembrare un controllo elementare, finché un workflow non combina un risultato di ricerca, una decisione semantica e l’output di un agente. Senza un validatore finale unico, una modifica della struttura in una qualsiasi diramazione può arrivare al chiamante sotto forma di successo parziale.
Il workflow di assistenza distingue un Candidate permissivo dall’Answer finale. La ricerca può restituire testo vuoto o nessuna fonte, perché proprio questa condizione deve poter avviare un’indagine. Il completamento è più rigoroso: la risposta finale richiede testo non vuoto e almeno una fonte. La guida alla creazione verifica inoltre i contratti di input e output dichiarati, mentre i percorsi dello stato intermedio vengono controllati durante l’esecuzione.
Nel test del contratto è stato aggiunto un campo obbligatorio senza modificare l’output della fixture:
schemaWorkflow.schemas.Answer.properties.resolutionCode = {
  type: 'string',
  minLength: 1,
};
schemaWorkflow.schemas.Answer.required.push('resolutionCode');
Il percorso per il ripristino della password ha comunque eseguito la ricerca nella guida e la prima decisione. Il completamento è poi fallito con WorkflowOutputInvalidError, codice output_invalid, perché mancava resolutionCode. Nessuna risposta non valida è stata restituita. È il comportamento corretto: il sistema si ferma al proprio confine invece di presentare come completo un oggetto soltanto plausibile sul piano semantico.
La protezione ha un limite preciso. Una stringa text valida e un array sources valido possono comunque contenere una risposta sbagliata. La validazione dello schema dimostra che il software a valle può consumare il valore, non che un cliente debba fidarsene. La recensione complementare sullo smistamento dei ticket di assistenza con Jev affronta questo livello decisionale: probabilità e output tipizzati richiedono comunque casi etichettati e un fallback umano.
Funzionalità 2 del workflow AgentRun: il controllo delle diramazioni limita le chiamate agli agenti
Il controllo del workflow AgentRun ha seguito esattamente il grafo previsto nei quattro casi di assistenza: due richieste si sono fermate dopo la ricerca e una decisione, mentre due hanno avviato un’indagine limitata e una seconda decisione. L’unità utile non è un agente autonomo, ma un percorso deterministico con un unico punto autorizzato a chiamare un agente.
Ogni esecuzione diretta delle fixture è terminata come documentato. Password, fattura e pagamento non riuscito hanno restituito il codice 0. Il pagamento irrisolto ha restituito il codice 2, indicando che dopo un’indagine la risposta era ancora insufficiente o incerta. Tutti e quattro i casi hanno scritto zero byte su stderr. Anche la suite mirata del repository per l’assistenza ha superato tutti i 31 test in 2.92 secondi, inclusi invii non validi, decisioni a bassa confidenza, annullamenti ed errori degli adapter.
Questi risultati dimostrano la disciplina delle chiamate, non la qualità dell’assistenza clienti. Le risposte di ricerca, le decisioni di Jev e gli output delle indagini erano fixture fisse. Una modifica al prompt non le rende adattive e non viene inviata alcuna risposta a clienti reali. La prova fornita dall’esecuzione è più circoscritta, ma utile: se la prima risposta supera il controllo, l’interprete non spende una chiamata a un agente; se non lo supera, ne consente esattamente una per l’indagine; se fallisce anche il secondo controllo, il caso non viene fatto passare per completato.
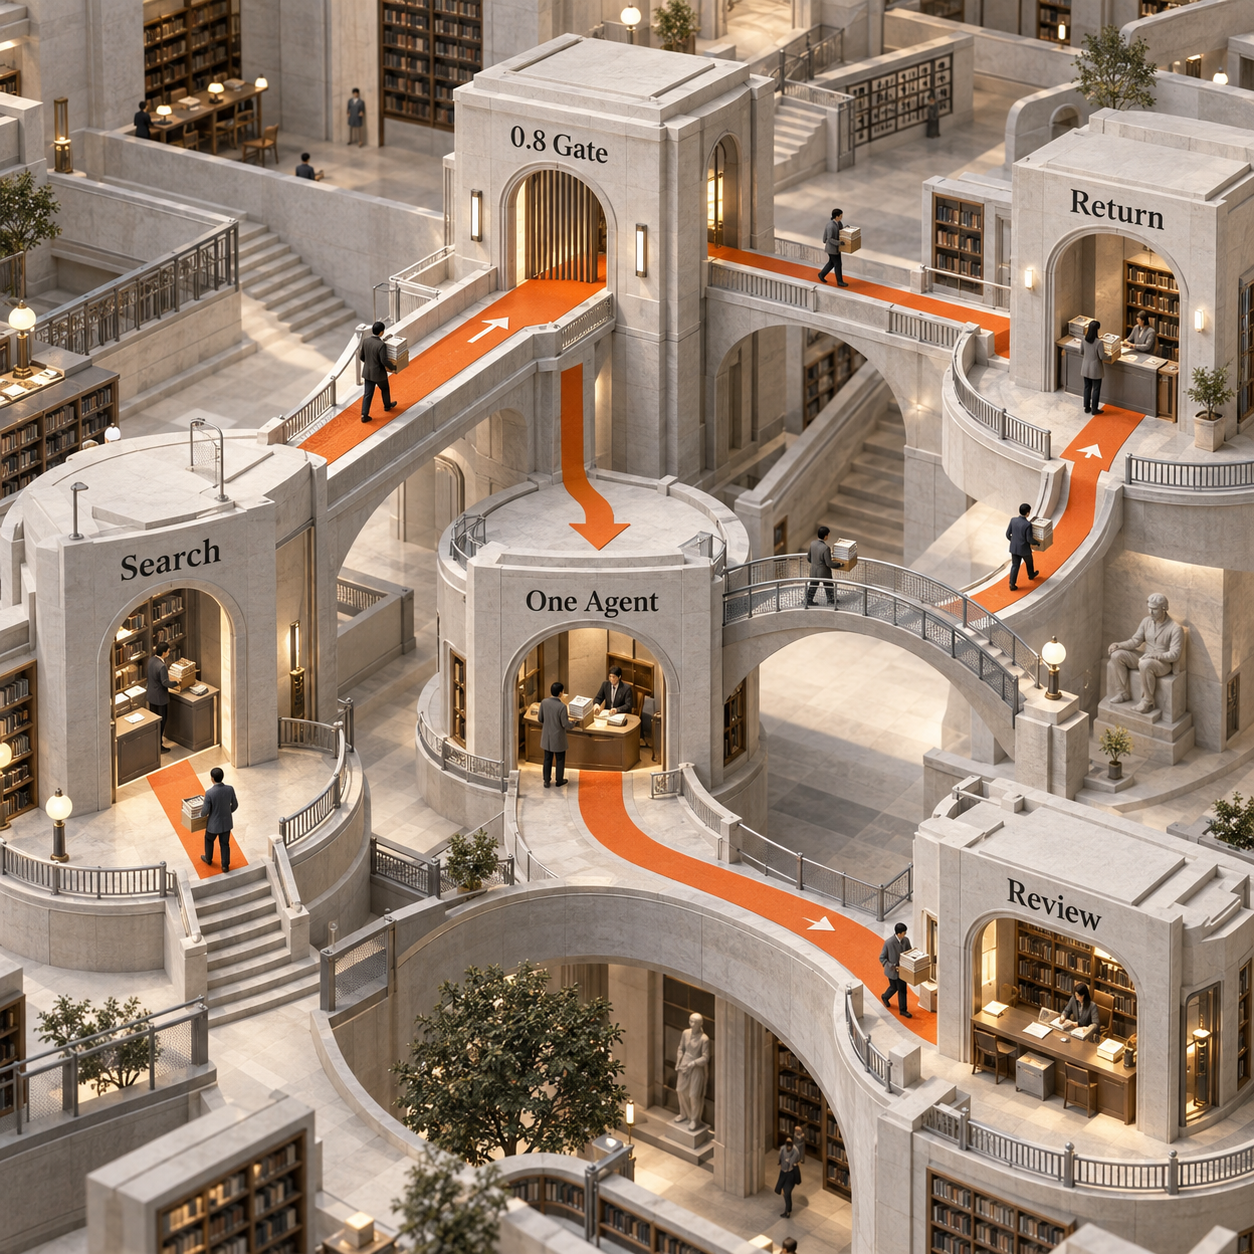
Questo è il motivo più convincente per adottare il runtime. Un ciclo generico di agenti può decidere di cercare ancora, rivedere ancora o chiamare un altro strumento perché la conversazione sembra incompleta. AgentRun rende finito, nel workflow stesso, il lavoro consentito. Un operatore ottiene così un budget di chiamate ispezionabile prima dell’esecuzione, anche se l’host deve comunque imporre i limiti di spesa del provider e le autorizzazioni degli strumenti.
Funzionalità 3: l’escalation è codice, non un auspicio nel prompt
AgentRun traduce l’escalation in uno stato del runtime restituito con una motivazione, anziché nasconderla in una frase del prompt dell’agente. Il workflow testato accetta una risposta solo quando la decisione è yes, l’output rispetta il contratto e la confidenza raggiunge 0.8. In caso contrario apre una coda con zero o un’indagine, controlla nuovamente il risultato e procede all’escalation se la stessa soglia non viene ancora superata.
Per verificare che il numero determinasse davvero il comportamento, entrambi i confronti sono stati alzati da 0.8 a 0.98. La decisione predefinita della fixture per la password è rimasta yes con confidenza 0.97. Con il workflow originale, il caso si concludeva subito senza chiamate agli agenti. Con quello più severo, entrava in indagine, riceveva la stessa risposta valida, otteneva un altro yes a 0.97 e passava a un operatore dopo una chiamata all’agente e due decisioni.
Questa piccola modifica ha cambiato la diramazione senza toccare il prompt, la risposta della fixture o l’adapter. È il vantaggio pratico di conservare nel codice la regola sulla confidenza. Il team può esaminare la modifica della soglia come qualsiasi altro cambiamento comportamentale, provarla su casi etichettati e misurare il conseguente tasso di passaggio a un operatore prima del rilascio.
Anche la consegna resta separata dall’escalation. Il runtime restituisce complete o escalated; spetta all’host decidere se aprire un ticket di assistenza, avvisare una persona o non fare nulla. Questa separazione impedisce a un documento di workflow di concedersi da solo il permesso di contattare un cliente o modificare un account.
Funzionalità 4: l’ispezione è utile, ma l’integrazione resta a carico del team
L’ispezione di AgentRun rende leggibile il workflow prima dell’esecuzione del codice, senza eliminare il lavoro applicativo che lo circonda. Sull’esempio di triage generato, agentrun inspect ha restituito il digest del workflow, i nodi judge, escalate e code, l’adapter runJudge necessario e executableCode: true. validate ha restituito ok: true. Anche dry-run ha restituito ok: true, segnalando però in modo esplicito che il percorso sintetico di escalation era stato saltato.
Quel salto è importante. Un dry run verde dimostra il cablaggio, non la copertura delle diramazioni. Le quattro fixture di assistenza hanno fornito la prova comportamentale perché hanno attivato intenzionalmente risposta, indagine e revisione. In CI conviene mantenere chiara la distinzione: l’ispezione controlla la struttura, la validazione controlla i contratti e i casi fissi controllano il comportamento.
L’integrazione richiede tre adapter principali. runEffect inoltra strumenti e altri effetti. runJudge fornisce decisioni tipizzate, eventualmente tramite Jev. runNode collega il runtime dell’agente e deve propagare schema, strumenti, segnale di annullamento ed eventuale callback di revisione. L’host rimane responsabile anche di autenticazione, segreti, scelta del modello, limiti ai turni, budget, log, redazione dei dati, consegna e ricevute durevoli.
La funzione di controllo mette a fuoco il compromesso. Il suo corpo di 31 righe usava gli stessi adapter predefiniti e ha riprodotto ogni stato e ogni conteggio di chiamate della baseline. Per una sola rotta di assistenza, quella funzione è più facile da leggere e distribuire. Le 62 righe aggiuntive nel file di workflow AgentRun acquistano un documento riutilizzabile, ispezione generica, semantica condivisa dei nodi, contratti di output, escalation strutturata e una superficie generabile da un agente di authoring. Non riducono automaticamente la quantità di codice.
Blocca la versione dell’interprete e il documento
Conserva la versione del pacchetto accanto al digest del workflow. Un documento
v: 2non identifica l’interprete, gli adapter, gli strumenti o le regole dell’host che lo hanno eseguito.Dimostra ogni percorso terminale
Crea casi fissi per il completamento immediato, la diramazione costosa, l’escalation e l’output non valido. Considera i percorsi saltati dal dry run come copertura ancora da realizzare, non come test superati.
Collega i confini dell’host
Implementa strumenti, decisioni, chiamate agli agenti, annullamento, redazione dei dati e consegna nel codice dell’applicazione. Mantieni autorizzazioni e regole di accettazione fuori dal documento di workflow.
Adotta l’astrazione soltanto dal secondo workflow
L’astrazione comincia a ripagarsi quando adapter, ispezione e schemi di regressione vengono riutilizzati. Per un unico percorso stabile, conserva la funzione.
È lo stesso confine alla base della più ampia scelta tra sviluppo interno e acquisto per i workflow degli agenti: conviene adottare meccanismi condivisi quando il lavoro operativo ricorrente supera il costo della loro manutenzione.
Prezzi di AgentRun beta: l’interprete è gratuito, il runtime no
AgentRun beta ha un solo prezzo software: $0 per il codice Apache-2.0. In beta.4 non esistono né un piano AgentRun a pagamento né un runtime AgentRun gestito. Pacchetto npm, sorgenti, CLI, interprete di workflow ed esempi costituiscono il prodotto. Parcha non include nella licenza token dei modelli, esecuzione degli strumenti, archiviazione, osservabilità o assistenza per la produzione.
Jev comporta un costo separato e facoltativo per il modello decisionale. Come verificato sulla pagina aggiornata dei modelli TypeSafe il 24 settembre 2026, Jev 1.13 costa $0.042 per milione di token di input, mentre i token di output sono gratuiti. Assumendo, come dichiarato, 500 token di input per decisione, un controllo costa $0.000021 e due controlli $0.000042. Su 100,000 casi, queste chiamate decisionali totalizzerebbero rispettivamente $2.10 o $4.20.
Il calcolo non comprende l’indagine dell’agente. AgentRun può collegarsi a qualsiasi runtime per agenti fornito dall’host, quindi non esiste una cifra universale onesta per singolo caso. Una richiesta di assistenza che termina dopo un controllo Jev ha un profilo di costo diverso da una che attiva un agente, gli strumenti, un secondo controllo, l’archiviazione, i log e la revisione umana. La recensione basata su script non ha effettuato chiamate a modelli dal vivo: la spesa di inferenza osservata è stata quindi $0, e pari a zero è anche il valore delle sue evidenze sui costi di produzione.
Temporal mostra perché l’hosting durevole è un acquisto separato. Temporal Cloud parte attualmente da $50 per milione di azioni, oltre ai costi di archiviazione, con $150 di crediti per 90 giorni. AgentRun non applica quella tariffa di piattaforma perché non offre un livello di esecuzione gestito paragonabile.
I veri limiti
I limiti di AgentRun sono abbastanza rilevanti da giustificare l’ingresso della beta attraverso un solo workflow ben delimitato, non la sua adozione come architettura predefinita.
1. Gli artefatti della release non concordano sulla propria versione
Il manifest del pacchetto pubblicato identifica la versione installata come 0.1.0-beta.4, ma il README incluso riporta Beta: 0.1.0-beta.3. Anche il README nella radice del tag beta.4 definisce la release beta.3 e il changelog indica beta.4 come non ancora pubblicata. Il ramo main attuale corregge il README principale in beta.4, ma chi blocca il tag pubblicato incontra indicazioni di stato contraddittorie.
La discrepanza non compromette l’interprete, ma è significativa in un sistema di workflow in cui conta la provenienza delle versioni. Blocca la versione npm, conserva il digest del workflow e registra separatamente le versioni di adapter e regole. Non affidarti a un badge testuale per ricostruire un’esecuzione in produzione.
2. Il carico sull’host è il confine del prodotto
AgentRun fornisce il flusso di controllo, non un sistema di assistenza completo. Restano da implementare strumenti autenticati, un adapter per l’agente, l’accesso a Jev se viene usato, segreti, applicazione dei budget, annullamento, diagnostica privata, regole sui dati dei clienti, consegna, monitoraggio e gestione della revisione umana. I 30.48 secondi necessari a configurare i sorgenti non dicono nulla su questo lavoro di integrazione.
3. Gli hook di ripristino non equivalgono a un’esecuzione durevole
Il runtime espone interfacce per checkpoint, memo, ricevute e ripristino, ma archiviazione e riconciliazione spettano all’host. Una chiave di idempotenza aiuta a eliminare i duplicati; non garantisce una consegna exactly-once. Un effetto esterno scaduto può comunque completarsi e l’host deve verificarne l’esito finale prima di riprovare. Se il ripristino dopo un crash è il requisito principale, usa Temporal. Se lo è la persistenza di grafi di agenti stateful, valuta LangGraph.js.
4. JavaScript attendibile è un confine di sicurezza invalicabile
I nodi di codice eseguono JavaScript con i privilegi del processo e la validazione può eseguire sonde. Il flag --trusted della CLI è una presa d’atto, non una sandbox. Un team che accetta workflow da utenti, artefatti generati o altri domini di fiducia deve isolarli tramite confini di processo, filesystem, rete e credenziali sotto il controllo dell’host.
5. Anche i risultati tipizzati possono essere sbagliati con grande sicurezza
Il test dello schema è fallito esattamente come previsto, ma non può individuare una risposta errata e ben formata. Una decisione yes ad alta confidenza resta il risultato di un modello. Il workflow necessita di casi etichettati, soglie specifiche per l’attività, monitoraggio in produzione e un percorso di revisione. I 31 test di assistenza superati convalidano gli scenari forniti, non l’accuratezza di Jev dal vivo.
6. Le opzioni di piattaforma e assistenza sono limitate
Beta.4 è una libreria Node.js ESM che richiede almeno Node 22.19 e, per chi usa TypeScript, TypeScript 5.4. Python, esecuzione nel browser e runtime gestito non rientrano nell’ambito del progetto. La beta non prevede alcun SLA di assistenza per la produzione e le modifiche alle API o all’esecuzione possono imporre una migrazione tra release beta.
7. Una funzione fissa resta sorprendentemente spesso l’astrazione migliore
La funzione di controllo di 31 righe non è un controesempio costruito ad arte. Ha replicato il workflow in tutti e quattro i casi predefiniti. Se il lavoro comprende una ricerca, una condizione, una chiamata facoltativa a un agente e un passaggio di consegne gestito da un solo team, una funzione offre maggiore località e meno concetti. AgentRun si giustifica quando il workflow deve essere ispezionato, generato, versionato, composto o valutato indipendentemente dall’applicazione che lo circonda.
Per l’adozione operativa, questa recensione va affiancata a un piano per raccogliere prove sui guasti. La guida agli strumenti per analizzare i malfunzionamenti degli agenti descrive log e trace necessari quando il grafo del percorso ideale non basta più.
Verdetto: quando AgentRun giustifica la propria presenza
AgentRun è una beta credibile per trasformare la parte ripetibile di un lavoro svolto da agenti in software esplicito. L’interprete è stato semplice da installare, il grafo di assistenza ha rispettato ogni diramazione limitata, il contratto di output ha bloccato il risultato non valido e la soglia si è comportata come codice. Il progetto è insolitamente chiaro su ciò che rimane fuori dalla libreria.
Il verdetto resta condizionato. Scegli AgentRun soltanto se sono vere tutte e quattro queste affermazioni: il workflow si ripete; almeno una diramazione con modello o agente richiede un limite visibile; più di una persona o di un sistema deve ispezionare o generare il workflow; l’host può gestire adapter, autorizzazioni, ripristino, valutazione e consegna. Se anche una sola non è vera, parti da una funzione TypeScript.
Usa LangGraph.js quando il prodotto consiste essenzialmente in un grafo persistente di agenti. Usa Temporal quando consiste essenzialmente in un processo distribuito durevole. AgentRun occupa lo spazio tra questi strumenti e una funzione: più circoscritto dei due runtime, ma più strutturato del controllo scritto a mano.
La prima mossa della settimana è concreta. Prendi un lavoro esistente basato su agenti e classifica ogni passaggio come codice deterministico, decisione tipizzata, indagine dell’agente o revisione umana. Se il diagramma contiene una sola linea fissa, conserva la funzione. Se mostra una diramazione ricorrente in cui la spesa degli agenti o la regola di escalation devono essere sottoposte a revisione, codifica quel singolo percorso in AgentRun, blocca beta.4 e costruisci quattro fixture prima di collegare modelli dal vivo.
FAQ su AgentRun
AgentRun vale la pena?
AgentRun vale la pena quando un workflow ricorrente richiede diramazioni ispezionabili, confini controllati tramite schema, chiamate agli agenti limitate e uno stato di revisione esplicito. Non giustifica l’astrazione per una sequenza fissa che una piccola funzione esprime con chiarezza.
Quanto è valido AgentRun?
In questa recensione, AgentRun beta.4 ha eseguito senza problemi il grafo di assistenza predefinito: tutti e quattro gli esiti hanno coinciso con le attese, il percorso irrisolto è terminato con codice 2 e tutti i 31 test mirati sono stati superati. Questi risultati descrivono il comportamento dell’interprete, non l’accuratezza dei modelli dal vivo, l’uptime o i risparmi in produzione.
Quali sono le migliori alternative ad AgentRun?
Usa TypeScript puro per un workflow fisso e breve, LangGraph.js per grafi di agenti stateful e di lunga durata con persistenza, e Temporal per workflow applicativi durevoli che devono riprendere dopo un guasto dell’infrastruttura. L’alternativa giusta dipende dal problema: chiarezza del codice, stato dell’agente o durevolezza operativa.
Come gestisce AgentRun lo stato durante l’esecuzione?
AgentRun mantiene uno stato strutturato all’interno del workflow, verifica i contratti dichiarati, copia lo stato nelle diramazioni e nelle mappe e rileva scritture parallele in conflitto. Checkpoint durevoli, archiviazione, conservazione, controllo degli accessi e ripristino restano responsabilità dell’host: il documento di workflow non è né un database né un livello di custodia.
- Ultimo aggiornamento
- 24 set 2026
- Categoria
- Build
Preferisca questo sito su Google


Segni omidsaffari.com come fonte preferita e Google lo mette in evidenza per lei in Top Stories, AI Overviews e AI Mode.

Perplexity API: Fast Search o ricerca web predefinita?
Perplexity API a confronto: costi, latenza e copertura di Fast Search e ricerca web, con una regola pratica per scegliere la modalità giusta.24 set 2026Build
Agenti AI: quando il fallback svuota il budget
Un writer in sandbox ha reso il fallback a pagamento il percorso predefinito: come proteggere budget, credenziali e output finali degli agenti AI.24 set 2026Build
Cursor gratis? Quanto costa davvero Rollouts
Cursor gratis non include Rollouts: servono Teams o Enterprise. Scopri cosa coprono i crediti di 10 giorni, i costi ancora ignoti e quando provarlo.24 set 2026Build
AI code review con Unreal Agent: guida pratica al runner
Scopri come usare Unreal Agent in sicurezza, conservare le sessioni JSONL e valutarne costi, prestazioni e casi d’uso concreti per l’AI code review.24 set 2026Build
JetBrains Air: guida pratica al plugin Alpha
Scopri come installare JetBrains Air Alpha, collegare un agente, aggiungere il contesto del progetto e verificare ogni modifica senza perdere il controllo.23 set 2026Build
JetBrains Air gratis: cosa costa davvero e chi paga
JetBrains Air è gratis solo come plugin. Scopri chi paga agenti, API, IDE e crediti JetBrains AI, più quando convengono i piani Pro o Ultimate.23 set 2026Build
Firecrawl self host: guida a Docker, verifica e costi
Come installare Firecrawl self host con Docker Compose, verificare uno scrape reale e confrontare costi e limiti con Firecrawl Cloud in 30 giorni.22 set 2026Build