Claude Code MCP: cómo ajustar la espera de inicio
Configura el tiempo de espera de Claude Code MCP al iniciar trabajos automáticos, separa los cuatro límites y evita resultados parciales o incompletos.


Configura CLAUDE_CODE_MCP_STARTUP_WAIT_MS con el máximo de milisegundos que un trabajo de Claude Code MCP puede esperar a los servidores MCP antes de su primer turno no interactivo. Usa 0 para omitir esa espera. Así, los trabajos programados tienen un margen de disponibilidad bien definido, pero esta variable no establece el tiempo de espera de la conexión MCP, el de las herramientas MCP ni el límite del trabajo completo.
La respuesta en una línea
Ejecuta CLAUDE_CODE_MCP_STARTUP_WAIT_MS=5000 claude -p "Run the scheduled check" para conceder hasta cinco segundos a la espera inicial de MCP en el primer turno. Usa CLAUDE_CODE_MCP_STARTUP_WAIT_MS=0 cuando el trabajo pueda comenzar sin que ningún servidor MCP esté listo.
Claude Code 2.1.274 incorporó esta variable el 17 de septiembre de 2026. La nota de la versión define con precisión dos aspectos: el valor limita, en milisegundos, la espera del primer turno no interactivo, y 0 significa no esperar. No indica un valor predeterminado para la nueva variable. Conviene fijarla de forma explícita en los trabajos sin supervisión para que un futuro valor predeterminado o una variable de entorno del equipo no cambien la política de inicio sin aviso.
Un trabajo no interactivo es el que se inicia con -p o --print, por ejemplo, una comprobación de CI, una tarea cron o una ejecución controlada mediante un SDK. Esta opción no está pensada para las sesiones interactivas de terminal.
La regla práctica es sencilla:
Estos rangos son recomendaciones operativas, no valores predeterminados de Anthropic. Mide tus propios servidores antes de adoptar una configuración común.
Qué controla realmente la espera de inicio de Claude Code MCP
Imagina el primer turno como la salida de un tren y cada servidor MCP como un andén de conexión. CLAUDE_CODE_MCP_STARTUP_WAIT_MS decide cuánto tiempo permanece el tren en la estación para esperar a quienes hacen conexión. No determina cuánto puede seguir intentando llegar cada pasajero, cuánto tarda el trabajo una vez a bordo ni cuándo debe terminar el viaje completo.
Ese alcance limitado es precisamente lo importante. Antes de 2.1.274, los equipos solían recurrir a MCP_TIMEOUT, que controla un reloj distinto. Ahora, un trabajo programado puede elegir una ventana breve de disponibilidad para el primer turno sin fingir que cada conexión de servidor o cada llamada posterior a una herramienta comparte el mismo límite.
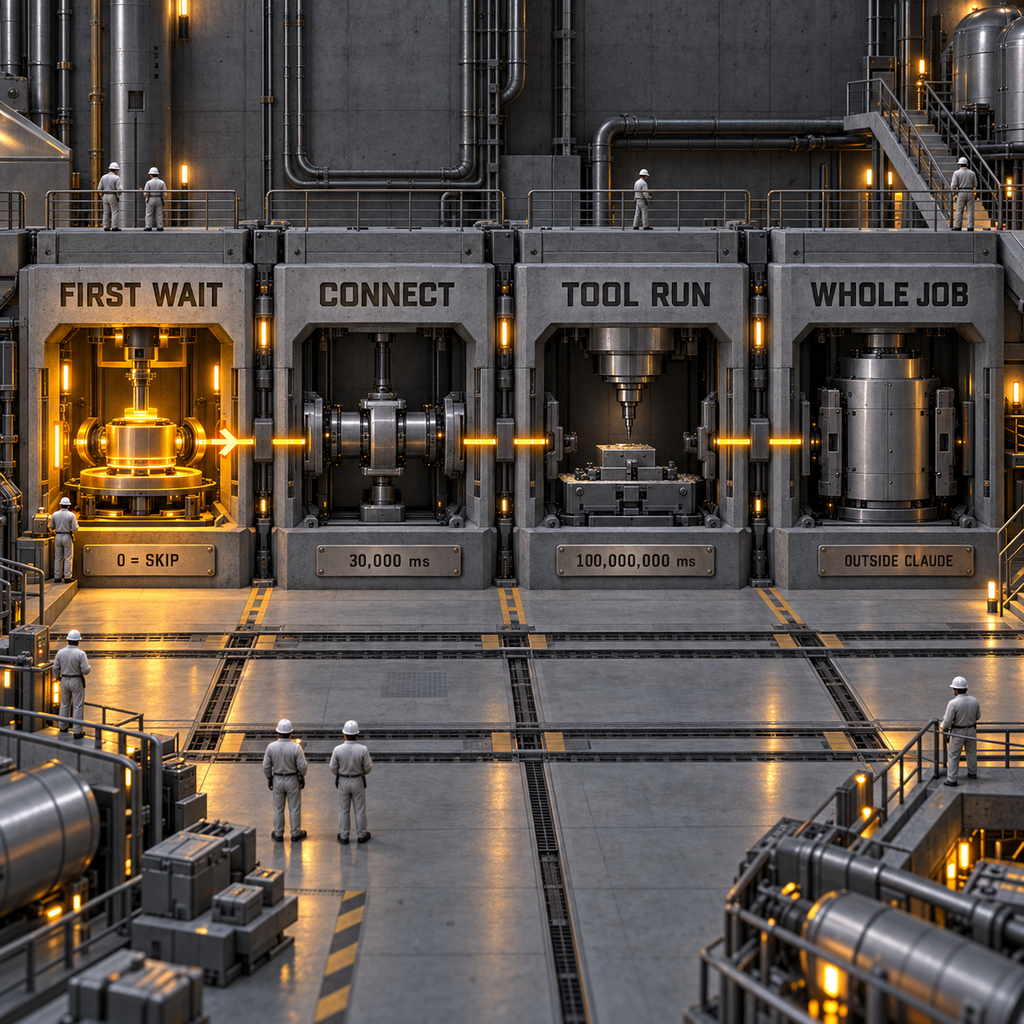
Cuatro relojes y cuatro decisiones de fallo distintas
La configuración más segura asigna un nombre y una sola función a cada reloj.
También existe MCP_CONNECT_TIMEOUT_MS, cuyo valor predeterminado es 5,000 ms para un lote bloqueante de conexiones al inicio. Se aplica a comportamientos de inicio bloqueantes, como MCP_CONNECTION_NONBLOCKING=0, o a un servidor marcado con alwaysLoad: true. La referencia de variables de entorno de Anthropic lo distingue expresamente de MCP_TIMEOUT.
En las llamadas a herramientas, un campo timeout definido para un servidor en .mcp.json reemplaza MCP_TOOL_TIMEOUT para ese servidor. Esto resulta útil cuando una consulta al almacén de datos necesita, con razón, más tiempo que una búsqueda de tickets. Aun así, no modifica la nueva espera del primer turno.
Esta diferencia también explica por qué 0 no sirve como interruptor universal de velocidad. Si la búsqueda de herramientas está habilitada y el prompt necesita más adelante un servidor que aún se está conectando, Claude Code espera dentro de ToolSearch. Si está deshabilitada, utiliza WaitForMcpServers. Omitir la espera de entrada puede trasladarla a un punto posterior del trabajo.
Prueba reproducible con un servidor lento
Puedes reproducir el límite con un servidor stdio local que solo retrase la respuesta de inicialización de MCP. Guarda el siguiente código como slow-mcp.mjs:
import readline from "node:readline";

const delay = Number(process.env.SLOW_MCP_DELAY_MS || 5000);
const lines = readline.createInterface({ input: process.stdin });
const send = message => process.stdout.write(JSON.stringify(message) + "\n");

lines.on("line", line => {
  const request = JSON.parse(line);
  if (request.method === "initialize") {
    setTimeout(() => send({
      jsonrpc: "2.0",
      id: request.id,
      result: {
        protocolVersion: request.params.protocolVersion,
        capabilities: { tools: {} },
        serverInfo: { name: "slow-ready", version: "1.0.0" }
      }
    }), delay);
  } else if (request.method === "tools/list") {
    send({ jsonrpc: "2.0", id: request.id, result: { tools: [] } });
  }
});
Configura Claude Code para usarlo mediante slow-mcp.json:
{
  "mcpServers": {
    "slow-ready": {
      "type": "stdio",
      "command": "node",
      "args": ["./slow-mcp.mjs"],
      "env": { "SLOW_MCP_DELAY_MS": "5000" }
    }
  }
}
Ejecútalo con CLAUDE_CODE_MCP_STARTUP_WAIT_MS=1000 MCP_TIMEOUT=10000 claude -p "Reply with OK." --mcp-config ./slow-mcp.json --strict-mcp-config --output-format stream-json --verbose.
La opción --strict-mcp-config evita que servidores del usuario o del proyecto ajenos a la prueba interfieran. El formato de flujo muestra el evento inicial system/init, incluido el nombre y el estado de cada servidor MCP. También expone mcp_server_errors cuando una configuración suministrada no es válida.
Qué mostró la comprobación local
Una comprobación de inicio previa a la autenticación en Claude Code 2.1.274 utilizó ese servidor de 5,000 ms. Como el entorno no tenía una sesión iniciada, la ejecución se detuvo en la autenticación. La medición solo abarca el inicio, que es precisamente el límite analizado.
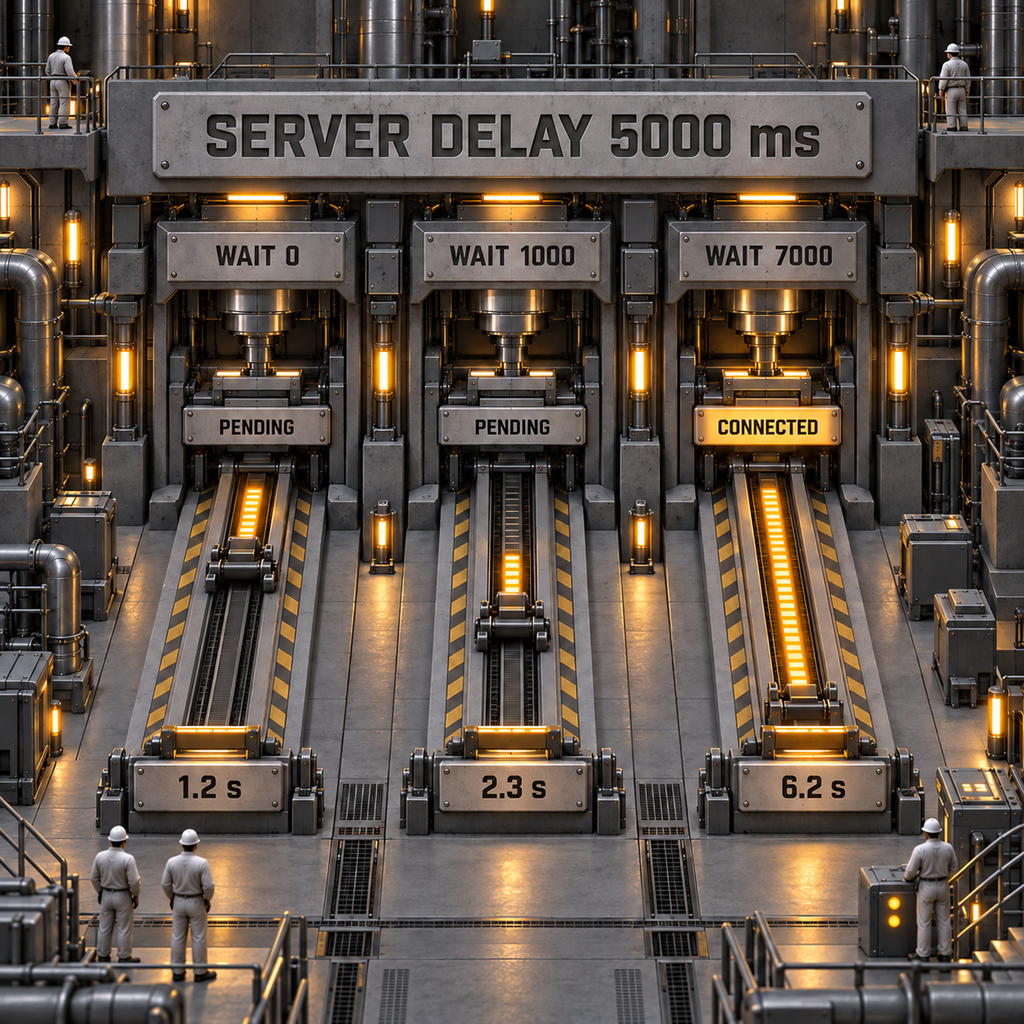
Los tiempos reales incluyen la sobrecarga de inicio de Claude Code y npx, por lo que no deben trasladarse sin más a un objetivo de servicio. Lo relevante es el resultado categórico: con 0 y 1,000 ms, la comprobación del primer turno terminó mientras el servidor seguía pendiente; con 7,000 ms, el mismo servidor apareció como conectado. Estas mediciones no incluyen la latencia del modelo ni la duración total del trabajo.
Define la disponibilidad antes del trabajo operativo
Un tiempo de espera solo responde a una pregunta: «¿Cuánto vamos a esperar?». Un trabajo de producción también debe resolver otra: «¿Qué herramientas son imprescindibles?».
Aplica una comprobación en dos partes:
- Antes de iniciar la tarea operativa, comprueba el estado de cada endpoint remoto o comando de servidor local que sea imprescindible. Para servidores configurados y aprobados,
claude mcp listinforma de estados como conectado, requiere autenticación o conexión fallida. - En el flujo de Claude Code, revisa
system/init.mcp_servers. Exige que el servidor indicado tengastatus: "connected"y rechaza cualquier entrada no vacía demcp_server_errorscorrespondiente a ese servidor. Gestiona los servidores en caché u opcionales mediante una lista de permitidos explícita.
Si un servidor imprescindible está pendiente, termina la ejecución antes de aceptar cualquier resultado operativo. Si es opcional, registra el modo degradado y continúa. De este modo, la espera se convierte en una entrada de la política, no en la política completa.
La caché de descubrimiento exige especial cuidado. Un servidor remoto cuya lista de herramientas esté almacenada en caché puede aparecer como pendiente durante la inicialización y conectarse al recibir su primera llamada. Este comportamiento es útil para herramientas opcionales, pero no cumple una promesa estricta de disponibilidad. La comprobación de una herramienta imprescindible debe exigir una conexión activa o realizar su propio control de estado.
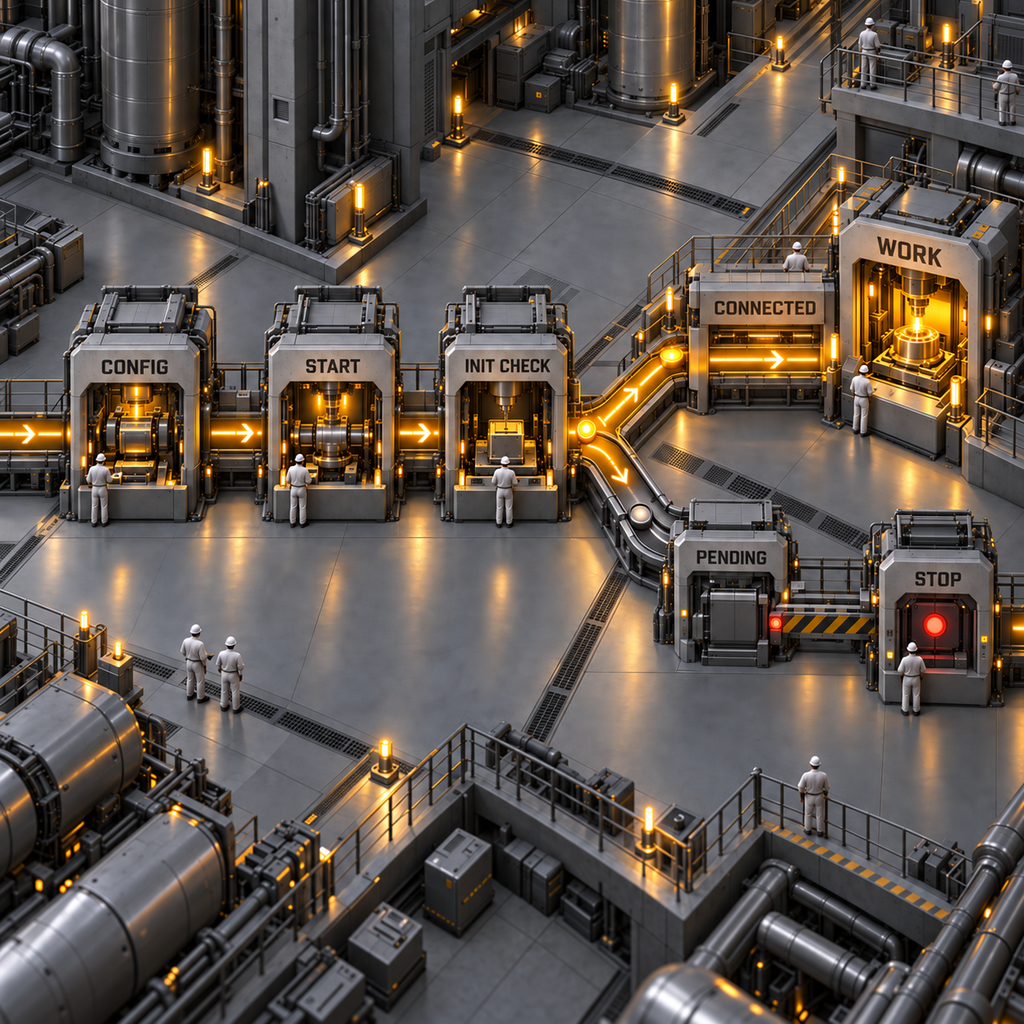
Por último, envuelve el proceso completo en un límite definido por el programador. La espera inicial no puede impedir que una solicitud al modelo, un comando de Bash, un hook o una llamada posterior a una herramienta MCP consuma el resto de la ventana de ejecución.
El valor económico está, sobre todo, en fallar antes
El ahorro de cómputo existe, pero es fácil exagerarlo. Supongamos que 10,000 trabajos mensuales dedicarían 30 segundos completos a esperar y que se fija un margen de 3 segundos para el primer turno. La capacidad máxima recuperada sería de 4,500 minutos de runner.
GitHub publica actualmente un precio de $0.006 por minuto para un runner Linux hospedado estándar de 2 núcleos y de $0.062 por minuto para uno de macOS. Con esas tarifas, 4,500 minutos equivalen a $27 de tiempo de Linux o $279 de tiempo de macOS antes de contabilizar los minutos incluidos. Además, GitHub redondea el consumo de cada trabajo al minuto completo, por lo que una mejora de 27 segundos puede no modificar la factura si la duración total permanece en el mismo bloque de facturación.
La mayor ganancia es operativa. Si un trabajo falla su comprobación de disponibilidad en tres segundos, el programador aún puede reintentarlo, avisar a la persona responsable o cambiar a una alternativa. En cambio, si comienza discretamente sin acceso a la base de datos o al gestor de incidencias, puede producir un resultado convincente pero incompleto, mucho más costoso de detectar y revertir que el tiempo de runner consumido.
Si también necesitas controlar respuestas extensas, la guía sobre límites de salida de herramientas en Claude Code aborda esa parte independiente del flujo. Para instalaciones sin supervisión y políticas de red, combina esta comprobación de disponibilidad con el acceso de red por comando.
Los siete flujos de trabajo que más se benefician
1. Informes programados de finanzas y operaciones
Un responsable financiero ejecuta a las 6 a.m. un informe que necesita un servidor MCP del almacén de datos. Márcalo como imprescindible, añade un pequeño margen a su arranque en frío medido y detén el trabajo si no se conecta. El beneficio no se limita a terminar antes: evita generar un informe impecable a partir de los archivos del repositorio cuando las cifras actuales no estaban disponibles.
2. Comprobaciones automáticas de riesgo en pull requests
Un equipo de plataforma ejecuta Claude Code en cada pull request de alto riesgo y necesita herramientas de GitHub, un gestor de incidencias y un escáner de seguridad. La comprobación puede exigir el escáner y GitHub, y considerar opcional el gestor de incidencias. Así, el equipo de desarrollo recibe un fallo rápido y comprensible, en lugar de una revisión que omitió sin avisar la evidencia más importante.
3. Trabajos de coordinación de versiones
Un responsable de versiones usa un agente programado para comparar el trabajo integrado, los incidentes abiertos y el estado del despliegue. Cada fuente puede tener su propia regla de disponibilidad. Si el servidor MCP de despliegue no responde, el trabajo se detiene antes de redactar notas de versión que den a entender que el lanzamiento es seguro.
4. Clasificación nocturna de solicitudes de soporte
Un equipo de soporte deja que un trabajo agrupe tickets, consulte el historial de las cuentas y prepare respuestas. Los servidores del centro de soporte y de datos de clientes son imprescindibles; Slack puede ser opcional. Una espera limitada mantiene la cola en movimiento, mientras que la regla de disponibilidad impide que se invente contexto privado del cliente cuando falta una fuente.
5. Asistentes de respuesta a incidentes
Un ingeniero de guardia inicia desde una alerta una ejecución de diagnóstico no interactiva. Un margen breve de inicio revela si los logs y las métricas están realmente accesibles. Si alguno de esos servidores imprescindibles no está disponible, el sistema envolvente puede recurrir de inmediato al runbook manual, en vez de consumir el tiempo del incidente en un diagnóstico parcial.
6. Runners efímeros con escalado automático
Un equipo crea contenedores nuevos para cada trabajo de agente. Los servidores stdio locales pueden sufrir costes de arranque en frío al cargar paquetes, ejecutar asistentes de autenticación o descubrir esquemas. Medir estos inicios permite distinguir entre un margen de disponibilidad realista de siete segundos y una solución provisional permanente para un servidor con problemas.
7. Productos de agentes multiinquilino
Un producto atiende a clientes con distintas conexiones MCP. Un inquilino puede necesitar Salesforce; otro, Linear; y otro, ninguna herramienta externa. Con una lista de servidores imprescindibles por ejecución, una misma capa de orquestación puede elegir una espera breve para cada inquilino sin convertir la integración más lenta en el valor predeterminado de todos.
Tres productos que vale la pena construir
1. Comprobación de disponibilidad MCP para CI con Claude Code
Es la oportunidad más sólida. El producto sería un pequeño wrapper del runner que lee la política de servidores imprescindibles, inicia Claude Code con una espera explícita, registra system/init y devuelve un fallo de disponibilidad legible por máquinas antes de aceptar el resultado del agente.
La demanda es limitada, pero tiene valor comercial: claude code automation registra unas 140 búsquedas mensuales en Estados Unidos, un crecimiento interanual del 200% en los datos de sugerencias y un CPC de $10.88. También se pregunta cómo ejecutar Claude Code automáticamente y cómo configurar Claude Code con MCP. Son expresiones directas del problema de configuración.
La versión mínima que se puede vender es una CLI con un archivo de políticas, anotaciones para GitHub Actions y evidencia en JSON de cada ejecución. El reto está en la distribución. Anthropic puede incorporar políticas nativas de disponibilidad más completas, así que el valor duradero debe residir en el historial entre ejecuciones, las alertas y la compatibilidad con varios entornos de agentes.
2. Linter de políticas de tiempo de espera
Esta herramienta analizaría scripts de shell, archivos de CI, ajustes y .mcp.json para detectar relojes confundidos: una espera inicial de cero con herramientas imprescindibles, un límite corto para el trabajo combinado con un tiempo de espera de herramientas de 28 horas o una integración opcional sin límite.
La palabra clave exacta mcp server timeout ronda las 10 búsquedas mensuales en Estados Unidos y muestra una tendencia interanual declarada de -67%. Una búsqueda relacionada es MCP_TOOL_TIMEOUT, y también se pregunta cómo aumentar el tiempo de espera de Claude Code. Hay demanda suficiente para una función dentro de la comprobación de disponibilidad, pero no para una empresa independiente.
Un MVP necesita analizadores de GitHub Actions, sintaxis habitual de shell y configuración MCP de Claude Code, además de correcciones con criterios claros. El riesgo es generar una falsa sensación de seguridad: una configuración estática no puede conocer la distribución real de los arranques en frío de un servidor sin mediciones durante la ejecución.
3. Telemetría de inicio para agentes programados
Este producto convertiría los eventos system/init en una cronología de latencia de conexión, estados pendientes, configuraciones no válidas y ejecuciones degradadas. Los equipos de plataforma pagarían por consultar tendencias y alertas en muchos repositorios, en lugar de leer archivos JSONL de forma manual.
Comparte las 140 búsquedas mensuales de claude code automation; además, claude code browser automation aporta otras 40 y también muestra un aumento interanual del 200% en los datos de sugerencias. La señal más amplia es que los equipos están llevando Claude Code a trabajos repetibles, donde la evidencia de inicio se convierte en un problema operativo.
El MVP consiste en un recolector de eventos, un mapa de servidores imprescindibles y opcionales, y alertas cuando la disponibilidad rebasa un objetivo de servicio. El reto es la sensibilidad de los datos. Los nombres de MCP y los metadatos de las herramientas pueden revelar sistemas internos, por lo que la redacción de datos y el alojamiento propio son parte del producto, no un refinamiento empresarial que pueda dejarse para después.
Límites y conclusión honesta
Este control resuelve una parte pequeña, pero valiosa, de la automatización confiable. No repara un servidor MCP averiado, autentica un conector vencido, acorta una llamada posterior a una herramienta ni detiene el proceso completo de Claude Code.
No uses 0 en un trabajo cuya primera acción útil necesite MCP. Puede mostrar el estado pending durante la inicialización, y la espera puede reaparecer cuando se busca la herramienta. Tampoco aumentes el valor hasta que los servidores inestables parezcan saludables. Los servidores HTTP y SSE reintentan los fallos transitorios de la primera conexión, pero los errores de autenticación y de recurso no encontrado exigen cambios de configuración. Esperar más solo demora esa realidad.
Los servidores stdio tampoco vuelven a conectarse automáticamente tras una interrupción a mitad de sesión. Una ventana de inicio generosa no dice nada sobre su estado diez minutos después.
La mejor política es estricta y predecible: una espera breve y explícita para el primer turno, servidores imprescindibles identificados, una comprobación de estado, un tiempo de espera independiente para las herramientas y un límite exterior para el trabajo. Esa combinación produce fallos útiles en lugar de demoras difíciles de explicar.
¿Cómo aumentar el tiempo de espera de Claude Code?
Elige el tiempo de espera que corresponda a la fase lenta. Usa CLAUDE_CODE_MCP_STARTUP_WAIT_MS para la disponibilidad de MCP en el primer turno no interactivo, MCP_TIMEOUT para el inicio del servidor, MCP_TOOL_TIMEOUT o un timeout por servidor para ejecutar herramientas y el límite del runner para controlar el trabajo completo.
¿Cómo ejecutar Claude Code automáticamente?
Ejecuta Claude Code de forma no interactiva con -p o --print, define el comportamiento de los permisos para herramientas sin supervisión, fija un límite exterior en el programador y declara la disponibilidad de MCP. Una espera de inicio, por sí sola, no convierte un trabajo automático en un proceso seguro.
¿Por qué Claude Code sigue agotando el tiempo de espera?
Primero identifica la fase en los logs. Una demora anterior a system/init apunta al inicio o a la disponibilidad de la conexión. Un fallo durante la llamada a una herramienta MCP apunta a límites de la herramienta, de inactividad o de solicitudes de red. Si CI finaliza el proceso, el problema está en el límite exterior del trabajo.
¿Cómo configurar Claude Code con MCP?
Añade una configuración MCP al proyecto o al usuario, o proporciona un archivo mediante --mcp-config. En trabajos repetibles, añade --strict-mcp-config, fija una espera explícita para el primer turno y verifica los servidores imprescindibles en system/init, en lugar de suponer que estar configurado equivale a estar conectado.
El lunes, elige un trabajo programado de Claude Code, mide los arranques en frío de sus servidores MCP imprescindibles, fija la espera mínima que refleje la realidad y haz que un servidor imprescindible pendiente detenga el proceso antes de confiar en el resultado. Si quieres llevar esa capa de confiabilidad a todos tus flujos de agentes, puedo ayudarte a construir el sistema de producción.
- Última actualización
- 17 sept 2026
- Categoría
- Build
Prefiera este sitio en Google


Marque omidsaffari.com como fuente preferida y Google lo destacará para usted en Top Stories, AI Overviews y AI Mode.
Bloquear bots de IA en Cloudflare sin cerrar el paso a los buscadores
Configura Cloudflare para bloquear bots de IA dedicados al entrenamiento sin cerrar el acceso de los buscadores. Revisa la migración y el robots.txt.16 sept 2026Build
Voz a texto con Murmure: análisis a fondo
Probamos Murmure para convertir voz a texto sin conexión: precisión, diccionario, reglas, requisitos, límites y uso de LLM locales o remotos.14 sept 2026Build
API FFmpeg: cuánto cuesta RenderIO y qué plan conviene
Compara precios, créditos, límites y sobrecostos de RenderIO para saber cuándo convienen Starter, Growth o Business en una API FFmpeg de producción.14 sept 2026Build
Voz a texto con Dictare: precio real y costos ocultos
Dictare convierte voz a texto por $0 y sin suscripción. Comparamos sus costos reales, límites y alternativas para saber cuándo conviene usarlo.13 sept 2026Build
Evals de Claude Code: cómo medir el aporte real de un plugin
Guía práctica para ejecutar evals de Claude Code, comparar un plugin con una línea base sin plugin y controlar costos antes de llevar la prueba a CI.12 sept 2026Build
IA de voz en Cloudflare: cómo diagnosticar latencia y silencios
Usa turnmetrics de Cloudflare para localizar la latencia, explicar turnos silenciosos y saber qué etapa de tu agente de voz con IA debes corregir.12 sept 2026Build
Cómo poner subtítulos a un video con Rendi
Aprende a poner subtítulos a un video con un archivo SRT y la API de Rendi: configura FFmpeg, controla el proceso y revisa el MP4 antes de escalar.11 sept 2026Build