Claude Code MCP 启动超时:四类超时怎么配
Claude Code 2.1.274 新增 CLAUDE_CODE_MCP_STARTUP_WAIT_MS,用于限制首轮非交互执行等待 MCP 服务器的时间。本文讲清它与 MCP_TIMEOUT、工具调用超时和任务截止时间的区别,并提供可复现测试、CI 就绪门禁及自动化场景配置建议,让定时任务在依赖未就绪时快速失败。


CLAUDE_CODE_MCP_STARTUP_WAIT_MS 用来设定 Claude Code MCP 启动超时:它限定 Claude Code 任务在首轮非交互式执行前,最多等待 MCP 服务器多少毫秒。设为 0 可跳过这段等待。这样,定时任务就有了明确的就绪等待预算;但它不会设置 MCP 连接超时、MCP 工具调用超时,也不会限制整个任务的总时长。
一句话结论
运行 CLAUDE_CODE_MCP_STARTUP_WAIT_MS=5000 claude -p "Run the scheduled check",首轮执行最多会等待 MCP 启动 5 秒。如果任务无需任何 MCP 服务器就绪即可开始,则设为 CLAUDE_CODE_MCP_STARTUP_WAIT_MS=0。
Claude Code 2.1.274 于 2026 年 9 月 17 日引入了这个变量。发布说明明确了两点:它以毫秒为单位,限制首轮非交互式执行的等待时间;0 表示不等待。说明中没有公布这个新变量的默认值。因此,无人值守任务应显式设置它,避免未来的默认值或机器级环境变量悄悄改变启动策略。
这里的“非交互式”是指通过 -p 或 --print 启动的运行,例如 CI 检查、cron 任务或由 SDK 驱动的任务。交互式终端会话不属于这个开关的适用范围。
实际配置可以遵循下面这条简单原则:
这些范围是运维建议,并非 Anthropic 的默认值。统一配置前,请先测量自己的服务器。
Claude Code MCP 启动超时到底控制什么
可以把首轮执行想成一趟即将发车的列车,把每台 MCP 服务器想成一处换乘站台。CLAUDE_CODE_MCP_STARTUP_WAIT_MS 决定列车会为换乘乘客在站内停留多久。它不决定每位乘客可以尝试赶到车站多久,不限制上车后的工作时长,也不规定整段旅程何时必须结束。
这个变量的价值正来自它明确而有限的作用范围。在 2.1.274 之前,运维人员经常使用 MCP_TIMEOUT,但它控制的是另一只计时器。现在,定时任务可以为首轮执行设置较短的就绪窗口,不必再假设每次服务器连接或后续工具调用都应采用同一个期限。
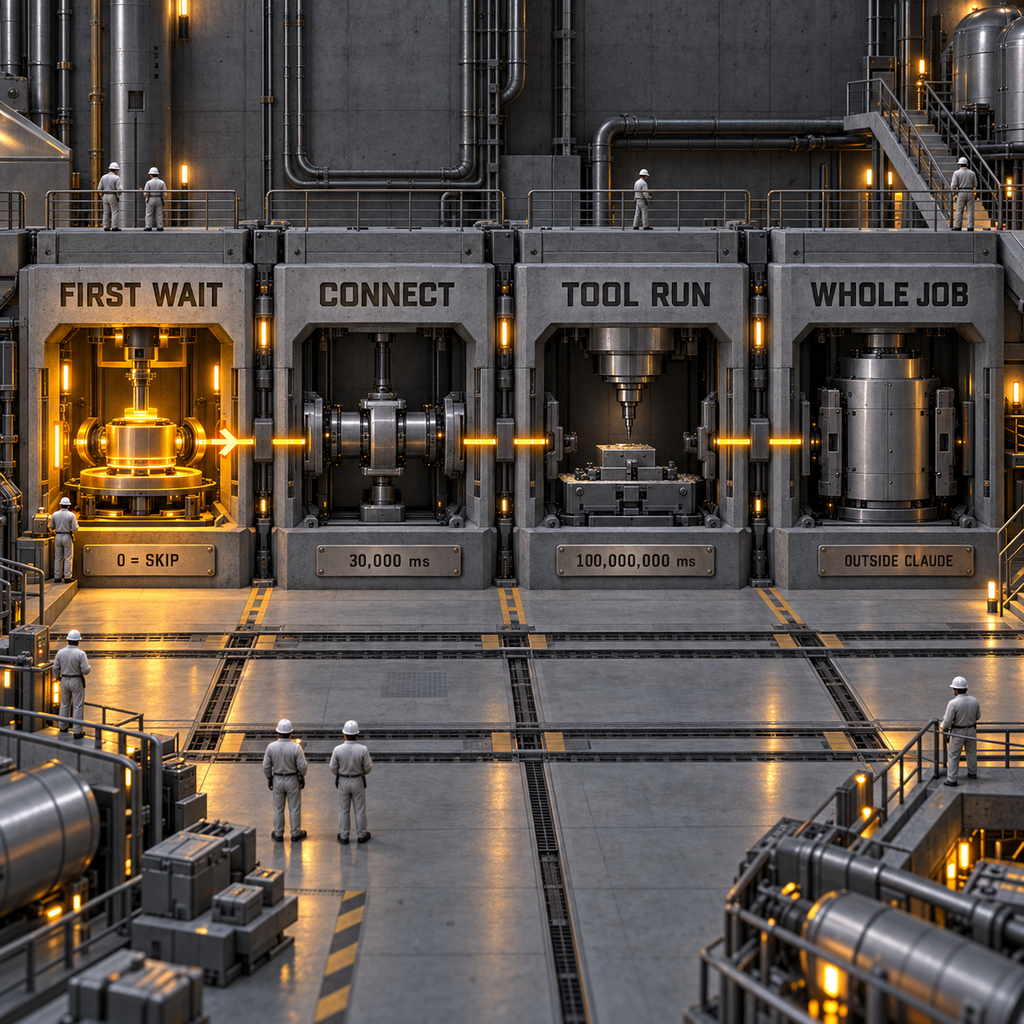
四类计时器,对应四种失败决策
最稳妥的做法,是给每只计时器一个清晰的名字,并让它只负责一件事。
此外还有 MCP_CONNECT_TIMEOUT_MS,其默认值为 5,000 ms,用于阻塞式启动连接批次。它适用于 MCP_CONNECTION_NONBLOCKING=0,或服务器被标记为 alwaysLoad: true 等阻塞式启动情形。Anthropic 的环境变量参考明确指出,它与 MCP_TIMEOUT 并不是同一项设置。
对于工具调用,timeout 字段可在 .mcp.json 中针对某台服务器覆盖 MCP_TOOL_TIMEOUT。例如,数据仓库查询理应比工单查询耗时更长,此时单独设置就很有用。但它仍不会改变新的首轮等待时间。
这也解释了为什么 0 不是一个适用于所有场景的加速开关。启用工具搜索后,如果提示词稍后需要一台仍在连接的服务器,Claude Code 会在 ToolSearch 内等待。关闭工具搜索时,它会使用 WaitForMcpServers。跳过入口处的等待,可能只是把等待挪到了任务更深的位置。
可直接运行的慢服务器测试
可以用一台本地 stdio 服务器复现这条边界:它只延迟 MCP 初始化响应。将下面的代码保存为 slow-mcp.mjs:
import readline from "node:readline";

const delay = Number(process.env.SLOW_MCP_DELAY_MS || 5000);
const lines = readline.createInterface({ input: process.stdin });
const send = message => process.stdout.write(JSON.stringify(message) + "\n");

lines.on("line", line => {
  const request = JSON.parse(line);
  if (request.method === "initialize") {
    setTimeout(() => send({
      jsonrpc: "2.0",
      id: request.id,
      result: {
        protocolVersion: request.params.protocolVersion,
        capabilities: { tools: {} },
        serverInfo: { name: "slow-ready", version: "1.0.0" }
      }
    }), delay);
  } else if (request.method === "tools/list") {
    send({ jsonrpc: "2.0", id: request.id, result: { tools: [] } });
  }
});
再通过 slow-mcp.json 让 Claude Code 连接它:
{
  "mcpServers": {
    "slow-ready": {
      "type": "stdio",
      "command": "node",
      "args": ["./slow-mcp.mjs"],
      "env": { "SLOW_MCP_DELAY_MS": "5000" }
    }
  }
}
执行 CLAUDE_CODE_MCP_STARTUP_WAIT_MS=1000 MCP_TIMEOUT=10000 claude -p "Reply with OK." --mcp-config ./slow-mcp.json --strict-mcp-config --output-format stream-json --verbose。
--strict-mcp-config 会把与测试无关的用户级和项目级服务器排除在外。流式输出会暴露早期的 system/init 事件,其中包括每台 MCP 服务器的名称和状态;如果传入的配置无效,还会显示 mcp_server_errors。
本地验证得到了什么结果
在 Claude Code 2.1.274 上进行的预认证启动检查使用了上述 5,000 ms 服务器。由于测试环境尚未登录,运行在身份验证阶段停止。因此,这次测量只覆盖启动过程,而这恰好就是要验证的边界。
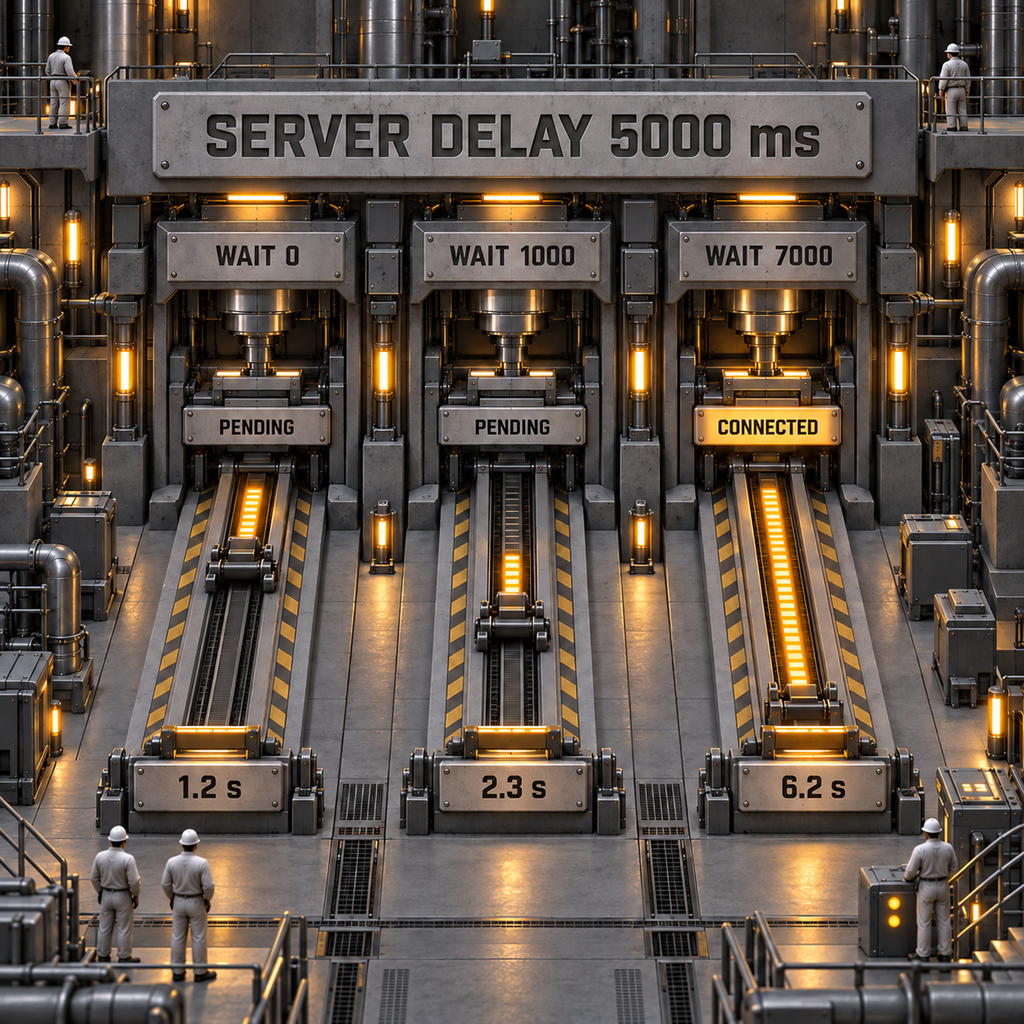
实际用时包含 Claude Code 和 npx 的启动开销,因此不能直接照搬为服务目标。真正有价值的是状态上的结论:0 和 1,000 ms 都会在服务器仍为 pending 时放行首轮门禁,而 7,000 ms 能让同一台服务器显示 connected。这里没有测量模型延迟或任务总时长。
先明确就绪条件,再执行正式任务
超时设置只回答“最多等多久”。生产任务还必须回答另一个问题:“哪些工具不可或缺?”
可以采用两段式门禁:
- 启动正式任务前,对每个必需的远程端点或本地服务器命令执行健康检查。对于已配置且获准使用的服务器,
claude mcp list会报告 connected、needs authentication 或 failed to connect 等状态。 - 在 Claude Code 的流式输出中检查
system/init.mcp_servers。要求指定服务器的status: "connected",并拒绝该服务器存在非空mcp_server_errors项的情况。对于带缓存或可选的服务器,则按明确的允许列表处理。
如果必需服务器仍是 pending,应在接受任何业务结果前终止运行。如果它只是可选依赖,则记录降级模式并继续。这样,等待值只是策略的一项输入,而不会被误当作策略本身。
发现结果缓存需要格外谨慎。具有工具列表缓存的远程服务器,初始化时可能显示 pending,直到第一次工具调用才完成连接。这种行为对可选工具很有用,却无法满足严格的就绪承诺。必需工具的门禁应要求实时连接,或自行执行健康检查。
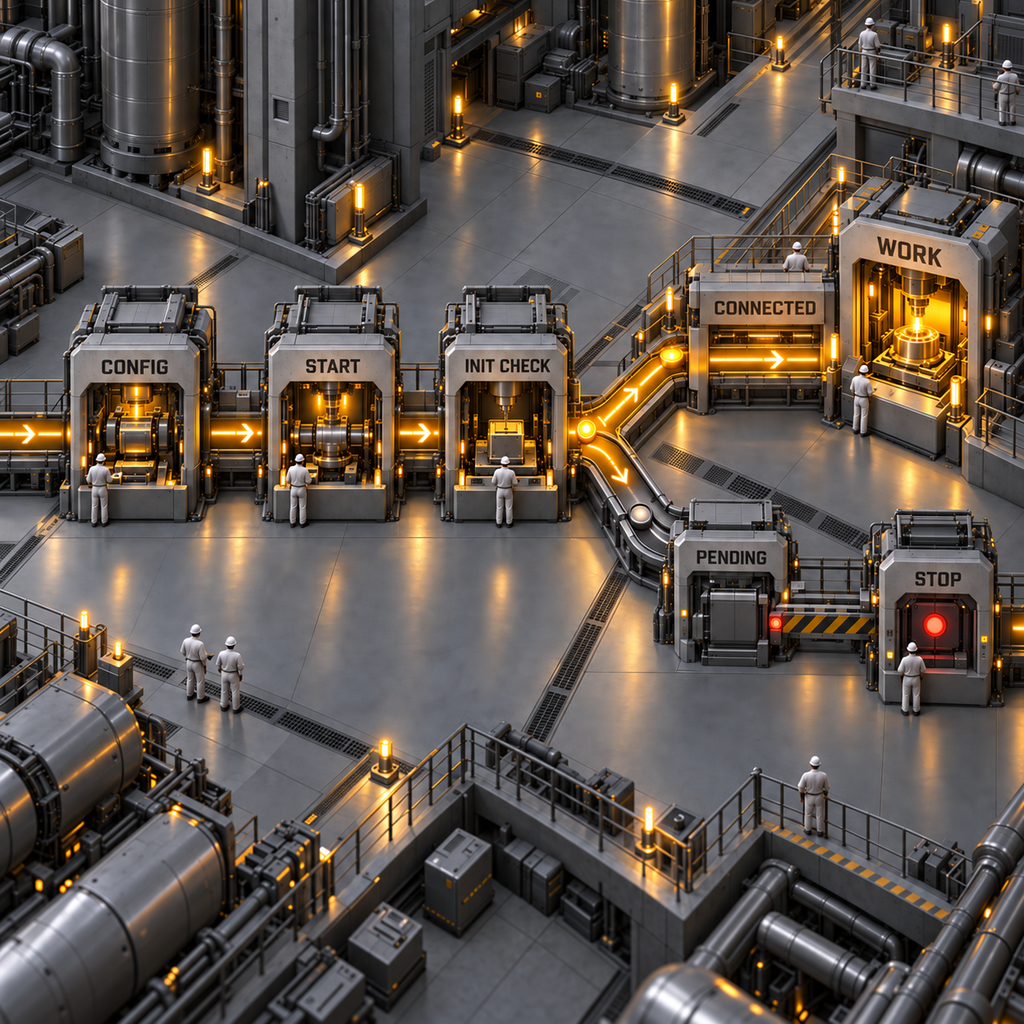
最后,还要在调度器层为整个进程设置截止时间。启动等待无法阻止模型请求、Bash 命令、hook 或后续 MCP 工具调用耗尽剩余的运行窗口。
真正重要的收益,是更快暴露失败
节省的计算资源确实存在,但很容易被夸大。假设每月有 10,000 个任务原本都会完整等待 30 秒,现在把首轮等待预算设为 3 秒,那么最多可释放 4,500 runner 分钟的容量。
GitHub 目前列出的标准 2 核 Linux 托管 runner 价格是每分钟 $0.006,macOS runner 是每分钟 $0.062。按这个费率计算,4,500 分钟在扣除套餐内包含的分钟数之前,分别相当于 $27 的 Linux 时间或 $279 的 macOS 时间。GitHub 还会把每个任务的用量向上取整到整分钟,因此,如果任务总时长仍落在同一个计费区间,缩短 27 秒可能完全不会影响账单。
更大的回报体现在运维上。任务若能在 3 秒内未通过就绪检查,调度器就有时间重试、通知正确的负责人,或切换到备用方案。反之,如果任务在数据库或工单系统缺席的情况下悄然开始,仍可能生成一份看似可信却不完整的结果;发现并撤销这种结果,成本远高于节省下来的 runner 时间。
如果还需要控制超大响应,可参考 Claude Code 工具输出限制指南,它处理的是工作流中另一侧的输出问题。对于无人值守安装和网络策略,可以把这套就绪门禁与按命令控制网络访问配合使用。
最适合这项设置的 7 类工作流
1. 定时财务与运营报告
财务运营人员每天早上 6 点运行一份报告,数据来自仓库 MCP 服务器。把这台服务器标记为必需依赖,在实测冷启动时间上留出少量余量,并在它未连接时停止任务。收益不只是跑得更快,更重要的是避免在实时数据不可用时,仅凭仓库文件生成一份包装精美的报告。
2. 自动化拉取请求风险检查
平台团队会对每个高风险拉取请求运行 Claude Code,并依赖 GitHub、工单系统和安全扫描器提供的工具。门禁可以要求扫描器和 GitHub 必须就绪,同时把工单系统设为可选。这样,开发者会看到快速且可解释的失败,而不是一份悄悄漏掉最关键证据的审查结果。
3. 发布协调任务
发布经理使用定时代理,对比已合并工作、未关闭事故与部署状态。每个数据源都可以有明确的就绪规则。如果部署 MCP 服务器宕机,任务会在起草发布说明之前停止,避免错误暗示本次发布是安全的。
4. 夜间客服分流
客服团队让任务对工单分组、查看账户历史并起草回复。帮助台和客户数据服务器是必需依赖,Slack 则可以是可选依赖。有限的等待时间能让队列持续流转,就绪规则则能防止数据源缺失时猜测客户的私密背景信息。
5. 事故响应助手
值班工程师收到告警后,启动一次非交互式诊断运行。较短的启动预算能立即显示日志和指标是否真的可访问。如果任一必需服务器不可用,外层封装程序可马上转入人工运行手册,避免在事故处置窗口内把时间耗在不完整的诊断上。
6. 自动扩缩容的临时 runner
团队为每个代理任务启动全新容器。本地 stdio 服务器可能需要在冷启动时加载软件包、运行身份验证辅助程序或发现 schema。测量这些启动过程,才能区分一个合理的 7 秒就绪预算,和为不健康服务器长期保留的权宜之计。
7. 多租户代理产品
产品为不同客户提供各自的 MCP 连接:一个租户可能必须使用 Salesforce,另一个依赖 Linear,还有一个完全不需要外部工具。按运行配置必需服务器列表,同一套编排层就能为每个租户选择较短的等待时间,而不必让最慢的集成成为所有人的默认配置。
值得开发的 3 个方向
1. 面向 Claude Code CI 的 MCP 就绪门禁
这是最值得投入的方向。产品可以是一个轻量 runner 封装器:读取必需服务器策略,以显式等待值启动 Claude Code,记录 system/init,并在接受代理结果前返回机器可读的就绪失败信息。
需求虽然垂直,却具有明确的商业价值:claude code automation 在美国每月约有 140 次搜索,建议数据中的年增长率为 200%,CPC 为 $10.88。用户也会搜索如何让 Claude Code 自动运行,以及如何为 Claude Code 配置 MCP。这些都是对安装配置问题的直接表达。
最小可售版本可以是一款 CLI,包含策略文件、GitHub Actions 注解,以及每次运行的 JSON 证据。难点在于分发。Anthropic 可能加入更丰富的原生就绪策略,因此,长期价值必须来自跨运行历史、告警和对多种代理运行时的支持。
2. 超时策略检查器
这款工具可以扫描 shell 脚本、CI 文件、设置和 .mcp.json,找出混用计时器的问题:例如必需工具存在却把启动等待设为 0;任务总截止时间很短,工具超时却长达 28 小时;或某个可选集成没有任何边界。
精确关键词 mcp server timeout 在美国每月约有 10 次搜索,报告的年度趋势为 -67%。相关搜索还包括 MCP_TOOL_TIMEOUT,用户也会询问如何延长 Claude Code 超时。这些需求足以成为就绪门禁中的一个功能,但不足以支撑一家独立公司。
MVP 需要解析 GitHub Actions、常见 shell 语法和 Claude Code MCP 配置,并给出明确的修复建议。难点是避免虚假的安全感:如果没有运行时测量,静态配置无法得知服务器真实的冷启动分布。
3. 定时代理启动遥测
这个产品会把 system/init 事件转换为时间线,展示连接延迟、pending 状态、无效配置和降级运行。平台团队愿意为跨多个代码仓库的趋势和告警付费,而不是逐个手工阅读 JSONL 文件。
它与 claude code automation 共用每月 140 次的搜索需求;claude code browser automation 还带来另外 40 次搜索,其建议数据的年度增长率同样为 200%。更广泛的信号是:团队正把 Claude Code 放进可重复执行的任务中,启动证据也因此变成了运维问题。
MVP 可以包含事件收集器、必需与可选服务器映射,以及就绪状态越过服务目标时的告警。难点是数据敏感性。MCP 名称和工具元数据可能暴露内部系统,因此,脱敏与自托管从一开始就是产品组成部分,而不是留到以后再补的企业功能。
能力边界与坦诚结论
这个控制项只解决可靠自动化中的一个小问题,但很有价值。它不会修复损坏的 MCP 服务器,不会为过期的连接器重新认证,不会缩短后续工具调用,也无法终止整个 Claude Code 进程。
如果任务的第一个有效动作必须依赖 MCP,就不要使用 0。初始化时服务器可能显示 pending,等搜索到相应工具时,等待还会再次出现。也不要为了让不稳定的服务器看起来健康而不断增大这个值。HTTP 和 SSE 服务器会重试首次连接中的临时故障,但身份验证错误和 not-found 错误需要修改配置。更长的等待只会推迟这个事实暴露的时间。
stdio 服务器在会话中途断开后,也不会自动重连。启动窗口再宽裕,也无法说明它在 10 分钟后是否仍然健康。
最好的策略严格而朴素:显式设置较短的首轮等待,列出必需服务器,加入状态门禁,单独设置工具超时,再为任务套上外层截止时间。这套组合带来的是有用的失败,而不是莫名其妙的延迟。
如何延长 Claude Code 超时时间?
先确认变慢的是哪个阶段,再选择对应的超时设置。首轮非交互式执行等待 MCP 就绪,用 CLAUDE_CODE_MCP_STARTUP_WAIT_MS;服务器启动用 MCP_TIMEOUT;工具执行用 MCP_TOOL_TIMEOUT 或单台服务器的 timeout;整个任务则使用 runner 自己的时限。
如何让 Claude Code 自动运行?
使用 -p 或 --print 以非交互方式运行 Claude Code,为无人值守工具定义权限策略,设置调度器层的总截止时间,并显式检查 MCP 就绪状态。仅设置启动等待,并不能保证自动化任务安全可靠。
为什么 Claude Code 总是超时?
先从日志确认超时发生在哪个阶段。system/init 之前的延迟,通常指向启动或连接就绪问题;MCP 工具调用期间的失败,则更可能与工具、空闲或网络请求时限有关;如果进程被 CI 终止,问题通常在外层任务截止时间。
如何为 Claude Code 配置 MCP?
添加项目级或用户级 MCP 配置,也可以通过 --mcp-config 传入文件。对于需要重复执行的任务,请加入 --strict-mcp-config,显式设置首轮等待,并在 system/init 中验证必需服务器,而不要把“已经配置”等同于“已经连接”。
周一先选一个定时 Claude Code 任务,测量其必需 MCP 服务器的冷启动时间,设置最小且符合实际的等待值,并让仍处于 pending 的必需服务器在结果被信任前触发失败。如果希望在整套代理工作流中构建这层可靠性保障,我可以协助搭建生产系统。
- 最近更新
- 2026年9月17日
- 分类
- Build
在 Google 中优先显示本站


把 omidsaffari.com 设为优先来源,Google 会在 Top Stories、AI Overviews 和 AI Mode 中为您优先展示。
Cloudflare 屏蔽 AI 爬虫:保留搜索,拒绝训练
Cloudflare 已重新定义 Training 下的 Block:它可能连 Googlebot、Applebot 和 Bingbot 的搜索抓取一并拦截。本文说明如何允许 Search、选择 Disallow AI Training,核对迁移设置、robots.txt 与爬虫活动,在拒绝模型训练的同时保留搜索收录。2026年9月16日Build
Murmure 语音转文字实测:离线听写值不值得用?
实测 Murmure 1.11.3:免费、离线的桌面语音转文字工具如何用 Parakeet、词典和格式化规则处理技术术语与文件路径。本文还对比 Windows、macOS、Linux 的安装限制,本地与远程 LLM 的隐私边界、速度表现、API 能力和 $0 定价,帮你判断它是否适合日常听写与开发工作流。2026年9月14日Build
RenderIO FFmpeg API 定价拆解:套餐、积分与升级临界点
RenderIO FFmpeg API 每月 $12 起。本文完整拆解 Starter、Growth 与 Business 的命令积分、链式任务、视频下载计费、运行时、存储及 webhook 限制,并算清 838、2,201 等关键升级临界点,帮助你判断何时继续支付超额费、何时换档更省钱。2026年9月14日Build
Dictare 价格拆解:这款语音转文字软件真的零成本吗?
Dictare 是面向编程智能体的免费本地语音转文字软件。本文拆解其 $0 定价、安装与硬件隐性成本,并与 Spokenly 和 Wispr Flow 的免费及付费方案逐项比较,还提供一套可直接套用的成本公式,帮你判断本地运行的所有权成本与托管订阅的跨平台便利,哪一个更适合你的开发工作流。2026年9月13日Build
Claude Code 插件评测实战:用原生 Evals 验证行为变化
Claude Code 2.1.269 已原生支持插件评测。本文从创建行为用例、配置确定性 grader、读取 WITH/W/OUT/Δ 报告,到故意制造回归、控制成本并接入 CI,完整演示如何证明插件确实改变了 Claude 的行为,而不只是通过文件校验,并给出最值得优先测试的场景和两类产品机会。2026年9月12日Build
Cloudflare 语音代理延迟排查:用 turnmetrics 找到真正卡点
Cloudflare 的 turnmetrics 能把每轮语音与文本交互拆成可定位的阶段,并标记 completed、no_output 等结果。本文详解如何读取重叠 timing、设计受控测试,并判断延迟来自转写、模型、TTS 还是浏览器播放,避免凭感觉更换供应商或购买超出需求的语音 QA 工具。2026年9月12日Build
SRT字幕烧录实战:用 Rendi 自动生成带字幕 MP4
用 Rendi 把审核通过的 SRT字幕永久烧录进 MP4。本文从 FFmpeg API 提交、字幕样式和异步任务状态讲到输出验收与字节计费,解释硬字幕与可选字幕轨该怎么选,并给出可直接运行的 Node.js 示例、轮询与 webhook 做法,以及批量处理前的必做检查,适合把字幕渲染接入自动化流程的内容团队与机构。2026年9月11日Build