Claude Haiku 5.5: precios, ahorro y claves para migrar
Consulta los precios de Claude Haiku 5.5, calcula el costo de un millón de llamadas y descubre cuándo conviene migrar o mantener Sonnet en tu aplicación.
Publicado el
 Por Omid Saffari



Claude Haiku 5.5, el modelo pequeño de Anthropic para automatizar tareas frecuentes, cuesta $60 al mes por un millón de llamadas de clasificación breves si cada una consume 500 tokens de entrada y 20 tokens de salida facturados. Es el Claude más económico de la oferta actual, aunque sus tarifas suben cuando el prompt supera los 100,000 tokens. Conviene evaluarlo para clasificar, extraer datos, asignar tareas y resumir; reserva Claude Sonnet 5.5, el modelo más grande y de propósito general de Anthropic, para los trabajos en los que los errores o la programación compleja pesan más que el ahorro en tokens.
Verificado el 8 de octubre de 2026 con el anuncio de Anthropic, la documentación de precios y la descripción de los modelos. Los presupuestos que siguen son ejemplos calculados con supuestos explícitos. Todos los precios son las tarifas de lista de Anthropic en USD.
Claude Haiku 5.5: qué cambia en esta versión
Haiku 5.5 reduce mucho el costo de ejecutar una y otra vez tareas de IA bien delimitadas. Anthropic lo lanzó el 7 de octubre de 2026, con el identificador de API claude-haiku-5-5, y lo presenta como su modelo pequeño más económico hasta ahora. Haiku es la línea de modelos pequeños de la familia Claude: el primer candidato que conviene probar cuando necesitas automatizar decisiones frecuentes y puedes definir con precisión qué respuesta resulta aceptable. Anuncio del lanzamiento.
Frente a Claude Haiku 4.5, el modelo pequeño anterior, esta versión combina tarifas más bajas, mayor capacidad y un nivel de razonamiento ajustable. La diferencia importa para quien funda una empresa y paga por cada etiqueta de un ticket o cada campo extraído. Importa menos si lo más costoso del producto es corregir los errores del modelo.
Anthropic indica que está disponible a través de la Claude API, Amazon Bedrock, Claude Platform on AWS, Google Cloud y Microsoft Foundry. En el anuncio, la disponibilidad en Microsoft aparece como Azure. Al migrar un servicio existente, utiliza la integración y el identificador de modelo que correspondan a tu plataforma. Lista oficial de plataformas.
¿Cuál es la ventana de contexto de Claude Haiku?
Haiku 5.5 ofrece una ventana de contexto de 1M tokens y un máximo de 128K tokens de salida en la API estándar. La ventana de contexto determina cuánto material puede manejar el modelo en una solicitud; el máximo de salida limita lo que puede generar. Haiku 4.5 ofrecía 200K de contexto y 64K de salida. Los límites mayores permiten trabajar con más material, pero indican capacidad: no son una cuota de tokens incluida ni una garantía de calidad. Especificaciones actuales, cambios entre versiones.
También es el primer Haiku con un ajuste del nivel de esfuerzo. El razonamiento adaptativo permite que el modelo decida cuándo razonar y cuánto, y viene activado de forma predeterminada. En la API de Haiku 5.5, el esfuerzo predeterminado es medium. Anuncio, configuración predeterminada y modo de razonamiento.
Para un clasificador sencillo, prueba primero el esfuerzo low. Si la extracción tiene excepciones o instrucciones más estrictas, compara medium y high. Anthropic admite low, medium, high, xhigh y max; recomienda usar los niveles más altos cuando las evaluaciones muestran una mejora y compararlos con Sonnet. Razonar más puede consumir más tokens y tiempo, así que registra el esfuerzo junto con el nombre del modelo en tu presupuesto. Recomendaciones sobre el esfuerzo.
Precios de Claude Haiku: qué cambia al superar 100K tokens
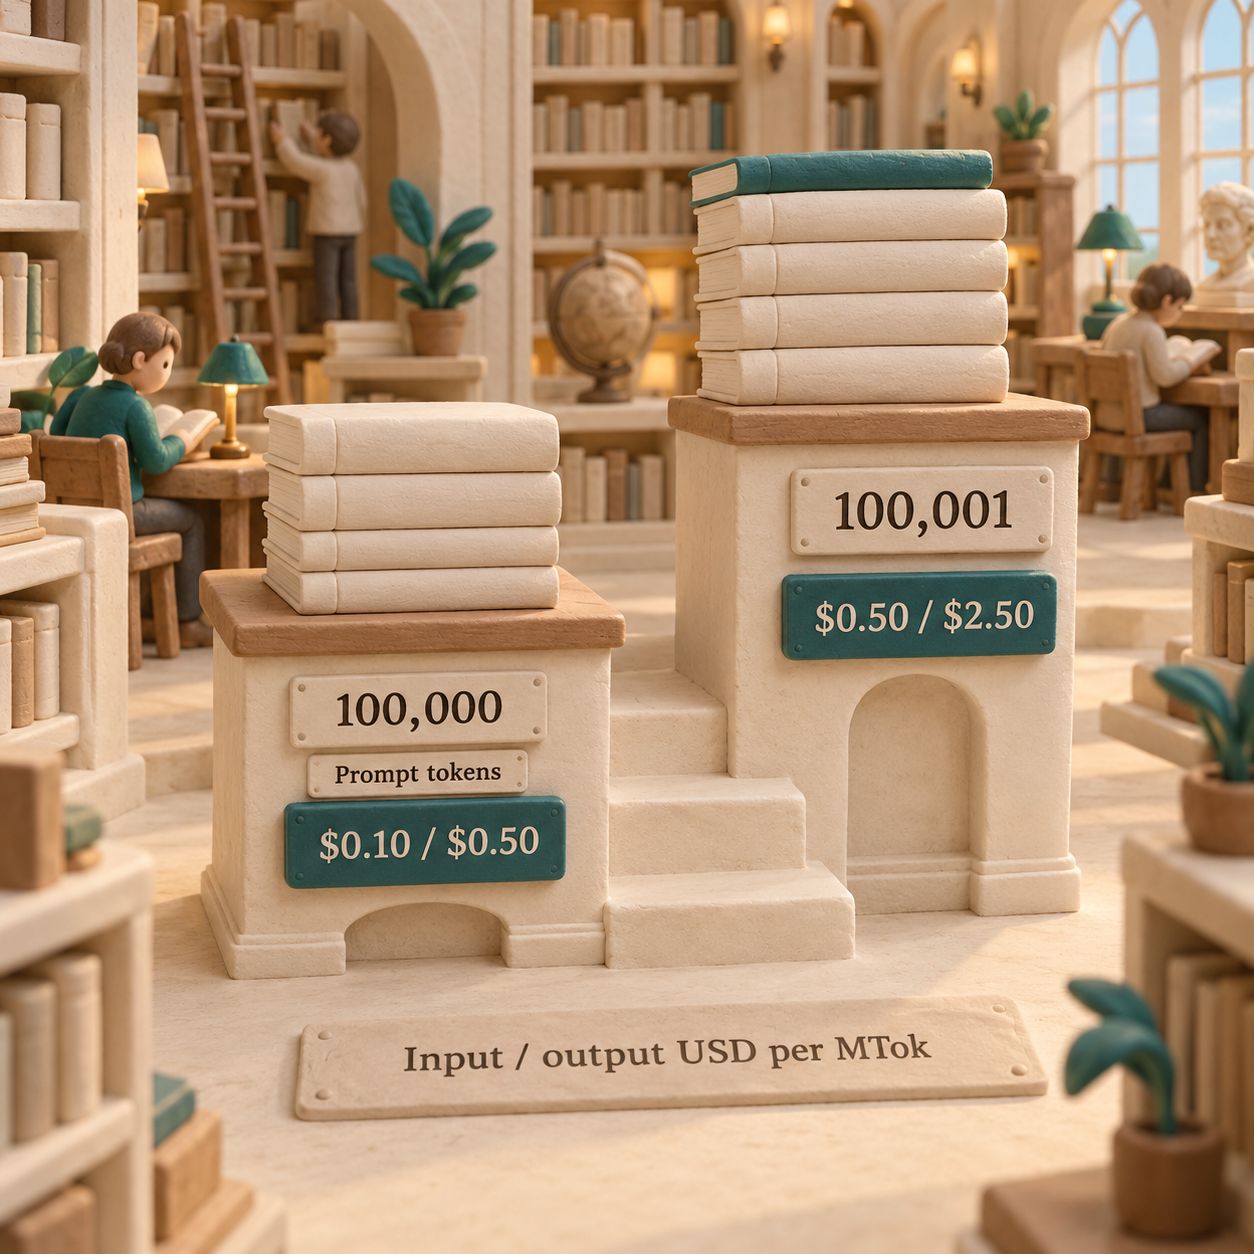
Un prompt de 100,000 tokens recibe la tarifa baja; si es más largo, toda esa solicitud pasa a la tarifa alta. El umbral depende de la longitud de cada prompt, no de la cantidad de tokens que utilice tu cuenta durante el mes.
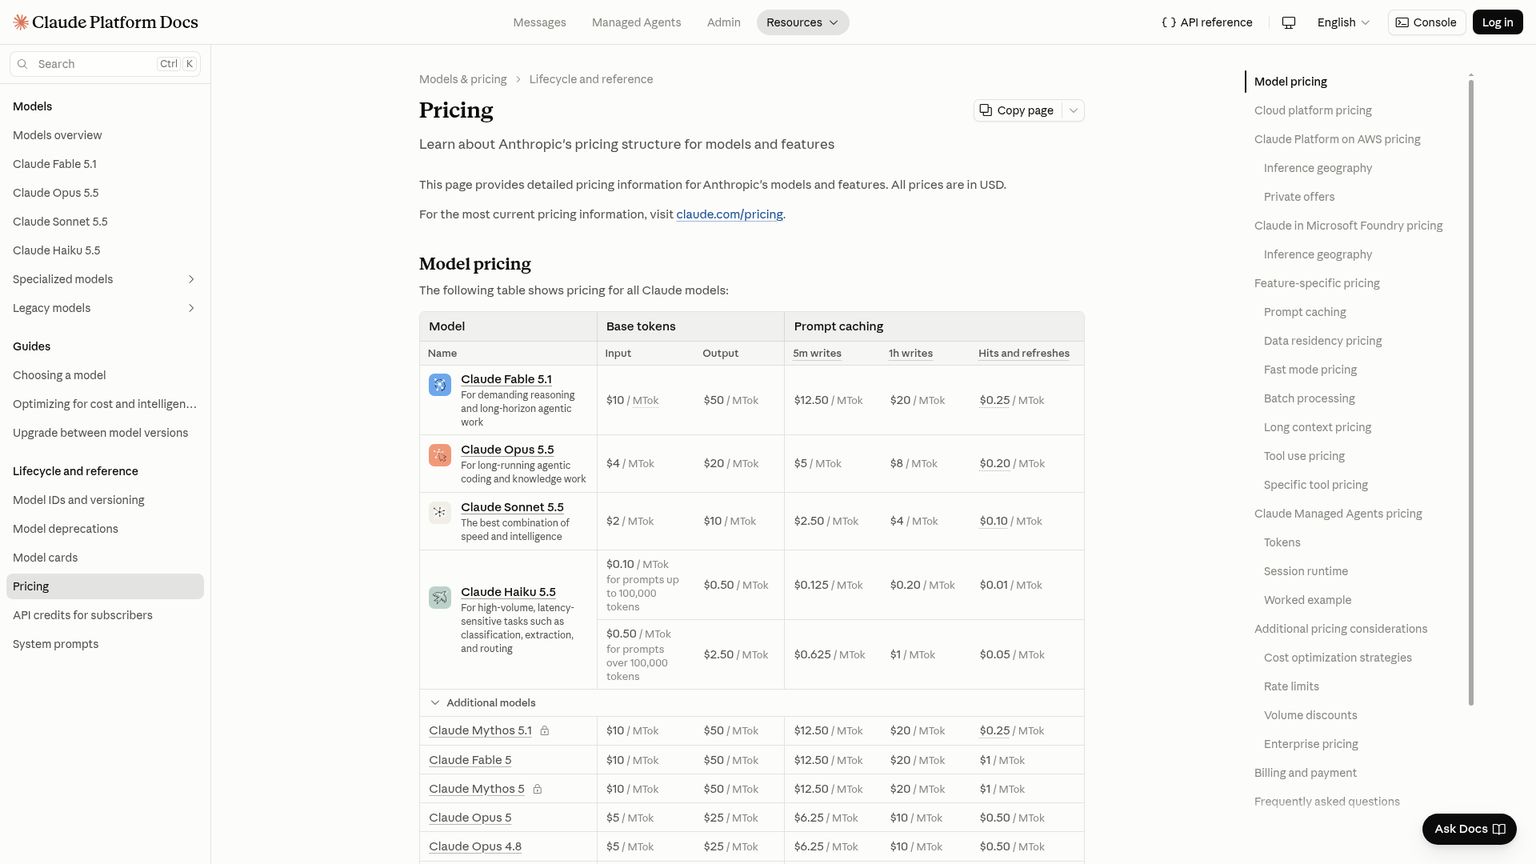
Los tokens son los fragmentos de texto que procesa un modelo. La entrada es lo que envías, incluidas las instrucciones pertinentes, el historial y el material de las herramientas; la salida es lo que genera el modelo. MTok significa un millón de tokens. Estas son las tarifas por MTok:
Fuente: precios de los modelos de Anthropic. Una lectura de caché reutiliza una parte de la entrada; esa tarifa no se aplica a todos los tokens de una solicitud.
Al cruzar el umbral de Haiku, cambia la tarifa de toda la solicitud; el aumento no se limita a los tokens adicionales. Para ilustrarlo, calculamos el costo de una solicitud sin caché con 1,000 tokens de salida, a partir de los tramos publicados:
- 100,000 tokens de entrada: 0.1 × $0.10 + 0.001 × $0.50 = $0.01050.
- 100,001 tokens de entrada: 0.100001 × $0.50 + 0.001 × $2.50 = $0.05250050.
Un solo token de entrada adicional hace que la solicitud pase a tarifas cinco veces mayores. Cambia tanto la tarifa de entrada como la de salida. El cálculo utiliza la tabla de los dos tramos, con entrada sin caché y el mismo supuesto de salida.
En un servicio de resúmenes, reúne el documento pertinente y las instrucciones, y cuenta los tokens de la solicitud completa. Añadir una conversación entera o una colección de documentos ajenos a la tarea puede cambiar el costo. Reduce el contexto o recupera solo el material pertinente cuando eso permita conservar la calidad de la respuesta. Dividir un documento sin criterio puede hacer que se pierda la relación que necesitabas que el modelo explicara.
El procesamiento por lotes reduce a la mitad ambas tarifas
Utiliza el procesamiento por lotes cuando el resultado pueda llegar de forma asíncrona, por ejemplo, para etiquetar durante la noche o resumir documentos pendientes. Las tarifas por lotes de Haiku 5.5 son de $0.05 de entrada/$0.25 de salida por MTok para prompts de hasta 100,000 tokens, y de $0.25/$1.25 por encima de ese umbral. La API Batch aplica un descuento del 50% tanto a la entrada como a la salida. Tarifas por lotes, procesamiento por lotes.
Las solicitudes que deben resolverse en tiempo real necesitan una vía de respuesta que cumpla el plazo de tu aplicación. El procesamiento por lotes sirve para trabajos que pueden esperar: cambia tanto la entrega como el precio.
La lectura de caché a $0.01 exige un prefijo reutilizable que cumpla los requisitos
La caché guarda un prefijo de prompt que se repite, como unas reglas de extracción que no cambian, para reutilizarlo en varias solicitudes. En el tramo bajo de Haiku 5.5, la lectura cuesta $0.01 por MTok, tras una escritura de pago: $0.125 por MTok para una caché de cinco minutos, o $0.20 para una hora. Por encima del umbral de longitud del prompt, los precios son de $0.05 para lecturas, $0.625 para escrituras de cinco minutos y $1 para escrituras de una hora. Precios de la caché.
Haiku 5.5 requiere un mínimo de 512 tokens en el prefijo que se puede guardar en caché. Los prefijos más cortos se procesan sin caché. Un mensaje de cliente que cambia sigue siendo entrada nueva, y una respuesta recién generada sigue siendo salida. Revisa cache_creation_input_tokens y cache_read_input_tokens para comprobar qué ocurrió. Limitaciones de la caché.
La diferencia importa en los clasificadores breves. El prompt completo de 500 tokens del siguiente ejemplo queda por debajo del mínimo de caché. Presupuestar esas llamadas como lecturas de caché subestimaría el gasto.
¿Cuánto cuesta Claude Haiku para un millón de clasificaciones al mes?
La factura mensual del ejemplo es de $60 con Haiku 5.5, $600 con Haiku 4.5 o $1,200 con Sonnet 5.5. La comparación de tarifas corresponde a un clasificador de tickets de soporte de un SaaS que devuelve la cola asignada y una decisión estructurada breve.
El supuesto es de un millón de llamadas al mes, cada una con 500 tokens de entrada nueva y 20 tokens de salida facturados. Se asumen esos mismos consumos facturados para cada modelo por separado. Todos los prompts quedan por debajo del umbral de precio. Este escenario base no utiliza caché, herramientas de servidor con cargos separados ni reintentos.
El consumo mensual es de 500 millones de tokens de entrada y 20 millones de tokens de salida. Los cálculos utilizan las tarifas de lista oficiales:
Bajo estos supuestos, Haiku 5.5 cuesta $0.06 por cada 1,000 clasificaciones. El mismo trabajo por lotes cuesta $30, $300 o $600, respectivamente. Esos totales cubren los tokens del modelo; la infraestructura de la aplicación y cualquier revisión humana se pagan aparte.
Precios de Claude Haiku 4.5: cuánto se ahorra al migrar
La tarifa de Haiku 4.5 de $1 de entrada/$5 de salida por MTok es diez veces la nueva tarifa para prompts cortos. De ahí sale el ahorro mensual de $540 de este ejemplo. Para los prompts de Haiku 5.5 que superan los 100,000 tokens, sus tarifas equivalen a la mitad de las de Haiku 4.5. Precios publicados.
No pierdas de vista el supuesto de igualdad en el consumo de tokens. Anthropic señala que el tokenizador actualizado de Haiku 5.5 utiliza algo más de tokens por tarea. El tokenizador es el sistema que divide el texto en tokens que se pueden contar. Antes de estimar el ahorro de tu propio trabajo, vuelve a contar la misma entrada con el modelo nuevo y mide la salida facturada, incluido el razonamiento. Nota de Anthropic sobre el tokenizador, conteo de tokens.
Los veinte tokens de salida son un supuesto, no un límite que debas copiar en todas las solicitudes. El razonamiento también consume capacidad de salida. Si el modelo necesita razonar antes de devolver la etiqueta, la salida facturada real puede superar la respuesta breve que ves. Evalúa un esfuerzo menor y un límite de salida que deje espacio suficiente para terminar. Razonamiento y límites de salida.
Para comparar otros proveedores, aplica la misma carga de trabajo y los mismos criterios de aceptación con la comparativa de las API de IA más económicas. Una tarifa anunciada más baja resulta útil cuando permite obtener un resultado aceptable dentro de tu presupuesto.
Cómo aplicar el cambio al desarrollar, operar o contratar
Migra primero la parte repetible del trabajo. Clasificar, extraer datos, asignar tareas, resumir y ejecutar subagentes son buenos candidatos porque permiten acotar las entradas e inspeccionar las salidas. Anthropic orienta Haiku a este tipo de trabajo de gran volumen. Posicionamiento del modelo.
Desarrollo: dale a Haiku una tarea bien delimitada
Si tu empresa cuenta con financiación, empieza con el clasificador de tickets de soporte del presupuesto anterior. Define las colas permitidas, incluye el ticket y exige una sola decisión. Establece también un destino para los casos que queden sin resolver. Una validación puede rechazar una etiqueta que no pertenezca al conjunto permitido; una muestra evaluada puede detectar etiquetas aparentemente válidas que asignan el ticket a la cola equivocada.
Quien desarrolla por su cuenta puede utilizar Haiku para una extracción igual de acotada: obtener la fecha de renovación y el identificador de contrato de un documento, conservar el texto que los respalda y verificar el formato de la fecha. Evita encargarle al modelo decidir qué condiciones comerciales prevalecen sobre otras hasta que tu evaluación cubra esas excepciones.
Operaciones: reduce el trabajo antes de recortar el presupuesto
Para un CTO de una empresa mediana, recuperar el contexto pertinente puede importar más que el límite de contexto anunciado. Dale al modelo que resume la reunión o la sección de la política que corresponda y evalúa si conserva decisiones, responsables y excepciones. Un resumen que omite una obligación sin advertirlo genera trabajo en otra parte de la organización.
Un responsable sénior que elija un sistema de asignación debe medir los tickets mal asignados, los casos sin resolver y el tiempo hasta obtener una decisión aceptable. Define cuándo escalar a partir de evidencia observable: campos obligatorios ausentes, pasajes contradictorios en las fuentes, una categoría no admitida o una comprobación fallida. La confianza que declara el propio modelo no basta por sí sola como política de asignación.
Compras: define la unidad por la que quieres pagar
Pide al proveedor un costo por extracción aceptada o por caso completado que incluya el conteo de tokens, el esfuerzo, los reintentos y la revisión. El presupuesto de $60 del clasificador dice poco sobre un servicio que reintenta repetidamente las solicitudes fallidas o envía un manual extenso de políticas con cada ticket.
En el caso de los subagentes, es decir, modelos que reciben tareas pequeñas dentro de un proceso más amplio, asigna a Haiku un trabajo acotado de recopilación de evidencia. Puede ser el candidato que localice un pasaje pertinente o devuelva un resumen breve mientras Sonnet se ocupa de la decisión general. Evalúa ese traspaso: el modelo más grande necesita suficiente material de origen para comprobar el trabajo del subagente.
Claude Haiku vs Sonnet: cómo elegir entre ambos
Elige Haiku cuando la respuesta sea acotada y fácil de verificar; conserva Sonnet cuando el éxito dependa del criterio, la coordinación o la capacidad de recuperarse de errores. Las tarifas de Sonnet 5.5 para tokens nuevos son 20 veces las de Haiku para prompts cortos y cuatro veces las de sus prompts largos. Ese sobreprecio debe traducirse en mejores resultados aceptados.
La tabla del lanzamiento de Anthropic justifica evaluar el nuevo Haiku, pero también da motivos para conservar Sonnet en los trabajos de programación más difíciles. Los siguientes son resultados de evaluaciones de rendimiento publicados por Anthropic, en el orden Haiku 5.5, Haiku 4.5 y OpenAI GPT-6 Luna:
- GDPval-AA v2.1, trabajo de conocimiento: 1620, 735 y 1437.
- OSWorld 2.1, subconjunto sin conexión, uso de equipos informáticos: 72.4%, 15.7% y 48.9%.
- Terminal-Bench 4.0, programación con agentes: 39.2%, 0.0% y 16.4%. Anthropic informa de un 70.6% para Sonnet 5.5 en esta evaluación.
Fuente: tabla de rendimiento de Anthropic. Las puntuaciones responden a preguntas sobre esas tareas de evaluación. No establecen una tasa de aceptación para tus contratos, tickets o código.
Mantén Sonnet al frente de un cambio que abarque todo un repositorio y exija descubrir dependencias, coordinar modificaciones y recuperarse de pasos fallidos. Considera Haiku para una subtarea, como resumir un archivo o extraer un fallo de prueba concreto. En el anuncio, la propia Anthropic recomienda los modelos más grandes para la programación compleja con agentes.
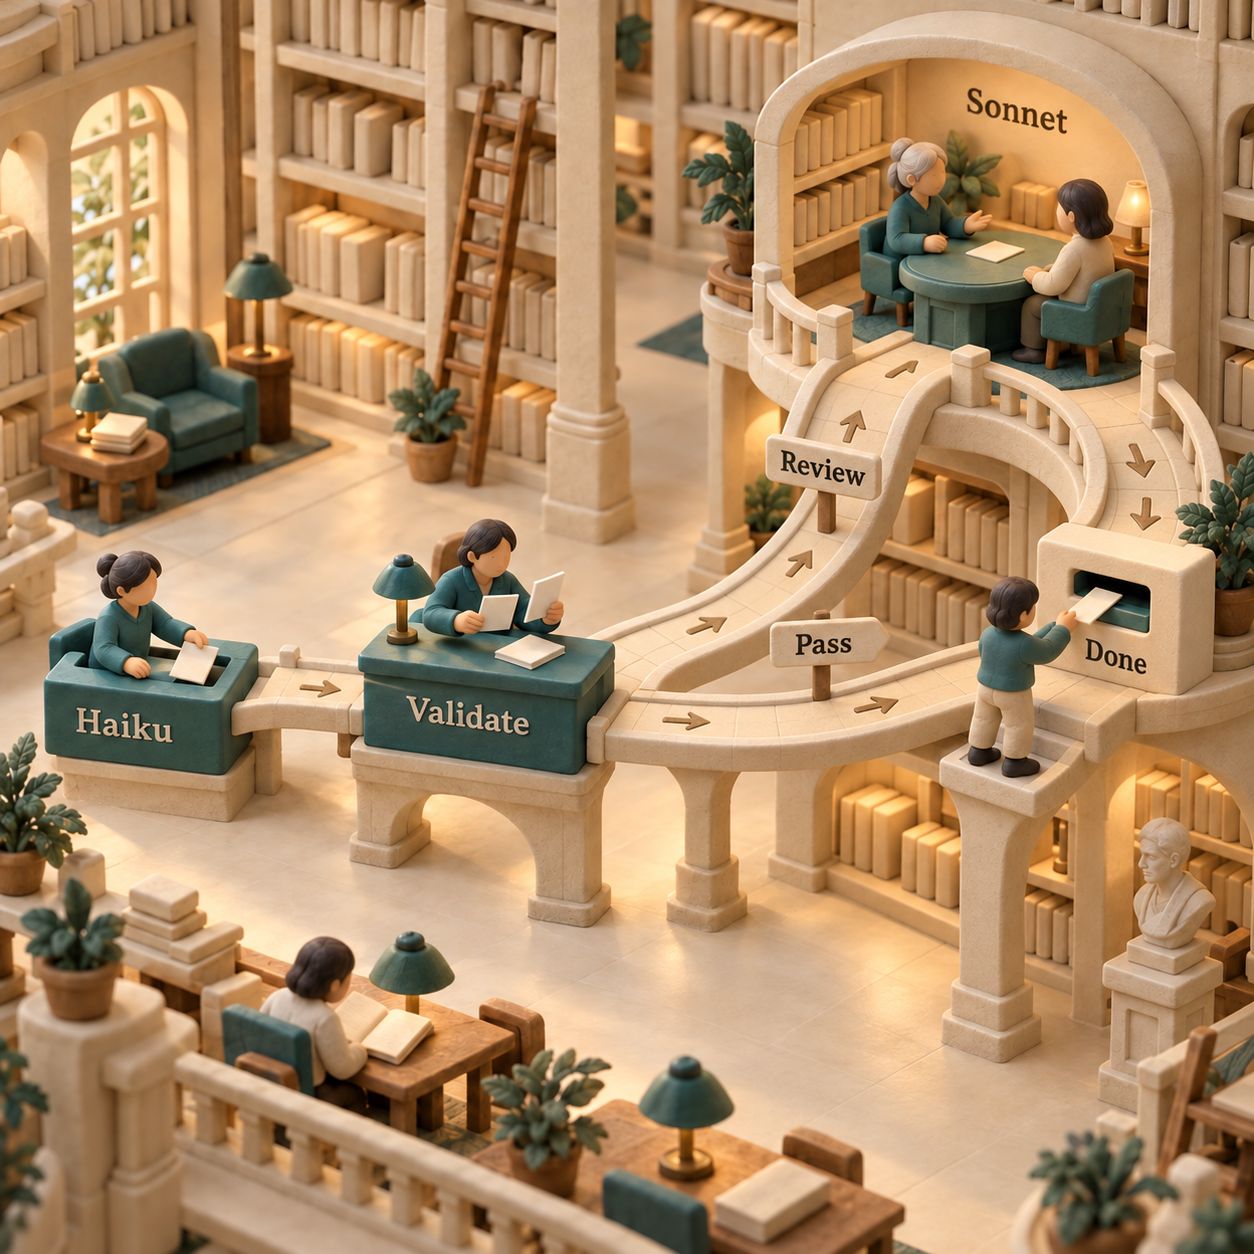
Valida primero y recurre a Sonnet cuando haga falta
En un proceso mixto ilustrativo, todas las clasificaciones pasan por Haiku y las validaciones fallidas o los casos sin resolver se envían a Sonnet. Si el 10% necesita una llamada adicional a Sonnet, con los mismos consumos de tokens del escenario base, la factura mensual es de $60 + $120 = $180. Son $1,020 menos que ejecutar todas las llamadas con Sonnet. El ejemplo excluye la infraestructura de validación y asume que la segunda llamada no necesita contexto adicional.
La primera llamada a Haiku se sigue facturando en cada caso escalado. Una previsión que solo incluya el modelo que finalmente resuelve el caso omite ese costo. Mide los reintentos como intentos por trabajo completado y compara también el tiempo total, además de los tokens.
Utiliza la guía de configuración de Sonnet 5.5 para la vía del modelo más grande. Al presupuestar, aplica la tarifa actual de $0.10 por MTok de lectura de caché, verificada aquí; Anthropic la redujo desde $0.20 el 7 de octubre. Cambio de precio.
API de Claude Haiku 4.5: cómo migrar a 5.5
Cambiar de modelo exige revisar la integración, además de sustituir su nombre. Un servicio que funcionaba con Haiku 4.5 puede fallar por los parámetros de la solicitud, la lectura de la respuesta o los límites de salida, aunque el modelo nuevo resuelva bien la tarea.
Sigue la guía de migración a Haiku de Anthropic para tu plataforma. Estos son los cambios que más pueden afectar al servicio:
- Actualiza el identificador y vuelve a contar los tokens. Utiliza
claude-haiku-5-5en la Claude API. Recuenta los prompts con ese modelo y revisa las estimaciones de costo y los límites de salida. - Actualiza los ajustes de razonamiento y muestreo. Sustituye el razonamiento manual con
thinking.type: enabledybudget_tokenspor razonamiento adaptativo. Configuraoutput_config.effortsegún la carga de trabajo. Eliminatemperature,top_pytop_kconforme a las instrucciones de la guía. - Elimina el prellenado del asistente. Se rechaza un mensaje final del asistente que se proporcione para que el modelo lo continúe. Termina la solicitud con un turno del usuario y elige el mecanismo de formato de salida compatible con tu plataforma.
- Lee los bloques de respuesta según su tipo. Una respuesta puede empezar con un bloque de razonamiento. Selecciona los bloques de texto o de uso de herramientas que necesites y contempla que se agote la capacidad de salida antes de que aparezca una respuesta visible.
- Gestiona los rechazos y la reutilización de conversaciones. Si
stop_reasonesrefusal, deriva el caso a una vía prevista en la aplicación. Si vuelves a enviar el razonamiento, conserva los bloques sin cambios, utiliza la cuenta que los generó o una vinculada y sigue las reglas de la guía sobre mantener intacto el prefijo.
Para un CTO con un compromiso de capacidad en Priority Tier, hay otro motivo para esperar: la guía de migración de Anthropic indica que Haiku 5.5 no admite Priority Tier. Define una vía de capacidad aceptable antes de migrar la cola. Los tokens baratos no sustituyen un requisito de servicio. Limitación de capacidad.
Retirada de Haiku: revisa el estado, además de la fecha
A fecha del 8 de octubre de 2026, la página de obsolescencia de Anthropic muestra Haiku 4.5 como activo, con retirada no antes del 15 de octubre de 2026. Esa fecha marca un límite mínimo; no anuncia el cierre del servicio para ese día. También muestra Haiku 5.5 como activo, con retirada no antes del 7 de octubre de 2027. Estado de los modelos de la Claude API.
Para las integraciones más antiguas, Haiku 3.5 se retiró de la Claude API el 19 de febrero de 2026, y Haiku 3 el 20 de abril de 2026. Son fechas de retirada que figuran en la página del ciclo de vida de la API, no un calendario deducido del lanzamiento de 5.5. Historial de retirada de modelos.
Planifica la migración desde Haiku 4.5 según los resultados de la evaluación y la preparación de la integración. Su estado actual deja margen para decidir con criterio; sigue consultando la página oficial del ciclo de vida para conocer cualquier anuncio de retirada.
Qué promesas conviene mirar con cuidado
Tres afirmaciones atractivas necesitan matices antes de servir de base para un presupuesto o una decisión de arquitectura.
«90% más barato» describe la diferencia de tarifa para prompts cortos. No garantiza una reducción del 90% en el costo de completar el mismo trabajo. La tokenización, el razonamiento, la longitud de las solicitudes, los intentos repetidos y los casos escalados afectan a la factura. El ejemplo con consumos iguales aísla el efecto del precio; tus consumos observados determinan la previsión.
Una ventana de un millón de tokens no hace baratos los prompts largos. El tramo alto de Haiku empieza mucho antes de alcanzar ese límite de capacidad. Un servicio de resúmenes que arrastra historial irrelevante en cada solicitud puede gastar más sin producir un resumen mejor. Cuenta los tokens del prompt una vez preparado y deja espacio suficiente para la salida que necesitas.
Ajustar el esfuerzo no permite que Haiku resuelva todas las tareas de Sonnet. Conviene evaluar un esfuerzo mayor cuando corrige un fallo observado. Incluye a Sonnet en esa evaluación si el problema requiere programar de forma sostenida o tomar decisiones difíciles. Compara los resultados completados y el tiempo transcurrido, con los reintentos incluidos.
La reducción de la tarifa de lectura de caché de Sonnet también cambia la comparación para un agente existente. Recalcula su factura actual antes de decidir la migración: reutilizar repetidamente la entrada ahora cuesta menos con Sonnet, mientras que la entrada nueva y la salida mantienen sus tarifas de lista. La guía de precios de la Claude API sitúa este lanzamiento dentro del presupuesto más amplio de modelos y funciones.
Qué hacer esta semana
Empieza ahora con una tarea acotada y un criterio claro de aceptación. Espera si aún no has resuelto los requisitos de calidad o capacidad de la cola. Quien paga por clasificaciones repetidas tiene un candidato inmediato para evaluar; un CTO que depende de Priority Tier necesita resolver primero la capacidad. Un servicio que ya cumple sus objetivos de presupuesto y calidad puede conservar el modelo actual mientras se realiza la comparación.
Elige una cola y define qué resultado es aceptable
Utiliza entradas representativas con respuestas correctas conocidas, incluidos los casos ambiguos y difíciles. Especifica qué errores requieren revisión y qué fallos pueden reintentarse de forma segura. Empieza con clasificación, extracción o un resumen acotado.
Mide el mismo trabajo con cada modelo candidato
Ejecuta Haiku 4.5, Haiku 5.5 y Sonnet 5.5 con esas entradas y ajustes de esfuerzo adecuados. Registra los conteos de entrada de cada modelo, la salida facturada, el tiempo de los trabajos completados y los resultados aceptados. Incluye todos los intentos en el cálculo del costo. Utiliza los conteos del tokenizador nuevo para comprobar en qué tramo de longitud cae el prompt.
Migra la parte que pase la evaluación y conserva una vía para escalar
Completa las comprobaciones de migración y traslada el subconjunto cuya calidad y costo observados cumplan tus requisitos. Valida las salidas, inspecciona los fallos y conserva Sonnet para el trabajo más difícil. El éxito consiste en obtener una decisión aceptada a menor costo y con la rapidez que necesitas.
Recibe las próximas novedades sobre modelos y presupuestos de API en el boletín.
- Publicado
- Categoría
- AI
- Idioma
Alternativas a Otter AI: cuál elegir según tu trabajo
Compara las alternativas a Otter AI por sus precios, límites gratuitos, transcripción sin bots e integración con CRM. Elige según lo que necesitas.8 oct 2026AI
Mistral Large 4: cuánto cuesta y cuándo conviene usarlo
Precios de Mistral Large 4, oferta de lanzamiento y pesos abiertos: qué dicen sus benchmarks y cuándo conviene probar la API o esperar al despliegue propio.7 oct 2026AI
Lindy AI como asistente de IA: análisis, precios y límites
Analizamos Lindy AI como asistente de IA: precios, créditos, correo, reuniones y límites de aprobación para decidir si encaja con el trabajo de tu empresa.7 oct 2026AI
Precios de Mistral (2026): cuánto cuestan la API y Vibe
Consulta los precios de Mistral: tarifas de API, planes de Vibe y Le Chat, límites gratuitos, alojamiento en la UE y un ejemplo de factura mensual.6 oct 2026AI
Skills de Claude: crea tu informe semanal de clientes
Crea skills de Claude para preparar informes semanales de clientes con datos validados. Guía paso a paso para instalarlas y compartirlas en tu equipo.6 oct 2026AI
Agentes de IA como empleados: qué delegar y cuánto cuestan
Qué tareas delegar a los agentes de IA, precios de seis herramientas y cómo evaluar una prueba de 30 días con revisión humana antes de ampliar sus permisos.6 oct 2026AI
Dictado por voz: qué alternativa a Wispr Flow elegir
Compara alternativas a Wispr Flow para dictado por voz: precios, privacidad sin internet, funciones de equipo y opciones para trabajar con agentes de IA.5 oct 2026AI