Claude Haiku 5.5 : combien coûte-t-il et faut-il l’adopter ?
Claude Haiku 5.5 : tarifs API, seuil de 100K tokens et budget mensuel face à Haiku 4.5 et Sonnet 5.5. Identifiez les tâches à lui confier en priorité.
Publié le
 Par Omid Saffari



Claude Haiku 5.5, le petit modèle d’Anthropic destiné aux tâches automatisées fréquentes, revient à $60 par mois pour un million d’appels de classification courts, à raison de 500 tokens en entrée et de 20 tokens facturés en sortie par appel. C’est actuellement le modèle Claude le moins cher, avec des tarifs qui augmentent dès que le prompt dépasse 100,000 tokens. Testez-le pour la classification, l’extraction, le routage et les résumés. Gardez Claude Sonnet 5.5, le modèle généraliste de plus grande taille d’Anthropic, pour les tâches où le coût des erreurs ou la complexité du code pèsent davantage que les économies de tokens.
Vérifié le 8 octobre 2026 à partir de l’annonce d’Anthropic, de la documentation tarifaire et de la présentation des modèles. Les budgets ci-dessous sont des exemples calculés selon des hypothèses explicites. Tous les prix correspondent aux tarifs catalogue d’Anthropic en USD.
Claude Haiku 5.5 : qu’est-ce qui change ?
Haiku 5.5 réduit fortement le coût des tâches d’IA bien délimitées que l’on exécute à répétition. Anthropic l’a lancé le 7 octobre 2026, sous l’identifiant API claude-haiku-5-5, et le présente comme son petit modèle le moins cher à ce jour. Haiku est la gamme de petits modèles de la famille Claude : un premier candidat à tester pour automatiser des décisions fréquentes, à condition de pouvoir définir précisément ce qu’est une réponse acceptable. Annonce du lancement.
Par rapport à Claude Haiku 4.5, le précédent petit modèle, cette version associe des tarifs plus bas, une capacité accrue et un effort de raisonnement réglable. L’intérêt est évident pour un fondateur qui paie chaque catégorisation de ticket ou chaque champ extrait. Il l’est moins pour un produit dont le principal poste de coût reste la correction des erreurs du modèle.
Anthropic annonce une disponibilité via Claude API, Amazon Bedrock, Claude Platform on AWS, Google Cloud et Microsoft Foundry. Dans son annonce, l’accès chez Microsoft est désigné sous le nom Azure. Pour migrer un service existant, utilisez l’intégration et l’identifiant de modèle propres à votre plateforme. Liste officielle des plateformes.
Quelle fenêtre de contexte pour Claude Haiku ?
Dans l’API standard, Haiku 5.5 dispose d’une fenêtre de contexte de 1M tokens et d’un maximum de 128K tokens en sortie. La fenêtre de contexte correspond à la quantité d’informations que le modèle peut prendre en compte dans une requête ; la limite de sortie plafonne ce qu’il peut générer. Haiku 4.5 proposait 200K tokens de contexte et 64K en sortie. Ces limites plus élevées permettent de traiter des contenus plus longs. Elles indiquent une capacité, sans constituer un forfait de tokens ni garantir la qualité du résultat. Caractéristiques actuelles, évolutions de cette version.
C’est aussi le premier Haiku dont l’effort de raisonnement est réglable. Le raisonnement adaptatif, activé par défaut, laisse le modèle décider quand raisonner et jusqu’où. Dans l’API, l’effort par défaut de Haiku 5.5 est medium. Annonce, réglage par défaut et mode de raisonnement.
Pour un classificateur simple, commencez par tester l’effort low. Pour une extraction qui doit gérer des exceptions ou respecter des consignes plus strictes, comparez medium et high. Anthropic prend en charge low, medium, high, xhigh et max. L’entreprise recommande les réglages les plus élevés lorsque l’évaluation montre un gain, en les comparant à Sonnet. Un raisonnement plus poussé peut consommer davantage de tokens et de temps : dans votre budget, consignez le niveau d’effort avec le nom du modèle. Recommandations sur l’effort.
Prix API de Claude Haiku : le seuil de 100K tokens
Un prompt de 100,000 tokens bénéficie du tarif bas ; au-delà, toute la requête passe au tarif supérieur. Le seuil s’applique à la longueur de chaque prompt, quel que soit le nombre de tokens consommés par votre compte dans le mois.
Les tokens sont les unités de texte traitées par le modèle. L’entrée comprend ce que vous envoyez : consignes pertinentes, historique et contenu provenant des outils. La sortie correspond à ce que le modèle génère. MTok désigne un million de tokens. Voici les tarifs par MTok :
Source : tarifs des modèles Anthropic. Une lecture du cache concerne une partie de l’entrée réutilisée ; son tarif ne s’applique pas à tous les tokens de la requête.
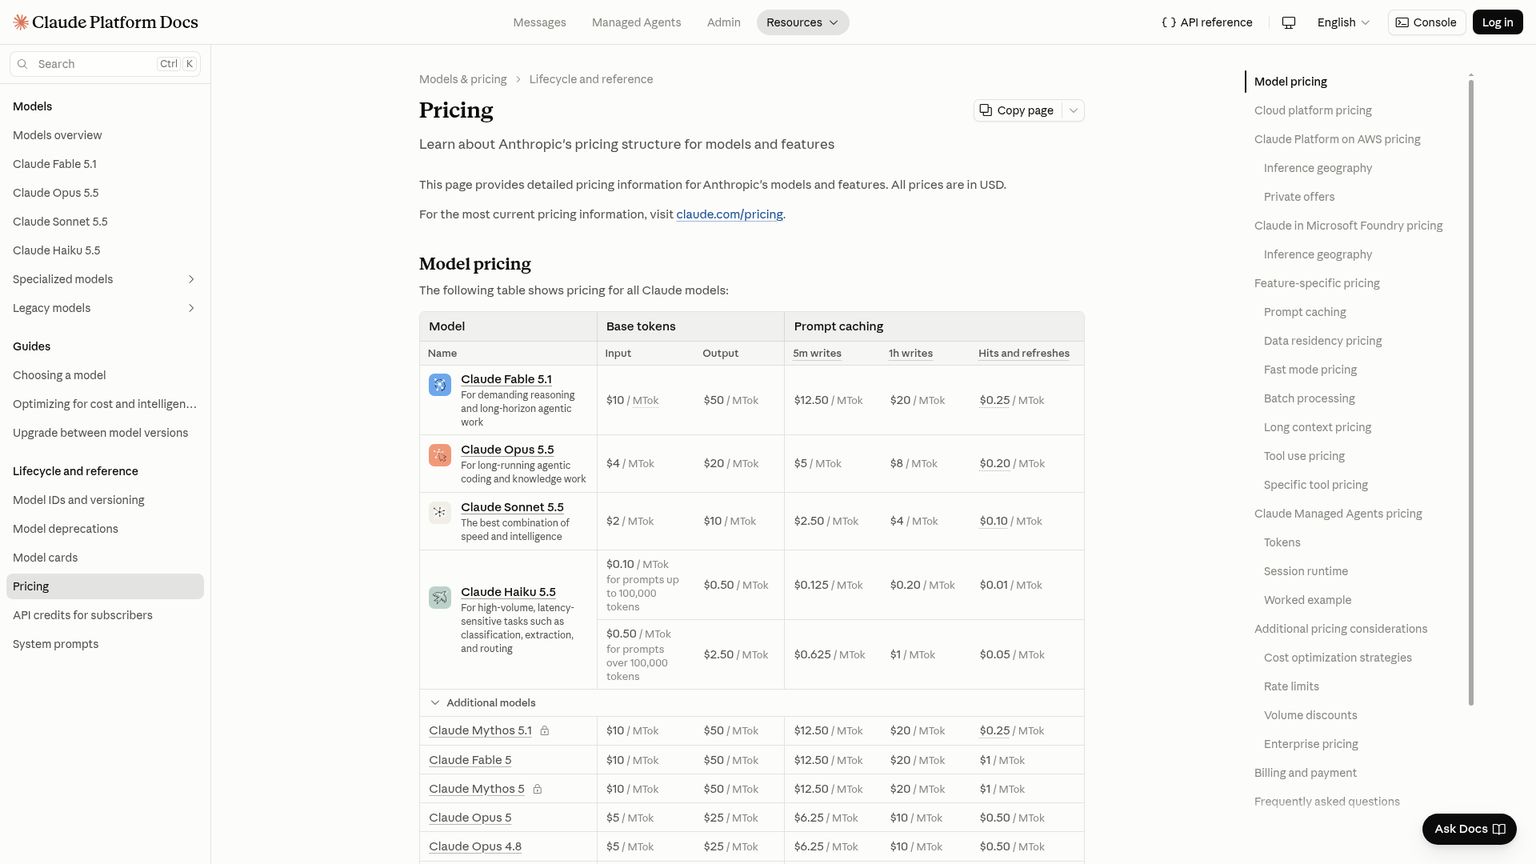
Chez Haiku, franchir ce seuil change le tarif de toute la requête, sans limiter la hausse aux tokens excédentaires. Pour illustrer l’effet sur une requête sans cache produisant 1,000 tokens en sortie, voici notre calcul à partir des paliers publiés :
- 100,000 tokens en entrée : 0.1 × $0.10 + 0.001 × $0.50 = $0.01050.
- 100,001 tokens en entrée : 0.100001 × $0.50 + 0.001 × $2.50 = $0.05250050.
Un seul token supplémentaire en entrée fait passer la requête à des tarifs cinq fois plus élevés. Le tarif d’entrée et celui de sortie changent tous les deux. Ce calcul repose sur la grille à deux paliers, avec une entrée hors cache et la même hypothèse de sortie.
Pour un service de résumé, réunissez le document pertinent et les consignes, puis comptez les tokens de cette requête complète. Ajouter toute une conversation ou une collection de documents sans rapport peut modifier le coût. Réduisez le contexte ou récupérez uniquement les passages utiles lorsque cela préserve la qualité de la réponse. Découper un document sans discernement peut faire perdre le lien que le modèle devait expliquer.
Le traitement par lots divise les deux tarifs par deux
Utilisez le traitement par lots lorsque le résultat peut arriver de façon asynchrone, par exemple pour un étiquetage nocturne ou un stock de documents à résumer. Les tarifs par lots de Haiku 5.5 sont de $0.05 en entrée/$0.25 en sortie par MTok pour les prompts jusqu’à 100,000 tokens, et de $0.25/$1.25 au-delà. La Batch API réduit les tarifs d’entrée et de sortie de 50%. Grille tarifaire par lots, traitement par lots.
Pour le routage de requêtes en direct, conservez un circuit de réponse qui respecte le délai de votre application. Le traitement par lots convient aux tâches qui peuvent attendre : il modifie le mode de livraison autant que le prix.
Le tarif de cache à $0.01 exige un préfixe réutilisable éligible
La mise en cache conserve un préfixe de prompt répété, comme des règles d’extraction inchangées, pour le réutiliser d’une requête à l’autre. Au palier bas de Haiku 5.5, la lecture coûte $0.01 par MTok, après une écriture payante : $0.125 par MTok pour un cache de cinq minutes, ou $0.20 pour une heure. Au-delà du seuil de longueur du prompt, les prix passent à $0.05 en lecture, $0.625 pour une écriture de cinq minutes et $1 pour une écriture d’une heure. Tarifs du cache.
Pour Haiku 5.5, le préfixe pouvant être mis en cache doit compter au moins 512 tokens. En dessous, la requête s’exécute sans cache. Un message client qui change reste facturé comme une entrée hors cache, et toute réponse nouvellement générée reste une sortie. Consultez cache_creation_input_tokens et cache_read_input_tokens pour vérifier ce qui s’est réellement passé. Limites du cache.
Cette distinction compte pour les classificateurs à prompts courts. Le prompt complet de 500 tokens utilisé dans l’exemple suivant est inférieur au minimum requis pour la mise en cache. Un budget qui facturerait ces appels au tarif de lecture du cache sous-estimerait la dépense.
Claude Haiku : quel budget pour un million de classifications par mois ?
Dans cet exemple, la facture mensuelle s’élève à $60 avec Haiku 5.5, $600 avec Haiku 4.5 ou $1,200 avec Sonnet 5.5. La comparaison porte sur un classificateur de tickets d’assistance pour un SaaS, qui renvoie le nom d’une file de traitement et une courte décision structurée.
Nous supposons un million d’appels par mois, consommant chacun 500 tokens d’entrée hors cache et 20 tokens de sortie facturés. Ces volumes facturés sont supposés identiques pour chaque modèle. Tous les prompts restent sous le seuil tarifaire. Ce scénario de référence n’utilise ni cache, ni outil exécuté côté serveur facturé séparément, ni nouvelle tentative.
La consommation mensuelle atteint 500 millions de tokens en entrée et 20 millions en sortie. Le calcul applique les tarifs catalogue officiels :
Dans ces conditions, Haiku 5.5 coûte $0.06 pour 1,000 classifications. Le même travail effectué par lots revient respectivement à $30, $300 ou $600. Ces montants couvrent les tokens des modèles ; l’infrastructure de votre application et les éventuelles vérifications humaines restent à ajouter.
Combien coûte encore Claude Haiku 4.5 ?
Les $1 en entrée/$5 en sortie par MTok de Haiku 4.5 représentent dix fois le nouveau tarif des prompts courts. D’où une économie mensuelle de $540 dans notre exemple. Pour les prompts de Haiku 5.5 qui dépassent 100,000 tokens, l’écart se réduit : ses tarifs sont alors la moitié de ceux de Haiku 4.5. Tarifs publiés.
Gardez bien visible l’hypothèse de volumes de tokens identiques. Selon Anthropic, le système de tokenisation mis à jour dans Haiku 5.5 utilise légèrement plus de tokens par tâche. Ce système découpe le texte en tokens que l’on peut compter. Avant d’estimer vos économies, recomptez la même entrée avec le nouveau modèle et mesurez la sortie facturée, raisonnement compris. Note d’Anthropic sur la tokenisation, comptage des tokens.
Les vingt tokens de sortie sont une hypothèse de calcul, pas une limite à recopier dans chaque requête. Le raisonnement consomme lui aussi de la capacité de sortie. Si le modèle doit raisonner avant de renvoyer une catégorie, la sortie réellement facturée peut dépasser la courte réponse visible. Testez un effort plus faible et un plafond de sortie qui laisse assez de marge pour terminer. Raisonnement et limites de sortie.
Pour comparer d’autres fournisseurs, appliquez la même charge de travail et les mêmes critères de validation au comparatif des API d’IA les moins chères. Un tarif affiché plus bas est utile lorsqu’il permet d’obtenir un résultat validé dans votre budget.
Développeurs, responsables techniques, acheteurs : comment l’utiliser ?
Migrez d’abord la partie répétitive du travail. Classification, extraction, routage, résumés et sous-agents sont de bons candidats : vous pouvez en limiter les entrées et contrôler les sorties. Anthropic positionne Haiku sur ces usages à gros volume. Positionnement du modèle.
Développeurs : confiez à Haiku une mission bien délimitée
Pour un fondateur qui a levé des fonds, le classificateur de tickets du budget précédent constitue un bon point de départ. Définissez les files autorisées, fournissez le ticket et demandez une seule décision. Prévoyez une destination pour les cas non résolus. Un contrôle de validation peut rejeter une catégorie absente de la liste autorisée ; un échantillon évalué peut révéler les catégories apparemment valides qui envoient pourtant le ticket dans la mauvaise file.
Un développeur indépendant peut confier à Haiku une extraction tout aussi ciblée : récupérer une date de renouvellement et un identifiant de contrat dans un document, conserver le passage qui les justifie et vérifier le format de la date. Évitez de laisser le modèle décider quelles clauses commerciales prévalent tant que votre évaluation ne couvre pas ces exceptions.
Responsables techniques : réduisez le travail avant de réduire le budget
Pour le directeur technique d’une entreprise de taille intermédiaire, la récupération des passages utiles peut compter davantage que la taille maximale du contexte. Donnez au modèle chargé du résumé le compte rendu de réunion ou la section de procédure pertinente, puis vérifiez qu’il conserve les décisions, les responsables et les exceptions. Un résumé qui omet discrètement une obligation crée du travail ailleurs dans l’organisation.
Un responsable expérimenté qui choisit un système de routage doit mesurer les tickets mal orientés, les cas non résolus et le délai nécessaire pour obtenir une décision validée. Définissez le transfert à un niveau supérieur à partir d’éléments observables : champs obligatoires manquants, passages sources contradictoires, catégorie non prise en charge ou contrôle échoué. La confiance que le modèle déclare avoir dans sa réponse ne suffit pas, à elle seule, à définir une politique de routage.
Acheteurs : définissez précisément ce que vous payez
Demandez au fournisseur un coût par extraction validée ou par dossier traité, en incluant les volumes de tokens, l’effort, les nouvelles tentatives et la vérification. Le budget de $60 du classificateur ne dit pas grand-chose d’un service qui relance sans cesse les requêtes échouées ou joint un volumineux manuel de procédures à chaque ticket.
Les sous-agents sont des modèles chargés de tâches plus petites au sein d’un workflow plus large. Dans ce cadre, confiez à Haiku une mission de collecte d’éléments bien délimitée. Il peut être le candidat qui trouve un passage pertinent ou renvoie un résumé compact, tandis que Sonnet prend en charge la décision d’ensemble. Évaluez la transmission : le grand modèle a besoin de suffisamment de sources pour vérifier le travail du sous-agent.
Claude Haiku vs Sonnet : lequel choisir ?
Choisissez Haiku quand une réponse ciblée est facile à vérifier ; gardez Sonnet lorsque le jugement, la coordination ou la capacité à surmonter un échec déterminent la réussite. Les tarifs de Sonnet 5.5 pour les tokens hors cache sont 20 fois ceux de Haiku sur les prompts courts et quatre fois ceux de Haiku sur les prompts longs. Ce surcoût doit se traduire par de meilleurs résultats validés.
Le tableau publié par Anthropic au lancement justifie de tester le nouveau Haiku, mais donne aussi une raison de conserver Sonnet pour les tâches de programmation les plus difficiles. Voici les résultats de benchmarks publiés par Anthropic, avec, dans cet ordre, Haiku 5.5, Haiku 4.5 et OpenAI GPT-6 Luna :
- GDPval-AA v2.1, travail intellectuel : 1620, 735 et 1437.
- OSWorld 2.1, sous-ensemble hors ligne, utilisation de l’ordinateur : 72.4%, 15.7% et 48.9%.
- Terminal-Bench 4.0, programmation agentique : 39.2%, 0.0% et 16.4%. Anthropic indique 70.6% pour Sonnet 5.5 sur ce benchmark.
Source : tableau de performances d’Anthropic. Ces scores renseignent sur les tâches utilisées dans ces évaluations. Ils ne permettent pas de déduire un taux de validation pour vos contrats, vos tickets ou votre base de code.
Gardez Sonnet aux commandes d’une modification à l’échelle d’un dépôt, lorsqu’il faut découvrir les dépendances, coordonner les changements et reprendre après des étapes échouées. Envisagez Haiku pour une sous-tâche, comme résumer un fichier ou extraire les détails d’un échec de test précis. Dans son annonce, Anthropic recommande lui-même les modèles plus grands pour la programmation agentique complexe.
Validez d’abord, puis payez le recours à Sonnet
Dans un exemple de workflow mixte, chaque classification passe par Haiku ; les cas non résolus ou qui échouent à la validation sont ensuite envoyés à Sonnet. Si 10% nécessitent un appel Sonnet supplémentaire, avec les mêmes volumes de tokens que dans le scénario de référence, la facture mensuelle est de $60 + $120 = $180. C’est $1,020 de moins que si tous les appels étaient exécutés sur Sonnet. L’exemple exclut l’infrastructure de validation et suppose que le second appel n’a besoin d’aucun contexte supplémentaire.
Le premier appel à Haiku reste facturé pour chaque cas transmis à Sonnet. Un prévisionnel qui ne compte que le modèle ayant finalement réussi oublie ce coût. Mesurez les nouvelles tentatives en nombre d’essais par tâche achevée et comparez le délai de bout en bout autant que les tokens.
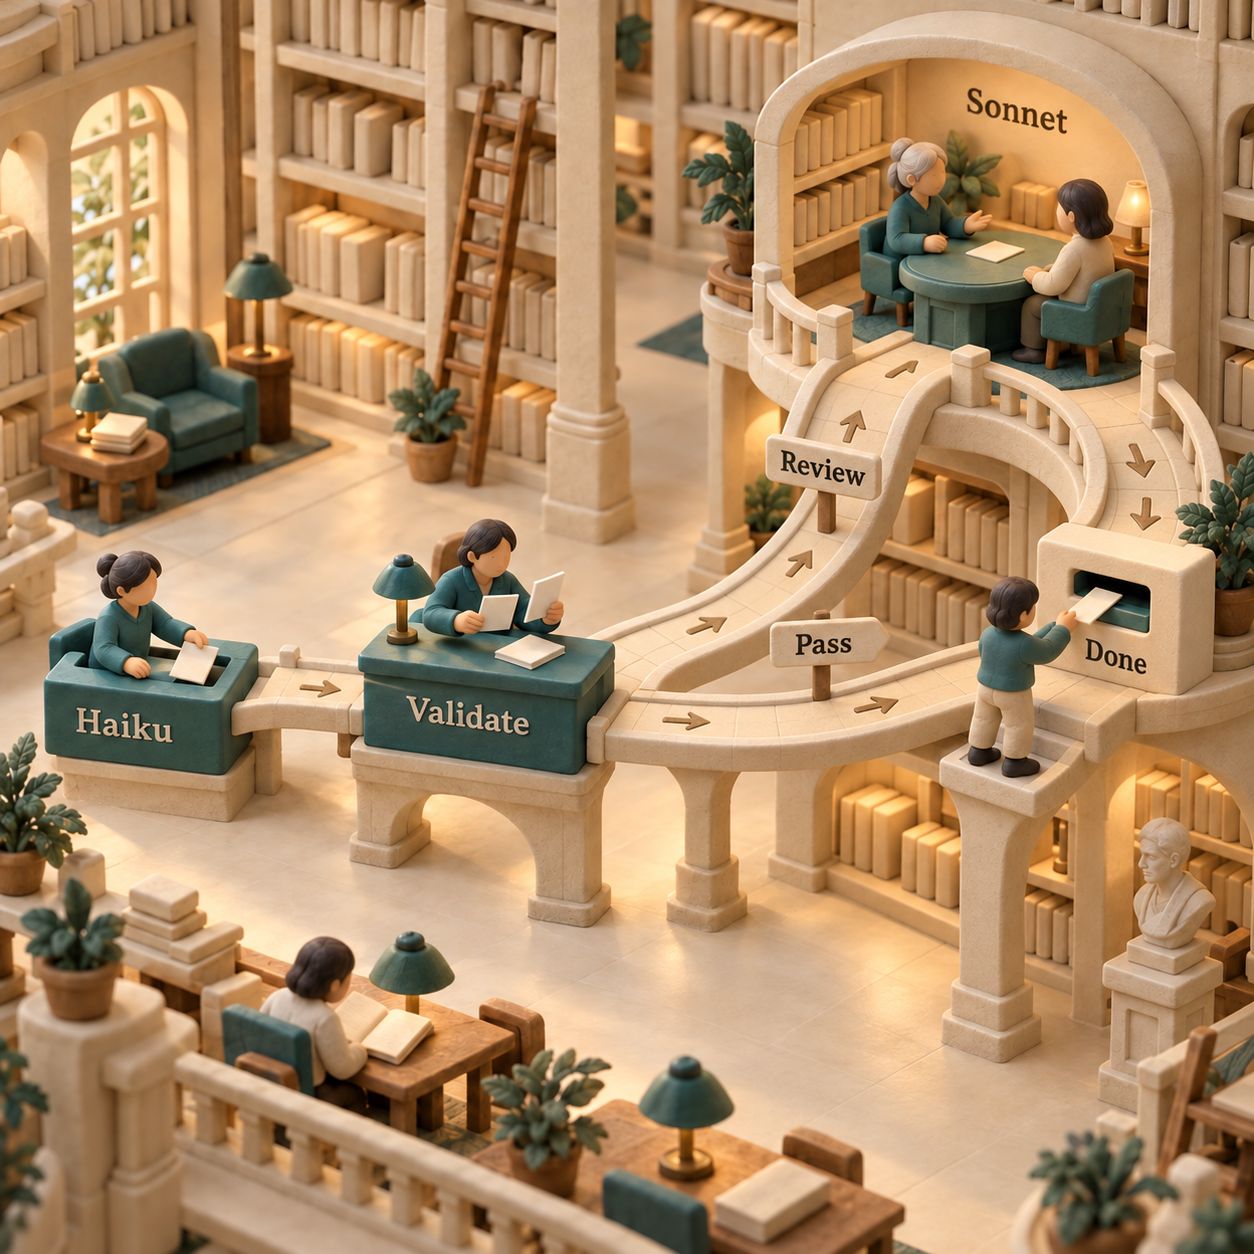
Consultez le guide de configuration de Sonnet 5.5 pour mettre en place le circuit avec le grand modèle. Pour votre budget, utilisez le tarif actuel de lecture du cache de $0.10 par MTok vérifié ici ; Anthropic l’a abaissé depuis $0.20 le 7 octobre. Changement de prix.
API de Claude Haiku 4.5 : comment passer à la version 5.5 ?
La migration touche l’intégration autant que le nom du modèle. Un service qui fonctionnait avec Haiku 4.5 peut échouer à cause des paramètres de requête, de l’analyse des réponses ou des limites de sortie, même si le nouveau modèle répond correctement à la tâche.
Suivez le guide de migration Haiku d’Anthropic pour votre plateforme. Voici les changements déterminants :
- Changez l’identifiant et recomptez les tokens. Sur Claude API, utilisez
claude-haiku-5-5. Recomptez les prompts avec ce modèle, puis revoyez les estimations de coût et les plafonds de sortie. - Mettez à jour les réglages de raisonnement et d’échantillonnage. Remplacez le raisonnement manuel
thinking.type: enabledetbudget_tokenspar le raisonnement adaptatif. Réglezoutput_config.effortselon la tâche. Supprimeztemperature,top_pettop_kcomme l’indique le guide. - Supprimez le préremplissage de l’assistant. Un dernier message de l’assistant fourni pour que le modèle le poursuive est rejeté. Terminez la requête par un tour utilisateur et choisissez le mécanisme de format de sortie pris en charge par votre plateforme.
- Lisez les blocs de réponse selon leur type. Une réponse peut commencer par un bloc de raisonnement. Sélectionnez les blocs de texte ou d’utilisation d’outils nécessaires et gérez l’épuisement de la capacité de sortie avant qu’une réponse visible soit produite.
- Gérez les refus et la réutilisation de l’historique. Aiguillez un
stop_reasonvalantrefusalvers un traitement prévu dans l’application. Si vous réinjectez les blocs de raisonnement, conservez-les tels quels, utilisez le compte qui les a produits ou un compte lié et respectez les règles du guide sur les préfixes inchangés.
Pour un directeur technique engagé sur une capacité Priority Tier, il existe une raison distincte d’attendre : le guide de migration d’Anthropic indique que Haiku 5.5 ne prend pas en charge Priority Tier. Trouvez une solution de capacité acceptable avant de migrer la file de traitement. Des tokens bon marché ne remplacent pas une exigence de service. Limite de capacité.
Retrait des modèles Haiku : que dit réellement leur statut ?
Au 8 octobre 2026, la page des modèles dépréciés d’Anthropic indique que Haiku 4.5 est actif, avec un retrait pas avant le 15 octobre 2026. Il s’agit d’une date minimale, pas de l’annonce d’un arrêt ce jour-là. Elle indique également que Haiku 5.5 est actif, avec un retrait pas avant le 7 octobre 2027. Statut des modèles de Claude API.
Pour les intégrations plus anciennes, Haiku 3.5 a été retiré de Claude API le 19 février 2026, et Haiku 3 le 20 avril 2026. Ces dates de retrait figurent sur la page du cycle de vie de l’API ; elles ne sont pas déduites du lancement de la version 5.5. Historique des retraits.
Planifiez la migration depuis Haiku 4.5 en fonction de vos évaluations et de l’état de préparation de l’intégration. Le statut actuel vous laisse le temps de décider méthodiquement ; continuez à consulter la page officielle du cycle de vie pour connaître la date de retrait lorsqu’elle sera annoncée.
Quelles promesses faut-il relativiser ?
Trois arguments séduisants demandent des précisions avant de guider un budget ou une décision d’architecture.
« 90% moins cher » décrit l’écart de tarif pour les prompts courts. Cela ne garantit pas une baisse de 90% du coût d’une même tâche achevée. La tokenisation, le raisonnement, la longueur des requêtes, les tentatives répétées et le recours à un autre modèle influent sur la facture. L’exemple à volumes identiques isole l’effet des prix ; ce sont vos volumes observés qui déterminent le prévisionnel.
Une fenêtre d’un million de tokens ne rend pas les prompts longs bon marché. Le palier supérieur de Haiku commence bien avant cette limite de capacité. Un service de résumé qui joint un historique sans rapport à chaque requête peut coûter plus cher sans produire de meilleur résumé. Comptez les tokens du prompt une fois celui-ci assemblé et gardez assez de place pour la sortie nécessaire.
Un réglage d’effort ne permet pas à Haiku d’accomplir toutes les tâches de Sonnet. Augmenter l’effort mérite un test lorsque cela corrige un échec observé. Incluez Sonnet dans cette évaluation si le problème exige un travail de programmation soutenu ou un jugement difficile. Comparez les résultats finaux et le temps écoulé, nouvelles tentatives comprises.
La baisse du tarif de lecture du cache de Sonnet modifie aussi la comparaison pour un agent existant. Recalculez sa facture actuelle avant de décider de migrer : les entrées réutilisées à répétition sont désormais moins chères sur Sonnet, tandis que les entrées hors cache et les sorties conservent leurs tarifs catalogue. Le guide des tarifs de Claude API replace cette version dans le budget global des modèles et des fonctionnalités.
Par quoi commencer cette semaine ?
Testez dès maintenant une tâche bien délimitée, avec un critère de validation clair. Attendez pour une file dont les exigences de qualité ou de capacité restent à résoudre. Un fondateur qui paie des classifications répétées dispose d’un candidat à évaluer immédiatement ; un directeur technique dépendant de Priority Tier doit d’abord trancher la question de la capacité. Un service qui respecte déjà son budget et son objectif de qualité peut conserver son modèle actuel pendant la comparaison.
Choisissez une file et définissez un résultat valide
Utilisez des entrées représentatives dont vous connaissez les bonnes réponses, y compris des cas ambigus et difficiles. Précisez quelles erreurs nécessitent une vérification et quels échecs peuvent faire l’objet d’une nouvelle tentative sans risque. Commencez par la classification, l’extraction ou un résumé bien cadré.
Mesurez le même travail sur chaque modèle candidat
Exécutez Haiku 4.5, Haiku 5.5 et Sonnet 5.5 sur ces entrées, avec des niveaux d’effort adaptés. Relevez les volumes d’entrée propres à chaque modèle, la sortie facturée, le temps nécessaire pour achever la tâche et les résultats validés. Incluez chaque tentative dans le calcul du coût. Pour vérifier le palier lié à la longueur du prompt, utilisez les volumes calculés par le nouveau système de tokenisation.
Migrez les cas validés et gardez un recours à Sonnet
Effectuez les vérifications de migration, puis transférez le sous-ensemble dont la qualité et le coût observés répondent à vos exigences. Validez les sorties, examinez les échecs et conservez Sonnet pour les tâches plus difficiles. La réussite se mesure à une décision validée moins chère, obtenue dans le délai requis.
Recevez les prochaines actualités sur les modèles et les budgets API dans la newsletter.
- Publié
- Catégorie
- AI
- Langue
Compte rendu de réunion par IA : quelle alternative à Otter AI choisir ?
Comparez les alternatives à Otter AI pour vos comptes rendus de réunion par IA : tarifs, offres gratuites, enregistrement sans bot et intégrations CRM.8 oct. 2026AI
Mistral Large 4 : quel budget et quand passer à l’action ?
Mistral Large 4 : tarifs API, remise de lancement et benchmarks. Découvrez quand tester la preview hébergée et quand attendre les poids pour l’héberger.7 oct. 2026AI
Agent IA Lindy : avis, tarifs et limites en octobre 2026
Notre avis sur Lindy AI : tarifs en USD, coût des crédits, gestion des e-mails et des réunions, limites des intégrations et alternatives adaptées.7 oct. 2026AI
Mistral pricing : quel budget pour l’API et Vibe en 2026 ?
Prix de l’API Mistral, abonnements Vibe, limites gratuites et hébergement UE : comparez les offres et calculez votre facture mensuelle en dollars.6 oct. 2026AI
Claude Skills : construisez votre workflow de reporting client
Créez un skill Claude pour vos rapports clients hebdomadaires : calculs en Python, validation des données, installation et partage dans l’équipe.6 oct. 2026AI
Agent IA en entreprise : missions, tarifs et premiers pas
Comparez les missions et les prix des agents IA pour votre entreprise. Choisissez un rôle, gardez une validation humaine et mesurez un test de 30 jours.6 oct. 2026AI
Superwhisper et les alternatives à Wispr Flow : que choisir en 2026 ?
Superwhisper, VoiceOS, Aqua Voice, Willow ou Monologue : comparez les alternatives à Wispr Flow selon les tarifs, le hors ligne et les besoins d’équipe.5 oct. 2026AI