Claude Haiku 5.5: Wann sich der günstigere Tarif rechnet
Claude Haiku 5.5 im Kostenvergleich: Preise, die 100K-Promptgrenze und eine Beispielrechnung mit Haiku 4.5 und Sonnet 5.5. Wann lohnt sich der Wechsel?
Veröffentlicht am
 Von Omid Saffari



Claude Haiku 5.5 ist Anthropics kleines Modell für häufig wiederkehrende, automatisierte Aufgaben. Eine Million kurze Klassifizierungsaufrufe kosten damit $60 im Monat, wenn jeder Aufruf 500 Eingabetokens und 20 abgerechnete Ausgabetokens benötigt. Es ist das derzeit günstigste Claude-Modell; bei Prompts mit mehr als 100,000 Tokens steigen allerdings die Preise. Für Klassifizierung, Datenextraktion, Routing und Zusammenfassungen lohnt sich ein Test. Claude Sonnet 5.5, Anthropics größeres Allzweckmodell, bleibt die bessere Wahl für Aufgaben, bei denen Fehler oder anspruchsvolle Programmierarbeit schwerer wiegen als die Tokenersparnis.
Geprüft am 8. Oktober 2026 anhand von Anthropics Ankündigung, der Preisdokumentation und der Modellübersicht. Die folgenden Budgetrechnungen sind Beispiele mit ausdrücklich genannten Annahmen. Sämtliche Preise sind Anthropics Listenpreise in USD.
Was bringt Claude Haiku 5.5?
Haiku 5.5 senkt die Kosten für häufig wiederholte KI-Aufgaben mit klar abgegrenztem Umfang deutlich. Anthropic veröffentlichte das Modell am 7. Oktober 2026 mit der API-ID claude-haiku-5-5 und bezeichnet es als sein bisher günstigstes kleines Modell. Haiku ist die Reihe der kleinen Modelle innerhalb der Claude-Familie. Sie ist ein erster Kandidat für häufige automatisierte Entscheidungen, deren akzeptables Ergebnis sich präzise definieren lässt. Ankündigung zur Veröffentlichung.
Gegenüber dem Vorgänger Claude Haiku 4.5 verbindet das neue Modell niedrigere Preise mit höheren Kapazitätsgrenzen und einem einstellbaren Denkaufwand. Das ist für Gründer relevant, die für jede Ticketkategorie oder jedes extrahierte Feld bezahlen. Weniger entscheidend ist es bei einem Produkt, dessen größter Kostenfaktor die Korrektur von Modellfehlern ist.
Anthropic nennt als Zugänge die Claude API, Amazon Bedrock, Claude Platform on AWS, Google Cloud und Microsoft Foundry. In der Ankündigung wird der Microsoft-Zugang als Azure bezeichnet. Beim Umzug eines bestehenden Dienstes sind die Integration und die Modellkennung der jeweiligen Plattform maßgeblich. Offizielle Plattformliste.
Wie groß ist das Kontextfenster von Claude Haiku?
Haiku 5.5 bietet in der Standard-API ein Kontextfenster von 1M Tokens und maximal 128K Ausgabetokens. Das Kontextfenster bestimmt, wie viel Material das Modell für eine Anfrage aufnehmen kann; das Ausgabelimit begrenzt die generierte Antwort. Haiku 4.5 bot 200K Kontext und 64K Ausgabe. Die höheren Grenzen ermöglichen längere Aufgaben. Sie sind jedoch Kapazitätsgrenzen, weder ein enthaltenes Tokenkontingent noch eine Qualitätsgarantie. Aktuelle Spezifikationen, Änderungen zur neuen Version.
Zudem ist dies das erste Haiku-Modell mit einstellbarem Denkaufwand. Adaptive Thinking lässt das Modell selbst entscheiden, wann und wie ausführlich es nachdenkt, und ist standardmäßig aktiviert. Die API verwendet bei Haiku 5.5 standardmäßig die Effort-Einstellung medium. Ankündigung, Standardeinstellung und Thinking-Modus.
Für eine einfache Klassifizierung empfiehlt sich zunächst ein Test mit low. Bei Datenextraktion mit Ausnahmefällen oder strengeren Vorgaben lohnt ein Vergleich von medium und high. Anthropic unterstützt low, medium, high, xhigh und max. Die höchsten Stufen empfiehlt das Unternehmen dort, wo eine Evaluierung ihren Nutzen belegt, und rät zum Vergleich mit Sonnet. Mehr Denkaufwand kann mehr Tokens und Zeit beanspruchen. Deshalb gehört die Effort-Einstellung neben dem Modellnamen in jede Budgetrechnung. Hinweise zum Denkaufwand.
Claude Haiku: Preise bis und über 100K Prompt-Tokens
Ein Prompt mit 100,000 Tokens fällt in den günstigen Tarif. Ein längerer Prompt löst für die gesamte Anfrage den höheren Tarif aus. Entscheidend ist die Länge des einzelnen Prompts, unabhängig vom monatlichen Tokenverbrauch des Kontos.
Tokens sind die Textbestandteile, die ein Modell verarbeitet. Zur Eingabe gehört alles, was an das Modell gesendet wird, einschließlich relevanter Anweisungen, des Verlaufs und der Inhalte aus Tools. Die Ausgabe ist das, was das Modell erzeugt. MTok steht für eine Million Tokens. Die folgenden Preise gelten jeweils pro MTok:
Quelle: Anthropics Modellpreise. Ein Cache-Treffer ist ein wiederverwendeter Teil der Eingabe. Sein Preis gilt nicht für sämtliche Tokens einer Anfrage.
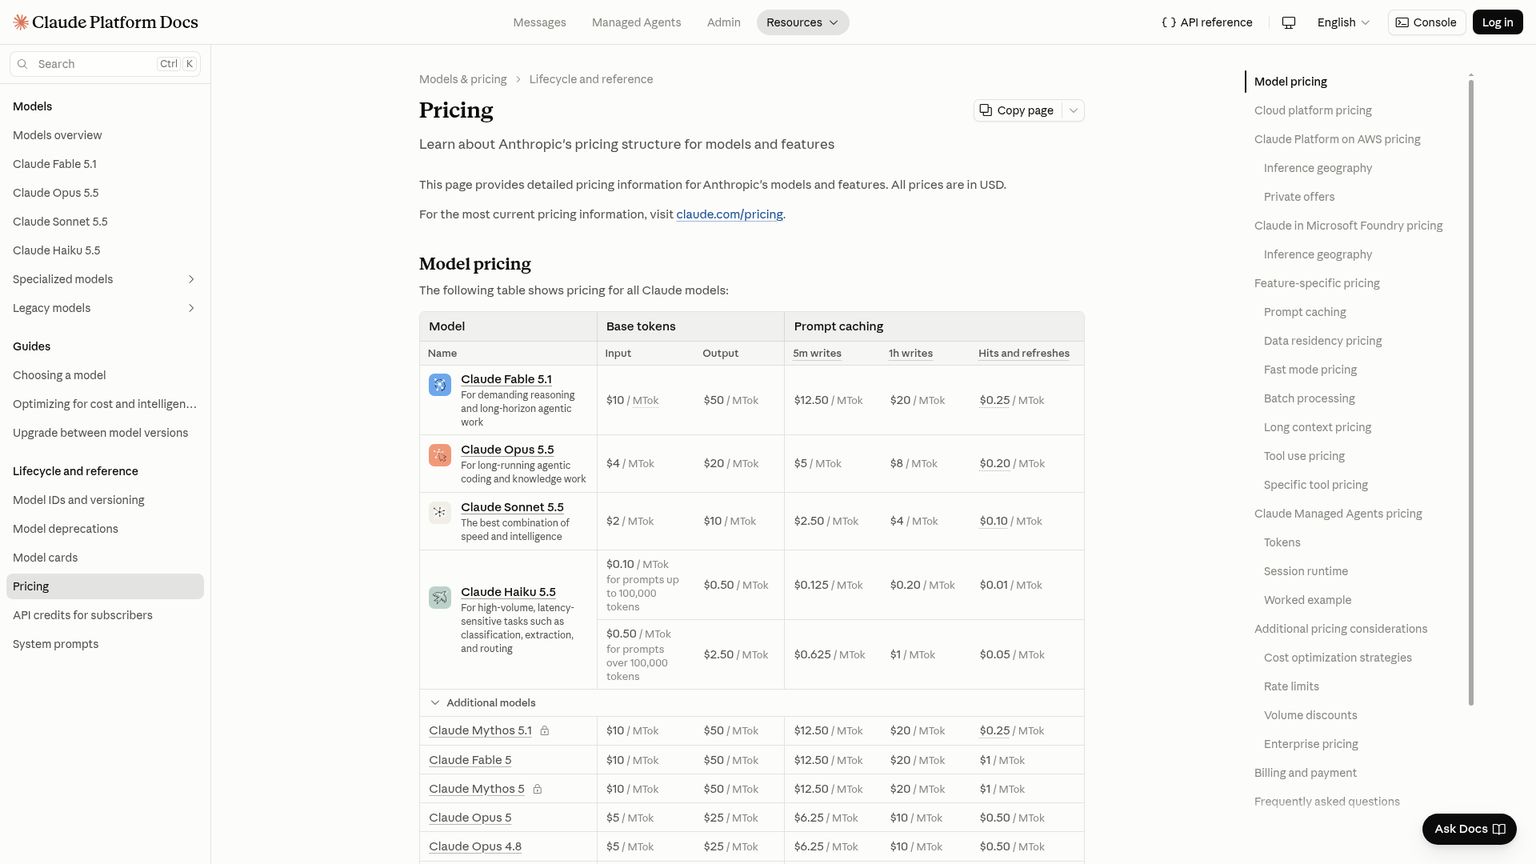
Die Haiku-Grenze ist ein Preissprung: Der Aufschlag betrifft nicht bloß die zusätzlichen Tokens. Für eine beispielhafte Anfrage ohne Cache und mit 1,000 Ausgabetokens ergibt unsere Rechnung anhand der veröffentlichten Tarifstufen:
- 100,000 Eingabetokens: 0.1 × $0.10 + 0.001 × $0.50 = $0.01050.
- 100,001 Eingabetokens: 0.100001 × $0.50 + 0.001 × $2.50 = $0.05250050.
Ein einziges zusätzliches Eingabetoken hebt die Anfrage auf fünfmal so hohe Tarife. Sowohl der Eingabe- als auch der Ausgabepreis ändern sich. Diese Rechnung basiert auf der Preisliste mit zwei Tarifstufen, mit ungecachter Eingabe und derselben angenommenen Ausgabe.
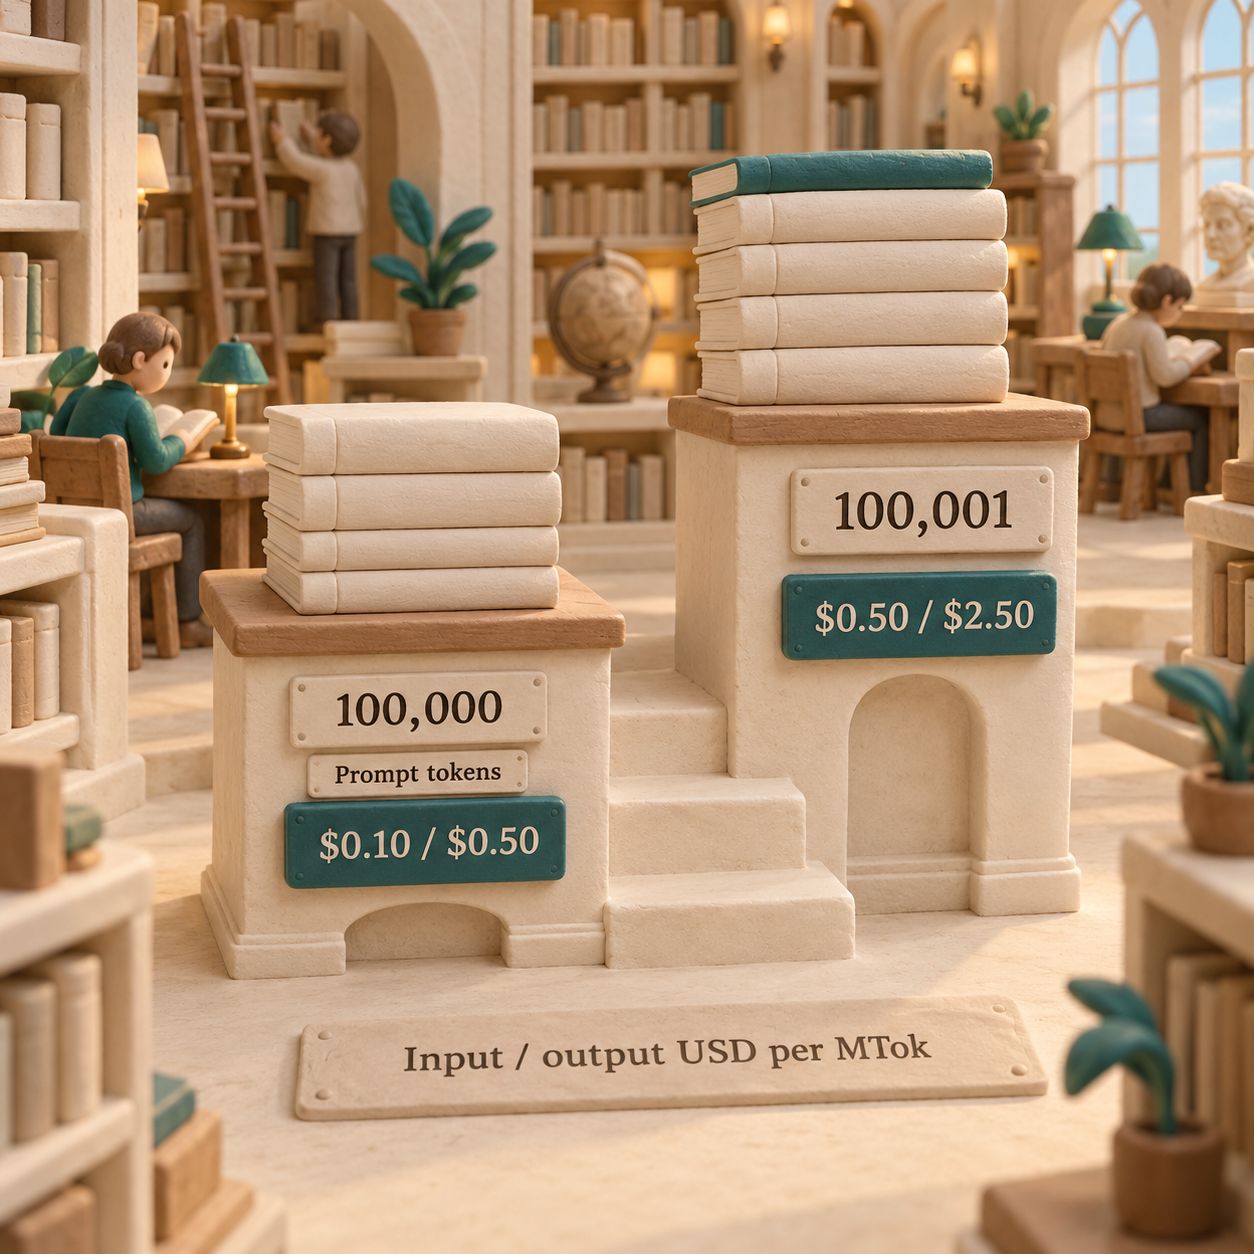
Bei einem Dienst für Zusammenfassungen sollten das relevante Dokument und die Anweisungen zusammenbleiben. Anschließend lässt sich die vollständige Anfrage zählen. Wird der gesamte Gesprächsverlauf oder eine Sammlung sachfremder Dokumente angehängt, kann das die Kostenrechnung verändern. Kontext lässt sich kürzen oder gezielt abrufen, sofern die Antwortqualität erhalten bleibt. Wer ein Dokument ohne Rücksicht auf seinen Inhalt aufteilt, kann genau den Zusammenhang verlieren, den das Modell erklären sollte.
Batch halbiert Eingabe- und Ausgabepreise
Batch eignet sich für Aufgaben, deren Ergebnisse asynchron eintreffen dürfen, etwa nächtliche Verschlagwortung oder einen Rückstand bei Dokumentzusammenfassungen. Bei Haiku 5.5 kosten Batch-Anfragen mit Prompts bis 100,000 Tokens $0.05 für die Eingabe/$0.25 für die Ausgabe pro MTok, darüber $0.25/$1.25. Die Batch API gewährt auf Eingabe und Ausgabe 50% Rabatt. Batch-Preise, Batch-Verarbeitung.
Das Routing laufender Anfragen braucht weiterhin einen Antwortpfad, der die Zeitvorgaben der Anwendung erfüllt. Batch ist eine Option für Arbeit, die warten kann. Es verändert neben dem Preis auch die Bereitstellung der Ergebnisse.
Ein Cache-Treffer für $0.01 setzt ein geeignetes Präfix voraus
Caching speichert einen wiederkehrenden Promptanfang, etwa unveränderte Regeln zur Datenextraktion, zur Wiederverwendung in weiteren Anfragen. Im günstigen Tarif kostet das Lesen bei Haiku 5.5 $0.01 pro MTok. Zuvor fällt ein kostenpflichtiger Schreibvorgang an: $0.125 pro MTok für einen Cache mit fünf Minuten Laufzeit oder $0.20 für eine Stunde. Oberhalb der Promptlängengrenze betragen diese Preise $0.05 für das Lesen, $0.625 für das Schreiben mit fünf Minuten Laufzeit und $1 für das Schreiben mit einer Stunde Laufzeit. Caching-Preise.
Für Haiku 5.5 muss das cachefähige Präfix mindestens 512 Tokens umfassen. Kürzere Präfixe werden ohne Caching verarbeitet. Eine wechselnde Kundennachricht bleibt neue Eingabe, und eine neu generierte Antwort bleibt Ausgabe. Die Felder cache_creation_input_tokens und cache_read_input_tokens zeigen, was tatsächlich im Cache gelandet ist oder daraus gelesen wurde. Cache-Grenzen.
Für kurze Klassifizierungsaufgaben ist diese Unterscheidung entscheidend. Der vollständige Prompt mit 500 Tokens im nächsten Beispiel liegt unter der Mindestlänge für Caching. Wer diese Aufrufe als Cache-Treffer kalkuliert, setzt die Kosten zu niedrig an.
Claude Haiku: Kosten für eine Million Klassifizierungen im Monat
Die Beispielrechnung ergibt $60 monatlich mit Haiku 5.5, $600 mit Haiku 4.5 oder $1,200 mit Sonnet 5.5. Verglichen werden die Tarife für eine SaaS-Anwendung, die Supporttickets klassifiziert und eine Warteschlangenkategorie samt kurzer strukturierter Entscheidung zurückgibt.
Angenommen werden eine Million Aufrufe pro Monat mit jeweils 500 neuen Eingabetokens und 20 abgerechneten Ausgabetokens. Diese abgerechneten Mengen werden für jedes Modell separat angenommen. Jeder Prompt bleibt unterhalb der Preisgrenze. Die Ausgangsrechnung enthält weder Caching noch gesondert berechnete serverseitige Tools oder Wiederholungsversuche.
Der Monatsverbrauch beträgt 500 Millionen Eingabetokens und 20 Millionen Ausgabetokens. Gerechnet wird mit den offiziellen Listenpreisen:
Unter diesen Annahmen kostet Haiku 5.5 $0.06 pro 1,000 Klassifizierungen. Per Batch kostet dieselbe Aufgabe mit den jeweiligen Modellen $30, $300 oder $600. Diese Summen decken die Modelltokens ab. Anwendungsinfrastruktur und eine etwaige Prüfung durch Menschen werden separat bezahlt.
Was kostet Claude Haiku 4.5 im Vergleich?
Haiku 4.5 kostet $1 für die Eingabe/$5 für die Ausgabe pro MTok und damit das Zehnfache des neuen Tarifs für kurze Prompts. Im Beispiel ergibt das eine monatliche Ersparnis von $540. Bei Haiku-5.5-Prompts mit mehr als 100,000 Tokens schrumpft der Abstand: Hier liegen die Preise bei der Hälfte der Haiku-4.5-Tarife. Veröffentlichte Preise.
Die Annahme gleicher Tokenmengen muss in der Rechnung sichtbar bleiben. Laut Anthropic verbraucht der überarbeitete Tokenizer von Haiku 5.5 etwas mehr Tokens pro Aufgabe. Ein Tokenizer zerlegt Text in zählbare Tokens. Bevor sich die Ersparnis für eine eigene Aufgabe prognostizieren lässt, muss dieselbe Eingabe mit dem neuen Modell erneut gezählt und dessen abgerechnete Ausgabe einschließlich Thinking gemessen werden. Anthropics Hinweis zum Tokenizer, Tokenzählung.
Zwanzig Ausgabetokens sind eine Rechenannahme, kein Limit, das pauschal in jede Anfrage gehört. Auch Thinking beansprucht Ausgabekapazität. Muss das Modell vor der Rückgabe einer Kategorie nachdenken, kann die tatsächlich abgerechnete Ausgabe länger sein als die kurze sichtbare Antwort. Sinnvoll sind Tests mit geringerem Denkaufwand und einem Ausgabelimit, das genügend Spielraum zum Abschließen der Antwort lässt. Thinking und Ausgabelimits.
Für andere Anbieter lässt sich dieselbe Aufgabe mit denselben Akzeptanzkriterien im Vergleich günstiger KI-APIs prüfen. Ein niedrigerer beworbener Tarif hilft dann, wenn innerhalb des Budgets ein akzeptables Ergebnis entsteht.
Was bedeutet das für Entwicklung, Betrieb und Einkauf?
Zuerst sollte der wiederholbare Teil einer Aufgabe umziehen. Klassifizierung, Datenextraktion, Routing, Zusammenfassungen und Subagenten sind geeignete Kandidaten, weil sich ihre Eingaben begrenzen und ihre Ausgaben kontrollieren lassen. Anthropic positioniert Haiku für solche Aufgaben mit hohem Volumen. Positionierung des Modells.
Entwicklung: Haiku braucht einen eng umrissenen Auftrag
Für Gründer mit Finanzierung bietet sich zunächst die Ticketklassifizierung aus der obigen Rechnung an. Die zulässigen Warteschlangen werden definiert, das Ticket wird mitgegeben und genau eine Entscheidung verlangt. Für ungeklärte Fälle braucht es ein Ziel. Eine Validierung kann Kategorien außerhalb der erlaubten Menge ablehnen. Eine bewertete Stichprobe deckt dagegen auch scheinbar gültige Kategorien auf, die ein Ticket in die falsche Warteschlange schicken.
Für Soloentwickler eignet sich eine ähnlich begrenzte Extraktionsaufgabe: Verlängerungsdatum und Vertragskennung aus einem Dokument auslesen, die belegende Textstelle aufbewahren und das Datumsformat prüfen. Welche Geschäftsbedingungen andere übersteuern, sollte das Modell erst entscheiden, wenn die Evaluierung solche Ausnahmefälle abdeckt.
Betrieb: Erst die Aufgabe verkürzen, dann das Budget
Für einen CTO im Mittelstand kann der gezielte Abruf relevanter Inhalte wichtiger sein als das beworbene Kontextlimit. Ein Modell für Zusammenfassungen erhält den passenden Abschnitt einer Besprechung oder Richtlinie. Danach wird geprüft, ob Entscheidungen, Verantwortliche und Ausnahmen erhalten bleiben. Eine Zusammenfassung, die stillschweigend eine Verpflichtung auslässt, erzeugt an anderer Stelle im Unternehmen neue Arbeit.
Verantwortliche für den operativen Betrieb sollten bei der Wahl eines Routingsystems fehlgeleitete Tickets, ungeklärte Fälle und die Zeit bis zu einer akzeptierten Entscheidung messen. Die Eskalation muss auf beobachtbaren Anhaltspunkten beruhen: fehlenden Pflichtfeldern, widersprüchlichen Quellpassagen, einer nicht unterstützten Kategorie oder einer fehlgeschlagenen Prüfung. Die eigene Aussage eines Modells über seine Sicherheit reicht allein als Routingregel nicht aus.
Einkauf: Entscheidend ist die bezahlte Ergebniseinheit
Ein Anbieter sollte die Kosten pro akzeptierter Extraktion oder abgeschlossenem Fall ausweisen, einschließlich Tokenmengen, Denkaufwand, Wiederholungsversuchen und Prüfung. Das Klassifizierungsbudget von $60 sagt wenig über einen Dienst aus, der fehlgeschlagene Anfragen immer wieder startet oder bei jedem Ticket ein umfangreiches Richtlinienhandbuch mitsendet.
Subagenten sind Modelle, die innerhalb eines größeren Arbeitsablaufs kleinere Aufgaben übernehmen. Haiku kann dort einen begrenzten Auftrag zur Belegsammlung erhalten: eine relevante Passage finden oder eine kompakte Zusammenfassung liefern, während Sonnet die übergeordnete Entscheidung trifft. Auch die Übergabe muss geprüft werden. Das größere Modell benötigt genügend Quellmaterial, um die Arbeit des Subagenten kontrollieren zu können.
Claude Haiku vs Sonnet: Wann lohnt sich welches Modell?
Haiku eignet sich, wenn sich eine eng begrenzte Antwort leicht prüfen lässt. Sonnet sollte bleiben, wenn Urteilsvermögen, Koordination oder das Abfangen von Fehlern über den Erfolg entscheiden. Die Tarife von Sonnet 5.5 für neue Eingabe und Ausgabe sind 20-mal so hoch wie Haikus Tarife für kurze Prompts und viermal so hoch wie dessen Tarife für lange Prompts. Der Aufpreis muss sich durch bessere akzeptierte Ergebnisse rechtfertigen.
Anthropics Tabelle zur Veröffentlichung spricht für eine Evaluierung des neuen Haiku, liefert aber auch einen Grund, Sonnet bei schwierigeren Programmieraufgaben beizubehalten. Die folgenden Werte sind von Anthropic veröffentlichte Benchmark-Ergebnisse, jeweils in der Reihenfolge Haiku 5.5, Haiku 4.5 und OpenAI GPT-6 Luna:
- GDPval-AA v2.1, Wissensarbeit: 1620, 735 und 1437.
- OSWorld 2.1, Offline-Teilmenge, Computerbedienung: 72.4%, 15.7% und 48.9%.
- Terminal-Bench 4.0, agentisches Programmieren: 39.2%, 0.0% und 16.4%. Anthropic nennt für diesen Benchmark 70.6% für Sonnet 5.5.
Quelle: Anthropics Leistungstabelle. Benchmark-Werte beantworten Fragen zu den jeweiligen Testaufgaben. Sie belegen keine Akzeptanzquote für eigene Verträge, Tickets oder Codebasen.
Bei einer Änderung im gesamten Repository, die Abhängigkeiten aufspüren, Bearbeitungen koordinieren und nach fehlgeschlagenen Schritten wieder ansetzen muss, sollte Sonnet die Führung behalten. Haiku kommt für Teilaufgaben infrage, etwa die Zusammenfassung einer Datei oder die Extraktion eines bestimmten Testfehlers. Auch Anthropic empfiehlt in der Ankündigung größere Modelle für komplexes agentisches Programmieren.
Erst validieren, dann die Eskalation bezahlen
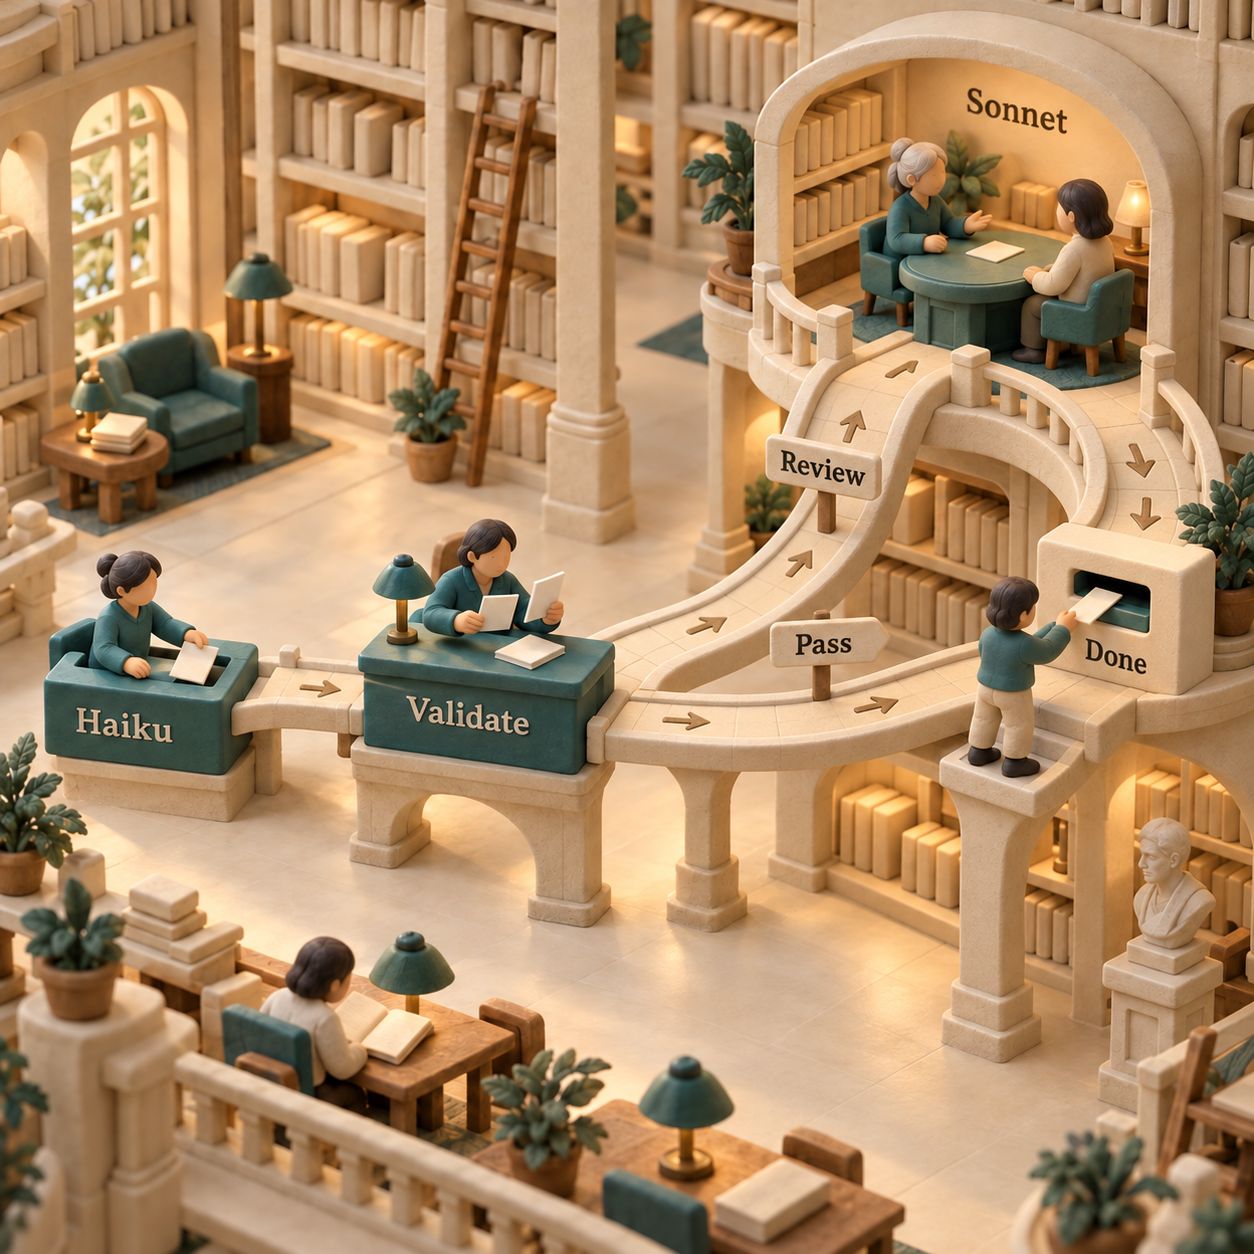
Ein beispielhafter gemischter Ablauf lässt jede Klassifizierung zunächst auf Haiku laufen. Fehlgeschlagene Validierungen und ungeklärte Fälle gehen anschließend an Sonnet. Wenn 10% einen zusätzlichen Sonnet-Aufruf benötigen, mit denselben Tokenmengen wie in der Ausgangsrechnung, beträgt die Monatsrechnung $60 + $120 = $180. Das sind $1,020 weniger als bei ausschließlicher Nutzung von Sonnet. Das Beispiel lässt die Validierungsinfrastruktur außen vor und nimmt an, dass der zweite Aufruf keinen zusätzlichen Kontext braucht.
Auch bei jedem eskalierten Fall wird der erste Haiku-Aufruf abgerechnet. Wer nur das Modell der letzten erfolgreichen Antwort einpreist, übersieht diese Kosten. Wiederholungsversuche sollten als Anzahl der Versuche pro abgeschlossener Aufgabe erfasst werden. Neben den Tokens zählt auch die Gesamtdauer.
Für den Pfad über das größere Modell hilft die Einrichtungsanleitung für Sonnet 5.5. Für die Budgetplanung gilt der hier geprüfte aktuelle Cache-Lesepreis von $0.10 pro MTok. Anthropic senkte ihn am 7. Oktober von $0.20. Preisänderung.
Claude Haiku 4.5 API: Was beim Umstieg auf 5.5 wichtig ist
Der Wechsel betrifft die Integration genauso wie den Modellnamen. Ein Dienst, der mit Haiku 4.5 funktionierte, kann an Anfrageparametern, der Auswertung von Antworten oder Ausgabelimits scheitern, selbst wenn das neue Modell die eigentliche Aufgabe gut löst.
Maßgeblich ist Anthropics Haiku-Migrationsanleitung für die jeweilige Plattform. Besonders relevant sind diese Änderungen:
- Kennung ändern und Tokens neu zählen. In der Claude API wird
claude-haiku-5-5verwendet. Die Prompts müssen mit diesem Modell erneut gezählt und Kostenschätzungen sowie Ausgabelimits überprüft werden. - Thinking- und Sampling-Einstellungen anpassen. Manuelles
thinking.type: enabledundbudget_tokenswerden durch Adaptive Thinking ersetzt.output_config.effortwird passend zur Aufgabe gesetzt.temperature,top_pundtop_kwerden nach den Vorgaben der Anleitung entfernt. - Assistant-Prefill entfernen. Eine abschließende Assistant-Nachricht, die das Modell fortsetzen soll, wird abgelehnt. Die Anfrage muss mit einer User-Nachricht enden; für das Ausgabeformat ist der unterstützte Mechanismus der jeweiligen Plattform zu wählen.
- Antwortblöcke nach Typ auslesen. Eine Antwort kann mit einem Thinking-Block beginnen. Benötigte Textblöcke oder Blöcke für Tool-Aufrufe müssen gezielt ausgewählt werden. Auch der Fall, dass das Ausgabelimit vor einer sichtbaren Antwort erreicht wird, muss abgefangen werden.
- Ablehnungen und erneut übergebene Gesprächsverläufe behandeln. Ein
stop_reasonmit dem Wertrefusalbraucht einen Verarbeitungspfad in der Anwendung. Werden Thinking-Blöcke erneut übergeben, bleiben sie unverändert. Dabei ist das erzeugende oder verknüpfte Konto zu verwenden; außerdem gelten die Regeln der Anleitung zum unveränderten Präfix.
Für einen CTO mit einer Kapazitätszusage im Priority Tier gibt es einen eigenen Grund abzuwarten: Laut Anthropics Migrationsanleitung unterstützt Haiku 5.5 Priority Tier nicht. Vor dem Umzug der Warteschlange muss ein akzeptabler Weg zur benötigten Kapazität feststehen. Günstige Tokens ersetzen keine Anforderung an den Dienst. Kapazitätsbeschränkung.
Haiku-Abschaltung: Was bedeuten Status und Datum?
Am 8. Oktober 2026 führt Anthropics Seite zu Modellabkündigungen Haiku 4.5 als Active. Eine Abschaltung erfolgt demnach nicht vor dem 15. Oktober 2026. Das ist ein frühestmöglicher Termin, keine angekündigte Abschaltung an diesem Tag. Haiku 5.5 wird ebenfalls als Active geführt, mit einer Abschaltung nicht vor dem 7. Oktober 2027. Modellstatus der Claude API.
Für ältere Integrationen gilt: Haiku 3.5 wurde in der Claude API am 19. Februar 2026 abgeschaltet, Haiku 3 am 20. April 2026. Diese Abschaltdaten stammen von der Seite zum API-Modelllebenszyklus. Sie sind kein aus der Veröffentlichung von 5.5 abgeleiteter Zeitplan. Historie der Modellabkündigungen.
Eine Haiku-4.5-Migration sollte sich nach den Ergebnissen der Evaluierung und der Bereitschaft der Integration richten. Der aktuelle Status lässt Raum für eine bewusste Entscheidung. Die offizielle Lebenszyklusseite sollte weiter auf einen angekündigten Abschalttermin geprüft werden.
Welche Versprechen brauchen Einschränkungen?
Drei verlockende Aussagen brauchen eine Einordnung, bevor sie zur Grundlage für Budget oder Architektur werden.
„90% günstiger“ beschreibt den Preisunterschied bei kurzen Prompts. Es garantiert keine Kostensenkung um 90% für dieselbe abgeschlossene Aufgabe. Tokenisierung, Thinking, Anfragelänge, wiederholte Versuche und Eskalationen beeinflussen die Rechnung. Das Beispiel mit identischen Tokenmengen isoliert den Preiseffekt. Für die eigene Prognose zählen die tatsächlich gemessenen Mengen.
Ein Kontextfenster von einer Million Tokens macht lange Prompts nicht automatisch günstig. Haikus höhere Tarifstufe beginnt deutlich vor dieser Kapazitätsgrenze. Ein Dienst für Zusammenfassungen, der bei jeder Anfrage irrelevanten Verlauf mitführt, kann mehr ausgeben, ohne bessere Zusammenfassungen zu liefern. Der Prompt muss nach dem Zusammenstellen gezählt werden. Dabei muss genügend Platz für die benötigte Ausgabe bleiben.
Ein Regler für den Denkaufwand macht Haiku nicht bei jeder Aufgabe zu Sonnet. Ein höherer Aufwand lohnt einen Test, wenn er einen beobachteten Fehler behebt. Bei längerer Programmierarbeit oder schwierigen Abwägungen gehört Sonnet weiterhin in den Vergleich. Entscheidend sind abgeschlossene Ergebnisse und die verstrichene Zeit einschließlich Wiederholungsversuchen.
Auch Sonnets niedrigerer Cache-Lesepreis verändert den Vergleich für einen bestehenden Agenten. Vor einer Migration sollte dessen aktuelle Rechnung neu berechnet werden: Wiederholt verwendete Eingaben sind nun bei Sonnet günstiger, während neue Eingabe und Ausgabe ihre Listenpreise behalten. Der Preisleitfaden zur Claude API ordnet diese Veröffentlichung in das gesamte Budget für Modelle und Funktionen ein.
Welche Schritte lohnen sich diese Woche?
Eine klar begrenzte Aufgabe mit eindeutiger Abnahmeprüfung lässt sich jetzt angehen. Bei Warteschlangen mit ungeklärten Qualitäts- oder Kapazitätsanforderungen ist Abwarten sinnvoll. Für Gründer, die für wiederholte Klassifizierungen bezahlen, gibt es einen unmittelbar prüfbaren Kandidaten. Ein CTO, der auf Priority Tier angewiesen ist, braucht zuerst eine Kapazitätsentscheidung. Ein Dienst, der sein Budget- und Qualitätsziel bereits erfüllt, kann während des Vergleichs beim bisherigen Modell bleiben.
Eine Warteschlange wählen und ein akzeptables Ergebnis definieren
Repräsentative Eingaben mit bekannten richtigen Antworten bilden die Grundlage, einschließlich mehrdeutiger und schwieriger Fälle. Es muss feststehen, welche Fehler eine Prüfung verlangen und bei welchen ein erneuter Versuch vertretbar ist. Als Einstieg eignen sich Klassifizierung, Datenextraktion oder eine eng begrenzte Zusammenfassung.
Dieselbe Aufgabe mit jedem Kandidaten messen
Haiku 4.5, Haiku 5.5 und Sonnet 5.5 verarbeiten diese Eingaben mit passenden Effort-Einstellungen. Erfasst werden die modellspezifischen Eingabemengen, die abgerechnete Ausgabe, die Zeit bis zum Abschluss und die akzeptierten Ergebnisse. Jeder Versuch gehört in die Kostenrechnung. Für die Prüfung der Promptlängenstufe zählen die Tokenmengen des neuen Tokenizers.
Den geeigneten Teil umziehen und einen Eskalationspfad behalten
Nach den Migrationsprüfungen zieht der Teil der Aufgaben um, dessen gemessene Qualität und Kosten die Anforderungen erfüllen. Ausgaben werden validiert, Fehler untersucht und Sonnet bleibt für die schwierigere Arbeit verfügbar. Erfolg bedeutet eine günstigere akzeptierte Entscheidung in der benötigten Zeit.
Weitere Updates zu Modellen und API-Budgets gibt es im Newsletter.
- Veröffentlicht
- Kategorie
- AI
- Sprache
KI-Meeting-Protokoll: Welche Otter-Alternative passt?
Otter-Alternativen für KI-Meeting-Protokolle: Granola, Krisp, MeetGeek, Circleback und Claap nach Preisen, Gratislimits, Aufnahme ohne Bot und CRM vergleichen.8. Okt. 2026AI
Mistral Large 4: Was es kostet und wann es sich lohnt
Mistral Large 4 im Überblick: API-Preise, Einführungsrabatt und Benchmarks. Wann sich die Preview lohnt und wer auf die Modellgewichte warten sollte.7. Okt. 2026AI
KI-Assistent Lindy AI: Was er kann und was er kostet
KI-Assistent Lindy AI im Überblick: Preise, Credit-Verbrauch, E-Mails, Meetings und Freigabegrenzen – mit Einordnung von Gumloop, n8n und Marblism.7. Okt. 2026AI
Mistral API Pricing 2026: API-Kosten und Vibe im Überblick
Mistral-Preise für API und Vibe: Modellkosten, Gratislimits, EU-Hosting und eine Monatsrechnung im Vergleich. Geprüft im Oktober 2026, alle Preise in USD.6. Okt. 2026AI
Claude Skills im Einsatz: Kundenberichte automatisieren
Claude Skills erstellen, installieren und im Team teilen: Anleitung für wöchentliche Kundenberichte mit geprüften Kennzahlen und menschlicher Prüfung.6. Okt. 2026AI
KI-Agenten als Mitarbeiter: Kosten, Tools und Einstieg
KI-Agenten als digitale Mitarbeiter: Aufgaben, Preise und Grenzen von sechs Tools. So gelingt der Einstieg mit klaren Zuständigkeiten und einem 30-Tage-Pilot.6. Okt. 2026AI
Sprache zu Text: Alternativen zu Wispr Flow im Vergleich (2026)
Wispr Flow, VoiceOS, Superwhisper, Aqua Voice, Willow und Monologue im Vergleich: Preise, Offline-Nutzung, Teamfunktionen und Eingabe für Coding-Agenten.5. Okt. 2026AI