Claude Haiku 5.5: quanto custa e quando vale migrar
Veja o preço do Claude Haiku 5.5, o limite de 100K tokens e a conta mensal frente a Haiku 4.5 e Sonnet 5.5. Entenda quais tarefas vale migrar.
Publicado em
 Por Omid Saffari



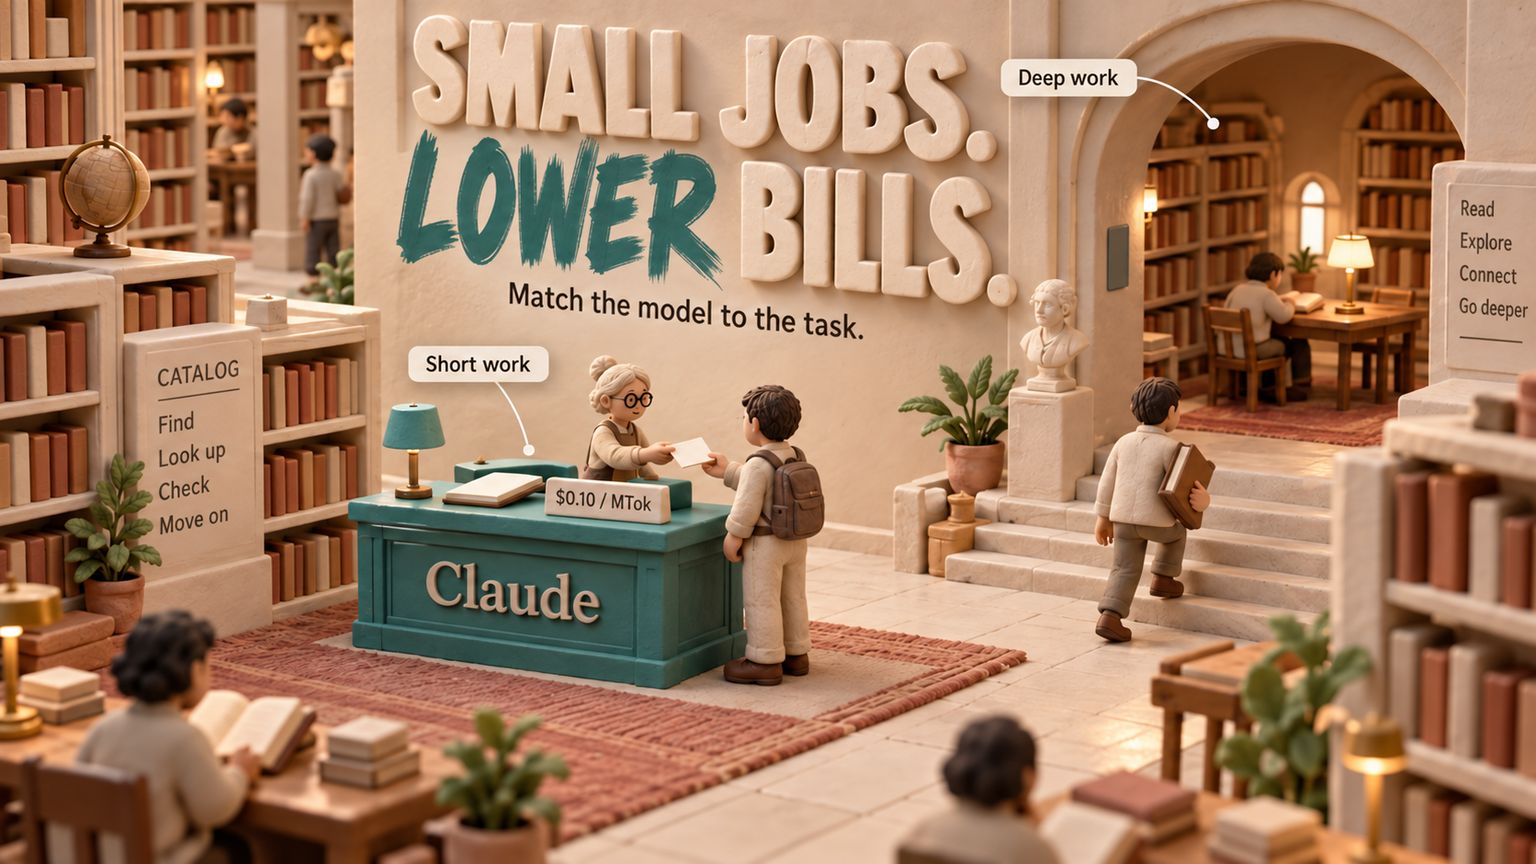
O Claude Haiku 5.5, modelo compacto da Anthropic para tarefas automatizadas frequentes, custa $60 por mês para um milhão de chamadas curtas de classificação, desde que cada uma use 500 tokens de entrada e 20 tokens de saída faturados. É o Claude mais barato da linha atual, mas as tarifas sobem quando o prompt ultrapassa 100,000 tokens. Vale avaliá-lo para classificação, extração, roteamento e resumos. Reserve o Claude Sonnet 5.5, modelo maior e de uso geral da Anthropic, para tarefas em que o custo dos erros ou a complexidade da programação pesem mais que a economia com tokens.
Informações verificadas em 8 de outubro de 2026 no anúncio da Anthropic, na documentação de preços e na visão geral dos modelos. Os orçamentos abaixo são exemplos calculados a partir das premissas indicadas. Todos os preços são os de tabela da Anthropic, em USD.
Claude Haiku 5.5: o que muda na prática?
O Haiku 5.5 reduz bastante o custo de executar repetidamente tarefas de IA bem delimitadas. A Anthropic lançou o modelo em 7 de outubro de 2026, com o identificador de API claude-haiku-5-5, e o apresenta como seu modelo compacto mais barato até agora. Haiku é a linha de modelos menores da família Claude: um primeiro candidato quando você precisa automatizar decisões frequentes e consegue definir com precisão o que é uma resposta aceitável. Anúncio do lançamento.
Em relação ao Claude Haiku 4.5, o modelo compacto anterior, a nova versão combina tarifas menores, mais capacidade e controle do esforço de raciocínio. Isso faz diferença para quem fundou uma empresa e paga por cada classificação de chamado ou campo extraído. O impacto é menor quando a parte mais cara do produto é corrigir os erros do modelo.
A Anthropic informa que o modelo está disponível na Claude API, Amazon Bedrock, Claude Platform on AWS, Google Cloud e Microsoft Foundry. No anúncio, a disponibilidade na Microsoft aparece como Azure. Ao migrar um serviço existente, use a integração e o identificador de modelo da sua plataforma. Lista oficial de plataformas.
Qual é a janela de contexto do Claude Haiku?
Na API padrão, o Haiku 5.5 oferece janela de contexto de 1M de tokens e saída máxima de 128K tokens. A janela de contexto define quanto material o modelo pode considerar em uma requisição; o limite de saída define quanto ele pode gerar. O Haiku 4.5 oferecia 200K de contexto e 64K de saída. Os novos limites permitem tarefas mais longas, mas representam capacidade: não são uma franquia de tokens nem uma garantia de qualidade. Especificações atuais, mudanças entre versões.
Este também é o primeiro Haiku com ajuste de esforço de raciocínio. O raciocínio adaptativo permite ao modelo decidir quando e quanto raciocinar e vem ativado por padrão. Na API, o esforço padrão do Haiku 5.5 é medium. Anúncio, configuração padrão e modo de raciocínio.
Para um classificador simples, comece avaliando o esforço low. Para extração com exceções ou instruções mais rígidas, compare medium e high. A Anthropic oferece low, medium, high, xhigh e max; recomenda usar os níveis mais altos quando a avaliação mostrar ganho e compará-los com o Sonnet. Mais raciocínio pode consumir mais tokens e tempo, por isso registre o nível de esforço junto ao nome do modelo no orçamento. Orientações sobre esforço.
Preço do Claude Haiku: o que acontece ao passar de 100K tokens?
Um prompt com 100,000 tokens recebe a tarifa menor; acima disso, a requisição inteira passa para a tarifa maior. O limite se aplica ao tamanho de cada prompt, independentemente de quantos tokens a conta consome no mês.
Tokens são as unidades de texto que o modelo processa. A entrada é o que você envia, incluindo instruções relevantes, histórico e conteúdo de ferramentas; a saída é o que o modelo gera. MTok significa um milhão de tokens. Estas são as tarifas por MTok:
Fonte: preços dos modelos da Anthropic. Uma leitura de cache reutiliza uma parte da entrada; essa tarifa não vale para todos os tokens da requisição.
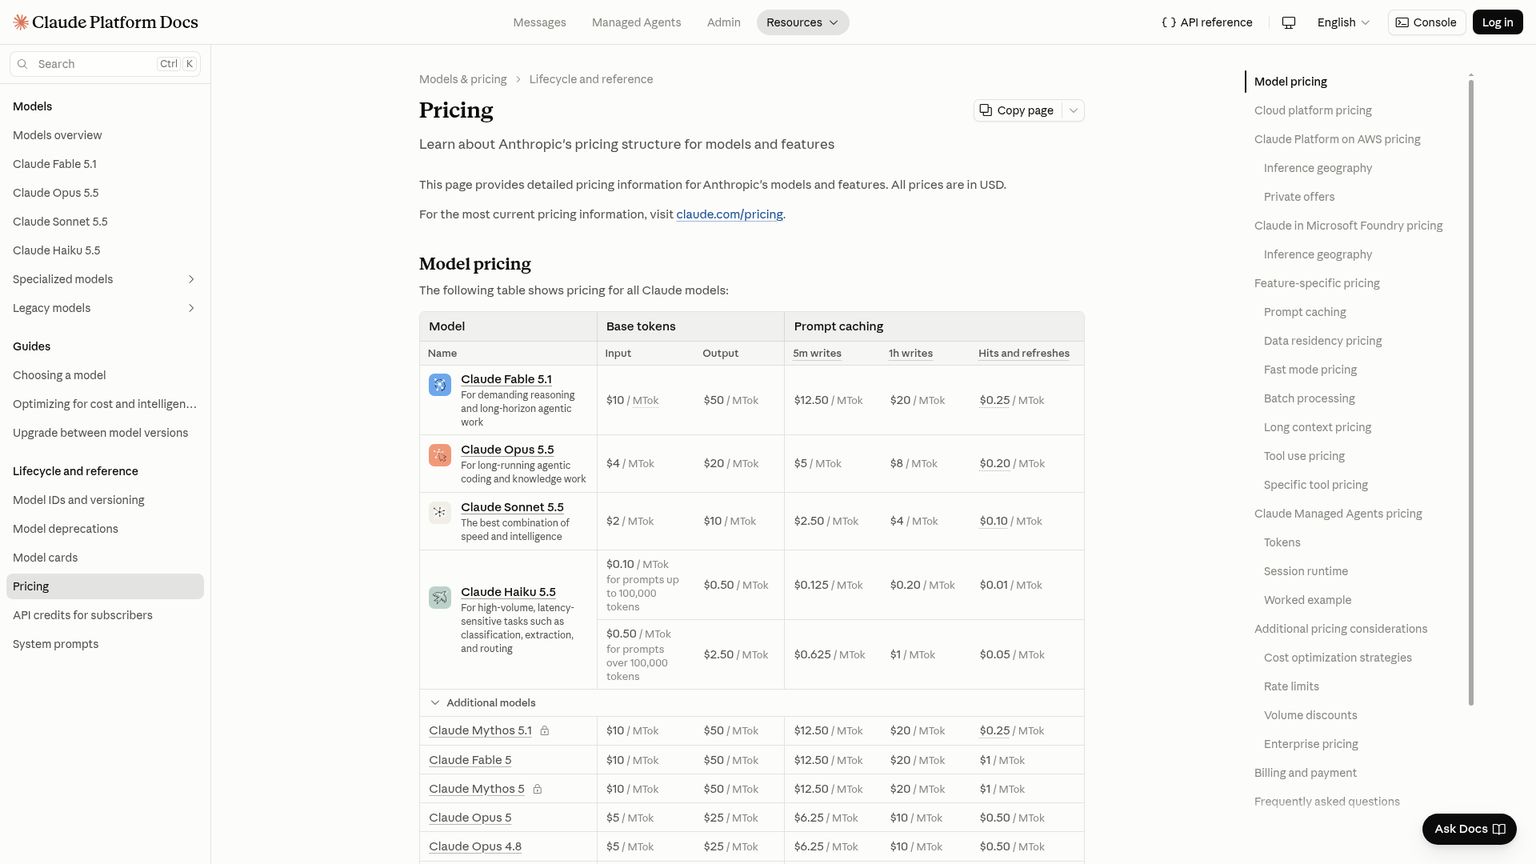
Esse limite do Haiku funciona como uma mudança de faixa de preço: a tarifa maior não incide apenas sobre os tokens excedentes. Para uma requisição ilustrativa sem cache, com 1,000 tokens de saída, o cálculo a partir das faixas publicadas fica assim:
- 100,000 tokens de entrada: 0.1 × $0.10 + 0.001 × $0.50 = $0.01050.
- 100,001 tokens de entrada: 0.100001 × $0.50 + 0.001 × $2.50 = $0.05250050.
Um único token a mais na entrada leva a requisição a tarifas cinco vezes maiores. Mudam tanto a tarifa de entrada quanto a de saída. O cálculo usa a tabela com as duas faixas, entrada sem cache e a mesma quantidade de saída como premissa.
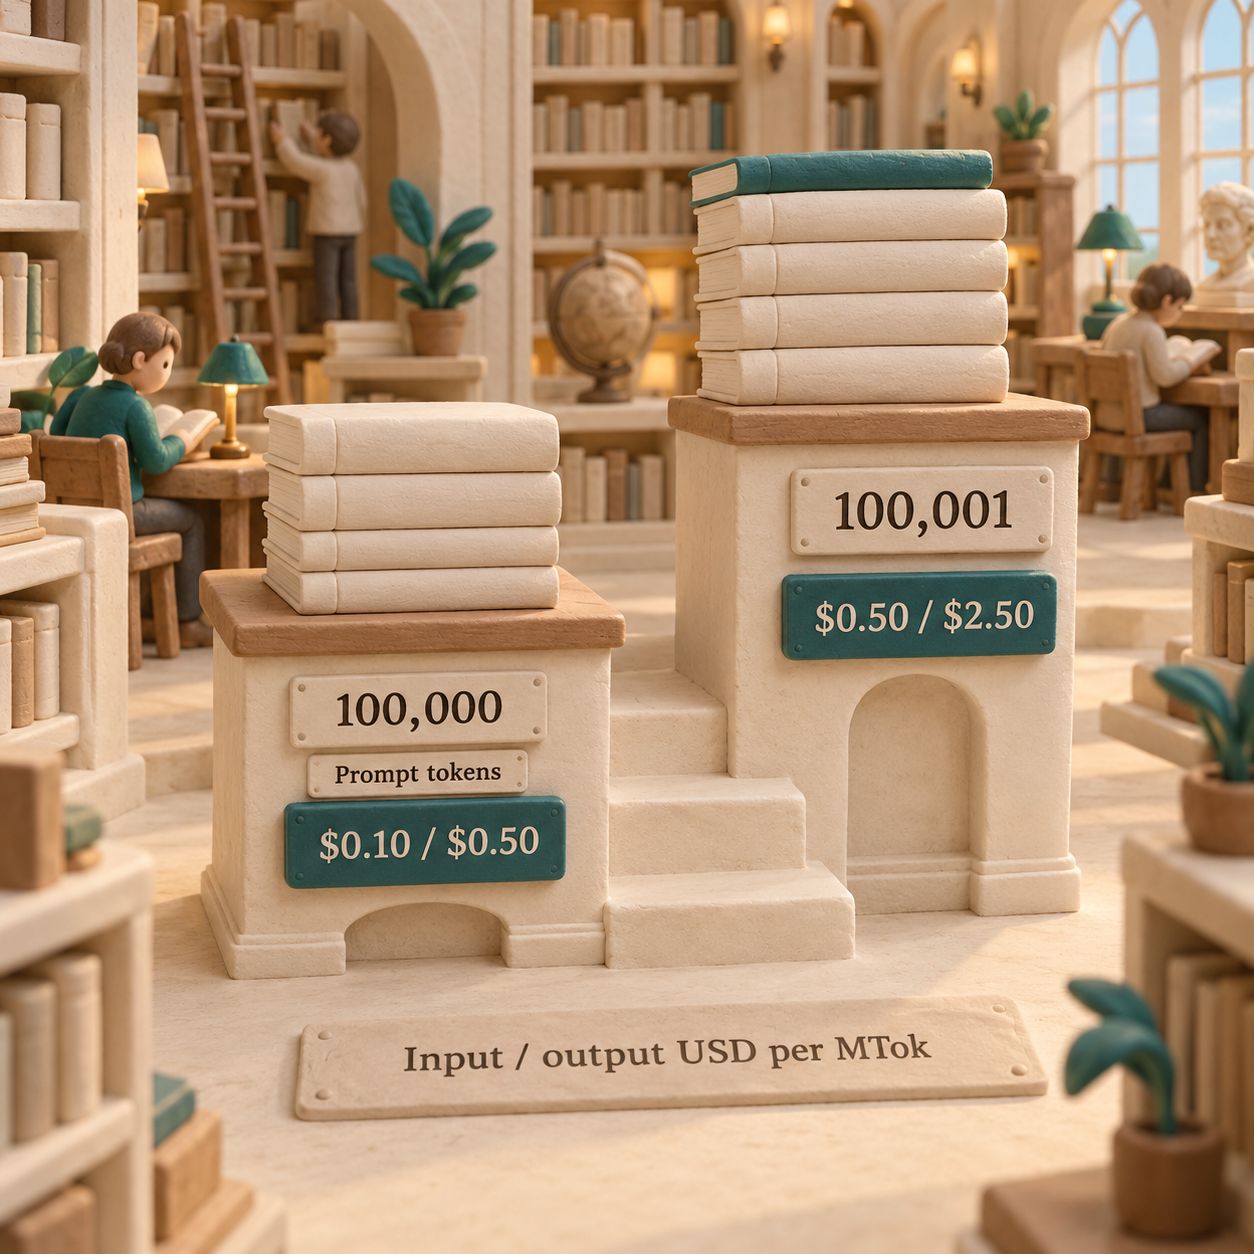
Em um serviço de resumos, reúna o documento relevante e as instruções e conte os tokens da requisição completa. Acrescentar uma conversa inteira ou uma coleção de documentos sem relação com a tarefa pode alterar o custo. Reduza o contexto ou recupere só os trechos relevantes quando isso preservar a qualidade da resposta. Dividir um documento sem critério pode eliminar justamente a relação que o modelo precisava explicar.
Processamento em lote reduz pela metade as tarifas de entrada e saída
Use o processamento em lote quando o resultado puder chegar de forma assíncrona, como na classificação de itens durante a madrugada ou no processamento de resumos de documentos acumulados. As tarifas em lote do Haiku 5.5 são $0.05 de entrada/$0.25 de saída por MTok para prompts de até 100,000 tokens e $0.25/$1.25 acima disso. A Batch API dá 50% de desconto na entrada e na saída. Tabela de preços em lote, processamento em lote.
Mantenha o roteamento de requisições em tempo real em um fluxo de resposta que cumpra o prazo da aplicação. O processamento em lote atende ao trabalho que pode esperar; sua adoção muda a entrega, além do preço.
A leitura de cache a $0.01 exige um prefixo reutilizado elegível
O cache armazena um prefixo de prompt repetido, como uma política de extração que não muda, para reutilizá-lo entre requisições. Na faixa menor do Haiku 5.5, a leitura custa $0.01 por MTok, depois de uma gravação paga: $0.125 por MTok para cache de cinco minutos ou $0.20 para uma hora. Acima do limite de tamanho do prompt, os preços são $0.05 para leitura, $0.625 para gravação de cinco minutos e $1 para gravação de uma hora. Preços de cache.
O mínimo para o Haiku 5.5 é de 512 tokens no prefixo que pode entrar no cache. Prefixos menores são processados sem cache. Uma mensagem do cliente que muda continua sendo entrada sem cache, e uma resposta recém-gerada continua sendo saída. Confira cache_creation_input_tokens e cache_read_input_tokens para confirmar o que aconteceu. Limitações do cache.
Essa diferença importa para classificadores com prompts curtos. O prompt inteiro de 500 tokens do próximo exemplo fica abaixo do mínimo para cache. Um orçamento que contabilize essas chamadas como leituras de cache subestima o gasto.
Quanto custa um milhão de classificações por mês com Claude Haiku?
No exemplo, a conta mensal é de $60 no Haiku 5.5, $600 no Haiku 4.5 ou $1,200 no Sonnet 5.5. A comparação de tarifas considera um classificador de chamados de suporte de um SaaS que retorna a fila de destino e uma decisão estruturada curta.
A premissa é de um milhão de chamadas por mês, cada uma consumindo 500 tokens de entrada sem cache e 20 tokens de saída faturados. Considere essas mesmas quantidades faturadas, separadamente, para cada modelo. Todos os prompts ficam abaixo do limite de preço. Este cenário-base não inclui cache, ferramenta executada no servidor com cobrança separada nem novas tentativas.
O consumo mensal é de 500 milhões de tokens de entrada e 20 milhões de tokens de saída. A conta usa os preços oficiais de tabela:
Com essas premissas, o Haiku 5.5 custa $0.06 por 1,000 classificações. O mesmo trabalho em lote custa $30, $300 ou $600, respectivamente. Esses totais cobrem os tokens dos modelos; a infraestrutura da aplicação e qualquer revisão humana ficam à parte.
Como fica o preço do Claude Haiku 4.5?
Os $1 de entrada/$5 de saída por MTok do Haiku 4.5 equivalem a dez vezes a nova tarifa para prompts curtos. Daí vem a economia mensal de $540 neste exemplo. Para prompts do Haiku 5.5 acima de 100,000 tokens, a diferença diminui: as tarifas passam a ser metade das cobradas pelo Haiku 4.5. Preços publicados.
Deixe explícita a premissa de quantidades iguais de tokens. A Anthropic afirma que o tokenizador atualizado do Haiku 5.5 usa um pouco mais de tokens por tarefa. O tokenizador é o sistema que divide o texto em tokens que podem ser contados. Antes de projetar a economia no seu caso, conte novamente a mesma entrada com o modelo novo e meça a saída faturada, incluindo o raciocínio. Observação da Anthropic sobre o tokenizador, contagem de tokens.
Vinte tokens de saída são uma premissa, não um limite a ser copiado para toda requisição. O raciocínio também consome a capacidade de saída. Se o modelo precisar raciocinar antes de retornar a classificação, a saída faturada pode superar a resposta curta que você vê. Avalie um nível menor de esforço e um limite de saída que dê espaço suficiente para concluir a tarefa. Raciocínio e limites de saída.
Para comparar outros fornecedores, use a mesma carga de trabalho e os mesmos critérios de aceitação no comparativo das APIs de IA mais baratas. Uma tarifa anunciada menor ajuda quando entrega um resultado aceitável dentro do orçamento.
O que muda para quem desenvolve, opera ou contrata?
Comece migrando a parte repetitiva do trabalho. Classificação, extração, roteamento, resumos e subagentes são bons candidatos porque permitem restringir a entrada e inspecionar a saída. A Anthropic posiciona o Haiku para esse tipo de tarefa de alto volume. Posicionamento do modelo.
Para quem desenvolve: dê ao Haiku uma tarefa bem delimitada
Se você é fundador de uma startup que já recebeu investimento, comece pelo classificador de chamados do orçamento acima. Defina as filas permitidas, inclua o chamado e peça uma decisão. Estabeleça um destino para os casos sem solução. Uma validação pode rejeitar uma classificação fora do conjunto permitido; uma amostra avaliada pode revelar classificações que parecem válidas, mas enviam o chamado para a fila errada.
Quem desenvolve sozinho pode usar o Haiku para uma extração igualmente delimitada: obter a data de renovação e o identificador de um contrato a partir de um documento, guardar o trecho que sustenta a resposta e conferir o formato da data. Não deixe o modelo decidir quais condições comerciais prevalecem sobre outras até que a avaliação cubra essas exceções.
Para quem opera: reduza o escopo antes de reduzir o orçamento
Para o CTO de uma empresa de médio porte, a recuperação de trechos relevantes pode importar mais que o tamanho anunciado da janela de contexto. Envie ao modelo de resumo a reunião ou a seção de política relevante e avalie se ele preserva decisões, responsáveis e exceções. Um resumo que omite uma obrigação sem dar sinais disso cria trabalho em outra parte da organização.
Um líder experiente de operações que escolhe um sistema de roteamento deve medir chamados enviados à fila errada, casos sem solução e tempo até uma decisão aceitável. Defina quando escalar com base em evidências observáveis: campos obrigatórios ausentes, trechos conflitantes na fonte, uma categoria não prevista ou uma validação que falhou. A confiança declarada pelo próprio modelo, sozinha, não basta como política de roteamento.
Para quem contrata: defina a unidade pela qual quer pagar
Peça ao fornecedor um orçamento por extração aceita ou caso concluído, incluindo contagem de tokens, esforço, novas tentativas e revisão. A conta de $60 do classificador diz pouco sobre um serviço que repete requisições que falharam ou envia um manual extenso de políticas junto de cada chamado.
No caso dos subagentes — modelos que recebem tarefas menores dentro de um fluxo maior —, dê ao Haiku uma tarefa delimitada de coleta de evidências. Ele pode ser o candidato a localizar um trecho relevante ou devolver um resumo compacto enquanto o Sonnet conduz a decisão mais ampla. Avalie a passagem de informações entre eles: o modelo maior precisa receber material de origem suficiente para conferir o trabalho do subagente.
Claude Haiku vs Sonnet: como escolher?
Escolha o Haiku quando uma resposta delimitada for fácil de verificar; mantenha o Sonnet quando o sucesso depender de julgamento, coordenação ou recuperação após falhas. As tarifas do Sonnet 5.5 para entrada sem cache e saída são 20 vezes as do Haiku para prompts curtos e quatro vezes as de prompts longos. O preço maior precisa se traduzir em melhores resultados aceitos.
A tabela de lançamento da Anthropic justifica avaliar o novo Haiku, mas também dá um motivo para manter o Sonnet nas tarefas de programação mais difíceis. Estes são os resultados de benchmarks publicados pela Anthropic, na ordem Haiku 5.5, Haiku 4.5 e OpenAI GPT-6 Luna:
- GDPval-AA v2.1, trabalho intelectual: 1620, 735 e 1437.
- OSWorld 2.1, subconjunto offline, uso de computador: 72.4%, 15.7% e 48.9%.
- Terminal-Bench 4.0, programação com agentes: 39.2%, 0.0% e 16.4%. A Anthropic informa 70.6% para o Sonnet 5.5 nesse benchmark.
Fonte: tabela de desempenho da Anthropic. Os resultados dos benchmarks respondem a perguntas sobre aquelas tarefas de avaliação. Não estabelecem uma taxa de aceitação para seus contratos, chamados ou base de código.
Mantenha o Sonnet à frente de uma mudança que envolva todo o repositório e exija descobrir dependências, coordenar alterações e se recuperar de etapas que falharam. Considere o Haiku para uma subtarefa, como resumir um arquivo ou extrair uma falha específica de teste. No anúncio, a própria Anthropic recomenda os modelos maiores para programação complexa com agentes.
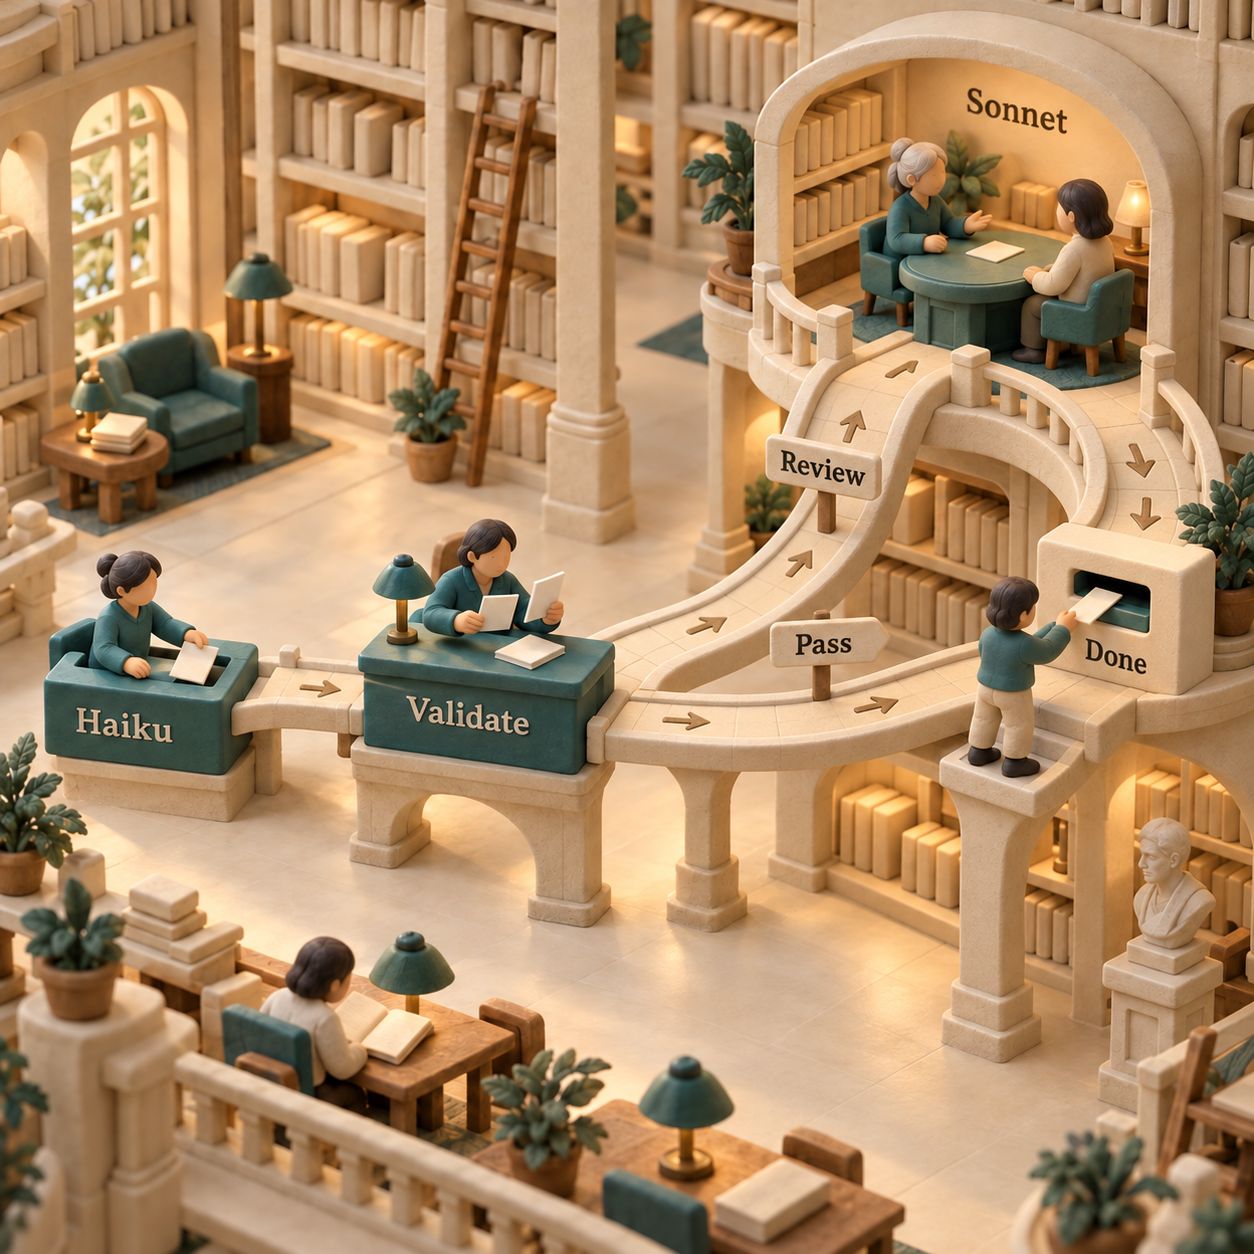
Valide primeiro e só pague pelo Sonnet quando necessário
Um fluxo misto ilustrativo executa todas as classificações no Haiku e envia ao Sonnet os casos sem solução ou que falham na validação. Se 10% precisarem de uma chamada adicional ao Sonnet, com as mesmas quantidades de tokens do cenário-base, a conta mensal será de $60 + $120 = $180. São $1,020 a menos do que executar todas as chamadas no Sonnet. O exemplo não inclui a infraestrutura de validação e pressupõe que a segunda chamada não precise de contexto adicional.
A primeira chamada ao Haiku continua sendo cobrada em todos os casos escalados. Uma projeção que contabiliza apenas o modelo que finalmente entrega o resultado correto deixa esse custo de fora. Meça as novas tentativas como tentativas por tarefa concluída e compare o tempo total, além dos tokens.
Use o guia de configuração do Sonnet 5.5 para o fluxo com o modelo maior. No orçamento, aplique a tarifa atual de $0.10 por MTok para leitura de cache, verificada aqui; a Anthropic a reduziu de $0.20 em 7 de outubro. Mudança de preço.
API do Claude Haiku 4.5: como migrar para o 5.5?
Trate a migração como uma mudança de integração, além da troca do nome do modelo. Um serviço que funcionava com o Haiku 4.5 pode falhar por causa de parâmetros da requisição, interpretação da resposta ou limites de saída, mesmo quando o modelo novo resolve bem a tarefa.
Siga o guia de migração do Haiku da Anthropic para a sua plataforma. As mudanças que exigem atenção são:
- Atualize o identificador e conte os tokens novamente. Use
claude-haiku-5-5na Claude API. Conte os tokens dos prompts com esse modelo e reveja as estimativas de custo e os limites de saída. - Atualize as configurações de raciocínio e amostragem. Substitua a configuração manual
thinking.type: enabledebudget_tokenspor raciocínio adaptativo. Ajusteoutput_config.effortà carga de trabalho. Removatemperature,top_petop_kconforme as instruções do guia. - Remova o preenchimento prévio da resposta do assistente. Uma mensagem final de assistente fornecida para o modelo continuar é rejeitada. Termine a requisição com uma mensagem do usuário e escolha o mecanismo de formato de saída compatível com sua plataforma.
- Leia os blocos da resposta por tipo. A resposta pode começar com um bloco de raciocínio. Selecione os blocos de texto ou de uso de ferramentas de que precisa e trate o esgotamento do limite de saída antes que apareça uma resposta visível.
- Trate recusas e o reenvio do histórico da conversa. Encaminhe um
stop_reasonderefusalpara um fluxo da aplicação. Ao reenviar blocos de raciocínio, preserve-os sem alterações, use a conta que os produziu ou uma conta vinculada e siga as regras do guia para manter o prefixo inalterado.
Para um CTO com capacidade contratada no Priority Tier, há um motivo adicional para esperar: o guia de migração da Anthropic informa que o Haiku 5.5 não oferece suporte ao Priority Tier. Defina uma alternativa de capacidade aceitável antes de migrar a fila. Tokens baratos não substituem um requisito de serviço. Limitação de capacidade.
Quando o Haiku será descontinuado? Confira o status junto da data
Em 8 de outubro de 2026, a página de descontinuações da Anthropic lista o Haiku 4.5 como ativo, com encerramento não antes de 15 de outubro de 2026. Essa data é um limite mínimo, não um anúncio de desligamento naquele dia. O Haiku 5.5 também aparece como ativo, com encerramento não antes de 7 de outubro de 2027. Status dos modelos na Claude API.
Para integrações mais antigas, o Haiku 3.5 foi descontinuado na Claude API em 19 de fevereiro de 2026, e o Haiku 3, em 20 de abril de 2026. São as datas de encerramento registradas na página de ciclo de vida da API, e não um cronograma deduzido a partir do lançamento do 5.5. Histórico de descontinuações.
Planeje a migração do Haiku 4.5 conforme a avaliação e a prontidão da integração. O status atual permite tomar essa decisão com cuidado; continue consultando a página oficial de ciclo de vida para saber quando houver um anúncio de encerramento.
O que o entusiasmo com o lançamento deixa de fora?
Três afirmações atraentes precisam de contexto antes de orientar uma decisão de orçamento ou arquitetura.
“90% mais barato” descreve a diferença de tarifa para prompts curtos. Isso não garante uma redução de 90% para a mesma tarefa concluída. Tokenização, raciocínio, tamanho da requisição, novas tentativas e escalonamentos afetam a conta. O exemplo com quantidades iguais de tokens isola o preço; as quantidades observadas no seu uso determinam a projeção.
Uma janela de um milhão de tokens não torna baratos os prompts longos. A faixa mais cara do Haiku começa muito antes desse limite de capacidade. Um serviço de resumos que carrega histórico irrelevante em toda requisição pode gastar mais sem produzir um resumo melhor. Conte os tokens depois de montar o prompt e reserve espaço suficiente para a saída necessária.
Ajustar o esforço não faz o Haiku resolver qualquer tarefa do Sonnet. Vale avaliar um esforço maior quando ele corrige uma falha observada. Inclua o Sonnet nessa avaliação quando o problema exigir trabalho prolongado de programação ou julgamento difícil. Compare resultados concluídos e tempo decorrido, incluindo as novas tentativas.
A redução no preço de leitura de cache do Sonnet também muda a comparação para quem já usa um agente. Recalcule a conta atual antes de decidir pela migração: a entrada reutilizada repetidamente agora custa menos no Sonnet, enquanto a entrada sem cache e a saída mantêm os preços de tabela. O guia de preços da Claude API situa este lançamento no orçamento mais amplo de modelos e recursos.
Por onde começar nesta semana?
Comece agora por uma tarefa delimitada, com um critério claro de aceitação. Espere para migrar uma fila se os requisitos de qualidade ou capacidade ainda estiverem em aberto. Um fundador que paga por classificações repetidas já tem um candidato para avaliar; um CTO que depende do Priority Tier precisa primeiro decidir como garantir a capacidade. Um serviço que já atende às metas de orçamento e qualidade pode manter o modelo atual enquanto a comparação acontece.
Escolha uma fila e defina um resultado aprovado
Use entradas representativas com respostas corretas conhecidas, incluindo casos ambíguos e difíceis. Defina quais erros exigem revisão e quais falhas permitem uma nova tentativa segura. Comece por classificação, extração ou um resumo com escopo limitado.
Meça o mesmo trabalho em cada modelo candidato
Execute Haiku 4.5, Haiku 5.5 e Sonnet 5.5 com essas entradas e níveis de esforço adequados. Registre a contagem de entrada de cada modelo, a saída faturada, o tempo por tarefa concluída e os resultados aceitos. Inclua todas as tentativas no cálculo de custo. Use a contagem do novo tokenizador para conferir a faixa de preço por tamanho do prompt.
Migre os casos aprovados e mantenha uma rota de escalonamento
Conclua as verificações de migração e transfira o subconjunto cuja qualidade e custo observados atendem aos seus requisitos. Valide as saídas, examine as falhas e mantenha o Sonnet para o trabalho mais difícil. O resultado esperado é uma decisão aceita mais barata, na velocidade de que você precisa.
Receba as próximas atualizações sobre modelos e custos de APIs na newsletter.
- Publicado
- Categoria
- AI
- Idioma
Transcrição de reuniões: qual alternativa ao Otter AI vale a pena?
Compare Granola, Krisp, MeetGeek, Circleback e Claap para transcrição de reuniões: preços, limites grátis, gravação sem bot e integrações com CRM.8 de out. de 2026AI
Mistral Large 4: quanto custa e quando vale testar
Veja os preços do Mistral Large 4, o desconto de lançamento e os limites do preview. Saiba quando testar a API e quando esperar pelos pesos abertos.7 de out. de 2026AI
Assistente de IA Lindy: preços, limites e quando vale a pena
Veja se o assistente de IA Lindy vale a pena: planos, consumo de créditos, e-mails, reuniões, limites de aprovação e alternativas para sua empresa.7 de out. de 2026AI
Mistral API: quanto custa usar a IA e assinar o Vibe em 2026
Veja os preços da Mistral API, uma conta mensal calculada e os planos do Vibe. Compare custos, créditos, limites gratuitos e opções de hospedagem regional.6 de out. de 2026AI
Claude Skills: do CSV ao relatório semanal do cliente
Aprenda a criar uma skill de relatório semanal com Claude Skills, validar métricas em Python e instalar e compartilhar o fluxo no app, Claude Code e API.6 de out. de 2026AI
Agentes de IA como funcionários: custos e como começar
Veja o que agentes de IA podem fazer, os preços de seis ferramentas e como testar uma função por 30 dias com revisão humana e controle de custos.6 de out. de 2026AI
Digitação por voz: alternativas ao Wispr Flow para cada tarefa
Compare alternativas ao Wispr Flow para digitação por voz: preços, uso offline, privacidade e recursos para equipes com VoiceOS, Superwhisper e outros.5 de out. de 2026AI