Claude Haiku: quanto costa 5.5 e dove conviene usarlo
Claude Haiku 5.5: prezzi API, soglia dei 100K token e costi mensili a confronto con Haiku 4.5 e Sonnet 5.5. Scopri quali attività conviene spostare.
Pubblicato il
 Di Omid Saffari



Claude Haiku 5.5, il modello compatto di Anthropic per le attività automatizzate frequenti, costa $60 al mese per un milione di brevi chiamate di classificazione, ciascuna con 500 token di input e 20 token di output fatturati. È il Claude più economico attualmente disponibile, ma le tariffe aumentano quando un prompt supera i 100,000 token. Vale la pena valutarlo per classificazione, estrazione di dati, instradamento e sintesi; Claude Sonnet 5.5, il modello generalista più grande di Anthropic, resta la scelta per i lavori in cui gli errori o la complessità del codice pesano più del risparmio sui token.
Dati verificati l’8 ottobre 2026 sull’annuncio di Anthropic, sulla documentazione dei prezzi e sulla panoramica dei modelli. I budget riportati sotto sono esempi calcolati sulla base di ipotesi esplicite. Tutti i prezzi sono quelli di listino di Anthropic, in USD.
Claude Haiku 5.5: le novità da conoscere
Haiku 5.5 riduce molto il costo delle attività di AI ben delimitate e ripetute spesso. Anthropic lo ha rilasciato il 7 ottobre 2026, con l’identificativo API claude-haiku-5-5, e lo presenta come il suo modello compatto più economico di sempre. Haiku è la linea di modelli compatti della famiglia Claude: il primo candidato da provare quando servono decisioni automatizzate frequenti ed è possibile definire con precisione una risposta accettabile. Annuncio del rilascio.
Rispetto a Claude Haiku 4.5, il precedente modello compatto, cambiano le tariffe, la capacità e la possibilità di regolare il ragionamento. Sono differenze rilevanti per chi paga ogni etichetta assegnata a un ticket o ogni campo estratto. Contano meno quando il costo principale del prodotto è correggere gli errori del modello.
Anthropic indica la disponibilità tramite Claude API, Amazon Bedrock, Claude Platform on AWS, Google Cloud e Microsoft Foundry. Nell’annuncio, la disponibilità su Microsoft è descritta come Azure. Per migrare un servizio esistente, occorre usare l’integrazione e l’identificativo del modello previsti dalla propria piattaforma. Elenco ufficiale delle piattaforme.
Quanto contesto può gestire Claude Haiku?
Nell’API standard, Haiku 5.5 offre una finestra di contesto da 1M token e un massimo di 128K token di output. La finestra di contesto determina quanto materiale il modello può gestire in una richiesta; il limite di output stabilisce quanto può generare. Haiku 4.5 offriva 200K token di contesto e 64K di output. I nuovi limiti consentono di affrontare lavori più lunghi, ma indicano una capacità: non sono un pacchetto di token inclusi né una garanzia di qualità. Specifiche attuali, novità della versione.
È anche il primo Haiku con un livello di effort regolabile. L’adaptive thinking, attivo per impostazione predefinita, lascia al modello la scelta di quando ragionare e quanto farlo. Nell’API di Haiku 5.5, il livello di effort predefinito è medium. Annuncio, impostazioni predefinite e modalità di ragionamento.
Per un classificatore semplice, conviene provare prima l’effort low. Per estrazioni con eccezioni o istruzioni più rigide, confrontare medium e high. Anthropic supporta low, medium, high, xhigh e max; consiglia i livelli più alti quando le valutazioni mostrano un miglioramento, confrontandoli con Sonnet. Più ragionamento può richiedere più token e più tempo: nel budget, registrare quindi l’effort insieme al nome del modello. Indicazioni sull’effort.
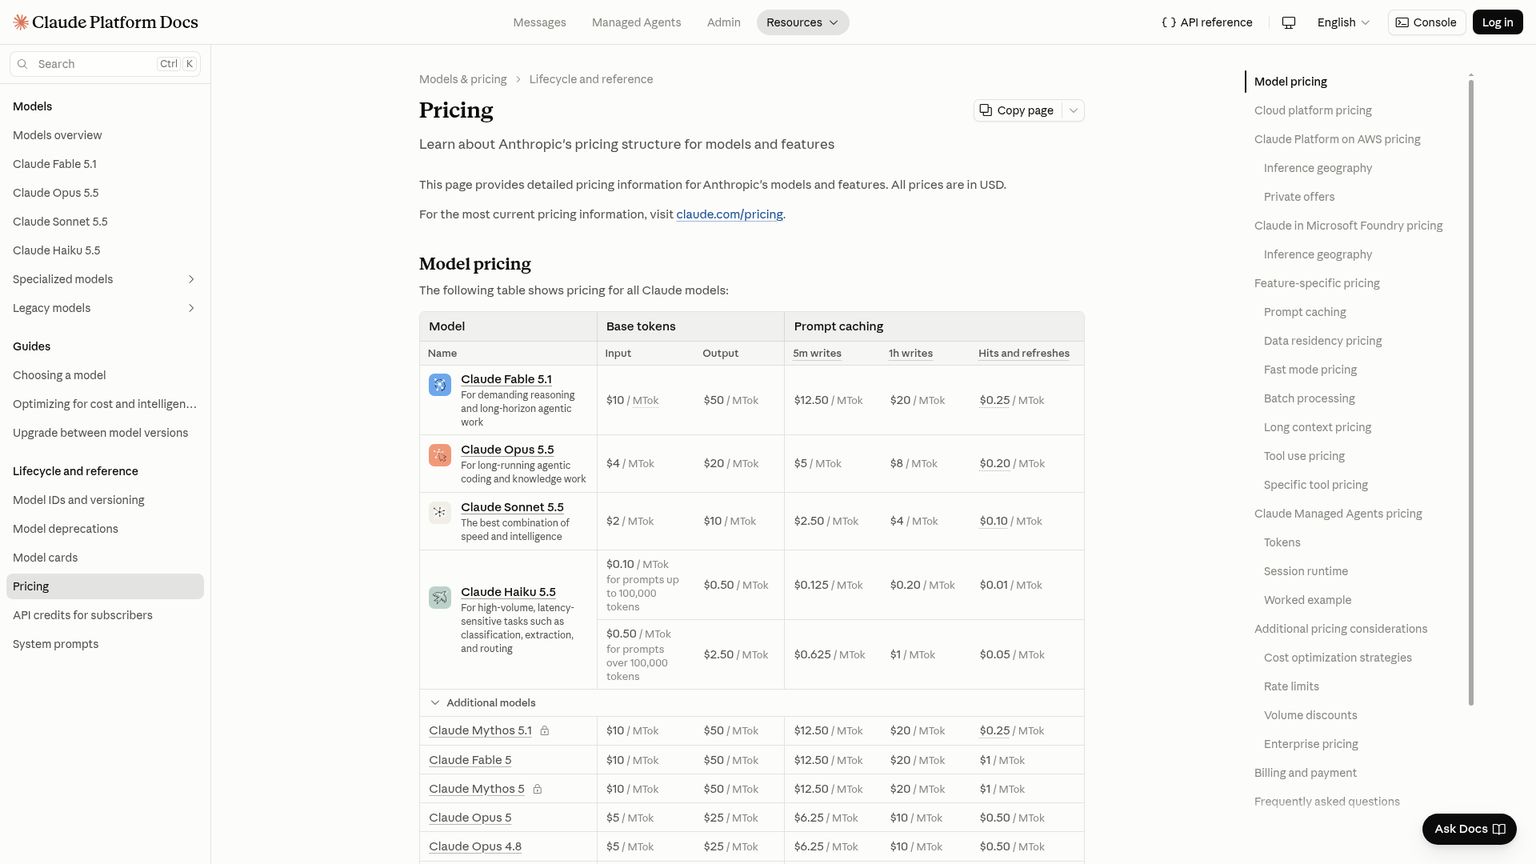
Prezzi di Claude Haiku: cosa cambia oltre 100K token
Un prompt da 100,000 token rientra nella tariffa bassa; uno più lungo fa scattare la tariffa alta per quella richiesta. La soglia riguarda la lunghezza di ciascun prompt, indipendentemente dal totale di token consumati dall’account nel mese.
I token sono le porzioni di testo elaborate dal modello. L’input è ciò che si invia, comprese istruzioni pertinenti, cronologia e materiale proveniente dagli strumenti; l’output è ciò che il modello genera. MTok significa un milione di token. Le tariffe per MTok sono:
Fonte: prezzi dei modelli Anthropic. Un cache hit corrisponde al riutilizzo di una parte dell’input; la relativa tariffa non si applica a tutti i token della richiesta.
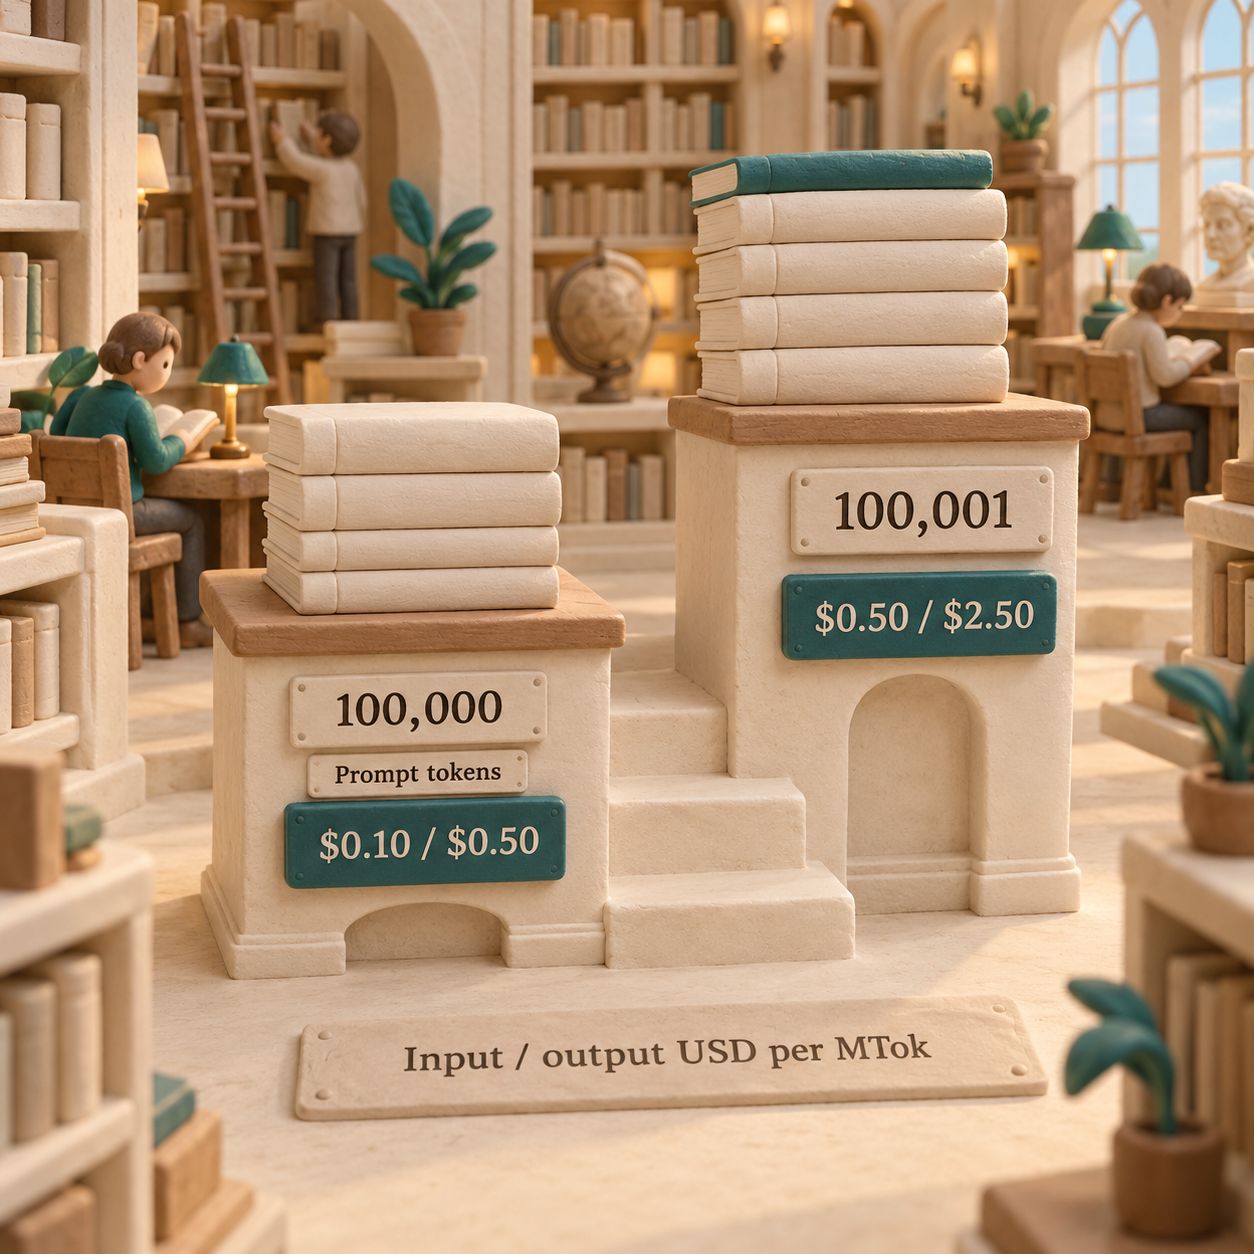
La soglia di Haiku introduce un salto di tariffa, non un sovrapprezzo limitato ai token in eccesso. Per una richiesta di esempio senza cache e con 1,000 token di output, il nostro calcolo basato sulle fasce pubblicate è:
- 100,000 token di input: 0.1 × $0.10 + 0.001 × $0.50 = $0.01050.
- 100,001 token di input: 0.100001 × $0.50 + 0.001 × $2.50 = $0.05250050.
Basta un token di input in più per passare a tariffe cinque volte superiori. Cambiano sia la tariffa dell’input sia quella dell’output. Il calcolo usa il listino a due fasce, ipotizzando input senza cache e la stessa quantità di output.
In un servizio di sintesi, tenere insieme il documento pertinente e le istruzioni, poi contare i token della richiesta completa. Aggiungere un’intera conversazione o una raccolta di documenti non pertinenti può cambiare i costi. Accorciare il contesto o recuperare solo il materiale necessario quando la qualità della risposta lo consente. Dividere un documento senza criterio può far perdere proprio il collegamento che si voleva far spiegare al modello.
Con il batch, input e output costano la metà
Il batch è adatto quando il risultato può arrivare in modo asincrono, per esempio per assegnare etichette durante la notte o smaltire un arretrato di documenti da sintetizzare. Le tariffe batch di Haiku 5.5 sono $0.05 per l’input/$0.25 per l’output per MTok fino a 100,000 token di prompt, e $0.25/$1.25 oltre la soglia. La Batch API riduce del 50% il prezzo di input e output. Listino batch, elaborazione batch.
Per instradare le richieste in tempo reale, mantenere un percorso di risposta compatibile con i tempi richiesti dall’applicazione. Il batch è una scelta per il lavoro che può aspettare: cambia sia il prezzo sia la modalità di consegna del risultato.
Cache a $0.01: serve un prefisso riutilizzabile idoneo
Il caching conserva un prefisso del prompt che si ripete, come una serie di regole di estrazione invariate, per riutilizzarlo nelle richieste successive. Nella fascia bassa, la lettura della cache di Haiku 5.5 costa $0.01 per MTok, dopo una scrittura a pagamento: $0.125 per MTok per una cache di cinque minuti, oppure $0.20 per un’ora. Oltre la soglia di lunghezza del prompt, i prezzi sono $0.05 per le letture, $0.625 per le scritture con durata di cinque minuti e $1 per quelle con durata di un’ora. Prezzi del caching.
Per Haiku 5.5, il prefisso memorizzabile in cache deve contenere almeno 512 token. I prefissi più brevi vengono elaborati senza cache. Un messaggio del cliente che cambia resta input non in cache, e una risposta appena generata resta output. Controllare cache_creation_input_tokens e cache_read_input_tokens per verificare cosa è successo. Limiti della cache.
La distinzione conta per i classificatori con prompt brevi. L’intero prompt da 500 token dell’esempio seguente è sotto il minimo richiesto per il caching. Un budget che conteggiasse queste chiamate come cache hit sottostimerebbe la spesa.
Quanto costa un milione di classificazioni al mese con Claude Haiku?
Nell’esempio, il costo mensile è $60 con Haiku 5.5, $600 con Haiku 4.5 e $1,200 con Sonnet 5.5. Il confronto riguarda le tariffe per un classificatore di ticket di assistenza di un SaaS, che restituisce l’etichetta della coda e una breve decisione strutturata.
Ipotizziamo un milione di chiamate al mese, ciascuna con 500 token di input non in cache e 20 token di output fatturati. Per ogni modello assumiamo separatamente questi stessi conteggi fatturati. Tutti i prompt restano sotto la soglia di prezzo. Questo scenario di base non prevede caching, strumenti lato server con addebito separato né nuovi tentativi.
Il consumo mensile è di 500 milioni di token di input e 20 milioni di token di output. Il calcolo usa le tariffe ufficiali di listino:
Con queste ipotesi, Haiku 5.5 costa $0.06 ogni 1,000 classificazioni. Lo stesso lavoro in batch costa rispettivamente $30, $300 o $600. I totali coprono i token del modello; l’infrastruttura dell’applicazione e l’eventuale revisione umana restano costi separati.
Quanto si risparmia rispetto a Claude Haiku 4.5?
Le tariffe di Haiku 4.5, $1 per l’input/$5 per l’output per MTok, sono dieci volte quelle nuove per i prompt brevi. Da qui derivano i $540 di risparmio mensile dell’esempio. Per i prompt di Haiku 5.5 oltre 100,000 token, il vantaggio si riduce: le tariffe sono la metà di quelle di Haiku 4.5. Prezzi pubblicati.
Va tenuta in evidenza l’ipotesi di un numero di token identico. Anthropic afferma che il tokenizer aggiornato di Haiku 5.5 usa un numero leggermente maggiore di token per attività. Il tokenizer è il sistema che suddivide il testo in token conteggiabili. Prima di stimare il risparmio per il proprio lavoro, ricontare lo stesso input con il nuovo modello e misurare l’output fatturato, compreso il ragionamento. Nota di Anthropic sul tokenizer, conteggio dei token.
Venti token di output sono un’ipotesi, non un limite da copiare in ogni richiesta. Anche il ragionamento occupa capacità di output. Se il modello deve ragionare prima di restituire l’etichetta, l’output effettivamente fatturato può superare la breve risposta visibile. Valutare un effort più basso e un limite di output che lasci spazio sufficiente per completare il lavoro. Ragionamento e limiti di output.
Per confrontare altri fornitori, applicare lo stesso carico di lavoro e gli stessi criteri di accettazione al confronto tra le API AI più economiche. Una tariffa dichiarata più bassa è utile quando permette di ottenere un risultato accettabile entro il budget.
Come scegliere i primi casi d’uso: sviluppo, operazioni e acquisti
Spostare prima la parte del lavoro che si ripete. Classificazione, estrazione, instradamento, sintesi e subagenti sono buoni candidati perché è possibile delimitare gli input e controllare gli output. Anthropic propone Haiku per questi tipi di attività ad alto volume. Posizionamento del modello.
Sviluppo: assegnare a Haiku un compito ben delimitato
Per chi ha fondato una startup finanziata, un punto di partenza è il classificatore di ticket del budget precedente. Definire le code consentite, includere il ticket e richiedere una sola decisione. Prevedere una destinazione per i casi irrisolti. Un controllo di validazione può respingere un’etichetta fuori dall’insieme consentito; un campione valutato può far emergere etichette apparentemente valide che indirizzano il ticket alla coda sbagliata.
Chi sviluppa da solo può usare Haiku per un’estrazione altrettanto circoscritta: recuperare da un documento la data di rinnovo e l’identificativo del contratto, conservare il testo che li giustifica e verificare il formato della data. Evitare di affidare al modello la scelta di quali condizioni commerciali prevalgano sulle altre finché la valutazione non copre queste eccezioni.
Operazioni: ridurre il lavoro prima di ridurre il budget
Per il CTO di un’azienda di medie dimensioni, il recupero del contesto pertinente può contare più della dimensione massima della finestra. Fornire al modello di sintesi la riunione o la sezione di policy rilevante, poi verificare che mantenga decisioni, responsabili ed eccezioni. Una sintesi che omette un obbligo senza segnalarlo crea lavoro altrove nell’organizzazione.
Un responsabile operativo senior che sceglie un sistema di instradamento dovrebbe misurare ticket assegnati alla coda sbagliata, casi irrisolti e tempo necessario per ottenere una decisione accettabile. Definire l’escalation sulla base di elementi osservabili: campi obbligatori mancanti, passaggi delle fonti in conflitto, categorie non supportate o controlli non superati. La dichiarazione di sicurezza del modello, da sola, non basta come regola di instradamento.
Acquisti: definire il risultato per cui si vuole pagare
Chiedere al fornitore un preventivo per estrazione accettata o caso completato, includendo conteggi dei token, effort, nuovi tentativi e revisione. Il budget da $60 del classificatore dice poco su un servizio che ripete spesso le richieste fallite o invia un voluminoso manuale di policy insieme a ogni ticket.
I subagenti sono modelli incaricati di svolgere compiti più piccoli all’interno di un flusso di lavoro più ampio. In questo contesto, assegnare a Haiku una raccolta di elementi a supporto ben delimitata. Può essere il candidato che trova un passaggio pertinente o restituisce una sintesi compatta, mentre Sonnet prende la decisione complessiva. Valutare il passaggio di consegne: il modello più grande deve ricevere materiale di origine sufficiente per controllare il lavoro del subagente.
Claude Haiku vs Sonnet: come decidere
Scegliere Haiku quando una risposta circoscritta è facile da verificare; mantenere Sonnet quando la riuscita dipende da giudizio, coordinamento o recupero dopo un errore. Le tariffe di Sonnet 5.5 per i token non in cache sono 20 volte quelle di Haiku per i prompt brevi e quattro volte quelle per i prompt lunghi. Il prezzo superiore deve tradursi in risultati accettabili migliori.
La tabella dell’annuncio di Anthropic giustifica una valutazione del nuovo Haiku, ma offre anche un motivo per tenere Sonnet sui lavori di programmazione più difficili. Quelli che seguono sono i risultati dei benchmark pubblicati da Anthropic, nell’ordine Haiku 5.5, Haiku 4.5 e OpenAI GPT-6 Luna:
- GDPval-AA v2.1, lavoro intellettuale: 1620, 735 e 1437.
- OSWorld 2.1, sottoinsieme offline, uso del computer: 72.4%, 15.7% e 48.9%.
- Terminal-Bench 4.0, programmazione agentica: 39.2%, 0.0% e 16.4%. Per questo benchmark, Anthropic riporta 70.6% per Sonnet 5.5.
Fonte: tabella delle prestazioni di Anthropic. I punteggi rispondono a domande su quelle specifiche prove. Non stabiliscono il tasso di accettazione sui propri contratti, ticket o codice.
Tenere Sonnet alla guida di una modifica che coinvolge l’intero repository e richiede di individuare dipendenze, coordinare interventi e recuperare dopo passaggi falliti. Considerare Haiku per un sottocompito, come sintetizzare un file o estrarre il dettaglio di uno specifico test fallito. Nell’annuncio, Anthropic stessa consiglia i modelli più grandi per la programmazione agentica complessa.
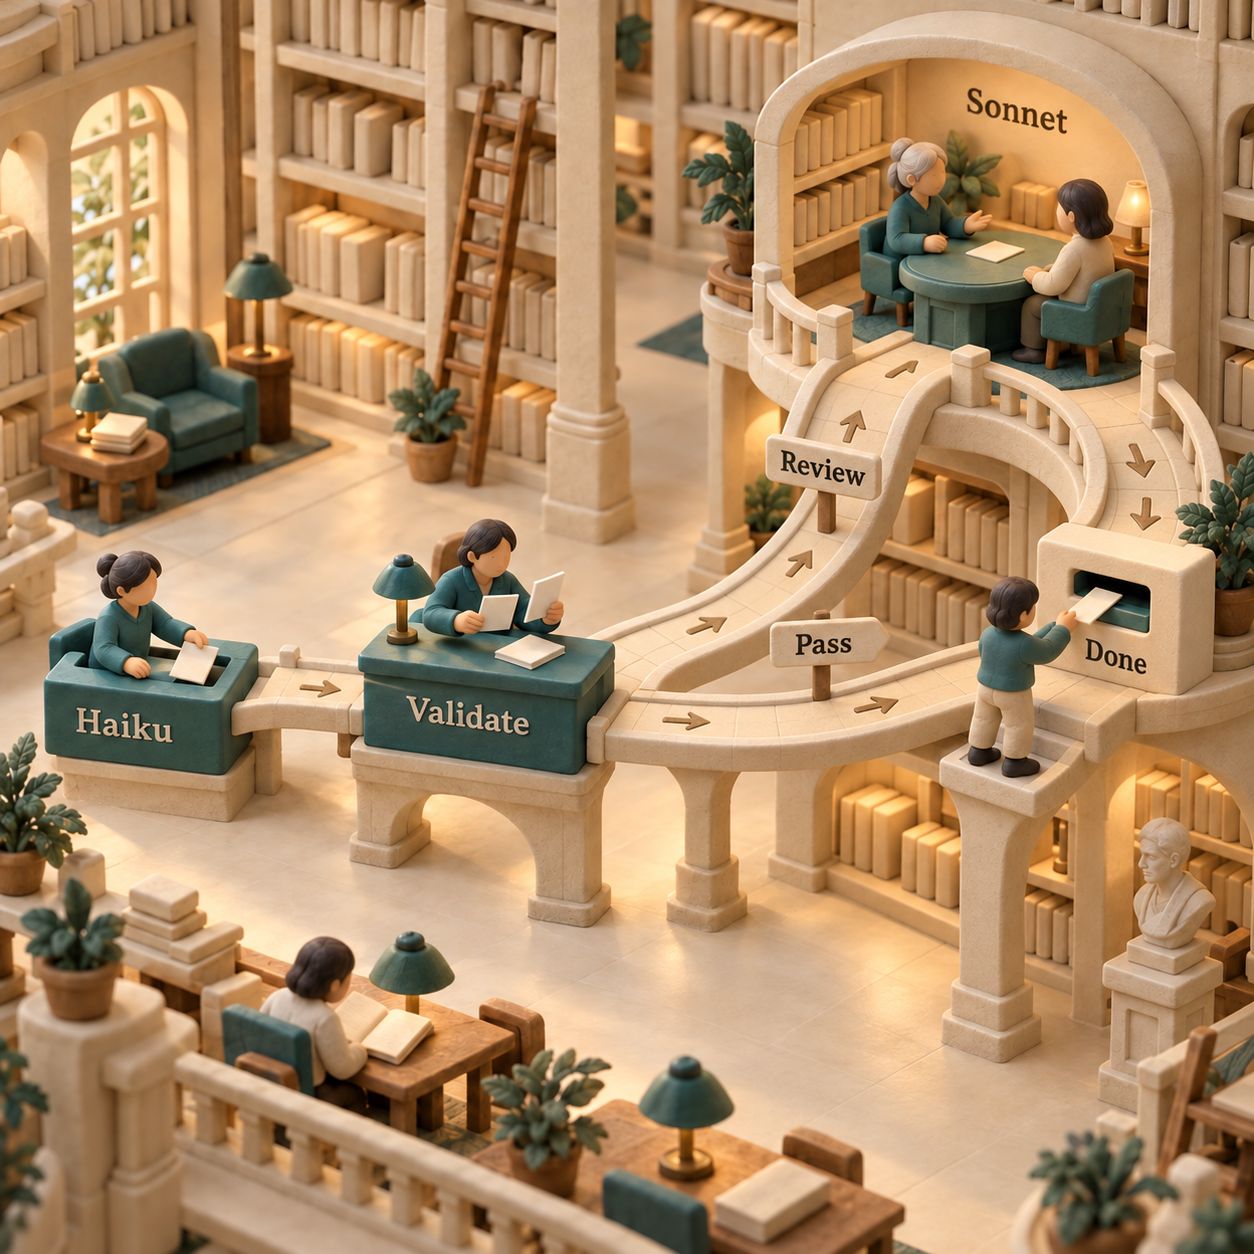
Prima validare, poi pagare l’escalation
Un flusso misto di esempio esegue ogni classificazione su Haiku e passa a Sonnet i casi irrisolti o che non superano la validazione. Se il 10% richiede una chiamata aggiuntiva a Sonnet, con gli stessi conteggi di token dello scenario di base, il costo mensile è $60 + $120 = $180. Sono $1,020 in meno rispetto a eseguire tutte le chiamate su Sonnet. L’esempio esclude l’infrastruttura di validazione e assume che la seconda chiamata non richieda contesto aggiuntivo.
La prima chiamata a Haiku viene comunque fatturata in ogni caso passato a Sonnet. Una stima che conteggia solo il modello che alla fine riesce a completare il lavoro omette quel costo. Misurare i nuovi tentativi come numero di esecuzioni per lavoro completato e confrontare, oltre ai token, il tempo complessivo.
Per il percorso con il modello più grande, usare la guida alla configurazione di Sonnet 5.5. Nel budget, applicare l’attuale tariffa di lettura della cache di $0.10 per MTok, verificata qui: Anthropic l’ha ridotta da $0.20 il 7 ottobre. Variazione del prezzo.
API di Claude Haiku 4.5: come passare a 5.5
Il passaggio richiede di aggiornare l’integrazione, oltre al nome del modello. Un servizio che funzionava con Haiku 4.5 può fallire per i parametri della richiesta, la lettura della risposta o i limiti di output, anche quando il nuovo modello svolge bene il compito.
Seguire la guida di Anthropic alla migrazione di Haiku per la propria piattaforma. Le modifiche più rilevanti sono:
- Aggiornare l’identificativo e ricontare i token. Sulla Claude API, usare
claude-haiku-5-5. Ricontare i prompt con quel modello e rivedere le stime di costo e i limiti di output. - Aggiornare le impostazioni di ragionamento e campionamento. Passare dall’impostazione manuale tramite
thinking.type: enabledebudget_tokensall’adaptive thinking. Impostareoutput_config.effortin base al carico di lavoro. Rimuoveretemperature,top_petop_kcome indicato nella guida. - Eliminare il prefill dell’assistente. Un messaggio finale dell’assistente fornito perché il modello lo continui viene respinto. Terminare la richiesta con un turno utente e scegliere il meccanismo supportato dalla piattaforma per il formato dell’output.
- Leggere i blocchi della risposta in base al tipo. Una risposta può iniziare con un blocco di ragionamento. Selezionare i blocchi di testo o di uso degli strumenti necessari e gestire il caso in cui lo spazio di output si esaurisca prima di una risposta visibile.
- Gestire rifiuti e riproduzione della conversazione. Instradare un
stop_reasonpari arefusalverso un percorso applicativo previsto. Se si ripropone il ragionamento, mantenere i blocchi invariati, usare l’account che li ha prodotti o un account collegato e rispettare le regole della guida sui prefissi invariati.
Per un CTO con un impegno di capacità su Priority Tier, c’è un motivo ulteriore per aspettare: la guida alla migrazione di Anthropic indica che Haiku 5.5 non supporta Priority Tier. Prima di spostare la coda, definire una soluzione di capacità accettabile. I token economici non sostituiscono un requisito di servizio. Limite di capacità.
Ritiro di Haiku: conta lo stato, oltre alla data
All’8 ottobre 2026, la pagina delle deprecazioni di Anthropic indica Haiku 4.5 come Active, con ritiro non prima del 15 ottobre 2026. È un limite minimo, non l’annuncio di una disattivazione in quella data. La stessa pagina indica Haiku 5.5 come Active, con ritiro non prima del 7 ottobre 2027. Stato dei modelli sulla Claude API.
Per le integrazioni più vecchie, Haiku 3.5 è stato ritirato dalla Claude API il 19 febbraio 2026, e Haiku 3 il 20 aprile 2026. Sono le date di ritiro riportate nella pagina sul ciclo di vita dell’API, non un calendario dedotto dal rilascio di 5.5. Cronologia delle deprecazioni.
Pianificare la migrazione da Haiku 4.5 in funzione delle valutazioni e della preparazione dell’integrazione. Lo stato attuale permette di decidere con criterio; continuare a consultare la pagina ufficiale del ciclo di vita per l’annuncio di un eventuale ritiro.
Le promesse da ridimensionare
Tre affermazioni allettanti richiedono precisazioni prima di diventare decisioni di budget o architettura.
«90% in meno» descrive la differenza di tariffa per i prompt brevi. Non garantisce una riduzione del 90% per lo stesso lavoro completato. Tokenizzazione, ragionamento, lunghezza delle richieste, tentativi ripetuti ed escalation incidono sulla fattura. L’esempio a parità di conteggio isola il prezzo; i conteggi osservati nel proprio caso determinano la previsione.
Una finestra da un milione di token non rende economici i prompt lunghi. La fascia alta di Haiku scatta molto prima di quel limite di capacità. Un servizio di sintesi che include cronologia irrilevante in ogni richiesta può spendere di più senza produrre una sintesi migliore. Contare il prompt dopo averlo assemblato e lasciare spazio sufficiente per l’output necessario.
Regolare l’effort non rende Haiku equivalente a Sonnet in ogni attività. Vale la pena provare un effort più alto quando risolve un errore osservato. Includere Sonnet nella valutazione quando il problema richiede programmazione prolungata o giudizi difficili. Confrontare risultati completati e tempo impiegato, compresi i nuovi tentativi.
Anche il taglio del prezzo di lettura della cache di Sonnet cambia il confronto per un agente già in uso. Ricalcolarne la fattura attuale prima di decidere la migrazione: l’input riutilizzato ripetutamente costa ora meno su Sonnet, mentre input non in cache e output mantengono le tariffe di listino. La guida ai prezzi della Claude API colloca questo rilascio nel budget complessivo di modelli e funzionalità.
Da dove partire questa settimana
Agire subito su un carico circoscritto, con un controllo di accettazione chiaro. Aspettare se i requisiti di qualità o capacità della coda sono ancora da risolvere. Chi ha fondato un’azienda e paga classificazioni ripetute ha un candidato da valutare subito; un CTO che dipende da Priority Tier deve prima decidere come garantire la capacità. Un servizio che rispetta già il budget e l’obiettivo di qualità può mantenere il modello attuale durante il confronto.
Scegliere una coda e definire un risultato accettabile
Usare input rappresentativi con risposte corrette note, includendo casi ambigui e difficili. Specificare quali errori richiedono revisione e quali esecuzioni fallite si possono ripetere in sicurezza. Iniziare con classificazione, estrazione o una sintesi circoscritta.
Misurare lo stesso lavoro su ogni candidato
Eseguire Haiku 4.5, Haiku 5.5 e Sonnet 5.5 su quegli input con livelli di effort adatti. Registrare per ciascun modello i conteggi di input, l’output fatturato, il tempo per completare il lavoro e i risultati accettati. Includere ogni tentativo nel calcolo del costo. Per verificare la fascia legata alla lunghezza del prompt, usare i conteggi del nuovo tokenizer.
Spostare i casi che superano i controlli e mantenere l’escalation
Completare i controlli di migrazione, poi spostare il sottoinsieme la cui qualità e il cui costo osservati soddisfano i requisiti. Validare gli output, esaminare gli errori e mantenere Sonnet per il lavoro più difficile. Il risultato utile è una decisione accettabile più economica, ottenuta alla velocità richiesta.
Per i prossimi aggiornamenti su modelli e budget API, iscriversi alla newsletter.
- Pubblicato
- Categoria
- AI
- Lingua
Alternative a Otter AI: quale scegliere per riunioni e CRM
Confronta Granola, Krisp, MeetGeek, Circleback e Claap: prezzi, limiti gratuiti, appunti senza bot e integrazioni CRM per scegliere in base al lavoro.8 ott 2026AI
Mistral Large 4: quando conviene e quanto costa davvero
Quanto costa Mistral Large 4? Prezzi API, sconto di lancio, benchmark e limiti della preview: quando provarlo e quando aspettare i pesi per il self-hosting.7 ott 2026AI
Agenti AI: recensione di Lindy per email e riunioni
Recensione di Lindy AI per email e riunioni: prezzi, crediti, integrazioni e limiti delle approvazioni, con alternative per scegliere il servizio adatto.7 ott 2026AI
Mistral pricing: quanto costano API e Vibe nel 2026
Scopri i prezzi delle API Mistral, i piani Vibe e i limiti gratuiti. Confronta i costi, calcola una spesa mensile e valuta le opzioni di hosting in UE.6 ott 2026AI
Claude Skills: crea una skill per il report settimanale
Scopri come usare Claude Skills nelle app, in Claude Code e via API. Crea una skill per i report clienti settimanali, con calcoli verificati e revisione.6 ott 2026AI
Agenti AI in azienda: ruoli, costi e come iniziare
Scopri cosa possono fare gli agenti AI, i costi di sei strumenti e come avviare un progetto pilota di 30 giorni con controllo umano e risultati misurabili.6 ott 2026AI
Dettatura vocale: le alternative a Wispr Flow nel 2026
Confronta le alternative a Wispr Flow per la dettatura vocale: prezzi, privacy offline, funzioni per i team e prompt per agenti di programmazione.5 ott 2026AI