拡張子なしファイルを改名せずCloudflare AI Searchに登録する方法
Cloudflare AI Searchが、正しいHTTP Content-Typeを持つ拡張子なしファイルをR2からインデックス化できるようになりました。リネーム工程を省ける条件、残る同期・検証作業、メタデータ修復時のR2コスト、Workersでの実装方法、移行前に確認すべき制限を実務目線で解説します。

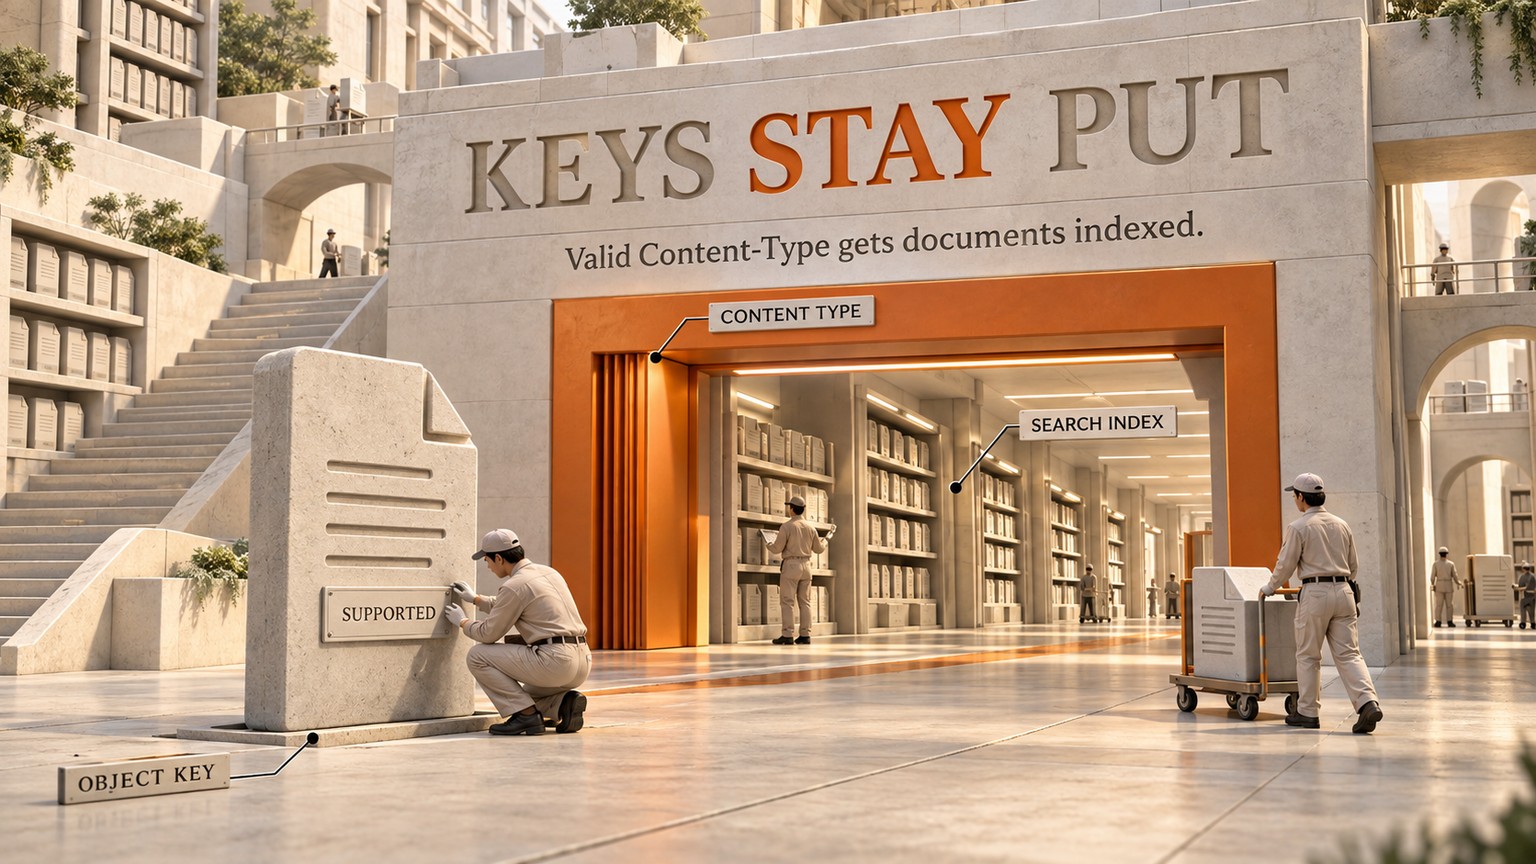
Cloudflare AI Searchは2026年9月11日、R2への取り込みで問題になっていたファイル名の制約を緩和しました。拡張子なしファイルを安定したキーで保存していても、対応するHTTP Content-Typeを各オブジェクトに設定すれば、キーを変えずに検索可能にできます。
これにより、取り込みワークフローからリネーム工程を外せます。ただし、メタデータの整備、インデックス作成、ドキュメントが実際に検索可能になったかの確認は、引き続き必要です。
Cloudflare AI Searchで拡張子なしファイルを扱える仕組み
Cloudflare AI Searchは、自社コンテンツ向けのマネージド検索サービスです。データの取り込み元には、CloudflareのオブジェクトストレージであるR2バケットを指定できます。AI Searchはバケットを読み込み、対応するドキュメントを検索可能なテキストに変換し、アプリからクエリを送る際に使うインデックスを構築します。
従来、ファイル形式を確実に判定するにはファイル名の拡張子が必要でした。manual.pdfというキーなら、インデクサーはファイル形式を識別できます。一方、documents/manual-alphaのような安定したキーだけでは判定できませんでした。
今回から、AI Searchは拡張子のないオブジェクトに付いた通常のHTTP Content-Typeを利用できます。application/pdfなら中身はPDF、text/markdownならMarkdownだと判定されます。Cloudflareはこのほか、text/plain、application/json、text/html、text/csvも対応形式として挙げています。
ファイル拡張子が不要になったわけではありません。Cloudflareは今も、認識可能な拡張子を優先的かつ高速な判定経路としています。新しい経路が効くのは、キーを変えるとURL、データベース参照、テナントのマッピング、署名、既存のアップロード契約などが壊れてしまうケースです。
ここで混同しやすい点があります。Content-TypeはR2オブジェクトに付くHTTPメタデータです。カテゴリ、顧客、ドキュメントの状態といったフィルターにAI Searchが使うカスタムメタデータとは別物です。カスタムフィールドはx-amz-meta-*ヘッダーで渡し、AI Search側でスキーマを定義する必要があります。x-amz-meta-content-typeを追加しても、本来のHTTPフィールドの代わりにはなりません。
今回変わったのは、ドキュメントがインデックスに入る入口にあたるソース取り込みです。検索後に回答を生成するモデルは変わりません。GLM-5.3 Flashのアップデートは、その後段にある生成処理の変更です。
実務上の変化は、命名ルールをひとつ減らせること
不透明なキーが広く使われているのには理由があります。たとえば、安定したデータベースIDをR2キーにすれば、オブジェクトを差し替えてもアドレスは変わりません。ドキュメントサービスなら、顧客の元ファイル名を外部に見せずに済みます。署名付きURLがキーそのものに依存している場合もあります。
従来の回避策は、検索用コピーに拡張子付きの名前を付けるか、AI Searchがオブジェクトを見る前にリネーム工程を挟むことでした。その結果、保存・突合・削除の対象となる識別子がもうひとつ増えていました。
今回の更新では、HTTPメタデータが正しければ元のキーを維持できます。これが、ワークフロー上の実質的な削減です。
取り込み作業が更新前後でどう変わるかを整理すると、次のようになります。これはプロセスのモデルであり、実測ベンチマークでも、削減効果の保証でもありません。
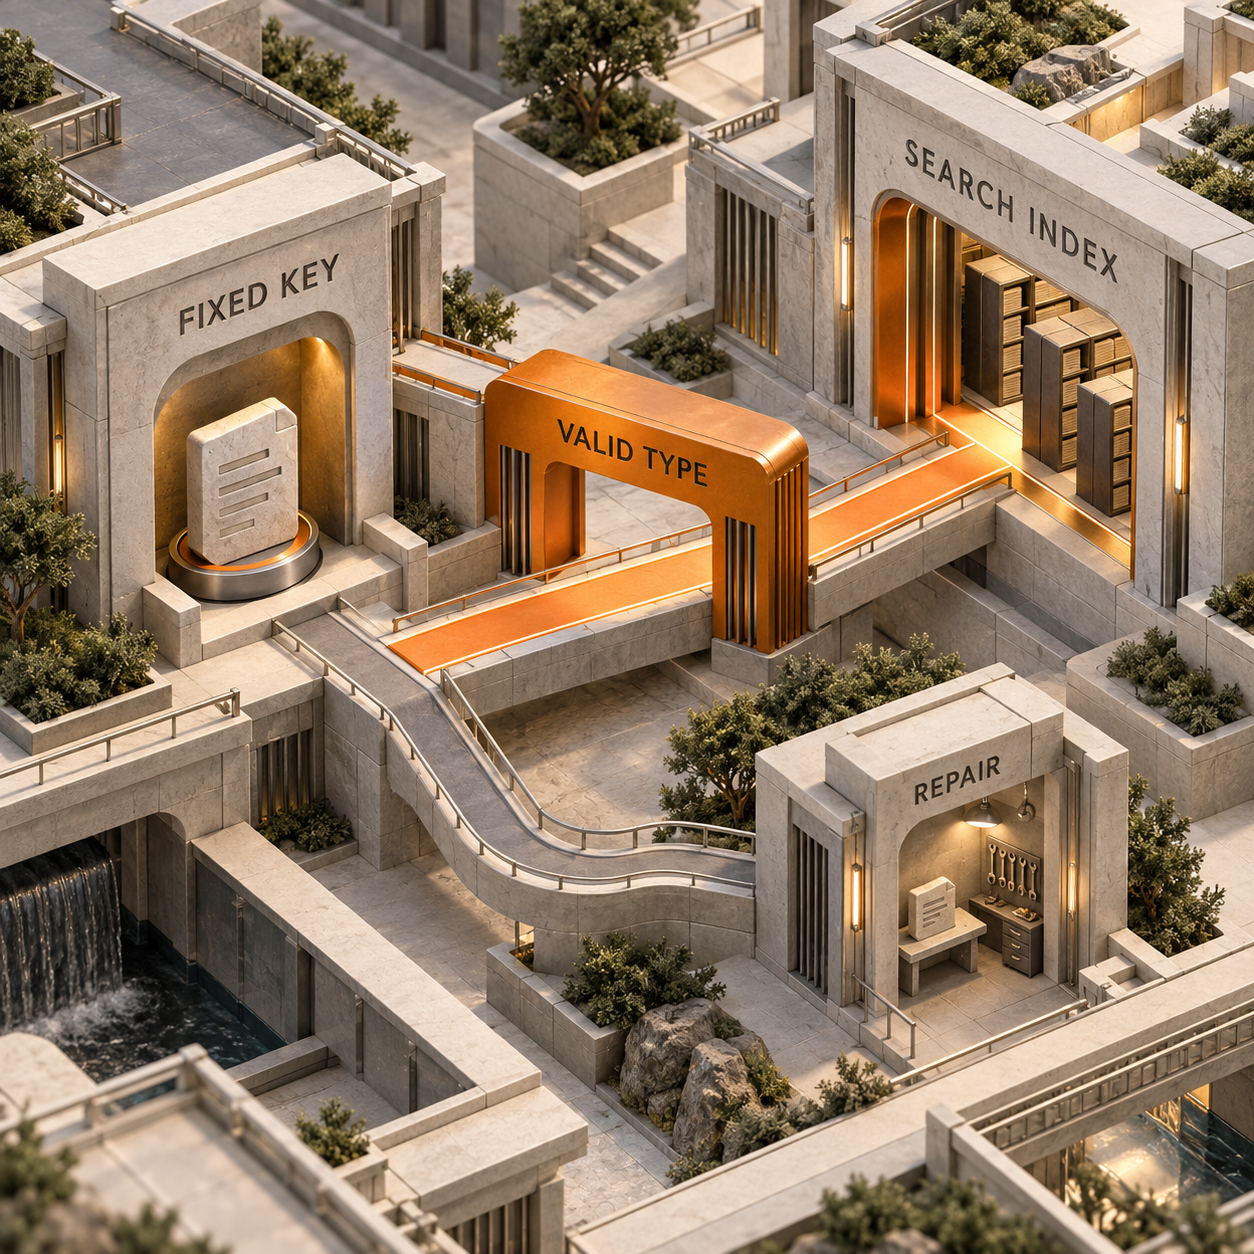
この表が意図的に金額を示していない点には理由があります。Cloudflareはこの機能による時間削減を公表しておらず、今回のリリースが既存のメタデータを書き換えてくれるわけでもありません。
残る作業にはどれだけコストがかかるか
AI Searchはオープンベータ期間中、Workersプランの上限内で無料です。ストレージとベクトルインデックス作成も含まれます。Workers AIとAI Gatewayの利用には別途料金が発生する場合がありますが、今回の取り込み変更によってその料金体系は変わりません。
一方、メタデータの修復はR2の請求に影響することがあります。ListObjects、PutObject、CopyObjectはClass Aオペレーションとして数えられます。修復ツールがオブジェクトの確認や読み取りに使う可能性があるHeadObjectとGetObjectは、Class Bオペレーションです。
Standardストレージでは、月間100万回の無料枠を超えると、Class Aリクエストは100万回あたり$4.50です。Infrequent Accessには無料枠がなく、Class Aリクエストは100万回あたり$9.00です。オブジェクトの読み取りやコピー時には、GBあたり$0.01が加算される場合もあります。
予算を考える際の基準は明快です。Content-Typeが正しいオブジェクトなら、リネームのための修復は必要ありません。値が誤っていれば、利用するツール次第で書き込みまたはコピーが必要になります。バケット全体の修復を予定する前に、発生するオペレーション数を数えておくべきです。
AI Search側では規模の上限にも注意が必要です。Workers Freeのインスタンスあたり上限は100,000ファイルです。Workers Paidでは100万ファイル、ハイブリッド検索を有効にした場合は500,000ファイルまで利用できます。4 MBのファイル上限は、どちらのプランでも変わりません。
明日から活用できるのは誰か
安定したアップロードIDを使う個人SaaS開発者
データベースに保存済みのR2キーはそのまま使い、アップローダーがオブジェクトを書き込む際に正しいMIMEタイプを付けるようにします。これでサポート検索は、ファイル名用の列を追加したり、検索用コピーを作るバッチジョブを用意したりせず、同じオブジェクトを取り込めます。
顧客がドキュメントを差し替え、削除し、移動したときに突き合わせる識別子が減るのが利点です。ただし、検索対象にするオブジェクトが汎用バイナリ型で届いた場合は、アップロード時に拒否する必要があります。
レガシーバケットを抱えるプラットフォームエンジニア
拡張子なしオブジェクトとそのHTTPメタデータを一覧にし、Cloudflareが対応するMIMEタイプと各値を比較して、失敗対象を切り分けます。バケット全体に手を入れる前に、小さなサンプルで修復を試します。
利点は、移行範囲を限定できることです。修復費用を必要なオブジェクトだけに使い、有効なメタデータを持つキーはそのまま同期と確認へ進められます。
マルチテナント製品の開発チーム
元のファイル名が外部に漏れない不透明なオブジェクトキーを維持し、アップロード時に信頼できるサーバー側の検査結果からContent-Typeを設定します。テナントごとにインデックス範囲を分ける必要がある場合は、AI Searchのパスフィルターやプレフィックスを別途適用します。
利点は、アーキテクチャに一貫性を持たせられることです。ストレージ上の識別子をファイル表示名から独立させたまま、インデクサーには検証可能な型情報を渡せます。
顧客のナレッジベースを運用するエージェンシー
運用手順では、メタデータの役割を分けて扱います。拡張子なしファイルを取り込めるかどうかはHTTP Content-Typeで決まります。インデックス済みの検索結果をどう絞り込むかは、スキーマ定義後のカスタムx-amz-meta-*フィールドで決まります。
こうしておけば、原因の切り分けが明確になります。ドキュメントが見つからないとき、フィルタールールや回答モデルを変更する前に、チームはまず取り込み用メタデータを確認できます。
拡張子なしオブジェクトを対応する取り込み経路に載せる
CloudflareのR2 Workers APIでは、リクエストヘッダーをhttpMetadataとして渡せます。次のWorkerはリクエストパスをそのままオブジェクトキーとして使い、Content-Typeがないアップロードを拒否します。
DOCSという名前でR2バケットをwrangler.jsoncにバインドします。
{
  "$schema": "./node_modules/wrangler/config-schema.json",
  "name": "r2-document-upload",
  "main": "src/index.ts",
  "compatibility_date": "2026-09-11",
  "r2_buckets": [
    {
      "binding": "DOCS",
      "bucket_name": "your-bucket"
    }
  ]
}
続いて、次のWorkerを使います。
interface Env {
  DOCS: R2Bucket;
}

export default {
  async fetch(request, env): Promise<Response> {
    if (request.method !== "PUT") {
      return new Response("Method Not Allowed", { status: 405 });
    }

    const key = new URL(request.url).pathname.replace(/^\//, "");
    const contentType = request.headers.get("content-type");

    if (!key || !contentType) {
      return new Response("Key and Content-Type are required");
    }

    await env.DOCS.put(key, request.body, {
      httpMetadata: request.headers,
    });

    return new Response(`Stored ${key}`);
  },
} satisfies ExportedHandler<Env>;
npx wrangler devを実行し、Wranglerが表示したローカルアドレスをWORKER_URLに設定します。そのうえで、ローカルのPDFを拡張子のない保存先へアップロードします。
curl "$WORKER_URL/documents/manual-alpha" \
  --request PUT \
  --header "Content-Type: application/pdf" \
  --data-binary @manual.pdf
この例で確認できるのはストレージへの保存までで、インデックス作成までは証明できません。本番環境では認証を追加し、ユーザーのファイル名だけに頼らず信頼できる検査から型を判定し、Cloudflareの対応形式一覧と照合してください。
アップロード成功だけでは検索可能とは限らない
R2への書き込みには強い整合性があるため、書き込み成功後はオブジェクトとメタデータを確認できます。一方、AI Searchのインデックス作成は別の非同期ジョブです。同期リクエストが受理されても、後からアイテムが失敗することはあります。
R2を取り込み元にするインスタンスの同期は、デフォルトで6時間ごとです。間隔は1、2、4、6、12、24時間から選べるほか、次のコマンドで自分でジョブを開始できます。
npx wrangler ai-search jobs create <INSTANCE_NAME>手動のソース同期を実行できるのは、最短でも30秒に1回です。再試行の回数を増やしても、不正なメタデータは直りません。
ジョブの完了後に、アイテムログ、アイテム詳細、またはインスタンス統計を確認します。AI Searchが検出したファイル形式を受け付けられないときは、アイテム単位のエラーとしてunsupported_typeが記録されます。オブジェクトを修正し、そのアイテムまたはソースをもう一度同期してください。
すべてのR2キーに認識可能な拡張子が付いているなら、今回の変更による影響はありません。AI Searchのソースが外部R2バケットではなく、Webサイトや組み込みストレージである場合も同様です。未対応の形式や上限を超えるファイルが、この変更でインデックス可能になるわけではありません。
次の月曜日にやること
最初に行うべきは、一括書き換えではなく監査です。
取り込まれなかった拡張子なしオブジェクトを見つける
httpMetadataを含めてR2オブジェクトを一覧取得し、truncatedがfalseになるまでページをたどります。最後のパス部分に拡張子がないキーを抽出し、AI Searchのアイテムログやunsupported_typeエラーと突き合わせます。メタデータを分類する
対応するMIMEタイプと、欠落、不正、未対応、
application/octet-streamの値を分けます。カスタムx-amz-meta-*フィールドは別の問題を解決するものなので、この確認には含めません。小規模な取り込みで修復を試す
実際に保存している形式から、偏りのない小さなサンプルを選びます。利用するツールで可能なら元のキーを保ったまま、正しいHTTP
Content-Typeを付けて各オブジェクトを書き込むかコピーします。同期し、検索できることを確かめる
ソース同期を一度実行します。アイテムの処理完了を待ってログを確認し、各ドキュメント内の既知の語句を検索します。ストレージへの書き込み成功がゴールではありません。ソースの該当箇所が返って初めて完了です。
検証できてから範囲を広げる
修復方法によって発生するClass AとClass Bのオペレーション数を見積もり、R2のストレージクラスを確認してからバッチを拡大します。同時にアップローダーも更新し、新しい拡張子なしオブジェクトに対応するメタデータが付くようにします。
安定した、または不透明なR2キーのためにAI Search用の別の命名経路を維持しているなら、今週中に対応する価値があります。既存オブジェクトに信頼できる型情報がないなら、書き換え前に分類計画が必要なので待つべきです。認識可能な拡張子だけで取り込みを問題なく運用できているなら、何もする必要はありません。
次のプラットフォーム変更も運用判断まで落とし込んで読みたい方は、ニュースレターにご登録ください。
- 最終更新
- 2026年9月12日
- カテゴリー
- Explained
Googleでこのサイトを優先する


omidsaffari.comを優先ソースに設定すると、GoogleがTop Stories・AI Overviews・AI Modeであなたのために優先表示します。
AI 文字起こしの料金は据え置き:Grok Voice Transcribe 2.0移行ガイド
Grok Voice Transcribe 2.0のAI 文字起こし料金は、バッチが音声1時間あたり$0.10、ストリーミングが$0.20のままです。デフォルトモデル変更で起こり得る出力差、移行前に確認すべき総コスト、1.0と2.0を同条件で検証して本番モデルを固定する手順を、運用担当者向けに整理します。2026年9月20日Explained
HAR ファイルで原因を追う:Cloudflare Browser Runの失敗調査
Cloudflare Browser RunのSession RecordingにInspectパネルが加わり、完了後のログ、通信、最終DOMを確認できるようになりました。HAR ファイルで失敗原因を絞り込み、不要な再実行を減らす手順、料金への影響、録画では見えない領域まで、実務向けに分かりやすく解説します。2026年9月19日Explained
v0でnpm プライベートパッケージを活用する:社内コンポーネント再利用の実践ガイド
v0が共有環境変数経由でnpm プライベートパッケージに対応。NPM_TOKENとNPM_RCの選び方、認証情報をモデルやSandboxに渡さない仕組み、社内コンポーネントを試作から本番へ引き継ぐ設定手順、料金と実務上の注意点を整理し、差し替え工数を減らせるか判断する方法を解説します。2026年9月19日Explained
Claude Code 料金を見直す:auto modeの分類器課金が消える条件
Claude Code 2.1.278では、auto modeの安全判定をサーバー側で処理できるセッションの分類器リクエスト課金がなくなります。API、Enterprise、クラウド、ゲートウェイ環境で適用条件を見極め、/statusで実際の課金経路を確認し、予算へ正しく反映する方法を解説します。2026年9月19日Explained
Vercel ビルド高速化:Turboを1回だけ使う方法と料金
VercelのPro/Enterpriseで、プロジェクト設定を変えずに1回のデプロイだけTurboを指定する方法を解説します。GitHubのコミットマーカー、Vercel CLI、デプロイAPIという3つの経路と、1分あたり$0.105からの料金、権限不足時のフォールバック、通常ビルドとの比較手順まで整理しました。2026年9月18日Explained
ChatGPT Word連携の実力:できること・料金・導入手順
ChatGPT Word連携を使えば、Wordのサイドバーで下書き、要約、選択範囲の修正、見出し調整まで完結します。利用条件、共有される使用量、料金の考え方、データ境界、導入手順を、提案書やSOPの具体例とともに解説。コピペ往復を減らしつつ、事実や約束を守るレビュー方法も紹介します。2026年9月18日Explained
Google Antigravity移行ガイド:10月5日までのローカルジョブ対応
Google Antigravityの5月版エージェントは2026年10月5日に停止予定です。出力のみのジョブはID変更で済みますが、ローカルツールやfunction_callを扱う環境には、新しいツール名、PascalCase引数、行範囲編集に対応するアダプター改修が必要です。安全な移行手順を解説します。2026年9月18日Explained