AIエージェント基盤で何を削り、何を残すか:Anthropic SDK 0.100–0.102とCloudflare移行
Anthropic SDK 0.100.0〜0.102.0のManaged Agentsを検証。AIエージェント基盤のCloudflare WorkflowsでoutcomesとWebhookをどう使い、約280行を削るのか。再試行とコスト上限を残し、マルチエージェント移行を見送る理由も解説します。



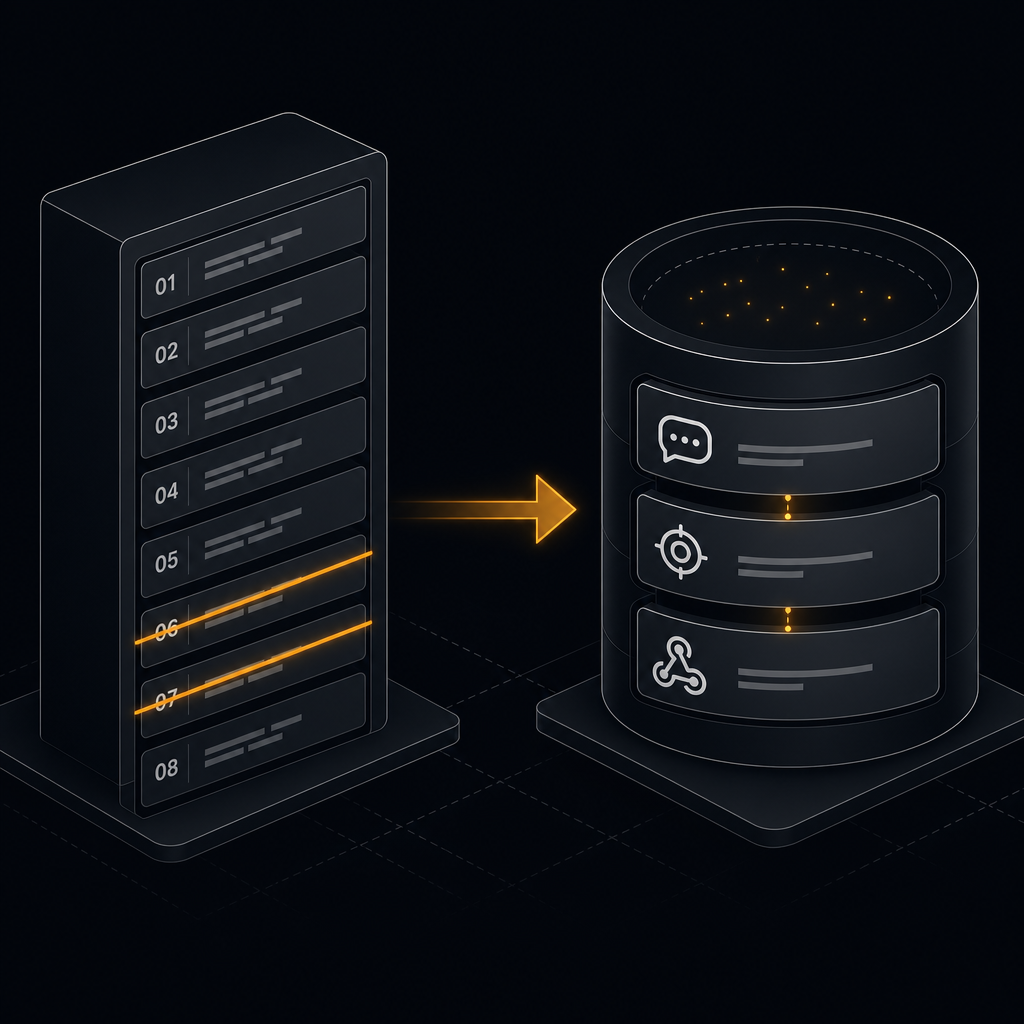
Anthropic Python SDKは5月6日に0.100.0、5月11日に0.101.0、5月13日に0.102.0を公開しました。わずか8日間の3リリースで、Managed Agentsはoutcomes、Webhook、マルチエージェント・オーケストレーションを備えたホステッドランタイムへと変わり、AIエージェントの運用方法そのものが大きく変わっています。Cloudflare上で動かしている私自身の6-Durable-Object構成を調べ、client.beta.managed_agents.sessions.create()で何を置き換えられるか検証したところ、実際に削れるのは2つのワークフローステップにまたがる再試行・ポーリング処理、約280行でした。それ以外は残します。
AIエージェント運用を変えたSDK 0.100〜0.102の中身
8日間で3回のリリースが続き、Python SDKのAPIサーフェスは、それ以前の6か月を上回るほど大きく変わりました。この日付が重要なのは、本番環境をanthropic==0.99.xに固定していた場合、わずか1スプリントの間にManaged Agentsランタイム一式を取り逃しているからです。
**v0.100.0(2026年5月6日)**では、beta名前空間にマルチエージェント、outcomes、Webhook、vault validationのサポートが追加されました。実装上の要点は、client.beta.managed_agents.sessions.create(thread=..., outcome=..., metadata=...)がsession_idを返し、Anthropicのインフラ上で非同期実行されることです。オーケストレーションループを自前で抱える必要がなくなります。
**v0.101.0(2026年5月11日)**では、Claude Platform on AWS向けのAWSクライアントが追加され、すべてのcookbook例がclaude-sonnet-4-5-20250929へ更新されました。Bedrockを使っているなら必要なのはこのリリースです。ANTHROPIC_BEDROCK_SERVICE_TIER環境変数によるdefault/flex/priorityの指定は0.100ではなく、ここで入りました。
**v0.102.0(2026年5月13日)**では、BetaManagedAgentsSearchResultBlock型、prompt cache betaのキャッシュ診断、Pydantic iteratorの即時検証が追加されました。ブロック型のAPIサーフェスは今も変化しており、私がまだマルチエージェントコードを移行しない最大の理由もここにあります。
最大の新機能はoutcomesです。評価基準を定義すると、独立した評価エージェントが結果を採点し、合格するまでエージェントを再実行します。Anthropicの社内evalでは、通常のプロンプトループに比べてタスク成功率が最大+10ポイント、docx生成が+8.4%、pptx生成が+10.1%向上したとされています。私自身のCritic Durable Objectでも、判定役の指摘を添えた再プロンプトを1回入れるだけで、モデルをおおむね1段階上げたほどの品質差が出ており、感触は一致します。
もう一方の柱がWebhookです。Claude Consoleで登録したURLに、session.status_run_started、session.status_idled、session.status_rescheduled、session.status_terminated、session.thread_created、session.thread_idled、session.thread_terminated、そして最も重要なsession.outcome_evaluation_endedという8種類のセッションイベントが送られます。署名シークレットはwhsec_…形式で、作成時に1度だけ表示されます。検証にはclient.webhooks.unwrap(payload, signature, secret)を使います。
マルチエージェント・オーケストレーションも追加されましたが、リサーチプレビューのため別途アクセス申請が必要です。なぜ今は有効にしないのかは後半で説明します。
非技術系の創業者にとって何が変わるのか
Anthropicがエージェントの実行まで引き受けるようになりました。「記事が2,000語に達しているか、一次情報を3件引用しているか、de-AI regexを通過しているか」といった評価基準を書けば、Anthropicの評価エージェントが出力を採点し、合格するまで再実行します。エンジニアが再試行ループを書く仕事はなくなります。
コストへの影響は2つあります。まず、コードベースから手作りの再試行ループが減り、シニアエンジニアがその保守に費やす時間も減ります。一方、Anthropicのセッション内部では再試行が増え、そのたびにトークン料金とは別にsession-hourあたり$0.08がかかります。得になるかどうかは、セッションの実行時間次第です。
率直に言えば、チームがv1のエージェント製品をこれから出す段階なら、Managed Agentsはシニアエンジニアが本来組むオーケストレーションコードの約40%を置き換えます。すでに製品を公開している場合、置き換わる割合は小さくなりますが、Webhook側だけでも、どこかに必ず残っているはずのポーリングループを削除できます。
今週CTOに聞くべきことは、*「完了確認はまだポーリングですか。それともsession.outcome_evaluation_endedへ切り替えましたか」*です。答えが「ポーリング」なら、半日で済むリファクタリングにより、インフラコストとリクエストのレイテンシを同時に下げられます。
現在運用しているCloudflare構成
何を削除できるのかを理解するため、まず現在のアーキテクチャを示します。Cloudflare Workers上の単一Hono worker(ES2021 target、Static Assets binding)が、パブリッシャールーチンごとに1つ、計6つのDurable Objectsのフロントに立っています。内訳はEditorial、Discovery、Writer、Distribution、Maintenance、Managerで、管理UIを支える7つ目のManualIntakeもあります。
各ルーチンは、PublishWorkflow、WriteArticle、PublishArticle、EnrichIdea、DiscoverIdeas、DistributeArticleという6つのCloudflare Workflowsのいずれかを通じて起動します。最も処理量の多いPublishWorkflowは、validate、ground、generate、clean、persist、index、cover、publishという8つの冪等なステップで構成されています。すべてのI/Oステップは次のようにラップしています。
const result = await step.do(
  "generate-article",
  { retries: { limit: 3, backoff: "exponential" } },
  async () => env.WRITER.generate(brief)
);D1が正規の状態を保持し、editorial_brief.statusはdispatched → drafting → published / failedと遷移します。Vectorizeはブロック単位の埋め込みを担当します(Gemini-2 768d、非対称検索形式)。有料モデルの呼び出しはすべて単一の一元管理ポイントであるcallAi(env, ctx, runner)を通り、agent_id、workflow_instance_id、idea_idとともにai_call_logへ記録されます。これによりコストを集計し、1日$20、インスタンスごとに$1の上限を適用しています。
これは以前紹介した6-DO構成です。Managed Agentsへの移行で重要なのは、再試行ロジックが置かれている場所です。次の2か所にあります。
- Workflowステップの再試行(基になる呼び出しが成功すれば安価で無料):一時的なネットワーク障害、レート制限、上流プロバイダーの一時的な5xxを処理します。
clean.tsに手書きした「判定・再試行」ループ:Writerを実行し、Criticを実行して、score < 0.75ならCriticの指摘を添えて再プロンプトします。試行は最大3回です。
Managed Agentsが置き換えるのは2番目です。1番目は残します。
SDK 0.100で削除できる280行
src/worker/workflows/publish/clean.tsの判定・再試行ループは、outcomesへ最も素直に対応づけられます。現在は約120行のオーケストレーションがあり、Writerを呼び出し、editorial_brief.rubric_mdに保存した評価基準でCriticを実行し、スコアを解析して閾値で分岐し、指摘をsystem blockとして添えて再プロンプトする処理を最大3回繰り返しています。Critic自体も80行のDurable Objectで、ハイバネーション用フック、評価基準の履歴を持つインスタンス単位のSQLite、試行ごとの冪等性キーを備えます。さらにcallAi.tsには、試行ごとに個別記録しダッシュボードで集計するためのai_call_log処理が40行あります。
この3つの処理は、Managed Agentsの1回の呼び出しに集約できます。
const session = await anthropic.beta.managedAgents.sessions.create({
  thread: { messages: [{ role: "user", content: brief.body_md }] },
  outcome: {
    rubric: brief.rubric_md,
    evaluator: "claude-sonnet-4-5-20250929"
  },
  metadata: { brief_id: brief.id, workflow_instance: ctx.instanceId }
});
return { session_id: session.id, status: "pending" };必要なのはこれだけです。セッションはAnthropic側で非同期に完了まで実行されます。outcomeパラメータが、これまでCritic DOで担っていた仕事を引き受けます。独立した評価エージェントが評価基準に沿って出力を採点し、合格するまで実行エージェントを再実行します。
追加するコードは、whsec_…署名を検証し、event.type === "session.outcome_evaluation_ended"で分岐して結果をD1へ書き戻す/api/admin/webhooks/managed-agentsルートだけです。
app.post("/api/admin/webhooks/managed-agents", async (c) => {
  const raw = await c.req.text();
  const event = await anthropic.webhooks.unwrap(
    raw, c.req.header("anthropic-signature")!, c.env.WEBHOOK_SECRET
  );

  if (event.type !== "session.outcome_evaluation_ended") {
    return c.json({ ok: true });
  }

  await c.env.DB.update(editorial_brief).set({
    status: event.outcome.passed ? "published" : "failed",
    body_md: event.result.body,
    session_cost_usd: event.session.usage.total_cost_usd
  }).where(eq(editorial_brief.id, event.session.metadata.brief_id));

  return c.json({ ok: true });
});40行で、署名検証済み、brief_idをキーにした冪等な処理です。
**差分の合計:**オーケストレーションを240行削減。wrangler.jsonからDurable Object bindingを1つ削除。migration fileを1つ削除。Webhook処理を40行追加。Cloudflare Secrets Storeにシークレットを1つ追加します。
GET /api/admin/workflows/:id/statusのポーリング用エンドポイントはそのまま機能します。ただし、env.PUBLISH_WORKFLOW.get(id).status()ではなく、Webhookが更新したD1のセッション状態を読むようになります。UIに変更はなく、管理ダッシュボードから見ても違いはありません。
注意点が1つあります。その他すべてのI/Oステップでは、step.doの再試行ラッパーを残します。カバー画像生成、Vercelの再検証、Cloudflareのキャッシュパージはいずれもoutcomeの評価基準の恩恵を受けませんが、Workflowsの再実行に安全なステップキャッシュは有効です。機能している部分まで外す必要はありません。
残すべき1ファイルと、規模拡大で逆転するコスト計算
callAi.tsは残します。1日$20、インスタンスごとに$1という上限があるためです。直接呼び出し、AI Gateway経由、Managed Agents経由のいずれでも、有料モデルの呼び出しはすべてここを通します。
この仕組みが重要になる理由は、Managed Agentsに3種類の課金軸があるからです。標準料金のトークン代に加え、session-hourあたり$0.08、さらにweb検索1000回あたり$10が発生します。私の現在の規模はパブリッシャールーチンが6本で、1回の起動につき各1記事、セッションは約3分です。トークン代とは別にかかるsession-hourコストは記事あたり約$0.004で、無視できる水準です。
分岐点はセッションが長時間化したときに来ます。4時間のAnthropic Skillsセッションなら、ランタイムだけで$0.32かかり、トークン料金はさらに上乗せされます。同じセッションを1日50回実行すると、トークン料金を含める前の純粋なsession-hour課金だけで月$480です。web検索キューを1時間待つ複数ステップのリサーチセッションなら、従来は不要だった$0.08が発生します。下流サービスを待つ時間も課金対象です(Anthropicのドキュメントではミリ秒単位とされていますが、待機中も課金メーターは動き続けます)。
この一元管理ポイントは、Managed Agentsのダッシュボードにはない厳格な上限を適用します。ダッシュボードでセッションコストが分かるのは事後です。一方、callAi.tsは事前見積もりが1日の上限を超える場合、セッション開始前にワークフローの途中でNonRetryableErrorを送出します。
事前見積もりは安全側に寄せています。
async function estimateSessionCost(brief: Brief): Promise<number> {
  const tokenEstimate = brief.body_md.length / 3.5;
  const inputCost = (tokenEstimate / 1_000_000) * 3.0;
  const outputCost = (tokenEstimate * 1.5 / 1_000_000) * 15.0;
  const sessionHourEstimate = (brief.expected_minutes / 60) * 0.08;
  const safetyMargin = 1.4;
  return (inputCost + outputCost + sessionHourEstimate) * safetyMargin;
}session-hour単位のコスト計算は、個人エンジニアの構成で最も早く判断を誤りやすい部分です。上限がなければ、評価基準が厳しすぎるとoutcomeの再試行ループが助長しかねない暴走エージェントが、気づく前に1日分の予算を使い切ります。実際に私はそれを見ています。
一元管理ポイントは残してください。sessions.create()をここへ通し、セッション開始前に事前見積もりを記録します。セッション終了時には、Webhookペイロードのevent.session.usage.total_cost_usdと突き合わせます。
まだ移行しない領域:マルチエージェント・オーケストレーション
Anthropic Dev Dayの目玉は、マルチエージェント・オーケストレーションです。リードエージェントがタスクを分割し、モデル、プロンプト、ツールを個別に持つ専門サブエージェントへサブタスクを渡します。サブエージェントは共有ファイルシステム上で並列に作業し、リードが結果を集約します。仕組みだけを見れば、現在のManager DOとまったく同じです。Writer、Discovery、DistributionへDO RPCで並列に振り分け、それぞれが独自のSQLite状態を持ち、R2とD1を共有「ファイルシステム」として利用しています。
それでも見送る理由は3つあります。
**1つ目はAPI変更の激しさです。**マルチエージェント・オーケストレーションはリサーチプレビューで、別途アクセス申請が必要です。BetaManagedAgentsSearchResultBlockが入ったのも0.102になってからです。マルチエージェント結果のブロック型は今も変化しています。この時点で移行すると、次の2〜3リリースのたびに連携コードを書き直すことになります。WebhookのAPIサーフェスは0.100で安定しましたが、マルチエージェント側はまだ動いています。
**2つ目は、共有ファイルシステムがセッション単位かつ一時的であることです。**Managed Agentsセッション内の共有ファイルシステムは、セッション終了時に消えます。R2とD1はすべてのルーチンをまたいで永続化され、どのworkerからも照会でき、セッションがクラッシュしても残ります。共有ファイルシステムが永続化されるか、セッションのサンドボックスへR2を直接マウントできるようになるまでは、私のワークロードにとって機能低下です。
**3つ目は、Anthropicのリード/サブエージェント分割が特定の設計を前提としていることです。**リードエージェントの役割は固定されています。私のEditorial DOは、パブリッシャールーチンが起動した日にはリードですが、管理UIがbriefを振り分け、Editorialがパイプラインの途中から参加する日にはpeerです。ホステッド抽象化に合わせるために、この有用な非対称性を平坦化することになります。
判断が変わるのは、共有ファイルシステムが永続化され、セッションをまたいで使えるようになったとき、またはR2をサンドボックスへマウントできるようになったときです。現時点ではアップグレードではなく、横方向の移行にすぎません。
SDK 0.100〜0.102へ移行するための完全チェックリスト
SDKのバージョンを固定する
Bashuv add anthropic@0.102.0まだuvを使っていない場合は
pip install anthropic==0.102.0でも構いません。Bedrock固有の理由で0.101に留まる必要がない限り、0.100と0.101は飛ばします。Claude ConsoleでWebhookを登録する
Claude Console → Settings → Webhooks → New endpointを開き、
https://your-worker.example.com/api/admin/webhooks/managed-agentsを指定します。作成時に1度だけ表示されるwhsec_…シークレットをコピーし、Cloudflare Secrets Storeへ保存します。SDK 0.101からClaude Platform on AWSを使う場合は、AWS Secrets Managerでも構いません。Webhookルートを追加する
/api/admin/webhooks/managed-agentsを作成します。署名はclient.webhooks.unwrap(payload, signature, secret)で検証します(このヘルパーはv0.95.xで追加され、0.100では安定しています)。unwrapの呼び出しがHMAC、タイムスタンプの許容差、イベント型の解析を一括で処理します。HMAC検証の自作は避けてください。タイムスタンプずれの許容範囲には分かりにくい点があります。評価ステップを変換する
判定・再試行ループを、
sessions.create()のoutcome={rubric: brief.rubric_md, evaluator: "claude-sonnet-4-5-20250929"}に置き換えます。Critic DOと再試行のオーケストレーションは削除します。評価基準はD1に保存したままにしてください。rubricカラムの重要性は下がるどころか高まります。ポーリングをD1ベースの読み取りへ切り替える
ステータス用エンドポイントは、
sessions.create()のmetadataに設定した相関キーであるevent.session.metadata.brief_idを使ってD1を読みます。Webhookが書き込み、ステータス用エンドポイントが読み取る構成です。workflow.status()への往復通信は不要になります。コストの一元管理ポイントを維持する
callAi.tsは残します。セッションコストを事前に見積もり、1日の上限を超える場合はNonRetryableErrorを送出します。完了後の実績値は、Webhookハンドラーでevent.session.usageから記録します。事前見積もりと実績値は毎週照合し、ずれが25%を超える場合は安全マージンを調整します。最も影響の小さいルーチンから検証する
私の場合は
Discoveryでした。移行に問題があっても公開コンテンツへ影響しないからです。旧経路と並行して72時間実行し、出力の差分を確認します。その後にだけWriterを移行します。
既存のAnthropic Bedrock構成でSDK 0.100を使えますか?
使えます。ただし、専用AWSクライアントが追加されたのは0.101です。Bedrockを使っている場合は0.100より新しいバージョンへ上げてください。SDK 0.101では、0.100にはないANTHROPIC_BEDROCK_SERVICE_TIER環境変数によるdefault/flex/priority指定も追加されています。
WebhookはストリーミングレスポンスAPIを完全に置き換えますか?
いいえ。Webhookが通知するのは、started、idled、terminated、outcome-evaluation-endedといったセッションのライフサイクルイベントです。ストリーミングレスポンスは引き続きmessages.create(stream=True)と通常のdelta protocolで流れます。Webhookは「長時間実行されるセッションが終わったら知らせてほしい」場合の仕組みです。ストリーミングは「生成中のトークンをその場で表示したい」場合に使います。
署名シークレットの形式と検証方法は?
形式はwhsec_…で、Consoleでの作成時に1度だけ表示されます。client.webhooks.unwrap(raw_body, signature_header, secret)で検証すれば、HMAC、タイムスタンプの許容差、イベント型の解析を1回の呼び出しで処理できます。生のシークレットをログに残したり、クエリパラメータとして渡したりしないでください。Cloudflare Secrets Storeなどへ保存します。
Managed Agentsを使わず、Messages APIだけでoutcomes評価を実行できますか?
できません。outcome={rubric, evaluator}はsessions.create()でだけ使えるManaged Agents専用パラメータです。Messages APIで同等の仕組みを自作することはできます。現在の私のCritic DOがまさにそれですが、オーケストレーションのレイテンシを負担し、コードも保守しなければなりません。その負担をなくすことがManaged Agentsの目的です。
Managed Agentsのセッション内でもprompt cachingは有効ですか?
有効です。キャッシュヒット時には入力コストを最大90%削減できます。prompt cache betaのキャッシュ診断は0.102で追加されたため、レスポンスペイロードからキャッシュヒット率を確認できるようになりました。
Discoveryの移行に午後1回、Writerにもう1回使えば、その後は同じ手順で展開できます。0.102.0に固定し、Webhookを登録し、Critic DOを削除してください。ただし、一元管理ポイントは残します。
- 最終更新
- 2026年9月5日
- カテゴリー
- Build
Googleでこのサイトを優先する


omidsaffari.comを優先ソースに設定すると、GoogleがTop Stories・AI Overviews・AI Modeであなたのために優先表示します。

Cursor 料金を検証:Rolloutsは無料で使えるのか
Cursor Rolloutsは無料ではなく、Teamsは1ユーザー月額$40、Enterpriseは個別見積もりです。10日間のローンチクレジットでTeamsは約50件、Enterpriseは約500件の変更を試せますが、その後の単価は未公表。料金の仕組みと導入判断を整理します。2026年9月24日Build
AIエージェント基盤「Unreal Agent」を実務で評価する方法
AIエージェント実行基盤「Unreal Agent」をコマンドラインで安全に試す手順を解説します。リリース、モデル、推論レベルを固定し、JSONL、実行時間、終了ステータス、トークン使用量、差分を記録して、既存エージェントとの品質・コスト比較や、ランナーとGoライブラリの選び分けまで判断できる実践ガイドです。2026年9月24日Build
JetBrains Airの使い方:Alphaプラグイン導入・設定・レビュー手順
JetBrains Airの使い方を、Air Alphaの導入からエージェント接続、@file:でのコンテキスト指定、差分レビュー、テスト、元に戻す判断まで実践的に解説します。Standard Accessで小さな修正から安全に始める手順に加え、料金、互換性、具体的な活用例も分かりやすくまとめました。2026年9月23日Build
JetBrains Airは無料?料金の仕組みと支払元を徹底整理
JetBrains AirのAir Alphaプラグインは無料ですが、IDE本体や接続するAIエージェント、API利用料まで無料とは限りません。Junie Lite、既存アカウント、APIキー、JetBrains AIという4つの認証経路ごとに、誰が料金を負担するのかを公開情報と具体的な料金比較で整理します。2026年9月23日Build
Firecrawl APIをセルフホストする方法:Docker導入と料金比較
Firecrawl APIをセルフホストする手順を、v2.11.162への固定、実スクレイプと再起動後の検証、証跡保存まで詳しく解説します。さらにFirecrawl Cloudとの機能差と30日間の費用を比較し、セルフホストを選ぶべき条件、運用負荷、導入前に確認すべきセキュリティと本番要件を整理します。2026年9月22日Build
生成AI ガバナンスの盲点:有料リトライを人が承認する設計
AIエージェントが自らの品質判定で有料レンダリングを再実行し、人が確認する前に$5.48を消費した事例を解説します。生成AI ガバナンスで見落としやすいのは、レビュー権限と購入権限の違いです。人だけが承認を書き込めるフィールドを設け、有料ツール呼び出しの直前で再購入を拒否する実装と、その適用範囲を具体的に整理します。2026年9月22日Build
AIエージェント 作り方ガイド:MindStudioの料金・機能・運用コストを検証
MindStudioでAIエージェントをどう作るのか。ノーコードのワークフロー設計、料金、モデル利用料、レビュー工数、競合ツールとの違いを公開情報から検証します。1,000件・10,000件のコスト試算、Businessプランの壁、導入前に実施すべき20件の合成データテストまで、購入判断に必要な条件を解説します。2026年9月22日Build