Agente de IA com GPT-6.1 Sol: configuração na API e no Codex
Aprenda a configurar o GPT-6.1 Sol como agente de IA na Responses API e no Codex, escolher o esforço certo, limitar ferramentas e medir o custo real.



Coloque o GPT-6.1 Sol à frente do trabalho sério e repetível que exige demais de um modelo leve, mas aparece com frequência demais para ser enviado automaticamente à Astra. Para um agente de IA, a configuração prática é direta: use gpt-6.1-sol na Responses API, comece em medium, disponibilize apenas as ferramentas necessárias para a tarefa e só leve o modelo à produção depois que ele passar por critérios fixos de aceitação. Uma execução nova do Codex feita para este guia criou um pequeno utilitário em JavaScript, escreveu quatro testes e passou nos quatro, com um custo equivalente na API, apenas em tokens, de $0.02816.
A decisão em um minuto
O GPT-6.1 Sol já pode ser usado em agentes via API, no Codex e nos planos pagos do ChatGPT Work. Ele ainda não chegou ao Chat comum, e o modo Ultrafast para esse modelo foi anunciado, mas ainda não está disponível.
O preço Standard da API é de $2 por milhão de tokens de entrada e $10 por milhão de tokens de saída. No GPT-6 Astra, os valores são $10 e $50. O anúncio de lançamento da OpenAI confirma a disponibilidade do produto. Para uma comparação mais completa de acesso e limites de uso, consulte GPT-6.1 Sol vs GPT-6 Sol; aqui, o foco está na configuração e nas decisões de operação.
O que é o GPT-6.1 Sol na prática
Pense na família GPT-6 como uma equipe de operações. Astra é o especialista reservado para o caso mais difícil e controverso. GPT-6.1 Sol é o profissional sênior que pode assumir trabalho complexo de forma recorrente. O GPT-6 Sol preserva a compatibilidade com uma rota de ferramentas mais antiga. Essa divisão é mais útil do que tratar o novo modelo como padrão universal.
O GPT-6.1 Sol recebe texto e imagens, responde em texto e oferece uma janela de contexto de 1,050,000 tokens, com até 128,000 tokens de saída. Para um agente, seu maior valor está no conjunto de ferramentas. Na Responses, ele oferece pesquisa na web, busca em arquivos, geração de imagens, interpretador de código, shell hospedado, aplicação de patches, skills, uso do computador, MCP, busca de ferramentas e funções próprias. O guia de ferramentas da Responses mostra como a API mantém o modelo em um ciclo de agente enquanto ele decide qual ferramenta permitida deve chamar em seguida.
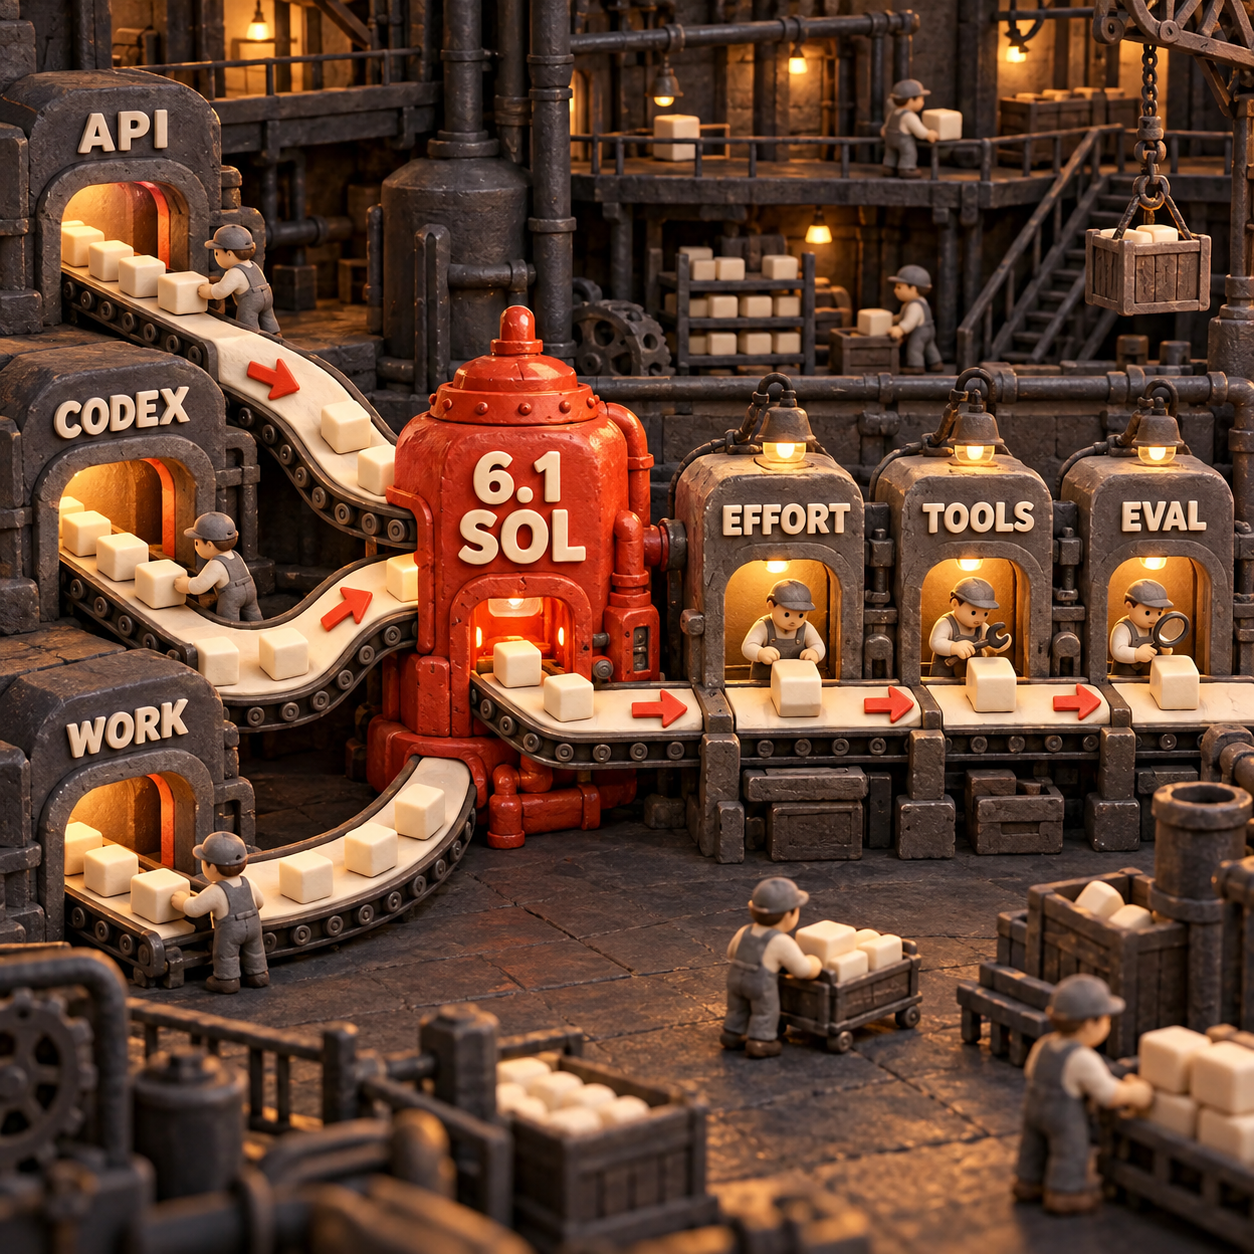
A restrição é igualmente importante: o GPT-6.1 Sol só usa ferramentas por meio da Responses. A Chat Completions ainda aceita uma solicitação simples, mas não uma solicitação que chame ferramentas. Se o agente atual chama funções pela Chat Completions, trocar apenas o ID do modelo não constitui uma migração.
Como configurar um agente de IA na Responses API
Comece com uma única rota e um único critério de aceitação. Não exponha todas as ferramentas só porque elas aparecem na página do modelo. Um agente de pesquisa pode precisar de pesquisa na web e busca em arquivos. Um agente que trabalha em repositórios talvez precise de acesso ao shell e a patches. Já um agente de operações pode precisar de duas funções e de uma barreira de aprovação.
Esta é a menor solicitação útil em JavaScript:
import OpenAI from "openai";

const client = new OpenAI();

const response = await client.responses.create({
  model: "gpt-6.1-sol",
  reasoning: { effort: "medium" },
  tools: [{ type: "web_search" }],
  input: "Find today's source for our target metric, cite it, and return one sentence."
});

console.log(response.output_text);
O ID do modelo seleciona o Sol. O objeto reasoning define quanto trabalho ele pode dedicar ao raciocínio. O array tools concede uma capacidade, mas não ordena que ela seja usada. O prompt ainda precisa declarar o resultado esperado, a exigência de evidências e a condição de parada.
Para migrar um agente existente da Chat Completions, trate a mudança em três partes: envie a solicitação à Responses, interprete os itens tipados de output e defina como o estado da conversa será mantido. O guia de migração do Astra para a Responses API detalha melhor essa infraestrutura.
Separe cinco tarefas reais
Escolha exemplos aprovados do fluxo de trabalho, incluindo um caso de falha. Preserve o prompt, as entradas, as permissões e os critérios de sucesso.
Comece em medium
Use primeiro o nível de esforço padrão. Altere uma variável por vez para não confundir um ganho do modelo com uma mudança de prompt ou de ferramenta.
Libere só as ferramentas necessárias
Exponha apenas os recursos de busca, arquivos, funções, shell ou controle do computador exigidos por aquela rota. Mantenha ações de escrita protegidas por políticas explícitas e barreiras de aprovação.
Registre o custo do resultado aceito
Capture entrada nova, entrada em cache, saída, novas tentativas, tarifas de ferramentas e a aprovação ou reprovação do estado final. Uma execução barata que falhou não representa economia.
Defina a rota com base em evidências
Mantenha o Sol nas tarefas em que ele passa. Escale apenas o resíduo difícil para Astra. Deixe rotas incompatíveis no GPT-6 Sol até que o cliente responsável pelas chamadas seja alterado.
Como escolher o nível de esforço de raciocínio
medium é o melhor ponto de partida para a maioria dos trabalhos com agentes. O GPT-6.1 Sol também aceita low, high, xhigh e max. Ele rejeita none e minimal; portanto, uma rota existente que use um desses níveis precisa passar por um teste específico de comportamento e latência. O guia de esforço de raciocínio da OpenAI segue a mesma progressão, da execução eficiente ao raciocínio máximo.
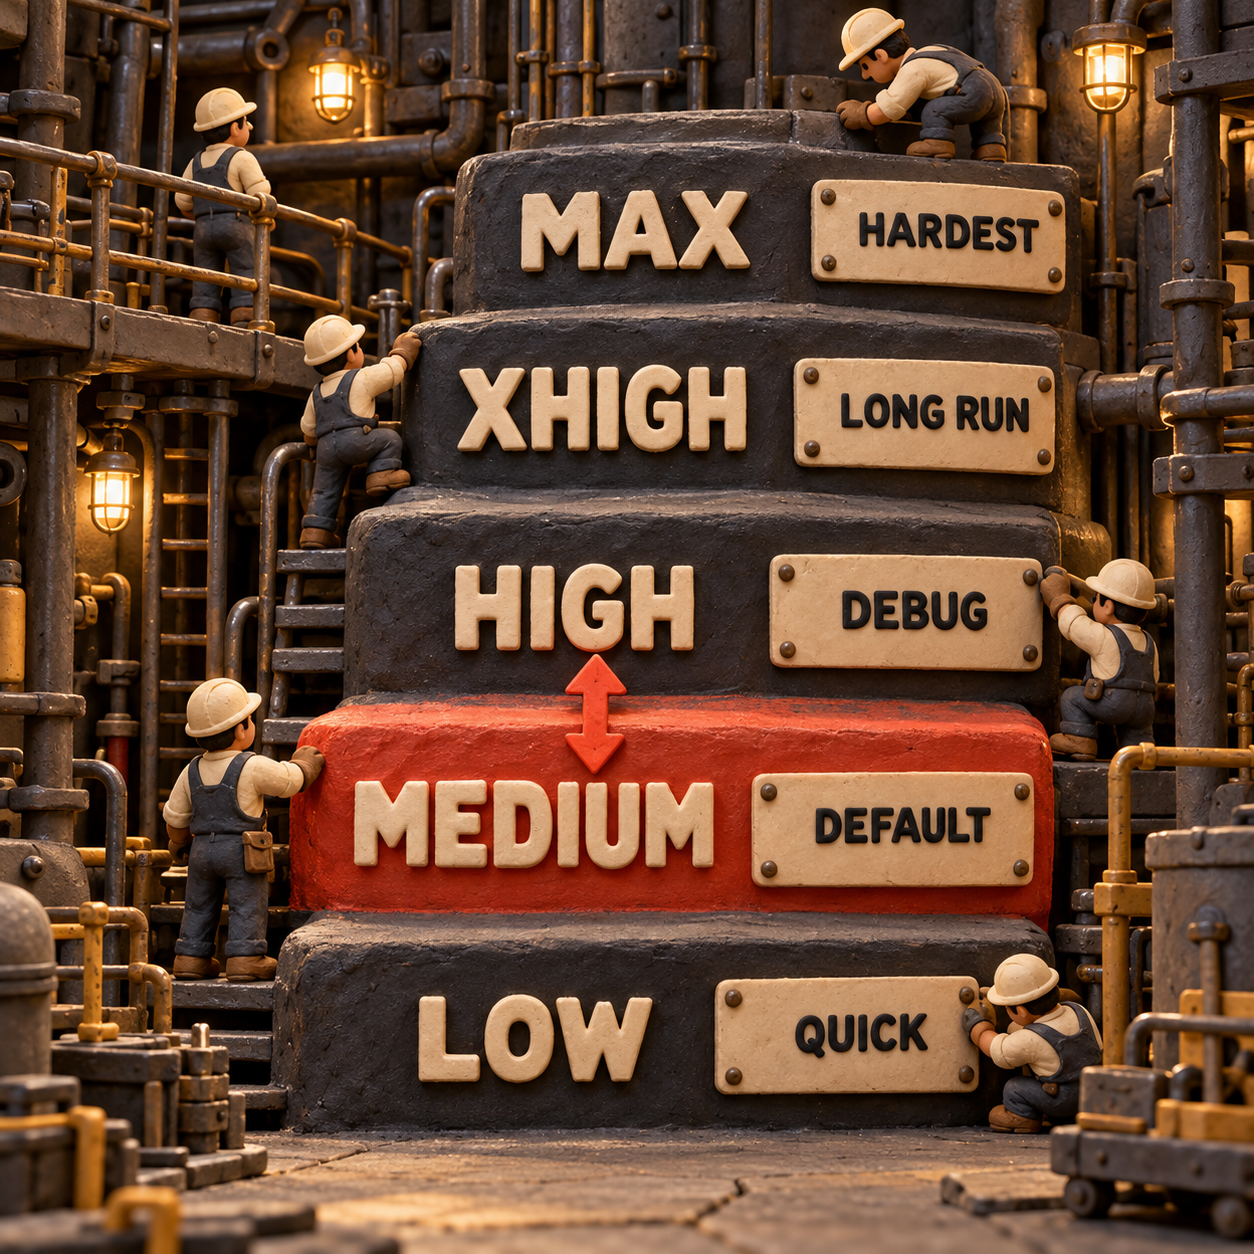
Três nomes parecidos representam controles distintos. max é um nível de esforço de raciocínio na API. Ultra, no Codex, é um modo multiagente que divide o trabalho entre subagentes. Ultrafast é um modo de velocidade, e o suporte a ele no GPT-6.1 Sol ainda está a caminho. Não monte orçamento nem plano de lançamento baseado em Ultrafast como se o recurso já estivesse disponível.
Uma tarefa real com GPT-6.1 Sol e seu custo em tokens
Uma execução pequena revela melhor a economia real do que o preço de tabela. No Codex, o GPT-6.1 Sol em low recebeu a seguinte tarefa: criar uma função slugify em JavaScript sem dependências, adicionar exatamente quatro casos com node:test para corte de espaços nas extremidades, espaços internos, pontuação e combinação de maiúsculas e minúsculas, executar os testes e corrigir qualquer falha.
O modelo criou slugify.js e slugify.test.js e, em seguida, executou node --test slugify.test.js. O resultado foi de 4 aprovações e 0 falhas. O uso registrado foi de 57,578 tokens de entrada, dos quais 48,640 vieram do cache, mais 542 tokens de saída. Isso significa que apenas 8,938 tokens de entrada foram cobrados pela tarifa de entrada nova.
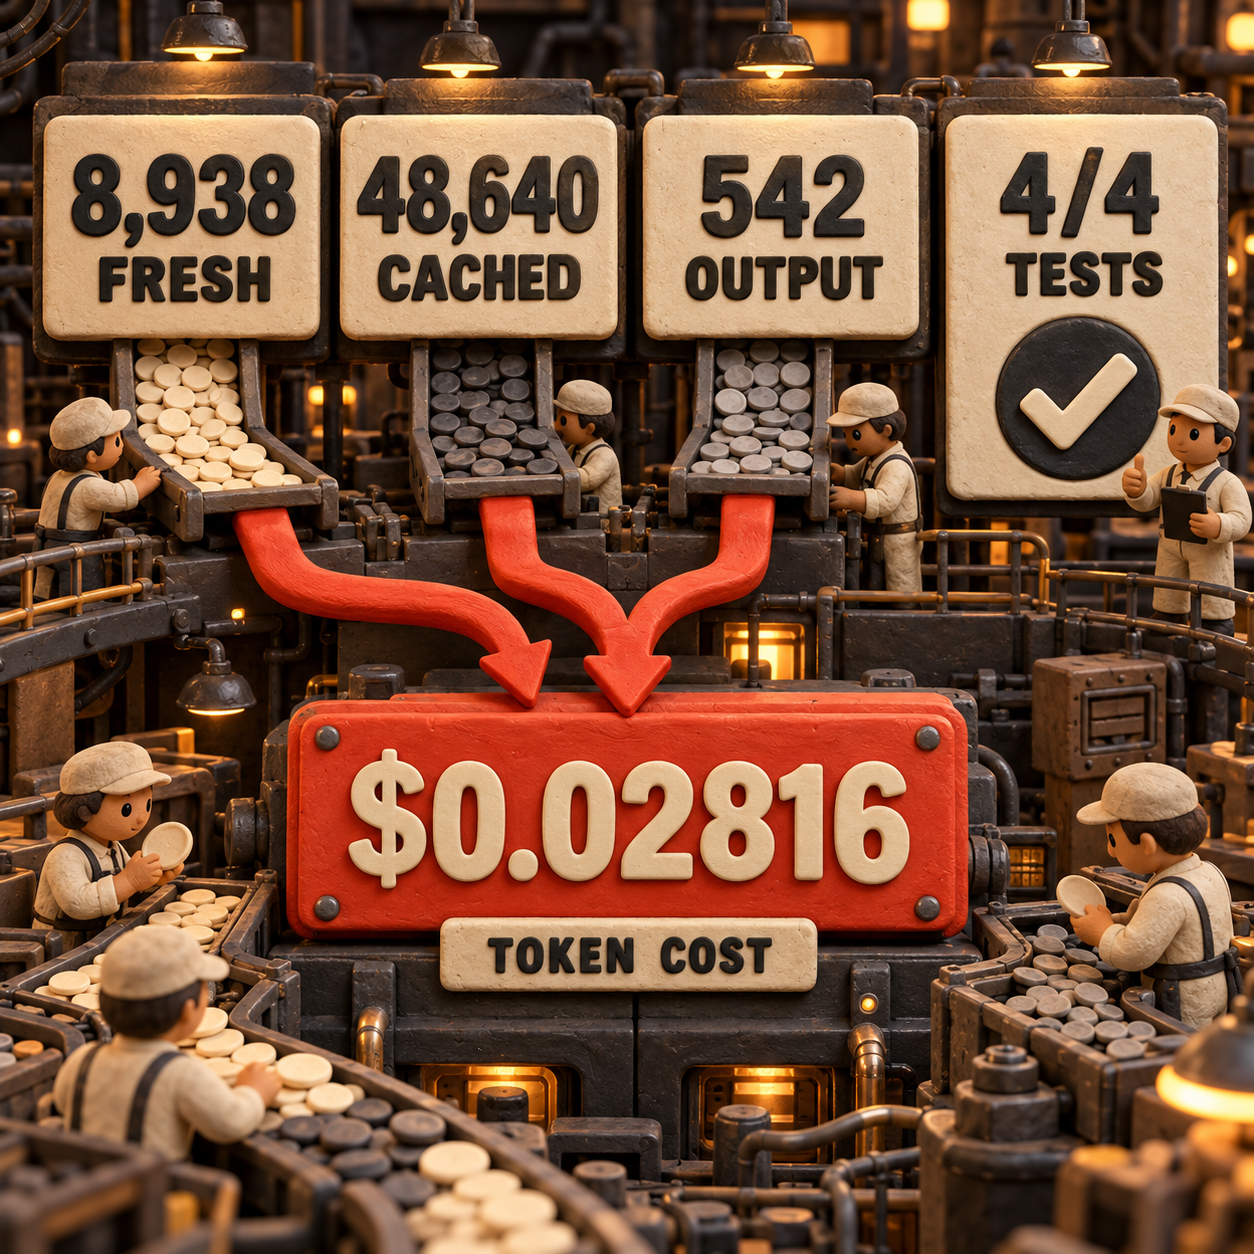
Essa foi uma execução real do Codex; portanto, ela consumiu o acesso do plano, em vez de gerar uma fatura de API. O valor de $0.02816 corresponde exatamente à combinação de tokens, calculada com as tarifas Standard publicadas para o GPT-6.1 Sol. Ele não inclui eventuais cobranças de ferramentas hospedadas pagas. Em 10,000 execuções idênticas, essa combinação custaria $281.60 em tokens do modelo. Mantida a mesma combinação de tokens, as tarifas do Astra levariam o valor a $1,651.20. Essa comparação com o Astra é apenas uma conta baseada nas tarifas, não uma afirmação de que o modelo usaria a mesma quantidade de tokens.
A conclusão não é que todo patch pequeno custa três centavos. O ponto é que o ambiente do agente, as definições das ferramentas, as instruções e o histórico podem pesar mais que a solicitação visível. Meça a execução aceita inteira, incluindo contexto em cache e novas tentativas.
Sete trabalhos em que o Sol faz mais sentido
As equipes que mais ganham são aquelas cujo trabalho difícil se repete. A lista abaixo segue a provável contribuição operacional:
O Sol não elimina a necessidade de definir aprovações, verificações determinísticas ou observabilidade. Ele oferece a esses sistemas um executor mais capaz, com uma tarifa de tokens menor que a do Astra.
Três produtos que valem a pena construir
1. Uma bancada de testes de migração para agentes de programação no Sol
Esta é a oportunidade mais forte. Cerca de 8,100 buscas mensais nos Estados Unidos têm como alvo ai powered coding agent, com intenção comercial. As equipes não precisam de mais um ranking vago de modelos. Elas precisam saber se as tarefas dos próprios repositórios passam em gpt-6-sol, gpt-6.1-sol e Astra usando o mesmo prompt, as mesmas ferramentas e os mesmos critérios.
A menor versão vendável é uma CLI acompanhada de uma ação de CI. A equipe fornece cinco fixtures JSON, um comando de aprovação e as ferramentas permitidas. A bancada executa cada modelo, registra resultados aceitos, latência, tokens novos e em cache, novas tentativas e custo; no fim, emite uma decisão de promoção. O problema é que executores genéricos de avaliações são fáceis de copiar. A vantagem defensável está na biblioteca de fixtures práticas de programação, nas integrações e em diagnósticos úteis de falhas.
2. Um roteador de esforço e custo para agentes de operações
Cerca de 1,000 buscas mensais nos Estados Unidos têm como alvo ai workflow automation, com intenção comercial e CPC de $37.80. É um mercado em busca de trabalho concluído, não de outra caixa de chat. Um roteador poderia enviar casos delimitados para low, trabalhos normais de várias etapas para medium, falhas difíceis para high e apenas o resíduo não resolvido para Astra.
Um MVP precisa de uma fila, três políticas de esforço, uma função de aceitação e um painel de gastos. Venda-o para equipes de operações que já pagam por várias automações. O risco é a falsa confiança: um roteador barato que classifica incorretamente um único caso importante pode anular toda a economia. O produto precisa nascer com fixtures reproduzíveis e opção de intervenção manual.
3. Uma camada de aceitação para agentes de documentos
ai document analysis recebe cerca de 1,000 buscas mensais nos Estados Unidos e tem CPC de $10.44. O produto não é mais uma tela para enviar e resumir arquivos. É uma camada de verificação que confirma se um agente de documentos encontrou todos os campos exigidos, preservou as citações, reconciliou os totais e encaminhou incertezas.
A menor versão atende a um pacote recorrente, como contratos de fornecedores ou PDFs financeiros mensais, com esquema fixo e fila de exceções. O GPT-6.1 Sol cuida da análise repetida; Astra recebe somente casos contestados ou incompletos. O obstáculo é a especificidade de cada domínio. Um produto horizontal amplo parecerá genérico, enquanto um pacote restrito com verificações confiáveis pode conquistar credibilidade.
Quando manter o GPT-6 Sol ou pagar pelo Astra
Mantenha o GPT-6 Sol quando a compatibilidade for a restrição principal. Ele ainda aceita o nível de raciocínio none e pode chamar funções pela Chat Completions quando reasoning_effort está em none. O GPT-6.1 Sol não pode fazer isso. Uma rota estável que dependa desses comportamentos deve mudar o caminho da API e passar pelos testes de regressão antes de trocar de modelo.
Pague pelo GPT-6 Astra quando o melhor resultado importar mais que a conta de tokens. A OpenAI o descreve como o modelo mais capaz para as tarefas mais exigentes de raciocínio, programação, uso do computador, pesquisa e criação de documentos. Use-o na faixa ambígua e de alto valor em que sua avaliação fixa demonstra um ganho relevante. Nas tarifas Standard, Astra custa $10 por milhão de tokens de entrada e $50 por milhão de tokens de saída, contra $2 e $10 no GPT-6.1 Sol.
Use o GPT-6.1 Sol no grande espaço intermediário: trabalho sério e recorrente baseado na Responses, com uma condição de sucesso mensurável. As avaliações de lançamento da OpenAI apontam resultados melhores que os do GPT-6 Sol em várias cargas de trabalho difíceis, mas são testes executados pelo fornecedor. A taxa de resultados aceitos da sua operação é o critério que autoriza a liberação.
Limites que mudam a configuração
O GPT-6.1 Sol não substitui todas as rotas. Ele não oferece os níveis de esforço none ou minimal, não chama ferramentas pela Chat Completions, não aceita fine-tuning, não recebe áudio nem vídeo e, no lançamento, não está disponível no Chat comum. Ferramentas pagas geram cobranças próprias. Uma solicitação com mais de 272,000 tokens de entrada também leva a solicitação inteira para as tarifas maiores de contexto longo; portanto, a janela de 1,050,000 tokens não deve ser tratada como espaço de trabalho gratuito.
Ultrafast é outro limite que precisa ser exposto com clareza. A OpenAI anunciou geração de tokens até 8x mais rápida que a velocidade padrão no Codex, mas informou que o recurso ainda chegará. Até que ele apareça para sua conta e seu cliente, planeje com Standard ou Fast e meça a latência que você realmente recebe.
O que fazer na segunda-feira
Separe cinco tarefas concluídas recentemente pelo seu agente atual: um sucesso fácil, duas tarefas normais, uma tarefa com uso intenso de ferramentas e uma falha conhecida. Execute as mesmas fixtures no GPT-6.1 Sol em medium, sem mudar prompts nem permissões. Registre aprovação ou reprovação, tempo total, entrada nova, entrada em cache, saída, novas tentativas e cobranças de ferramentas.
Depois, defina rotas em vez de declarar um vencedor. Leve o trabalho delimitado para low se ele continuar passando. Teste high apenas nas falhas que exigem raciocínio mais profundo. Mantenha clientes presos por compatibilidade no GPT-6 Sol. Envie o resíduo caro para Astra somente quando o ganho de aceitação justificar o preço. Assim, você obtém uma decisão de produção nesta semana, não apenas uma opinião sobre modelos.
Perguntas frequentes
O que é o GPT-6.1 Sol?
O GPT-6.1 Sol é o modelo de menor custo da OpenAI para trabalhos complexos de programação, uso do computador e atividades profissionais. Seu ID na API é gpt-6.1-sol, e as chamadas de ferramentas passam pela Responses API.
O que são agentes de IA para programação?
Agentes de IA para programação podem inspecionar um repositório, editar arquivos, executar comandos e testes e relatar o resultado dentro das permissões definidas. A unidade de valor é um resultado testado, não apenas código gerado.
O ChatGPT tem um agente de programação?
Sim. Codex é o agente de programação da OpenAI, e o GPT-6.1 Sol está disponível na liberação gradual para planos pagos. O modelo também faz parte do ChatGPT Work, mas ainda não está disponível no Chat comum.
O GPT-6 Sol é mais barato?
Não na entrada nova nem na saída: os dois modelos Sol listam $2 por milhão de tokens de entrada e $10 por milhão de tokens de saída na modalidade Standard. O GPT-6.1 Sol tem uma tarifa menor para entrada em cache. A comparação completa entre os modelos Sol detalha essa diferença de preço e compatibilidade.
Se você quer que uma dessas rotas de agentes seja projetada, testada e colocada em produção para sua empresa, conheça os sistemas de IA para produção.
- Última atualização
- 30 de set. de 2026
- Categoria
- AI
Prefira este site no Google


Marque omidsaffari.com como fonte preferida e o Google destaca o site para você em Top Stories, AI Overviews e AI Mode.
Comparação GPT-6.1 Sol vs GPT-6 Sol: qual escolher?
Comparação GPT-6.1 Sol vs GPT-6 Sol em preços, benchmarks, cache e compatibilidade de API para decidir se a migração vale a pena na prática.30 de set. de 2026AI
Claude Sonnet 5.5: como usar na prática
Aprenda a usar o Claude Sonnet 5.5 com o nível de esforço certo, um fluxo verificável e ajustes de API para obter respostas rápidas sem perder o controle.28 de set. de 2026AI
GLM-5.3-Flash ou Jev: qual escolher para decisões de IA?
Compare Jev e GLM-5.3-Flash em preço, imagens, latência e privacidade para escolher a melhor opção em roteamento de tickets e triagem de documentos.27 de set. de 2026AI
Claude Opus 5.5 vs Opus 5: qual vale mais a pena?
Claude Opus 5.5 reduz preços e avança nos benchmarks publicados, mas traz mudanças na API. Compare custos, desempenho e riscos antes de migrar.23 de set. de 2026AI
GPT-6 Sol ou Luna: qual escolher e quando pagar mais
Compare GPT-6 Sol e Luna em preço, programação e adequação à tarefa — e veja quando a qualidade do Sol realmente compensa o custo 20× maior.23 de set. de 2026AI
GPT-6 Luna grátis: onde usar e quanto custa
O GPT-6 Luna é grátis no app para desktop, mas Work, Codex e API seguem regras diferentes. Veja acesso, preços, limites e quando vale pagar.22 de set. de 2026AI
Xiaomi MiMo: como usar o MiMo-V2.6 na prática
Aprenda a testar o Xiaomi MiMo no Studio, configurar a API do MiMo-V2.6, escolher entre Flash e Pro e levar o fluxo à produção com segurança.22 de set. de 2026AI