DeepSeek API em 2026: chat grátis, preços e custo por token
Veja quanto custa a DeepSeek API, compare os preços do V4 Flash e V4 Pro, entenda o chat grátis e calcule o custo real por resultado aprovado.




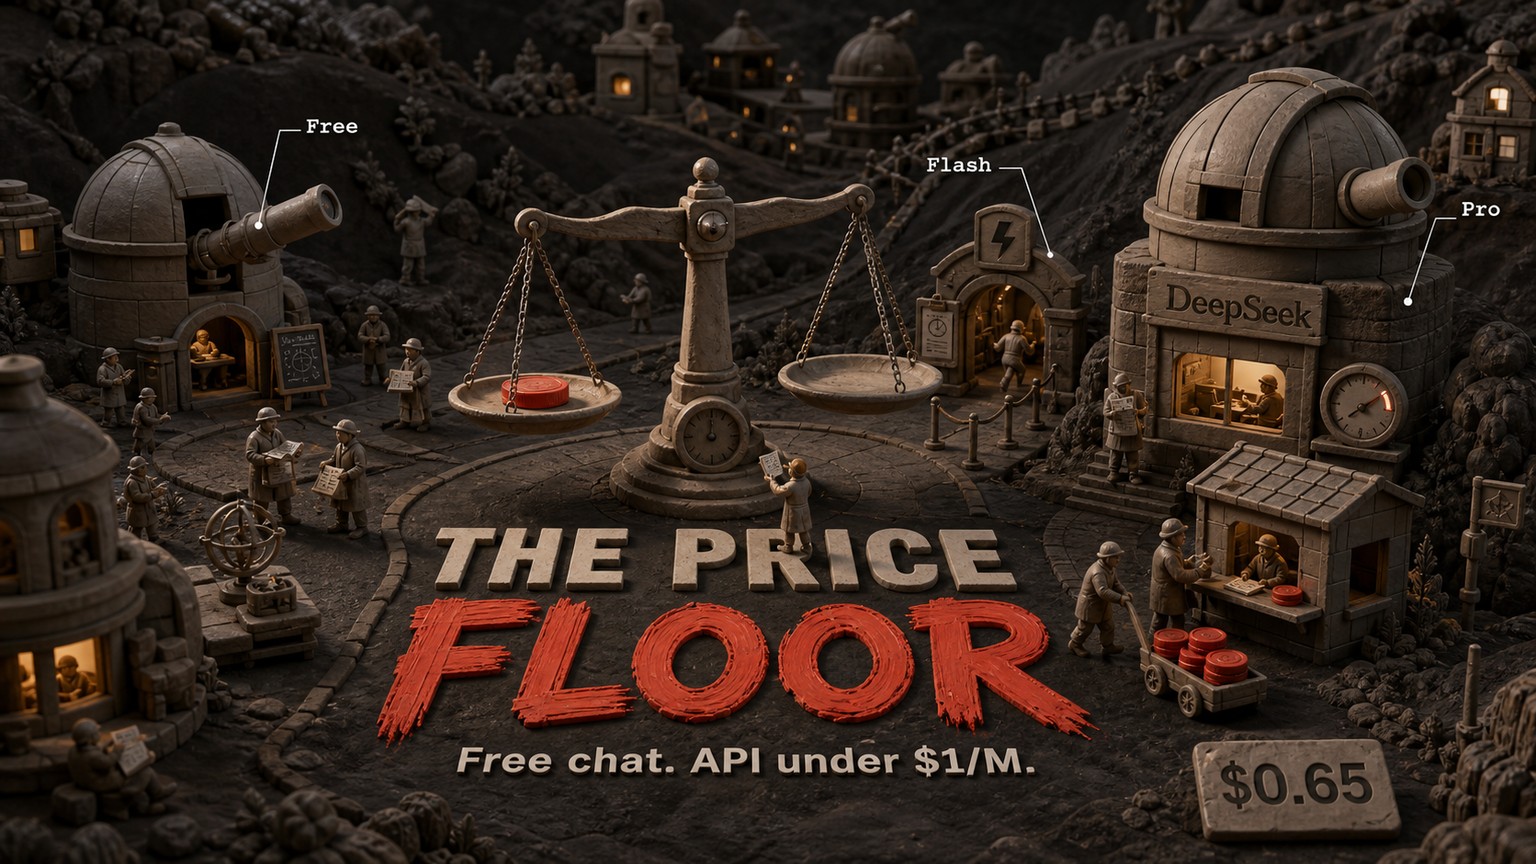
O chat do DeepSeek custa $0. Já a DeepSeek API cobra pelo uso: no V4 Flash, são $0.14 por milhão de tokens de entrada e $0.28 por milhão de tokens de saída; no V4 Pro, $0.435 e $0.87. A decisão é simples: mantenha o chat pessoal no plano gratuito, adote o Flash como padrão em produção e só pague pelo Pro quando ele reduzir as novas tentativas o bastante para compensar um preço 3.11x maior.
Preços da DeepSeek API em resumo
A DeepSeek oferece um produto gratuito para o consumidor e dois modelos pagos via API. Não existe assinatura mensal ou anual self-service para a API: as cobranças por token são descontadas do saldo da conta conforme o uso.
Estes valores foram conferidos na página ativa de modelos e preços da DeepSeek em 12 de agosto de 2026.
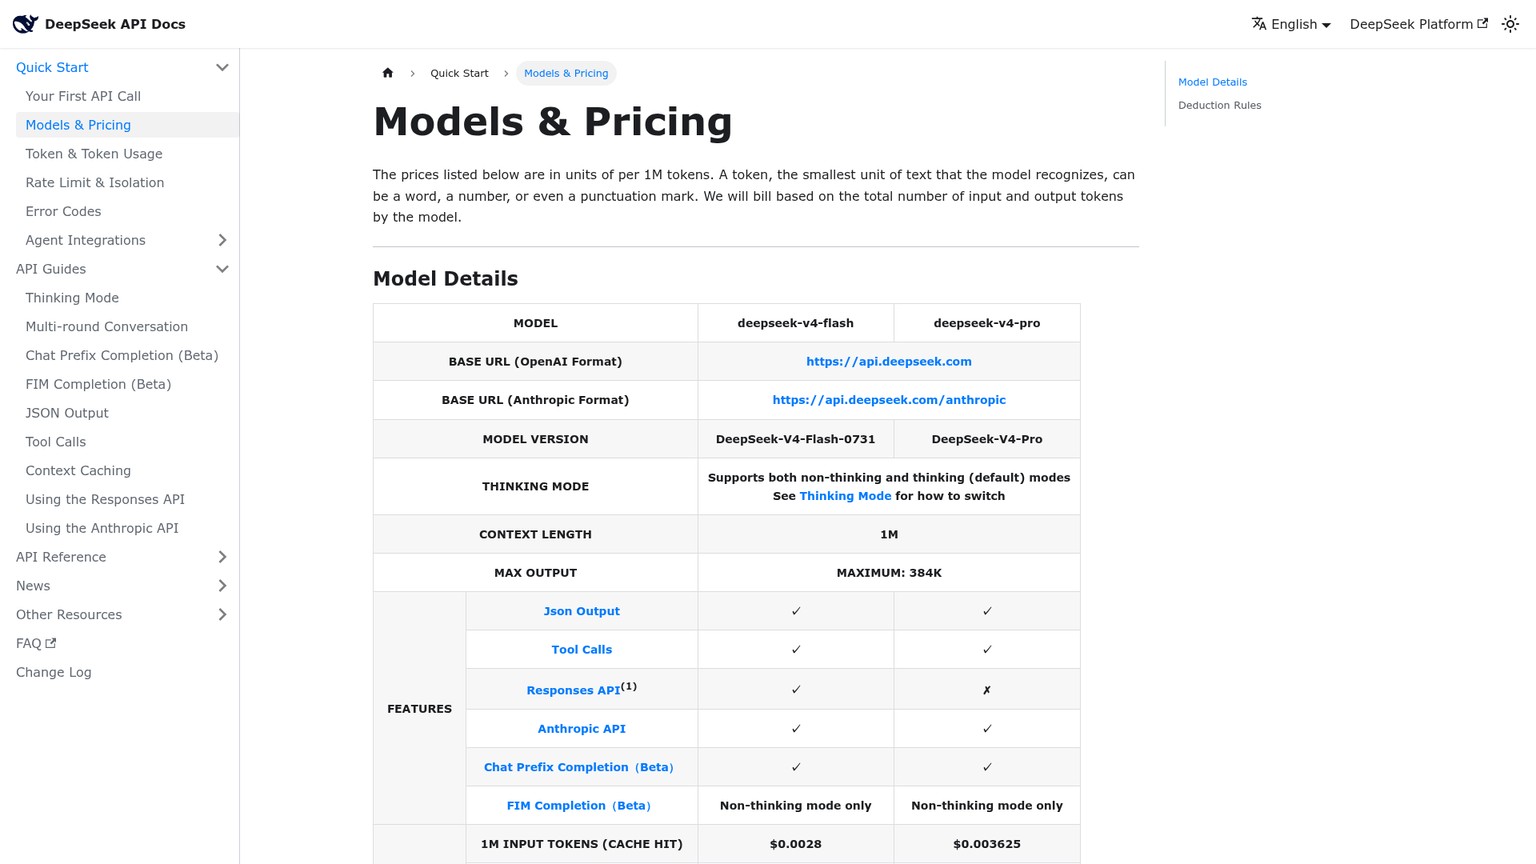
Token é a unidade usada na cobrança do modelo — não equivale a uma solicitação nem a uma palavra. A entrada inclui tudo o que é enviado ao modelo: instruções, histórico, documentos e contexto de ferramentas. A saída reúne tudo o que o modelo devolve. Um cache hit ocorre quando a DeepSeek reaproveita uma entrada repetida e aplica a tarifa menor; no cache miss, a entrada precisa ser processada pela tarifa cheia.
Os dois modelos de API têm uma janela de contexto de 1M de tokens e saída máxima de 384K. Isso elimina a necessidade comum de pagar uma sobretaxa por contexto longo dentro da DeepSeek. Os limites operacionais, porém, são diferentes: o V4 Flash informa 2,500 solicitações simultâneas, enquanto o V4 Pro informa 500.
A DeepSeek é gratuita no chat, mas cobra a API à parte
O aplicativo da DeepSeek para consumidores não custa nada. O anúncio oficial do aplicativo afirma que ele é 100% gratuito, sem anúncios nem compras no app, e a página inicial atual ainda apresenta o acesso ao chat como gratuito.
Isso não significa que a API também seja grátis. O aplicativo é uma interface usada por uma pessoa; a API é o produto medido que softwares acessam. A página da DeepSeek API informa que o consumo é descontado de um saldo concedido ou recarregado. Portanto, ter uma conta gratuita no chat não torna gratuito o tráfego programático.
Essa separação entre produtos também surpreende clientes de outras empresas: uma assinatura do aplicativo e a cobrança da API podem usar a mesma marca e continuar sendo produtos distintos, como mostra a análise dos preços do Perplexity. Na DeepSeek, a divisão é ainda mais clara: o app não tem preço de assinatura publicado, enquanto cada token da API aparece na tabela de cobrança.
Quem nunca precisa pagar
Não é preciso pagar quando o uso é interativo, eventual e atendido pelo aplicativo oficial para web ou celular. Isso inclui perguntas pessoais, textos pontuais, conversas sobre documentos e estudantes que não precisam conectar a DeepSeek a outro produto.
A DeepSeek não publica um plano nem um desconto específico para estudantes nas páginas de preços, FAQ ou aplicativo verificadas para esta análise. Para o acesso comum do consumidor, isso nem é necessário, pois esse uso já custa $0.
O limite é a automação. Assim que um CRM, fluxo de suporte, ferramenta interna ou produto voltado ao cliente precisar chamar a DeepSeek sem que alguém abra o aplicativo, é preciso reservar orçamento para os tokens da API. Também não trate o chat gratuito como infraestrutura de produção: a página do app gratuito não promete capacidade ilimitada nem publica um nível de serviço.
V4 Flash é o padrão em produção; V4 Pro fica para escalonamento
Na maioria das rotas de produção, o V4 Flash-0731 deve receber a primeira solicitação. Ele custa menos, tem um limite de simultaneidade maior e oferece hoje uma superfície de integração mais ampla.
V4 Flash-0731
O V4 Flash cobra $0.14 por milhão de tokens de entrada com cache miss, $0.0028 por milhão de tokens de entrada com cache hit e $0.28 por milhão de tokens de saída. Ele oferece modos com e sem raciocínio, saída em JSON, chamadas de ferramentas, API da DeepSeek compatível com a Anthropic e Responses API. A página atual informa janela de contexto de 1M, saída máxima de 384K e 2,500 solicitações simultâneas.
Essa combinação faz do Flash a rota mais sensata para classificação, extração, resumo, geração de primeiro rascunho, alterações rotineiras de código e etapas delimitadas de agentes. Essas tarefas têm critérios claros de aprovação, então uma saída com falha pode ser identificada e escalada sem que um erro barato chegue ao cliente.
Não use o Flash como única rota quando uma falha for cara e difícil de detectar. Uma recomendação jurídica, financeira ou com impacto sobre clientes não deve escolher o modelo apenas pelo preço do token. A tarifa baixa abre espaço para avaliar; não substitui a avaliação.
V4 Pro
O V4 Pro cobra $0.435 por milhão de tokens de entrada com cache miss, $0.003625 por entrada com cache hit e $0.87 por saída. Ele traz a mesma janela de contexto de 1M e a mesma saída máxima de 384K, além dos mesmos modos de raciocínio, saída em JSON, chamadas de ferramentas e formato compatível com a Anthropic. Seu limite de simultaneidade informado é 500.
O Pro é a rota para a parte mais difícil: solicitações ambíguas, planos complexos, tarefas de programação exigentes ou a segunda tentativa depois que o Flash reprova em uma verificação determinística. Ele não deve virar padrão só porque seu nome inclui Pro.
Há também uma limitação de integração pouco evidente na tabela ativa. Hoje, a DeepSeek indica compatibilidade da Responses API com o Flash, mas não com o Pro. A página ainda diz que a compatibilidade com o Pro estava prevista para o início de agosto de 2026, porém o status ativo em 12 de agosto continua como não compatível. Se o aplicativo depender desse endpoint, o preço do token do Pro deixa de importar até que a integração exista.
- O aplicativo para consumidores custa $0, sem anúncios nem compras no app.
- Todas as tarifas atuais da API ficam abaixo de $1 por milhão de tokens.
- Os dois modelos de API oferecem janela de contexto de 1M e saída máxima de 384K.
- O cache automático de contexto pode reduzir drasticamente o custo de prefixos repetidos.
- O V4 Flash reúne a menor tarifa, compatibilidade com mais endpoints e maior simultaneidade.
- A DeepSeek avisa que haverá um aumento expressivo no preço da API, mas não informa valor nem data.
- Cache hits operam em regime de melhor esforço, sem garantia.
- O V4 Pro custa cerca de 3.11x o Flash em cache misses e tokens de saída.
- O V4 Pro tem um quinto da simultaneidade informada do Flash e ainda não oferece compatibilidade com a Responses API.
- O chat gratuito não tem promessa publicada de capacidade ilimitada nem nível de serviço.
O token da DeepSeek custa pouco; o resultado aprovado é que decide
O gasto bruto com a API é tão baixo que uma única revisão humana evitável pode custar mais do que milhares de chamadas ao modelo. A fórmula útil não é custo por solicitação, e sim custo por resultado aprovado.
Para uma solicitação sem cache hits:
cost = input tokens / 1,000,000 × input rate + output tokens / 1,000,000 × output rate
Com 1,000 tokens, o V4 Flash custa $0.00014 pela entrada com cache miss e $0.00028 pela saída. No V4 Pro, esses valores são $0.000435 pela entrada com cache miss e $0.00087 pela saída.
Considere um fluxo que prepara respostas de suporte com 2,000 tokens de entrada e 500 tokens de saída por resposta. Para 1,000 respostas e sem cache hits, o Flash custa $0.42 e o Pro, $1.305. Todo o adicional do Pro é de $0.885 a cada mil respostas.
Agora inclua o trabalho humano. Cinco minutos de revisão a um custo ilustrativo de $60 por hora equivalem a $5. Uma única revisão adicional custa mais do que cinco lotes completos desse adicional do Pro. Portanto, a pergunta certa não é “Qual modelo tem o menor preço na tabela?”, mas “Qual rota passa no critério de aprovação com a menor soma entre gasto com o modelo e tempo de revisão?”.
Como fica uma fatura mensal da DeepSeek
A DeepSeek não cobra por usuário ao mês como uma assinatura de software. O custo mensal depende apenas do perfil do tráfego: quanto contexto entra, quanto texto sai, com que frequência os prefixos acertam o cache e quantas tentativas são necessárias para chegar a um resultado aprovado.
Em um protótipo individual que use 10M de tokens de entrada com cache miss e 2M de tokens de saída por mês, o Flash custa $1.96 e o Pro, $6.09. A diferença de $4.13 não decidirá se o produto sobrevive. O melhor será o modelo que entregar um resultado válido com menos depuração.
Em uma operação de suporte que prepare 100,000 respostas com 2,000 tokens de entrada e 500 tokens de saída cada, a fatura sem cache será de $42.00 no Flash ou $130.50 no Pro. Com uma taxa ilustrativa de 80% de cache hit na entrada, os totais caem para $20.048 e $61.48. Mesmo nesse volume, uma hora de revisão humana pode superar toda a conta mensal do Flash sob a premissa de $60 por hora.
Para 1,000 tarefas de análise de documentos com 50,000 tokens de entrada e 2,000 tokens de saída cada, a conta sem cache será de $7.56 no Flash ou $23.49 no Pro. Com 80% da entrada atingindo o cache, ela passa a $2.072 ou $6.235. Uma entrada longa não produz automaticamente uma fatura alta na DeepSeek; quando se repete, pode gerar um custo unitário excepcionalmente baixo.
Os exemplos também mostram por que copiar a estimativa mensal de outra empresa não serve. Uma resposta de suporte usa muita saída em relação ao prompt. Uma tarefa com documentos concentra o volume na entrada. Um agente pode multiplicar ambos por meio de novas tentativas e ciclos de ferramentas. Guarde a composição dos tokens junto ao valor em dólares para que a equipe financeira consiga distinguir uma mudança de tráfego, qualidade ou tarifa do fornecedor.
O ponto de equilíbrio entre Flash e Pro
As tarifas de entrada com cache miss e de saída do V4 Pro são 3.107143 vezes as do Flash, arredondadas para 3.11x. Mantendo a mesma composição de tokens, o Pro precisa reduzir as tentativas cobradas ou o volume de tokens em 67.82% para empatar apenas no gasto com o modelo.
Se o Pro concluir uma tarefa em uma tentativa, o Flash pode usar em média até 3.11 tentativas comparáveis antes que sua conta de tokens fique maior. Se o Flash resolver em uma ou duas tentativas, o Pro perde na comparação de preço. Se o Flash precisar repetidamente de quatro tentativas, o Pro vence antes mesmo de considerar a revisão humana.
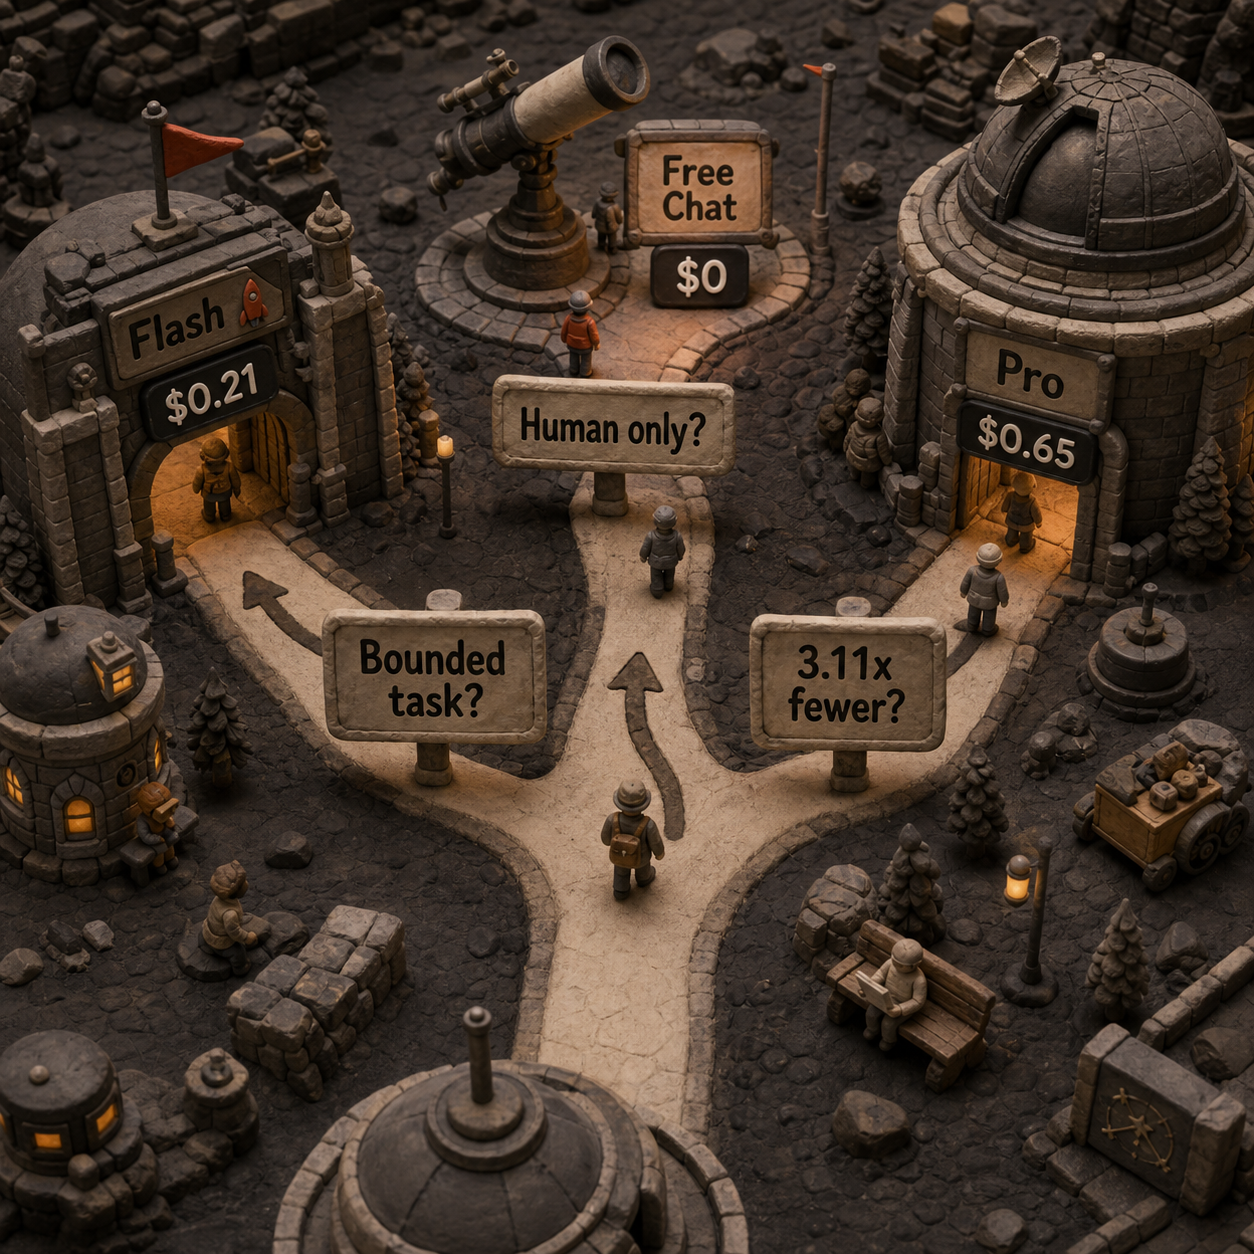
Essa regra de roteamento também evita um erro comum nas compras de tecnologia. A equipe vê tarifas abaixo de um dólar, envia todas as tarefas ao Pro e considera o total barato. A conta absoluta pode continuar pequena, mas pagar um adicional sem medir em milhões de chamadas não é estratégia. O Flash deve assumir a carga básica e delimitada; o Pro, as falhas que justifiquem seu custo.
O cache de contexto só muda a conta quando os prefixos se repetem
A tarifa de cache hit da DeepSeek é valiosa, mas não deve entrar na planilha como um desconto garantido. O guia de cache de contexto informa que o cache vem ativado por padrão, funciona com unidades completas e persistidas do prefixo e opera em regime de melhor esforço.
Um prompt de sistema estável seguido por um documento de referência igualmente estável é um forte candidato ao cache. Uma solicitação posterior pode reaproveitar esse início e acrescentar uma nova pergunta. Repetir uma frase do meio de outro prompt não basta. O prefixo inteiro precisa corresponder a uma unidade que a DeepSeek tenha armazenado.
O cache também tem uma dimensão temporal. A construção leva alguns segundos, e entradas sem uso normalmente são removidas em um intervalo de horas a dias. Um relatório semanal pode não encontrar um cache que seria aproveitado por uma sequência concentrada de solicitações quase idênticas. A DeepSeek não garante uma taxa de acerto de 100%.
Com uma taxa ilustrativa de 80% de cache hit na entrada, o custo combinado por milhão de tokens cai para $0.03024 no Flash e $0.08990 no Pro. No exemplo das 1,000 respostas de suporte, o custo total passa de $0.42 para $0.20048 no Flash e de $1.305 para $0.61480 no Pro.
Isso representa cerca de metade da conta total nesse fluxo que também gera saída — não a redução quase integral sugerida quando se comparam isoladamente as tarifas de entrada com cache hit e cache miss. Tokens de saída não recebem o desconto do cache de entrada.
Mantenha o prefixo estável
Coloque primeiro as instruções permanentes e os materiais de referência que se repetem. Acrescente depois a solicitação variável do usuário, em vez de reconstruir o prompt em outra ordem.
Leia os campos de uso
Acompanhe
prompt_cache_hit_tokenseprompt_cache_miss_tokensnas respostas da API. Uma taxa de acerto projetada só vira dado de cobrança quando esses campos a confirmam.Calcule o preço da composição observada
Separe a entrada medida entre tokens com hit e miss, some os tokens de saída e calcule o custo por resultado aprovado. Refaça a conta sempre que a estrutura do prompt ou a cadência do tráfego mudar.
A DeepSeek API é mais barata que as alternativas antes de ajustar a qualidade
A DeepSeek vence por ampla margem quando a comparação considera apenas o preço bruto dos tokens. Isso não garante o melhor resultado de negócio, pois os modelos diferem em capacidade, ferramentas, latência e taxa de falhas.
Use uma carga normalizada para tornar os preços de tabela comparáveis: 1M de tokens totais de entrada mais 250K tokens de saída, sem desconto de cache. Essa carga custa $0.21 no V4 Flash e $0.6525 — arredondados para $0.65 — no V4 Pro.
O OpenAI GPT-5.6 Sol cobra $5 por milhão de tokens de entrada e $30 por milhão de tokens de saída. A carga normalizada custa $12.50 quando cada solicitação fica abaixo do limite de contexto longo da OpenAI, ou 19.16x o V4 Pro. Prompts acima de 272K tokens de entrada acionam preços 2x maiores na entrada e 1.5x maiores na saída para toda a solicitação, e as gravações no cache custam 1.25x a entrada sem cache.
O Claude Sonnet 5 cobra $2 por milhão de tokens de entrada e $10 por milhão de tokens de saída. A mesma carga custa $4.50, ou 6.90x o V4 Pro. A Anthropic inclui a janela de contexto de 1M no preço padrão e oferece desconto de 50% no Batch, o que pode reduzir a diferença em trabalhos que toleram maior latência.
O Gemini 3.1 Pro Preview cobra $2 por milhão de tokens de entrada e $12 por milhão de tokens de saída quando o prompt tem até 200K. A carga normalizada agregada custa $5.00 se todas as solicitações ficarem abaixo desse limite, ou 7.66x o V4 Pro. Coloque a mesma carga em uma única solicitação acima de 200K e as tarifas do Google sobem para $4 na entrada e $18 na saída, levando a conta a $8.50, ou 13.03x o V4 Pro.
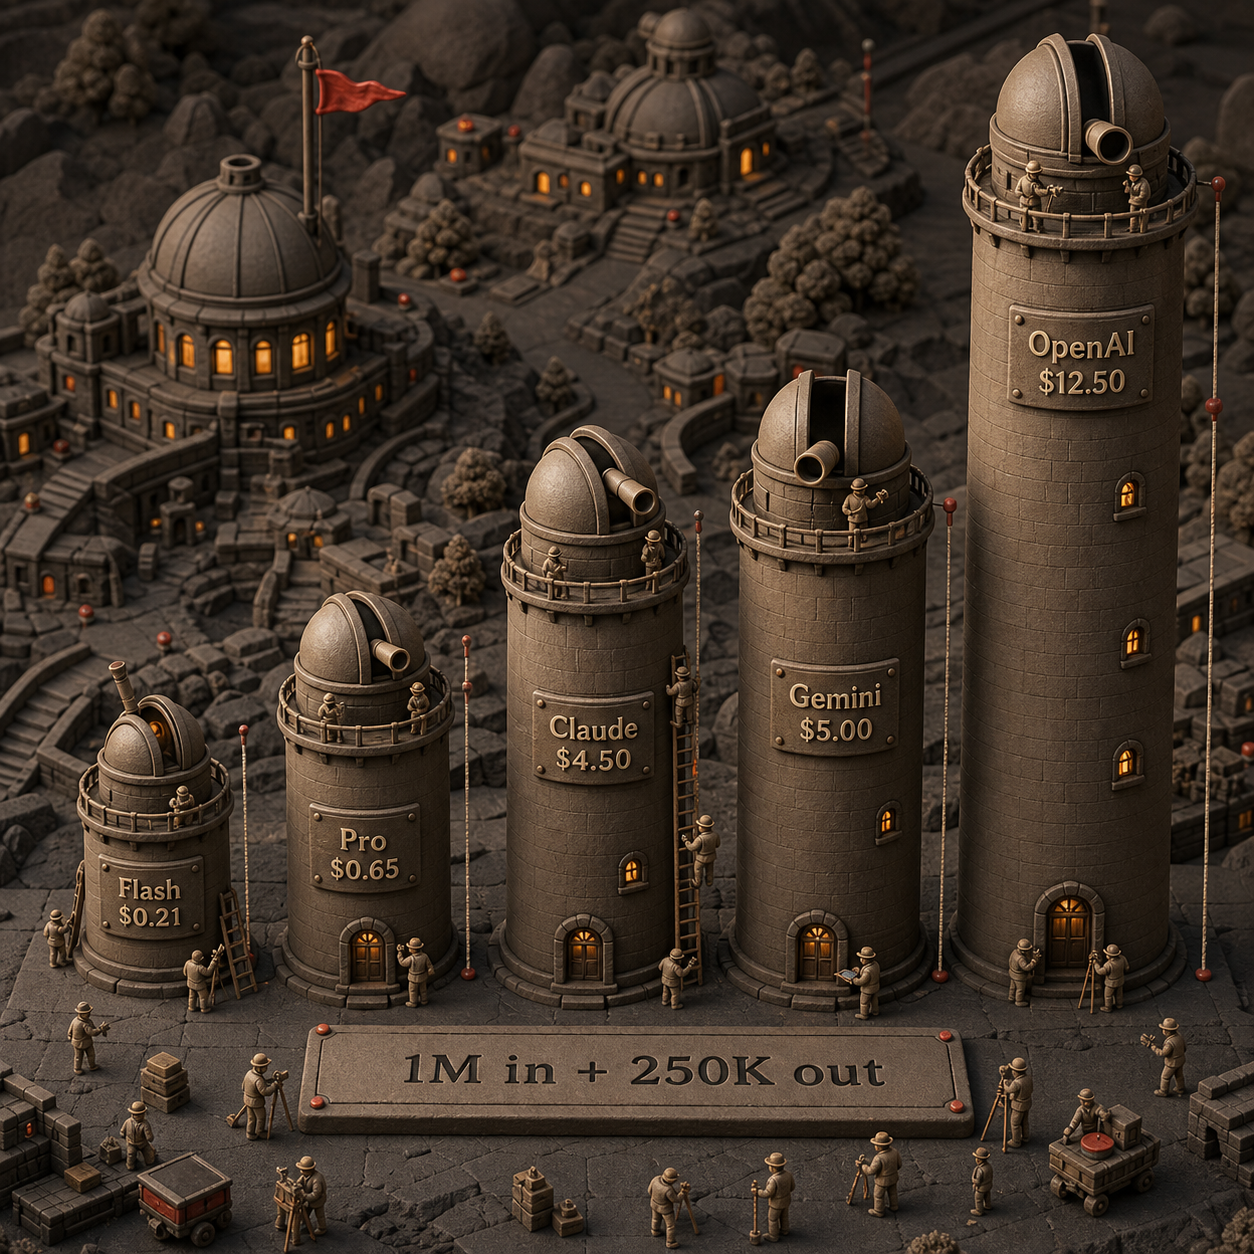
A diferença entre os preços é grande, mas a distância em dólares é menor do que os múltiplos sugerem. Trocar o V4 Pro pelo GPT-5.6 Sol na carga normalizada acrescenta $11.8475. Uma correção humana pode consumir essa economia, enquanto uma rota confiável e de alto volume pode multiplicá-la.
Consulte o comparativo entre DeepSeek e ChatGPT quando qualidade do modelo, recursos do produto e tratamento de dados forem mais importantes que a tabela de tokens. Veja a lista das APIs de IA mais baratas quando a tarefa comportar modelos econômicos menores e gateways. Uma página de preços consegue normalizar tarifas; só a sua avaliação consegue normalizar resultados.
O risco oculto no orçamento é o reajuste, não um contrato anual
A página ativa da DeepSeek informa que haverá um aumento geral no preço da API em um futuro próximo e descreve a alta esperada como expressiva. Ela não publica valor nem data de vigência. As tarifas de hoje são fatos verificados; qualquer multiplicador futuro é especulação.
Esse aviso muda a decisão de compra. Não prometa a um cliente, ao conselho ou à equipe financeira que a tarifa de agosto valerá por um ano. Salve a data de verificação da página de preços junto a cada modelo de orçamento, mantenha a tarifa como campo editável e defina qual alteração de preço deve acionar uma mudança de rota.
Não há armadilha mensal nem anual na API
A DeepSeek trabalha com desconto de saldo por token, não com cobrança mensal por usuário nem contrato anual self-service. O saldo recarregado não expira. O saldo concedido pode expirar, e a data aparece na página Billing. Quando ambos existem, a API consome primeiro o saldo concedido.
Segundo a FAQ oficial da DeepSeek, o saldo não usado pode ser reembolsado em Billing > Refunds. Isso torna uma recarga moderada menos arriscada que um compromisso anual não reembolsável. A exclusão da conta é a exceção: a FAQ alerta que qualquer saldo restante na Open Platform será perdido.
A DeepSeek também evita surpresas com excedentes pós-pagos. Quando o saldo é insuficiente, a API devolve HTTP 402 e pede uma recarga. O risco operacional é uma interrupção, não uma fatura que ultrapassa silenciosamente o limite do plano. Configure um alerta de saldo antes que o tráfego de produção encontre esse limite.
Integração e simultaneidade podem custar mais que tokens
O Flash informa 2,500 solicitações simultâneas e compatibilidade atual com a Responses API. O Pro informa 500 e ainda não oferece essa compatibilidade. Quem projeta o sistema em torno do Pro sem conferir esses limites pode pagar em filas, lógica de fallback ou trabalho de integração, mesmo que a conta do modelo fique abaixo de um dólar por milhão de tokens.
A arquitetura segura mais barata mantém o roteamento reversível. Use uma única interface interna, registre o modelo escolhido e o consumo de tokens e preserve um fallback testado. O aviso de reajuste da DeepSeek transforma essa prática comum de engenharia em um controle de orçamento.
O histórico de preços da DeepSeek separou Flash e Pro
O V4 não barateou todos os itens da tabela da mesma forma. A estratégia atual de níveis reduziu agressivamente o Flash, mas manteve um valor mais alto para a entrada com cache miss no Pro.
O anúncio de preços do V3 informava $0.07 por milhão de tokens de entrada com cache hit, $0.27 com cache miss e $1.10 por milhão de tokens de saída. Comparado a essas tarifas, o V4 Flash ficou 96.00% mais barato na entrada com cache hit, 48.15% mais barato na entrada com cache miss e 74.55% mais barato na saída.
O movimento do V4 Pro é diferente. Sua entrada com cache hit ficou 94.82% mais barata que no V3 e a saída, 20.91% mais barata, mas a entrada de $0.435 com cache miss ficou 61.11% mais cara que os $0.27 do V3.
Esse histórico explica a regra de decisão atual. O Flash não é apenas uma versão com um selo menor; é a aposta para volume. O Pro exige que o fluxo justifique a tarifa sem cache mais alta com resultados melhores. O próximo aumento anunciado pode alterar ambos, por isso a data de verificação deve ficar junto dos cálculos.
A ação de segunda-feira: meça uma rota antes de mover o orçamento
Na segunda-feira, separe 100 solicitações higienizadas de um fluxo delimitado e faça um teste de roteamento por uma semana. Não comece com uma migração de toda a empresa.
Defina primeiro o critério de aprovação
Escolha um resultado que o revisor consiga avaliar de modo consistente: schema válido, classificação correta, testes aprovados ou rascunho de suporte aceito. Retire dados de clientes, pessoais e confidenciais do conjunto de avaliação.
Envie a carga básica ao Flash
Execute todas as 100 solicitações no V4 Flash-0731. Para cada uma, registre dados de entrada, saída, cache hit, cache miss, novas tentativas, latência e aprovação.
Escale apenas as falhas
Encaminhe os casos reprovados ou ambíguos ao V4 Pro. Meça se o Pro reduz a parte problemática o suficiente para compensar a tarifa 3.11x maior do modelo e qualquer tempo de revisão humana.
Defina dois gatilhos de orçamento
Mantenha o Flash como padrão somente enquanto ele superar o patamar mínimo de qualidade. Mantenha a DeepSeek como fornecedora somente enquanto o custo normalizado ativo ficar abaixo do fallback testado após qualquer alteração de preço.
O teste entrega um único número pronto para orientar a decisão: custo por resultado aprovado. Assim, as tarifas minúsculas por token da DeepSeek viram um orçamento de fluxo de trabalho que a equipe financeira pode revisar sem refazer toda a análise.
Perguntas frequentes
A DeepSeek é paga ou gratuita?
O aplicativo oficial da DeepSeek para consumidores é gratuito, sem anúncios nem compras no app. O acesso à API é separado e cobra pelos tokens de entrada com cache hit, entrada com cache miss e saída.
Quanto custa o DeepSeek V4 Pro?
O V4 Pro custa $0.003625 por milhão de tokens de entrada com cache hit, $0.435 por milhão de tokens de entrada com cache miss e $0.87 por milhão de tokens de saída. Ele oferece janela de contexto de 1M, saída máxima de 384K e limite informado de simultaneidade de 500.
Quanto custa a DeepSeek por mês?
O chat para consumidores custa $0 por mês. A API não tem preço mensal fixo: multiplique os totais mensais de tokens de entrada com cache hit, entrada com cache miss e saída pelas respectivas tarifas por milhão.
Por que a DeepSeek é mais barata que o ChatGPT?
Em uma carga baseada apenas em preço, com 1M de tokens de entrada e 250K tokens de saída, o DeepSeek V4 Pro custa cerca de $0.65, enquanto o OpenAI GPT-5.6 Sol custa $12.50 abaixo do limite de contexto longo — uma diferença de 19.16x. Compare resultados aprovados, não apenas tokens, pois a qualidade do modelo e a compatibilidade com ferramentas são diferentes.
A DeepSeek oferece desconto para estudantes?
A DeepSeek não informa um plano nem um desconto específico para estudantes nas páginas oficiais de preços, FAQ ou aplicativo verificadas em agosto de 2026. Estudantes que usam o aplicativo para web ou celular já pagam $0.
Posso pedir reembolso à DeepSeek?
Sim. O saldo não usado da API pode ser reembolsado em Billing > Refunds. O saldo recarregado não expira, enquanto o saldo concedido pode ter data de validade. Excluir a conta elimina o saldo restante na Open Platform.
Os preços da DeepSeek mudaram em 2026?
Sim. Em comparação com a tabela anterior do V3, o V4 Flash ficou 48.15% mais barato na entrada com cache miss e 74.55% mais barato na saída. A saída do V4 Pro ficou 20.91% mais barata, mas sua entrada com cache miss ficou 61.11% mais cara. A DeepSeek agora avisa que haverá outro aumento expressivo, sem informar valor nem data.
Devo escolher o V4 Flash ou o V4 Pro?
Escolha o Flash para a carga básica e delimitada; use o Pro em casos reprovados ou de alto impacto. Considerando o gasto sem cache, o Pro precisa usar cerca de 67.82% menos tentativas cobradas ou tokens para empatar com a tarifa 3.11x menor do Flash.
Receba o Mapa de Ferramentas de IA para Empresas
O Mapa de Ferramentas de IA para Empresas transforma preços de modelos em uma estrutura prática de adoção, com patamar mínimo de qualidade, função no roteamento e gatilho de custo para cada ferramenta. Assine para receber gratuitamente a próxima edição.
- Última atualização
- 3 de set. de 2026
- Categoria
- AI
Prefira este site no Google


Marque omidsaffari.com como fonte preferida e o Google destaca o site para você em Top Stories, AI Overviews e AI Mode.
Nouswise vale a pena? Análise da IA para pesquisa com fontes
Analisamos em detalhes o Nouswise, uma IA para pesquisa com citações: preços, limites, riscos e o que validar antes de adotá-lo no lugar do NotebookLM.10 de set. de 2026AI
IA na construção civil: 5 ferramentas para revisar submittals
Veja quais ferramentas de IA na construção civil conferem submittals contra especificações, com fontes, controle de revisões, preços e testes.9 de set. de 2026AI
IA veterinária: VetGeni ou ScribbleVet — qual vale mais?
VetGeni ou ScribbleVet? Compare preços, limite de notas SOAP, integrações com PIMS, modelos e acesso da equipe antes de escolher a IA veterinária.9 de set. de 2026AI
IA para construção civil: o InspectMind vale a pena?
Veja como a IA para construção civil do InspectMind revisa projetos, quanto custa cada checagem e quais limites pesam antes de adotar a ferramenta.8 de set. de 2026AI
BuildSync ou SpecLens: qual software para construção civil escolher?
Compare BuildSync e SpecLens em submittals, integrações, arquivos, exportações e preços para escolher o software para construção civil ideal para sua obra.8 de set. de 2026AI
Melhores ferramentas de IA veterinária para prontuários de equinos
Compare 8 ferramentas de IA veterinária para prontuários de equinos, com gravação offline, separação por cavalo, preços e integração com PIMS.7 de set. de 2026AI
Claude ou ChatGPT em 2026: qual é a melhor IA para programar?
Claude ou ChatGPT em 2026? Compare código, escrita, imagens, preços e recursos para saber qual assinatura de $20 faz mais sentido para o seu trabalho.6 de set. de 2026AI