Стоимость голосового ИИ-агента на GPT-Live-1: полный расчет
Разбираем стоимость голосового ИИ-агента на GPT-Live-1: $0.05 за минуту голосовой сессии, расходы на бэкенд, инструменты и телефонный трафик.



Стоимость голосового ИИ-агента на GPT-Live-1 теперь проще рассчитать хотя бы в одной части: голосовая сессия стоит $0.05 в минуту. С 10 сентября 2026 года командам легче строить разговорный контур, в котором модель сама говорит и слушает, однако для бюджета по-прежнему важна полная стоимость успешно обработанного звонка — с учетом рассуждений на бэкенде, инструментов и телефонного трафика.
Пять центов — цена только голосового слоя
GPT-Live-1 — полнодуплексная голосовая модель. Она продолжает слушать, пока говорит, поэтому собеседник может перебить агента, сделать паузу, поправить деталь или коротко подтвердить услышанное, не дожидаясь формального конца реплики.
Из-за этого меняется сама архитектура системы. Традиционный голосовой агент часто последовательно связывает распознавание речи, языковую модель и синтез речи. Приложению приходится передавать данные между этими этапами и решать, что делать, если обе стороны говорят одновременно.
В GPT-Live-1 живой разговор сосредоточен в одном голосовом слое. Модель слушает и говорит, следит за таймингом и определяет, когда более сложную работу следует передать на бэкенд. Там можно проверить бронирование, получить данные учетной записи, вызвать инструмент или разобраться в правилах обслуживания.
Бэкенд намеренно отделен от голоса. Можно использовать делегирование через Responses: GPT-Live-1 отправит задачу настроенной вами текстовой модели OpenAI. Другой вариант — клиентское делегирование, при котором ваше приложение запускает любую модель, агента или сервис и возвращает результат. Голос остается прежним, а для конкретной задачи можно выбрать более дешевую или более мощную модель.
Телефонное подключение — еще один отдельный слой. Входящий звонок может поступать в GPT-Live-1 через SIP-транк, то есть интернет-соединение от оператора телефонии, либо через приложение, которое ретранслирует аудио. OpenAI обслуживает сессию Live, но номер и телефонный трафик по-прежнему находятся на стороне вашего оператора.
В этом и состоит главное изменение для бюджета. В таком сценарии больше не нужно отдельно считать распознавание и генерацию речи как два этапа на моделях OpenAI. Зато необходимо вести три статьи расходов.
Из чего складывается стоимость голосового ИИ-агента
Первая ловушка — работа счетчика времени. Тарификация GPT-Live-1 охватывает всю активную сессию от запуска до закрытия. Тишина учитывается. Ожидание ответа инструмента учитывается. Отключение микрофона не останавливает начисление платы.
Вторая ловушка — считать бэкенд бесплатным только потому, что он работает в фоне. Это не так. При стандартных тарифах для короткого контекста GPT-5.6 Luna стоит $0.20 за миллион входных токенов и $1.20 за миллион выходных. Для GPT-5.6 Terra цены составляют $2.00 и $12.00, для GPT-6 Astra — $10.00 и $50.00. Сравнивать следует не просто тариф за токен, а то, какая комбинация надежно завершает задачу с минимальными общими затратами времени и без переделок.
Звонок для бронирования показывает реальную арифметику
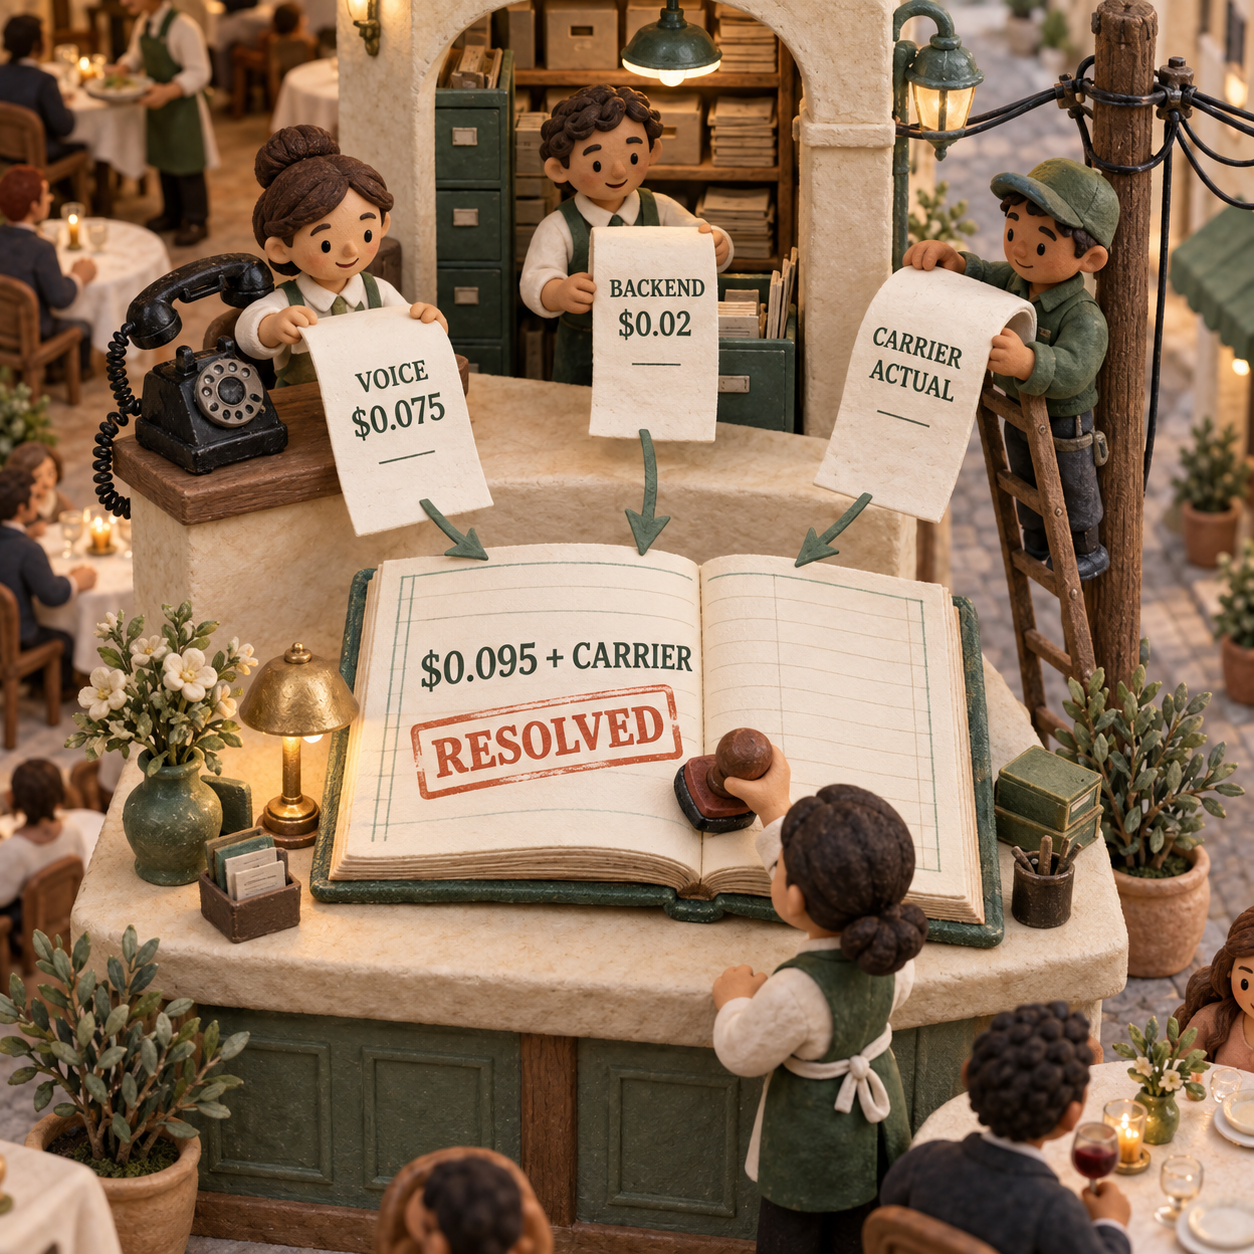
Рассмотрим входящий звонок в ресторан для бронирования столика длительностью 90 секунд. Пример расчета от OpenAI дает понятную отправную точку:
- Голос: 90 секунд делим на 60 и умножаем на $0.05 — получаем $0.075.
- Бэкенд: предположим, что измеренное использование модели и инструментов в этом примере стоит в сумме $0.02.
- Промежуточный итог для голоса и бэкенда: $0.095.
- Телефонный трафик: добавьте стоимость услуг оператора для этого звонка.
Итак, звонок стоит не $0.075, а $0.095 плюс телефонный трафик в рамках этого примера. Если бронирование подтверждено, это прямые эксплуатационные расходы на одну успешно оформленную бронь. Если агент не справился и человеку пришлось повторить работу, расходы на неудачный звонок остаются в числителе при расчете стоимости одного решенного обращения.
Поэтому оставить тариф оператора отдельной переменной честнее, чем подставить в итог выдуманную рыночную ставку. OpenAI не определяет эту часть цены — сумму за телефонный трафик нужно брать из счета вашего провайдера.
В расчете есть еще одна важная взаимосвязь. Более быстрый бэкенд может оправдать повышенный тариф за токены, если он раньше закрывает сессию Live. Если открытая сессия сокращается на одну минуту, голосовые расходы уменьшаются на $0.05. Более дешевый бэкенд способен в итоге обойтись дороже, если из-за него собеседнику приходится повторять детали, ждать инструменты или так и не удается оформить бронь.
Как это выглядит в реальном сценарии звонка
Ресторан может подключить GPT-Live-1 к входящему номеру для бронирований и ограничить задачу агента. Голосовой слой ведет разговор. Недорогой бэкенд проверяет доступность и готовит бронь. Приложение подтверждает выбранное время, записывает бронирование и не позволяет запоздалому результату оформить столик на неверное время.
Руководитель поддержки может сохранить тот же голосовой интерфейс, но задать разные правила для бэкенда. Обычную проверку статуса заказа можно направить в экономичную модель. Спорное списание или исключение из правил — передать более мощной модели либо человеку. Ценность подхода не в том, чтобы одна голосовая модель выполняла всю работу, а в возможности подбирать стоимость рассуждений под задачу, сохраняя единый разговорный интерфейс.
У продуктовой команды с готовой цепочкой из распознавания речи, модели и синтеза речи выбор будет другим. GPT-Live-1 может убрать код для передачи данных между этапами и упростить обработку одновременной речи, но миграция окупится лишь в том случае, если новая система достаточно улучшит выполнение задач или упростит поддержку. Когда нужно решить, создавать систему самостоятельно или покупать готовую, по-прежнему пригодится более широкий разбор стоимости голосовых ИИ-агентов.
Команда браузерного приложения может подключаться через WebRTC и полностью исключить расходы на телефонного провайдера. Платить за длительность Live и работу бэкенда все равно придется. На текстовых агентов, пакетные процессы и приложения без голосового общения этот релиз не влияет.
Минимальный полезный пилот для телефонного ИИ-агента
Прямое SIP-подключение начинается с того, что провайдер направляет входящий звонок в OpenAI, а ваш вебхук получает идентификатор сессии Live. Документированный запрос для принятия звонка выглядит так:
curl -X POST "https://api.openai.com/v1/live/sessions/$SESSION_ID/accept" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "session": {
      "type": "live",
      "model": "gpt-live-1",
      "instructions": "You are answering an inbound support call.",
      "audio": { "output": { "voice": "marin" } },
      "delegation": { "type": "client" }
    }
  }'
API-ключ хранится на доверенном бэкенде. Формат аудио согласуется по SIP, поэтому audio.format указывать не нужно. Клиентское делегирование означает, что бэкенд-модель, инструменты, разрешения и учет использования остаются под контролем вашего приложения.
Для пилота входящих звонков с бронированием объем работы достаточно мал, чтобы измерения оставались прозрачными.
Выберите один результат
Критерием успеха должно быть подтвержденное бронирование, а не просто приятный разговор. Сохраняйте запрошенное время, фактическое время брони и факт передачи разговора человеку.
Записывайте каждую статью расходов
Во время звонка сохраняйте последнее накопительное значение голосовых секунд. При корректном закрытии замените его финальными данными об использовании из
session.closed. Каждый идентификатор ответа бэкенда, расход токенов и инструментов записывайте один раз. Свяжите эти данные с детализацией звонка от оператора.Проверьте реальные перебивания
В тестах воспроизведите паузы, исправления, фоновую речь и короткие подтверждения, характерные для реальных звонков. Проверьте расшифровку, действие бэкенда и звук, который действительно услышал собеседник. Завершенный ответ бэкенда еще не доказывает, что результат был озвучен.
Сравните стоимость выполненной задачи
Сложите затраты на голос, бэкенд и телефонный трафик за весь пилот, затем разделите сумму на количество подтвержденных бронирований. Учитывайте расходы на неудачные звонки, повторные попытки и передачу человеку. Сравнивайте результат с текущей системой на одних и тех же сценариях звонков.
Заявление о перебиваниях еще нужно проверить на своих данных
GPT-Live-1 рассчитан на одновременную речь, однако пример при запуске продукта — не соглашение об уровне сервиса для вашей системы. Сооснователь и CTO Speak Andrew Hsu сообщает, что в ранней оценке Speak количество перебиваний во время пауз на обдумывание сократилось почти на 80% по сравнению с прежними системами с поочередными репликами. Этот результат относится к сценарию языкового репетитора Speak.
Шумная линия ресторана, звонок в поддержку с диктовкой номера заказа и пациент, который делает паузу перед датой, — разные рабочие нагрузки. На восприятие звонящего влияют промпт, телефонный кодек, джиттер у оператора, задержка инструментов и ваши механизмы управления воспроизведением. Универсальной оценки улучшения обработки перебиваний или задержки, которую можно было бы честно перенести в прогноз, не существует.
Важен и пограничный случай в продакшене. Если звонящий перебивает агента и меняет пятницу на четверг, устная поправка сама по себе не отменяет работу бэкенда для пятницы. Приложение должно изменить или отменить старую задачу, проигнорировать запоздалый результат и не допустить, чтобы повторная попытка создала второе бронирование.
Сейчас прямое SIP-подключение GPT-Live поддерживает входящие звонки. Эндпоинт создания сессии Live не инициирует исходящий SIP-вызов, поэтому для исходящих кампаний по-прежнему нужен партнерский маршрут под управлением провайдера. Командам, которым в первую очередь необходимы исходящие звонки, следует проверить этот маршрут до планирования миграции.
Что сделать в понедельник
Если вы работаете с очередью входящих звонков для бронирования или поддержки, запустите один узкий пилот с полноценными измерениями. Сведите в одну запись голосовые секунды, использование бэкенда, расходы оператора, выполненные задачи, передачи человеку и сбои при перебиваниях. Сравните экономичную модель на бэкенде с более мощной моделью, которая, как вам кажется, необходима.
Переходить дальше стоит, когда полная стоимость успешно обработанного звонка оказывается ниже, чем у текущего стека, а звонящие могут поправлять агента без запуска уже неактуальных действий. Подождите, если единственное преимущество — заявленные $0.05 или если вопрос с оператором и исходящими звонками еще не решен. Для текстовых задач и голосовых систем, которые уже достигают целевых показателей стоимости и успешного выполнения, этот релиз можно пропустить.
Чтобы получать больше понятных разборов изменений, которые влияют на экономику работы, подпишитесь на рассылку.
- Последнее обновление
- 14 сент. 2026 г.
- Категория
- Explained
Сделать этот сайт предпочтительным в Google


Отметьте omidsaffari.com как предпочтительный источник — и Google будет поднимать его для вас в Top Stories, AI Overviews и AI Mode.

ChatGPT Appshots в Windows: контекст без ручного копирования
Разбираемся, как ChatGPT Appshots в Windows передаёт окно приложения в чат, экономит время на сборе контекста и какие данные важно проверить.14 сент. 2026 г.Explained
FastAPI на Vercel: когда статика больше не вызывает Functions
FastAPI на Vercel теперь отдаёт подходящую статику через CDN без вызова Functions. Разбираем экономию, правила маршрутов и риски обхода защиты.13 сент. 2026 г.Explained
Ротация API-ключей OpenAI: план без простоя
OpenAI разрешила задавать срок действия проектных API-ключей. Разбираем, как заранее заменить ключ, проверить рабочие процессы и не остановить агентов.13 сент. 2026 г.Explained
Права доступа Vercel Connect: кто отвечает за общие учётные данные
Права доступа Vercel Connect: кто управляет общими подключениями, как работает роль Connector Manager и какие уровни контроля остаются отдельными.13 сент. 2026 г.Explained
Cloudflare AI Search: как убрать переименование файлов R2 из конвейера
Cloudflare AI Search индексирует файлы R2 без расширения по HTTP Content-Type. Разбираем новый процесс, стоимость исправления метаданных и проверку поиска.12 сент. 2026 г.Explained
Vercel Sandbox: как 64 GB меняют сборки и задачи ИИ-агентов
Vercel Sandbox получил 64 GB рабочего диска. Разбираем, какие сборки и задачи ИИ-агентов теперь помещаются в одну среду и как считать расходы.12 сент. 2026 г.Explained
Cloudflare Workflows: как настроить хранение истории запусков
В Cloudflare Workflows состояние новых платных Workflow теперь по умолчанию хранится 7 дней. Как выбрать сроки для ошибок, расследований и расчёта затрат.11 сент. 2026 г.Explained