Claude Code precio: qué cuesta realmente ejecutar build-eval
Qué partes de build-eval son públicas, dónde aparece el costo y cómo estimar 144 ejecuciones con un piloto medido antes de ampliar la evaluación.




No. Si buscas “Claude Code precio” para saber si el flujo build-eval de la API de Claude es gratis, hay que separar las instrucciones públicas del trabajo facturable: 24 casos × 3 repeticiones × 2 variantes de modelo son 144 ejecuciones de la aplicación, antes de cualquier llamada opcional a un juez o por reintentos. Para esta verificación no había disponible un piloto financiado de la aplicación, así que 144 es un cálculo aritmético, no un total medido en dólares.
¿El build-eval de la API de Claude es gratis?
Los archivos del flujo se pueden consultar gratis; al ejecutar la evaluación, el uso de modelos puede generar cargos en tres puntos distintos. Claude Code puede consumir el cupo de una suscripción o cargar el uso a una cuenta con facturación por consumo; la aplicación que se prueba llama a su propio proveedor de modelos; y un juez opcional basado en un modelo hace otra serie de llamadas. Un evaluador local determinista evita la tercera factura, pero no las llamadas de la aplicación.
Esta diferencia importa porque build-eval no es una bolsa de créditos gratuitos para evaluaciones. Es un flujo guiado de Claude Code que permite construir una evaluación alrededor de una aplicación existente. Ayuda a identificar el punto de entrada, reunir casos, elegir un evaluador, escribir o adaptar un ejecutor y producir resultados que se puedan revisar. La implementación pública está disponible en el repositorio de skills de Anthropic, pero las llamadas que haga el ejecutor resultante se facturan según las reglas de la cuenta y del proveedor utilizados.
La respuesta prudente, por tanto, depende del caso: diseñar la evaluación puede ser gratis; ejecutarla solo lo será si no se realizan llamadas facturables o si todo el uso cabe en un cupo que ya se paga. Incluso entonces, “gratis” describe el costo marginal en la factura, no una capacidad ilimitada.
Qué cambió el 28 y 29 de septiembre
Anthropic convirtió la creación de evaluaciones y la optimización iterativa en dos flujos explícitos de Claude Code. La guía del 28 de septiembre de 2026 presentó /claude-api build-eval para crear una evaluación y /claude-api hillclimb para mejorar una aplicación a partir de ella. La implementación se publicó el 29 de septiembre a las 02:20:03 UTC en el commit 8a1541c4.
build-eval parte de un único flujo de la aplicación. Lee el punto de entrada existente, pregunta de dónde deben salir los casos representativos, propone el evaluador más barato que mida correctamente el resultado y exige una aprobación clara tanto de las entradas como del método de evaluación. El resultado es código y evidencia en el repositorio, incluidos un ejecutor, results.jsonl, trazas y un informe.
hillclimb entra después. Divide los casos entre conjuntos de entrenamiento y prueba reservada, modifica una sola parte permitida cada vez, vuelve a ejecutar la evaluación y revierte los cambios que empeoran el resultado o solo mejoran el conjunto de entrenamiento. Así puede mejorar prompts, selección de modelo, esfuerzo, herramientas o el código que envuelve la aplicación, pero cada variante que se intenta implica más ejecuciones.
El cambio duradero no es que “las evaluaciones ahora sean gratis”. Es que Claude Code puede montar un flujo de evaluación disciplinado y auditable sin obligar a adoptar un framework aparte. El modelo de pago que hay debajo no desapareció.
Claude Code precio: cuatro fuentes de costo en build-eval
Un presupuesto útil separa cuatro partidas, porque solo una es claramente gratuita. Agruparlas bajo un único “costo de Claude” impide explicar adónde se fue el dinero.
- El flujo público. La guía y los archivos de la skill son públicos. Leerlos, revisar los archivos locales generados y ejecutar una comprobación determinista local no genera por sí solo cargos por tokens de la API de Claude.
- La orquestación de Claude Code. Claude Code lee el repositorio, hace preguntas, escribe el ejecutor y ayuda a revisar los resultados. Quienes tienen una suscripción consumen el cupo de su plan; las sesiones autenticadas mediante API consumen tokens medidos. El costo de sesión que ven los usuarios de la API es una estimación, mientras que los usuarios con suscripción ven el uso de su plan, como explica la documentación de costos de Claude Code de Anthropic. Los detalles actuales del plan y la autenticación están en la guía de precios de Claude Code del sitio.
- La aplicación que se prueba. El ejecutor debe llamar al punto de entrada existente, en lugar de reconstruir una petición simplificada al modelo. Por eso, cada ticket de soporte, reintento, ciclo de herramientas y repetición consume recursos del proveedor y la cuenta que ya utiliza la aplicación.
- El evaluador. Una etiqueta fija, una comprobación de esquema, una prueba unitaria o una aserción sobre el estado final pueden ejecutarse localmente. Las respuestas abiertas quizá requieran un juez de modelo por resultado o por pares, lo que añade su propio uso de entrada, salida y caché, además de posibles herramientas.
El primer lugar donde ahorrar no es un juez más barato. Es elegir un evaluador programático siempre que el resultado correcto tenga una forma restringida. Si un enrutador de soporte debe devolver una sola cola de una lista fija, se puede comprobar con código. Preguntarle a otro modelo si billing equivale a billing supone pagar para resolver una cuestión determinista.
Un juez de modelo sí tiene sentido cuando la propiedad exige criterio, por ejemplo, para decidir si un resumen de escalamiento conserva la urgencia del cliente sin inventar hechos. Aun así, el uso de la aplicación y el del juez deben guardarse en campos separados. Un juez barato puede ocultar una ejecución cara de la aplicación, y también puede ocurrir lo contrario.
Las cifras: 24 casos se convierten en 144 ejecuciones de la aplicación
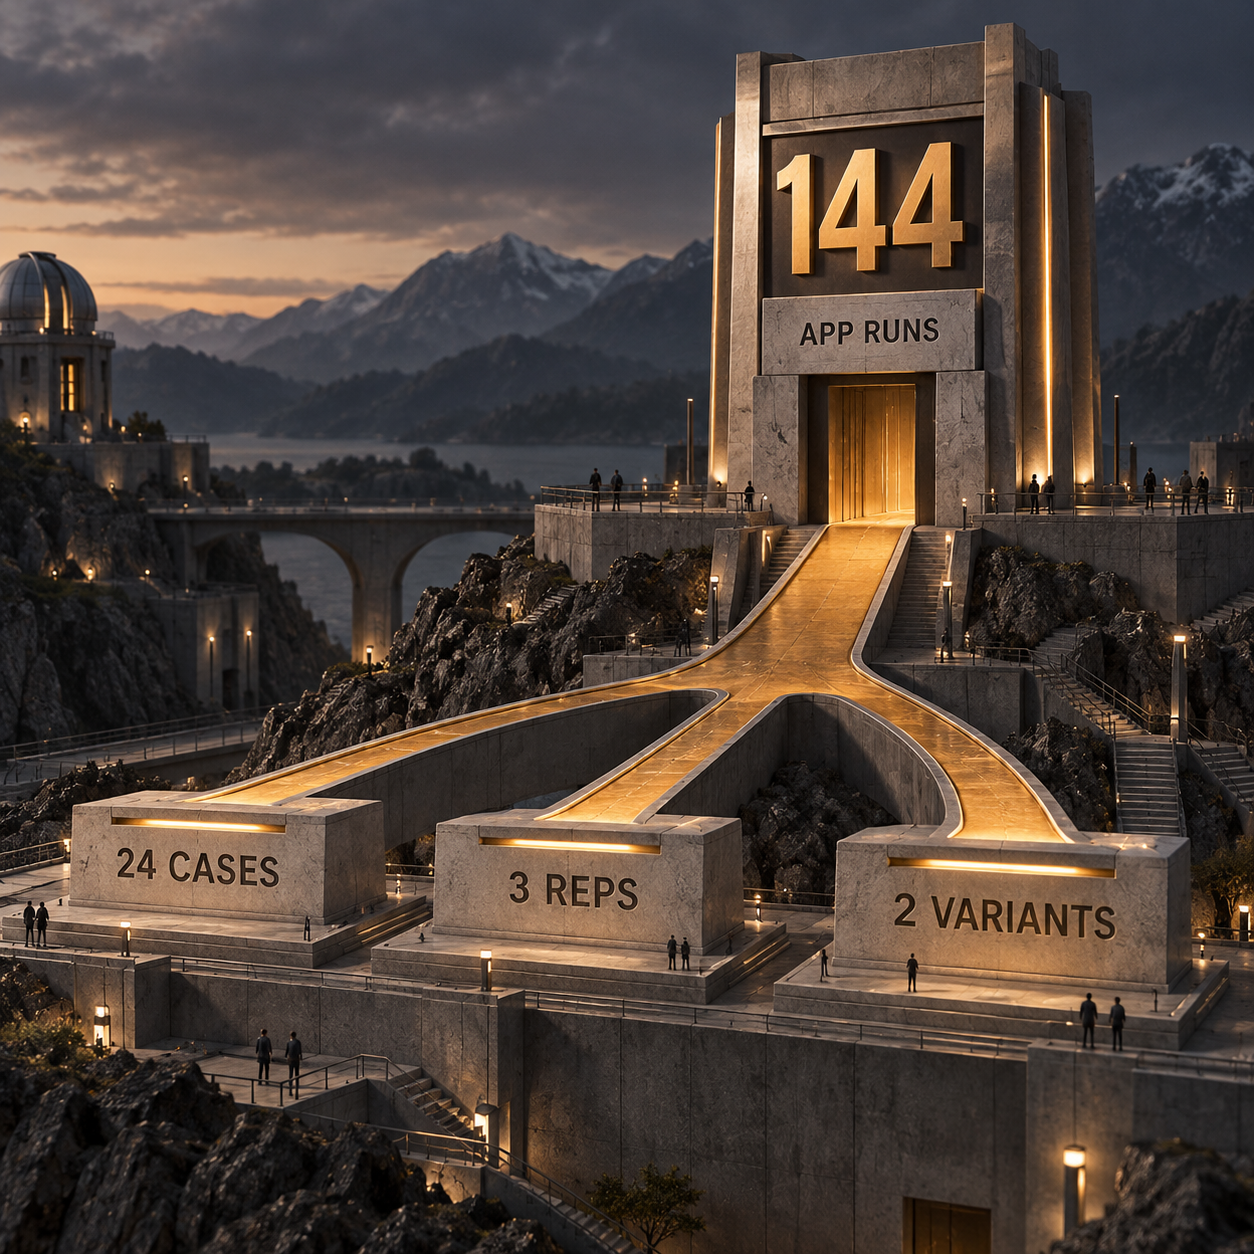
La cantidad de casos es apenas el primer multiplicador. La guía de lanzamiento de Anthropic muestra un ejemplo de enrutamiento de correo con 24 entradas. Si se comparan 2 variantes de modelo y cada caso se repite 3 veces, el número de ejecuciones de la aplicación es:
24 casos × 3 repeticiones × 2 variantes = 144 ejecuciones de la aplicación
Ese es el mínimo de ejecuciones para este diseño, antes de que un modelo evalúe nada y antes de que se reintente una petición fallida. Las repeticiones importan porque un modelo puede generar respuestas distintas ante la misma entrada. Las variantes importan porque una comparación necesita resultados de ambas configuraciones.
El tipo de evaluador determina el siguiente multiplicador:
- Evaluador programático: 0 llamadas a un juez de modelo. La ejecución se mantiene en 144 ejecuciones de la aplicación.
- Juez por pares: 72 llamadas al juez si una llamada compara las dos variantes para cada caso y repetición, porque 24 × 3 = 72 pares.
- Juez por resultado: 144 llamadas al juez si cada resultado de la aplicación se evalúa por separado. El total asciende así a 288 llamadas a modelos: 144 de la aplicación más 144 del juez, antes de reintentos o del uso de orquestación de Claude Code.
El hillclimbing añade otra dimensión porque cada ronda ejecuta un candidato nuevo. Un ciclo que prueba varios parches puede consumir varias pasadas completas de la evaluación, aunque todos los parches perdedores se reviertan. Hay que fijar un límite de rondas y otro de gasto antes de optimizar. “Detenerse cuando mejore la puntuación” no es un presupuesto, porque el ruido de las puntuaciones puede prolongar la búsqueda.
El precio de una evaluación con Claude API empieza por el uso medido
Un caso no tiene un precio fijo, de modo que la única estimación defendible empieza con los campos de uso reales de un piloto de pago. Un ticket puede resolverse con una sola llamada breve de clasificación. Otro puede activar un contexto largo, varias herramientas, reintentos y un juez. Poner precio a ambos como “un caso de evaluación” oculta precisamente la diferencia que determina la factura.
La tabla de tarifas de la API directa de Anthropic se verificó el 29 de septiembre de 2026. Los precios siguientes son por millón de tokens:
Fuente: página vigente de precios de la API de Claude de Anthropic. Para Amazon Bedrock o Google Cloud hay que usar la tabla de tarifas del propio proveedor, no copiar estos precios de la API directa.
Para cada fila del piloto, calcula:
entrada nueva de la aplicación + salida de la aplicación + escrituras de caché de la aplicación + lecturas de caché de la aplicación + entrada nueva del juez + salida del juez + escrituras de caché del juez + lecturas de caché del juez + herramientas de servidor de pago
Multiplica cada grupo de tokens por la tarifa del modelo que lo produjo. No mezcles los tokens de caché con la entrada nueva. El atajo genérico dice que una escritura de caché de 5 minutos cuesta 1.25 veces la entrada y una lectura cuesta 0.1 veces la entrada, pero la tabla actual presenta excepciones importantes en las lecturas: Fable 5.1 cuesta 0.025 veces su tarifa de entrada y Opus 5.5, 0.05 veces. Aplicar sin más un multiplicador de 0.1 exageraría ambos costos.
La misma disciplina se aplica al juez. Si la aplicación usa Sonnet 5.5 y el juez utiliza Haiku 4.5, cada uno debe calcularse con su propio uso y tarifa. Si la aplicación está sujeta a una tarifa de nube contratada, se usa ese contrato. Si una herramienta de servidor cobra por operación, se añade por separado. Las herramientas del lado del cliente también amplían el contexto del modelo y, por tanto, la factura de tokens.
Aquí no aparece una cifra medida en dólares porque esta publicación no contaba con un punto de entrada de la aplicación, una cuenta del proveedor ni un piloto financiado y aprobado. Inventar un número de tokens daría una cifra ordenada, pero un presupuesto inútil. La tabla de tarifas está verificada; el total de la ejecución debe esperar a que exista uso medido.
Claude Code build-eval: primero pon precio a un piloto de cinco tickets
El primer paso útil es ejecutar un piloto de cinco tickets a través del punto de entrada existente del enrutador de soporte y revisar después el uso fila por fila. Cinco no bastan para certificar la calidad en producción. Sí bastan para comprobar que el ejecutor, el evaluador, la traza y la contabilidad de costos están bien conectados antes de multiplicar el error por toda una suite.
Usa cinco tickets sintéticos que ejerciten comportamientos de enrutamiento distintos sin copiar datos de clientes:
- Un cliente no puede abrir el portal de facturación.
- Parece que se cobró dos veces una tarjeta.
- Un cliente pregunta si un plan anual admite reembolso.
- Una interrupción en producción requiere un escalamiento urgente.
- Un comprador empresarial solicita modificar un contrato.
Estos casos forman un conjunto piloto propuesto, no una prueba ya realizada. Deben entrar por la misma función, endpoint o script que utiliza el enrutador de producción, con los efectos externos aislados. Si el flujo real puede enviar correo, modificar una base de datos o avisar a un ingeniero, sustituye únicamente ese efecto por un fixture de prueba. El ensamblado del prompt, la llamada al modelo, las herramientas, los reintentos y el análisis de la respuesta deben ser equivalentes a producción; de lo contrario, el piloto estará calculando el precio del sistema equivocado.
Confirma el punto de entrada y la identidad de facturación
Registra la función o el endpoint de la aplicación, el modelo, el proveedor, la cuenta, el prompt, las herramientas y la forma de salida. Registra también cómo se autentica Claude Code. Así se separa el cupo del plan del uso de la API de la aplicación antes de que comience cualquiera de los dos.
Aprueba las cinco entradas y el evaluador
Revisa cada ticket sintético y aprueba la ruta esperada. Para una etiqueta de cola fija, usa un evaluador programático. Añade un juez de modelo solo para una propiedad que el código no pueda comprobar y nunca permitas que el modelo sometido a prueba se evalúe a sí mismo.
Ejecuta un piloto financiado
Ejecuta 5 casos × 1 repetición × 1 variante de la aplicación, es decir, 5 ejecuciones de la aplicación. El flujo publicado exige un sí claro antes de la primera pasada de pago. Si no hay presupuesto aprobado, detente aquí con una configuración en seco que pueda ejecutarse, en vez de afirmar que conoces el precio.
Inspecciona la fila, no el titular de la consola
Abre
results.jsonly una traza. Confirma que las filas correctas incluyan valores no vacíos enmodelyusage, que el punto de entrada expongastop_reasony que el uso de la aplicación se distinga del uso del juez. Los campos de escritura y lectura de caché deben conservarse, no integrarse en la entrada. Un cero donde no debería haberlo es un error del ejecutor, no una llamada gratuita.Calcula el precio y aprueba la escala completa
Calcula las cinco filas con las tarifas reales del proveedor, informa el mínimo, la mediana y el máximo por caso, y luego multiplica por las cantidades aprobadas de casos y repeticiones. Añade el tipo de evaluador elegido, los reintentos y el límite de hillclimb. Presenta esa fórmula antes de solicitar la aprobación de la ejecución completa.
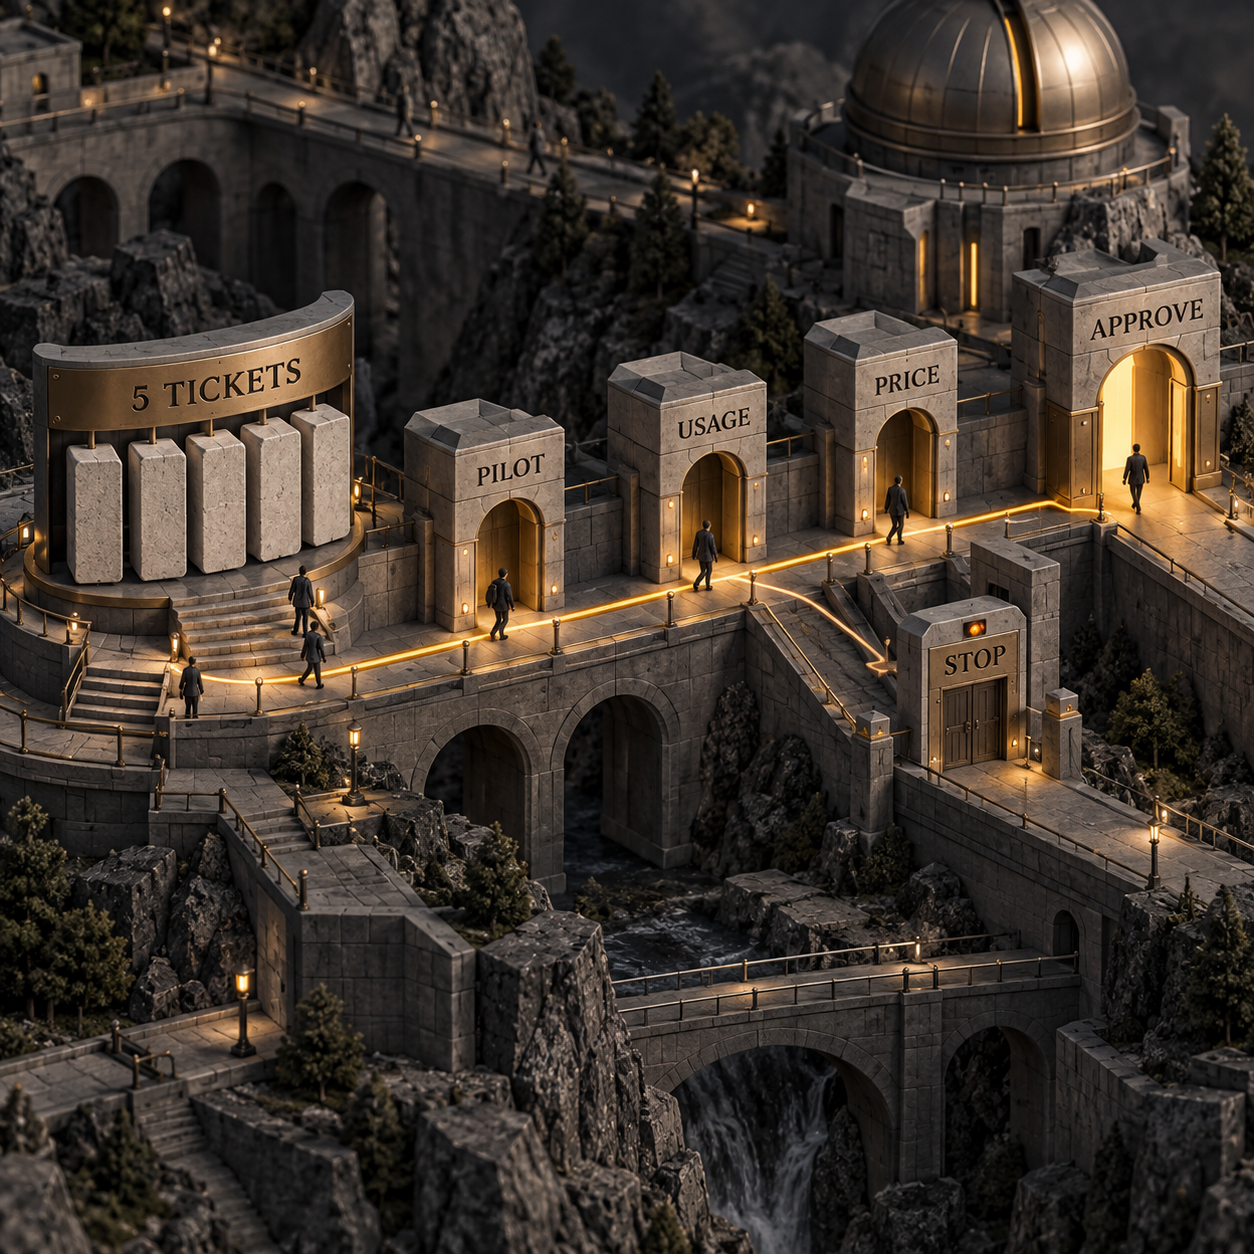
Este orden sigue la implementación publicada: medir un piloto financiado, inspeccionar su uso y solo entonces estimar la suite. Los promedios históricos no sirven como sustituto porque el estado de la caché, los ciclos de herramientas, el esfuerzo, los reintentos y la longitud de salida pertenecen a esta aplicación, no a una aplicación promedio.
Qué implica para equipos de desarrollo, operaciones y compras
Los equipos de desarrollo deben hacer visible el costo en el límite de la aplicación. Si el punto de entrada oculta model, usage o stop_reason, añade esos campos a su evento final antes de escribir el ejecutor completo. Conserva los campos de caché nativos del proveedor y adjunta por separado el uso del juez. El obstáculo habitual es un informe impecable respaldado por filas incompletas: una vez que termina la ejecución completa, a menudo ya no es posible reconstruir los grupos de tokens que faltan.
Operaciones debe controlar la multiplicación y la aprobación. Reúne en una sola página los casos, repeticiones, variantes, llamadas al evaluador, política de reintentos y máximo de rondas de hillclimb. Un presupuesto que solo dice “24 casos” está incompleto. Uno que incluye 144 ejecuciones de la aplicación, el tipo de evaluador, el uso medido por caso y un límite de parada sí se puede revisar.
Compras debe preguntar qué capas cubre un precio cotizado. ¿Incluye la orquestación de Claude Code, el modelo de la aplicación, el juez, el margen del proveedor de nube, los cargos de herramientas, los reintentos y las rondas de optimización? Un proveedor puede cotizar de buena fe un juez barato y excluir las ejecuciones de la aplicación que dominan el gasto. Hay que exigir las filas del piloto y la fórmula, no solo un total.
Quién debe actuar ahora, esperar o seguir con la vía de plugins
Conviene actuar ahora si la aplicación tiene un único punto de entrada estable, existe una decisión concreta que tomar y hay cinco casos representativos que se pueden revisar con seguridad. Una migración de prompt, un cambio de modelo, una revisión de la política de enrutamiento o un cambio de herramienta son buenos objetivos porque la evaluación puede comparar un antes y un después concretos.
Conviene esperar si el ejecutor no puede llamar a la lógica de producción con seguridad. Primero hay que aislar las escrituras en bases de datos, los mensajes salientes, las herramientas destructivas y el estado externo mutable. También hay que esperar si nadie puede aprobar las entradas o el evaluador. Aumentar las ejecuciones no salvará una evaluación que mide la tarea equivocada.
Es mejor seguir por la vía nativa de plugins si la pregunta es si un plugin de Claude Code aporta valor. Ese flujo compara por diseño sesiones WITH-plugin y W/OUT-plugin. La guía del sitio para probar plugins de Claude Code con evaluaciones explica ese control específico. El build-eval de aplicaciones evalúa el punto de entrada de la aplicación; no pretende sustituir el control de plugins por un benchmark genérico.
Nada cambia si ya existe un ejecutor y un evaluador de confianza. Reutilízalos. La implementación pública prefiere explícitamente adaptar las piezas existentes a reemplazarlas con un framework nuevo. La aportación útil puede ser la disciplina de aprobación, la captura del uso o el ciclo de hillclimb, no una nueva pila de pruebas.
Lo que se exagera
El flujo reduce la fricción de preparación; no vuelve la evaluación automática, objetiva ni gratuita. Claude puede proponer casos, pero una persona todavía debe decidir si representan la producción. Puede proponer un evaluador, pero una persona aún debe comprobar que un oráculo lo supera, que una respuesta nula falla y que un juez de modelo no premie el estilo por encima de la corrección.
El hillclimbing tampoco es un optimizador gratuito. Su funcionamiento consiste precisamente en ejecutar más variantes, leer los fallos, proponer parches y volver a evaluar. La división con un conjunto reservado protege contra un tipo de sobreajuste, pero no elimina la necesidad de contar con suficientes casos, suficientes repeticiones ni un límite de gasto.
El informe solo es evidencia si sus filas están completas. Un report.html atractivo junto a campos usage vacíos no puede responder la pregunta sobre el costo. Tampoco mejora la situación un total en dólares derivado de cantidades de tokens supuestas. Antes de un piloto financiado, el entregable defendible es un plan de ejecución y la tabla de tarifas actual, con el total medido todavía en blanco.
La acción del lunes
Asigna a una persona un piloto acotado, no la instrucción indefinida de “crear evaluaciones”. El lunes, elige el punto de entrada existente del enrutador de soporte, redacta los cinco tickets sintéticos anteriores y utiliza un evaluador programático de etiquetas fijas. Revisa las entradas y las rutas esperadas con quien sea responsable de la política de soporte.
Después solicita aprobación para ejecutar exactamente 5 ejecuciones de la aplicación. Inspecciona results.jsonl, una traza, cada grupo de uso y stop_reason. Calcula esas filas con la tarifa real del proveedor. Solo entonces conviene proponer el diseño de 24 casos, 3 repeticiones y 2 variantes, junto con los límites del juez, los reintentos y el hillclimb.
La regla de decisión es tajante: sin un uso completo del piloto, no se aprueba el presupuesto de la ejecución completa.
- Última actualización
- 29 sept 2026
- Categoría
- Build
Prefiera este sitio en Google


Marque omidsaffari.com como fuente preferida y Google lo destacará para usted en Top Stories, AI Overviews y AI Mode.

Checkout Shopify con WebMCP: guía de implementación segura
Guía práctica del checkout Shopify con WebMCP: cómo leer y actualizar el pedido, gestionar Shop Pay y exigir aprobación antes de completar la compra.29 sept 2026Build
Cloudflare API desde la terminal: guía práctica de cf CLI
Instala cf CLI, autentícate, encuentra comandos de Cloudflare API y prueba un Worker con salida JSON, sin perder la compatibilidad con Wrangler.29 sept 2026Build
Krisp bajo la lupa: ¿vale la pena para llamadas de trabajo?
Análisis de Krisp para llamadas de trabajo: cancelación de ruido, rutas de audio, precios y controles de privacidad que conviene revisar antes de pagar.29 sept 2026Build
Precio de SaneBox: planes, costes y cuál conviene
Consulta el precio de SaneBox, compara Snack, Lunch y Dinner, calcula el ahorro anual y decide qué plan encaja antes de pagar por adelantado.29 sept 2026Build
Precio de Marblism en 2026: planes, horas y límites
Calcula el precio de Marblism según las tareas, las horas compartidas y la facturación, y descubre qué se detiene cuando se agota el saldo mensual.28 sept 2026Build
Fyxer AI: precios, planes y cuándo vale la pena
Precios de Fyxer AI: compara Starter y Professional, calcula el costo real por usuario y descubre cuánto tiempo debe ahorrar para que la inversión compense.28 sept 2026Build
Cloudflare Workers Free: qué cuestan realmente los Previews
Cloudflare Worker Previews incluye 100 vistas previas gratis por Worker. Analizamos sus límites, ejecución, builds, almacenamiento, IA y Containers.28 sept 2026Build