Claude API وbuild-eval: ما المجاني وأين تبدأ التكلفة؟
دليل عملي يوضح أين تنشأ تكلفة build-eval في Claude API، وكيف تتحول 24 حالة إلى 144 تشغيلًا للتطبيق، ولماذا ينبغي تسعير تجربة ممولة صغيرة قبل التقييم الكامل.




لا. سير عمل build-eval في Claude API متاح للعامة، لكن التقييم الذي ينسّقه ليس مجانيًا تلقائيًا. إذا كان سؤالك «هل تقييم build-eval في Claude API مجاني؟»، فافصل بين التعليمات المجانية والعمل المدفوع: 24 حالة × 3 تكرارات × 2 من خيارات النموذج تعني 144 عملية تشغيل للتطبيق قبل أي استدعاءات اختيارية للمحكّم أو إعادة المحاولة. لم تتوفر تجربة تطبيق ممولة لهذا التحقق، لذا فإن 144 ناتجة عن عملية حسابية وليست إجماليًا دولاريًا مقاسًا.
هل تقييم build-eval في Claude API مجاني؟
يمكن قراءة ملفات سير العمل مجانًا، لكن تنفيذ التقييم قد يستهلك استخدامًا مدفوعًا للنموذج في ثلاثة مواضع مختلفة. قد يُخصم استخدام Claude Code من حصة اشتراك أو يُحاسب عبر حساب حسب الاستهلاك، كما يستدعي التطبيق الخاضع للاختبار مزوّد النموذج الخاص به، ويضيف محكّم اختياري يعمل بنموذج مجموعة أخرى من الاستدعاءات. يجنّبك المصحح المحلي الحتمي فاتورة الموضع الثالث، لكنه لا يلغي استدعاءات التطبيق.
هذا التفريق مهم لأن build-eval ليس رصيدًا مجانيًا لتشغيل التقييمات. إنه سير عمل موجّه داخل Claude Code لبناء تقييم حول التطبيق الموجود لديك بالفعل. يساعدك على تحديد نقطة الدخول، وتجميع الحالات، واختيار المصحح، وكتابة مشغّل أو تكييفه، ثم إنتاج نتائج قابلة للمراجعة. يتوفر التنفيذ العام في مستودع مهارات Anthropic، لكن الاستدعاءات التي ينفذها المشغّل الناتج تخضع لقواعد فوترة الحساب والمزوّد اللذين يستخدمهما.
لذلك تعتمد الإجابة الآمنة على طريقة التشغيل: قد يكون تصميم التقييم مجانيًا، أما تنفيذه فلا يكون مجانيًا إلا إذا لم تقع أي استدعاءات مدفوعة أو بقي الاستخدام كله ضمن حصة تدفع مقابلها أصلًا. وحتى عندئذ، تصف كلمة «مجاني» الزيادة الهامشية في الفاتورة، لا سعة غير محدودة.
ما الذي تغير في 28 و29 سبتمبر؟
حوّلت Anthropic بناء التقييم والتحسين التكراري إلى مساري عمل واضحين داخل Claude Code. قدّم دليل 28 سبتمبر 2026 الأمر /claude-api build-eval لإنشاء تقييم، والأمر /claude-api hillclimb لتحسين تطبيق بالاستناد إليه. ثم نُشر التنفيذ علنًا في 29 سبتمبر عند 02:20:03 UTC ضمن الالتزام 8a1541c4.
يبدأ build-eval من مسار واحد في التطبيق. يقرأ نقطة الدخول الحالية، ويسأل عن مصدر الحالات التمثيلية، ويقترح أرخص مصحح يقيس المخرجات على نحو صحيح، ويشترط موافقة واضحة على كل من المدخلات وطريقة التصحيح. والنتيجة شيفرة وأدلة داخل مستودعك، تشمل مشغّلًا وresults.jsonl وآثار تنفيذ وتقريرًا.
يأتي hillclimb بعد ذلك. فهو يقسم الحالات إلى مجموعة تدريب ومجموعة اختبار محجوبة، ويغيّر سطحًا مسموحًا واحدًا في كل مرة، ثم يعيد تشغيل التقييم ويتراجع عن التغييرات التي تخفّض الأداء أو تحسّن مجموعة التدريب وحدها. يمكن بهذه الطريقة تحسين الـ prompts أو اختيار النموذج أو مستوى الجهد أو الأدوات أو شيفرة تغليف التطبيق، لكن كل خيار تجريبي يعني عمليات تشغيل إضافية.
التغيير الجوهري ليس أن «التقييمات أصبحت مجانية»، بل أن Claude Code يستطيع تركيب سير تقييم منضبط وقابل للتدقيق من دون فرض إطار عمل منفصل. أما نموذج الدفع الذي يقوم عليه هذا السير فلم يختفِ.
تكلفة build-eval في Claude API موزعة على أربع طبقات فوترة
تفصل الميزانية المفيدة بين أربع طبقات، لأن واحدة منها فقط مجانية بوضوح. جمعها كلها تحت بند واحد باسم «تكلفة Claude» يجعل تفسير مصدر الإنفاق مستحيلًا.
- سير العمل العام. الدليل وملفات المهارة متاحة للعامة. لا تترتب رسوم رموز Claude API بمجرد قراءتها أو مراجعة الملفات المحلية الناتجة أو تشغيل فحص حتمي محلي.
- التنسيق عبر Claude Code. يقرأ Claude Code المستودع، ويطرح الأسئلة، ويكتب المشغّل، ويساعد على فحص النتائج. يستهلك المشتركون من حصة الخطة، بينما تستهلك الجلسات الموثقة عبر API رموزًا محسوبة حسب الاستخدام. يرى مستخدمو API تقديرًا لتكلفة الجلسة، في حين يرى المشتركون استخدام الخطة، كما توضح وثائق تكلفة Claude Code لدى Anthropic. وترد تفاصيل الخطط والمصادقة الحالية في دليل أسعار Claude Code على الموقع.
- التطبيق الخاضع للاختبار. ينبغي للمشغّل استدعاء نقطة دخول التطبيق الحالية بدل إعادة بناء طلب مبسط إلى النموذج. لذلك تستهلك كل تذكرة دعم وإعادة محاولة وحلقة أدوات وتكرار موارد المزوّد والحساب اللذين يستخدمهما التطبيق أصلًا.
- المصحح. يمكن تشغيل تسمية ثابتة أو فحص مخطط أو اختبار وحدة أو تأكيد للحالة النهائية محليًا. أما الإجابات المفتوحة فقد تحتاج إلى محكّم يعمل بنموذج، سواء للتقييم النقطي أو المقارنة الثنائية، وهذا يضيف مدخلات ومخرجات وذاكرة مخبأة وربما استخدام أدوات خاصًا به.
أول فرصة لتقليل التكلفة ليست اختيار محكّم أرخص، بل استخدام مصحح برمجي كلما كانت للمخرجات بنية صحيحة ومقيدة. فإذا كان موجّه الدعم ملزمًا بإرجاع طابور واحد من قائمة ثابتة، تستطيع الشيفرة التحقق من ذلك. أما سؤال نموذج آخر عمّا إذا كانت billing تساوي billing فينفق المال للإجابة عن مسألة حتمية.
استخدم محكّمًا يعمل بنموذج عندما تتطلب الخاصية حكمًا حقيقيًا، مثل التحقق من أن ملخص التصعيد يحافظ على إحساس العميل بالإلحاح من دون اختلاق حقائق. وحتى عندئذ، ضع استخدام التطبيق واستخدام المحكّم في حقول منفصلة. فقد يخفي محكّم رخيص تشغيلًا مكلفًا للتطبيق، أو يحدث العكس.
بالأرقام: 24 حالة تتحول إلى 144 عملية تشغيل للتطبيق
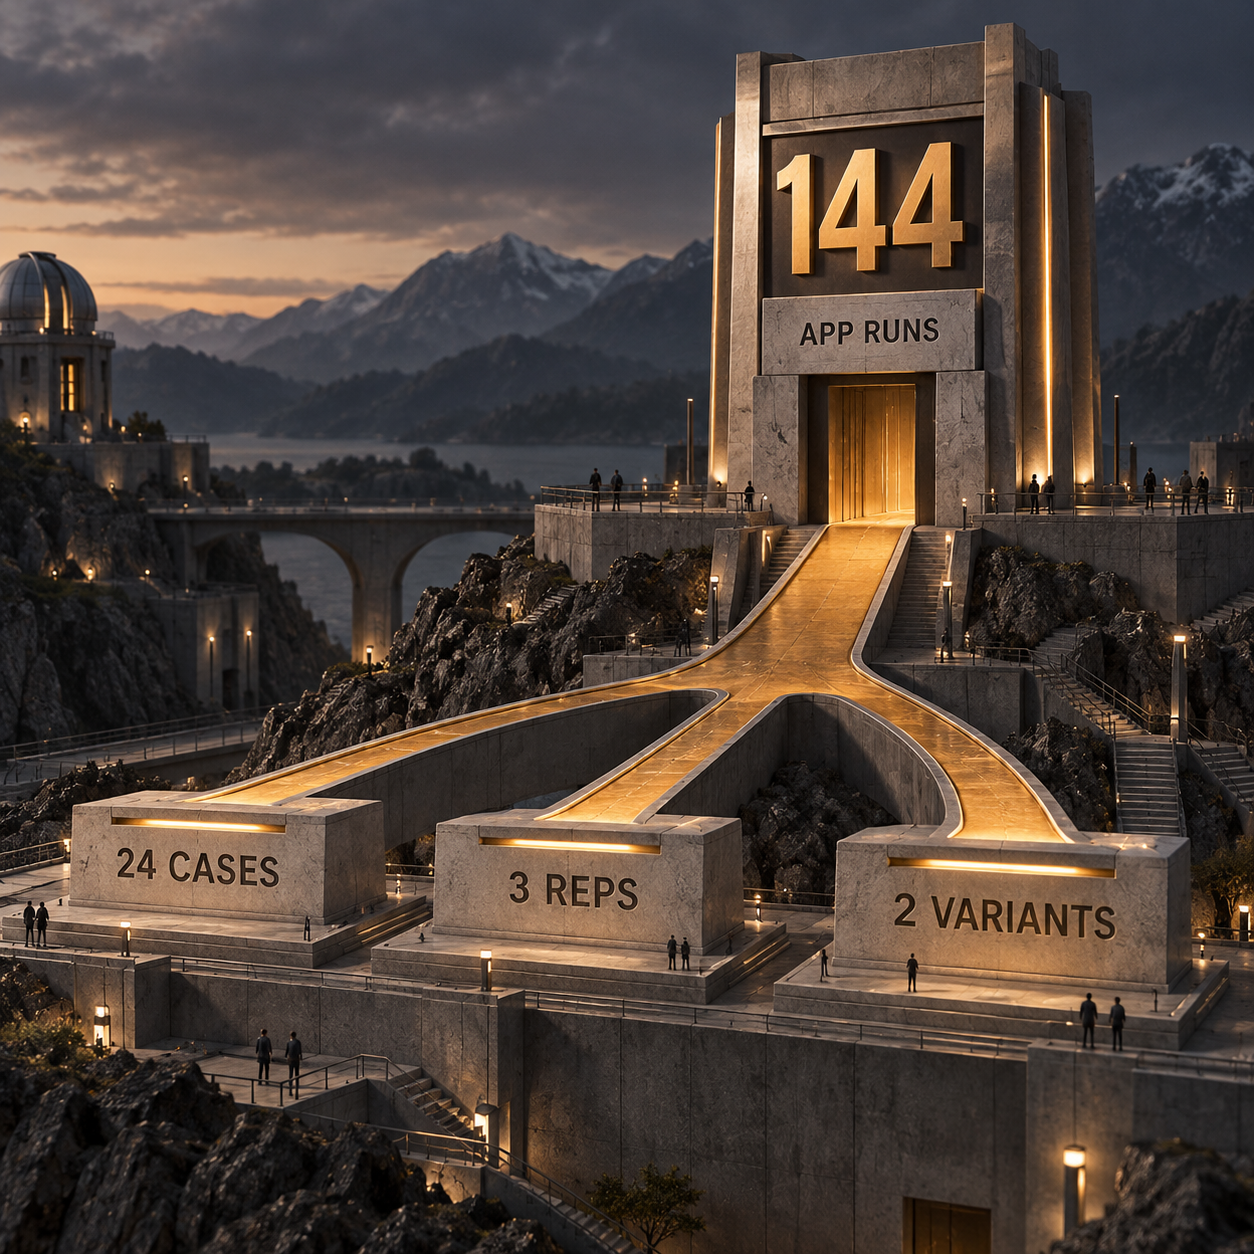
عدد الحالات ليس سوى المضاعِف الأول. يعرض دليل إطلاق Anthropic مثالًا لتوجيه البريد الوارد يضم 24 مدخلًا. وإذا قارنت 2 من خيارات النموذج وكررت كل حالة 3 مرات، يصبح عدد مرات تشغيل التطبيق:
24 حالة × 3 تكرارات × 2 من الخيارات = 144 عملية تشغيل للتطبيق
هذا هو الحد الأدنى لعمليات التشغيل في هذا التصميم، قبل أن يصحح أي نموذج النتائج وقبل إعادة محاولة أي طلب فاشل. التكرارات مهمة لأن النموذج قد ينتج إجابات مختلفة للمدخل نفسه. والخيارات مهمة لأن المقارنة تحتاج إلى مخرجات من الإعدادين.
ويغيّر نوع المصحح المضاعِف التالي:
- مصحح برمجي: 0 استدعاءات لمحكّم يعمل بنموذج. يبقى التشغيل عند 144 عملية للتطبيق.
- محكّم للمقارنة الثنائية: 72 استدعاءً للمحكّم إذا كان كل استدعاء يقارن الخيارين لكل حالة وتكرار، لأن 24 × 3 = 72 زوجًا.
- محكّم نقطي: 144 استدعاءً للمحكّم إذا جرى تصحيح كل مخرج من التطبيق على حدة. بذلك يصبح الإجمالي 288 استدعاءً للنموذج، منها 144 للتطبيق و144 للمحكّم، قبل عمليات إعادة المحاولة أو استخدام Claude Code في التنسيق.
يضيف hillclimbing بُعدًا آخر، لأن كل جولة تشغّل مرشحًا جديدًا. وقد تستهلك حلقة تجرب عدة تعديلات عدة تمريرات كاملة من التقييم حتى لو تراجعت عن كل تعديل خاسر. ضع حدًا للجولات وحدًا للإنفاق قبل بدء التحسين. عبارة «توقف عندما تتحسن النتيجة» ليست ميزانية، لأن النتائج المتذبذبة قد تبقي الحلقة في حالة بحث.
تسعير تقييم Claude API يبدأ من الاستخدام المقاس
لا يوجد سعر ثابت للحالة الواحدة، لذا يبدأ أي تقدير يمكن الدفاع عنه من حقول الاستخدام الفعلية في تجربة مدفوعة. قد تكون إحدى التذاكر مجرد استدعاء تصنيف قصير، بينما قد تتطلب أخرى سياقًا طويلًا وأدوات متعددة وعمليات إعادة محاولة ومحكّمًا. تسعير كلتيهما على أنهما «حالة تقييم واحدة» يخفي الفارق الذي يصنع الفاتورة.
جرى التحقق من بطاقة أسعار API المباشر لدى Anthropic في 29 سبتمبر 2026. الأسعار التالية لكل مليون رمز:
المصدر: صفحة أسعار Claude API المباشرة لدى Anthropic. استخدم بطاقة أسعار المزوّد نفسه عند العمل عبر Amazon Bedrock أو Google Cloud بدل نسخ أسعار API المباشر هذه.
احسب لكل صف في التجربة:
إدخال التطبيق الجديد + إخراج التطبيق + كتابات ذاكرة التطبيق المخبأة + قراءات ذاكرة التطبيق المخبأة + إدخال المحكّم الجديد + إخراج المحكّم + كتابات ذاكرة المحكّم المخبأة + قراءات ذاكرة المحكّم المخبأة + أدوات الخادم المدفوعة
اضرب كل فئة من الرموز في سعر النموذج الذي أنتجها. لا تدمج رموز الذاكرة المخبأة مع الإدخال الجديد. تقول القاعدة العامة المختصرة إن كتابة ذاكرة مخبأة لمدة 5 دقائق تكلف 1.25 ضعف سعر الإدخال، وإن القراءة تكلف 0.1 منه، لكن البطاقة الحالية تتضمن استثناءات مهمة للقراءة: يبلغ معامل Fable 5.1 مقدار 0.025 من سعر الإدخال، ويبلغ معامل Opus 5.5 مقدار 0.05. استخدام معامل 0.1 منسوخ سيضخم تقدير كليهما.
ينطبق الانضباط نفسه على المحكّم. إذا استخدم التطبيق Sonnet 5.5 واستخدم المحكّم Haiku 4.5، فسعّر استخدام كل منهما وفق بياناته وسعره. وإذا كان التطبيق يعمل بسعر سحابي متعاقد عليه، فاستخدم ذلك العقد. وإذا كانت أداة على الخادم تُحاسب لكل عملية، فأضفها على حدة. أما أدوات جانب العميل فتظل توسّع سياق النموذج، وبالتالي فاتورة الرموز.
لا يظهر هنا رقم دولاري مقاس، لأن دورة النشر هذه لم تتضمن نقطة دخول للتطبيق أو حساب مزوّد أو تجربة ممولة ومعتمدة. اختلاق عدد للرموز سينتج رقمًا مرتبًا وميزانية بلا فائدة. جرى التحقق من جدول الأسعار، أما إجمالي التشغيل فيجب أن ينتظر استخدامًا مقاسًا.
Claude Code build-eval: سعّر تجربة من خمس تذاكر أولًا
أصغر خطوة مفيدة هي تشغيل تجربة من خمس تذاكر عبر نقطة الدخول الحالية لموجّه الدعم، ثم فحص الاستخدام صفًا بصف. لا تكفي خمس حالات لإثبات جاهزية الإنتاج، لكنها تكفي للتأكد من سلامة توصيل المشغّل والمصحح والأثر ومحاسبة التكلفة قبل تكرار الخطأ على مجموعة كاملة.
استخدم خمس تذاكر اصطناعية تغطي سلوكيات توجيه مختلفة من دون نسخ بيانات العملاء:
- عميل لا يستطيع فتح بوابة الفوترة.
- تبدو بطاقة ما وكأنها خُصمت مرتين.
- عميل يسأل إن كانت الخطة السنوية قابلة للاسترداد.
- انقطاع في بيئة الإنتاج يحتاج إلى تصعيد عاجل.
- مشترٍ من قطاع المؤسسات يطلب تعديلًا على العقد.
هذه الحالات مجموعة مقترحة للتجربة، وليست اختبارًا أُجري بالفعل. ينبغي أن تدخل إلى الوظيفة أو نقطة النهاية أو البرنامج النصي نفسه الذي يستخدمه موجّه الإنتاج، مع عزل الآثار الخارجية. إذا كان المسار الفعلي قادرًا على إرسال بريد إلكتروني أو تعديل قاعدة بيانات أو تنبيه مهندس، فاستبدل ذلك الأثر وحده بأداة اختبار. حافظ على تجميع الـ prompt واستدعاء النموذج والأدوات وإعادة المحاولة وتحليل الاستجابة بما يكافئ الإنتاج، وإلا فستسعّر التجربة نظامًا آخر.
ثبّت نقطة الدخول وهوية الفوترة
سجّل وظيفة التطبيق أو نقطة نهايته، والنموذج، والمزوّد، والحساب، والـ prompt، والأدوات، وشكل المخرجات. وسجّل أيضًا طريقة مصادقة Claude Code نفسه. هكذا تفصل حصة الخطة عن استخدام API الخاص بالتطبيق قبل أن يبدأ أي منهما.
اعتمد المدخلات الخمسة والمصحح
راجع كل تذكرة اصطناعية واعتمد المسار المتوقع لها. استخدم مصححًا برمجيًا عندما تكون النتيجة تسمية ثابتة لطابور. لا تضف محكّمًا يعمل بنموذج إلا لخاصية لا تستطيع الشيفرة التحقق منها، ولا تسمح أبدًا للنموذج الخاضع للاختبار بأن يحكم على نفسه.
شغّل تجربة ممولة واحدة
شغّل 5 حالات × 1 تكرار × 1 خيار للتطبيق، أي 5 عمليات تشغيل للتطبيق. يشترط سير العمل المنشور موافقة واضحة قبل أول تمريرة مدفوعة. وإذا لم توجد ميزانية معتمدة، فتوقف هنا عند إعداد جاف قابل للتشغيل بدل الادعاء بمعرفة السعر.
افحص الصف لا الرقم البارز في الطرفية
افتح
results.jsonlوأحد آثار التنفيذ. تأكد من أن الصفوف الناجحة تحمل قيمًا غير فارغة فيmodelوusage، وأن نقطة الدخول تكشفstop_reason، وأن استخدام التطبيق واستخدام المحكّم قابلان للتمييز. يجب الحفاظ على حقول كتابة الذاكرة المخبأة وقراءتها بدل دمجها مع الإدخال. الصفر الذي لا ينبغي أن يكون صفرًا خلل في المشغّل، لا استدعاء مجانيًا.سعّر الشكل الكامل واعتمده
احسب الصفوف الخمسة وفق أسعار المزوّد الفعلية، واعرض الحد الأدنى والوسيط والحد الأقصى لكل حالة، ثم اضرب في عدد الحالات والتكرارات المعتمد. أضف شكل المصحح المختار، وعمليات إعادة المحاولة، وسقف hillclimb. اعرض هذه الصيغة قبل طلب الموافقة على التشغيل الكامل.
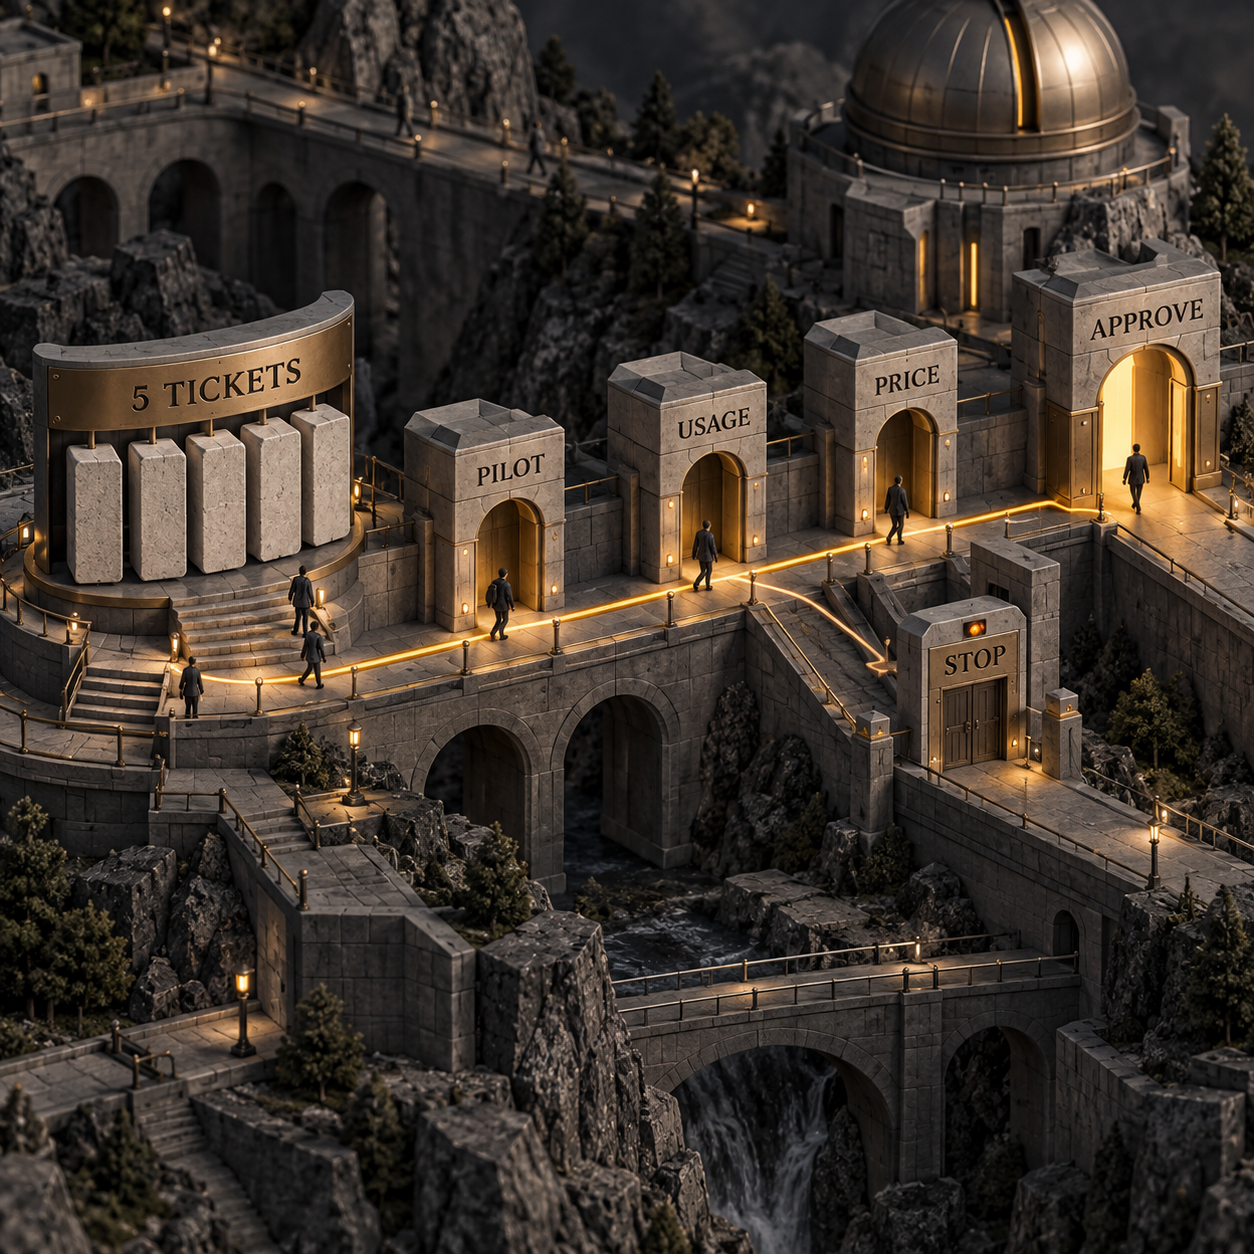
يتبع هذا الترتيب التنفيذ المنشور: قِس تجربة ممولة واحدة، وافحص استخدامها، ثم قدّر المجموعة. المتوسطات التاريخية ليست بديلًا، لأن حالة الذاكرة المخبأة وحلقات الأدوات ومستوى الجهد وإعادة المحاولة وطول المخرجات تخص هذا التطبيق، لا تطبيقًا متوسطًا.
ماذا يعني ذلك للمطورين والمشغّلين والمشترين؟
على المطورين جعل التكلفة قابلة للرصد عند حدود التطبيق. إذا كانت نقطة الدخول تخفي model أو usage أو stop_reason، فأضف هذه الحقول إلى حدثها النهائي قبل كتابة المشغّل الكامل. احتفظ بحقول الذاكرة المخبأة الأصلية لدى المزوّد، وأرفق استخدام المحكّم بصورة منفصلة. العقبة المتكررة لدى الفرق هي تقرير مصقول يستند إلى صفوف ناقصة؛ وبعد انتهاء التشغيل الكامل، غالبًا ما يستحيل إعادة بناء فئات الرموز المفقودة.
على المشغّلين امتلاك عملية الضرب وبوابة الموافقة. اطلب وضع الحالات والتكرارات والخيارات واستدعاءات المصحح وسياسة إعادة المحاولة والحد الأقصى لجولات hillclimb في صفحة واحدة. الميزانية التي لا تقول سوى «24 حالة» ناقصة. أما ميزانية تتضمن 144 عملية تشغيل للتطبيق، وشكل المصحح، والاستخدام المقاس لكل حالة، وسقفًا للتوقف، فيمكن مراجعتها.
على المشترين السؤال عمّا تشمله أي تكلفة معروضة. هل تشمل تنسيق Claude Code، ونموذج التطبيق، والمحكّم، وهامش المزوّد السحابي، ورسوم الأدوات، وعمليات إعادة المحاولة، وجولات التحسين؟ يمكن للمورّد أن يعرض بصدق سعر محكّم رخيص مع استثناء عمليات التطبيق التي تستحوذ على معظم الإنفاق. اطلب صفوف التجربة والصيغة الحسابية، لا الإجمالي وحده.
من ينبغي أن يبدأ الآن، ومن ينتظر، ومن يبقى في مسار الـ plugin؟
ابدأ الآن إذا كان للتطبيق نقطة دخول واحدة مستقرة، ولديك قرار تريد اتخاذه، وخمس حالات تمثيلية تستطيع مراجعتها بأمان. يناسب ذلك ترحيل prompt أو تغيير النموذج أو مراجعة سياسة التوجيه أو تغيير الأدوات، لأن التقييم يستطيع مقارنة وضع واضح قبل التغيير وبعده.
انتظر إذا لم يستطع المشغّل استدعاء منطق الإنتاج بأمان. اعزل أولًا عمليات الكتابة في قاعدة البيانات والرسائل الصادرة والأدوات المدمرة والحالة الخارجية القابلة للتغيير. وانتظر أيضًا إذا لم يوجد من يعتمد المدخلات أو المصحح. المزيد من عمليات التشغيل لن ينقذ تقييمًا يقيس المهمة الخطأ.
ابقَ مع مسار الـ plugin الأصلي إذا كان السؤال هو مدى القيمة التي يضيفها plugin إلى Claude Code. فهذا المسار يقارن، بحكم تصميمه، بين جلسات WITH-plugin وW/OUT-plugin. يشرح دليل الموقع حول اختبار إضافات Claude Code عبر التقييمات آلية الضبط المنفصلة هذه. صُمم build-eval الخاص بالتطبيقات لنقطة دخول التطبيق، لا لاستبدال اختبار ضبط الـ plugin بمعيار عام.
لن يتغير عليك شيء إذا كان لديك مشغّل ومصحح موثوقان بالفعل. أعد استخدامهما. فالتنفيذ العام يفضّل بوضوح تكييف الأجزاء الموجودة على استبدالها بإطار عمل جديد. وقد تكون الإضافة المفيدة هي انضباط الموافقات أو التقاط الاستخدام أو حلقة hillclimb، لا حزمة اختبار جديدة.
أين تكمن المبالغة؟
يقلل سير العمل احتكاك الإعداد، لكنه لا يجعل التقييم تلقائيًا أو موضوعيًا أو مجانيًا. يستطيع Claude اقتراح الحالات، لكن يبقى على شخص ما تحديد ما إذا كانت تمثل الإنتاج. ويستطيع اقتراح المصحح، لكن يبقى على شخص ما التأكد من أن الإجابة المرجعية تنجح، والإجابة الفارغة تفشل، والمحكّم الذي يعمل بنموذج لا يكافئ الأسلوب على حساب الصحة.
كذلك ليس hillclimbing أداة تحسين مجانية. فهو يشغّل عمدًا مزيدًا من الخيارات، ويقرأ حالات الفشل، ويقترح تعديلات، ثم يعيد التقييم. تحمي مجموعة الاختبار المحجوبة من نوع واحد من فرط التوافق، لكنها لا تلغي الحاجة إلى حالات كافية أو تكرارات كافية أو سقف للإنفاق.
ولا يكون التقرير دليلًا إلا عندما تكون صفوفه مكتملة. ملف report.html جميل بجوار حقول usage فارغة لا يستطيع الإجابة عن سؤال التكلفة. ولا يكون الإجمالي الدولاري المستمد من أعداد رموز مفترضة أفضل حالًا. قبل وجود تجربة ممولة، يتمثل الناتج القابل للدفاع عنه في خطة تنفيذ وبطاقة أسعار حالية، مع ترك الإجمالي المقاس فارغًا.
خطوة يوم الاثنين
امنح مالكًا واحدًا تجربة محدودة النطاق، لا توجيهًا مفتوحًا يقول «ابنِ تقييمات». يوم الاثنين، اختر نقطة الدخول الحالية لموجّه الدعم، واكتب التذاكر الاصطناعية الخمس أعلاه، واستخدم مصححًا برمجيًا للتسمية الثابتة. راجع المدخلات والمسارات المتوقعة مع المشغّل المسؤول عن سياسة الدعم.
بعد ذلك، اطلب الموافقة على تشغيل 5 عمليات للتطبيق بالضبط. افحص results.jsonl وأثر تنفيذ واحدًا وكل فئة استخدام وstop_reason. سعّر تلك الصفوف وفق السعر الفعلي للمزوّد. وعندها فقط اقترح شكلًا من 24 حالة و3 تكرارات و2 من الخيارات، مع سقوف المحكّم وإعادة المحاولة وhillclimb.
قاعدة القرار مباشرة: لا توجد بيانات استخدام كاملة من التجربة، فلا توجد موافقة على ميزانية التشغيل الكامل.
- آخر تحديث
- 29 سبتمبر 2026
- التصنيف
- Build
فضّل هذا الموقع في Google


اجعل omidsaffari.com مصدرًا مفضّلًا، وسيرفعه Google لك في Top Stories وAI Overviews وAI Mode.

دليل Shopify checkout عبر WebMCP: من قراءة الطلب إلى إتمامه بأمان
دليل عملي لاستخدام أدوات Shopify WebMCP لقراءة صفحة الدفع وتحديثها، وتسليم تحديات الدفع للمشتري، وإتمام الطلب فقط بعد موافقته الصريحة على الإجمالي.29 سبتمبر 2026Build
Cloudflare CLI: دليل عملي للتثبيت والترحيل الآمن
تعرّف إلى تثبيت Cloudflare CLI وتسجيل الدخول والبحث عن الأوامر بصيغة JSON، مع إنشاء Workers وترحيلها بأمان ومعرفة متى يبقى Wrangler ضرورياً.29 سبتمبر 2026Build
Krisp تحت الاختبار: هل يستحق الاشتراك؟
هل يستحق Krisp الاشتراك؟ مراجعة عربية تفحص أسعار Core وAdvanced، ومسار الصوت والبيانات، وتوضح متى تكفي أدوات إزالة الضوضاء المدمجة في تطبيق الاجتماع.29 سبتمبر 2026Build
SaneBox pricing: دليل الأسعار والخطط قبل الاشتراك
قارن أسعار SaneBox وخطط Snack وLunch وDinner حسب عدد الحسابات والميزات ومدة الفوترة، واعرف التكلفة المدفوعة مقدماً ومتى تستحق الترقية ومتى تتجاوزها.29 سبتمبر 2026Build
أسعار Marblism في 2026: ما الخطة المناسبة لحجم عملك؟
دليل عملي يشرح أسعار Marblism وباقات الساعات ورسوم المهام وحدود الاستخدام، مع أمثلة محسوبة تساعدك على اختيار الخطة المناسبة قبل الاشتراك بثقة.28 سبتمبر 2026Build
أسعار Fyxer: تكلفة الخطط وهل يستحق الاشتراك؟
دليل أسعار Fyxer يشرح تكلفة خطط Starter وProfessional، وفارق الفوترة الشهرية والسنوية، وحدود صناديق البريد، وكيف تقيس العائد قبل أن تدفع للاشتراك.28 سبتمبر 2026Build
تسعير Cloudflare Workers: هل Worker Previews مجانية؟
دليل عملي يشرح تسعير Cloudflare Workers وحدود Worker Previews في الخطة المجانية، وما يبقى خاضعًا لعدادات الطلبات والبناء والتخزين والذكاء الاصطناعي.28 سبتمبر 2026Build