Claude API бесплатно? Как посчитать стоимость build-eval
Разбираем, когда Claude API build-eval обходится бесплатно, где возникают расходы и как оценить 144 запуска по фактическим данным пилотного теста.




Нет: сценарий build-eval для Claude API опубликован в открытом доступе, но запускаемая им оценка не становится бесплатной автоматически. Если ваш запрос — «Claude API бесплатно», важно отделить бесплатные инструкции от оплачиваемых вычислений: 24 кейса × 3 повтора × 2 варианта модели дают 144 запуска приложения еще до необязательных обращений к модели-судье и повторных попыток. Для этой проверки не было профинансированного пилота на реальном приложении, поэтому 144 — результат арифметики, а не измеренная сумма в долларах.
Claude API бесплатно: что на самом деле дает build-eval?
Файлы сценария можно читать бесплатно, однако запущенная оценка способна расходовать оплачиваемые ресурсы сразу в трех местах. Claude Code может использовать лимит подписки или тарифицируемый аккаунт; тестируемое приложение обращается к своему провайдеру модели; необязательная модель-судья создает еще одну серию запросов. Детерминированная локальная проверка избавляет от третьей статьи расходов, но не от вызовов приложения.
Это принципиальное различие: build-eval — не пакет бесплатных кредитов на оценку. Это управляемый сценарий Claude Code, который помогает построить оценку вокруг уже существующего приложения. Он находит точку входа, собирает кейсы, предлагает способ проверки, создает или адаптирует раннер и формирует результаты, пригодные для ревью. Публичная реализация находится в репозитории skills от Anthropic, но запросы созданного раннера оплачиваются по правилам используемых аккаунта и провайдера.
Поэтому корректный ответ всегда зависит от условий: спроектировать оценку можно бесплатно; ее запуск будет бесплатным лишь тогда, когда платных обращений нет либо весь расход укладывается в уже оплаченный лимит. Даже в этом случае «бесплатно» означает отсутствие доплаты в счете, а не неограниченную мощность.
Что изменилось 28 и 29 сентября
Anthropic оформила создание оценок и итеративную оптимизацию как два отдельных сценария Claude Code. В руководстве от 28 сентября 2026 года появился /claude-api build-eval для создания оценки и /claude-api hillclimb для улучшения приложения по ее результатам. Публичная реализация была добавлена 29 сентября в 02:20:03 UTC — в коммите 8a1541c4.
build-eval начинает с одного рабочего потока приложения. Сценарий изучает существующую точку входа, уточняет источник репрезентативных кейсов, предлагает самый дешевый способ корректно проверить результат и требует явно утвердить как входные данные, так и метод оценки. На выходе в репозитории остаются код и проверяемые свидетельства: раннер, results.jsonl, трассировки и отчет.
hillclimb подключается следующим этапом. Он делит кейсы на обучающую и отложенную тестовую выборки, за один шаг меняет только одну разрешенную часть системы, повторно запускает оценку и откатывает изменения, если метрика ухудшилась либо выросла лишь на обучающей выборке. Так можно улучшать промпты, выбор модели, уровень усилий, инструменты или код обвязки приложения, но каждый проверяемый вариант требует новых запусков.
Главное изменение не в том, что «оценки стали бесплатными». Теперь Claude Code может собрать дисциплинированный и проверяемый процесс оценки без отдельного фреймворка. Модель оплаты, на которой работает этот процесс, никуда не исчезла.
Стоимость Claude build-eval: четыре отдельные статьи
В рабочем бюджете нужно разделять четыре статьи, потому что лишь одна из них однозначно бесплатна. Если свести их к одной «стоимости Claude», понять источник расходов будет невозможно.
- Публичный сценарий. Руководство и файлы skill открыты. Само по себе их чтение, ревью созданных локальных файлов и запуск локальной детерминированной проверки не расходуют токены Claude API.
- Оркестрация в Claude Code. Claude Code читает репозиторий, задает вопросы, пишет раннер и помогает разбирать результаты. У подписчиков расходуется лимит тарифа, а сессии с API-аутентификацией оплачивают токены по факту. Пользователю API стоимость сессии показывается как оценочная, тогда как подписчик видит расход лимита своего плана — это объясняет документация Claude Code по расходам. Актуальные планы и способы аутентификации разобраны в руководстве сайта по ценам Claude Code.
- Тестируемое приложение. Раннер должен обращаться к существующей точке входа приложения, а не воссоздавать упрощенный запрос к модели. Поэтому каждый тикет поддержки, повторная попытка, цикл инструментов и повтор расходуют ресурсы того провайдера и аккаунта, которыми уже пользуется приложение.
- Способ проверки. Фиксированную метку, схему, юнит-тест или конечное состояние можно проверить локально. Для открытых ответов может понадобиться поточечная или попарная модель-судья, а значит — дополнительные входные и выходные токены, кэш и, возможно, инструменты.
Первый способ сэкономить — не искать более дешевую модель-судью, а применять программную проверку везде, где правильный ответ имеет ограниченную форму. Если маршрутизатор поддержки обязан выбрать одну очередь из фиксированного списка, результат проверяется кодом. Просить другую модель определить, равно ли billing значению billing, — значит платить за ответ на детерминированный вопрос.
Модель-судья оправдана, когда свойство действительно требует оценки: например, нужно проверить, сохранила ли сводка для эскалации срочность обращения клиента и не добавила ли вымышленных фактов. Но даже тогда расход приложения и судьи следует хранить в разных полях. Дешевый судья может скрывать дорогой запуск приложения — и наоборот.
Расчет: 24 кейса превращаются в 144 запуска приложения
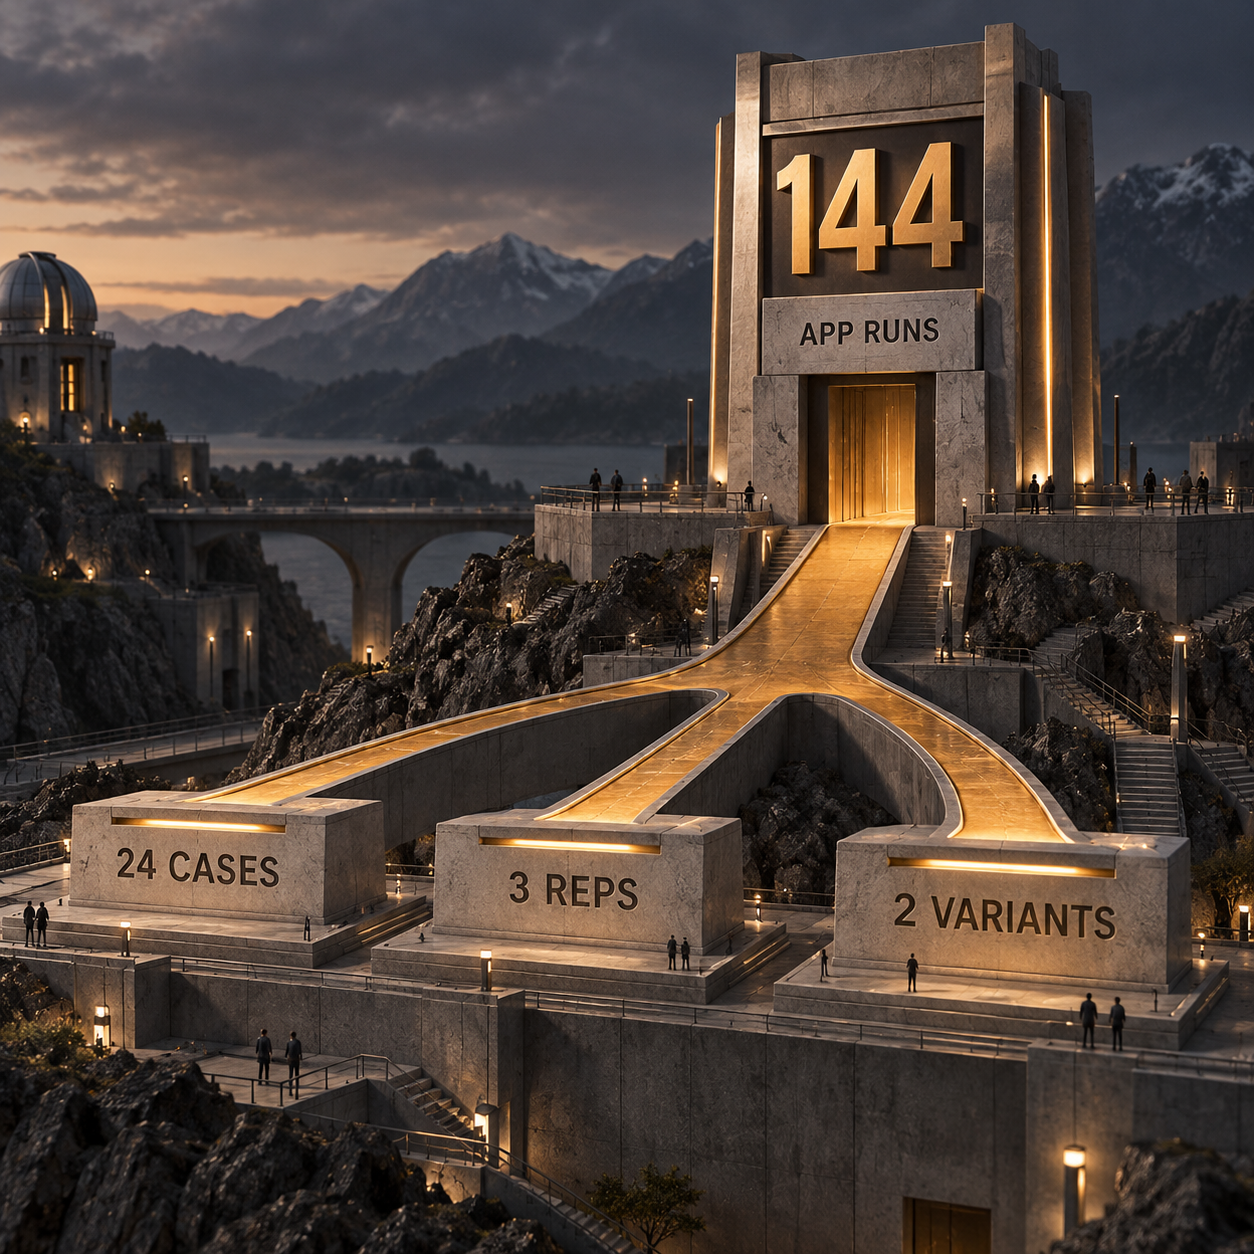
Количество кейсов — только первый множитель. В примере Anthropic с маршрутизацией входящих обращений используются 24 входа. Если сравнить 2 варианта модели и повторить каждый кейс 3 раза, получится:
24 кейса × 3 повтора × 2 варианта = 144 запуска приложения
Это нижняя граница для такой схемы: модель-судья еще ничего не проверяла, а неудачные запросы не запускались повторно. Повторы нужны потому, что модель может отвечать по-разному на один и тот же вход. Варианты нужны потому, что для сравнения требуются результаты обеих конфигураций.
Следующий множитель зависит от способа проверки:
- Программная проверка: 0 обращений к модели-судье. Итого остается 144 запуска приложения.
- Попарная модель-судья: 72 обращения, если один запрос сравнивает два варианта для каждого кейса и повтора, поскольку 24 × 3 = 72 пары.
- Поточечная модель-судья: 144 обращения, если каждый результат приложения оценивается отдельно. Всего получается 288 обращений к моделям: 144 к приложению плюс 144 к судье — без учета повторных попыток и работы Claude Code по оркестрации.
Hillclimbing добавляет еще одно измерение: каждый раунд запускает нового кандидата. Цикл, который перебирает несколько патчей, способен потратить несколько полных проходов оценки, даже если затем откатит все проигравшие изменения. До оптимизации задайте предел числа раундов и расходов. Формулировка «остановиться, когда метрика вырастет» не заменяет бюджет: из-за шума цикл может продолжать поиск.
Цена оценки Claude API начинается с измеренного расхода
У кейса нет фиксированной цены, поэтому обоснованный расчет начинается с фактических полей usage в оплаченном пилоте. Один тикет может потребовать короткого запроса на классификацию. Другой — длинного контекста, нескольких инструментов, повторных попыток и судьи. Если считать и то и другое «одним кейсом оценки», из сметы исчезнет именно та разница, которая определяет счет.
Тарифы прямого API Anthropic были проверены 29 сентября 2026 года. Ниже указаны цены за миллион токенов:
Источник: актуальная страница цен Claude API от Anthropic. Для Amazon Bedrock и Google Cloud используйте тарифы соответствующего провайдера, а не копируйте цены прямого API.
Для каждой строки пилота сложите:
свежий вход приложения + выход приложения + запись приложения в кэш + чтение приложением из кэша + свежий вход судьи + выход судьи + запись судьи в кэш + чтение судьей из кэша + платные серверные инструменты
Каждую категорию токенов умножьте на ставку той модели, которая их произвела. Не объединяйте токены кэша со свежим входом. В упрощенной формуле запись в кэш на 5 минут стоит в 1.25 раза больше входа, а чтение — в 0.1 раза; однако в текущем тарифе есть важные исключения для чтения: у Fable 5.1 множитель равен 0.025 от цены входа, а у Opus 5.5 — 0.05. Если механически применить множитель 0.1, обе суммы окажутся завышены.
Та же логика действует для судьи. Если приложение работает на Sonnet 5.5, а судья — на Haiku 4.5, рассчитывайте каждого по его собственным usage и ставке. Для приложения с контрактным облачным тарифом берите условия контракта. Если серверный инструмент тарифицируется за операцию, добавьте его отдельно. Клиентские инструменты все равно расширяют контекст модели, а значит, увеличивают счет за токены.
Измеренной суммы в долларах здесь нет, потому что в ходе подготовки публикации не было точки входа приложения, аккаунта провайдера или согласованного финансирования пилота. Выдуманное количество токенов дало бы аккуратную цифру, но бесполезный бюджет. Тарифная таблица проверена; итоговую стоимость запуска можно назвать только после измерения usage.
Claude Code build-eval: сначала оцените пилот на пяти тикетах
Самый небольшой осмысленный шаг — пропустить пять тикетов через существующую точку входа маршрутизатора поддержки, а затем проверить usage построчно. Пяти кейсов недостаточно, чтобы подтвердить производственную надежность. Но их хватит, чтобы до масштабирования ошибки на полный набор убедиться в правильной связке раннера, проверки, трассировок и учета затрат.
Используйте пять синтетических тикетов с разными сценариями маршрутизации, не копируя клиентские данные:
- Клиент не может открыть платежный портал.
- Похоже, с карты клиента дважды списали одну сумму.
- Клиент спрашивает, можно ли вернуть деньги за годовой план.
- Сбой в продакшене требует срочной эскалации.
- Корпоративный покупатель просит внести поправку в договор.
Это предлагаемый пилотный набор, а не отчет о проведенном тесте. Кейсы должны поступать в ту же функцию, конечную точку или скрипт, что и производственный маршрутизатор, а внешние побочные эффекты нужно изолировать. Если рабочий поток способен отправить письмо, изменить базу данных или вызвать инженера, замените тестовой фикстурой только этот побочный эффект. Сборка промпта, вызов модели, инструменты, повторные попытки и разбор ответа должны соответствовать продакшену, иначе пилот оценит стоимость другой системы.
Зафиксируйте точку входа и плательщика
Запишите функцию или конечную точку приложения, модель, провайдера, аккаунт, промпт, инструменты и формат результата. Также зафиксируйте, как аутентифицируется сам Claude Code. Так лимит подписки будет отделен от расхода API приложения еще до запуска.
Утвердите пять входов и способ проверки
Проверьте каждый синтетический тикет и согласуйте ожидаемый маршрут. Фиксированную метку очереди проверяйте программно. Добавляйте модель-судью только для свойств, которые нельзя проверить кодом, и не позволяйте тестируемой модели судить саму себя.
Проведите один профинансированный пилот
Запустите 5 кейсов × 1 повтор × 1 вариант приложения, то есть 5 запусков приложения. Опубликованный сценарий требует однозначного согласия перед первым платным проходом. Если бюджет не утвержден, остановитесь на готовой конфигурации без запуска и не заявляйте цену.
Изучите строку, а не итоговую цифру в консоли
Откройте
results.jsonlи одну трассировку. Убедитесь, что в успешных строках поляmodelиusageне пусты, точка входа отдаетstop_reason, а расходы приложения и судьи можно различить. Поля записи в кэш и чтения из него должны сохраняться отдельно, а не объединяться со входом. Ноль там, где его не должно быть, означает ошибку раннера, а не бесплатный вызов.Рассчитайте полную схему и согласуйте ее
Посчитайте пять строк по фактическим тарифам провайдера, покажите минимум, медиану и максимум на кейс, а затем умножьте на согласованное число кейсов и повторов. Добавьте выбранную схему судьи, повторные попытки и предел hillclimb. Сначала представьте эту формулу и только затем запрашивайте согласование полного запуска.
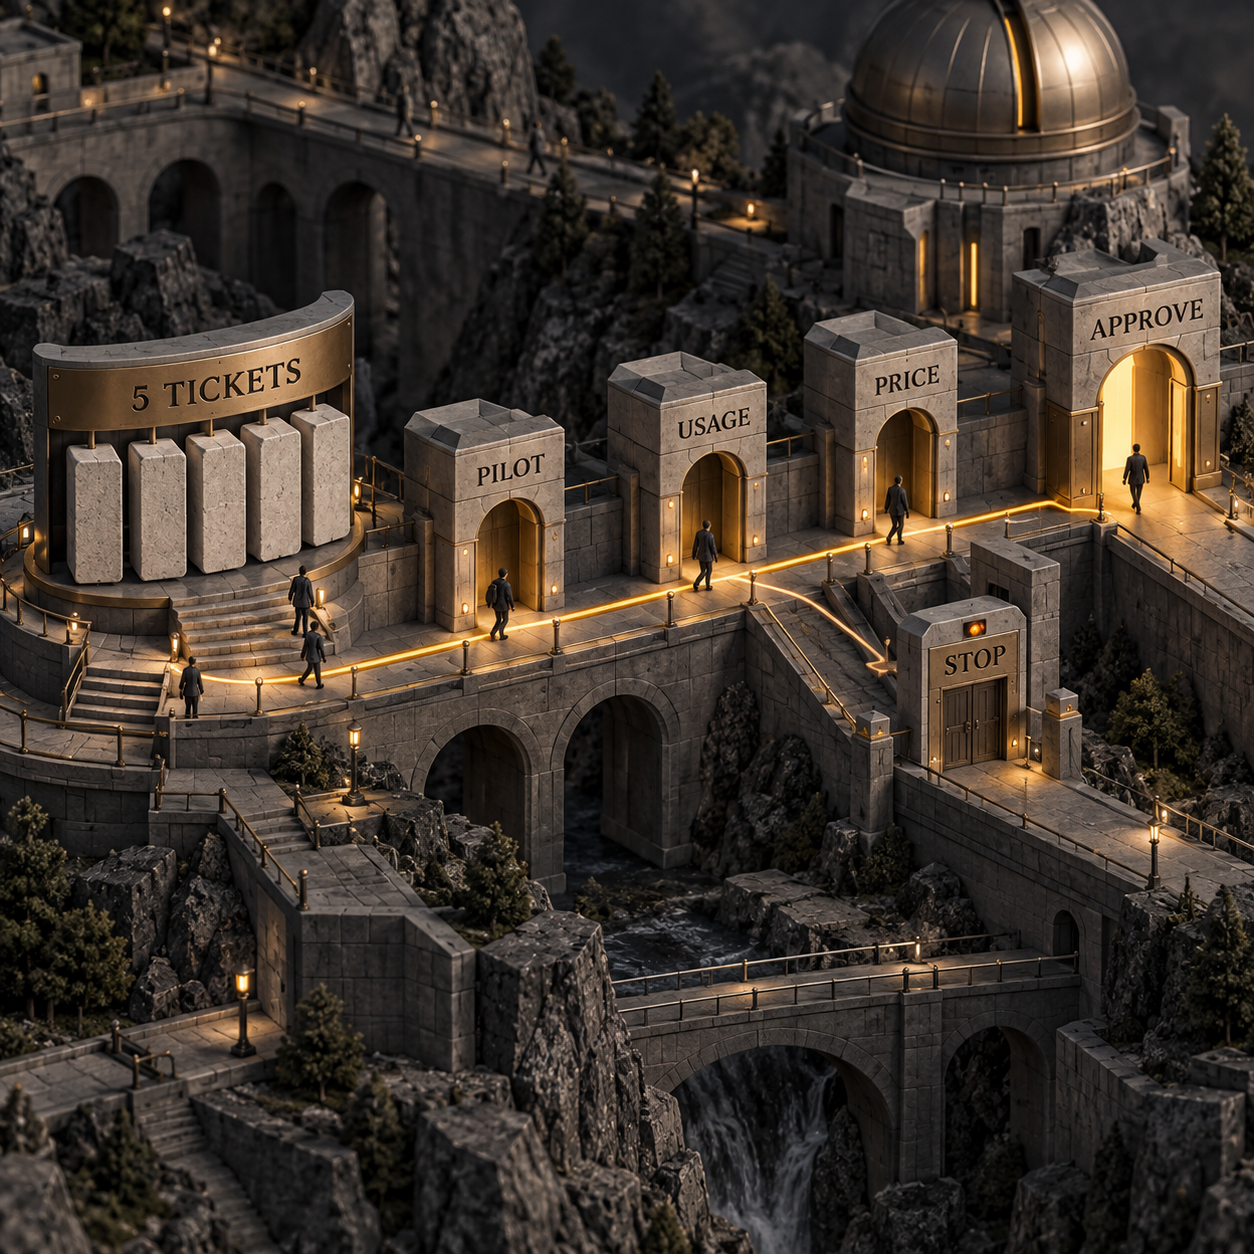
Именно такой порядок заложен в опубликованной реализации: провести один профинансированный пилот, проверить его usage и лишь затем оценивать полный набор. Исторические средние здесь не подходят — состояние кэша, циклы инструментов, уровень усилий, повторы и длина ответа относятся к конкретному приложению, а не к усредненному.
Что это означает для разработчиков, операторов и покупателей
Разработчикам стоит сделать расходы наблюдаемыми на границе приложения. Если точка входа скрывает model, usage или stop_reason, добавьте эти поля в ее финальное событие до создания полного раннера. Сохраняйте нативные поля кэша провайдера, а usage судьи прикрепляйте отдельно. Типичная проблема команд — безупречный отчет, построенный на неполных строках: после завершения полного запуска восстановить пропавшие категории токенов часто уже невозможно.
Оператор должен отвечать за множители и контрольную точку согласования. Сведите на одной странице кейсы, повторы, варианты, обращения к судье, правила повторных попыток и максимальное число раундов hillclimb. Бюджет, где указаны только «24 кейса», неполон. Смету со 144 запусками приложения, схемой судьи, измеренным usage на кейс и жестким пределом уже можно проверить.
Покупателю следует уточнять, какие уровни входят в названную цену. Учтены ли оркестрация Claude Code, модель приложения, судья, наценка облачного провайдера, инструменты, повторные попытки и раунды оптимизации? Поставщик может честно назвать низкую цену судьи, исключив из нее основные расходы на запуски приложения. Требуйте строки пилота и формулу, а не только итог.
Кому действовать сейчас, кому подождать, а кому остаться на плагинах
Начинайте сейчас, если у приложения есть одна стабильная точка входа, перед вами стоит конкретное решение и можно безопасно проверить пять репрезентативных кейсов. Миграция промпта, смена модели, пересмотр правил маршрутизации или инструментов — удачные задачи, потому что оценка сравнит четкие состояния до и после.
Подождите, если раннер пока не способен безопасно вызвать производственную логику. Сначала изолируйте запись в базу данных, исходящие сообщения, разрушительные инструменты и изменяемое внешнее состояние. Стоит подождать и в том случае, если некому утвердить входные данные или способ проверки. Дополнительные запуски не исправят оценку, которая измеряет не ту задачу.
Оставайтесь на нативном сценарии плагинов, если нужно понять, дает ли плагин Claude Code пользу. Этот процесс изначально сравнивает сессии WITH-plugin и W/OUT-plugin. Отдельный контрольный сценарий разобран в руководстве сайта по тестированию плагинов Claude Code с помощью оценок. Приложение build-eval проверяет точку входа приложения, а не заменяет плагин-контроль универсальным бенчмарком.
Если у вас уже есть надежные раннер и способ проверки, менять их не нужно. Используйте их повторно. Публичная реализация прямо отдает приоритет адаптации существующих компонентов, а не замене их новым фреймворком. Ценной добавкой могут оказаться правила согласования, сбор usage или цикл hillclimb, а не новый тестовый стек.
Что в этом переоценено
Сценарий упрощает подготовку, но не делает оценку автоматической, объективной или бесплатной. Claude может предложить кейсы, однако человек все равно решает, отражают ли они продакшен. Он может предложить способ проверки, но человеку придется убедиться, что эталонный ответ проходит, пустой — проваливается, а модель-судья не вознаграждает стиль вместо правильности.
Hillclimbing тоже не является бесплатным оптимизатором. Он намеренно запускает дополнительные варианты, изучает ошибки, предлагает патчи и повторяет оценку. Отложенная выборка защищает от одного вида переобучения, но не отменяет потребность в достаточном количестве кейсов и повторов или в пределе расходов.
Отчет служит доказательством только при полных строках. Красивый report.html рядом с пустыми полями usage не отвечает на вопрос о стоимости. Итог в долларах, выведенный из предполагаемого числа токенов, ничем не лучше. До профинансированного пилота обоснованным результатом остается план запусков и актуальная тарифная таблица, а место измеренной суммы должно оставаться пустым.
Что сделать в понедельник
Назначьте одному ответственному ограниченный пилот, а не расплывчатую задачу «построить оценки». В понедельник выберите существующую точку входа маршрутизатора поддержки, подготовьте пять синтетических тикетов из примера выше и примените программную проверку фиксированной метки. Проверьте входы и ожидаемые маршруты вместе с оператором, который отвечает за правила поддержки.
Затем запросите согласование ровно 5 запусков приложения. Проверьте results.jsonl, одну трассировку, каждую категорию usage и stop_reason. Рассчитайте строки по фактическому тарифу провайдера. Лишь после этого предлагайте схему из 24 кейсов, 3 повторов и 2 вариантов вместе с пределами расходов на судью, повторные попытки и hillclimb.
Правило принятия решения предельно простое: нет полного usage пилота — нет согласования бюджета полного запуска.
- Последнее обновление
- 29 сент. 2026 г.
- Категория
- Build
Сделать этот сайт предпочтительным в Google


Отметьте omidsaffari.com как предпочтительный источник — и Google будет поднимать его для вас в Top Stories, AI Overviews и AI Mode.

Shopify WebMCP: безопасный чекаут для ИИ-агентов
Практическое руководство по Shopify WebMCP: чтение и обновление чекаута, согласие покупателя, Shop Pay, обработка ошибок и безопасное завершение заказа.29 сент. 2026 г.Build
Cloudflare CLI: установка cf, команды и миграция Workers
Разбираем Cloudflare CLI: установку и авторизацию cf, поиск команд, JSON-ответы, создание Workers, миграцию с Wrangler и безопасные сценарии для команд.29 сент. 2026 г.Build
Обзор Krisp: шумоподавление, цены и конфиденциальность
Разбираем Krisp: как работает шумоподавление, чем отличаются Core и Advanced, сколько стоят тарифы и какие данные Meeting Assistant хранит в облаке.29 сент. 2026 г.Build
Тарифы SaneBox: какой план выбрать и сколько платить
Разбираем тарифы SaneBox Snack, Lunch и Dinner: цены за месяц, год и два года, скрытые расходы, ограничения и проверка сервиса перед оплатой.29 сент. 2026 г.Build
Цены Marblism в 2026 году: как выбрать тариф по задачам
Разбираем цены Marblism, тарифные часы и списания за задачи: какой план выбрать, где скрыты расходы и что произойдёт, когда лимит закончится.28 сент. 2026 г.Build
Тарифы Fyxer: цены, окупаемость и выбор плана
Разбираем тарифы Fyxer: цены Starter и Professional, годовую оплату, порог окупаемости и условия, при которых подписка действительно экономит время.28 сент. 2026 г.Build
Cloudflare Workers бесплатно: лимиты Worker Previews
Cloudflare Workers бесплатно: разбираем лимиты Worker Previews, запросов, CPU, сборок, хранилищ, Workers AI и Containers для тарифов Free и Paid.28 сент. 2026 г.Build