Claude Code 料金ガイド:build-evalは無料か、実行コストを検証
Claude Code 料金の内訳を、公開ワークフロー、オーケストレーション、評価対象アプリ、モデルジャッジの4層に分けて解説します。24ケース×3回×2候補で144回になる理由と、実測トークンからClaude API 料金を見積もる5件パイロットの進め方まで具体的に整理しました。




結論から言えば、無料とは限りません。Claude APIのbuild-evalワークフロー自体は公開されていますが、そこで実行する評価まで自動的に無料になるわけではありません。Claude Code 料金を考えるときは、無料で読める手順と課金対象の処理を分ける必要があります。24ケース × 3回の反復 × 2つのモデル候補なら、任意のジャッジやリトライを加える前の段階でアプリケーション実行は144回です。今回の検証では有償のアプリケーションパイロットを実施できなかったため、144は計算上の回数であり、実測した金額ではありません。
Claude Code 料金から見るbuild-evalの無料範囲
ワークフローのファイルは無料で読めますが、評価を実行すると3か所で有料のモデル利用が発生する可能性があります。 Claude Codeは、サブスクリプションなら利用枠を消費し、API認証なら従量課金になります。評価対象のアプリケーションは、設定されたモデルプロバイダーを呼び出します。さらに、任意でモデルジャッジを使えば、その呼び出しも加わります。決定論的なローカル採点なら3つ目の費用は避けられますが、アプリケーションの呼び出しは残ります。
この区別が重要なのは、build-evalが無料の評価クレジットを提供する仕組みではないからです。手元のアプリケーションを対象に評価を組み立てるための、Claude Codeのガイド付きワークフローです。エントリーポイントの特定、ケースの作成、採点方法の選択、ランナーの新規作成や調整、レビュー可能な結果の出力を支援します。公開されている実装はAnthropicのskillsリポジトリで確認できますが、完成したランナーが実行する呼び出しには、利用するアカウントとプロバイダーの課金ルールが適用されます。
したがって、答えには条件が付きます。評価の設計は無料で行える一方、実行が無料になるのは、課金対象の呼び出しがない場合か、すべての利用量が既に支払っている枠内に収まる場合だけです。 その場合でも「無料」が意味するのは追加請求がないということであり、容量が無制限になるわけではありません。
9月28日と29日に何が変わったのか
Anthropicは、評価の構築と反復的な最適化を、2つの明示的なClaude Codeワークフローとして提供しました。 2026年9月28日のガイドでは、評価を作る /claude-api build-eval と、評価に沿ってアプリケーションを改善する /claude-api hillclimb が紹介されました。実装は9月29日02:20:03 UTCにコミット 8a1541c4として公開されています。
build-evalは、アプリケーションの1つの処理フローから始めます。既存のエントリーポイントを読み、代表的なケースの入手元を確認し、出力を正しく測れるうちで最も安価な採点方法を提案します。そして、入力と採点方法の両方について明確な承認を求めます。最終的に、ランナー、results.jsonl、トレース、レポートなど、コードと根拠がリポジトリに残ります。
hillclimbを使うのはその後です。ケースを訓練用とホールドアウトのテスト用に分け、変更を許可した箇所を1つずつ修正して再評価し、性能が下がった変更や、訓練用データだけで改善した変更は元に戻します。プロンプト、モデル選択、effort、ツール、アプリケーションのラッパーコードを改善できますが、候補を試すたびに実行回数は増えます。
本質的な変化は「評価が無料になった」ことではありません。別のフレームワークを必須にせず、Claude Codeで規律と監査可能性を備えた評価フローを組み立てられるようになったことです。その土台にある課金の仕組みは変わっていません。
Claude Code 料金を4つの課金ポイントに分ける
予算を正しく組むには、4つの課金ポイントを分けて考える必要があります。明確に無料なのは、そのうち1つだけです。 すべてをひとまとめにして「Claudeの費用」と呼ぶと、何にいくら使ったのか説明できなくなります。
- 公開ワークフロー。 ガイドとスキルファイルは公開されています。読むこと、生成されたローカルファイルを確認すること、決定論的なチェックをローカルで実行すること自体には、Claude APIのトークン料金は発生しません。
- Claude Codeによるオーケストレーション。 Claude Codeはリポジトリを読み、必要事項を確認し、ランナーを作成して、結果の精査を支援します。サブスクリプション利用者はプランの利用枠を消費し、API認証のセッションはトークンの従量課金になります。AnthropicのClaude Codeコストに関するドキュメントにあるとおり、API利用者に表示されるセッション費用は推定値で、サブスクリプション利用者には代わりにプランの使用量が表示されます。現在のプランと認証方式は、当サイトのClaude Code料金ガイドで確認できます。
- 評価対象のアプリケーション。 ランナーは、単純化したモデルリクエストを作り直すのではなく、既存アプリケーションのエントリーポイントを呼び出すべきです。そのため、サポートチケット、リトライ、ツールのループ、反復のたびに、そのアプリケーションが既に利用しているプロバイダーとアカウントの使用量が増えます。
- 採点処理。 固定ラベル、スキーマ検証、ユニットテスト、最終状態のアサーションならローカルで実行できます。自由形式の回答では、ポイントワイズまたはペアワイズのモデルジャッジが必要になる場合があり、その入力、出力、キャッシュ、場合によってはツール利用も加算されます。
最初に検討すべき節約策は、安いジャッジを選ぶことではありません。正解の形式が限定されているなら、プログラムで採点することです。固定リストからキューを1つ返すサポートルーターなら、コードで判定できます。別のモデルを呼び出してbillingとbillingが一致するかを確かめるのは、決定論的に答えられる問いに費用をかけることになります。
モデルジャッジを使うべきなのは、たとえば、エスカレーション要約が事実を捏造せずに顧客の緊急度を保っているかなど、本当に判断を要する性質を評価するときです。その場合でも、アプリケーションとジャッジの使用量は別のフィールドに記録してください。安いジャッジの陰に高額なアプリケーション実行が隠れることも、その逆もあります。
24ケースが144回のアプリケーション実行になる仕組み
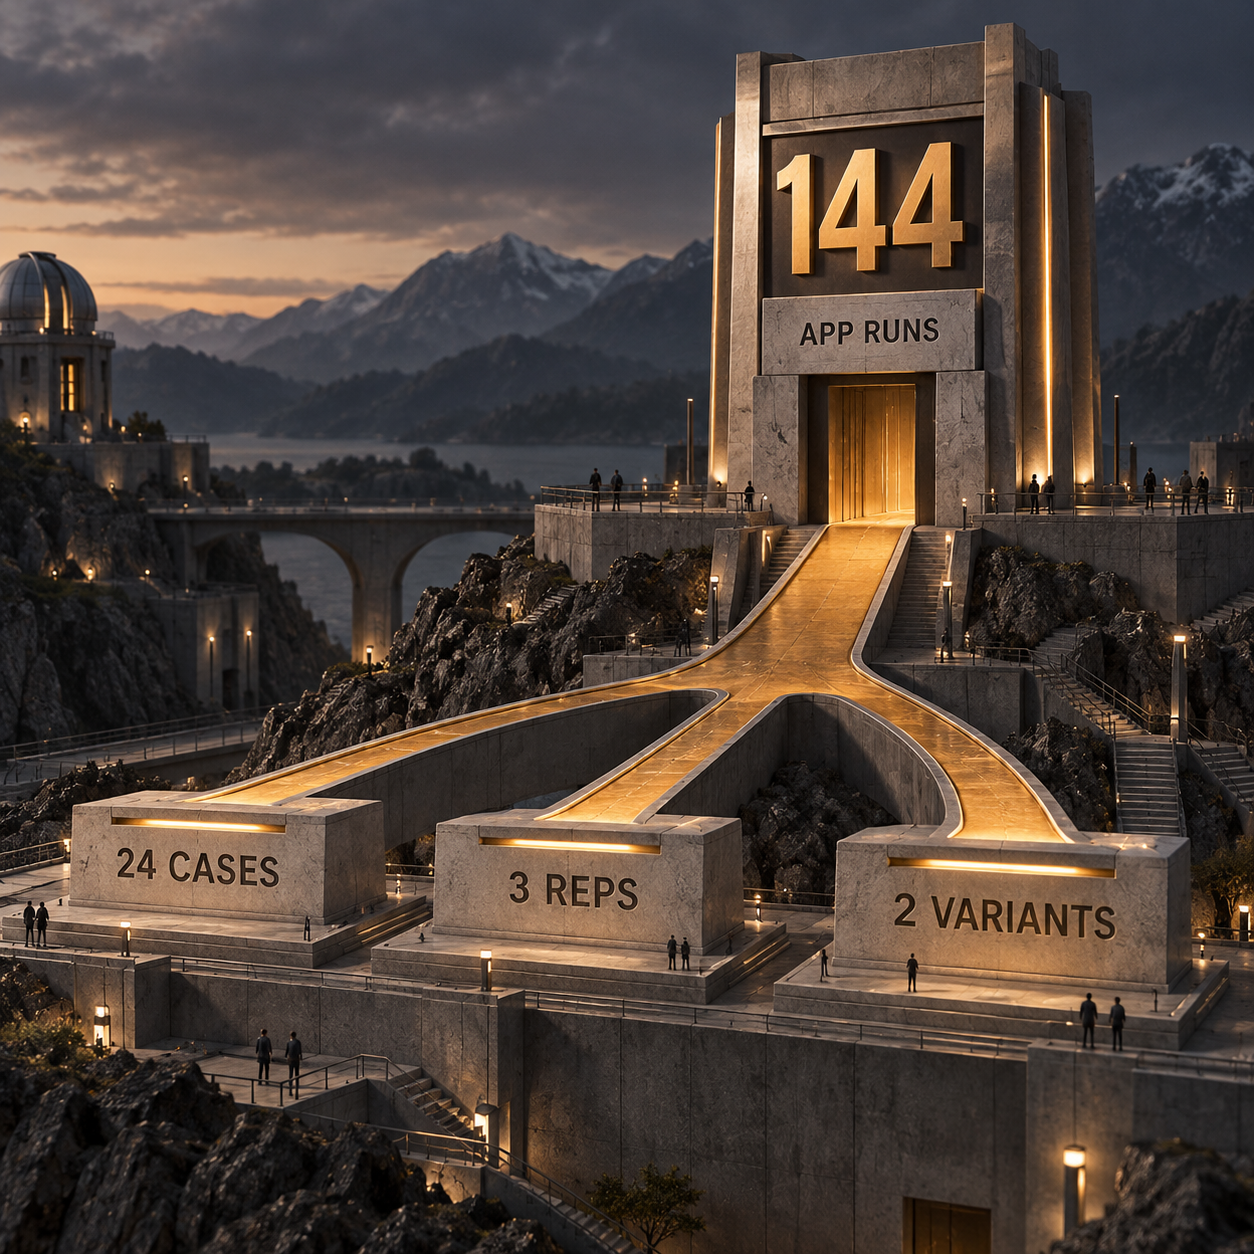
ケース数は、最初の掛け算にすぎません。 Anthropicの発表ガイドには、24件の入力を使う受信トレイ振り分けの例があります。2つのモデル候補を比較し、各ケースを3回ずつ反復すると、アプリケーションの実行回数は次のとおりです。
24ケース × 3回の反復 × 2候補 = 144回のアプリケーション実行
これは、モデルによる採点や失敗したリクエストのリトライを加える前の、最低実行回数です。同じ入力でもモデルの回答が変わり得るため、反復が必要です。また、比較には両方の設定から出力を得る必要があるため、候補の数も掛け合わせます。
次の倍率を決めるのは採点方法です。
- プログラムによる採点: モデルジャッジの呼び出しは0回です。アプリケーション実行は144回のままです。
- ペアワイズジャッジ: ケースと反復の組み合わせごとに1回の呼び出しで2候補を比較するなら、ジャッジは72回です。24 × 3 = 72組だからです。
- ポイントワイズジャッジ: アプリケーションの出力を1件ずつ採点するなら、ジャッジは144回です。リトライやClaude Codeのオーケストレーション利用を除いても、アプリケーション144回とジャッジ144回、合計288回のモデル呼び出しになります。
hillclimbingでは、ラウンドごとに新しい候補を実行するため、掛け算がさらに増えます。複数のパッチを試すループでは、不採用のパッチをすべて元に戻しても、評価一式を何度も実行することになります。最適化を始める前に、ラウンド数と支出の上限を決めてください。「スコアが上がるまで続ける」は予算とは呼べません。スコアにノイズがあれば、探索が延々と続く可能性があるからです。
Claude API 料金は実測した利用量から計算する
1ケース当たりの固定価格はありません。そのため、根拠のある見積もりは、有償パイロットで実測した使用量フィールドから始める必要があります。 あるチケットは短い分類を1回呼ぶだけかもしれません。別のチケットは、長いコンテキスト、複数のツール、リトライ、ジャッジを必要とする場合があります。どちらも「評価ケース1件」として価格を付ければ、請求額を左右する差が見えなくなります。
Anthropicの直接契約APIの料金表は、2026年9月29日に確認しました。以下は100万トークン当たりの料金です。
出典:Anthropicの最新Claude API料金ページ。Amazon BedrockまたはGoogle Cloudを利用する場合は、ここにある直接契約APIの料金を転記せず、各プロバイダーの料金表を使用してください。
パイロットの各行について、次の項目を計算します。
アプリケーションの新規入力 + アプリケーションの出力 + アプリケーションのキャッシュ書き込み + アプリケーションのキャッシュ読み取り + ジャッジの新規入力 + ジャッジの出力 + ジャッジのキャッシュ書き込み + ジャッジのキャッシュ読み取り + 有料のサーバーサイドツール
トークンの区分ごとに、その処理を実行したモデルの単価を掛けます。キャッシュトークンを新規入力にまとめてはいけません。一般的な簡易計算では、5分キャッシュへの書き込みを入力料金の1.25倍、読み取りを0.1倍としますが、現在の料金表には重要な例外があります。Fable 5.1の読み取りは入力料金の0.025倍、Opus 5.5は0.05倍です。一律に0.1倍を使うと、どちらも過大に見積もることになります。
ジャッジにも同じ原則を適用します。アプリケーションがSonnet 5.5、ジャッジがHaiku 4.5なら、それぞれの使用量と料金で計算します。アプリケーションにクラウドの契約料金が適用されるなら、その契約を使います。サーバーサイドツールに操作単位の料金がある場合は、別途加算してください。クライアントサイドツールもモデルのコンテキストを増やすため、トークン料金には影響します。
ここに実測の金額がないのは、今回の公開作業ではアプリケーションのエントリーポイント、プロバイダーのアカウント、承認済みの有償パイロットを用意できなかったためです。トークン数を作り上げれば、見栄えのよい数字は出せても、予算には役立ちません。料金表は確認済みですが、実行総額は使用量を実測するまで確定できません。
Claude API 評価は5件のパイロットから始める
最初の一歩として適切なのは、既存のサポートルーターのエントリーポイントに5件のチケットを通し、行ごとの使用量を確認することです。 5件では本番品質を保証できません。しかし、本格的な評価一式に誤りを広げる前に、ランナー、採点処理、トレース、費用計測が正しく接続されているかを確かめるには十分です。
顧客データをコピーせず、振り分けの異なる挙動を試せる5件の合成チケットを使用します。
- 顧客が請求ポータルを開けない。
- カードに同じ請求が2回付いたように見える。
- 顧客が年間プランの返金可否を尋ねている。
- 本番環境の障害について、緊急のエスカレーションが必要である。
- 法人の購入担当者が契約変更を求めている。
これは提案するパイロット用ケースであり、実施済みのテスト結果ではありません。外部への副作用を分離したうえで、本番ルーターと同じ関数、エンドポイント、スクリプトに入力してください。本番フローがメール送信、データベース変更、エンジニアの呼び出しを行う可能性があるなら、その副作用だけをテスト用フィクスチャに置き換えます。プロンプトの組み立て、モデルの呼び出し、ツール、リトライ、レスポンスの解析は本番相当のままにしなければ、別のシステムの費用を測ることになります。
エントリーポイントと課金主体を確認する
アプリケーションの関数またはエンドポイント、モデル、プロバイダー、アカウント、プロンプト、ツール、出力形式を記録します。Claude Code自体の認証方式も記録してください。これにより、処理を始める前に、プランの利用枠とアプリケーションAPIの使用量を区別できます。
5件の入力と採点方法を承認する
合成チケットを1件ずつ確認し、期待する振り分け先を承認します。固定されたキューのラベルなら、プログラムによる採点を使います。コードで判定できない性質に限ってモデルジャッジを追加し、評価対象のモデル自身には決して採点させないでください。
有償パイロットを1回実行する
5ケース × 1回の反復 × 1つのアプリケーション候補、つまりアプリケーションを5回実行します。公開されたワークフローでは、最初の有料実行前に明確な同意を求めています。承認済みの予算がなければ、料金を断定せず、実行できる状態まで準備したところで止めます。
コンソールの見出しではなく、各行を確認する
results.jsonlとトレースを1つ開きます。成功した行のmodelとusageが空でないこと、エントリーポイントがstop_reasonを公開していること、アプリケーションとジャッジの使用量を区別できることを確認します。キャッシュの書き込みと読み取りのフィールドは、入力にまとめずそのまま保持します。本来0ではない値が0なら、無料の呼び出しではなくランナーの不具合です。料金を計算し、全体の実行形状を承認する
実際のプロバイダー料金で5行分を計算し、1ケース当たりの最小値、中央値、最大値を報告してから、承認したケース数と反復回数を掛けます。採用する採点方法、リトライ、hillclimbの上限も加えてください。全体の実行承認を求める前に、この計算式を提示します。
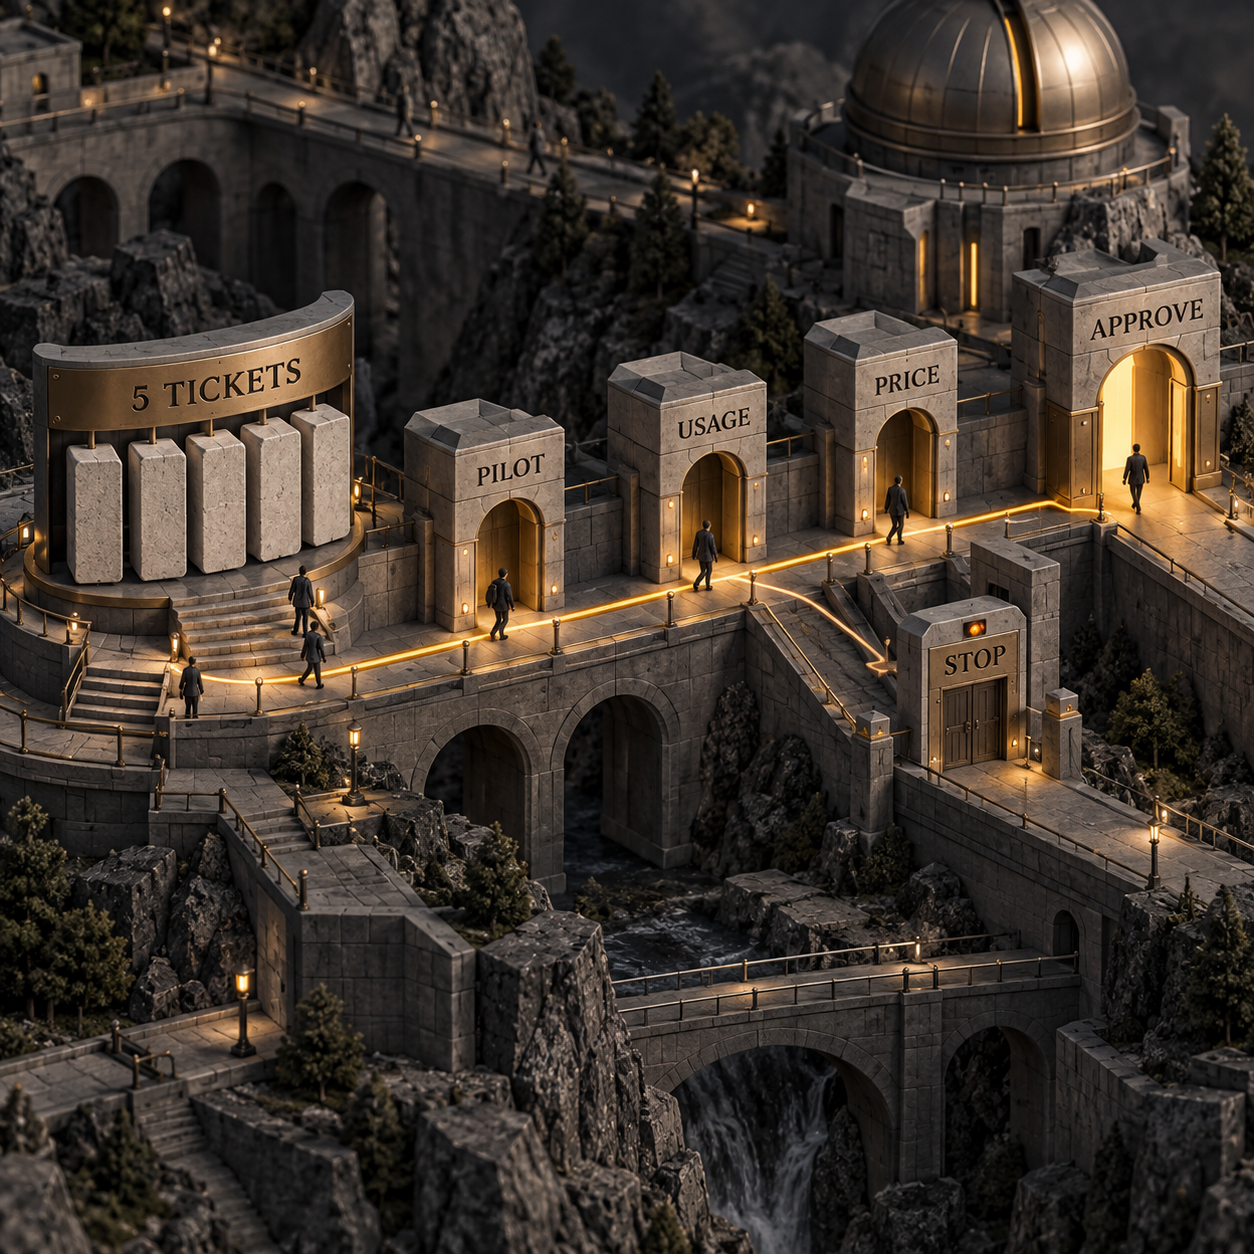
この順番は公開された実装に沿っています。まず、有償パイロットを1回測定し、使用量を精査してから、評価一式の費用を見積もります。キャッシュの状態、ツールのループ、effort、リトライ、出力長はこのアプリケーション固有のものであり、平均的なアプリケーションの値ではないため、過去の平均で置き換えることはできません。
開発者、運用担当者、購入担当者への影響
開発者は、アプリケーション境界で費用を観測できるようにする必要があります。 エントリーポイントがmodel、usage、stop_reasonを返していないなら、ランナー全体を書く前に最終イベントへ追加します。プロバイダー固有のキャッシュフィールドを保持し、ジャッジの使用量は別に記録してください。多くのチームが直面するのは、行データが不完全なのにレポートだけが整っている状態です。全体の実行が終わってからでは、欠けたトークン区分を復元できないことが少なくありません。
運用担当者は、掛け算と承認ゲートに責任を持つ必要があります。 ケース数、反復回数、候補数、採点の呼び出し回数、リトライ方針、hillclimbの最大ラウンド数を1ページにまとめます。「24ケース」としか書かれていない予算は不完全です。144回のアプリケーション実行、採点方法、実測したケース当たりの使用量、停止上限まであればレビューできます。
購入担当者は、提示された価格にどの層まで含まれるか確認する必要があります。 Claude Codeのオーケストレーション、アプリケーションモデル、ジャッジ、クラウドプロバイダーの上乗せ、ツール料金、リトライ、最適化ラウンドは含まれているでしょうか。アプリケーション実行が支出の大半を占めていても、それを除外して安価なジャッジだけを提示することは可能です。合計額だけでなく、パイロットの各行と計算式を求めてください。
今すぐ動くべき場合、待つべき場合、プラグイン評価を続ける場合
アプリケーションに安定したエントリーポイントが1つあり、判断すべき事項があり、安全にレビューできる代表的なケースを5件用意できるなら、今すぐ始める価値があります。 プロンプト移行、モデル変更、振り分けポリシーの改定、ツール変更は、具体的な変更前後を比較できるため適しています。
ランナーから本番ロジックを安全に呼び出せないなら、いったん待つべきです。 まず、データベースへの書き込み、外部へのメッセージ、破壊的なツール、変更可能な外部状態を分離してください。入力や採点方法を承認できる担当者がいない場合も待つ必要があります。誤った課題を測っている評価は、実行回数を増やしても改善しません。
Claude Codeプラグインに価値があるかを確かめたいなら、専用のプラグイン評価を使い続けてください。 このワークフローは、プラグインありとプラグインなしのセッションを比較するように設計されています。当サイトのClaude Codeプラグインを評価でテストするガイドでは、その専用の比較方法を解説しています。アプリケーションのbuild-evalはアプリのエントリーポイントを評価するものであり、プラグイン用の比較を一般的なベンチマークに置き換えるものではありません。
信頼できるランナーと採点処理が既にあるなら、影響はありません。 そのまま再利用してください。公開実装でも、既存の部品を新しいフレームワークで置き換えるのではなく、調整して使うことを明確に優先しています。新しいテスト基盤より、承認手順、使用量の取得、hillclimbのループだけが役立つ場合もあります。
過大評価されている点
このワークフローは準備の手間を減らしますが、評価を自動、客観的、無料にするものではありません。 Claudeはケースを提案できますが、本番を代表しているかを判断するのは人です。採点方法も提案できますが、正解例を合格にし、無回答を不合格にし、モデルジャッジが正しさより文体を評価していないかを、人が確かめる必要があります。
hillclimbingも無料の最適化機能ではありません。複数の候補を意図的に実行し、失敗を読み、パッチを提案して、再び評価します。ホールドアウト分割は特定の過学習を防ぎますが、十分なケース数と反復回数、支出上限が必要なことは変わりません。
レポートが根拠になるのは、各行のデータが揃っている場合だけです。空のusageフィールドが並ぶ美しいreport.htmlでは、費用の問いに答えられません。仮定したトークン数から算出した総額も同じです。有償パイロットを実施する前に提示できる堅実な成果物は、実行計画と最新の料金表であり、実測総額は空欄のままにしておくべきです。
月曜日に実行すること
「評価を作る」という際限のない指示ではなく、範囲を限定したパイロットを1人の担当者に任せます。 月曜日に、既存のサポートルーターのエントリーポイントを選び、上記の5件の合成チケットを作成し、固定ラベルを判定するプログラム採点を用意します。入力と期待する振り分け先は、サポートポリシーを担当する運用責任者と確認してください。
その後、アプリケーションをちょうど5回実行する承認を求めます。results.jsonl、トレース1件、すべての使用量区分、stop_reason を確認し、実際のプロバイダー料金で各行を計算します。その作業を終えて初めて、24ケース、3回の反復、2候補という実行形状と、採点、リトライ、hillclimbの上限を提案します。
判断基準は明快です。完全なパイロット使用量がなければ、全体実行の予算は承認しません。
- 最終更新
- 2026年9月29日
- カテゴリー
- Build
Googleでこのサイトを優先する


omidsaffari.comを優先ソースに設定すると、GoogleがTop Stories・AI Overviews・AI Modeであなたのために優先表示します。

Shopify チェックアウト カスタマイズをWebMCPで実装する方法
Shopify チェックアウト カスタマイズをWebMCPで安全に実装する方法を解説。状態の読み取りと更新、Shop Payへの引き継ぎ、購入者の明示的な承認後に注文を確定する設計、対象外フロー、エラー別の復旧手順まで実務目線でまとめます。ブラウザエージェント開発者向けの実践ガイドです。2026年9月29日Build
Cloudflare Workersをcf CLIで操作する方法
Cloudflare Workersを新しいcf CLIで操作する手順を解説します。インストールと認証、コマンド検索、JSON出力、新規Workerの作成、Vite移行を実例で確認。Wranglerを残すケース、権限を絞った安全な運用、ベータ版の制約まで、導入前に押さえるべきポイントを整理しました。2026年9月29日Build
Krisp 料金・機能レビュー:導入前に確認すべき音声とデータの経路
Krispの料金、ノイズキャンセリング、録音・文字起こしのデータ経路を検証。CoreとAdvancedの実費、7日間の無料トライアル、導入前に行う3経路の音声テスト、プライバシー上の注意点を整理し、標準機能で十分なケースと購入すべきチームを明確にします。確認済みの仕様と再現可能な判断基準で導入可否を見極めます。2026年9月29日Build
SaneBox料金ガイド:メール 自動振り分けの費用と選び方
メール 自動振り分けサービスSaneBoxのSnack、Lunch、Dinnerを、月払い・12か月・24か月の総額で比較。接続できるアカウント数と選べる機能数、年払いの損益分岐点、見えにくい追加コストを整理し、7日間トライアルで緊急メールの見落としを検証してから最適なプランを選ぶ方法を解説します。2026年9月29日Build
AI従業員Marblismの料金ガイド:タスク量で選ぶ最適プラン
AI従業員Marblismの料金を、50〜10,000時間の全プラン、タスク別の消費時間、ワークスペース共有、追加購入、返金・解約条件まで整理。3つの業務例から必要プランを計算し、Sintra AIやLindyとの違い、向いている企業と見送るべきケースを購入前の判断軸として具体的に比較します。2026年9月28日Build
メール AI「Fyxer」の料金を検証:StarterとProfessionalの選び方
メール AIツール「Fyxer」の料金は、Starterが月額$30または年額$270、Professionalが月額$50または年額$450です。受信トレイ数によるプランの境界、7日間トライアル、1席・5席・10席の実コスト、月27分・45分・18分の回収条件を比較し、購入、月払い継続、見送りの判断材料を示します。2026年9月28日Build
Cloudflare Workers 料金ガイド:Worker Previewsは無料か
Cloudflare Workers 料金を、Worker Previewsの無料枠、実行リクエスト、CPU、ビルド、ストレージ、Workers AI、Containers別に整理。100 Previewsと100 deploymentsの意味、Paidへ移る基準、5ブランチの試算を解説します。2026年9月28日Build