Claude API gratis? Quanto costa davvero build-eval
Claude API gratis? Le istruzioni di build-eval sono pubbliche, ma test, giudici e chiamate dell’app possono generare costi. Ecco come stimarli.




No: il workflow build-eval della Claude API è pubblico, ma la valutazione che orchestra non è automaticamente gratuita. Per chi cerca “Claude API gratis”, la distinzione è tra istruzioni gratuite e attività fatturabili: 24 casi × 3 ripetizioni × 2 varianti di modello fanno 144 esecuzioni dell’applicazione, prima di eventuali chiamate del giudice o tentativi aggiuntivi. Per questa verifica non era disponibile un test pilota finanziato sull’applicazione, quindi 144 è un calcolo aritmetico, non un totale in dollari misurato.
Claude API gratis: build-eval è davvero gratuito?
I file del workflow si possono leggere gratuitamente; eseguire una valutazione, invece, può comportare consumi a pagamento in tre punti diversi. Claude Code può attingere al traffico incluso in un abbonamento oppure a un account a consumo, l’applicazione sotto test chiama il proprio provider di modelli e un eventuale giudice basato su modello effettua un’altra serie di chiamate. Un valutatore deterministico locale evita la terza voce di costo, ma non le chiamate dell’applicazione.
La distinzione è importante perché build-eval non offre un pacchetto di crediti gratuiti per le valutazioni. È un workflow guidato di Claude Code che costruisce una valutazione attorno a un’applicazione esistente. Aiuta a individuare l’entry point, preparare i casi, scegliere un sistema di valutazione, scrivere o adattare un runner e produrre risultati verificabili. L’implementazione pubblica è disponibile nel repository delle skill di Anthropic, ma le chiamate eseguite dal runner prodotto seguono le regole di fatturazione dell’account e del provider utilizzati.
La risposta prudente, quindi, dipende dalle condizioni: progettare la valutazione può essere gratuito; eseguirla lo è soltanto se non avvengono chiamate fatturabili o se tutto il consumo rientra in una quota già pagata. Anche in quel caso, “gratis” descrive l’impatto marginale sulla fattura, non una capacità illimitata.
Che cosa è cambiato il 28 e 29 settembre
Anthropic ha trasformato la creazione delle valutazioni e l’ottimizzazione iterativa in due workflow espliciti di Claude Code. La guida del 28 settembre 2026 ha introdotto /claude-api build-eval per creare una valutazione e /claude-api hillclimb per migliorare un’applicazione rispetto a quella valutazione. L’implementazione è diventata pubblica il 29 settembre alle 02:20:03 UTC con il commit 8a1541c4.
build-eval parte da un singolo flusso dell’applicazione. Legge l’entry point esistente, chiede da dove ricavare casi rappresentativi, propone il valutatore più economico capace di misurare correttamente l’output e richiede un’approvazione esplicita sia degli input sia del metodo di valutazione. Il risultato è costituito da codice e prove nel repository, tra cui un runner, results.jsonl, tracce e un report.
hillclimb interviene dopo. Divide i casi tra un set di addestramento e un set di test separato, modifica un solo elemento consentito alla volta, riesegue la valutazione e annulla i cambiamenti che peggiorano il risultato o migliorano soltanto il set di addestramento. Può ottimizzare prompt, scelta del modello, livello di effort, strumenti o codice wrapper dell’applicazione, ma ogni variante tentata comporta altre esecuzioni.
La novità sostanziale non è che “le valutazioni ora sono gratuite”. È la possibilità per Claude Code di assemblare un workflow di valutazione rigoroso e verificabile senza imporre un framework separato. Il modello di pagamento sottostante non è scomparso.
Costo Claude API: quattro voci da tenere separate
Un budget utile distingue quattro voci, perché soltanto una è inequivocabilmente gratuita. Riunirle tutte sotto un generico “costo di Claude” impedisce di capire dove sia finito il denaro.
- Il workflow pubblico. La guida e i file della skill sono pubblici. Leggerli, esaminare i file locali generati ed eseguire un controllo deterministico in locale non produce di per sé addebiti per i token della Claude API.
- L’orchestrazione di Claude Code. Claude Code legge il repository, raccoglie le informazioni necessarie, scrive il runner e aiuta a esaminare i risultati. Chi ha un abbonamento consuma il traffico incluso nel piano; le sessioni autenticate via API consumano token a pagamento. Il costo di sessione mostrato agli utenti API è una stima, mentre gli abbonati vedono il consumo del piano, come spiega la documentazione sui costi di Claude Code di Anthropic. I dettagli aggiornati su piani e autenticazione sono raccolti nella guida ai prezzi di Claude Code del sito.
- L’applicazione sotto test. Il runner dovrebbe chiamare l’entry point esistente, non ricostruire una richiesta semplificata al modello. Ogni ticket di assistenza, tentativo aggiuntivo, ciclo di strumenti e ripetizione consuma quindi il provider e l’account già utilizzati dall’applicazione.
- Il valutatore. Un’etichetta fissa, una verifica dello schema, un test unitario o un’asserzione sullo stato finale possono essere eseguiti in locale. Le risposte aperte possono richiedere un giudice basato su modello, pointwise o pairwise, con ulteriori consumi di input, output, cache ed eventuali strumenti.
Il primo risparmio non nasce da un giudice più economico, ma dalla scelta di un valutatore programmatico ogni volta che l’output corretto ha una forma ben definita. Se un sistema di smistamento dell’assistenza deve restituire una sola coda presa da una lista chiusa, basta verificarlo con il codice. Chiedere a un altro modello se billing è uguale a billing significa pagare per rispondere a una domanda deterministica.
Un giudice basato su modello serve quando il criterio richiede davvero un giudizio: per esempio, stabilire se il riepilogo di un’escalation conserva l’urgenza del cliente senza inventare fatti. Anche in questo caso, i consumi dell’applicazione e del giudice vanno registrati in campi separati. Un giudice economico può nascondere un’esecuzione costosa dell’applicazione, e può accadere anche il contrario.
I numeri: 24 casi diventano 144 esecuzioni dell’applicazione
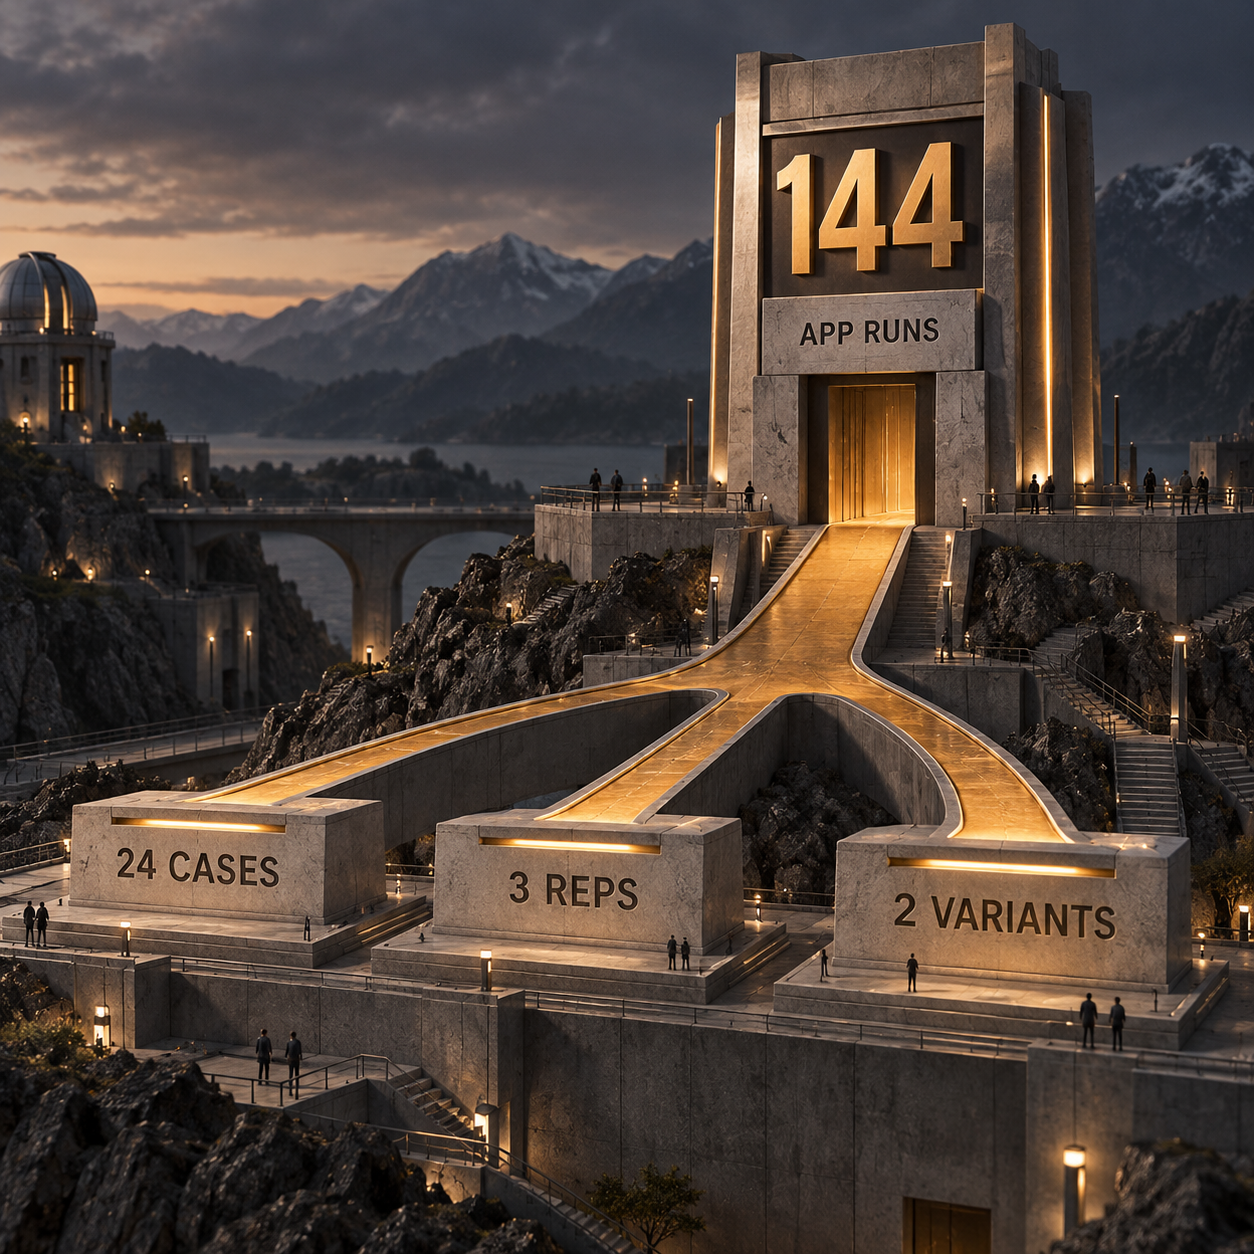
Il numero di casi è soltanto il primo moltiplicatore. La guida di lancio di Anthropic mostra un esempio di smistamento della posta in arrivo con 24 input. Confrontando 2 varianti di modello e ripetendo ogni caso 3 volte, il numero di esecuzioni dell’applicazione è:
24 casi × 3 ripetizioni × 2 varianti = 144 esecuzioni dell’applicazione
È la soglia minima di esecuzioni per questa configurazione, prima che un modello valuti qualsiasi risultato e prima dei nuovi tentativi dovuti a richieste fallite. Le ripetizioni contano perché un modello può produrre risposte diverse a parità di input. Le varianti contano perché il confronto richiede gli output di entrambe le configurazioni.
Il valutatore determina il moltiplicatore successivo:
- Valutatore programmatico: 0 chiamate a un giudice basato su modello. L’esecuzione resta composta da 144 esecuzioni dell’applicazione.
- Giudice pairwise: 72 chiamate al giudice se una chiamata confronta le due varianti per ogni caso e ripetizione, perché 24 × 3 = 72 coppie.
- Giudice pointwise: 144 chiamate al giudice se ogni output dell’applicazione viene valutato separatamente. Il totale sale a 288 chiamate al modello: 144 dell’applicazione più 144 del giudice, senza contare tentativi aggiuntivi o consumo dell’orchestrazione di Claude Code.
L’hillclimbing aggiunge un’altra dimensione, perché ogni ciclo esegue un nuovo candidato. Un processo che prova diverse patch può consumare diverse valutazioni complete, anche quando ogni patch perdente viene annullata. Prima di ottimizzare, bisogna fissare un limite ai cicli e uno alla spesa. “Fermarsi quando il punteggio migliora” non è un budget: la variabilità dei punteggi può far proseguire la ricerca.
I prezzi della Claude API partono dall’uso misurato
Un caso non ha un prezzo fisso: l’unica stima difendibile parte dai dati di consumo effettivi di un test pilota a pagamento. Un ticket può richiedere una sola breve chiamata di classificazione. Un altro può attivare un contesto lungo, diversi strumenti, nuovi tentativi e un giudice. Trattarli entrambi come “un caso di valutazione” nasconde proprio la differenza che determina la fattura.
Il tariffario dell’API diretta di Anthropic è stato verificato il 29 settembre 2026. I prezzi seguenti si intendono per milione di token:
Fonte: pagina aggiornata dei prezzi della Claude API di Anthropic. Per Amazon Bedrock o Google Cloud va usato il tariffario del provider, senza copiare questi prezzi dell’API diretta.
Per ogni riga del test pilota, il calcolo è:
input nuovo dell’applicazione + output dell’applicazione + scritture nella cache dell’applicazione + letture dalla cache dell’applicazione + input nuovo del giudice + output del giudice + scritture nella cache del giudice + letture dalla cache del giudice + strumenti server-side a pagamento
Ogni gruppo di token va moltiplicato per la tariffa del modello che lo ha prodotto. I token in cache non vanno sommati all’input nuovo. La scorciatoia generica assegna alla scrittura in cache per 5 minuti un costo pari a 1.25 volte quello dell’input e alla lettura un costo pari a 0.1 volte; il tariffario attuale, però, contiene eccezioni importanti per la lettura: Fable 5.1 costa 0.025 volte la propria tariffa di input e Opus 5.5 costa 0.05 volte. Applicare alla cieca il moltiplicatore 0.1 sovrastimerebbe entrambi.
Lo stesso rigore vale per il giudice. Se l’applicazione usa Sonnet 5.5 e il giudice usa Haiku 4.5, ciascun consumo va valorizzato con il relativo modello e tariffario. Se l’applicazione usa una tariffa cloud contrattualizzata, si applica quel contratto. Se uno strumento server-side ha un costo per operazione, va aggiunto a parte. Gli strumenti client-side ampliano comunque il contesto del modello e quindi il conto dei token.
Qui non compare alcuna cifra in dollari misurata perché, per la pubblicazione di questo articolo, non erano disponibili un entry point dell’applicazione, un account del provider o un test pilota finanziato e approvato. Inventare un numero di token produrrebbe una cifra ordinata, ma un budget inutile. Il tariffario è verificato; il totale dell’esecuzione deve attendere i consumi misurati.
Claude Code build-eval: prima un test pilota su cinque ticket
La prima mossa utile è un test pilota di cinque ticket eseguito tramite l’entry point esistente del sistema di smistamento dell’assistenza, seguito dall’esame dei consumi riga per riga. Cinque casi non bastano a certificare la qualità in produzione. Bastano però a dimostrare che runner, valutatore, tracce e contabilità dei costi sono collegati correttamente, prima che un errore venga moltiplicato su una suite completa.
Si possono usare cinque ticket sintetici che mettano alla prova comportamenti di smistamento diversi senza copiare dati dei clienti:
- Un cliente non riesce ad aprire il portale di fatturazione.
- Una carta sembra essere stata addebitata due volte.
- Un cliente chiede se un piano annuale sia rimborsabile.
- Un’interruzione in produzione richiede un’escalation urgente.
- Un cliente enterprise chiede una modifica contrattuale.
Questi casi sono una proposta per il test pilota, non il resoconto di un test eseguito. Devono entrare nella stessa funzione, nello stesso endpoint o nello stesso script usato dal sistema di produzione, isolando gli effetti esterni. Se il flusso reale può inviare email, modificare un database o allertare un tecnico, soltanto quell’effetto collaterale va sostituito con una fixture di test. Composizione del prompt, chiamata al modello, strumenti, nuovi tentativi e parsing della risposta devono restare equivalenti alla produzione, altrimenti il test pilota stima il costo del sistema sbagliato.
Confermare l’entry point e l’account di fatturazione
Registrare la funzione o l’endpoint dell’applicazione, il modello, il provider, l’account, il prompt, gli strumenti e la forma dell’output. Va annotato anche il metodo di autenticazione di Claude Code. In questo modo, prima ancora di iniziare, la quota del piano resta distinta dal consumo API dell’applicazione.
Approvare i cinque input e il valutatore
Esaminare ogni ticket sintetico e approvare l’instradamento atteso. Per un’etichetta di coda fissa va usato un valutatore programmatico. Un giudice basato su modello si aggiunge soltanto per una proprietà che il codice non può verificare, senza mai affidare il giudizio al modello sotto test.
Eseguire un solo test pilota finanziato
Eseguire 5 casi × 1 ripetizione × 1 variante dell’applicazione, cioè 5 esecuzioni dell’applicazione. Il workflow pubblicato richiede un sì esplicito prima del primo passaggio a pagamento. In assenza di un budget approvato, ci si ferma qui con una configurazione pronta per un dry run, senza dichiarare un prezzo.
Esaminare la riga, non il riepilogo della console
Aprire
results.jsonle una traccia. Verificare che le righe delle esecuzioni riuscite contengano valori non vuoti permodeleusage, che l’entry point espongastop_reasone che i consumi di applicazione e giudice siano distinguibili. I campi di scrittura e lettura della cache devono restare separati, invece di essere inclusi nell’input. Uno zero dove il valore non dovrebbe essere zero segnala un bug del runner, non una chiamata gratuita.Calcolare il prezzo e approvare la configurazione completa
Calcolare le cinque righe alle tariffe reali del provider, indicare minimo, mediana e massimo per caso, quindi moltiplicare per il numero approvato di casi e ripetizioni. Aggiungere il tipo di valutatore scelto, i nuovi tentativi e il limite dell’hillclimb. La formula va presentata prima di chiedere l’approvazione dell’esecuzione completa.
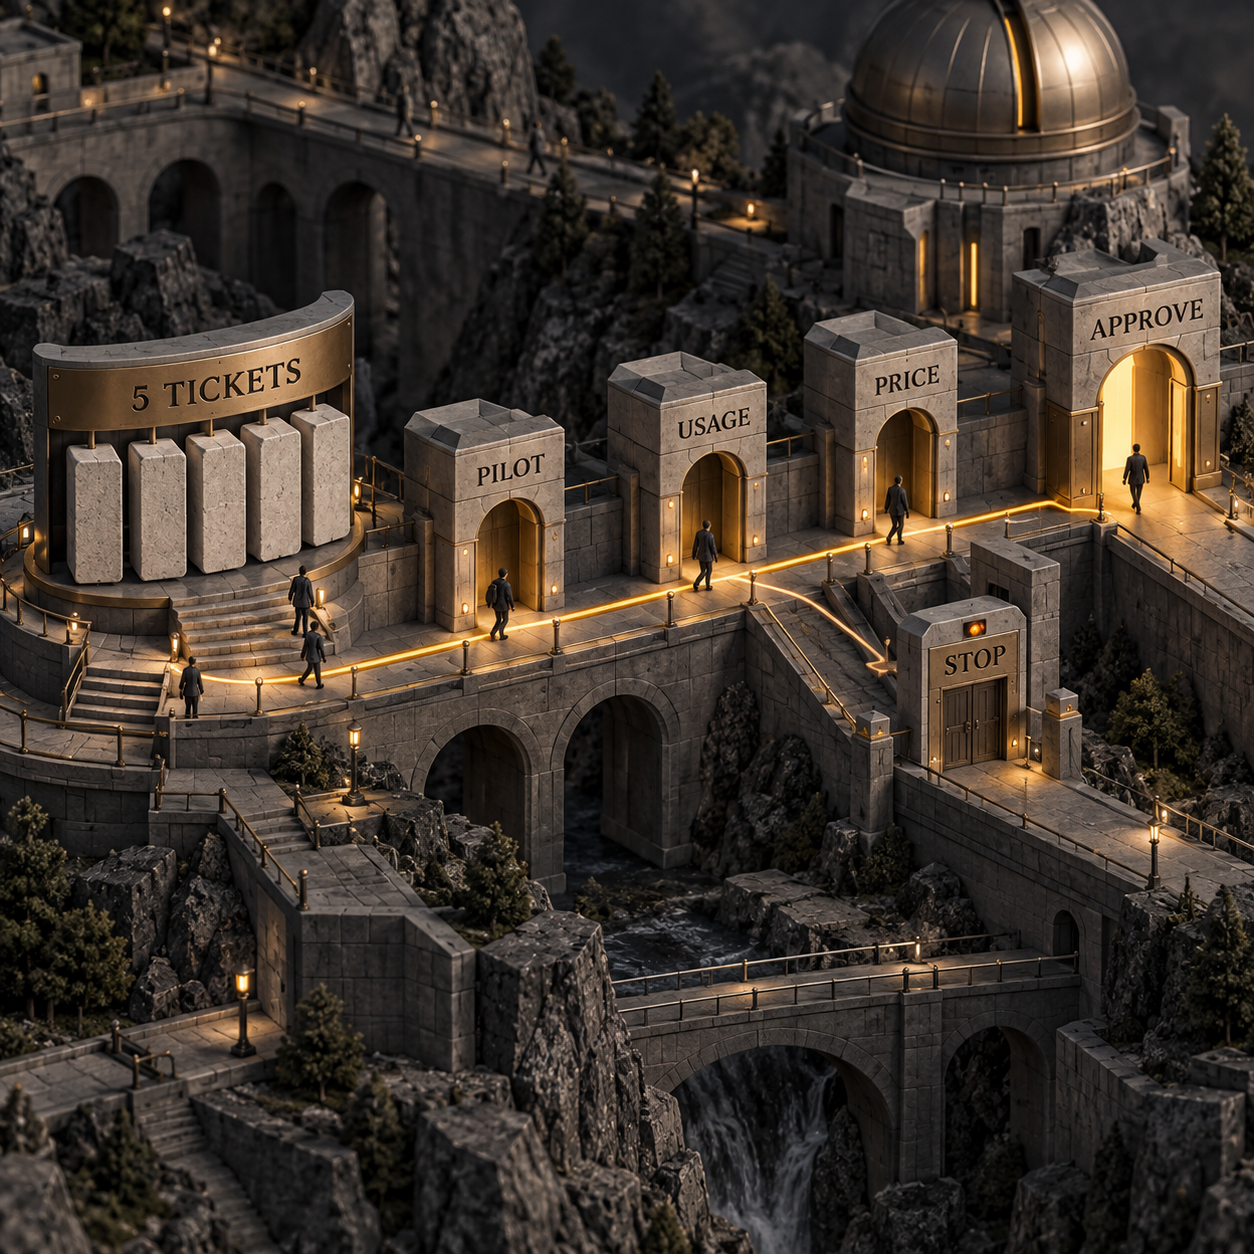
Quest’ordine segue l’implementazione pubblicata: si misura un solo test pilota finanziato, se ne esaminano i consumi e soltanto allora si stima la suite. Le medie storiche non bastano, perché stato della cache, cicli di strumenti, effort, nuovi tentativi e lunghezza dell’output appartengono a questa applicazione, non a un’applicazione media.
Cosa cambia per chi sviluppa, gestisce e acquista
Chi sviluppa dovrebbe rendere osservabile il costo all’interfaccia dell’applicazione. Se l’entry point nasconde model, usage o stop_reason, questi campi vanno aggiunti all’evento finale prima di scrivere il runner completo. Occorre conservare i campi di cache nativi del provider e allegare separatamente il consumo del giudice. Il problema ricorrente è un report curato costruito su righe incomplete: al termine dell’esecuzione completa, spesso non è più possibile ricostruire i gruppi di token mancanti.
Chi gestisce l’operatività dovrebbe occuparsi dei moltiplicatori e dell’approvazione. In una sola pagina vanno richiesti casi, ripetizioni, varianti, chiamate del valutatore, politica dei nuovi tentativi e numero massimo di cicli di hillclimb. Un budget che riporta soltanto “24 casi” è incompleto. Un budget che specifica 144 esecuzioni dell’applicazione, tipo di valutatore, consumo misurato per caso e limite di arresto è verificabile.
Chi acquista dovrebbe chiedere quali livelli siano inclusi nel prezzo dichiarato. Comprende l’orchestrazione di Claude Code, il modello dell’applicazione, il giudice, il ricarico del cloud provider, i costi degli strumenti, i nuovi tentativi e i cicli di ottimizzazione? Un fornitore può dichiarare in buona fede un giudice economico escludendo le esecuzioni dell’applicazione che rappresentano la maggior parte della spesa. Bisogna chiedere le righe del test pilota e la formula, non soltanto un totale.
Chi dovrebbe agire ora, aspettare o restare sul percorso dei plugin
È il momento di agire se l’applicazione ha un entry point stabile, una decisione da prendere e cinque casi rappresentativi che possono essere esaminati in sicurezza. Una migrazione del prompt, un cambio di modello, una revisione della politica di smistamento o una modifica degli strumenti sono buoni candidati, perché la valutazione può confrontare un prima e un dopo concreti.
Conviene aspettare se il runner non può chiamare in sicurezza la logica di produzione. Prima vanno isolati le scritture nel database, i messaggi in uscita, gli strumenti distruttivi e lo stato esterno modificabile. Bisogna aspettare anche quando nessuno può approvare gli input o il valutatore. Più esecuzioni non salveranno una valutazione che misura il compito sbagliato.
Il percorso nativo dei plugin resta preferibile quando la domanda è se un plugin di Claude Code aggiunga valore. Quel workflow confronta per definizione sessioni WITH-plugin e W/OUT-plugin. La guida del sito su come testare i plugin di Claude Code con le valutazioni tratta questo controllo specifico. build-eval per le applicazioni riguarda l’entry point dell’app, non serve a sostituire il controllo del plugin con un benchmark generico.
Chi dispone già di un runner e di un valutatore affidabili non deve cambiare nulla. Vanno riutilizzati. L’implementazione pubblica privilegia esplicitamente l’adattamento dei componenti esistenti rispetto alla loro sostituzione con un nuovo framework. Il contributo utile può consistere nella disciplina di approvazione, nella raccolta dei consumi o nel ciclo di hillclimb, non in un nuovo stack di test.
Cosa viene sopravvalutato
Il workflow riduce l’attrito iniziale, ma non rende la valutazione automatica, oggettiva o gratuita. Claude può proporre casi, ma una persona deve comunque decidere se rappresentano la produzione. Può proporre un valutatore, ma una persona deve verificare che una risposta corretta di riferimento venga accettata, una risposta nulla venga respinta e un giudice basato su modello non premi lo stile a scapito della correttezza.
Nemmeno l’hillclimbing è un ottimizzatore gratuito. Per sua natura esegue più varianti, legge gli errori, propone patch e valuta di nuovo. Il set separato protegge da una forma di overfitting, ma non elimina la necessità di un numero sufficiente di casi e ripetizioni, né di un limite di spesa.
Il report costituisce una prova soltanto quando le righe sono complete. Un elegante report.html affiancato da campi usage vuoti non può rispondere alla domanda sui costi. Un totale in dollari ricavato da un numero di token ipotizzato non è migliore. Prima di un test pilota finanziato, il risultato difendibile è un piano di esecuzione con il tariffario aggiornato, lasciando vuoto il totale misurato.
La mossa da fare lunedì
Va assegnato a un unico responsabile un test pilota circoscritto, non un mandato indefinito a “costruire valutazioni”. Lunedì si sceglie l’entry point esistente del sistema di smistamento dell’assistenza, si scrivono i cinque ticket sintetici elencati sopra e si usa un valutatore programmatico con etichette fisse. Input e instradamenti attesi vanno esaminati con il responsabile operativo della politica di assistenza.
Poi si chiede l’approvazione per eseguire esattamente 5 esecuzioni dell’applicazione. Si controllano results.jsonl, una traccia, tutti i gruppi di consumo e stop_reason. Si calcola il costo di quelle righe alla tariffa reale del provider. Soltanto a quel punto si può proporre la configurazione da 24 casi, 3 ripetizioni e 2 varianti, con i relativi limiti per il giudice, i nuovi tentativi e l’hillclimb.
La regola decisionale è netta: senza dati di consumo completi del test pilota, nessuna approvazione del budget per l’esecuzione completa.
- Ultimo aggiornamento
- 29 set 2026
- Categoria
- Build
Preferisca questo sito su Google


Segni omidsaffari.com come fonte preferita e Google lo mette in evidenza per lei in Top Stories, AI Overviews e AI Mode.

Checkout Shopify con WebMCP: guida sicura per agenti AI
Checkout Shopify con WebMCP: scopri come leggere e aggiornare l’ordine, gestire i passaggi di pagamento e completare l’acquisto solo con il consenso.29 set 2026Build
Cloudflare Wrangler e cf CLI: guida pratica alla nuova beta
Scopri come usare la nuova cf CLI con Cloudflare Wrangler: installazione, autenticazione, comandi JSON, Worker con Vite e migrazioni controllate.29 set 2026Build
Krisp alla prova: costi, audio e privacy prima dell'acquisto
Krisp migliora davvero le chiamate? Analisi di prezzi, cancellazione del rumore, privacy e limiti, con il test pratico da fare prima dell'acquisto.29 set 2026Build
SaneBox pricing: prezzi, piani e convenienza
Scopri quanto costa SaneBox: prezzi mensili e annuali di Snack, Lunch e Dinner, differenze tra i piani, costi nascosti e alternative più convenienti.29 set 2026Build
Marblism prezzi 2026: piani, ore e costi per attività
Marblism prezzi e costi reali: calcola le ore consumate da ogni attività, scegli il piano più adatto e scopri cosa accade quando il monte ore finisce.28 set 2026Build
Fyxer AI: prezzi, piani e costi reali
Scopri prezzi e piani di Fyxer AI, il costo reale per i team e quanti minuti devono far risparmiare le bozze perché l’abbonamento convenga davvero.28 set 2026Build
Cloudflare Workers pricing: i Preview sono davvero gratis?
Cloudflare Workers pricing, spiegato: i Worker Previews sono inclusi nel piano Free, ma runtime, build, storage, AI e Containers seguono limiti separati.28 set 2026Build