Claude Code 가격으로 보는 build-eval: 무료일까?
Claude API build-eval 지침은 공개되어 있지만 실제 평가는 자동으로 무료가 아닙니다. Claude Code 가격, 애플리케이션 호출, 모델 심사 비용을 분리하고 24개 사례가 144회 실행으로 늘어나는 계산법과 5건 파일럿 절차를 정리합니다.




결론부터 말하면, Claude Code 가격과 Claude API 비용은 따로 봐야 합니다. Claude API의 build-eval 워크플로는 공개되어 있지만, 이 워크플로가 실행하는 평가까지 자동으로 무료인 것은 아닙니다. “Claude API build eval은 무료인가?”를 묻는다면 무료로 읽을 수 있는 안내 문서와 비용이 발생하는 작업을 구분해야 합니다. 24개 사례 × 3회 반복 × 2개 모델 변형이면, 선택 사항인 심사 모델 호출이나 재시도 전부터 애플리케이션이 144회 실행됩니다. 이 검증에서는 비용 지원을 받은 애플리케이션 파일럿을 진행할 수 없었으므로, 144는 실측 금액이 아니라 산술적으로 계산한 값입니다.
Claude API build-eval은 무료인가?
워크플로 파일은 무료로 읽을 수 있지만, 실제 평가를 실행하면 세 곳에서 유료 모델 사용량이 발생할 수 있습니다. Claude Code는 구독 플랜의 사용 한도를 소모하거나 종량제 계정에 비용을 발생시킬 수 있습니다. 테스트 대상 애플리케이션은 자체 모델 제공업체를 호출하며, 선택 사항인 모델 심사기는 여기에 별도의 호출을 더합니다. 결정론적인 로컬 채점기를 쓰면 세 번째 비용은 피할 수 있지만, 애플리케이션 호출 비용까지 사라지지는 않습니다.
이 차이가 중요한 이유는 build-eval이 무료 평가 크레딧 묶음이 아니기 때문입니다. 이미 보유한 애플리케이션을 중심으로 평가를 만드는 과정을 안내하는 Claude Code 워크플로입니다. 진입점을 찾고, 사례를 구성하고, 채점기를 고르고, 러너를 새로 작성하거나 기존 러너를 조정한 뒤, 검토 가능한 결과를 만드는 일을 돕습니다. 공개 구현은 Anthropic의 skills 저장소에서 확인할 수 있지만, 완성된 러너가 만드는 호출에는 해당 계정과 제공업체의 과금 규칙이 적용됩니다.
따라서 정확한 답은 조건부입니다. 평가 설계는 무료일 수 있지만, 유료 호출이 전혀 없거나 모든 사용량이 이미 결제한 한도 안에 들어갈 때만 실행 비용이 0입니다. 이때도 “무료”는 추가 청구액이 없다는 뜻이지, 용량이 무제한이라는 뜻은 아닙니다.
9월 28일과 29일, 무엇이 달라졌나
Anthropic은 평가 구성과 반복 최적화를 2개의 명시적인 Claude Code 워크플로로 만들었습니다. 2026년 9월 28일 공개된 가이드는 평가를 만드는 /claude-api build-eval과 애플리케이션을 평가에 맞춰 개선하는 /claude-api hillclimb을 소개했습니다. 구현은 9월 29일 02:20:03 UTC에 커밋 8a1541c4으로 공개 저장소에 반영됐습니다.
build-eval은 하나의 애플리케이션 흐름에서 시작합니다. 기존 진입점을 읽고, 대표 사례를 어디서 가져올지 묻고, 결과를 제대로 측정할 수 있는 가장 저렴한 채점 방식을 제안합니다. 입력과 채점 방식 모두에 명확한 승인을 요구합니다. 최종 결과물은 러너, results.jsonl, 트레이스, 보고서를 포함해 저장소에 남는 코드와 증거입니다.
hillclimb은 그다음 단계입니다. 사례를 학습 세트와 비공개 테스트 세트로 나누고, 한 번에 허용된 영역 하나만 바꾼 뒤 평가를 다시 실행합니다. 성능이 떨어지거나 학습 세트에서만 좋아진 변경은 되돌립니다. 프롬프트, 모델 선택, 추론 강도, 툴, 애플리케이션 래퍼 코드를 개선할 수 있지만, 시도하는 변형마다 실행 횟수는 더 늘어납니다.
지속적으로 남는 변화는 “평가가 이제 무료다”가 아닙니다. 별도의 프레임워크를 강제하지 않으면서 Claude Code가 체계적이고 감사 가능한 평가 워크플로를 구성할 수 있게 됐다는 점입니다. 그 아래의 과금 구조는 없어지지 않았습니다.
Claude Code 가격과 build-eval 비용의 4가지 과금 지점
예산을 제대로 세우려면 4가지 지점을 분리해야 하며, 이 가운데 명백히 무료인 것은 1가지뿐입니다. 모두를 하나의 “Claude 비용”으로 묶으면 돈이 어디에서 나갔는지 설명할 수 없습니다.
- 공개 워크플로. 가이드와 스킬 파일은 공개되어 있습니다. 이를 읽고, 생성된 로컬 파일을 검토하고, 결정론적인 로컬 검사를 실행하는 일 자체에는 Claude API 토큰 비용이 발생하지 않습니다.
- Claude Code 오케스트레이션. Claude Code는 저장소를 읽고, 사용자에게 질문하고, 러너를 작성하고, 결과 검토를 돕습니다. 구독자는 플랜 사용 한도를 소모하고, API 인증 세션은 종량제 토큰을 사용합니다. Anthropic의 Claude Code 비용 문서에 따르면 API 사용자는 세션 비용 추정치를 보고, 구독자는 플랜 사용량을 확인합니다. 현재 플랜과 인증 방식은 이 사이트의 Claude Code 가격 가이드에서 다룹니다.
- 테스트 대상 애플리케이션. 러너는 단순화한 모델 요청을 다시 만드는 대신 기존 애플리케이션 진입점을 호출해야 합니다. 따라서 지원 티켓, 재시도, 툴 루프, 반복 실행마다 애플리케이션이 이미 사용하는 제공업체와 계정의 사용량이 소모됩니다.
- 채점기. 고정 레이블, 스키마 검사, 단위 테스트, 최종 상태 검증은 로컬에서 실행할 수 있습니다. 개방형 답변에는 점별 또는 쌍별 모델 심사가 필요할 수 있으며, 이때 별도의 입력·출력·캐시·툴 사용량이 추가됩니다.
비용을 줄일 때 가장 먼저 할 일은 더 저렴한 심사기를 찾는 것이 아닙니다. 정답의 형태가 제한되어 있다면 프로그래밍 방식의 채점기를 선택하는 것이 먼저입니다. 지원 요청 라우터가 고정 목록에서 큐 하나를 반환해야 한다면 코드로 검사할 수 있습니다. billing과 billing이 같은지 다른 모델에 묻는 것은 결정론적으로 답할 수 있는 문제에 돈을 쓰는 셈입니다.
고객의 긴급성을 유지하면서 사실을 지어내지 않은 에스컬레이션 요약인지처럼 실제 판단이 필요한 속성에만 모델 심사기를 사용해야 합니다. 이때도 애플리케이션과 심사기의 사용량은 별도 필드로 기록해야 합니다. 저렴한 심사기가 비싼 애플리케이션 실행 비용을 가릴 수 있고, 그 반대도 마찬가지입니다.
숫자로 보면: 24개 사례가 144회 실행이 되는 과정
사례 수는 첫 번째 승수일 뿐입니다. Anthropic의 출시 가이드에는 24개 입력을 쓰는 받은편지함 라우팅 사례가 나옵니다. 2개 모델 변형을 비교하고 각 사례를 3회씩 반복하면 애플리케이션 실행 횟수는 다음과 같습니다.
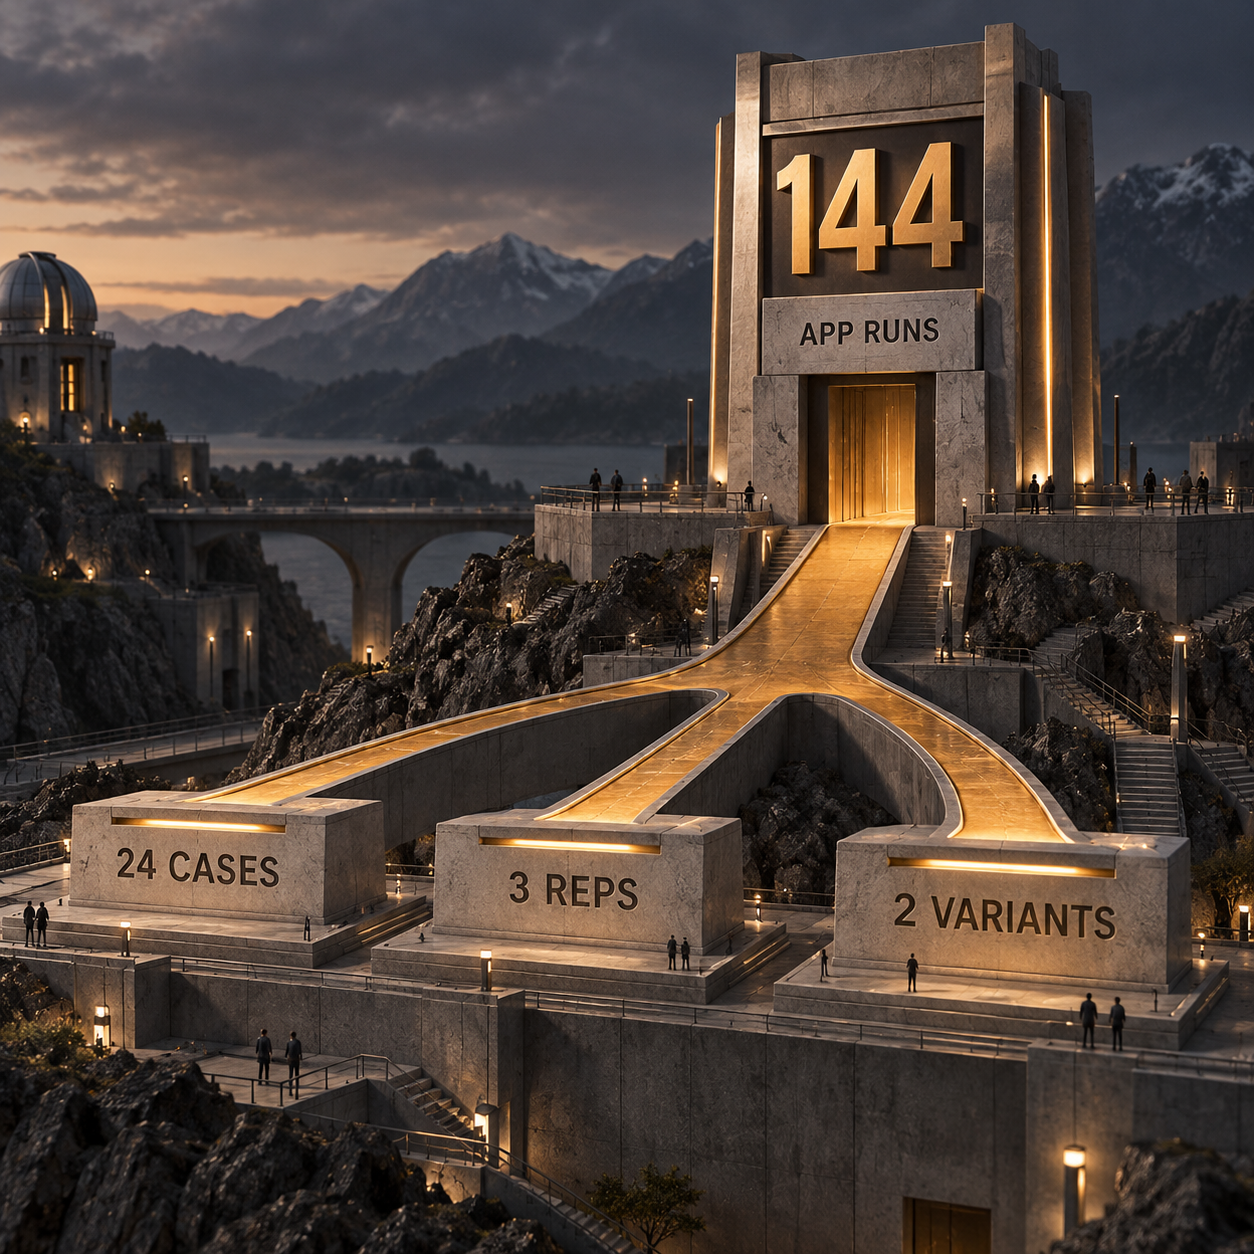
24개 사례 × 3회 반복 × 2개 변형 = 애플리케이션 144회 실행
이는 모델이 채점하기 전, 실패한 요청을 재시도하기 전부터 필요한 최소 실행 횟수입니다. 반복이 필요한 이유는 모델이 같은 입력에도 서로 다른 답을 낼 수 있기 때문입니다. 두 구성을 비교하려면 양쪽의 출력이 모두 필요하므로 변형 수 역시 승수가 됩니다.
채점 방식에 따라 다음 승수가 달라집니다.
- 프로그래밍 방식 채점기: 모델 심사 호출은 0회입니다. 애플리케이션 실행은 144회로 유지됩니다.
- 쌍별 심사기: 사례와 반복마다 한 번의 호출로 2개 변형을 비교하면 심사 호출은 72회입니다. 24 × 3 = 72쌍이기 때문입니다.
- 점별 심사기: 애플리케이션 출력을 하나씩 채점하면 심사 호출은 144회입니다. 재시도나 Claude Code 오케스트레이션 사용량을 제외해도 애플리케이션 144회와 심사기 144회를 합쳐 총 288회의 모델 호출이 됩니다.
hillclimb은 각 라운드에서 새 후보를 실행하므로 차원을 하나 더 추가합니다. 여러 패치를 시도하는 루프라면 성능이 낮아 되돌린 패치도 매번 전체 평가를 거치므로 비용이 듭니다. 최적화 전에 최대 라운드 수와 지출 한도를 정해야 합니다. “점수가 오를 때까지”는 예산이 아닙니다. 점수에 잡음이 있으면 탐색이 계속될 수 있기 때문입니다.
Claude API 가격: 평가 비용은 실측 사용량에서 출발합니다
사례 1건에는 고정 가격이 없으므로, 신뢰할 만한 견적은 유료 파일럿에서 실제로 측정한 사용량 필드로 시작해야 합니다. 어떤 티켓은 짧은 분류 호출 1번으로 끝납니다. 다른 티켓은 긴 컨텍스트, 여러 툴, 재시도, 심사기까지 동원할 수 있습니다. 둘 다 단순히 “평가 사례 1건”으로 가격을 매기면 청구액을 좌우하는 차이가 사라집니다.
Anthropic의 직접 API 요금표는 2026년 9월 29일에 검증했습니다. 아래 가격의 단위는 토큰 100만 개당 금액입니다.
출처: Anthropic의 실시간 Claude API 가격 페이지. Amazon Bedrock 또는 Google Cloud를 사용한다면 이 직접 API 가격을 복사하지 말고 해당 제공업체의 요금표를 적용해야 합니다.
각 파일럿 행은 다음 항목으로 계산합니다.
애플리케이션 신규 입력 + 애플리케이션 출력 + 애플리케이션 캐시 쓰기 + 애플리케이션 캐시 읽기 + 심사기 신규 입력 + 심사기 출력 + 심사기 캐시 쓰기 + 심사기 캐시 읽기 + 유료 서버 측 툴
각 토큰 묶음에 해당 토큰을 생성한 모델의 요율을 곱합니다. 캐시 토큰을 신규 입력에 합치면 안 됩니다. 일반적인 단축 계산법은 5분 캐시 쓰기를 입력 요율의 1.25배, 캐시 읽기를 0.1배로 봅니다. 하지만 현재 요금표에는 중요한 읽기 예외가 있습니다. Fable 5.1은 입력 요율의 0.025배이고, Opus 5.5는 0.05배입니다. 0.1이라는 승수를 그대로 복사하면 둘 다 과대 계산됩니다.
심사기도 같은 원칙으로 계산해야 합니다. 애플리케이션이 Sonnet 5.5를 쓰고 심사기가 Haiku 4.5를 쓴다면 각각의 사용량과 요율을 따로 적용합니다. 애플리케이션에 계약된 클라우드 요율이 있다면 그 계약을 사용합니다. 서버 측 툴이 작업당 비용을 청구하면 이를 별도로 더합니다. 클라이언트 측 툴도 모델 컨텍스트를 늘리므로 토큰 비용에 영향을 줍니다.
여기에는 실측 금액을 제시하지 않습니다. 이번 게시 작업에는 애플리케이션 진입점, 제공업체 계정, 승인된 유료 파일럿이 없었기 때문입니다. 토큰 수를 지어내면 깔끔해 보이는 숫자는 만들 수 있어도 쓸 만한 예산은 만들 수 없습니다. 요금표는 검증했지만, 총실행 비용은 실제 사용량을 측정한 뒤에야 계산할 수 있습니다.
Claude Code 가격 산정은 5건 티켓 파일럿부터
가장 작으면서도 유용한 첫 단계는 기존 지원 요청 라우터의 진입점에 5개 티켓을 통과시킨 뒤, 행 단위 사용량을 살펴보는 것입니다. 5개만으로 운영 환경의 품질을 보증할 수는 없습니다. 다만 전체 스위트에 같은 실수를 반복하기 전에 러너, 채점기, 트레이스, 비용 계산이 올바르게 연결됐는지 확인하기에는 충분합니다.
고객 데이터를 복사하지 않고도 서로 다른 라우팅 동작을 확인할 수 있도록 다음 5개의 합성 티켓을 사용합니다.
- 고객이 결제 포털을 열 수 없습니다.
- 카드가 2번 청구된 것으로 보입니다.
- 고객이 연간 플랜의 환불 가능 여부를 묻습니다.
- 운영 환경 장애를 긴급 에스컬레이션해야 합니다.
- 엔터프라이즈 구매자가 계약 변경을 요청합니다.
이 사례들은 제안하는 파일럿 세트이지, 실제 테스트 결과가 아닙니다. 운영 라우터가 사용하는 것과 같은 함수, 엔드포인트, 스크립트로 입력하되 외부 부작용은 격리해야 합니다. 실제 흐름에서 이메일을 보내거나, 데이터베이스를 바꾸거나, 엔지니어를 호출할 수 있다면 그 부작용만 테스트 픽스처로 대체합니다. 프롬프트 조립, 모델 호출, 툴, 재시도, 응답 파싱은 운영 환경과 동일하게 유지해야 합니다. 그렇지 않으면 엉뚱한 시스템의 비용을 측정하게 됩니다.
진입점과 과금 주체 확인
애플리케이션 함수 또는 엔드포인트, 모델, 제공업체, 계정, 프롬프트, 툴, 출력 형태를 기록합니다. Claude Code 자체의 인증 방식도 함께 기록합니다. 그래야 어느 쪽이든 실행하기 전에 플랜 사용 한도와 애플리케이션 API 사용량을 분리할 수 있습니다.
5개 입력과 채점기 승인
모든 합성 티켓을 검토하고 예상 라우트를 승인합니다. 고정 큐 레이블에는 프로그래밍 방식의 채점기를 사용합니다. 코드로 확인할 수 없는 속성에만 모델 심사기를 추가하고, 테스트 대상 모델이 자기 결과를 심사하게 해서는 안 됩니다.
유료 파일럿 1회 실행
5개 사례 × 1회 반복 × 1개 애플리케이션 변형을 실행하면 애플리케이션 실행은 5회입니다. 공개된 워크플로는 첫 유료 실행 전에 명확한 승인을 요구합니다. 승인된 예산이 없다면 가격을 주장하지 말고, 실행 가능한 드라이런 구성까지만 만든 뒤 여기서 멈춥니다.
콘솔의 요약 대신 개별 행 확인
results.jsonl과 트레이스 하나를 엽니다. 성공한 행의model과usage가 비어 있지 않은지, 진입점이stop_reason을 노출하는지, 애플리케이션과 심사기 사용량을 구분할 수 있는지 확인합니다. 캐시 쓰기와 캐시 읽기 필드는 입력에 합치지 말고 그대로 보존해야 합니다. 0이 아니어야 할 값이 0이라면 무료 호출이 아니라 러너 버그입니다.전체 규모의 비용 계산과 승인
실제 제공업체 요율로 5개 행의 비용을 계산하고, 사례당 최솟값·중앙값·최댓값을 보고한 다음, 승인된 사례 수와 반복 횟수를 곱합니다. 선택한 채점 방식, 재시도, hillclimb 한도도 추가합니다. 전체 실행 승인을 요청하기 전에 이 공식을 먼저 제시해야 합니다.
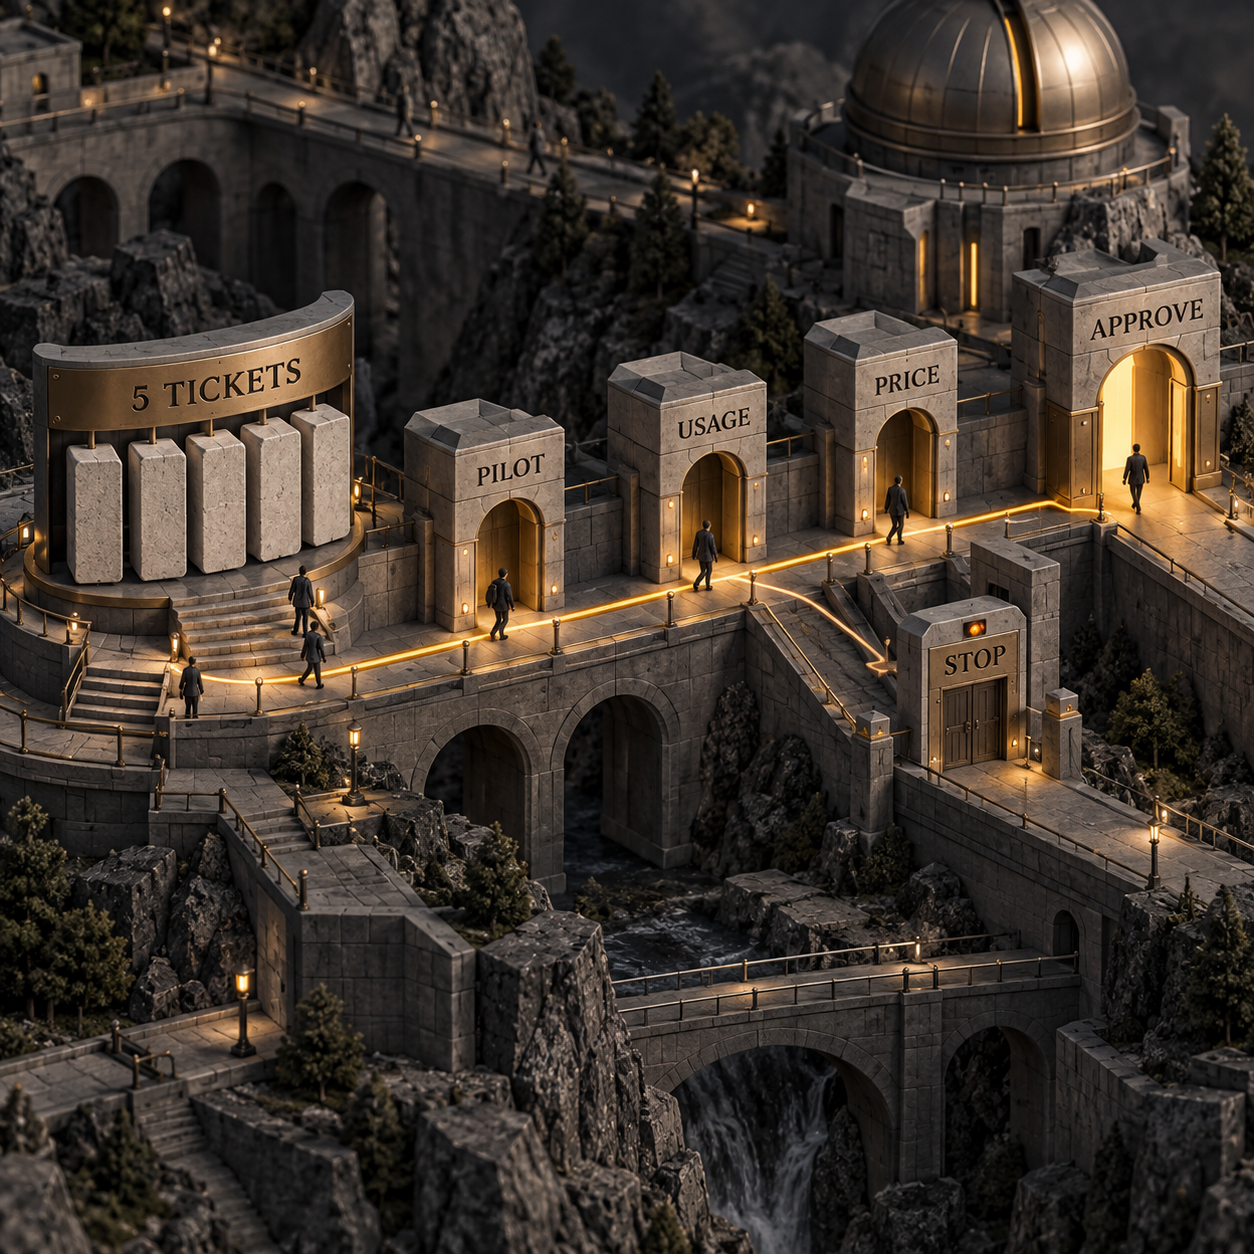
이 순서는 공개된 구현과 같습니다. 유료 파일럿 1회를 측정하고 사용량을 살핀 뒤에야 전체 스위트의 비용을 추정합니다. 캐시 상태, 툴 루프, 추론 강도, 재시도, 출력 길이는 평균적인 애플리케이션이 아니라 이 애플리케이션에 속하는 값이므로 과거 평균으로 대신할 수 없습니다.
개발자·운영자·구매자에게 필요한 대응
개발자는 애플리케이션 경계에서 비용이 보이게 만들어야 합니다. 진입점이 model, usage, stop_reason을 숨긴다면 전체 러너를 작성하기 전에 최종 이벤트에 해당 필드를 추가합니다. 제공업체가 제공하는 캐시 필드를 그대로 보존하고, 심사기 사용량은 별도로 붙입니다. 팀이 흔히 막히는 지점은 불완전한 행을 바탕으로 멋진 보고서를 만드는 순간입니다. 전체 실행이 끝나고 나면 누락된 토큰 묶음을 복원하기 어려운 경우가 많습니다.
운영자는 전체 실행 횟수 계산과 승인 관문을 맡아야 합니다. 사례 수, 반복 횟수, 변형 수, 채점기 호출 수, 재시도 정책, 최대 hillclimb 라운드를 한 페이지에 정리하도록 요구합니다. “24개 사례”만 적힌 예산은 불완전합니다. 애플리케이션 144회 실행, 채점 방식, 사례당 실측 사용량, 중단 한도가 들어간 예산이어야 검토할 수 있습니다.
구매자는 제시된 가격에 어느 계층까지 포함됐는지 물어야 합니다. Claude Code 오케스트레이션, 애플리케이션 모델, 심사기, 클라우드 제공업체의 가산 요금, 툴 비용, 재시도, 최적화 라운드가 모두 포함됐습니까? 판매자는 전체 지출에서 큰 비중을 차지하는 애플리케이션 실행 비용을 제외하고 저렴한 심사기 비용만 정직하게 제시할 수도 있습니다. 총액만 받지 말고 파일럿 행과 계산식을 요구해야 합니다.
지금 시작할 팀, 기다릴 팀, 플러그인 방식을 유지할 팀
애플리케이션에 안정적인 진입점이 하나 있고, 내려야 할 결정이 있으며, 안전하게 검토할 수 있는 대표 사례 5개가 있다면 지금 시작할 수 있습니다. 프롬프트 이전, 모델 변경, 라우팅 정책 개정, 툴 변경은 구체적인 변경 전후를 평가할 수 있으므로 좋은 대상입니다.
러너가 운영 로직을 안전하게 호출할 수 없다면 기다려야 합니다. 먼저 데이터베이스 쓰기, 외부 메시지, 파괴적인 툴, 변경 가능한 외부 상태를 격리합니다. 입력이나 채점기를 승인할 사람이 없어도 기다려야 합니다. 잘못된 작업을 측정하는 평가는 실행 횟수를 늘려도 바로잡을 수 없습니다.
Claude Code 플러그인이 가치를 더하는지가 질문이라면 네이티브 플러그인 방식을 유지해야 합니다. 그 워크플로는 설계상 WITH-plugin 세션과 W/OUT-plugin 세션을 비교합니다. 이 사이트의 평가로 Claude Code 플러그인을 테스트하는 방법에서 별도의 대조 실험을 다룹니다. 애플리케이션 build-eval은 앱 진입점을 위한 것이며, 플러그인 대조군을 일반 벤치마크로 대체하기 위한 도구가 아닙니다.
이미 신뢰할 수 있는 러너와 채점기가 있다면 영향을 받지 않습니다. 그대로 재사용하면 됩니다. 공개 구현도 기존 구성 요소를 새 프레임워크로 교체하기보다 조정해 쓰는 방식을 명시적으로 선호합니다. 새로운 테스트 스택보다 승인 절차, 사용량 수집, hillclimb 루프가 더 유용한 추가 요소일 수 있습니다.
과장된 기대는 무엇인가
이 워크플로는 설정의 번거로움을 줄일 뿐, 평가를 자동화하거나 객관적으로 만들거나 무료로 만들지는 않습니다. Claude가 사례를 제안할 수는 있지만, 운영 환경을 대표하는지 결정하는 일은 사람이 해야 합니다. 채점기를 제안할 수도 있지만, 정답 사례는 통과하고 빈 답변은 실패하는지, 모델 심사기가 정확성보다 문체에 높은 점수를 주고 있지는 않은지 사람이 확인해야 합니다.
hillclimb 역시 무료 최적화 도구가 아닙니다. 의도적으로 더 많은 변형을 실행하고, 실패를 읽고, 패치를 제안하고, 다시 평가합니다. 비공개 테스트 분할은 한 종류의 과적합을 막아 주지만, 충분한 사례와 반복 횟수, 지출 한도까지 대신해 주지는 않습니다.
보고서는 각 행이 완전할 때만 증거가 됩니다. 멋진 report.html이 있어도 그 옆 행의 usage 필드가 비어 있다면 비용 질문에는 답할 수 없습니다. 가정한 토큰 수에서 도출한 금액도 더 낫지 않습니다. 유료 파일럿 전까지 제시할 수 있는 방어 가능한 결과물은 실행 계획과 현재 요금표이며, 실측 총액은 비워 둬야 합니다.
월요일에 바로 할 일
누군가에게 막연히 “평가를 만들어 달라”고 하지 말고, 담당자 1명에게 범위가 정해진 파일럿을 맡깁니다. 월요일에는 지원 요청 라우터의 기존 진입점을 고르고, 위의 합성 티켓 5개를 작성한 뒤, 고정 레이블을 확인하는 프로그래밍 방식의 채점기를 사용합니다. 지원 정책을 담당하는 운영자와 입력 및 예상 라우트를 함께 검토합니다.
그런 다음 애플리케이션을 정확히 5회 실행할 수 있도록 승인을 요청합니다. results.jsonl, 트레이스 1개, 모든 사용량 묶음, stop_reason을 확인합니다. 실제 제공업체 요율로 각 행의 가격을 계산합니다. 그 후에야 24개 사례, 3회 반복, 2개 변형으로 이루어진 전체 규모와 함께 심사기·재시도·hillclimb 한도를 제안해야 합니다.
판단 기준은 명확합니다. 완전한 파일럿 사용량이 없다면 전체 실행 예산도 승인하지 않습니다.
- 마지막 업데이트
- 2026년 9월 29일
- 카테고리
- Build
Google에서 이 사이트를 우선하기


omidsaffari.com을 선호 소스로 지정하면 Google이 Top Stories, AI Overviews, AI Mode에서 우선적으로 보여 줍니다.

AI 쇼핑 에이전트를 위한 Shopify WebMCP 결제 가이드
Shopify Checkout WebMCP로 AI 쇼핑 에이전트가 결제 상태를 읽고 수정한 뒤 구매자 승인 후 주문을 완료하는 방법을 정리했습니다. 툴 탐색, 전체 상태 업데이트, Shop Pay 처리, 오류 복구, 명시적 동의 게이트까지 안전한 구현 흐름을 단계별로 살펴봅니다.2026년 9월 29일Build
Cloudflare CLI 사용법: cf 설치부터 Worker 마이그레이션까지
Cloudflare CLI 사용법을 설치, 인증, 명령 검색, JSON 출력 순서로 정리합니다. cf로 Worker를 만들고 Vite 프로젝트를 마이그레이션하는 방법, Wrangler를 계속 써야 하는 경우, 안전한 자동화 원칙까지 실전 예제로 살펴봅니다.2026년 9월 29일Build
Krisp 리뷰: AI 회의록보다 통화 품질을 먼저 검증해야 하는 이유
Krisp가 화상회의의 마이크 노이즈 제거와 AI 회의록 업무를 실제로 개선하는지 살펴봅니다. 가상 오디오 라우팅, 가격, 보안·데이터 경로, 7일 무료 체험에서 반드시 검증할 항목까지 구매 전에 필요한 판단 기준을 정리했습니다. Core와 Advanced의 좌석 비용도 계산했습니다.2026년 9월 29일Build
이메일 관리 프로그램 SaneBox 가격: 요금제와 실제 비용
이메일 관리 프로그램 SaneBox의 Snack·Lunch·Dinner 요금과 계정·기능별 차이, 월간·연간·2년 선결제 총액을 비교했습니다. 7일 체험으로 긴급 메일 누락을 점검하는 법과 업그레이드가 필요한 경우, 기존 메일 규칙을 유지할 때를 확인하세요.2026년 9월 29일Build
Marblism 가격 총정리: 좌석이 아니라 업무량으로 고르는 요금제
Marblism 가격은 월간 결제 기준 $44부터 시작하지만, 요금제 선택 기준은 직원 수가 아니라 업무별로 차감되는 공유 시간입니다. 50시간부터 10,000시간까지의 구간, 작업별 차감량, 숨은 비용, 용량 소진 시 멈추는 기능까지 실제 계산으로 정리했습니다.2026년 9월 28일Build
Fyxer 가격 분석: Starter와 Professional, 어느 쪽이 맞을까?
Fyxer 가격은 Starter 월 $30, Professional 월 $50부터입니다. 연간 결제 비용, 좌석별 총액, 두 번째 받은편지함의 추가 부담과 7일 체험의 손익분기점을 비교하고, 환불 조건과 주요 AI 이메일 비서 대안까지 짚어 어떤 요금제가 맞는지 판단합니다.2026년 9월 28일Build
Cloudflare Workers 무료 플랜, 프리뷰는 어디까지 무료인가
Cloudflare Workers 무료 플랜에서 Worker Previews가 제공하는 범위와 숨은 비용을 정리했습니다. Preview 100개와 배포 100개의 의미, 요청·CPU·빌드·스토리지·AI·Containers 한도, Free와 Paid 전환 기준까지 한 번에 확인하세요.2026년 9월 28일Build