Claude Code preço: quanto custa rodar o build-eval?
Entenda quando o build-eval do Claude Code pode ser gratuito, onde surgem cobranças de API e como estimar o custo real antes de rodar a avaliação.




Não: o fluxo de build-eval da Claude API é público, mas a avaliação que ele orquestra não é automaticamente gratuita. Se você chegou aqui pesquisando “Claude Code preço” e quer saber se o build-eval é grátis, separe as instruções gratuitas do trabalho cobrado: 24 casos × 3 repetições × 2 variantes de modelo resultam em 144 execuções do aplicativo antes de qualquer chamada opcional de juiz ou nova tentativa. Como não havia um piloto financiado do aplicativo para esta verificação, 144 é o resultado da conta — não um custo medido em dólares.
Claude Code preço: o build-eval é gratuito?
Os arquivos do fluxo podem ser consultados de graça; executar uma avaliação pode consumir uso pago de modelos em três pontos diferentes. O Claude Code pode descontar o uso da franquia de uma assinatura ou cobrar de uma conta por consumo, o aplicativo avaliado chama o próprio provedor de modelos e um juiz opcional baseado em modelo faz outra série de chamadas. Um avaliador determinístico local elimina essa terceira conta, mas não as chamadas do aplicativo.
Essa distinção é importante porque build-eval não é um pacote de créditos gratuitos para avaliações. Trata-se de um fluxo guiado do Claude Code para criar uma avaliação em torno do aplicativo que você já tem. Ele ajuda a identificar o ponto de entrada, montar os casos, escolher o avaliador, escrever ou adaptar um executor e gerar resultados que possam ser revisados. A implementação pública está disponível no repositório de skills da Anthropic, mas as chamadas feitas pelo executor resultante seguem as regras de cobrança da conta e do provedor usados.
Portanto, a resposta segura depende do contexto: projetar a avaliação pode ser gratuito; executá-la só sai de graça quando não há chamadas cobradas ou quando todo o uso cabe em uma franquia que você já paga. Mesmo nesse caso, “grátis” descreve o impacto marginal na fatura, não uma capacidade ilimitada.
O que mudou em 28 e 29 de setembro
A Anthropic transformou a criação de avaliações e a otimização iterativa em dois fluxos explícitos do Claude Code. O guia de 28 de setembro de 2026 apresentou /claude-api build-eval para criar uma avaliação e /claude-api hillclimb para melhorar um aplicativo com base nela. A implementação foi publicada no dia 29, às 02:20:03 UTC, no commit 8a1541c4.
O build-eval parte de um único fluxo do aplicativo. Ele lê o ponto de entrada existente, pergunta de onde devem vir os casos representativos, sugere o avaliador mais barato que consiga medir a saída corretamente e exige aprovação explícita tanto das entradas quanto do método de avaliação. O resultado fica registrado como código e evidências no seu repositório, incluindo um executor, results.jsonl, traces e um relatório.
O hillclimb entra depois. Ele divide os casos entre um conjunto de treino e outro de teste reservado, altera uma superfície permitida por vez, executa a avaliação novamente e reverte mudanças que pioram o resultado ou melhoram apenas o conjunto de treino. Esse processo pode otimizar prompts, escolha de modelo, nível de esforço, ferramentas ou o código que encapsula o aplicativo, mas cada variante testada representa novas execuções.
A mudança duradoura não é que “as avaliações agora são grátis”. O que mudou é que o Claude Code consegue montar um fluxo disciplinado e auditável de avaliação sem exigir um framework separado. A forma de cobrança por trás desse fluxo continua existindo.
O build-eval da Claude API tem quatro frentes de cobrança
Um orçamento útil mantém quatro frentes separadas, porque apenas uma delas é claramente gratuita. Juntar tudo em um único “custo do Claude” torna impossível explicar para onde foi o dinheiro.
- O fluxo público. O guia e os arquivos da skill são públicos. Apenas consultá-los, revisar os arquivos locais gerados e executar uma verificação determinística local não cria cobranças de tokens da Claude API.
- A orquestração do Claude Code. O Claude Code lê o repositório, faz perguntas, escreve o executor e ajuda a inspecionar os resultados. Assinantes consomem a franquia do plano; sessões autenticadas por API consomem tokens cobrados por uso. O custo de sessão exibido para usuários da API é uma estimativa, enquanto assinantes veem o consumo do plano, como explica a documentação de custos do Claude Code da Anthropic. Os detalhes atuais sobre planos e autenticação estão no guia de preços do Claude Code do site.
- O aplicativo avaliado. O executor deve chamar o ponto de entrada existente do aplicativo em vez de reconstruir uma requisição simplificada ao modelo. Assim, cada ticket de suporte, nova tentativa, ciclo de ferramentas e repetição consome recursos do provedor e da conta já usados pelo aplicativo.
- O avaliador. Um rótulo fixo, uma validação de schema, um teste unitário ou uma asserção sobre o estado final podem rodar localmente. Respostas abertas talvez exijam um juiz de modelo pontual ou comparativo, o que acrescenta o próprio consumo de entrada, saída, cache e possíveis ferramentas.
O primeiro lugar para economizar não é um juiz mais barato. É optar por um avaliador programático sempre que a saída tiver um formato correto e restrito. Um roteador de suporte que precisa devolver apenas uma fila de uma lista fixa pode ser verificado por código. Pedir a outro modelo que decida se billing é igual a billing gasta dinheiro para responder a uma pergunta determinística.
Use um juiz de modelo quando a propriedade realmente exigir julgamento — por exemplo, para verificar se um resumo de escalonamento preserva a urgência do cliente sem inventar fatos. Ainda assim, mantenha o consumo do aplicativo e o do juiz em campos separados. Um juiz barato pode esconder uma execução cara do aplicativo, e o inverso também é verdadeiro.
Na conta: 24 casos viram 144 execuções do aplicativo
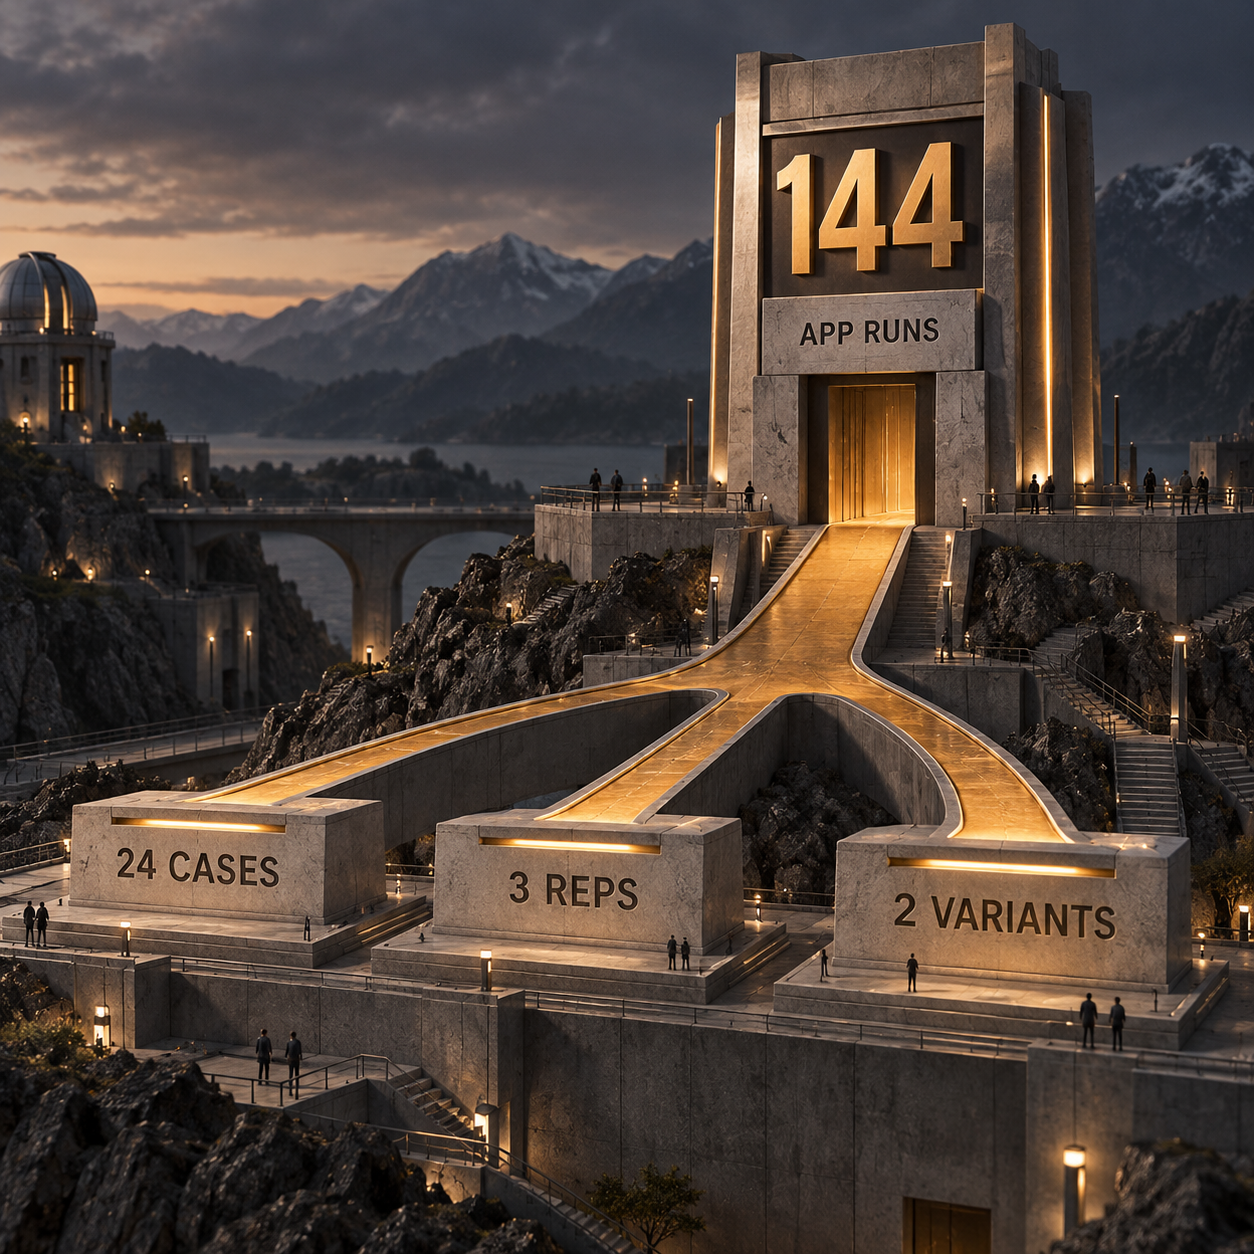
A quantidade de casos é apenas o primeiro multiplicador. O guia de lançamento da Anthropic traz um exemplo de roteamento de caixa de entrada com 24 entradas. Ao comparar 2 variantes de modelo e repetir cada caso 3 vezes, o número de execuções do aplicativo é:
24 casos × 3 repetições × 2 variantes = 144 execuções do aplicativo
Esse é o piso de execuções para esse desenho, antes de qualquer avaliação feita por modelo e antes de novas tentativas após uma falha. As repetições são importantes porque um modelo pode gerar respostas diferentes para a mesma entrada. As variantes também importam porque uma comparação precisa das saídas das duas configurações.
O tipo de avaliador determina o próximo multiplicador:
- Avaliador programático: 0 chamadas a um juiz de modelo. A rodada continua com 144 execuções do aplicativo.
- Juiz comparativo: 72 chamadas ao juiz se uma chamada comparar as duas variantes para cada caso e repetição, pois 24 × 3 = 72 pares.
- Juiz pontual: 144 chamadas ao juiz se cada saída do aplicativo for avaliada separadamente. O total passa a 288 chamadas de modelo: 144 do aplicativo mais 144 do juiz, antes de novas tentativas ou do uso de orquestração do Claude Code.
O hillclimbing acrescenta outra dimensão, porque cada rodada executa um novo candidato. Um ciclo que testa vários patches pode consumir várias passagens completas pela avaliação, mesmo quando todos os patches perdedores são revertidos. Defina um limite de rodadas e um teto de gastos antes de otimizar. “Parar quando a pontuação melhorar” não é um orçamento: resultados ruidosos podem manter o ciclo em busca de outra solução.
O preço da avaliação pela Claude API começa pelo uso medido
Um caso não tem preço fixo; por isso, qualquer estimativa defensável começa pelos campos de uso real de um piloto pago. Um ticket pode exigir uma única chamada curta de classificação. Outro pode acionar um contexto longo, várias ferramentas, novas tentativas e um juiz. Precificar ambos como “um caso de avaliação” apaga justamente a diferença que determina o valor da fatura.
A tabela de preços da API direta da Anthropic foi verificada em 29 de setembro de 2026. Os valores abaixo são por milhão de tokens:
Fonte: página atual de preços da Claude API da Anthropic. Para Amazon Bedrock ou Google Cloud, use a tabela do próprio provedor em vez de copiar os preços da API direta.
Para cada linha do piloto, calcule:
entrada nova do aplicativo + saída do aplicativo + gravações de cache do aplicativo + leituras de cache do aplicativo + entrada nova do juiz + saída do juiz + gravações de cache do juiz + leituras de cache do juiz + ferramentas pagas executadas no servidor
Multiplique cada grupo de tokens pela tarifa do modelo que o gerou. Não misture tokens de cache com entrada nova. O atalho genérico diz que uma gravação de cache de 5 minutos custa 1.25 vez o valor da entrada e que uma leitura custa 0.1 vez, mas a tabela atual traz exceções importantes para leitura: no Fable 5.1, ela equivale a 0.025 vez a tarifa de entrada; no Opus 5.5, a 0.05 vez. Reaproveitar o multiplicador de 0.1 superestimaria os dois.
A mesma disciplina vale para o juiz. Se o aplicativo usar Sonnet 5.5 e o juiz usar Haiku 4.5, precifique cada um com base no próprio consumo e na própria tarifa. Se o aplicativo estiver sujeito a uma tarifa contratada com um provedor de nuvem, use esse contrato. Se uma ferramenta executada no servidor cobrar por operação, some esse valor à parte. Ferramentas executadas no cliente ainda aumentam o contexto do modelo e, portanto, a conta de tokens.
Não há aqui um valor medido em dólares porque esta publicação não contava com um ponto de entrada do aplicativo, uma conta no provedor nem um piloto financiado e aprovado. Inventar uma quantidade de tokens produziria um número elegante, mas um orçamento inútil. A tabela de preços foi verificada; o total da execução precisa esperar por dados reais de uso.
Build-eval no Claude Code: calcule primeiro um piloto de cinco tickets
O menor passo útil é executar um piloto de cinco tickets pelo ponto de entrada já usado pelo roteador de suporte e, em seguida, examinar o consumo linha por linha. Cinco casos não bastam para certificar a qualidade em produção. Bastam, porém, para confirmar que o executor, o avaliador, o trace e a contabilização de custos estão conectados corretamente antes de reproduzir um erro em toda a suíte.
Use cinco tickets sintéticos que exercitem diferentes comportamentos de roteamento sem copiar dados de clientes:
- Um cliente não consegue abrir o portal de cobrança.
- Um cartão parece ter sido cobrado duas vezes.
- Um cliente quer saber se um plano anual é reembolsável.
- Uma indisponibilidade em produção exige escalonamento urgente.
- Um comprador corporativo solicita uma alteração no contrato.
Esses casos formam uma proposta de piloto, não o relato de um teste realizado. Eles devem entrar pela mesma função, endpoint ou script usado pelo roteador em produção, com os efeitos externos isolados. Se o fluxo real puder enviar e-mails, alterar um banco de dados ou acionar um engenheiro, substitua apenas esse efeito colateral por uma fixture de teste. Preserve a montagem do prompt, a chamada ao modelo, as ferramentas, as novas tentativas e o parsing da resposta como em produção — caso contrário, o piloto estará precificando o sistema errado.
Confirme o ponto de entrada e a identidade de cobrança
Registre a função ou o endpoint do aplicativo, o modelo, o provedor, a conta, o prompt, as ferramentas e o formato de saída. Registre também como o próprio Claude Code está autenticado. Isso separa a franquia do plano do uso da API pelo aplicativo antes que qualquer um dos dois comece.
Aprove as cinco entradas e o avaliador
Revise cada ticket sintético e aprove a rota esperada. Para um rótulo de fila fixo, use um avaliador programático. Acrescente um juiz de modelo apenas para uma propriedade que o código não consiga verificar e nunca deixe o modelo avaliado julgar a si próprio.
Execute um piloto financiado
Execute 5 casos × 1 repetição × 1 variante do aplicativo, totalizando 5 execuções. O fluxo publicado exige um “sim” explícito antes da primeira passagem paga. Sem orçamento aprovado, pare aqui com uma configuração pronta para rodar, mas ainda não executada, em vez de alegar um preço.
Inspecione a linha, não o resumo do console
Abra
results.jsonle um trace. Confirme que as linhas bem-sucedidas contêm valores não vazios emmodeleusage, que o ponto de entrada expõestop_reasone que é possível distinguir o consumo do aplicativo daquele do juiz. Os campos de gravação e leitura de cache devem ser preservados, não incorporados à entrada. Um zero onde não deveria haver zero indica uma falha no executor, não uma chamada gratuita.Calcule e aprove o formato completo
Calcule as cinco linhas com as tarifas reais do provedor, informe o custo mínimo, a mediana e o máximo por caso e, então, multiplique pelas quantidades aprovadas de casos e repetições. Acrescente o formato escolhido para o avaliador, as novas tentativas e o limite do hillclimb. Apresente essa fórmula antes de solicitar a aprovação da execução completa.
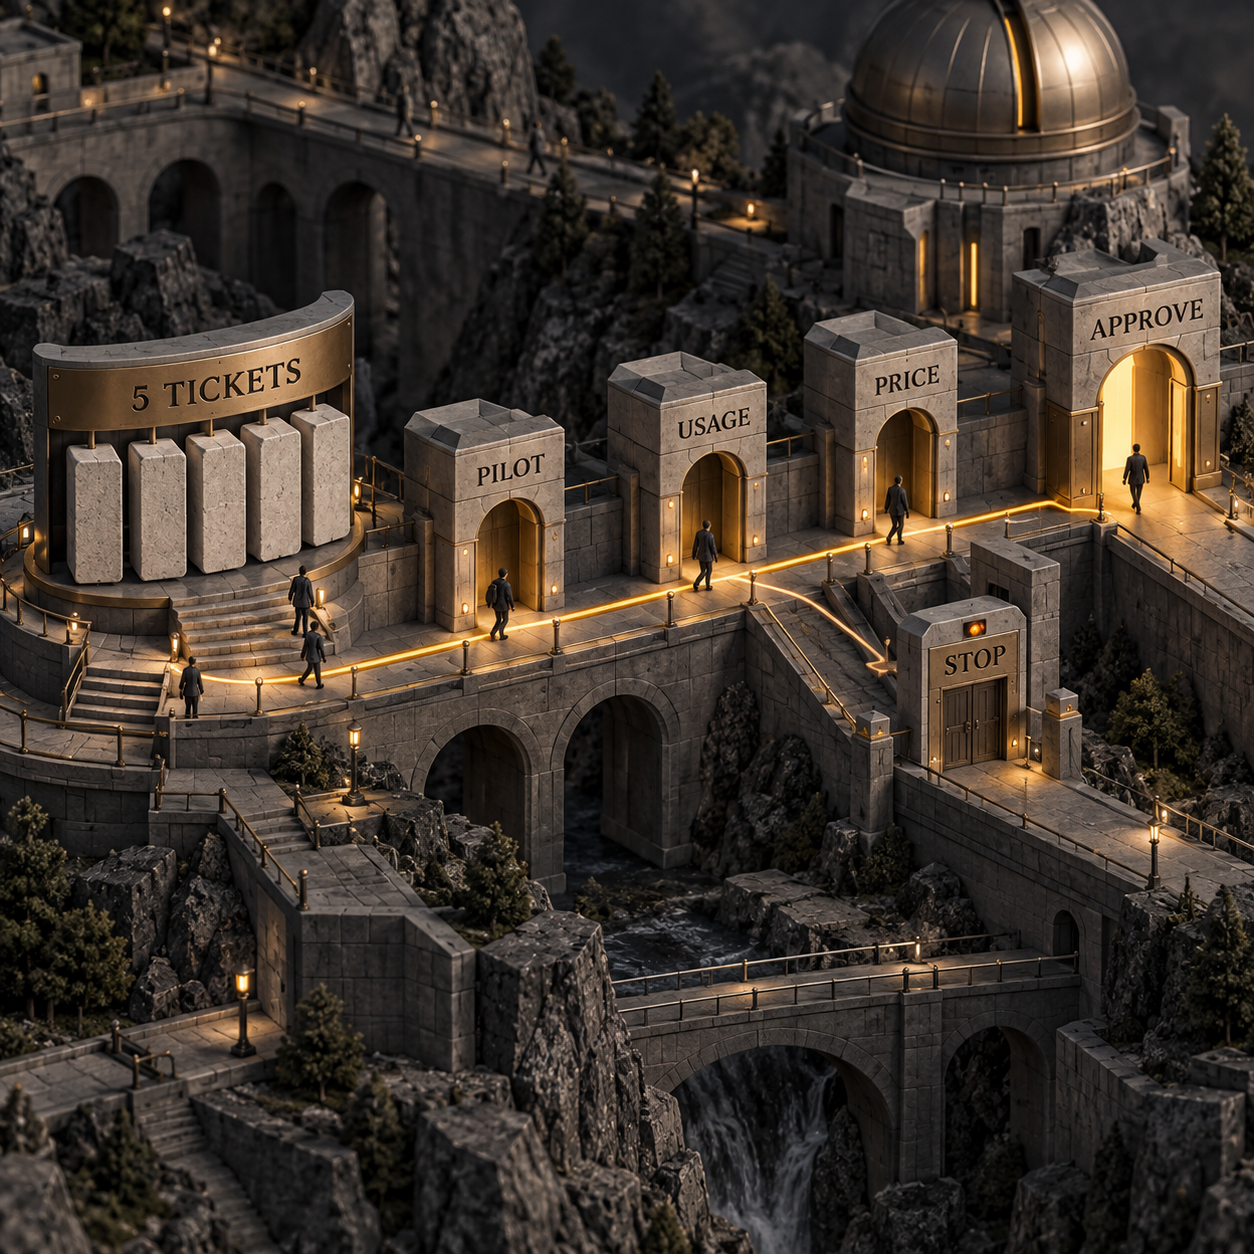
Essa ordem segue a implementação publicada: meça um piloto financiado, examine o consumo e só depois estime a suíte. Médias históricas não substituem esse trabalho, porque o estado do cache, os ciclos de ferramentas, o nível de esforço, as novas tentativas e o tamanho da saída pertencem a este aplicativo — não a um aplicativo médio.
O que isso muda para quem desenvolve, opera e compra
Quem desenvolve deve tornar o custo observável na fronteira do aplicativo. Se o ponto de entrada ocultar model, usage ou stop_reason, acrescente esses campos ao evento final antes de escrever o executor completo. Preserve os campos de cache nativos do provedor e registre o consumo do juiz separadamente. O obstáculo recorrente é um relatório impecável apoiado em linhas incompletas: depois que a execução termina, muitas vezes já não é possível reconstruir os grupos de tokens ausentes.
Quem opera deve assumir a multiplicação e o controle de aprovação. Peça, em uma única página, os casos, as repetições, as variantes, as chamadas do avaliador, a política de novas tentativas e o número máximo de rodadas de hillclimb. Um orçamento que informa apenas “24 casos” está incompleto. Um orçamento com 144 execuções do aplicativo, o formato do avaliador, o consumo medido por caso e um limite de parada pode ser revisado.
Quem compra deve perguntar quais camadas estão incluídas no preço apresentado. O valor inclui a orquestração do Claude Code, o modelo do aplicativo, o juiz, o acréscimo do provedor de nuvem, as cobranças de ferramentas, as novas tentativas e as rodadas de otimização? Um fornecedor pode, honestamente, cotar um juiz barato e deixar de fora as execuções do aplicativo que dominam o gasto. Exija as linhas do piloto e a fórmula, não apenas um total.
Quem deve agir agora, esperar ou seguir com o fluxo de plugins
Aja agora se o aplicativo tiver um ponto de entrada estável, uma decisão a ser tomada e cinco casos representativos que possam ser revisados com segurança. Uma migração de prompt, uma troca de modelo, uma revisão da política de roteamento ou uma mudança de ferramenta são bons alvos, porque a avaliação consegue comparar um antes e um depois concretos.
Espere se o executor não puder chamar a lógica de produção com segurança. Primeiro, isole gravações no banco de dados, mensagens enviadas para fora, ferramentas destrutivas e qualquer estado externo mutável. Também espere se ninguém puder aprovar as entradas ou o avaliador. Aumentar o número de execuções não salva uma avaliação que mede a tarefa errada.
Continue no fluxo nativo de plugins se a pergunta for se um plugin do Claude Code agrega valor. Esse fluxo compara sessões WITH-plugin e W/OUT-plugin por definição. O guia do site sobre como testar plugins do Claude Code com avaliações apresenta esse controle separado. O build-eval de aplicativos serve para o ponto de entrada do aplicativo, não para substituir o controle do plugin por um benchmark genérico.
Nada muda para quem já tem um executor e um avaliador confiáveis. Reaproveite os dois. A implementação pública privilegia explicitamente a adaptação de componentes existentes em vez da troca por um novo framework. O ganho pode estar na disciplina de aprovação, na captura do consumo ou no ciclo de hillclimb, e não em uma nova pilha de testes.
O que é exagero
O fluxo reduz o atrito de configuração; não torna a avaliação automática, objetiva nem gratuita. O Claude pode sugerir casos, mas uma pessoa ainda precisa decidir se eles representam a produção. Ele pode sugerir um avaliador, mas alguém precisa confirmar que uma resposta de referência é aprovada, que uma resposta nula reprova e que um juiz de modelo não está premiando estilo no lugar de correção.
O hillclimbing tampouco é um otimizador gratuito. De propósito, ele executa mais variantes, lê as falhas, sugere patches e avalia tudo novamente. O conjunto reservado protege contra uma forma de overfitting, mas não elimina a necessidade de casos suficientes, repetições suficientes nem de um teto de gastos.
O relatório só é evidência quando suas linhas estão completas. Um belo report.html ao lado de campos usage vazios não responde à pergunta sobre custos. Um total em dólares derivado de uma quantidade presumida de tokens não é melhor. Antes de um piloto financiado, o único resultado defensável é um plano de execução acompanhado da tabela de preços atual, deixando em branco o total que ainda precisa ser medido.
O que fazer na segunda-feira
Defina um responsável por um piloto com limites claros, em vez de dar uma instrução vaga para “criar avaliações”. Na segunda-feira, escolha o ponto de entrada já usado pelo roteador de suporte, escreva os cinco tickets sintéticos acima e use um avaliador programático de rótulo fixo. Revise as entradas e as rotas esperadas com quem responde pela política de suporte na operação.
Em seguida, peça aprovação para fazer exatamente 5 execuções do aplicativo. Examine results.jsonl, um trace, todos os grupos de consumo e stop_reason. Calcule o preço dessas linhas com a tarifa real do provedor. Só depois proponha o formato de 24 casos, 3 repetições e 2 variantes, com limites para o juiz, as novas tentativas e o hillclimb.
A regra de decisão é direta: sem dados completos de uso no piloto, não há aprovação de orçamento para a execução completa.
- Última atualização
- 29 de set. de 2026
- Categoria
- Build
Prefira este site no Google


Marque omidsaffari.com como fonte preferida e o Google destaca o site para você em Top Stories, AI Overviews e AI Mode.

Checkout Shopify com WebMCP: guia para agentes de IA
Entenda como agentes de IA usam o Checkout WebMCP da Shopify para ler, atualizar e concluir pedidos com confirmação explícita e estado sempre atualizado.29 de set. de 2026Build
Cloudflare CLI na prática: instalação, comandos e migração
Aprenda a instalar o Cloudflare CLI, autenticar sua conta, encontrar comandos e testar um Worker com saída JSON sem abandonar o Wrangler antes da hora.29 de set. de 2026Build
Krisp vale a pena? Análise de preço, áudio e privacidade
Krisp vale a pena? Confira preços, limites, rota de áudio e privacidade e descubra quando o cancelamento de ruído compensa em chamadas de trabalho.29 de set. de 2026Build
SaneBox: preços, planos e análise do organizador de email
Veja os preços e planos do organizador de email SaneBox, compare Snack, Lunch e Dinner e descubra quando a assinatura realmente vale a pena para sua empresa.29 de set. de 2026Build
Marblism preço em 2026: o plano certo depende das tarefas
Veja o preço do Marblism, como as horas são cobradas por tarefa e qual plano escolher para e-mails, conteúdo, leads, chamadas e automações em 2026.28 de set. de 2026Build
Fyxer AI: preços, planos e quando vale a pena
Veja quanto custa o Fyxer AI, o que muda entre Starter e Professional e quantos minutos o app precisa economizar por mês para justificar a assinatura.28 de set. de 2026Build
Cloudflare Workers Free: os Worker Previews são grátis?
Cloudflare Workers Free inclui 100 Previews por Worker, mas execução, builds, armazenamento, IA e Containers seguem limites e preços próprios.28 de set. de 2026Build