Prix API Claude : le vrai coût de Build Eval
Prix API Claude : Build Eval est public, mais son exécution reste payante. Voici comment chiffrer Claude Code, l’application, le juge et un pilote.




Non : le workflow build-eval de l’API Claude est public, mais l’évaluation qu’il orchestre n’est pas gratuite par défaut. Pour comprendre le prix API Claude de Build Eval, il faut distinguer les instructions accessibles sans frais du travail facturé : 24 cas × 3 répétitions × 2 variantes de modèle représentent 144 exécutions de l’application, avant même les éventuels appels d’un juge ou les nouvelles tentatives. Aucun pilote applicatif financé n’était disponible pour cette vérification : 144 est donc un résultat arithmétique, pas un montant mesuré en dollars.
Prix API Claude : Build Eval est-il vraiment gratuit ?
Les fichiers du workflow sont gratuits à consulter ; l’exécution d’une évaluation peut générer des coûts de modèle à trois niveaux. Claude Code peut puiser dans le quota d’un abonnement ou utiliser un compte facturé à l’usage, l’application testée appelle son propre fournisseur de modèle, et un éventuel modèle juge déclenche une nouvelle série d’appels. Un évaluateur local déterministe évite la troisième dépense, mais pas les appels de l’application.
Cette distinction est essentielle : build-eval n’est pas une réserve de crédits d’évaluation gratuits. C’est un workflow guidé dans Claude Code qui construit une évaluation autour de l’application existante. Il aide à repérer le point d’entrée, constituer les cas, choisir un évaluateur, écrire ou adapter un runner et produire des résultats vérifiables. L’implémentation publique est disponible dans le dépôt de skills d’Anthropic, mais les appels effectués par le runner qui en résulte restent soumis aux règles de facturation du compte et du fournisseur utilisés.
La réponse prudente dépend donc du contexte : la conception de l’évaluation peut être gratuite ; son exécution ne l’est que si aucun appel facturable n’a lieu ou si toute l’utilisation tient dans un quota déjà payé. Même dans ce cas, « gratuit » ne désigne que l’absence de coût marginal sur la facture, pas une capacité illimitée.
Ce qui a changé les 28 et 29 septembre
Anthropic a transformé la construction d’évaluations et l’optimisation itérative en deux workflows Claude Code explicites. Le guide du 28 septembre 2026 a présenté /claude-api build-eval pour créer une évaluation et /claude-api hillclimb pour améliorer une application à partir de celle-ci. L’implémentation a été publiée le 29 septembre à 02:20:03 UTC dans le commit 8a1541c4.
build-eval part d’un seul parcours applicatif. Il lit le point d’entrée existant, demande d’où doivent venir les cas représentatifs, propose l’évaluateur le moins coûteux capable de mesurer correctement la sortie, puis exige une validation claire des entrées comme de la méthode de notation. Il produit du code et des preuves dans le dépôt, notamment un runner, results.jsonl, des traces et un rapport.
hillclimb intervient ensuite. Il sépare les cas en ensembles d’entraînement et de test réservé, ne modifie qu’une surface autorisée à la fois, relance l’évaluation, puis annule les changements qui dégradent les résultats ou n’améliorent que l’ensemble d’entraînement. Cette boucle peut optimiser les prompts, le choix du modèle, le niveau d’effort, les outils ou le code qui enveloppe l’application, mais chaque variante testée entraîne de nouvelles exécutions.
La véritable nouveauté n’est pas que « les évaluations sont désormais gratuites ». Claude Code peut maintenant assembler un workflow d’évaluation rigoureux et vérifiable sans imposer un framework distinct. Le modèle de facturation sous-jacent, lui, n’a pas disparu.
Le coût de Claude Build Eval se répartit sur quatre postes
Un budget exploitable sépare quatre postes, car un seul est clairement gratuit. Les fondre dans un unique « coût Claude » empêche de comprendre où part l’argent.
- Le workflow public. Le guide et les fichiers du skill sont publics. Les consulter, examiner les fichiers locaux générés et lancer une vérification déterministe en local ne créent pas, en eux-mêmes, de frais de tokens sur l’API Claude.
- L’orchestration par Claude Code. Claude Code lit le dépôt, pose des questions, écrit le runner et aide à examiner les résultats. Les abonnés puisent dans le quota de leur offre ; les sessions authentifiées par API consomment des tokens facturés à l’usage. Le coût de session affiché aux utilisateurs de l’API est une estimation, tandis que les abonnés voient l’utilisation de leur forfait, comme l’explique la documentation de Claude Code sur les coûts. Les offres et modes d’authentification actuels sont détaillés dans le guide tarifaire de Claude Code du site.
- L’application testée. Le runner doit appeler le point d’entrée réel de l’application plutôt que de reconstituer une requête simplifiée au modèle. Chaque ticket d’assistance, nouvelle tentative, boucle d’outil et répétition consomme donc les ressources du fournisseur et du compte déjà utilisés par l’application.
- L’évaluateur. Une étiquette fixe, une validation de schéma, un test unitaire ou une assertion sur l’état final peuvent s’exécuter localement. Les réponses ouvertes peuvent nécessiter un modèle juge point par point ou par comparaison, ce qui ajoute ses propres entrées, sorties, caches et éventuels outils.
Pour réduire les coûts, le premier réflexe n’est pas de chercher un juge moins cher, mais de choisir un évaluateur programmatique dès que la bonne sortie possède une forme contrainte. Si un routeur d’assistance doit renvoyer une file parmi une liste fermée, du code suffit pour le vérifier. Demander à un autre modèle si billing est égal à billing revient à payer pour trancher une question déterministe.
Un modèle juge se justifie lorsque la propriété évaluée exige réellement un jugement, par exemple pour vérifier qu’un résumé d’escalade conserve l’urgence du client sans inventer de faits. Même dans ce cas, consignez séparément l’utilisation de l’application et celle du juge. Un juge bon marché peut masquer une exécution applicative coûteuse, et l’inverse est tout aussi vrai.
Les chiffres : 24 cas deviennent 144 exécutions applicatives
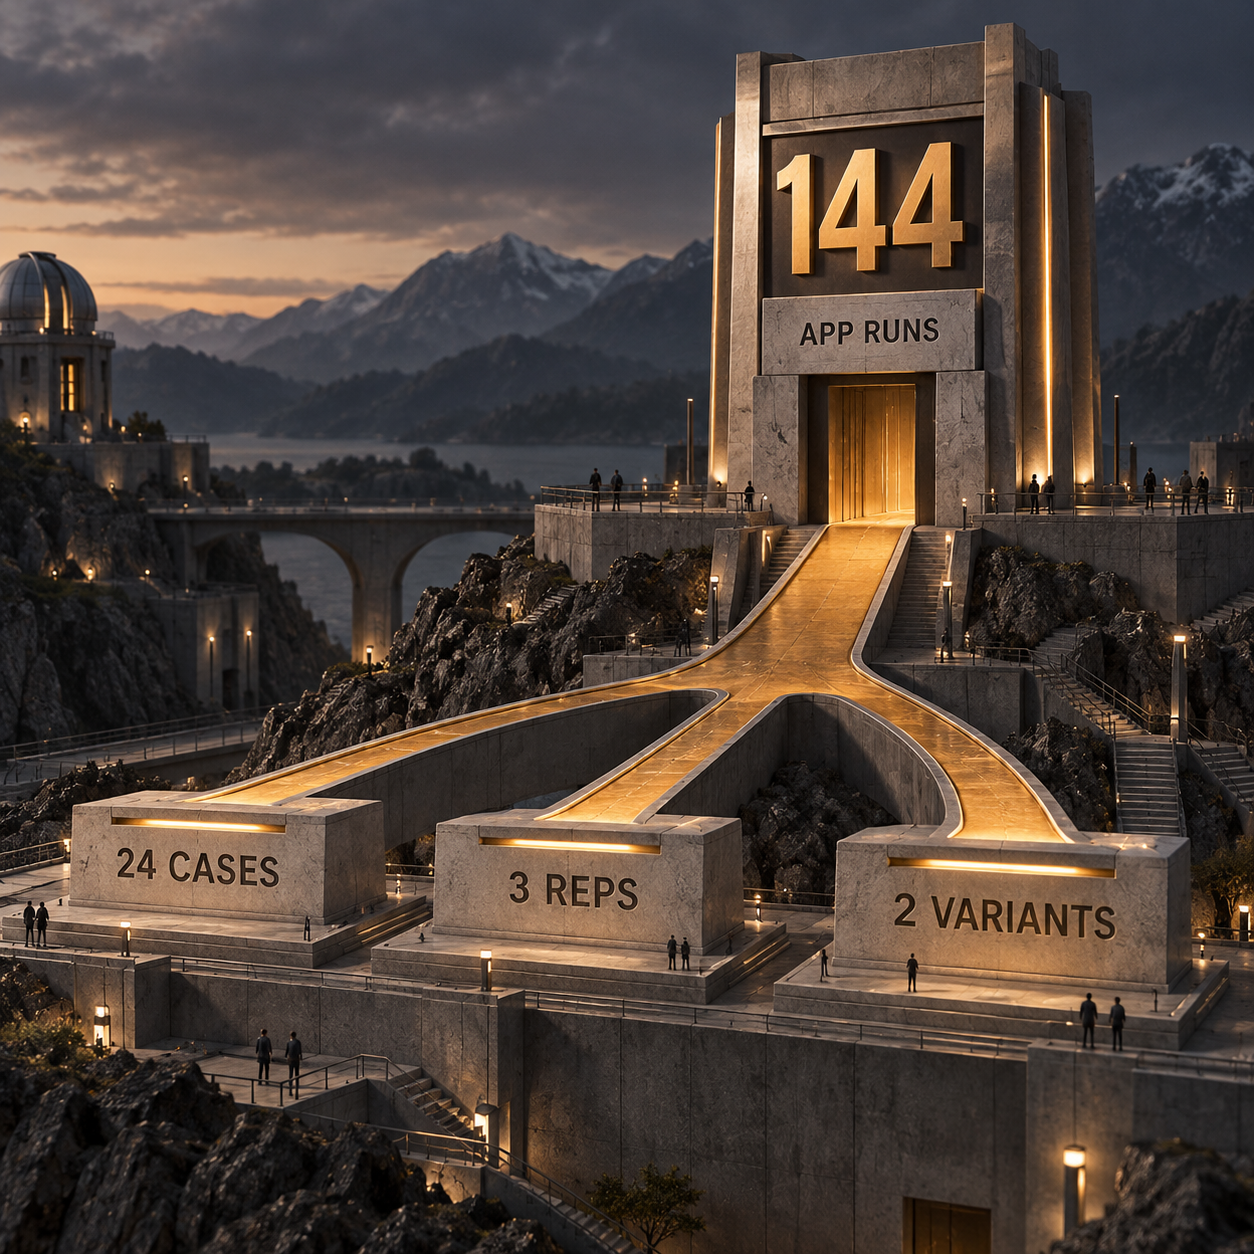
Le nombre de cas n’est que le premier multiplicateur. Le guide de lancement d’Anthropic présente un exemple de routage de boîte de réception avec 24 entrées. En comparant 2 variantes de modèle et en répétant chaque cas 3 fois, on obtient le nombre d’exécutions suivant :
24 cas × 3 répétitions × 2 variantes = 144 exécutions applicatives
C’est le plancher de ce protocole, avant toute notation par un modèle et toute nouvelle tentative après un échec. Les répétitions comptent, car un modèle peut produire des réponses différentes pour une même entrée. Les variantes comptent aussi, puisqu’une comparaison exige les sorties des deux configurations.
Le choix de l’évaluateur détermine le multiplicateur suivant :
- Évaluateur programmatique : 0 appel à un modèle juge. Le test reste à 144 exécutions applicatives.
- Juge par comparaison : 72 appels au juge si chaque appel compare les deux variantes pour un cas et une répétition, puisque 24 × 3 = 72 paires.
- Juge point par point : 144 appels au juge si chaque sortie de l’application est notée séparément. Le total atteint alors 288 appels de modèle : 144 pour l’application et 144 pour le juge, avant les nouvelles tentatives et l’utilisation d’orchestration de Claude Code.
Le hillclimbing ajoute une dimension supplémentaire, car chaque cycle exécute un nouveau candidat. Une boucle qui essaie plusieurs correctifs peut consommer plusieurs passes complètes d’évaluation, même si chaque correctif perdant est ensuite annulé. Fixez un nombre maximal de cycles et un plafond de dépenses avant d’optimiser. « Arrêter quand le score s’améliore » ne constitue pas un budget : des scores bruités peuvent prolonger la recherche.
Le prix API Claude commence par l’usage mesuré
Un cas n’a pas de tarif fixe : toute estimation défendable doit donc partir des champs d’utilisation réels d’un pilote payant. Un ticket peut se limiter à un bref appel de classification. Un autre peut déclencher un long contexte, plusieurs outils, des nouvelles tentatives et un juge. Les chiffrer tous deux comme « un cas d’évaluation » gomme précisément ce qui détermine la facture.
La grille tarifaire de l’API directe d’Anthropic a été vérifiée le 29 septembre 2026. Les prix ci-dessous s’entendent par million de tokens :
Source : page tarifaire en vigueur de l’API Claude d’Anthropic. Pour Amazon Bedrock ou Google Cloud, utilisez la grille du fournisseur concerné plutôt que de reprendre ces prix de l’API directe.
Pour chaque ligne du pilote, calculez :
entrée fraîche de l’application + sortie de l’application + écritures en cache de l’application + lectures du cache de l’application + entrée fraîche du juge + sortie du juge + écritures en cache du juge + lectures du cache du juge + outils payants côté serveur
Multipliez chaque catégorie de tokens par le tarif du modèle qui l’a produite. Ne fusionnez pas les tokens mis en cache avec les entrées fraîches. La règle simplifiée indique qu’une écriture dans un cache de 5 minutes coûte 1.25 fois le tarif d’entrée et qu’une lecture coûte 0.1 fois ce tarif, mais la grille actuelle comporte des exceptions importantes pour la lecture : Fable 5.1 coûte 0.025 fois son tarif d’entrée et Opus 5.5, 0.05 fois. Appliquer mécaniquement un coefficient de 0.1 surestimerait les deux.
La même rigueur s’applique au juge. Si l’application utilise Sonnet 5.5 et le juge Haiku 4.5, calculez chacun à partir de sa propre utilisation et de son propre tarif. Si l’application bénéficie d’un tarif cloud négocié, utilisez ce contrat. Si un outil côté serveur est facturé à l’opération, ajoutez-le séparément. Les outils côté client continuent d’augmenter le contexte du modèle et, par conséquent, la facture de tokens.
Aucun montant mesuré en dollars n’apparaît ici, car cette publication ne disposait ni d’un point d’entrée applicatif, ni d’un compte fournisseur, ni d’un pilote financé et approuvé. Inventer un nombre de tokens donnerait un chiffre propre, mais un budget inutile. La grille tarifaire est vérifiée ; le total de l’exécution doit attendre des mesures réelles.
Claude Code Build Eval : commencez par chiffrer cinq tickets
La plus petite étape utile consiste à faire passer cinq tickets pilotes par le point d’entrée existant du routeur d’assistance, puis à examiner l’utilisation ligne par ligne. Cinq tickets ne suffisent pas à valider la qualité en production. Ils suffisent à confirmer que le runner, l’évaluateur, la trace et le calcul des coûts sont correctement reliés avant de reproduire une erreur à l’échelle d’une suite complète.
Utilisez cinq tickets synthétiques qui couvrent des comportements de routage différents sans reprendre de données clients :
- Un client n’arrive pas à ouvrir le portail de facturation.
- Un paiement par carte semble avoir été débité deux fois.
- Un client demande si une offre annuelle est remboursable.
- Un incident en production nécessite une escalade urgente.
- Un acheteur en entreprise demande une modification du contrat.
Ces cas constituent une proposition de pilote, pas un test réellement exécuté. Ils doivent emprunter la même fonction, le même endpoint ou le même script que le routeur de production, tout en isolant les effets externes. Si le parcours réel peut envoyer un e-mail, modifier une base de données ou alerter un ingénieur, remplacez uniquement cet effet secondaire par une fixture de test. L’assemblage du prompt, l’appel au modèle, les outils, les nouvelles tentatives et l’analyse de la réponse doivent rester équivalents à la production ; sinon, le pilote chiffre le mauvais système.
Confirmer le point d’entrée et le compte de facturation
Consignez la fonction ou l’endpoint de l’application, le modèle, le fournisseur, le compte, le prompt, les outils et la forme de sortie. Notez également comment Claude Code est lui-même authentifié. Vous distinguerez ainsi le quota de l’offre de l’utilisation de l’API par l’application avant même leur démarrage.
Valider les cinq entrées et l’évaluateur
Examinez chaque ticket synthétique et validez la route attendue. Pour une étiquette de file fixe, utilisez un évaluateur programmatique. N’ajoutez un modèle juge que pour une propriété impossible à vérifier par du code, et ne laissez jamais le modèle testé s’évaluer lui-même.
Exécuter un pilote financé
Lancez 5 cas × 1 répétition × 1 variante de l’application, soit 5 exécutions applicatives. Le workflow publié exige un accord explicite avant la première passe payante. Sans budget approuvé, arrêtez-vous à une configuration à blanc exécutable plutôt que d’annoncer un prix.
Examiner la ligne, pas le chiffre affiché dans la console
Ouvrez
results.jsonlet une trace. Vérifiez que les lignes réussies contiennent des champsmodeletusagenon vides, que le point d’entrée exposestop_reason, et que l’utilisation de l’application se distingue de celle du juge. Les champs d’écriture et de lecture du cache doivent être conservés au lieu d’être intégrés à l’entrée. Un zéro qui ne devrait pas l’être révèle un bug du runner, pas un appel gratuit.Chiffrer puis valider le protocole complet
Calculez les cinq lignes avec les tarifs réels du fournisseur, présentez le minimum, la médiane et le maximum par cas, puis multipliez selon le nombre de cas et de répétitions approuvé. Ajoutez la forme d’évaluateur choisie, les nouvelles tentatives et le plafond de hillclimb. Présentez cette formule avant de demander l’autorisation de lancer l’exécution complète.
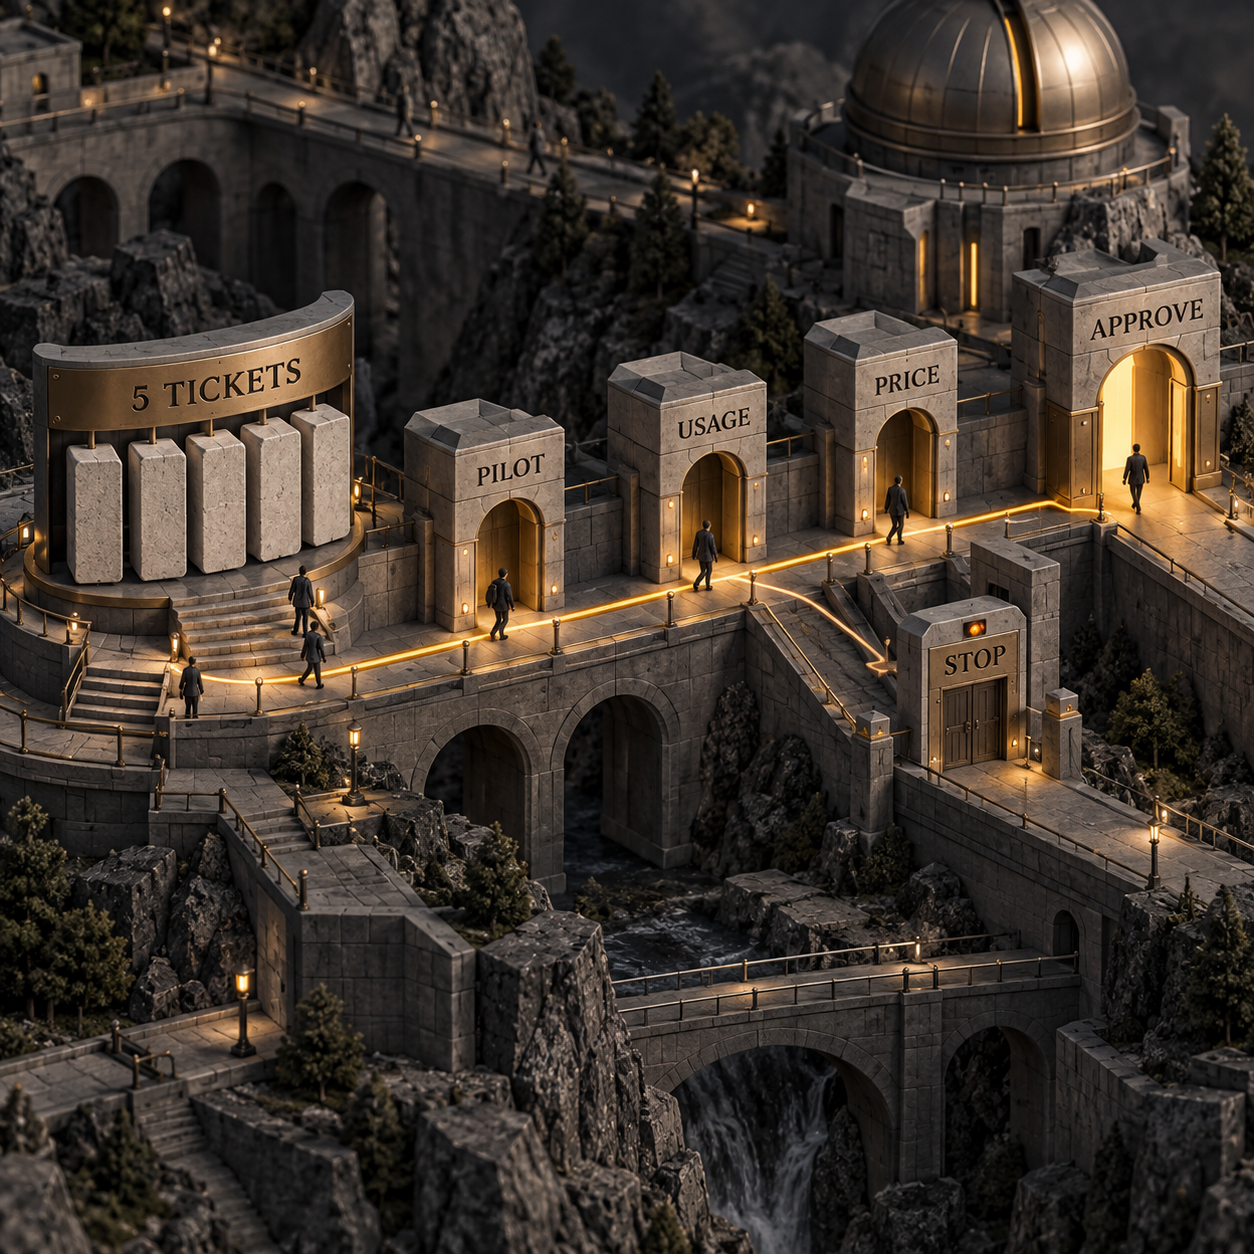
Cet ordre suit l’implémentation publiée : mesurer un pilote financé, examiner son utilisation, puis seulement estimer la suite. Les moyennes historiques ne peuvent pas s’y substituer, car l’état du cache, les boucles d’outils, l’effort, les nouvelles tentatives et la longueur des sorties appartiennent à cette application, pas à une application moyenne.
Ce que cela change pour les développeurs, les opérateurs et les acheteurs
Les développeurs doivent rendre le coût observable à la frontière de l’application. Si le point d’entrée masque model, usage ou stop_reason, ajoutez ces champs à son événement final avant d’écrire le runner complet. Conservez les champs de cache natifs du fournisseur et rattachez séparément l’utilisation du juge. Toutes les équipes rencontrent le même mur : un rapport soigné appuyé sur des lignes incomplètes. Une fois l’exécution complète terminée, il est souvent impossible de reconstituer les catégories de tokens manquantes.
Les opérateurs doivent maîtriser la multiplication et le jalon de validation. Réunissez sur une page les cas, les répétitions, les variantes, les appels de l’évaluateur, la politique de nouvelle tentative et le nombre maximal de cycles de hillclimb. Un budget qui indique seulement « 24 cas » est incomplet. Un budget qui détaille 144 exécutions applicatives, la forme de l’évaluateur, l’utilisation mesurée par cas et un plafond d’arrêt peut être examiné sérieusement.
Les acheteurs doivent demander quelles couches couvre le prix annoncé. Inclut-il l’orchestration de Claude Code, le modèle de l’application, le juge, la marge du fournisseur cloud, les outils, les nouvelles tentatives et les cycles d’optimisation ? Un fournisseur peut annoncer en toute honnêteté un juge peu coûteux tout en excluant les exécutions applicatives qui concentrent la dépense. Exigez les lignes du pilote et la formule, pas seulement un total.
Qui doit agir maintenant, attendre ou conserver le workflow des plugins ?
Agissez maintenant si l’application possède un point d’entrée stable, si une décision doit être prise et si cinq cas représentatifs peuvent être examinés en toute sécurité. Une migration de prompt, un changement de modèle, une révision de la politique de routage ou une modification d’outil sont de bonnes cibles, car l’évaluation peut comparer un avant et un après concrets.
Attendez si le runner ne peut pas appeler la logique de production sans risque. Commencez par isoler les écritures en base, les messages sortants, les outils destructifs et les états externes mutables. Attendez également si personne ne peut approuver les entrées ou l’évaluateur. Multiplier les exécutions ne sauvera pas une évaluation qui mesure la mauvaise tâche.
Conservez le workflow natif des plugins si vous cherchez à savoir si un plugin Claude Code apporte de la valeur. Ce workflow compare par conception des sessions WITH-plugin et W/OUT-plugin. Le guide du site consacré aux tests de plugins Claude Code avec des évaluations couvre ce protocole distinct. Le build-eval applicatif vise le point d’entrée de l’application ; il ne remplace pas cette comparaison de plugin par un benchmark générique.
Rien ne change pour vous si vous disposez déjà d’un runner et d’un évaluateur fiables. Réutilisez-les. L’implémentation publique privilégie explicitement l’adaptation des composants existants plutôt que leur remplacement par un nouveau framework. L’apport utile peut résider dans la discipline de validation, la collecte de l’utilisation ou la boucle de hillclimb, et non dans une nouvelle pile de tests.
Ce qui est survendu
Le workflow simplifie la mise en place ; il ne rend l’évaluation ni automatique, ni objective, ni gratuite. Claude peut proposer des cas, mais une personne doit encore décider s’ils représentent la production. Il peut suggérer un évaluateur, mais une personne doit vérifier qu’une réponse oracle est acceptée, qu’une réponse nulle est rejetée et qu’un modèle juge ne récompense pas le style au détriment de l’exactitude.
Le hillclimbing n’est pas non plus un optimiseur gratuit. Il exécute délibérément davantage de variantes, analyse les échecs, propose des correctifs et recommence l’évaluation. L’ensemble de test conservé à part protège contre une forme de surapprentissage, mais il ne dispense ni d’un nombre suffisant de cas et de répétitions, ni d’un plafond de dépenses.
Le rapport ne constitue une preuve que si ses lignes sont complètes. Un superbe report.html placé à côté de champs usage vides ne répond pas à la question du coût. Un total en dollars dérivé d’hypothèses sur les tokens ne vaut pas mieux. Avant tout pilote financé, le livrable défendable est un plan d’exécution accompagné de la grille tarifaire actuelle, avec un total mesuré encore vide.
Ce qu’il faut faire lundi
Confiez à un responsable un pilote borné, pas une consigne ouverte du type « construire des évaluations ». Lundi, choisissez le point d’entrée existant du routeur d’assistance, rédigez les cinq tickets synthétiques ci-dessus et utilisez un évaluateur programmatique à étiquette fixe. Examinez les entrées et les routes attendues avec l’opérateur responsable de la politique d’assistance.
Demandez ensuite l’autorisation d’exécuter exactement 5 appels applicatifs. Examinez results.jsonl, une trace, chaque catégorie d’utilisation et stop_reason. Chiffrez ces lignes au tarif réel du fournisseur. Ce n’est qu’alors qu’il faudra proposer le protocole de 24 cas, 3 répétitions et 2 variantes, avec ses plafonds pour le juge, les nouvelles tentatives et les cycles de hillclimb.
La règle de décision est nette : sans données d’utilisation complètes pour le pilote, pas d’approbation du budget de l’exécution complète.
- Dernière mise à jour
- 29 sept. 2026
- Catégorie
- Build
Préférez ce site dans Google


Marquez omidsaffari.com comme source préférée et Google le met en avant pour vous dans Top Stories, AI Overviews et AI Mode.

Shopify MCP : automatiser le checkout sans sacrifier le consentement
Découvrez comment Shopify MCP structure le checkout WebMCP, sécurise les mises à jour et exige l’accord de l’acheteur avant toute validation de commande.29 sept. 2026Build
API Cloudflare : maîtriser le nouveau CLI cf
Installez le CLI cf, trouvez la bonne commande, exploitez ses réponses JSON et migrez vos Workers sans abandonner Wrangler avant le bon moment.29 sept. 2026Build
Logiciel Krisp : avis, tarifs et limites pour les appels
Notre avis sur le logiciel Krisp pour les appels pro : réduction du bruit, routage audio, tarifs et critères pour savoir si votre outil suffit.29 sept. 2026Build
SaneBox avis : tarifs, formules et coût réel
Notre avis sur SaneBox et ses tarifs : comparez Snack, Lunch et Dinner, les économies et coûts cachés, puis testez le filtre avant de vous abonner.29 sept. 2026Build
Tarif Marblism en 2026 : combien coûtent vraiment les tâches ?
Quel tarif Marblism choisir ? Comparez les forfaits, le coût réel des tâches, les heures partagées et les blocages lorsque le quota est épuisé.28 sept. 2026Build
Tarifs Fyxer : coûts réels, seuils de rentabilité et verdict
Découvrez les tarifs Fyxer, le coût réel par utilisateur, les limites de chaque formule et les seuils de rentabilité avant de choisir ou de passer.28 sept. 2026Build
Cloudflare Worker Previews : ce qui est gratuit, ce qui ne l’est pas
Worker Previews est bien inclus gratuitement chez Cloudflare. Découvrez ses limites, les coûts d’exécution et les ressources à budgéter par branche.28 sept. 2026Build