Perplexity Search API: Fast Search o web por defecto
Comparamos Fast Search y el modo web de Perplexity Search API en precio, latencia y cobertura, con una regla práctica para enrutar cada consulta.




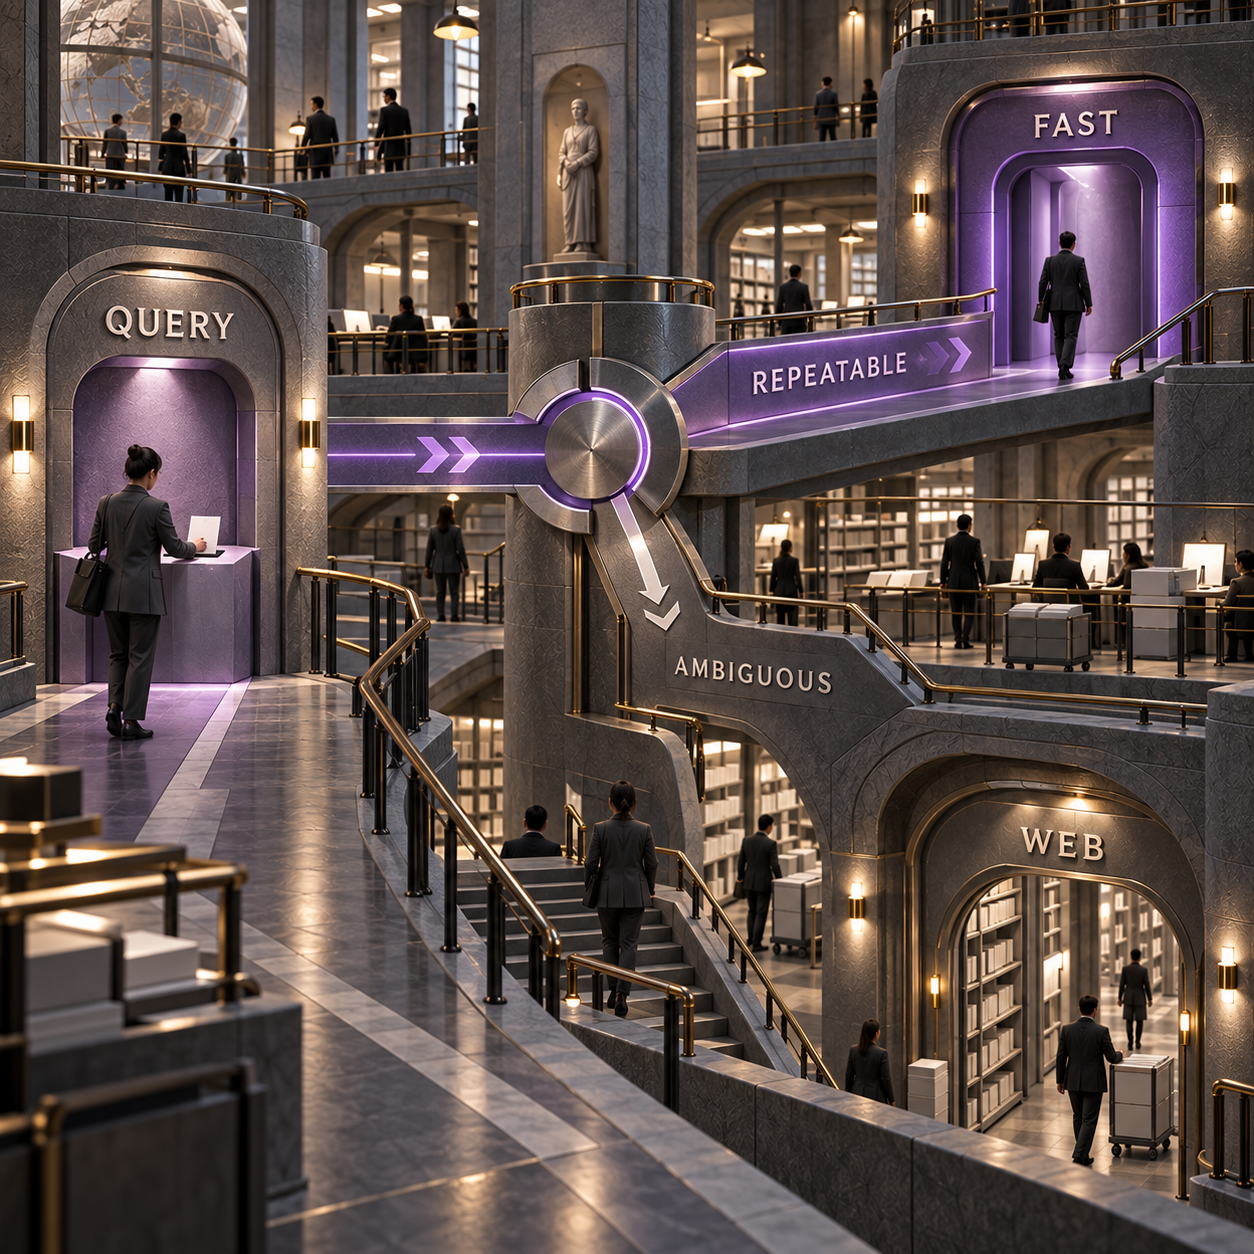
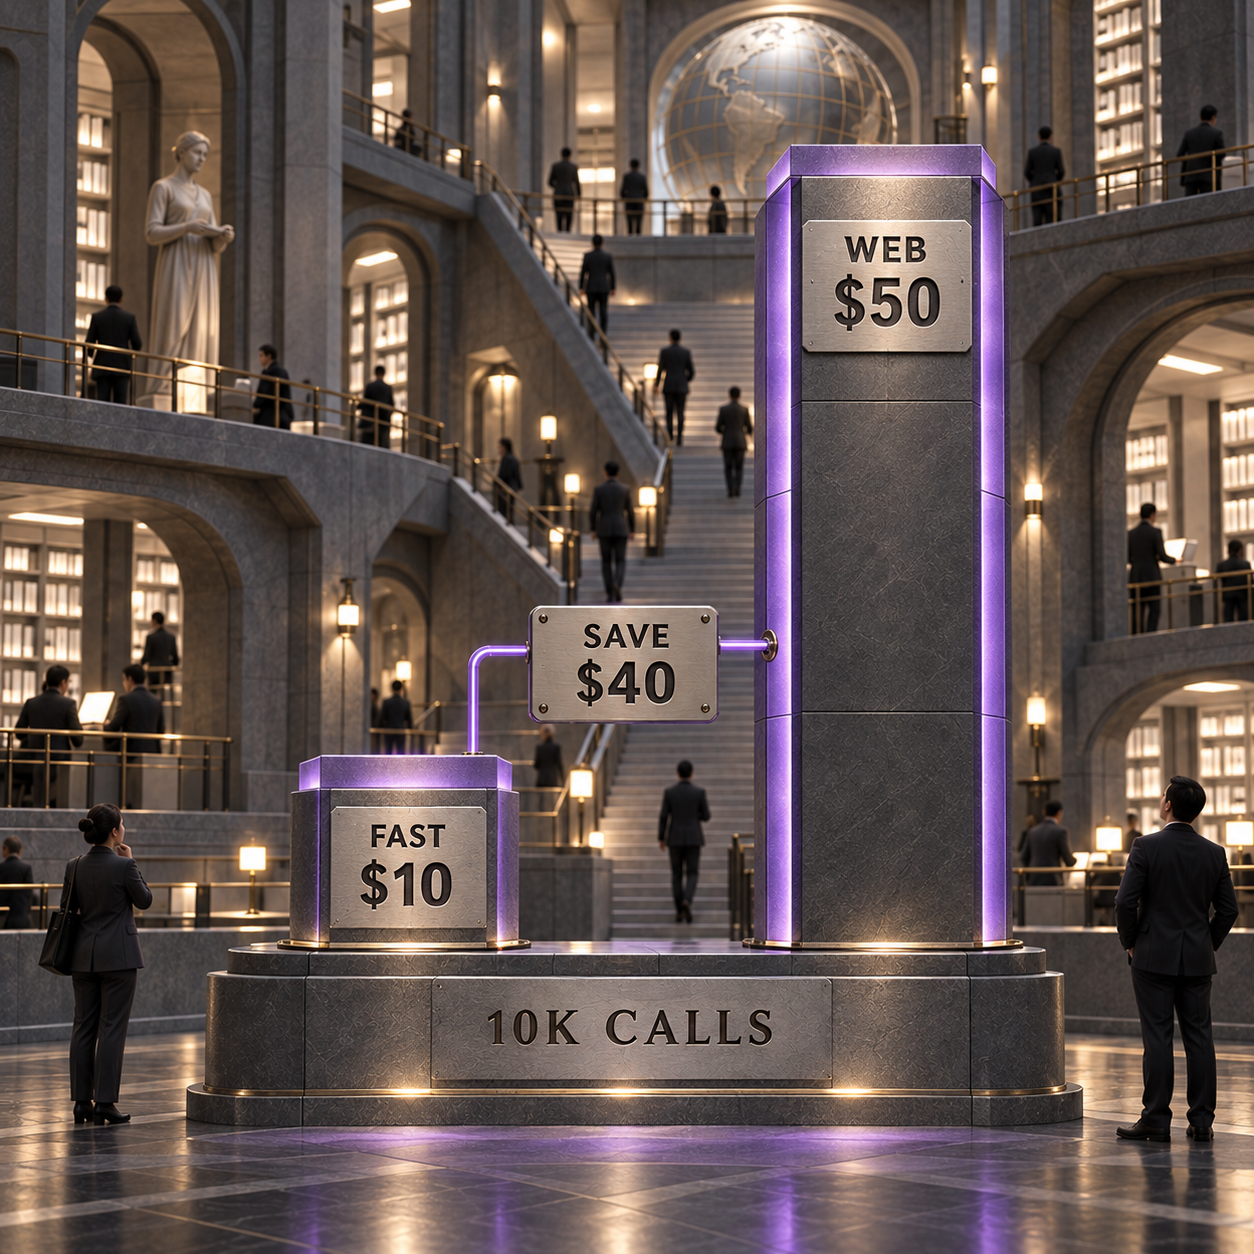
Elegir entre Fast Search y el modo por defecto de Perplexity Search API es una decisión de enrutamiento: conviene usar fast para las consultas repetibles de un agente, a $1 por cada 1,000 llamadas exitosas, y reservar el modo web por defecto para investigaciones ambiguas o en las que la cobertura sea crítica, a $5. Con 10,000 llamadas, la búsqueda cuesta $10 frente a $50, sin contar el modelo que procesa los resultados.
Perplexity Search API: ¿Fast Search o el modo web por defecto?
Elija Fast Search para tareas acotadas y repetibles; use el modo web por defecto cuando omitir una sola fuente pueda cambiar la decisión. Fast gana en precio y latencia. El modo web por defecto ofrece mayor calidad de recuperación y disponibilidad de respuestas. Un agente en producción debería alternar entre ambos, no forzar todas las consultas por un único modo.
La guía actual de Fast Search de Perplexity recomienda fast para el trabajo cotidiano de los agentes y la configuración web por defecto para preguntas poco frecuentes, difíciles o ambiguas. Los precios y las mediciones del proveedor que aparecen en esta comparativa se verificaron en las páginas activas de Perplexity el 24 de septiembre de 2026.
Para un desarrollador independiente que lanza un agente de soporte, el punto de partida es ejecutar en fast las consultas rutinarias sobre documentación y estados, y escalar a web cuando la evidencia sea escasa o nula. El recargo de $0.004 por una llamada al modo web por defecto es mínimo si un fallo obliga a una revisión humana, pero supone un desperdicio cuando se trata de una consulta de bajo riesgo repetida miles de veces.
Para un fundador con financiación que desarrolla investigación de mercado, el modo web por defecto debería encargarse de las preguntas ambiguas sobre empresas, políticas y competencia. Fast aún puede resolver comprobaciones en fuentes conocidas, disponibilidad de productos y seguimiento recurrente. La carga de trabajo contiene dos clases de recuperación, aunque el producto solo muestre un cuadro de búsqueda.
Para un CTO de una empresa mediana, conviene mantener el modo web por defecto en las investigaciones de compras, seguridad, regulación e incidentes hasta que una reproducción interna demuestre que Fast Search conserva el conjunto de fuentes necesario. Una solicitud cinco veces más barata deja de serlo si un analista tiene que reparar el expediente de evidencias.
Perplexity Search API y Fast Search: qué cambia con Photon
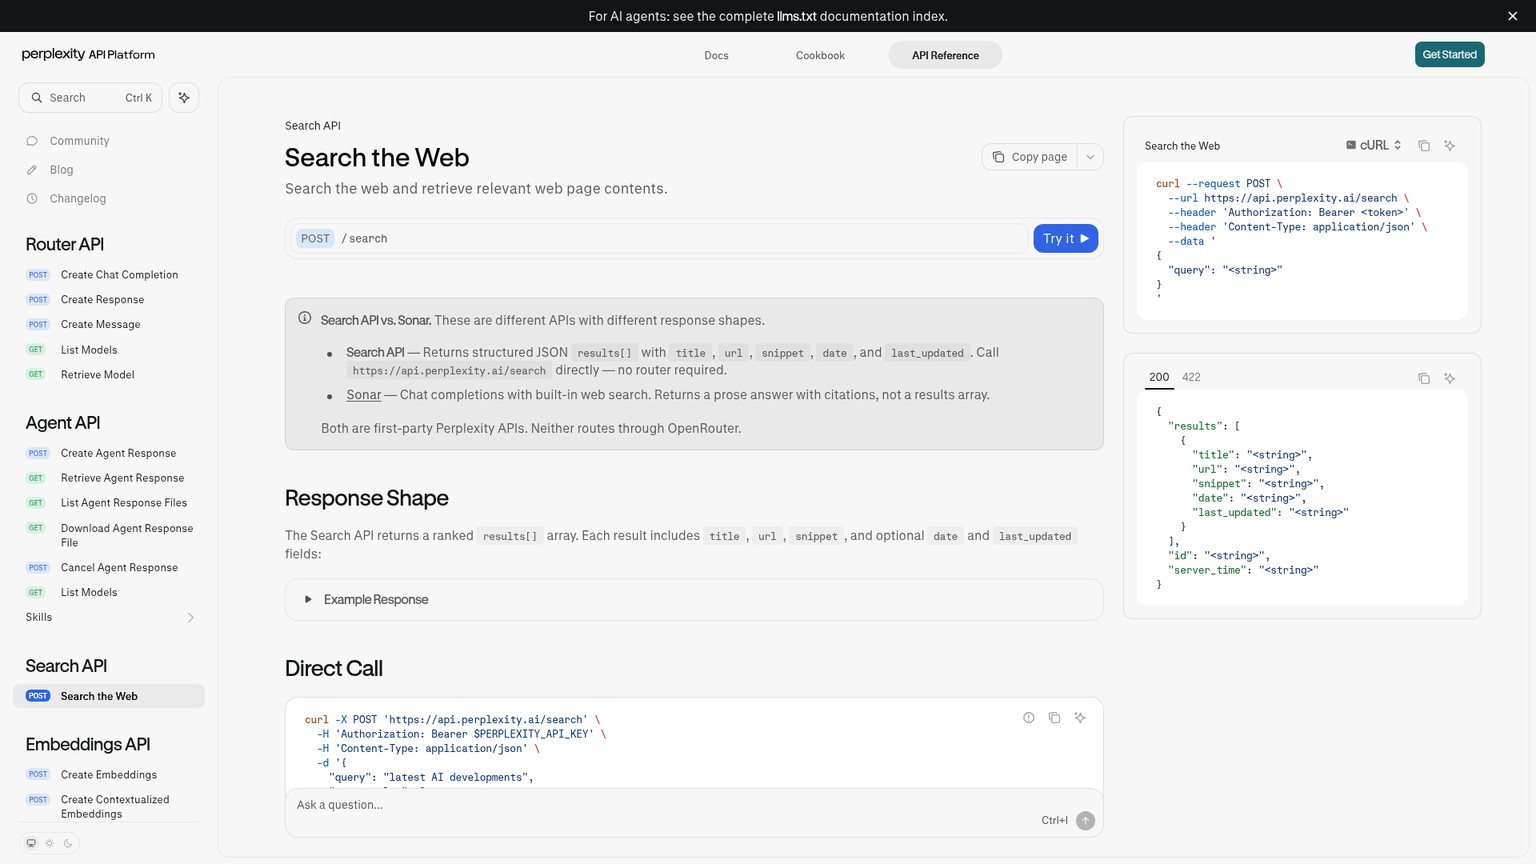
Fast Search modifica el presupuesto de recuperación, no el endpoint ni el esquema de resultados. Perplexity lanzó este modo el 24 de septiembre de 2026, respaldado por Photon, su motor interno de recuperación y clasificación. La documentación activa de Fast Search confirma que el mismo endpoint POST /search devuelve el mismo array ordenado results[]; la solicitud solo añade search_type: "fast".
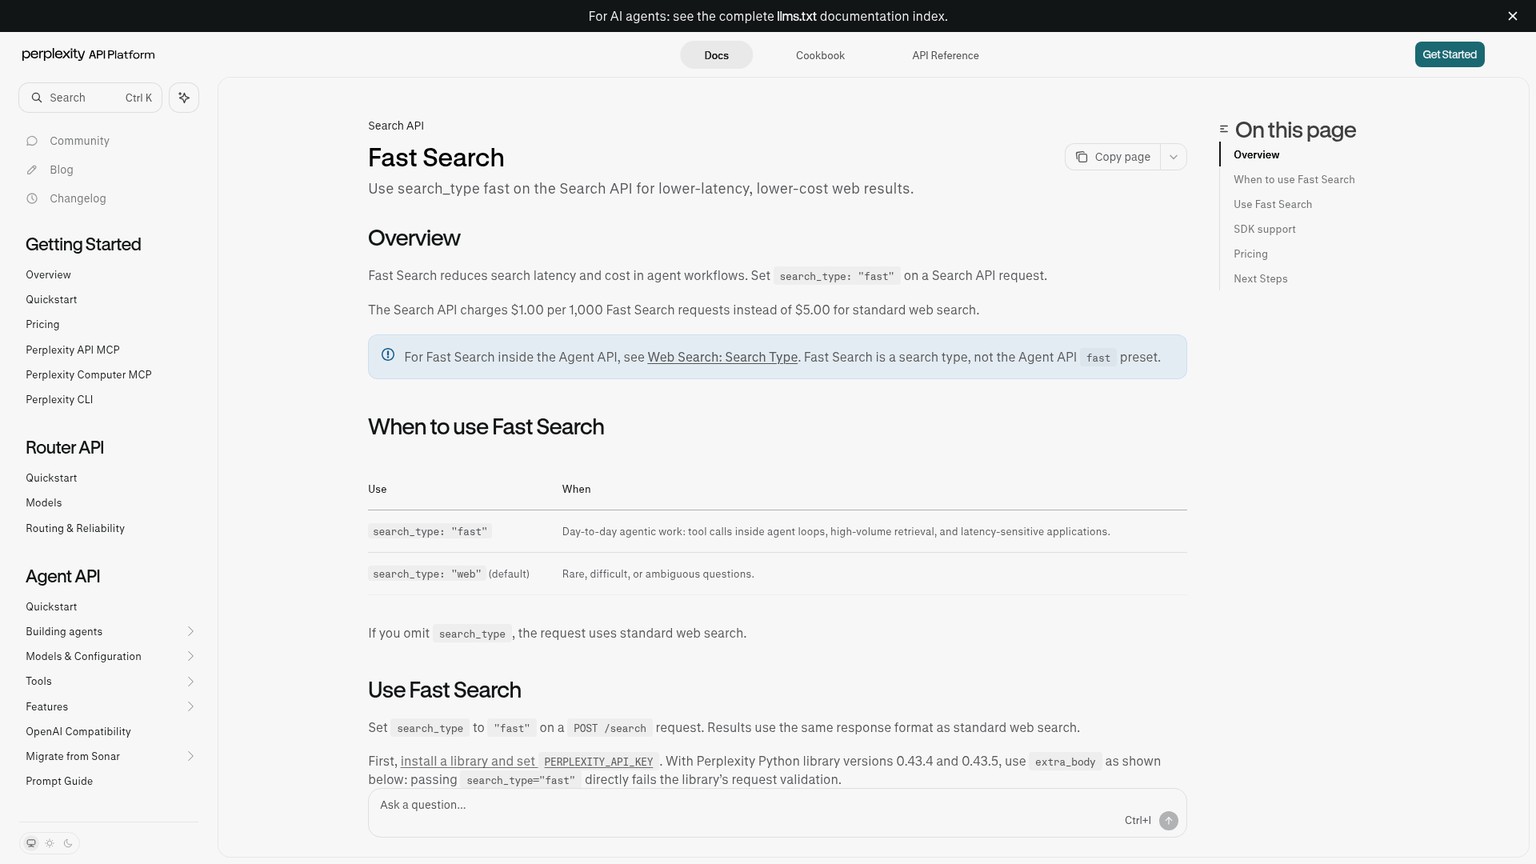
Si se omite search_type, Perplexity utiliza el modo web estándar. Este detalle importa porque “por defecto” aquí no alude al modelo de lenguaje predeterminado de la aplicación de consumo de Perplexity, sino al modo de recuperación estándar de Search API. Ambos modos devuelven títulos, URL, fragmentos y, de forma opcional, fechas de publicación y actualización para el procesamiento posterior.
El lanzamiento de Photon describe un motor que lee solo los datos necesarios para cada consulta, solapa las esperas de disco y emplea una caché que tiene en cuenta el procesamiento por lotes; la figura oficial de la arquitectura de Perplexity muestra el recorrido de la solicitud por su broker y sus shards. Estas decisiones de ingeniería explican la promesa de velocidad. No eliminan la concesión deliberada en la clasificación: Fast Search consume menos cómputo y sacrifica parte de la calidad de una recuperación más amplia.
Perplexity Photon es el motor, no un tercer modo
Photon es la infraestructura que sostiene la pila de búsqueda de Perplexity. Las opciones de la API siguen siendo fast, web y el tipo de búsqueda independiente people. Quien desarrolla no selecciona Photon de forma directa, no lo despliega ni recibe un objeto de respuesta distinto.
La salvedad actual de los SDK es práctica. Perplexity documenta extra_body={"search_type": "fast"} para las versiones 0.43.4 y 0.43.5 de la biblioteca de Python porque la validación directa rechaza el valor nuevo. Su ejemplo en TypeScript convierte el tipo con "fast" as any en el SDK 0.38.5 hasta que se actualicen los tipos. Las solicitudes HTTP directas evitan ambas limitaciones temporales del cliente.
Precio de Perplexity Search API: $10 frente a $50 por 10,000 solicitudes
Ganador: Fast Search. La tabla de precios activa de Perplexity cobra $1 por cada 1,000 solicitudes exitosas de Fast Search sin procesar y $5 por cada 1,000 solicitudes exitosas del modo web por defecto, sin una tarifa adicional de tokens para Search API.
La carga de trabajo normalizada es sencilla:
- 10,000 llamadas de Fast Search: 10,000 × $0.001 = $10.
- 10,000 llamadas al modo web por defecto: 10,000 × $0.005 = $50.
- Diferencia: $40, es decir, una reducción del 80% en la partida de recuperación sin procesar.
Esos $40 no representan toda la factura del agente. Después vienen el modelo que lee los resultados, las búsquedas posteriores, los reintentos, la validación y la revisión humana. Fast solo gana si no genera más de $40 de trabajo adicional en ese lote de 10,000 llamadas.
Las respuestas exitosas pero vacías también se cobran
Una respuesta exitosa de POST /search se factura aunque results[] esté vacío. Las solicitudes no válidas, las que superan el límite de tasa y los fallos del proveedor no se cobran según las reglas de precios actuales. Por eso, la tasa de resultados vacíos es una métrica presupuestaria, no solo de calidad.
El procesamiento por lotes cambia la factura, no la decisión de calidad
El inicio rápido de consultas múltiples de Perplexity admite hasta cinco consultas relacionadas en una solicitud. Una solicitud múltiple exitosa cuenta como una unidad de facturación, aunque cada consulta sigue computando para los límites de tasa. Por tanto, veinte consultas distribuidas en cuatro solicitudes por modo costarían $0.024 en total, frente a $0.12 por 40 solicitudes individuales separadas.
No utilice lotes para comparar la latencia de una sola llamada. Una carga con cinco consultas cambia el trabajo que realiza la solicitud y oculta el tiempo por consulta. Compare primero 20 llamadas de una sola consulta por modo. Pruebe los lotes por separado cuando la elección del modo ya esté bien fundamentada.
Mantenga las tarifas de herramientas de Agent API en una partida propia
La tabla de herramientas de Agent API tiene precios estándar distintos: $1 por cada 1,000 invocaciones fast de web_search y $2.50 por cada 1,000 invocaciones del modo web estándar, más los tokens del modelo seleccionado. No son las tarifas de $1 y $5 de Search API sin procesar. Fast Search tampoco es el preset fast independiente de Agent API, aunque se reutilice la misma palabra.
La comparativa anterior de costos de Perplexity, Exa y Tavily responde qué proveedor comprar. Esta decisión está un nivel más abajo, cuando Perplexity ya forma parte de la pila.
Ganador en latencia: Fast, con un asterisco sobre la medición del proveedor
Ganador: Fast Search, según la medición de Perplexity. El gráfico oficial de latencia de Perplexity registra 160 ms en p50 y 230 ms en p95 para una sola llamada de Fast Search. Perplexity no publica un p50 y un p95 equivalentes del modo web por defecto en el texto de lanzamiento ni en la guía activa de Fast Search, de modo que no existe una proporción comparativa de latencia que pueda citarse con rigor.
Los percentiles importan. p50 corresponde a la solicitud central. p95 es el umbral por debajo del cual finaliza el 95% de las solicitudes. Un agente que encadena varias búsquedas nota más la cola lenta que la mediana, porque una sola llamada tardía puede dejar todo el plan en espera.
Fast merece, por tanto, la vía sensible a la latencia, pero la pregunta de producción sigue dependiendo de la carga concreta. La distancia de red, los filtros, el número de resultados solicitado, el contexto extraído, los lotes y la política de reintentos afectan al tiempo total que percibe el agente. La cifra del proveedor sirve como referencia, no como promesa de nivel de servicio para todas las integraciones.
El planteamiento práctico de Mikhail Basyuk fija el criterio correcto: un p95 inferior a 250 ms solo es útil si se conserva la relevancia que exige la tarea. Velocidad y evidencia deben aparecer en el mismo panel.
Ganador en cobertura: el modo web por defecto
Ganador: el modo web por defecto para investigaciones difíciles y ambiguas. El gráfico interno de recuperación de Perplexity asigna a Fast Search una relevancia de 2.21, frente a 2.45 para el modo por defecto: una diferencia de 0.24 puntos. La disponibilidad de respuestas es 0.567 frente a 0.596, una brecha de 2.9 puntos porcentuales.
La relevancia mide si el material clasificado responde bien a la consulta. La disponibilidad de respuestas indica si la recuperación encontró suficiente material para sustentar una respuesta. Fast puede responder rápido y, aun así, dejar al siguiente modelo con un conjunto de evidencias más pobre. Por eso, una pregunta amplia sobre políticas, una comparación de varias empresas o una afirmación controvertida deben ir al modo web por defecto, aunque la ruta rápida parezca ágil.
Perplexity también publica un resultado que parece contradictorio en su gráfico agregado de proveedores, basado en seis benchmarks públicos de agentes y 3,554 tareas seleccionadas: Fast obtuvo 64.3% con un costo total estimado de modelo y búsqueda de $59.73, mientras que el modo por defecto alcanzó 64.0% con $187.60. El proveedor describe la configuración fast como aproximadamente un 68% más barata, con una calidad agregada de las tareas comparable.
Ambos hallazgos pueden coexistir. En una evaluación agregada, los agentes pueden compensar una recuperación más débil mediante el conocimiento del modelo, el razonamiento o llamadas repetidas; también puede ocurrir que las tareas seleccionadas no penalicen cada fuente ausente. Un sistema de recuperación sin procesar que atiende investigaciones empresariales o de cumplimiento no puede dar por hecho que el modelo posterior reparará un documento faltante.
La guía más amplia sobre API de búsqueda con IA aplica el mismo principio operativo a distintos proveedores: comprar el nivel de recuperación más barato que produzca un expediente de evidencias aceptable para la siguiente comprobación determinista.
Cómo activar Fast Search en Perplexity Search API
Use la misma solicitud dos veces y cambie únicamente search_type. Mantenga constantes query, max_results, search_context_size, los filtros, la región y la ubicación del cliente. La referencia activa de Search API documenta web como valor por defecto, max_results en 10 de forma predeterminada y high como tamaño de contexto extraído por defecto. Fije explícitamente ambos controles de la comparación para que un cambio futuro en los valores predeterminados de la API no altere la repetición.
Este par de solicitudes puede ejecutarse tal como está escrito:
set -euo pipefail
: "${PERPLEXITY_API_KEY:?Set PERPLEXITY_API_KEY first}"

QUERY='Which CRM has the stronger current EU data residency and audit-control evidence?'
COMMON=$(jq -nc --arg query "$QUERY" '{
  query: $query,
  max_results: 10,
  search_context_size: "high"
}')

for MODE in fast web; do
  jq --arg mode "$MODE" '. + {search_type: $mode}' <<<"$COMMON" |
    curl -sS 'https://api.perplexity.ai/search' \
      -H "Authorization: Bearer $PERPLEXITY_API_KEY" \
      -H 'Content-Type: application/json' \
      -o "$MODE.json" \
      -w "$MODE\tHTTP %{http_code}\t%{time_total}s\n" \
      --data-binary @-
done
Durante la publicación no se dispuso de credenciales para la API de Perplexity. Por eso no se afirma haber medido la latencia, la cobertura, la tasa de resultados vacíos ni el respaldo de las respuestas. El protocolo siguiente es una pequeña comprobación por pares, no una reproducción del estudio de seis benchmarks de Perplexity.
Utilice 20 consultas de investigación empresarial: 10 búsquedas específicas con una fuente autorizada como objetivo y 10 preguntas ambiguas que requieran varias fuentes. Un conjunto fijo útil puede cubrir precios actuales de SaaS, límites de servicios en la nube, fechas regulatorias, países compatibles, controles de seguridad, documentos regulatorios recientes, comparaciones de proveedores, efectos de políticas, preguntas de costo total y afirmaciones con evidencia creíble en ambos sentidos.
Con una sola consulta por solicitud, esas 40 solicitudes exitosas sin procesar cuestan $0.12 antes de cualquier llamada posterior al modelo: $0.02 por 20 llamadas fast más $0.10 por 20 llamadas al modo web por defecto.
Congele la solicitud
Use
max_results: 10ysearch_context_size: "high"en ambos modos. Mantenga idénticos los filtros, el país, el idioma y la región del cliente. Alterne al azar qué modo se ejecuta primero en cada consulta para que las cachés calientes y las condiciones transitorias de la red no favorezcan siempre al mismo lado.Registre el comportamiento de recuperación
Capture
time_totalde extremo a extremo, el estado HTTP, el número de resultados, un indicador de respuesta vacía, los dominios únicos, el número de fuentes autorizadas y si aparece la fuente principal esperada. Conserve todos los JSON sin procesar para revisarlos.Aplique una única escala de utilidad
Asigne cero a la cobertura de fuentes útiles si no hay ninguna relevante para la decisión; uno, si el conjunto sirve pero está incompleto; y dos, si hay suficiente evidencia independiente para avanzar. No conceda puntos por dominios duplicados ni por fragmentos largos que repitan una misma fuente.
Mantenga constante la capa de respuesta
Si un modelo convierte los resultados en una respuesta, utilice el mismo modelo, prompt, presupuesto de tokens y verificador de citas. Puntúe el respaldo de la respuesta con cero si una afirmación sustancial carece de evidencia; uno, si el respaldo es parcial; y dos, si cada afirmación sustancial se corresponde con la evidencia devuelta.
Decida por clase de carga de trabajo
Compare por separado, para los grupos específico y ambiguo, las medianas y la latencia p95, las respuestas vacías, la cobertura de fuentes y el respaldo de las respuestas. Promueva fast únicamente en una clase cuya puntuación de evidencia se mantenga dentro del margen de aceptación del equipo.
La comparación clave no es el promedio de resultados. Una montaña de enlaces débiles puede ser peor que un conjunto pequeño de fuentes primarias. La cobertura útil y las respuestas respaldadas son las métricas que dan sentido al precio y la latencia.
El costo real de cambiar de modo
Modificar el cuerpo de la solicitud es fácil; cambiar la política operativa es el verdadero trabajo. Trasladar una carga del modo web por defecto a fast no requiere migrar datos ni adoptar un endpoint nuevo. Aun así, modifica el comportamiento de recuperación, la identidad de la caché, la supervisión y la gestión de fallos.
Incluya search_type en la clave de caché. Una respuesta fast almacenada no debe satisfacer silenciosamente una solicitud posterior al modo web por defecto, cuyo emisor pagó por una recuperación más amplia. Incluya también el tamaño del contexto, el número de resultados, los filtros, el país y el idioma.
Registre el modo de cada solicitud y de cada afirmación posterior. Sin ese dato, una caída en la tasa de aceptación de fuentes parece una deriva del modelo o ruido aleatorio de búsqueda. El enrutador también necesita un motivo de escalamiento visible, como empty_results, missing_primary_source, ambiguous_query o high_impact.
Mantenga los reintentos vinculados al modo. Reintentar por un timeout en el mismo modo es una medida de disponibilidad. Pasar de fast a web es un escalamiento de calidad y cambia el precio. Ambos eventos no deberían compartir un contador.
Quién no debería cambiar
No convierta Fast Search en el modo universal por defecto cuando:
- El agente gestiona contratos, regulación, seguridad, finanzas, información médica o respuesta a incidentes, ámbitos en los que omitir una fuente tiene consecuencias graves.
- La carga actual está dominada por preguntas ambiguas que exigen diversidad de fuentes en lugar de una consulta factual conocida.
- No existe una escala de evidencia aceptada, de modo que “más rápido” se convertiría en la única métrica visible de éxito.
- Un adaptador del proveedor o un SDK rechaza el enum nuevo y el equipo no puede usar con seguridad la solución documentada ni HTTP directo.
- Las respuestas exitosas pero vacías no se registran por separado de los fallos de transporte.
- El recargo del modo web por defecto es irrelevante frente a la revisión humana que ya requiere cada respuesta.
La mejor migración es un despliegue con enrutamiento. Traslade a fast una clase repetible, conserve web como ruta de escalamiento y compare la evidencia aceptada antes de ampliar el alcance.
La acción para el lunes
Implemente una política de búsqueda sencilla antes de cambiar el valor predeterminado global. Envíe a fast las consultas repetibles y de bajo impacto; dirija a web las preguntas ambiguas o de alto impacto. Después, convierta el rechazo de evidencias en un escalamiento automático, no en una respuesta débil que pase inadvertida.
Empiece con las solicitudes de la semana pasada, no con demostraciones inventadas. Seleccione 20 que representen el trabajo habitual del producto, sepárelas en grupos específicos y ambiguos, y reproduzca el par exacto anterior. La prueba cuesta $0.12 en tarifas de búsqueda sin procesar si las 40 solicitudes individuales son exitosas.
El martes, revise cuatro resultados: la latencia p95 de las solicitudes, las respuestas exitosas pero vacías, la cobertura de fuentes útiles y la puntuación de respaldo de las respuestas. Si fast mantiene el umbral de evidencia en el grupo específico, traslade solo esa clase. Si pierde una fuente primaria en el grupo ambiguo, mantenga ahí el modo web por defecto, con independencia del benchmark agregado.
Esa es la consecuencia empresarial de Photon: no una configuración global más barata, sino un enrutador práctico según el riesgo de la búsqueda. El agente gasta $1 por cada 1,000 llamadas cuando la consulta admite margen y paga los $4 adicionales solo cuando una recuperación más amplia puede evitar un error más costoso.
Preguntas frecuentes
¿Por qué Perplexity genera controversia?
Los debates sobre el producto de consumo, la atribución de fuentes y la relación con los editores son independientes de esta elección entre modos de API. Quien compra la API debería validar la cobertura de fuentes, las condiciones de uso y la gestión de evidencias frente a los requisitos de su propia organización.
¿Cómo cambiar el buscador predeterminado a Perplexity?
Ese es un ajuste del navegador o del dispositivo. En esta comparativa, “por defecto” se refiere al comportamiento de Search API: si se omite search_type, se utiliza el modo web estándar; Fast Search exige search_type: "fast".
¿Por qué falla Perplexity?
La premisa es demasiado amplia para demostrarla con la evidencia citada sobre la API. En una integración, conviene definir el fallo con precisión: un resultado vacío, la ausencia de la fuente primaria esperada, cobertura útil insuficiente, una respuesta sin respaldo, un timeout o un error del proveedor.
¿Qué es mejor para buscar: Perplexity o el modo IA de Google?
Esa comparación enfrenta productos de respuesta para consumidores, no los modos de Perplexity Search API sin procesar. La decisión entre Fast y el modo web por defecto debe basarse en la latencia de recuperación, la cobertura de fuentes útiles y el respaldo de evidencias en la respuesta posterior.
¿Por qué Joe Rogan usa Perplexity?
Un respaldo público o un anuncio no aporta una razón técnica ni evidencia para elegir fast o web. La decisión sobre la API debe basarse en datos de la carga de trabajo, no en el uso de una celebridad.
¿Sigue siendo bueno Perplexity?
Fast Search tiene una función clara a $1 por cada 1,000 solicitudes exitosas sin procesar, y Perplexity informa una latencia p50 de 160 ms. Los propios resultados de recuperación del proveedor también muestran que el modo web por defecto sigue siendo la mejor opción cuando importan una relevancia más amplia y la disponibilidad de respuestas.
¿Cuál es la desventaja de Perplexity?
En Fast Search, la desventaja documentada es una menor relevancia de recuperación y disponibilidad de respuestas. En el modo web por defecto, es un precio por solicitud sin procesar cinco veces mayor y una latencia superior a la del modo diseñado específicamente para la velocidad.
¿Perplexity está perdiendo usuarios?
Las páginas de lanzamiento y de la API citadas no publican datos auditados sobre la evolución de usuarios activos, por lo que esta comparativa no puede respaldar esa afirmación. Además, el crecimiento de usuarios no decidiría qué modo de Search API encaja con una consulta de producción.
¿Perplexity AI es mejor que ChatGPT?
La Search API sin procesar de Perplexity devuelve resultados web ordenados para que otro sistema los procese, mientras que ChatGPT es un asistente para usuarios finales con herramientas y modelos propios. Compare el flujo de trabajo concreto y sus requisitos de evidencia, no las marcas en abstracto.
¿Quiere reunir en una sola hoja las preguntas sobre enrutamiento, validación y costos? Descargue la lista de verificación para auditar flujos de trabajo empresariales con IA y trace el primer enrutador de riesgo de búsqueda el lunes.
- Última actualización
- 24 sept 2026
- Categoría
- Build
Prefiera este sitio en Google


Marque omidsaffari.com como fuente preferida y Google lo destacará para usted en Top Stories, AI Overviews y AI Mode.

Agentes de IA: el costo oculto de un fallback que agotó el saldo
Un fallo en un flujo de agentes de IA convirtió el fallback de imágenes en la ruta predeterminada, agotó un saldo compartido y dejó artículos incompletos.24 sept 2026Build
Cursor gratis: cuánto cuesta Rollouts en realidad
¿Cursor gratis incluye Rollouts? No. Comparamos acceso, créditos de 10 días y costos de Teams y Enterprise para saber qué pagar después, sin sorpresas.24 sept 2026Build
Agente de IA para programar: guía práctica de Unreal Agent
Prueba este agente de IA para programar en un repositorio controlado: configura el runner, conserva el JSONL y mide seguridad, costo y resultados.24 sept 2026Build
JetBrains Air: guía práctica para usar Air Alpha
Instala JetBrains Air Alpha, conecta un agente, añade contexto del proyecto y revisa tu primer cambio de código con un flujo seguro y verificable.23 sept 2026Build
JetBrains Air gratis: qué incluye y quién paga el agente
El plugin JetBrains Air es gratis. Compara Junie Lite, suscripciones de agentes, cobro por API y créditos de JetBrains AI antes de elegir quién paga.23 sept 2026Build
Firecrawl Docker: cómo autohospedarlo y cuánto cuesta
Aprende a desplegar Firecrawl con Docker, verificar un scraping real y comparar el costo de autohospedarlo frente a Firecrawl Cloud durante 30 días.22 sept 2026Build
Agentes de IA: cuándo un reintento necesita aprobación humana
Un agente rechazó resultados y compró nuevas renderizaciones antes de la revisión humana. Así se impone aprobación en cada reintento de pago.22 sept 2026Build