Perplexity Search API : Fast Search ou mode web par défaut ?
Fast Search coûte cinq fois moins cher, mais le mode web couvre mieux les requêtes complexes. Voici comment router chaque recherche dans Perplexity Search API.




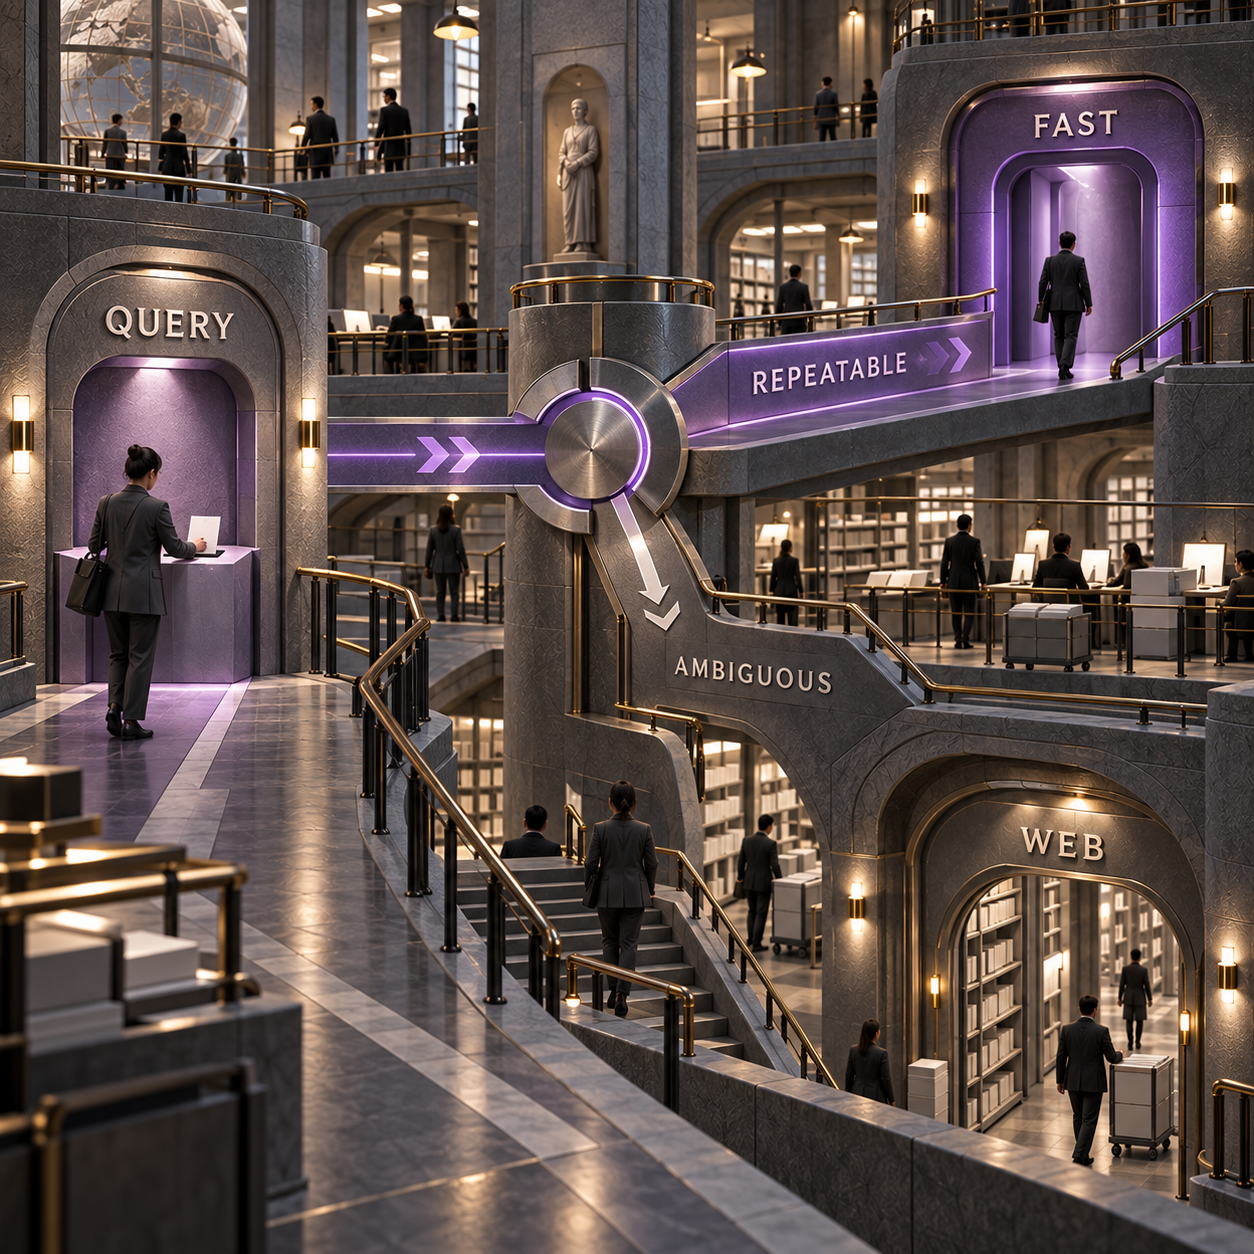
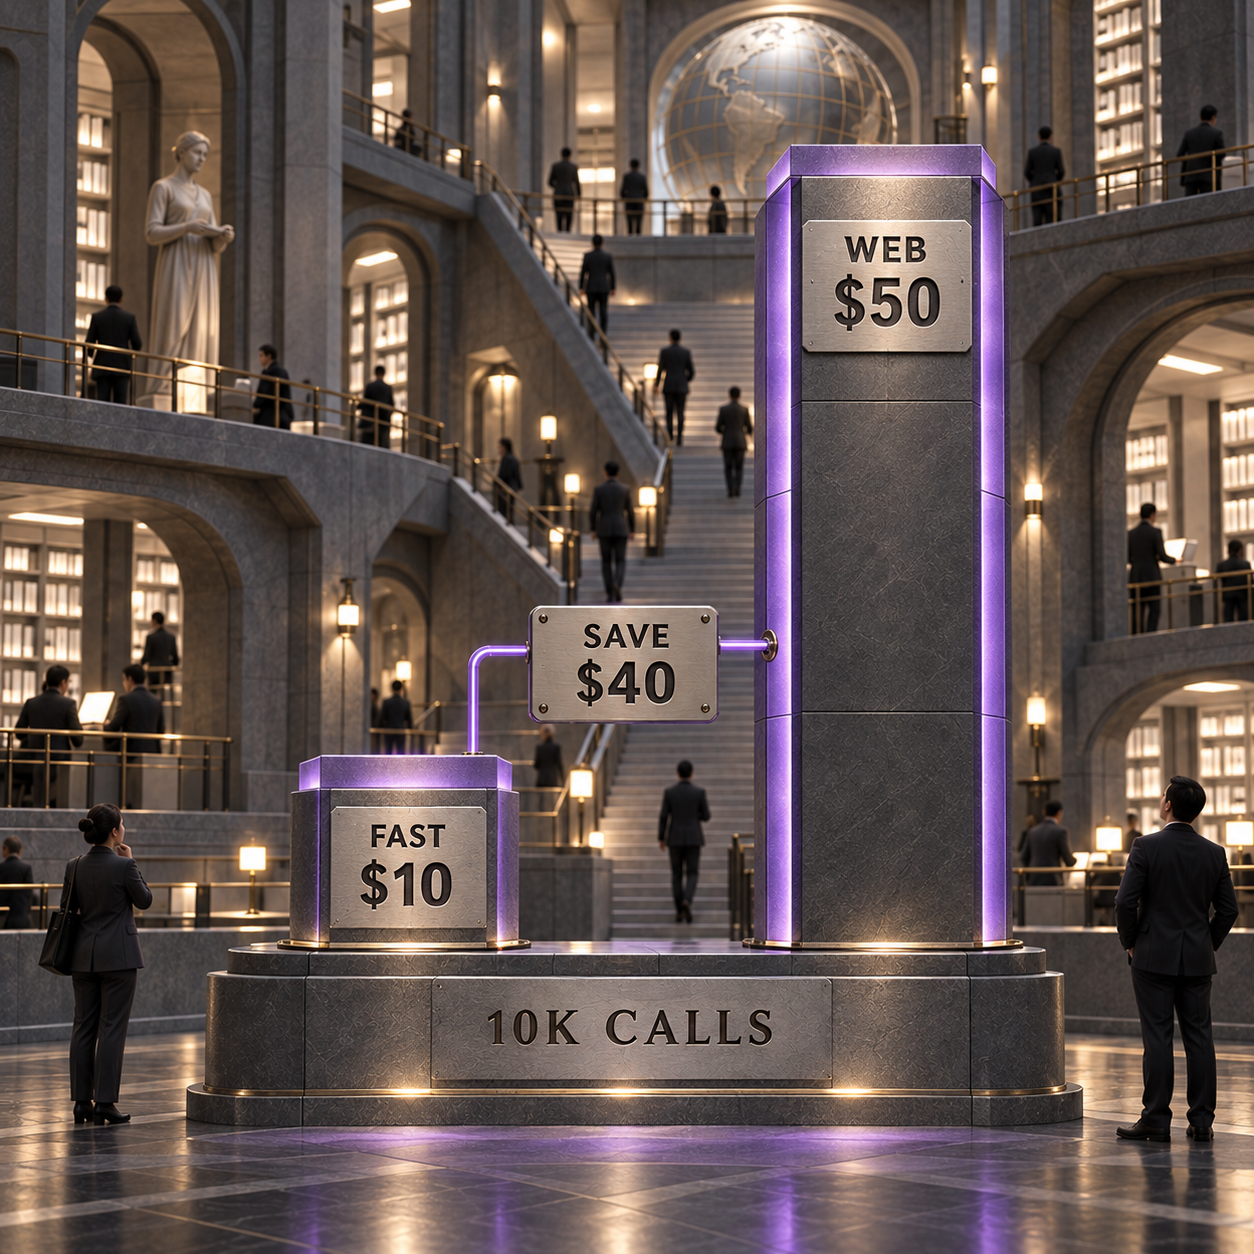
Avec Perplexity Search API, le choix entre Fast Search et le mode par défaut relève surtout du routage : réservez fast aux recherches répétables des agents, à $1 pour 1,000 appels réussis, et conservez le mode web par défaut pour les recherches ambiguës ou sensibles à la couverture, au tarif de $5 pour le même volume. Sur 10,000 appels, la recherche seule revient à $10 contre $50, hors coût du modèle qui exploite les résultats.
Perplexity Search API : faut-il choisir Fast Search ou le mode web par défaut ?
Choisissez Fast Search pour les tâches délimitées et répétables ; gardez le mode web par défaut lorsqu'une source manquante peut changer la décision. Fast l'emporte sur le prix et la latence. Le mode web par défaut offre la meilleure qualité de recherche et la meilleure disponibilité des réponses. En production, mieux vaut router les requêtes entre les deux que tout faire passer par un mode unique.
Perplexity recommande dans son guide Fast Search d'utiliser fast pour le travail quotidien des agents et le réglage web par défaut pour les questions rares, difficiles ou ambiguës. Les tarifs et les mesures du fournisseur présentés ici ont été vérifiés sur les pages en ligne de Perplexity le 24 septembre 2026.
Pour un indépendant qui déploie un agent de support, commencez par envoyer les consultations courantes de documentation et de statut vers fast, puis basculez vers web si les preuves sont absentes ou trop faibles. Le surcoût de $0.004 d'un appel au mode web par défaut est négligeable si une lacune déclenche une revue humaine, mais inutile pour une recherche peu risquée répétée des milliers de fois.
Pour le fondateur d'une start-up financée qui développe un outil d'étude de marché, le mode web par défaut doit traiter les questions ambiguës sur les entreprises, les politiques et la concurrence. Fast reste pertinent pour les vérifications sur des sources connues, la disponibilité des produits et le suivi récurrent. Même si le produit n'affiche qu'un seul champ de recherche, la charge de travail comporte bien deux catégories de recherche.
Pour un CTO d'une entreprise de taille intermédiaire, conservez le mode web par défaut pour les achats, la sécurité, la réglementation et les incidents, tant qu'un test interne sur des requêtes rejouées n'a pas confirmé que Fast Search préserve l'ensemble de sources requis. Une requête cinq fois moins chère ne l'est plus si un analyste doit ensuite réparer le dossier de preuves.
API Perplexity Fast Search : ce que Photon change réellement
Fast Search modifie le budget de recherche, pas l'endpoint ni le schéma des résultats. Perplexity a lancé ce mode le 24 septembre 2026. Il repose sur Photon, son moteur interne de recherche et de classement. La documentation Fast Search en ligne confirme son fonctionnement : le même endpoint POST /search renvoie le même tableau classé results[], et il suffit d'ajouter search_type: "fast" à la requête.
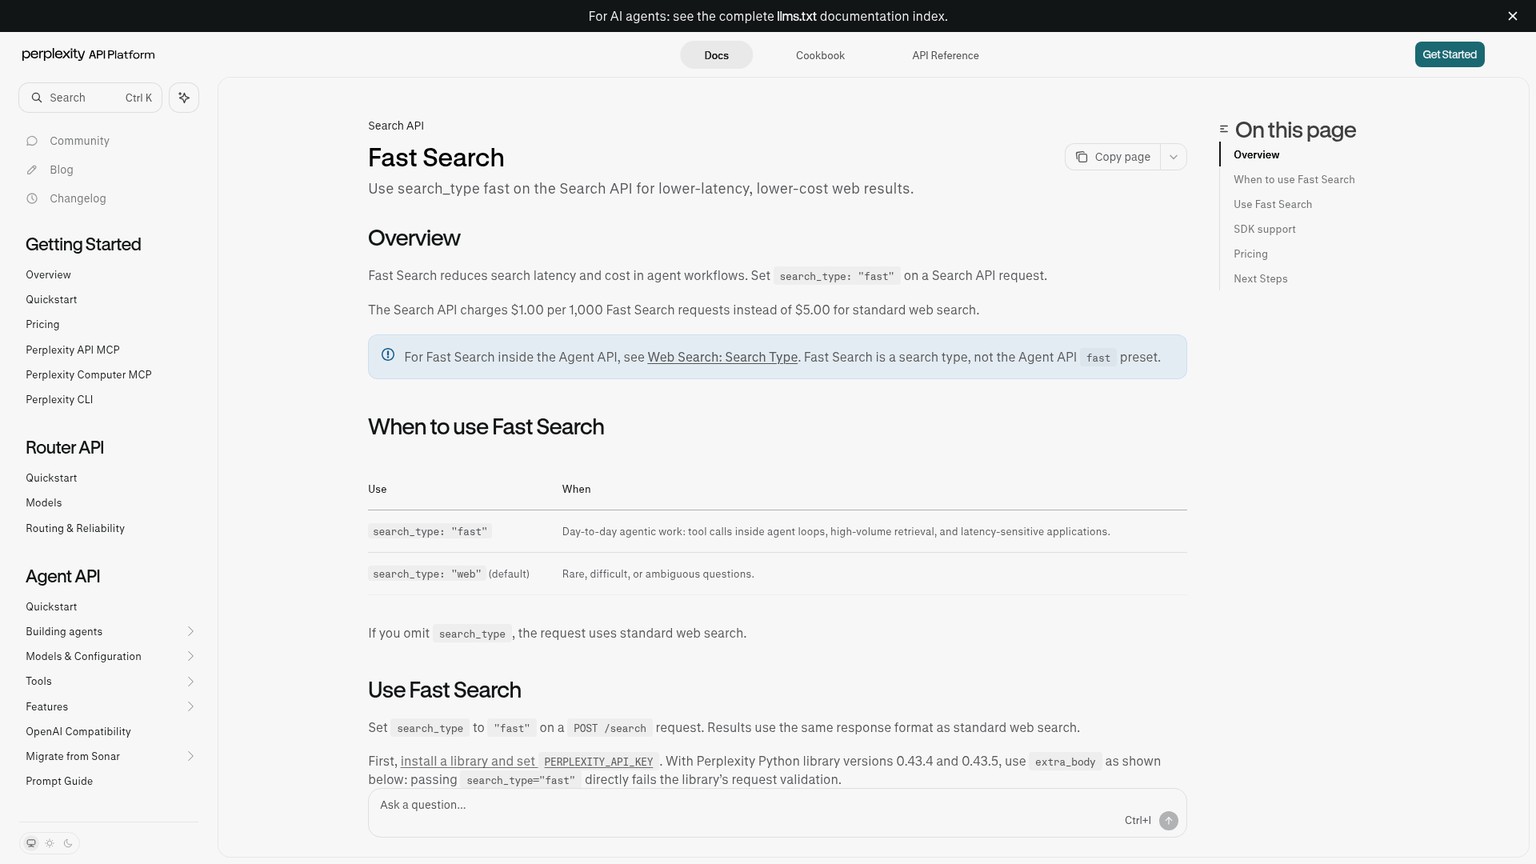
Si search_type est omis, Perplexity utilise le mode web standard. Cette précision compte : « par défaut » ne désigne pas ici le modèle de langage sélectionné par défaut dans l'application grand public Perplexity, mais le mode de recherche standard de la Search API. Les deux modes renvoient des titres, des URL, des extraits et, en option, les dates de publication et de mise à jour destinées aux traitements en aval.
Selon la présentation de Photon, le moteur ne lit que les données nécessaires à une requête, amortit les temps d'attente disque en les faisant se chevaucher et s'appuie sur un cache adapté au traitement par lots. Le schéma d'architecture officiel de Perplexity illustre le parcours d'une requête à travers son broker et ses shards. Ces choix d'ingénierie expliquent le gain de vitesse annoncé. Ils ne suppriment pas le compromis assumé sur le classement : Fast Search consomme moins de ressources de calcul et sacrifie une part de la qualité d'une recherche plus large.
Perplexity Photon est le moteur, pas un troisième mode
Photon constitue l'infrastructure sous-jacente de la pile de recherche de Perplexity. Côté API, les choix restent fast, web et le type de recherche distinct people. Il n'est pas possible de sélectionner Photon directement, de le déployer ou d'obtenir un objet de réponse différent.
La réserve actuelle concerne surtout les SDK. Perplexity documente extra_body={"search_type": "fast"} pour les versions 0.43.4 et 0.43.5 de la bibliothèque Python, car la validation directe refuse la nouvelle valeur. L'exemple TypeScript convertit quant à lui le type avec "fast" as any dans le SDK 0.38.5, en attendant la mise à jour des types. Les requêtes HTTP directes évitent ces deux contraintes temporaires côté client.
Prix de Perplexity Search API : $10 contre $50 pour 10,000 requêtes
Gagnant : Fast Search. La grille tarifaire de Perplexity facture $1 pour 1,000 requêtes brutes Fast Search réussies et $5 pour 1,000 requêtes réussies en mode web par défaut, sans frais de tokens supplémentaires pour la Search API.
Le calcul sur une charge normalisée est simple :
- 10,000 appels Fast Search : 10,000 × $0.001 = $10.
- 10,000 appels au mode web par défaut : 10,000 × $0.005 = $50.
- Écart : $40, soit une réduction de 80% sur la ligne de coût de la recherche brute.
Ces $40 ne représentent pas la facture complète d'un agent. Le modèle qui lit les résultats, les récupérations complémentaires, les nouvelles tentatives, la validation et la revue humaine interviennent ensuite. Fast n'est réellement gagnant que s'il ne génère pas plus de $40 de travail supplémentaire sur ce lot de 10,000 appels.
Une réponse vide mais réussie reste facturée
Une réponse réussie à POST /search est facturable même si results[] est vide. Selon les règles tarifaires actuelles, les requêtes invalides, limitées par le débit ou victimes d'une défaillance en amont ne sont pas facturées. Le taux de résultats vides devient donc un indicateur budgétaire, et pas seulement un indicateur de qualité.
Le batching change la facture, pas la décision de qualité
Le guide de démarrage multi-requêtes de Perplexity accepte jusqu'à cinq requêtes liées dans un même appel. Un appel groupant plusieurs requêtes et exécuté avec succès ne compte que pour une unité de facturation, même si chaque requête reste prise en compte dans les limites de débit. Vingt requêtes regroupées dans quatre appels par mode coûteraient donc $0.024 au total, contre $0.12 pour 40 appels individuels.
N'utilisez pas le batching pour comparer la latence d'un appel unique. Un payload de cinq requêtes modifie le travail effectué et masque le temps propre à chacune. Commencez par comparer 20 appels mono-requête dans chaque mode. Testez ensuite le batching séparément, une fois le choix du mode validé.
Isolez les tarifs des outils Agent API dans votre budget
Le tableau des outils Agent API applique un autre tarif standard : $1 pour 1,000 invocations de web_search en mode fast et $2.50 pour 1,000 invocations en mode web standard, auxquels s'ajoutent les tokens du modèle choisi. Il ne s'agit pas des tarifs à $1 et $5 de la Search API brute. Malgré le même terme, Fast Search ne correspond pas non plus au préréglage fast distinct de l'Agent API.
Le précédent comparatif des coûts de Perplexity, Exa et Tavily aide à choisir le fournisseur. La décision traitée ici intervient un niveau plus bas, une fois Perplexity déjà intégré à la stack.
Latence : Fast gagne, avec une réserve sur les mesures du fournisseur
Gagnant : Fast Search, d'après les mesures de Perplexity. Le graphique de latence officiel annonce 160 ms au p50 et 230 ms au p95 pour un appel Fast Search unique. Ni le texte de lancement ni le guide Fast Search en ligne ne publient de p50 et p95 comparables pour le mode web par défaut : impossible, donc, de citer honnêtement un ratio de latence entre les deux.
Ces percentiles sont déterminants. Le p50 correspond à la requête médiane. Le p95 est le seuil sous lequel 95% des requêtes se terminent. Un agent qui enchaîne plusieurs recherches ressent davantage la longue traîne que la médiane, car un seul appel d'outil retardé peut bloquer tout son plan.
Fast mérite donc la voie réservée aux tâches sensibles à la latence, mais la réponse en production dépend toujours de la charge réelle. La distance réseau, les filtres, le nombre de résultats demandé, le contexte extrait, le batching et la politique de nouvelle tentative influencent tous le délai de bout en bout observé par l'agent. La mesure du fournisseur sert de référence, pas de promesse de niveau de service pour chaque intégration.
La formule de Mikhail Basyuk, issue du terrain, fixe le bon critère : un p95 inférieur à 250 ms n'a d'intérêt que si la pertinence exigée par la tâche est préservée. Vitesse et qualité des preuves doivent figurer sur le même tableau de bord.
Couverture des sources : le mode web par défaut gagne
Gagnant : le mode web par défaut pour les recherches difficiles et ambiguës. Dans son évaluation interne de la recherche, Perplexity attribue à Fast Search un score de pertinence de 2.21, contre 2.45 pour le mode par défaut, soit un écart de 0.24 point. La disponibilité des réponses atteint 0.567 contre 0.596, soit 2.9 points de pourcentage d'écart.
La pertinence mesure si les contenus classés correspondent bien à la requête. La disponibilité des réponses indique si la recherche a fait remonter assez d'éléments pour étayer une réponse. Fast peut répondre vite tout en laissant au modèle en aval un corpus de preuves plus mince. Une question générale de politique publique, une comparaison de plusieurs entreprises ou une affirmation contestée doit donc passer par le mode web par défaut, même si la voie rapide semble plus réactive.
Perplexity publie aussi un résultat apparemment inverse dans son graphique agrégé par fournisseur. Sur six benchmarks agentiques publics et 3,554 tâches sélectionnées, Fast obtient 64.3% pour un coût total modèle-plus-recherche estimé à $59.73, tandis que le mode par défaut atteint 64.0% pour $187.60. Le fournisseur présente la configuration fast comme environ 68% moins chère, avec une qualité globale des tâches comparable.
Ces deux constats ne sont pas contradictoires. Sur des évaluations agrégées, les agents peuvent compenser une recherche moins robuste grâce aux connaissances du modèle, au raisonnement, à des appels répétés ou simplement parce que les tâches retenues ne sanctionnent pas chaque source manquante. Un système de recherche brute utilisé pour la conformité ou les études métier ne peut pas présumer que le modèle en aval réparera l'absence d'un document.
Le guide général des API de recherche IA applique le même principe opérationnel aux différents fournisseurs : achetez le niveau de recherche le moins cher qui produit un dossier de preuves accepté par le prochain contrôle déterministe.
Comment activer le mode Fast dans Perplexity Search API
Envoyez deux fois la même requête en ne modifiant que search_type. Conservez les mêmes valeurs pour query, max_results, search_context_size, les filtres, la région et la localisation du client. La référence de la Search API en ligne indique que web est le mode par défaut, que max_results vaut 10 par défaut et que high est la taille par défaut du contexte extrait. Définissez explicitement ces deux paramètres de contrôle afin qu'un changement ultérieur des valeurs par défaut de l'API ne fausse pas les tests rejoués.
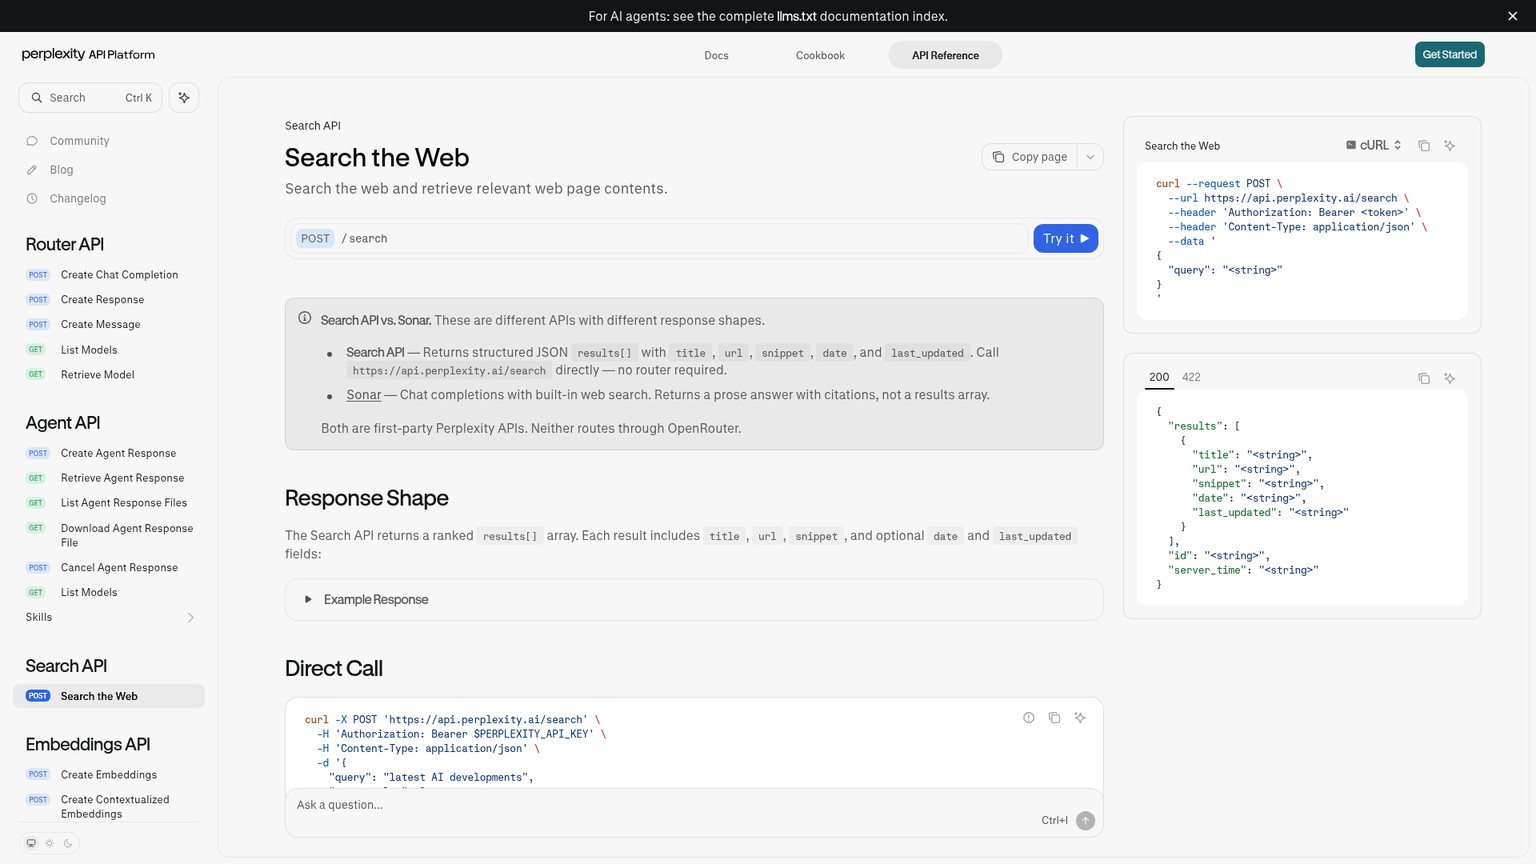
Cette paire de requêtes est exécutable telle quelle :
set -euo pipefail
: "${PERPLEXITY_API_KEY:?Set PERPLEXITY_API_KEY first}"

QUERY='Which CRM has the stronger current EU data residency and audit-control evidence?'
COMMON=$(jq -nc --arg query "$QUERY" '{
  query: $query,
  max_results: 10,
  search_context_size: "high"
}')

for MODE in fast web; do
  jq --arg mode "$MODE" '. + {search_type: $mode}' <<<"$COMMON" |
    curl -sS 'https://api.perplexity.ai/search' \
      -H "Authorization: Bearer $PERPLEXITY_API_KEY" \
      -H 'Content-Type: application/json' \
      -o "$MODE.json" \
      -w "$MODE\tHTTP %{http_code}\t%{time_total}s\n" \
      --data-binary @-
done
Aucun identifiant d'API Perplexity n'était disponible lors de cette publication. Nous ne revendiquons donc ici aucune mesure de latence, de couverture, de taux de résultats vides ou d'étayage des réponses. Le protocole ci-dessous est un petit test apparié, pas une réplication de l'étude de Perplexity sur six benchmarks.
Utilisez 20 requêtes de recherche métier : 10 recherches précises visant une source faisant autorité et 10 questions ambiguës qui nécessitent plusieurs sources. Un jeu fixe pertinent peut couvrir les tarifs SaaS actuels, les limites du cloud, des dates réglementaires, les pays pris en charge, les contrôles de sécurité, les dépôts récents, les comparatifs de fournisseurs, les effets d'une politique, des questions de coût total et des affirmations pour lesquelles il existe des éléments crédibles dans les deux sens.
À raison d'une requête par appel, ces 40 requêtes brutes réussies coûtent $0.12 avant tout appel d'un modèle en aval : $0.02 pour 20 appels fast, plus $0.10 pour 20 appels au mode web par défaut.
Figer la requête
Utilisez
max_results: 10etsearch_context_size: "high"dans les deux modes. Conservez à l'identique les filtres, le pays, la langue et la région du client. Pour chaque requête, tirez au sort le mode exécuté en premier afin que les caches chauds et les variations transitoires du réseau ne favorisent pas toujours le même.Consigner le comportement de la recherche
Enregistrez le
time_totalde bout en bout, le statut HTTP, le nombre de résultats, un indicateur de réponse vide, le nombre de domaines uniques, le nombre de sources faisant autorité et la présence éventuelle de la source principale attendue. Conservez tous les fichiers JSON bruts pour la revue.Appliquer une grille d'utilité unique
Attribuez zéro à la couverture utile si aucune source ne sert la décision, un si l'ensemble est exploitable mais incomplet, et deux si les preuves indépendantes suffisent pour avancer. N'accordez aucun point supplémentaire aux domaines dupliqués ni aux longs extraits qui répètent une même source.
Garder une couche de réponse identique
Si un modèle transforme les résultats en réponse, utilisez le même modèle, le même prompt, le même budget de tokens et le même vérificateur de citations. Notez l'étayage de la réponse à zéro si une affirmation importante n'est pas justifiée, un si les preuves sont partielles, et deux si chaque affirmation importante renvoie à un élément récupéré.
Décider par catégorie de charge
Comparez séparément, pour les recherches précises et les questions ambiguës, les médianes et la latence p95, les réponses vides, la couverture des sources et l'étayage des réponses. Ne faites passer sur fast que les catégories dont le score de preuves respecte la marge d'acceptation de l'équipe.
Le nombre moyen de résultats n'est pas le critère central. Une longue liste de liens faibles peut valoir moins qu'une poignée de sources primaires. Ce sont la couverture utile et les réponses étayées qui donnent un sens au prix et à la latence.
Le coût réel du passage à Fast Search
Modifier le corps de la requête est simple ; faire évoluer la politique opérationnelle demande le plus de travail. Basculer une charge du mode web par défaut vers fast ne nécessite ni migration de données ni nouvel endpoint. En revanche, ce changement touche le comportement de la recherche, l'identité du cache, le monitoring et la gestion des échecs.
Ajoutez search_type à la clé de cache. Une réponse fast en cache ne doit jamais servir silencieusement une requête ultérieure en mode web par défaut, dont l'appelant a payé pour une recherche plus large. Incluez également la taille du contexte, le nombre de résultats, les filtres, le pays et la langue.
Consignez le mode pour chaque requête et chaque affirmation produite en aval. Sans cette donnée, une baisse du taux d'acceptation des sources ressemble à une dérive du modèle ou à du bruit aléatoire dans la recherche. Le routeur doit aussi exposer un motif d'escalade clair, par exemple empty_results, missing_primary_source, ambiguous_query ou high_impact.
Les nouvelles tentatives doivent tenir compte du mode. Relancer le même mode après un timeout relève de la disponibilité. Passer de fast à web est une escalade de qualité qui modifie le prix. Ces deux événements ne doivent pas alimenter le même compteur.
Qui ne devrait pas basculer
Ne faites pas de Fast Search la valeur par défaut universelle si :
- L'agent traite des contrats, de la réglementation, de la sécurité, de la finance, des informations médicales ou des incidents pour lesquels manquer une source aurait de lourdes conséquences.
- La charge actuelle est dominée par des questions ambiguës qui exigent des sources variées plutôt qu'une information factuelle connue.
- Il n'existe aucune grille d'acceptation des preuves : « plus rapide » deviendrait alors le seul indicateur de réussite visible.
- Un adaptateur fournisseur ou un SDK refuse la nouvelle valeur de l'énumération et l'équipe ne peut utiliser en toute sécurité ni le contournement documenté ni des appels HTTP directs.
- Les réponses vides mais réussies ne sont pas consignées séparément des erreurs de transport.
- Le surcoût du mode web par défaut est négligeable à côté de la revue humaine déjà requise pour chaque réponse.
La meilleure migration prend la forme d'un déploiement routé. Faites passer une seule catégorie répétable vers fast, conservez web comme voie d'escalade et comparez les preuves acceptées avant d'aller plus loin.
L'action à lancer lundi
Déployez une politique de recherche simple avant de modifier la valeur par défaut globale. Envoyez les recherches répétables et à faible impact vers fast, et les questions ambiguës ou à fort impact vers web. Puis transformez tout rejet des preuves en escalade automatique, plutôt qu'en réponse faible et invisible.
Partez des requêtes de la semaine précédente, pas de démonstrations inventées. Sélectionnez-en 20 qui représentent le travail courant du produit, séparez-les en groupes précis et ambigus, puis rejouez exactement la paire ci-dessus. Si les 40 appels mono-requête réussissent, le test coûte $0.12 en frais de recherche brute.
Mardi, examinez quatre résultats : la latence p95 des requêtes, les réponses vides mais réussies, la couverture utile des sources et le score d'étayage des réponses. Si fast respecte le seuil de preuve dans le groupe précis, ne basculez que cette catégorie. S'il manque une source primaire dans le groupe ambigu, gardez le mode web par défaut, quel que soit le benchmark agrégé.
Voilà la conséquence métier de Photon : pas un réglage global moins cher, mais un véritable routeur fondé sur le risque de recherche. L'agent paie $1 pour 1,000 appels lorsque la requête tolère une marge d'erreur, puis dépense les $4 supplémentaires uniquement lorsqu'une recherche plus large peut éviter une erreur bien plus coûteuse.
Questions fréquentes
Pourquoi Perplexity suscite-t-il la controverse ?
Les débats sur le produit grand public, l'attribution des sources et les relations avec les éditeurs ne concernent pas directement ce choix de mode API. Un acheteur doit valider la couverture des sources, les conditions d'utilisation et la gestion des preuves selon les exigences propres à son organisation.
Comment définir Perplexity comme moteur de recherche par défaut ?
Il s'agit d'un réglage du navigateur ou de l'appareil. Dans ce comparatif, « par défaut » décrit le comportement de la Search API : sans search_type, elle utilise le mode web standard, tandis que Fast Search exige search_type: "fast".
Pourquoi Perplexity échoue-t-il ?
La question est trop générale pour recevoir une réponse à partir des éléments API cités. Pour une intégration, définissez précisément l'échec : résultat vide, absence de la source primaire attendue, couverture utile trop faible, réponse non étayée, timeout ou erreur en amont.
Pour la recherche, Perplexity vaut-il mieux que le mode IA de Google ?
Cette question compare des produits de réponse destinés au grand public, pas les modes de la Search API brute de Perplexity. Le choix entre Fast et le mode web par défaut doit reposer sur la latence de recherche, la couverture utile des sources et les preuves qui étayent la réponse en aval.
Pourquoi Joe Rogan utilise-t-il Perplexity ?
Une recommandation publique ou une publicité n'établit aucune raison technique et ne fournit aucune preuve en faveur de fast ou de web. Pour choisir le mode API, fiez-vous aux données de la charge réelle, pas à l'usage d'une célébrité.
Perplexity est-il encore performant ?
Fast Search remplit clairement son rôle à $1 pour 1,000 requêtes brutes réussies, et Perplexity annonce une latence p50 de 160 ms. Les résultats de recherche publiés par le fournisseur montrent aussi que le mode web par défaut reste préférable lorsque la pertinence globale et la disponibilité des réponses comptent davantage.
Quel est le principal inconvénient de Perplexity ?
Pour Fast Search, l'inconvénient documenté est une pertinence plus faible et une moindre disponibilité des réponses. Pour le mode web par défaut, c'est un prix par requête brute cinq fois plus élevé et une latence supérieure à celle du mode spécialement conçu pour la vitesse.
Perplexity perd-il des utilisateurs ?
Les pages de lancement et d'API citées ne publient aucune tendance auditée sur les utilisateurs actifs ; ce comparatif ne peut donc pas étayer cette affirmation. De toute façon, l'évolution du nombre d'utilisateurs ne détermine pas quel mode de Search API convient à une requête en production.
Perplexity AI est-il meilleur que ChatGPT ?
La Search API brute de Perplexity renvoie des résultats web classés qu'un autre système doit traiter, tandis que ChatGPT est un assistant destiné aux utilisateurs finaux, avec ses propres outils et modèles. Comparez les workflows concrets et leurs exigences de preuve, pas les marques dans l'absolu.
Vous voulez réunir les questions de routage, de validation et de coût dans un même document opérationnel ? Téléchargez la checklist d'audit des workflows métier avec l'IA et préparez dès lundi votre premier routeur fondé sur le risque de recherche.
- Dernière mise à jour
- 24 sept. 2026
- Catégorie
- Build
Préférez ce site dans Google


Marquez omidsaffari.com comme source préférée et Google le met en avant pour vous dans Top Stories, AI Overviews et AI Mode.

Agent IA : le coût caché d’un fallback mal conçu
Un agent IA peut faire exploser les coûts lorsqu’un fallback payant devient le chemin par défaut. Voici les signaux de la panne et le correctif durable.24 sept. 2026Build
Cursor gratuit ? Rollouts reste payant après les crédits
Cursor Rollouts n’est pas gratuit : accès dès Teams à $40 par utilisateur, crédits de 10 jours et tarif d’usage encore non publié. Voici quoi vérifier.24 sept. 2026Build
Unreal Agent : mettre un agent IA open source à l’épreuve
Installez et évaluez Unreal Agent, un agent IA open source en Go, sur une tâche de dépôt ciblée avant de l’intégrer à vos workflows de développement.24 sept. 2026Build
JetBrains Air : prendre en main le plugin Alpha pas à pas
Découvrez comment installer JetBrains Air Alpha, connecter un agent de codage, cibler le bon contexte et valider chaque modification dans votre IDE.23 sept. 2026Build
JetBrains Air à $0 : qui paie vraiment les agents ?
Le plugin JetBrains Air est gratuit, mais chaque agent suit sa propre facturation. Comparez Junie Lite, abonnements, API et crédits JetBrains AI.23 sept. 2026Build
Firecrawl Docker : auto-hébergement, vérification et coûts réels
Déployez Firecrawl avec Docker, validez un vrai scrape et comparez sur 30 jours le coût réel de l’auto-hébergement à celui de Firecrawl Cloud.22 sept. 2026Build
Agent IA : pourquoi un retry payant exige une validation humaine
Un agent IA a relancé des rendus payants sans accord humain. Voici où placer le contrôle qui sépare diagnostic, autorisation et décision de dépense.22 sept. 2026Build