Perplexity Suchmaschine: Fast Search oder Web?
Perplexity Suchmaschine im Vergleich: Fast Search oder Web? Preise, Tempo, Quellenabdeckung und die passende API-Einstellung für KI-Agenten.




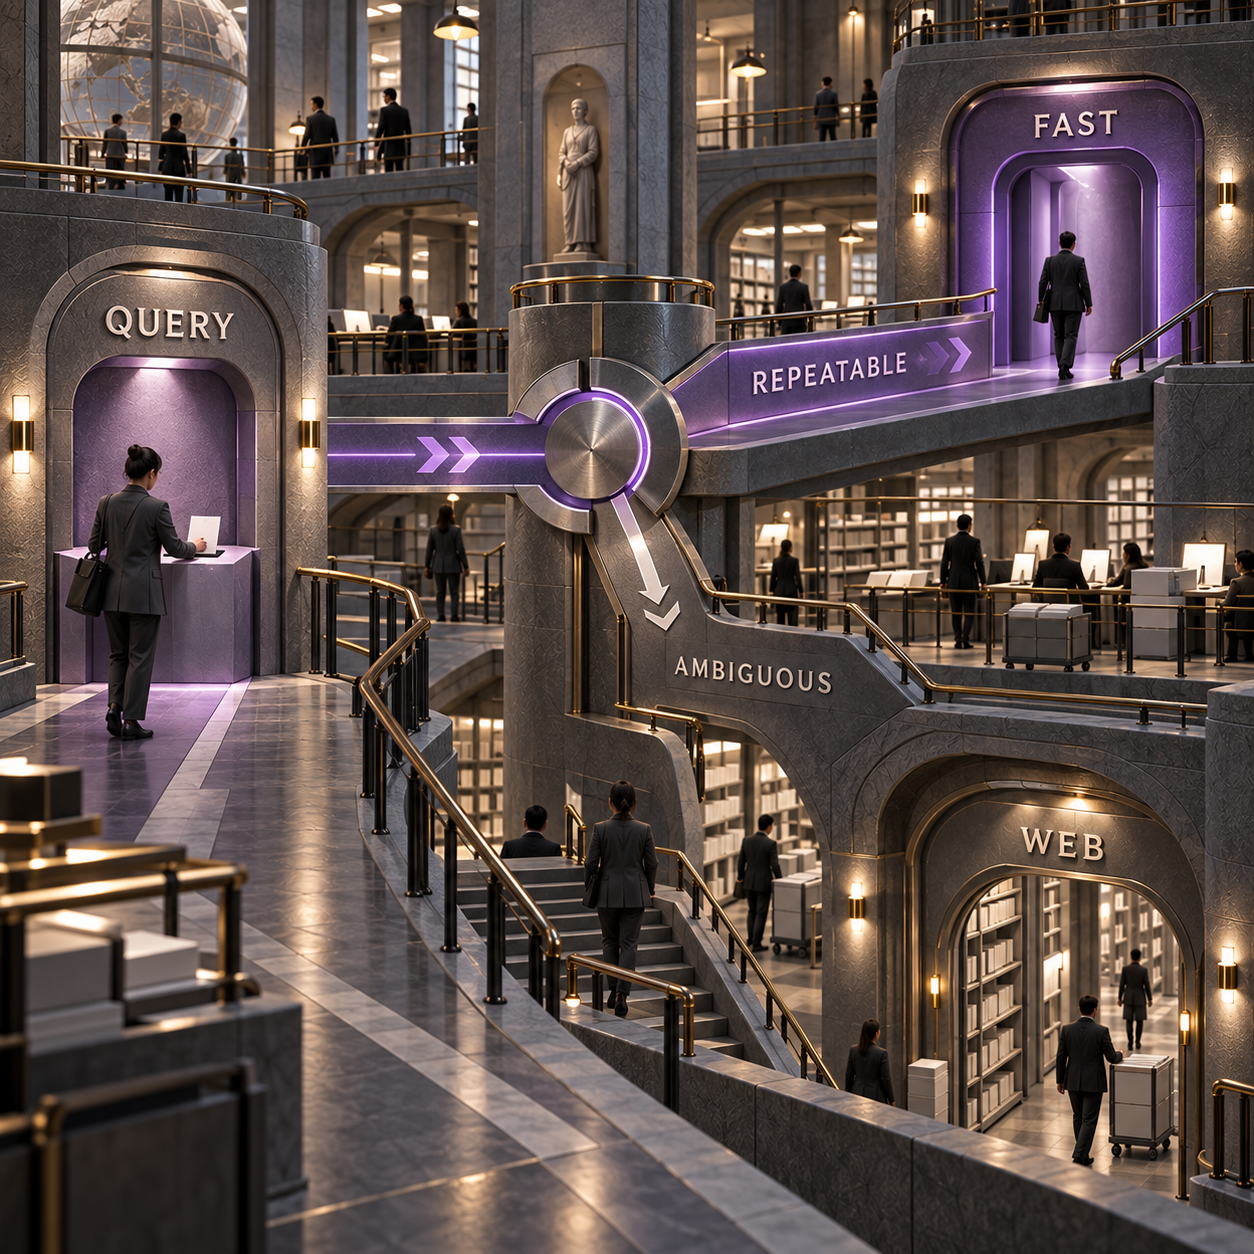
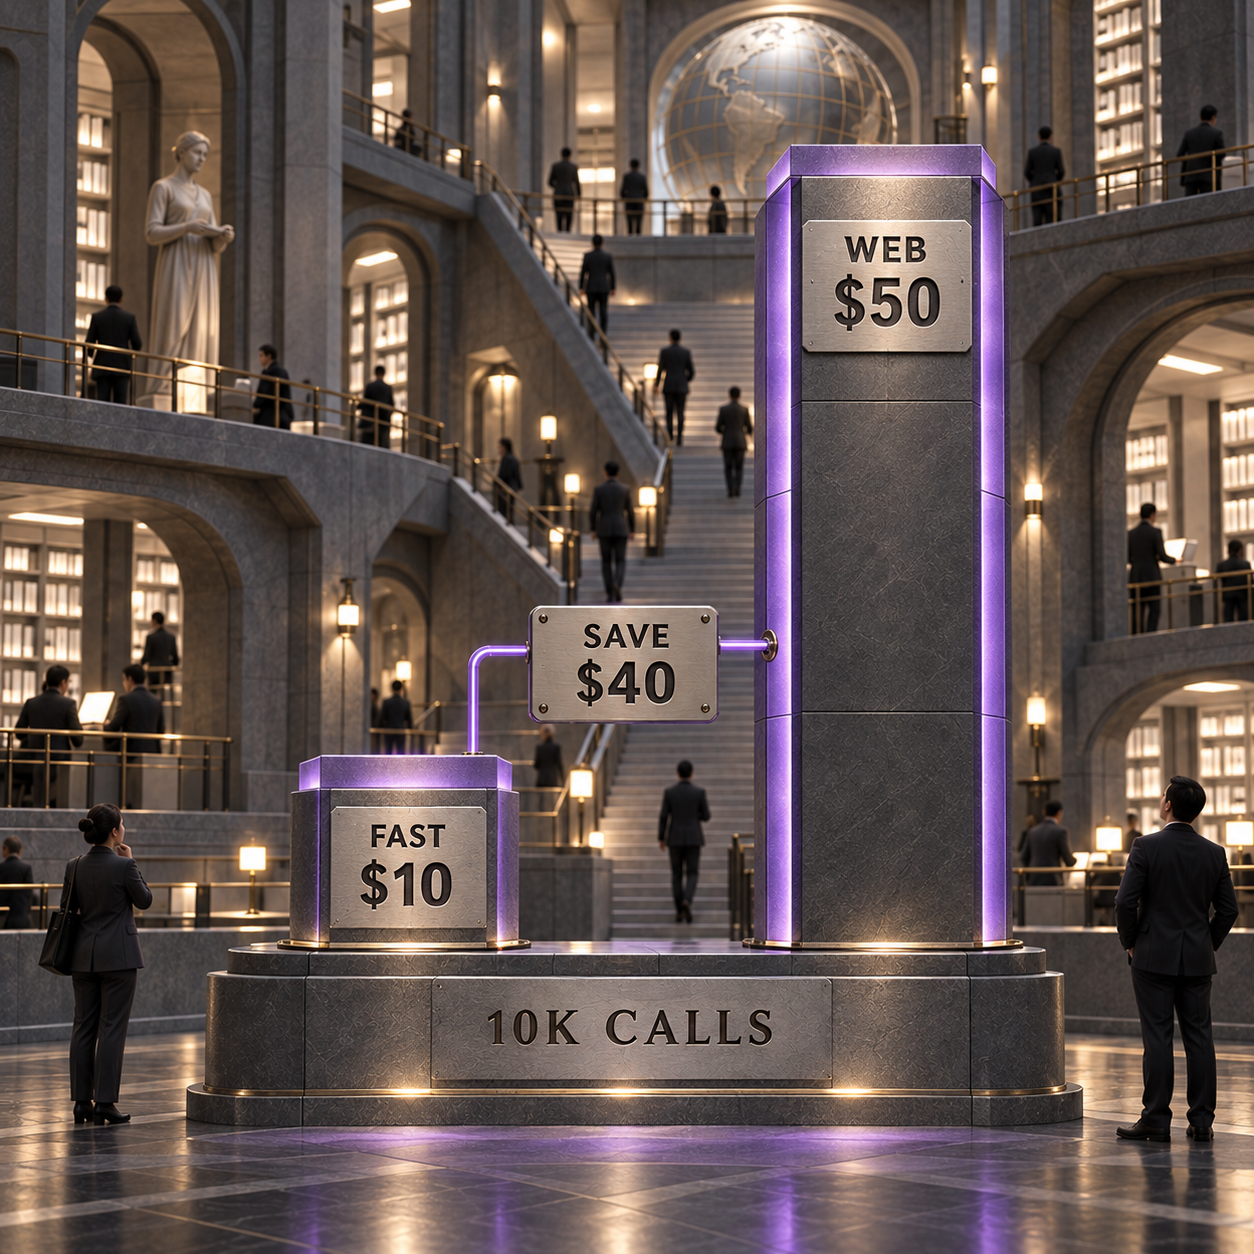
Bei der Perplexity Suchmaschine ist die Wahl zwischen Fast Search und dem Standardmodus vor allem eine Routingfrage: fast eignet sich für wiederholbare Abfragen von Agenten und kostet $1 je 1,000 erfolgreiche Aufrufe. Für mehrdeutige Recherchen oder Aufgaben, bei denen eine breite Quellenabdeckung zählt, bleibt der standardmäßige web-Modus für $5 die bessere Wahl. Bei 10,000 Aufrufen kostet die reine Suche damit $10 statt $50 – noch bevor das Modell abgerechnet wird, das die Ergebnisse verarbeitet.
Perplexity Suchmaschine: Fast Search oder Web – welcher Modus passt?
Fast Search ist die richtige Wahl für klar umrissene, wiederkehrende Aufgaben; die standardmäßige Websuche empfiehlt sich, sobald eine übersehene Quelle die Entscheidung verändern könnte. Bei Preis und Latenz liegt Fast vorn. Beim Abruf relevanter Quellen und bei der Wahrscheinlichkeit, überhaupt genügend Material für eine Antwort zu finden, gewinnt die Websuche. In einer produktiven Agentenarchitektur sollten beide Modi gezielt angesteuert werden, statt jede Anfrage durch denselben Kanal zu schicken.
Der aktuelle Leitfaden von Perplexity zu Fast Search empfiehlt fast für alltägliche Agentenaufgaben und die Standardeinstellung web für seltene, schwierige oder mehrdeutige Fragen. Preise und Anbietermesswerte in diesem Vergleich wurden am 24. September 2026 mit den Live-Seiten von Perplexity abgeglichen.
Wer allein einen Support-Agenten entwickelt, sollte routinemäßige Abfragen zu Dokumentation und Systemstatus zunächst über fast führen und bei leeren Ergebnissen oder schwacher Beleglage auf web eskalieren. Der Aufpreis von $0.004 für einen Standard-Web-Aufruf fällt kaum ins Gewicht, wenn ein Fehltreffer sonst eine manuelle Prüfung auslöst. Bei einer risikoarmen Abfrage, die tausendfach wiederholt wird, ist er dagegen unnötig.
Für ein finanziertes Start-up mit Marktforschungsprodukt sollte die Standard-Websuche mehrdeutige Fragen zu Unternehmen, Regulierung und Wettbewerb übernehmen. Fast bleibt sinnvoll für Prüfungen bekannter Quellen, Produktverfügbarkeit und wiederkehrendes Monitoring. Auch wenn das Produkt nur ein Suchfeld zeigt, liegen dahinter zwei unterschiedliche Abrufklassen.
Ein CTO im Mittelstand sollte bei Beschaffung, Sicherheit, Regulierung und Vorfallanalyse zunächst bei der Standard-Websuche bleiben – bis ein interner Replay belegt, dass Fast Search die benötigte Quellenmenge bewahrt. Eine fünfmal günstigere Anfrage spart nichts, wenn anschließend ein Analyst die Belegsammlung reparieren muss.
Perplexity Fast Search API: Was ändert sich durch Photon?
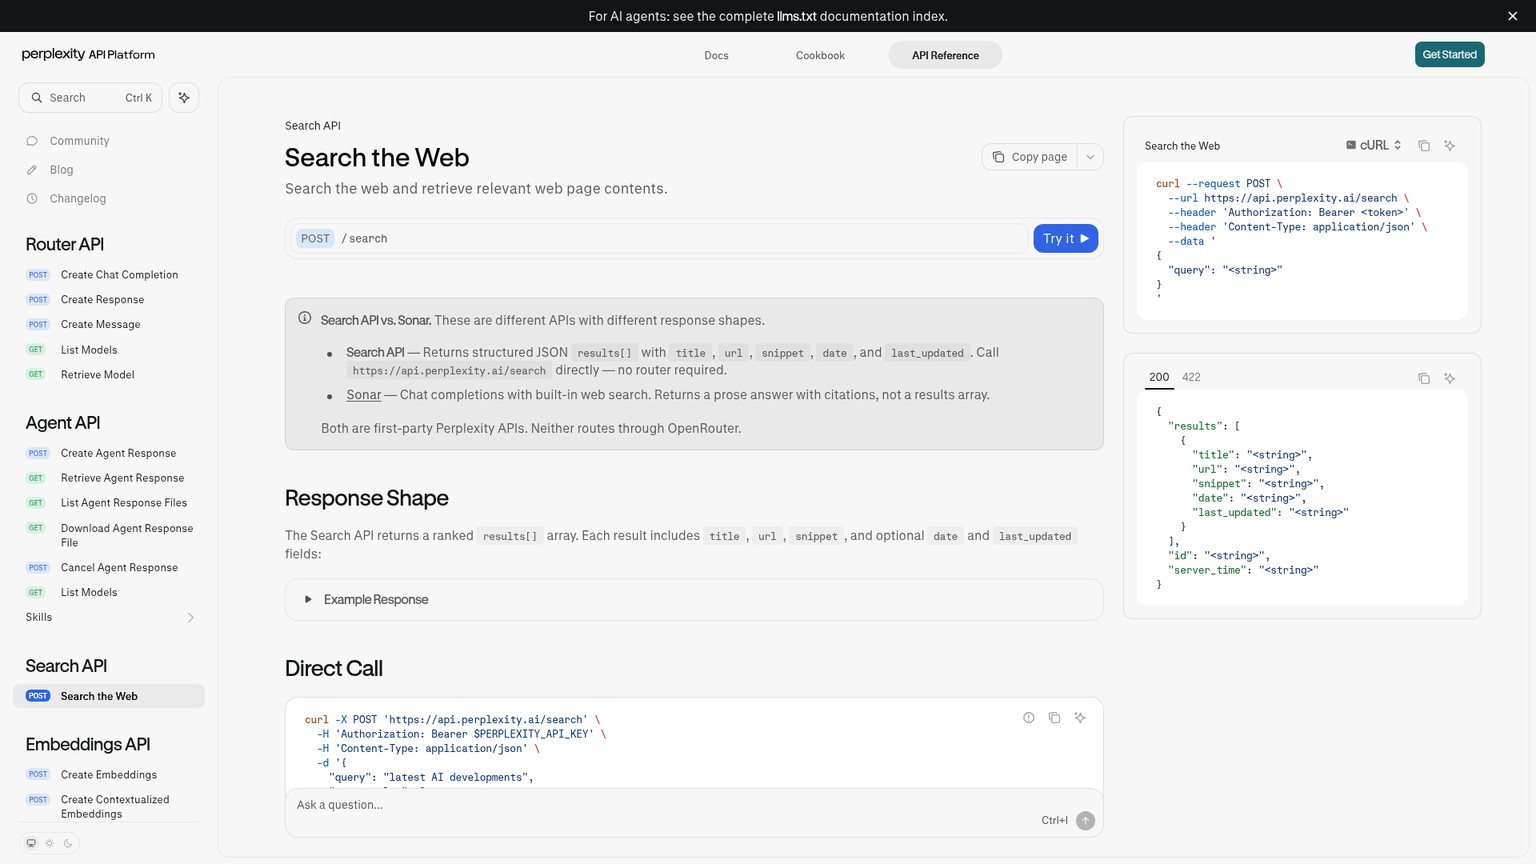
Fast Search verändert das Abrufbudget, nicht den Endpunkt oder das Ergebnisschema. Perplexity veröffentlichte den Modus am 24. September 2026 auf Basis von Photon, der hauseigenen Engine für Abruf und Ranking. Die aktuelle Fast-Search-Dokumentation bestätigt die Verfügbarkeit: Derselbe Endpunkt POST /search liefert weiterhin das geordnete Array results[]; zur Anfrage kommt lediglich search_type: "fast" hinzu.
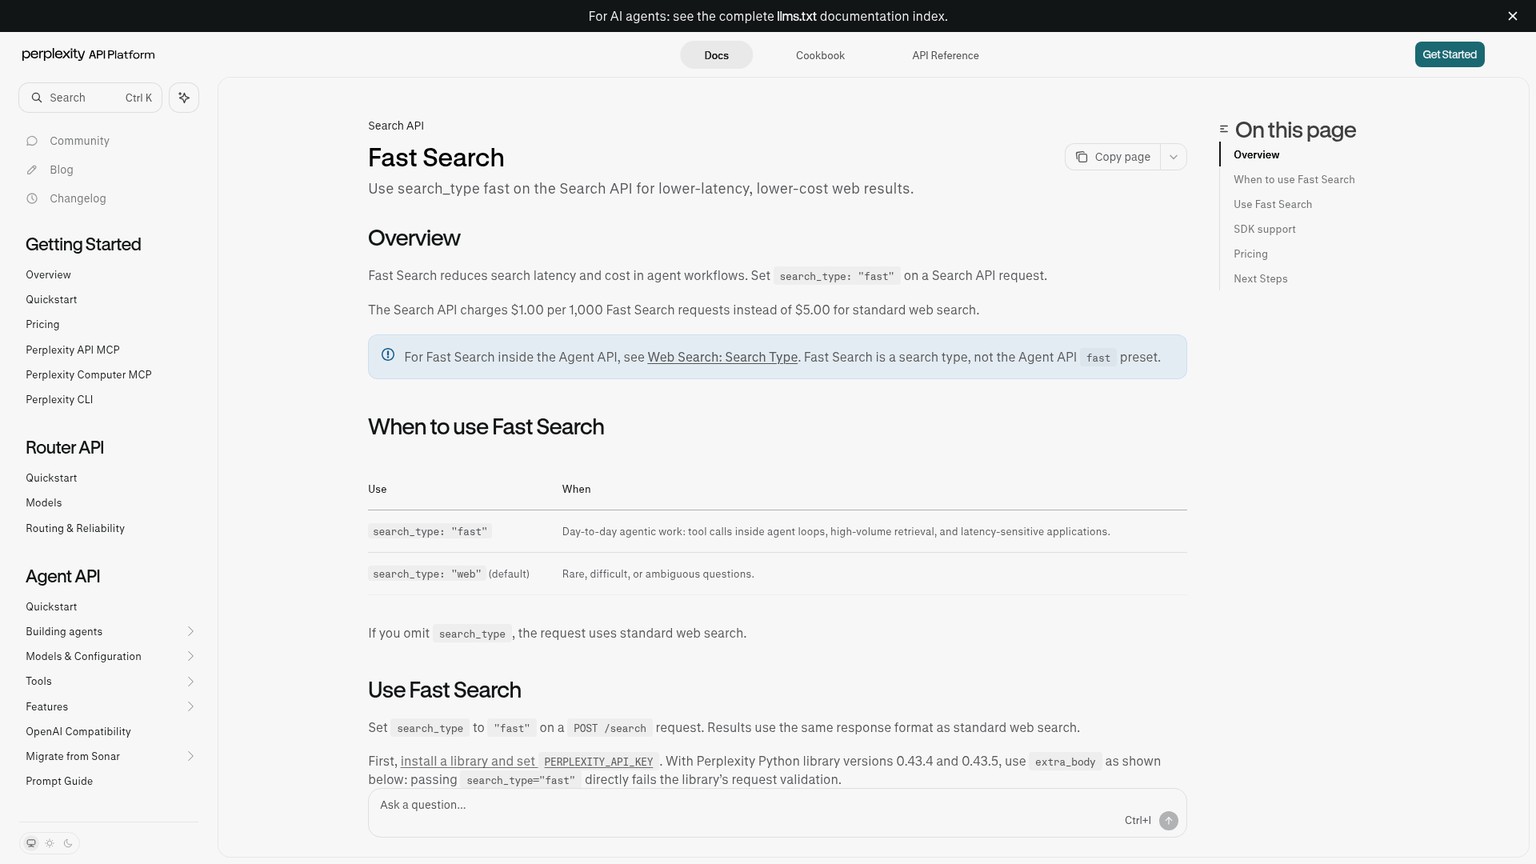
Fehlt search_type, verwendet Perplexity den Standard web. Das ist wichtig, denn „Standard“ bezeichnet hier nicht das voreingestellte Sprachmodell in der Perplexity-App für Endkunden. Gemeint ist der normale Abrufmodus der Search API. Beide Modi liefern Titel, URLs, Snippets sowie optional Veröffentlichungs- und Aktualisierungsdaten für die nachgelagerte Verarbeitung.
In der Photon-Veröffentlichung ist von einer Engine die Rede, die nur die für eine Anfrage benötigten Daten liest, Wartezeiten beim Plattenzugriff überlappt und einen stapelbewussten Cache nutzt. Die offizielle Architekturgrafik von Perplexity zeigt den Anfrageweg durch Broker und Shards. Diese Technik erklärt das Geschwindigkeitsversprechen. Sie beseitigt aber nicht den bewusst eingegangenen Ranking-Kompromiss: Fast Search beansprucht weniger Rechenleistung und verzichtet dafür auf einen Teil der breiteren Abrufqualität.
Perplexity Photon ist die Engine, kein dritter Modus
Photon arbeitet als Infrastruktur unterhalb des Perplexity-Suchstacks. Auf API-Ebene bleiben die Optionen fast, web und der separate Suchtyp people. Entwickler wählen Photon weder direkt aus noch stellen sie die Engine selbst bereit; auch das Antwortobjekt ändert sich nicht.
Bei den aktuellen SDKs gibt es eine praktische Einschränkung. Für die Python-Bibliotheksversionen 0.43.4 und 0.43.5 dokumentiert Perplexity extra_body={"search_type": "fast"}, weil die direkte Validierung den neuen Wert ablehnt. Im TypeScript-Beispiel wird mit SDK 0.38.5 vorübergehend auf "fast" as any zurückgegriffen, bis die Typdefinitionen nachgezogen haben. Direkte HTTP-Anfragen umgehen beide clientseitigen Übergangsprobleme.
Kosten der Perplexity Search API: $10 statt $50 bei 10,000 Anfragen
Sieger: Fast Search. Laut aktueller Preistabelle von Perplexity kosten 1,000 erfolgreiche reine Fast-Search-Anfragen $1. Für 1,000 erfolgreiche Anfragen über die Standard-Websuche werden $5 berechnet; eine zusätzliche Tokengebühr für die Search API fällt nicht an.
Für die normierte Auslastung ergibt sich eine einfache Rechnung:
- 10,000 Fast-Search-Aufrufe: 10,000 × $0.001 = $10.
- 10,000 Aufrufe der Standard-Websuche: 10,000 × $0.005 = $50.
- Differenz: $40 beziehungsweise 80% weniger in der reinen Abrufposition.
Die $40 bilden nicht die gesamte Agentenrechnung ab. Das Modell, das die Ergebnisse liest, weitere Abrufe, Wiederholungsversuche, Validierung und manuelle Prüfung kommen nachgelagert hinzu. Fast gewinnt nur dann, wenn es über diese 10,000 Aufrufe nicht mehr als $40 Zusatzaufwand verursacht.
Auch erfolgreiche leere Antworten kosten Geld
Eine erfolgreiche Antwort auf POST /search wird auch dann berechnet, wenn results[] leer bleibt. Ungültige Anfragen, durch Ratenbegrenzung abgewiesene Anfragen und Fehler vorgelagerter Systeme werden nach den aktuellen Preisregeln nicht in Rechnung gestellt. Die Quote leerer Ergebnisse ist damit nicht nur eine Qualitäts-, sondern auch eine Budgetkennzahl.
Batching verändert die Rechnung, nicht die Qualitätsentscheidung
Der Schnellstart für Mehrfachanfragen von Perplexity nimmt bis zu fünf zusammengehörige Suchanfragen in einer Anfrage an. Eine erfolgreiche Mehrfachanfrage gilt als eine Abrechnungseinheit, obwohl jede einzelne Suchanfrage weiterhin auf die Ratenbegrenzung angerechnet wird. Zwanzig Suchanfragen, gebündelt in vier Anfragen je Modus, würden zusammen $0.024 kosten; 40 getrennte Einzelanfragen kämen dagegen auf $0.12.
Für einen Latenzvergleich einzelner Aufrufe eignet sich Batching nicht. Eine Nutzlast mit fünf Suchanfragen verändert die Arbeit pro Anfrage und verdeckt die Laufzeit der einzelnen Suche. Verglichen werden sollten zunächst 20 Einzelanfragen je Modus. Batching lässt sich getrennt testen, sobald die Modusentscheidung belastbar ist.
Tarife der Agent-API-Tools separat budgetieren
In der Tool-Tabelle der Agent API gelten andere Standardpreise: $1 je 1,000 schnelle web_search-Aufrufe und $2.50 je 1,000 Standard-Web-Aufrufe, jeweils zuzüglich der Tokenkosten des gewählten Modells. Diese Werte sind nicht mit den Tarifen von $1 und $5 für die reine Search API gleichzusetzen. Trotz des wiederverwendeten Begriffs ist Fast Search außerdem nicht das separate fast-Preset der Agent API.
Der ältere Kostenvergleich von Perplexity, Exa und Tavily beantwortet die Frage nach dem passenden Anbieter. Die hier betrachtete Entscheidung liegt eine Ebene tiefer – nachdem Perplexity bereits Teil des Stacks ist.
Schnellster Modus: Fast – mit einem Vorbehalt bei der Anbietermessung
Sieger: Fast Search, gemessen von Perplexity. Die offizielle Latenzgrafik nennt für einen einzelnen Fast-Search-Aufruf 160 ms bei p50 und 230 ms bei p95. Im begleitenden Einführungstext und im aktuellen Fast-Search-Leitfaden veröffentlicht Perplexity keine direkt vergleichbaren p50- und p95-Werte für die Standard-Websuche. Ein belastbares Verhältnis der beiden Latenzen lässt sich daher nicht angeben.
Die Perzentile sind entscheidend: p50 bezeichnet die mittlere Anfrage. p95 ist die Schwelle, unterhalb derer 95% der Anfragen abgeschlossen sind. Ein Agent mit mehreren aufeinanderfolgenden Suchaufrufen spürt das langsame Ende der Verteilung stärker als den Median, denn ein einziges verzögertes Tool kann den gesamten Ablauf aufhalten.
Damit gehört der latenzkritische Pfad zu Fast. Die eigentliche Produktionsentscheidung bleibt jedoch vom Workload abhängig. Netzwerkentfernung, Filter, gewünschte Ergebniszahl, extrahierter Kontext, Batching und Wiederholungsstrategie beeinflussen die End-to-End-Zeit des Agenten. Der Anbieterwert ist ein Ausgangspunkt, aber kein Serviceversprechen für jede Integration.
Mikhail Basyuk setzt für die Praxis den richtigen Maßstab: Ein p95 unter 250 ms ist nur dann hilfreich, wenn die für die Aufgabe erforderliche Relevanz erhalten bleibt. Geschwindigkeit und Belegqualität gehören auf dasselbe Dashboard.
Beste Quellenabdeckung: Standard-Websuche
Sieger: die Standard-Websuche bei schwierigen und mehrdeutigen Recherchen. Die interne Abrufgrafik von Perplexity weist Fast Search einen Relevanzwert von 2.21 zu; der Standardmodus erreicht 2.45. Das entspricht einer Differenz von 0.24 Punkten. Bei der Antwortverfügbarkeit stehen 0.567 und 0.596 gegenüber – ein Abstand von 2.9 Prozentpunkten.
Relevanz beschreibt, wie gut das geordnete Material zur Anfrage passt. Die Antwortverfügbarkeit gibt an, ob der Abruf genug Material für eine Antwort zutage gefördert hat. Fast kann schnell reagieren und dem nächsten Modell trotzdem eine dünnere Belegbasis liefern. Deshalb gehören breit angelegte Fragen zu Richtlinien, Vergleiche mehrerer Unternehmen oder strittige Behauptungen in die Standard-Websuche, selbst wenn sich der schnelle Pfad reaktionsfreudiger anfühlt.
In einer aggregierten Anbietergrafik meldet Perplexity zugleich ein scheinbar gegenteiliges Ergebnis. Über sechs öffentliche Benchmarks für agentische Systeme und 3,554 ausgewählte Aufgaben erzielte Fast 64.3% bei geschätzten $59.73 Gesamtkosten für Modell und Suche. Der Standardmodus kam auf 64.0% bei $187.60. Der Anbieter beschreibt die schnelle Konfiguration als rund 68% günstiger bei vergleichbarer aggregierter Aufgabenqualität.
Beide Befunde können gleichzeitig stimmen. Aggregierte Agentensysteme können einen schwächeren Abruf durch Modellwissen, Schlussfolgerungen, wiederholte Aufrufe oder durch eine Aufgabenauswahl ausgleichen, die nicht jede fehlende Quelle bestraft. Ein reines Abrufsystem für Compliance- oder Geschäftsrecherchen darf nicht voraussetzen, dass das nachgelagerte Modell ein fehlendes Dokument ersetzt.
Der umfassendere Leitfaden zu KI-Such-APIs folgt bei allen Anbietern demselben Betriebsprinzip: Bezahlt wird für die günstigste Abrufstufe, deren Belegsammlung die nächste deterministische Prüfung akzeptiert.
Perplexity Search API auf Fast Search einstellen
Dieselbe Anfrage zweimal senden und nur search_type ändern. query, max_results, search_context_size, Filter, Region und Clientstandort müssen konstant bleiben. Die aktuelle Referenz der Search API dokumentiert web als Standard, 10 als Standardwert für max_results und high als Standardgröße für den extrahierten Kontext. Beide Vergleichsparameter sollten ausdrücklich gesetzt werden, damit eine spätere Änderung der API-Vorgabe den Replay nicht verfälscht.
Dieses Anfragepaar ist direkt ausführbar:
set -euo pipefail
: "${PERPLEXITY_API_KEY:?Set PERPLEXITY_API_KEY first}"

QUERY='Which CRM has the stronger current EU data residency and audit-control evidence?'
COMMON=$(jq -nc --arg query "$QUERY" '{
  query: $query,
  max_results: 10,
  search_context_size: "high"
}')

for MODE in fast web; do
  jq --arg mode "$MODE" '. + {search_type: $mode}' <<<"$COMMON" |
    curl -sS 'https://api.perplexity.ai/search' \
      -H "Authorization: Bearer $PERPLEXITY_API_KEY" \
      -H 'Content-Type: application/json' \
      -o "$MODE.json" \
      -w "$MODE\tHTTP %{http_code}\t%{time_total}s\n" \
      --data-binary @-
done
Für diesen Veröffentlichungslauf standen keine Zugangsdaten zur Perplexity API bereit. Deshalb werden hier keine selbst gemessenen Werte für Latenz, Abdeckung, Leerergebnisquote oder Antwortbelege behauptet. Das folgende Protokoll ist ein kleiner gepaarter Test und keine Replikation der Perplexity-Studie mit sechs Benchmarks.
Verwendet werden 20 Suchanfragen aus der Geschäftspraxis: 10 konkrete Abfragen mit einer maßgeblichen Zielquelle und 10 mehrdeutige Fragen, die mehrere Quellen verlangen. Ein brauchbarer fester Satz kann aktuelle SaaS-Preise, Cloud-Limits, regulatorische Termine, unterstützte Länder, Sicherheitskontrollen, jüngste Geschäftsberichte, Anbietervergleiche, Auswirkungen von Richtlinien, Gesamtkostenfragen und Behauptungen mit belastbaren Belegen für beide Seiten abdecken.
Bei einzelnen Suchanfragen kosten diese 40 erfolgreichen reinen Anfragen $0.12, bevor ein nachgelagertes Modell aufgerufen wird: $0.02 für 20 Fast-Aufrufe plus $0.10 für 20 Aufrufe der Standard-Websuche.
Anfrage unveränderlich festlegen
Für beide Modi
max_results: 10undsearch_context_size: "high"verwenden. Filter, Land, Sprache und Clientregion müssen identisch bleiben. Die Reihenfolge der Modi sollte für jede Suchanfrage zufällig wechseln, damit warme Caches und vorübergehende Netzwerkeffekte nicht immer dieselbe Seite begünstigen.Abrufverhalten protokollieren
End-to-End-
time_total, HTTP-Status, Ergebniszahl, Kennzeichen für leere Antworten, eindeutige Domains, Anzahl maßgeblicher Quellen und das Vorhandensein der erwarteten Primärquelle erfassen. Sämtliche JSON-Rohdaten für die Prüfung aufbewahren.Einheitliches Nützlichkeitsraster anwenden
Die brauchbare Quellenabdeckung mit null bewerten, wenn keine entscheidungsrelevante Quelle vorliegt, mit eins für eine nutzbare, aber unvollständige Sammlung und mit zwei, wenn genügend unabhängige Belege für eine Entscheidung vorhanden sind. Doppelte Domains oder lange Snippets, die nur dieselbe Quelle wiederholen, erhalten keine Zusatzpunkte.
Antwortschicht konstant halten
Wenn ein Modell aus den Ergebnissen eine Antwort formuliert, müssen Modell, Prompt, Tokenbudget und Zitationsprüfung identisch bleiben. Die Belegqualität der Antwort erhält null Punkte, wenn einer wesentlichen Aussage der Beleg fehlt, eins bei teilweiser Stützung und zwei, wenn jede wesentliche Aussage auf zurückgegebenen Belegen beruht.
Nach Workload-Klasse entscheiden
Median und p95-Latenz, leere Antworten, Quellenabdeckung und Antwortbelege für die konkreten und mehrdeutigen Gruppen getrennt vergleichen. Fast darf nur für eine Klasse ausgerollt werden, deren Belegwert innerhalb des Akzeptanzbereichs des Teams bleibt.
Die entscheidende Vergleichsgröße ist nicht die durchschnittliche Ergebniszahl. Eine Ansammlung schwacher Links kann schlechter sein als eine kleine Auswahl von Primärquellen. Erst brauchbare Abdeckung und belegte Antworten verleihen Preis und Latenz Aussagekraft.
Was ein Wechsel tatsächlich kostet
Den Anfragekörper zu ändern ist leicht; die eigentliche Arbeit steckt in der Betriebsrichtlinie. Für den Wechsel eines Workloads von der Standard-Websuche zu Fast sind weder Datenmigration noch ein neuer Endpunkt nötig. Trotzdem verändern sich Abrufverhalten, Cache-Identität, Monitoring und Fehlerbehandlung.
search_type gehört in den Cache-Schlüssel. Eine gespeicherte Fast-Antwort darf nicht stillschweigend eine spätere Standard-Web-Anfrage bedienen, deren Aufrufer für einen breiteren Abruf bezahlt hat. Aus demselben Grund müssen Kontextgröße, Ergebniszahl, Filter, Land und Sprache einfließen.
Der Modus sollte für jede Anfrage und jede nachgelagerte Aussage protokolliert werden. Andernfalls wirkt eine sinkende Akzeptanzrate von Quellen wie Modelldrift oder zufälliges Suchrauschen. Der Router braucht außerdem sichtbare Eskalationsgründe wie empty_results, missing_primary_source, ambiguous_query oder high_impact.
Auch Wiederholungsversuche müssen den Modus berücksichtigen. Ein erneuter Versuch im selben Modus dient der Verfügbarkeit. Der Wechsel von fast zu web ist dagegen eine Qualitätseskalation und ändert den Preis. Beide Ereignisse dürfen nicht in derselben Kennzahl verschwinden.
Wer nicht wechseln sollte
Fast Search sollte nicht zum allgemeinen Standard werden, wenn:
- der Agent Verträge, Regulierung, Sicherheit, Finanzen, medizinische Informationen oder Vorfälle bearbeitet, bei denen eine fehlende Quelle gravierende Folgen haben kann;
- der aktuelle Workload überwiegend aus mehrdeutigen Fragen besteht, die Quellenvielfalt statt einer bekannten Tatsachenabfrage verlangen;
- kein Raster für akzeptierte Belege existiert und „schneller“ dadurch zur einzigen sichtbaren Erfolgskennzahl würde;
- ein Provider-Adapter oder SDK den neuen Enum-Wert ablehnt und das Team weder den dokumentierten Workaround noch direkte HTTP-Anfragen sicher einsetzen kann;
- erfolgreiche leere Antworten nicht getrennt von Transportfehlern protokolliert werden;
- der Aufpreis für die Standard-Websuche gegenüber der ohnehin für jede Antwort erforderlichen manuellen Prüfung keine Rolle spielt.
Sinnvoller ist eine geroutete Einführung: Zunächst wird eine wiederkehrende Klasse auf fast umgestellt, web bleibt als Eskalationspfad erhalten, und vor jeder Ausweitung werden die akzeptierten Belege verglichen.
Der nächste Montagsschritt
Vor einer Änderung des globalen Standards sollte eine einfache Suchrichtlinie produktiv gehen. Wiederkehrende, wenig folgenreiche Abfragen werden an fast geroutet; mehrdeutige oder folgenreiche Fragen gehen an web. Abgelehnte Belege lösen anschließend automatisch eine Eskalation aus, statt unbemerkt in eine schwache Antwort einzufließen.
Ausgangspunkt sind die Anfragen der vergangenen Woche, nicht eigens konstruierte Demos. Ausgewählt werden 20 typische Produktanfragen, aufgeteilt in konkrete und mehrdeutige Gruppen; anschließend wird das obige Paar unverändert wiederholt. Sind alle 40 Einzelanfragen erfolgreich, kostet der Test $0.12 an reinen Suchgebühren.
Am Dienstag werden vier Ergebnisse geprüft: p95-Anfragelatenz, erfolgreiche leere Antworten, brauchbare Quellenabdeckung und der Wert für Antwortbelege. Hält Fast in der konkreten Gruppe den Belegstandard, wird nur diese Klasse umgestellt. Fehlt bei den mehrdeutigen Anfragen eine Primärquelle, bleibt dort unabhängig vom aggregierten Benchmark die Standard-Websuche aktiv.
Das ist die geschäftliche Konsequenz von Photon: keine einzelne, günstigere Globaleinstellung, sondern ein praktikabler Suchrisiko-Router. Der Agent zahlt $1 je 1,000 Aufrufe, wenn die Anfrage fehlertolerant ist, und die zusätzlichen $4 nur dort, wo ein breiterer Abruf einen teureren Fehltreffer verhindern kann.
Häufig gestellte Fragen
Warum ist Perplexity umstritten?
Debatten über das Endkundenprodukt, Quellenangaben und die Beziehungen zu Verlagen sind von dieser Wahl des API-Modus getrennt zu betrachten. Käufer einer API sollten Quellenabdeckung, Nutzungsbedingungen und Belegverarbeitung anhand der eigenen organisatorischen Anforderungen prüfen.
Wie lässt sich Perplexity als Standardsuchmaschine festlegen?
Das ist eine Einstellung des Browsers oder Geräts. In diesem Vergleich bezeichnet „Standard“ das Verhalten der Search API: Ohne search_type wird der normale Modus web verwendet; Fast Search erfordert dagegen search_type: "fast".
Warum schlägt Perplexity fehl?
Diese Annahme ist zu pauschal, um sie aus den angeführten API-Belegen abzuleiten. Für eine Integration muss ein Fehler konkret definiert werden: als leeres Ergebnis, fehlende erwartete Primärquelle, unzureichende brauchbare Abdeckung, unbelegte Antwort, Zeitüberschreitung oder Fehler eines vorgelagerten Systems.
Was eignet sich besser für die Suche: Perplexity oder der KI-Modus von Google?
Damit würden Endkundenprodukte für Antworten verglichen, nicht die reinen Search-API-Modi von Perplexity. Die Entscheidung zwischen Fast und Standard-Websuche sollte sich an Abruflatenz, brauchbarer Quellenabdeckung und der Belegqualität der nachgelagerten Antwort orientieren.
Warum nutzt Joe Rogan Perplexity?
Eine öffentliche Empfehlung oder Werbung liefert keinen technischen Grund und keinen Beleg für die Wahl zwischen fast und web. Entscheidend für die API-Auswahl sind Workload-Daten, nicht die Nutzung durch Prominente.
Ist Perplexity noch gut?
Fast Search erfüllt zu $1 je 1,000 erfolgreiche reine Anfragen eine klar definierte Aufgabe, und Perplexity nennt eine p50-Latenz von 160 ms. Zugleich zeigen die eigenen Abrufwerte des Anbieters, dass die Standard-Websuche die bessere Wahl bleibt, sobald breitere Relevanz und Antwortverfügbarkeit wichtig sind.
Welchen Nachteil hat Perplexity?
Bei Fast Search liegt der dokumentierte Nachteil in der geringeren Abrufrelevanz und Antwortverfügbarkeit. Bei der Standard-Websuche sind es der fünffach höhere Preis pro reiner Anfrage und die höhere Latenz gegenüber dem ausdrücklich auf Geschwindigkeit ausgelegten Modus.
Verliert Perplexity Nutzer?
Die zitierten Einführungs- und API-Seiten veröffentlichen keine geprüften Trends zu aktiven Nutzern; dieser Vergleich kann die Behauptung daher nicht stützen. Das Nutzerwachstum würde ohnehin nicht klären, welcher Search-API-Modus zu einer produktiven Anfrage passt.
Ist Perplexity AI besser als ChatGPT?
Die reine Search API von Perplexity liefert geordnete Webergebnisse, die von einem anderen System verarbeitet werden. ChatGPT ist dagegen ein Assistent für Endnutzer mit eigenen Tools und Modellen. Verglichen werden sollten der konkrete Workflow und seine Beleganforderungen, nicht abstrakte Markennamen.
Sollen Routing, Validierung und Kosten in einem Arbeitsblatt zusammenlaufen? Die Checkliste zur Prüfung von KI-Geschäftsworkflows herunterladen und am Montag den ersten Suchrisiko-Router entwerfen.
- Zuletzt aktualisiert
- 24. Sept. 2026
- Kategorie
- Build
Diese Seite in Google bevorzugen


Markieren Sie omidsaffari.com als bevorzugte Quelle, und Google hebt die Seite für Sie in Top Stories, AI Overviews und AI Mode hervor.

KI-Agenten-Kosten: Wie Fallbacks das Budget leeren
Ein blockierter Datei-Upload machte den bezahlten Fallback zum Standard. So liefen KI-Agenten-Kosten aus dem Ruder, obwohl Jobs weiter „done“ meldeten.24. Sept. 2026Build
Cursor Rollouts kostenlos? Was Zugang und Nutzung kosten
Ist Cursor Rollouts kostenlos? Nur Teams und Enterprise erhalten Zugang. Was die 10-Tage-Credits abdecken und welche Kosten danach offenbleiben.24. Sept. 2026Build
KI Agenten mit Unreal Agent ausführen: Praxisleitfaden
So lassen sich KI Agenten mit Unreal Agent testen: Runner einrichten, Repository absichern, JSONL-Spuren auswerten und Kosten belastbar vergleichen.24. Sept. 2026Build
JetBrains Air einrichten: Sicher mit Coding-Agenten starten
JetBrains Air installieren, Coding-Agenten sicher verbinden und Änderungen im IDE-Diff prüfen: So gelingt der erste kleine, testbare Workflow.23. Sept. 2026Build
JetBrains Air: Was kostenlos ist – und wer die Nutzung bezahlt
JetBrains Air kostet als Plugin $0. Welche Kosten für IDE, Agenten, API und JetBrains AI trotzdem entstehen und welcher Zugang sich wirklich lohnt.23. Sept. 2026Build
Firecrawl Docker selbst hosten: Setup, Belege und echte Kosten
Firecrawl mit Docker selbst hosten: versioniertes Setup, belastbare Scrape-Prüfung und ein 30-Tage-Kostenvergleich mit Firecrawl Cloud im Detail.22. Sept. 2026Build
KI-Agenten: Warum bezahlte Retries eine Freigabe brauchen
Wenn KI-Agenten fertige Renderings selbst verwerfen, wird Qualitätskontrolle zur Kaufentscheidung. So stoppt menschliche Freigabe bezahlte Retries.22. Sept. 2026Build