Perplexity Search API: Fast Search ou busca web?
Compare Fast Search e a busca web padrão da Perplexity em preço, latência e cobertura para escolher o melhor modo da API em cada consulta do seu agente.




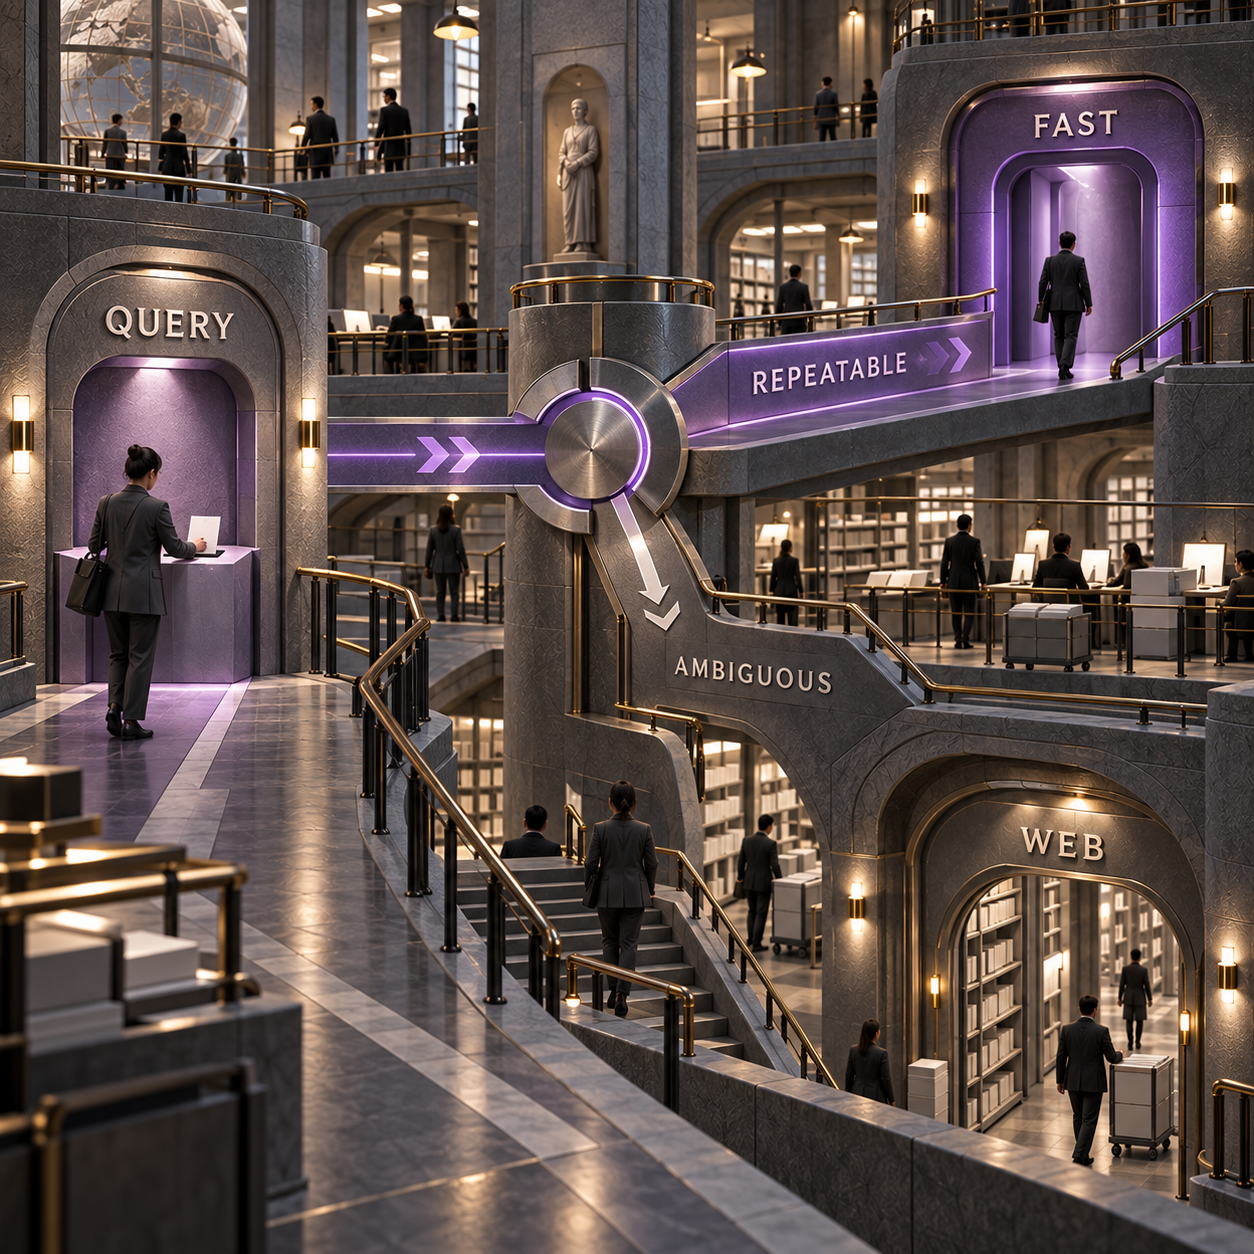
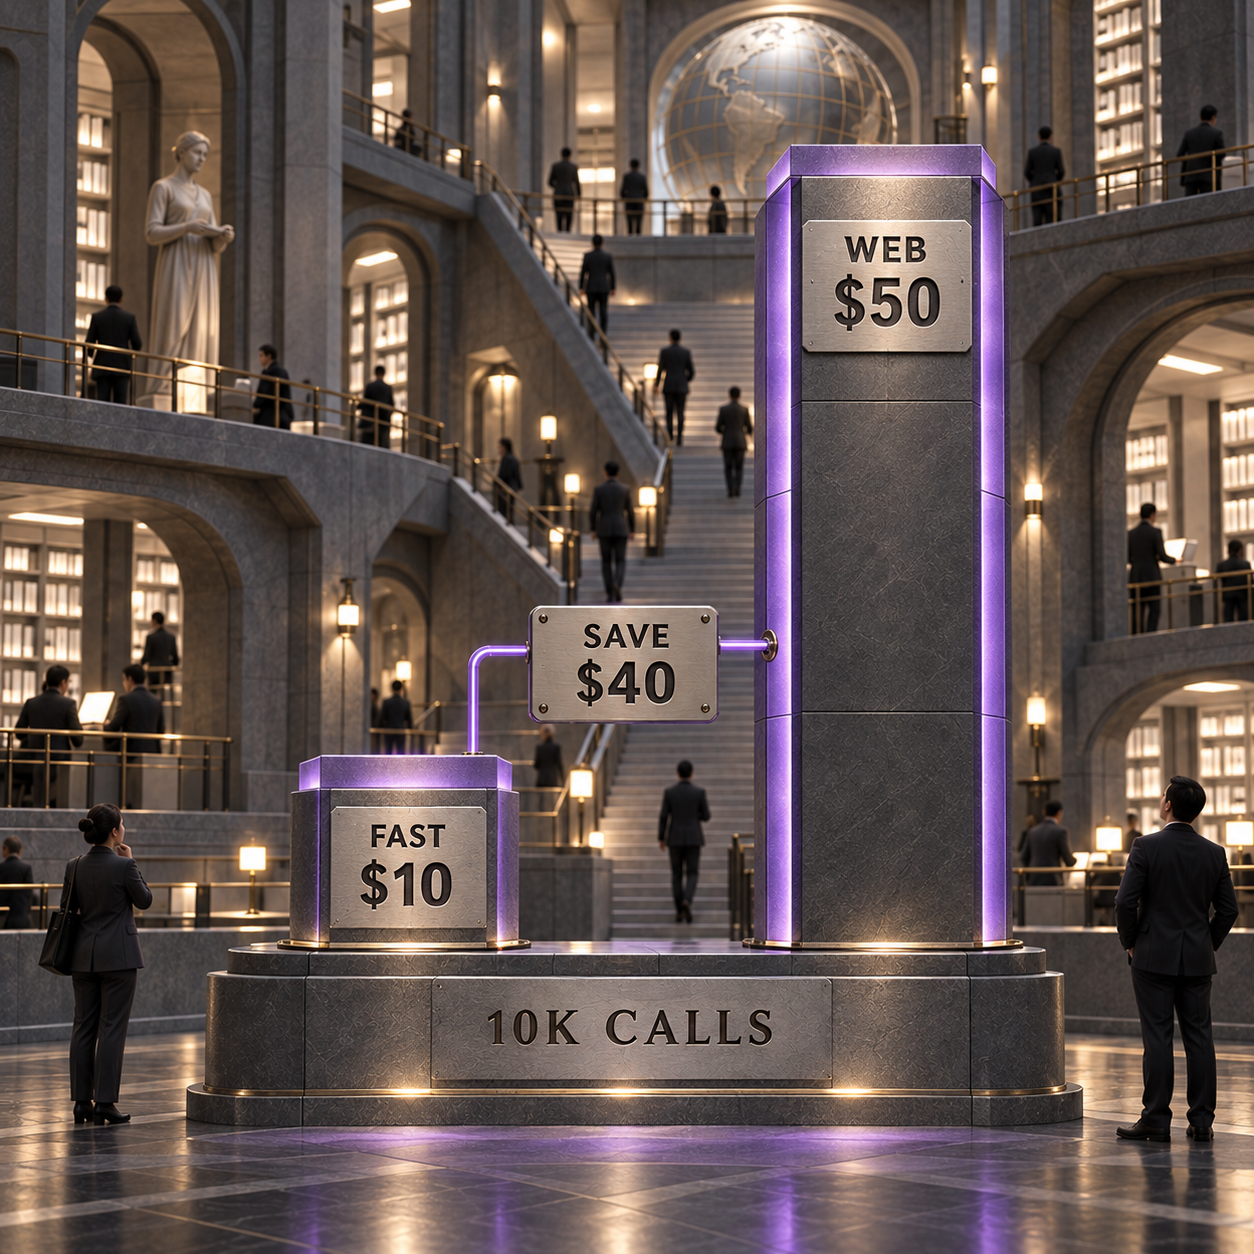
Na Perplexity Search API, escolher entre Fast Search e o modo padrão é uma decisão de roteamento: use fast em consultas repetíveis feitas por agentes por $1 a cada 1,000 chamadas bem-sucedidas e mantenha o modo web padrão para pesquisas ambíguas ou nas quais a cobertura é decisiva, por $5. Em 10,000 chamadas, a busca custa $10 contra $50, antes de considerar o modelo que consumirá os resultados.
Perplexity Search API: quando usar Fast Search ou web padrão?
Escolha Fast Search para tarefas delimitadas e repetíveis; use a busca web padrão quando uma única fonte ausente puder mudar a decisão. Fast vence em preço e latência. O modo web padrão leva vantagem em qualidade de recuperação e disponibilidade de respostas. Em produção, o agente deve rotear as consultas entre os dois, não obrigar toda busca a passar pelo mesmo modo.
O guia atualizado da Perplexity sobre Fast Search recomenda fast para o trabalho cotidiano de agentes e a configuração web padrão para perguntas raras, difíceis ou ambíguas. Os preços e as medições da empresa nesta comparação foram conferidos nas páginas oficiais da Perplexity em 24 de setembro de 2026.
Para quem desenvolve sozinho um agente de suporte, vale começar com fast nas consultas rotineiras de documentação e status e escalar para web quando as evidências vierem vazias ou fracas. O adicional de $0.004 por uma chamada à web padrão é pequeno se uma falha levar à revisão humana, mas vira desperdício em uma consulta de baixo risco repetida milhares de vezes.
Para quem fundou uma startup já financiada e está criando uma solução de pesquisa de mercado, o modo web padrão deve assumir perguntas ambíguas sobre empresas, políticas e concorrência. Fast ainda pode cuidar de verificações em fontes conhecidas, disponibilidade de produtos e monitoramento recorrente. A carga de trabalho tem duas classes de recuperação, mesmo que o produto mostre apenas uma caixa de busca.
Para um CTO de empresa de médio porte, mantenha a web padrão em pesquisas de compras, segurança, regulamentação e incidentes até que um replay interno demonstre que Fast Search preserva o conjunto de fontes exigido. Uma solicitação cinco vezes mais barata deixa de ser economia quando um analista precisa reconstruir as evidências.
Perplexity Fast Search API: o que muda com o Photon
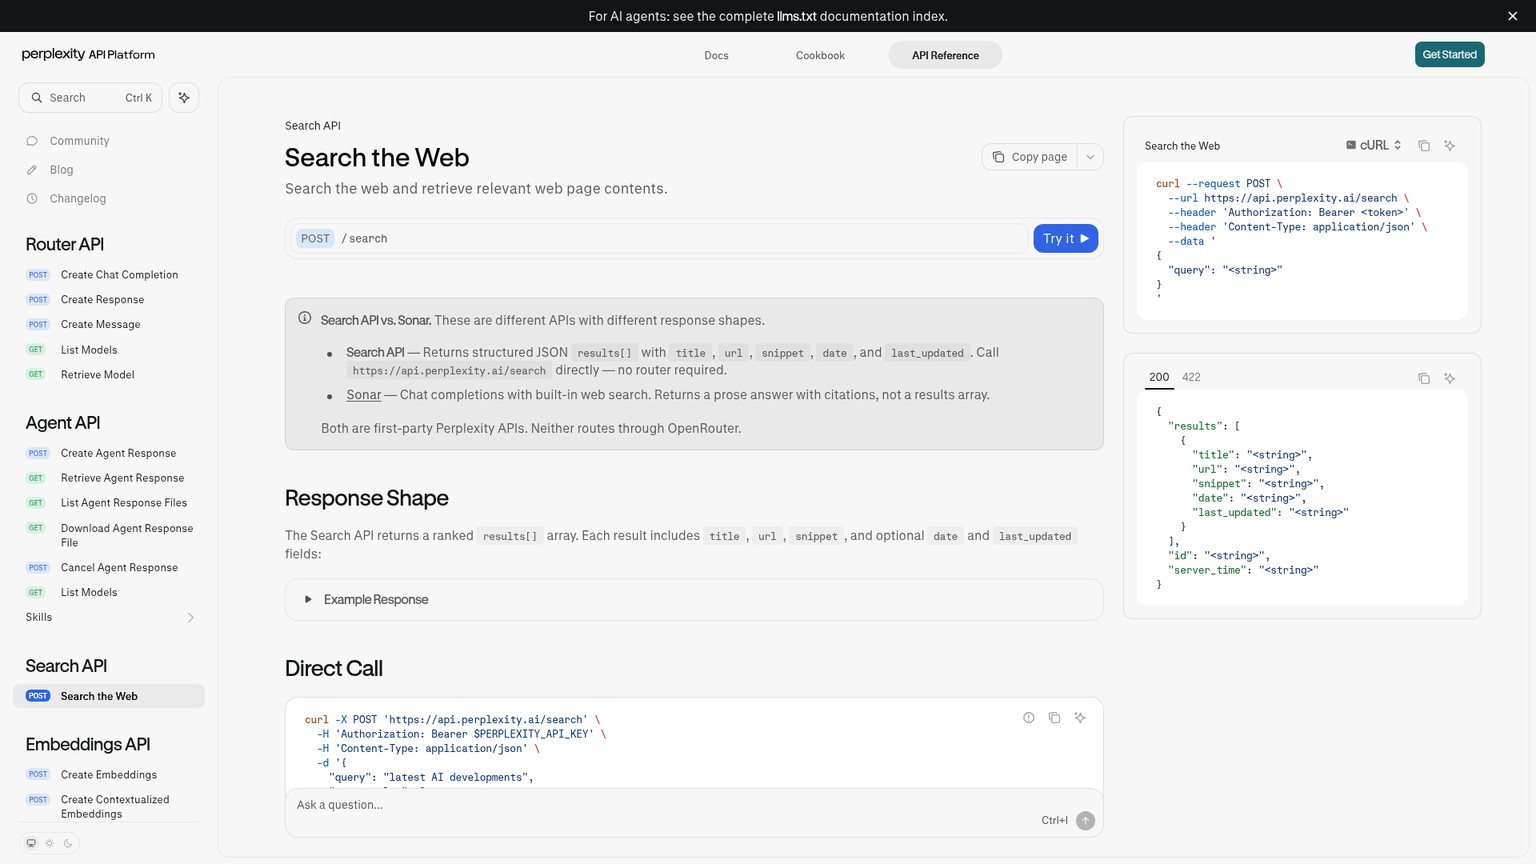
Fast Search muda o orçamento de recuperação, não o endpoint nem o formato dos resultados. A Perplexity lançou o modo em 24 de setembro de 2026, apoiado pelo Photon, seu mecanismo próprio de recuperação e ranqueamento. A documentação atual do Fast Search confirma a disponibilidade: o mesmo endpoint POST /search devolve o mesmo array ordenado results[]; basta acrescentar search_type: "fast" à solicitação.
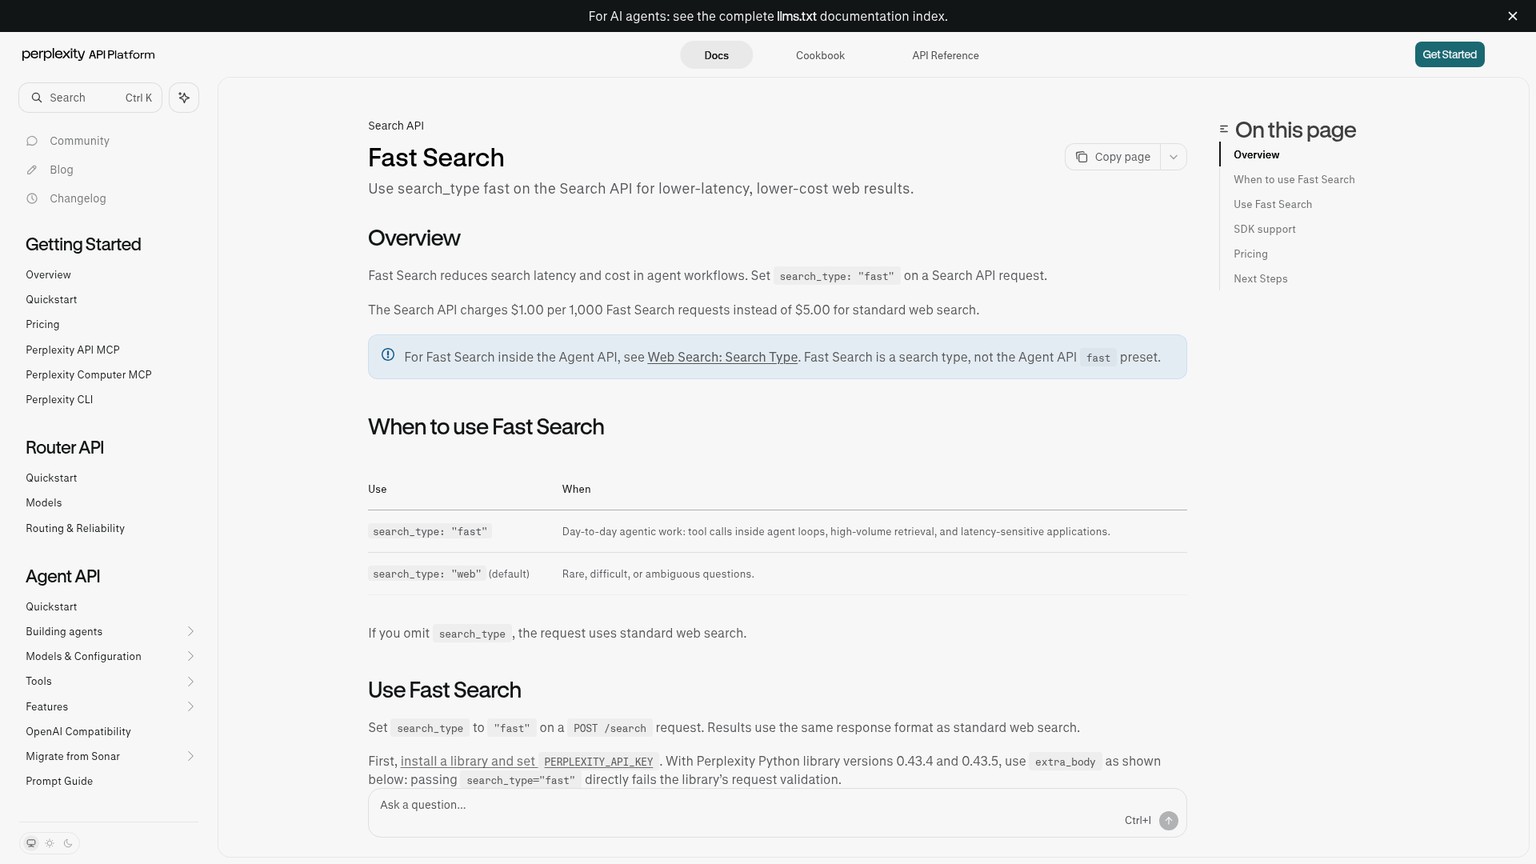
Quando search_type é omitido, a Perplexity usa o modo web padrão. Esse detalhe importa: “padrão”, aqui, não é o modelo de linguagem padrão do aplicativo da Perplexity para consumidores. É o modo convencional de recuperação da Search API. Ambos os modos retornam títulos, URLs, trechos e, opcionalmente, datas de publicação e atualização para o processamento posterior.
Segundo o lançamento do Photon, o mecanismo lê apenas os dados necessários para cada consulta, sobrepõe os períodos de espera do disco e usa cache otimizado para lotes; a figura oficial da arquitetura da Perplexity mostra o percurso da solicitação pelo broker e pelos shards. Essas decisões de engenharia ajudam a explicar a velocidade anunciada. Elas não eliminam o trade-off deliberado no ranqueamento: Fast Search consome menos capacidade computacional e abre mão de parte da qualidade de recuperação mais ampla.
Perplexity Photon é o mecanismo, não um terceiro modo
Photon é a infraestrutura por trás da pilha de busca da Perplexity. As opções da API continuam sendo fast, web e o tipo separado de busca people. Quem desenvolve não seleciona o Photon diretamente, não precisa implantá-lo e não recebe outro objeto de resposta.
A ressalva sobre os SDKs atuais é prática. A Perplexity documenta extra_body={"search_type": "fast"} para as versões 0.43.4 e 0.43.5 da biblioteca Python, pois a validação direta rejeita o novo valor. O exemplo em TypeScript faz o cast de "fast" as any com o SDK 0.38.5 enquanto os tipos não são atualizados. Solicitações HTTP diretas evitam as duas limitações temporárias no cliente.
Preço da Perplexity Search API: $10 contra $50 em 10,000 solicitações
Vencedor: Fast Search. A tabela de preços atual da Perplexity cobra $1 por 1,000 solicitações brutas bem-sucedidas do Fast Search e $5 por 1,000 solicitações bem-sucedidas da web padrão, sem tarifa adicional por tokens na Search API.
A carga normalizada deixa a conta clara:
- 10,000 chamadas ao Fast Search: 10,000 × $0.001 = $10.
- 10,000 chamadas à web padrão: 10,000 × $0.005 = $50.
- Diferença: $40, ou redução de 80% no custo bruto de recuperação.
Esses $40 não representam toda a conta do agente. O modelo que lê os resultados, as buscas complementares, as novas tentativas, a validação e a revisão humana vêm depois. Fast só ganha se não gerar mais de $40 em trabalho adicional ao longo desse lote de 10,000 chamadas.
Respostas vazias bem-sucedidas também são cobradas
Uma resposta bem-sucedida de POST /search é cobrada mesmo quando results[] vem vazio. Pelas regras de preço atuais, solicitações inválidas, limitadas por taxa e falhas upstream não são cobradas. Assim, a frequência de resultados vazios é uma métrica de orçamento, não apenas de qualidade.
O uso de lotes muda a conta, não a decisão sobre qualidade
O guia rápido de consultas múltiplas da Perplexity aceita até cinco consultas relacionadas em uma única solicitação. Uma solicitação com várias consultas que seja concluída com sucesso conta como uma unidade de cobrança, embora cada consulta ainda entre no limite de requisições. Vinte consultas agrupadas em quatro solicitações por modo custariam, portanto, $0.024 no total, contra $0.12 por 40 solicitações individuais com uma consulta cada.
Não use lotes para comparar a latência de uma única chamada. Um payload com cinco consultas muda o trabalho executado pela solicitação e esconde o tempo de cada consulta. Primeiro, compare 20 chamadas individuais em cada modo. Avalie os lotes separadamente, depois que a escolha do modo estiver bem fundamentada.
Mantenha as tarifas das ferramentas da Agent API em outra linha do orçamento
A tabela de ferramentas da Agent API usa outra precificação padrão: $1 por 1,000 execuções fast de web_search e $2.50 por 1,000 execuções da web padrão, além dos tokens cobrados pelo modelo escolhido. Não são as tarifas de $1 e $5 da Search API bruta. Fast Search também não é o preset separado fast da Agent API, apesar da repetição do nome.
A comparação anterior de custos entre Perplexity, Exa e Tavily ajuda a escolher o fornecedor. Esta decisão ocorre um nível abaixo, quando a Perplexity já faz parte da pilha.
Latência: Fast vence, mas há uma ressalva na medição
Vencedor: Fast Search, segundo a medição da Perplexity. O gráfico oficial de latência informa 160 ms no p50 e 230 ms no p95 para uma chamada individual ao Fast Search. A Perplexity não publica p50 e p95 equivalentes para a web padrão no texto de lançamento nem no guia atual do Fast Search. Portanto, não há uma proporção honesta de latência entre os modos a citar.
Os percentis importam. p50 é a solicitação central da distribuição. p95 é o limite abaixo do qual 95% das solicitações terminam. Um agente que faz várias buscas em sequência sente mais a cauda lenta do que a mediana, pois uma única chamada atrasada pode travar todo o plano.
Fast, portanto, merece o fluxo sensível à latência, mas a decisão em produção continua dependendo da carga. Distância de rede, filtros, número solicitado de resultados, contexto extraído, uso de lotes e política de novas tentativas afetam o tempo total percebido pelo agente. A medição da empresa é uma referência inicial, não uma promessa de nível de serviço para qualquer integração.
A avaliação prática de Mikhail Basyuk aponta para o critério certo: p95 abaixo de 250 ms só é útil se a busca preservar a relevância exigida pela tarefa. Velocidade e evidência precisam aparecer no mesmo painel.
Cobertura: a web padrão vence
Vencedor: web padrão em pesquisas difíceis e ambíguas. O gráfico interno de recuperação da Perplexity atribui ao Fast Search uma relevância de 2.21, contra 2.45 para a web padrão, diferença de 0.24 ponto. A disponibilidade de respostas é 0.567 contra 0.596, diferença de 2.9 pontos percentuais.
Relevância indica se o material ranqueado corresponde bem à consulta. Disponibilidade de respostas indica se a recuperação encontrou material suficiente para sustentar uma resposta. Fast pode responder depressa e ainda entregar um conjunto de evidências mais raso ao modelo seguinte. Por isso, uma pergunta ampla sobre políticas, uma comparação entre várias empresas ou uma alegação contestada deve seguir para a web padrão, mesmo quando o caminho fast parece ágil.
A Perplexity também apresenta um resultado aparentemente contrário em seu gráfico agregado de fornecedores, que reúne seis benchmarks públicos de agentes e 3,554 tarefas selecionadas: Fast alcançou 64.3% com custo total estimado de $59.73 entre modelo e busca, enquanto a web padrão registrou 64.0% por $187.60. A empresa descreve a configuração fast como aproximadamente 68% mais barata, com qualidade agregada comparável nas tarefas.
Os dois resultados podem ser verdadeiros ao mesmo tempo. Agentes avaliados de forma agregada conseguem compensar uma recuperação pior com conhecimento do modelo, raciocínio, chamadas repetidas ou simplesmente porque as tarefas selecionadas não penalizam toda fonte ausente. Um sistema de recuperação bruto usado em compliance ou pesquisa empresarial não pode presumir que o modelo posterior consertará a falta de um documento.
O guia mais amplo sobre APIs de busca com IA segue o mesmo princípio operacional entre fornecedores: compre o nível de recuperação mais barato que produza um conjunto de evidências aceito pela próxima verificação determinística.
Como configurar o search type fast na Perplexity Search API
Faça a mesma solicitação duas vezes e altere apenas search_type. Mantenha constantes query, max_results, search_context_size, filtros, região e localização do cliente. A referência atual da Search API documenta web como padrão, max_results com valor padrão de 10 e high como tamanho padrão do contexto extraído. Defina explicitamente os dois controles da comparação para que uma mudança futura nos padrões da API não altere o replay.
O par de solicitações abaixo pode ser executado como está:
set -euo pipefail
: "${PERPLEXITY_API_KEY:?Set PERPLEXITY_API_KEY first}"

QUERY='Which CRM has the stronger current EU data residency and audit-control evidence?'
COMMON=$(jq -nc --arg query "$QUERY" '{
  query: $query,
  max_results: 10,
  search_context_size: "high"
}')

for MODE in fast web; do
  jq --arg mode "$MODE" '. + {search_type: $mode}' <<<"$COMMON" |
    curl -sS 'https://api.perplexity.ai/search' \
      -H "Authorization: Bearer $PERPLEXITY_API_KEY" \
      -H 'Content-Type: application/json' \
      -o "$MODE.json" \
      -w "$MODE\tHTTP %{http_code}\t%{time_total}s\n" \
      --data-binary @-
done
Nenhuma credencial da API da Perplexity estava disponível nesta execução de publicação. Por isso, não há aqui alegações próprias sobre latência medida, cobertura, frequência de resultados vazios ou sustentação das respostas. O protocolo abaixo é um pequeno teste pareado, não uma replicação do estudo da Perplexity com seis benchmarks.
Use 20 consultas de pesquisa empresarial: 10 buscas específicas com uma fonte oficial esperada e 10 perguntas ambíguas que exijam várias fontes. Um conjunto fixo e útil pode incluir preços atuais de SaaS, limites de nuvem, datas regulatórias, países atendidos, controles de segurança, documentos financeiros recentes, comparações de fornecedores, efeitos de políticas, perguntas sobre custo total e alegações com evidências confiáveis dos dois lados.
Com uma consulta por solicitação, essas 40 solicitações brutas bem-sucedidas custam $0.12 antes de qualquer chamada posterior ao modelo: $0.02 por 20 chamadas fast, mais $0.10 por 20 chamadas à web padrão.
Congele a solicitação
Use
max_results: 10esearch_context_size: "high"nos dois modos. Mantenha idênticos os filtros, o país, o idioma e a região do cliente. Alterne aleatoriamente qual modo roda primeiro em cada consulta, para que caches aquecidos e condições transitórias de rede não favoreçam sempre o mesmo lado.Registre o comportamento da recuperação
Capture
time_totalde ponta a ponta, status HTTP, número de resultados, indicador de resposta vazia, domínios únicos, quantidade de fontes oficiais e a presença da fonte primária esperada. Preserve todo o JSON bruto para revisão.Aplique uma única régua de utilidade
Atribua zero à cobertura de fontes úteis quando não houver nenhuma fonte relevante para a decisão; um quando o conjunto for utilizável, mas incompleto; e dois quando houver evidências independentes suficientes para avançar. Não dê pontos a domínios duplicados nem a trechos longos que apenas repetem uma fonte.
Mantenha constante a camada de resposta
Se um modelo transformar os resultados em resposta, use o mesmo modelo, prompt, orçamento de tokens e verificador de citações. Dê zero à sustentação da resposta quando uma alegação relevante não tiver evidência, um quando o apoio for parcial e dois quando cada alegação relevante corresponder a uma evidência retornada.
Decida por classe de tarefa
Compare medianas e latência p95, respostas vazias, cobertura de fontes e sustentação das respostas separadamente para os grupos específico e ambíguo. Adote fast apenas em uma classe cuja pontuação de evidências permaneça dentro da faixa de aceitação da equipe.
O principal critério não é a média de resultados. Um monte de links fracos pode valer menos que um pequeno conjunto de fontes primárias. Cobertura útil e respostas sustentadas são as métricas que dão sentido ao preço e à latência.
Quanto custa mudar de modo na prática
Alterar o corpo da solicitação é simples; o trabalho está em mudar a política operacional. Levar uma carga da web padrão para fast não exige migração de dados nem outro endpoint. Ainda assim, a mudança afeta o comportamento da recuperação, a identidade do cache, o monitoramento e o tratamento de falhas.
Inclua search_type na chave do cache. Uma resposta fast armazenada não pode atender silenciosamente a uma solicitação posterior de web padrão, cujo chamador pagou por uma recuperação mais ampla. Inclua também tamanho do contexto, quantidade de resultados, filtros, país e idioma.
Registre o modo em toda solicitação e em cada alegação posterior. Sem essa informação, uma queda na taxa de aceitação das fontes parece deriva do modelo ou ruído aleatório da busca. O roteador também precisa indicar um motivo visível de escalada, como empty_results, missing_primary_source, ambiguous_query ou high_impact.
Trate as novas tentativas conforme o modo. Repetir uma solicitação no mesmo modo após um timeout é uma ação de disponibilidade. Repetir de fast para web é uma escalada de qualidade e muda o preço. Esses eventos não devem compartilhar o mesmo contador.
Quem não deve migrar
Não transforme Fast Search no padrão universal quando:
- O agente lida com contratos, regulamentação, segurança, finanças, informações médicas ou resposta a incidentes, áreas em que perder uma fonte traz consequências graves.
- A carga atual é dominada por perguntas ambíguas que precisam de diversidade de fontes, e não de uma consulta factual com alvo conhecido.
- Não existe uma régua para aceitar evidências, de modo que “mais rápido” passaria a ser a única métrica visível de sucesso.
- Um adaptador do fornecedor ou SDK rejeita o novo enum e a equipe não consegue usar com segurança a solução documentada nem HTTP direto.
- Respostas vazias bem-sucedidas não são registradas separadamente de falhas de transporte.
- O adicional da web padrão é irrelevante diante da revisão humana já exigida para toda resposta.
A melhor migração é gradual e roteada. Leve uma classe repetível para fast, preserve web como caminho de escalada e compare as evidências aceitas antes de ampliar o uso.
A ação para segunda-feira
Implemente uma política simples de busca antes de trocar o padrão global. Envie consultas repetíveis e de baixo impacto para fast; direcione perguntas ambíguas ou de alto impacto a web. Em seguida, transforme a rejeição de evidências em escalada automática, em vez de permitir uma resposta fraca e invisível.
Comece pelas solicitações da semana passada, não por demonstrações inventadas. Selecione 20 que representem o trabalho cotidiano do produto, separe-as entre os grupos específico e ambíguo e execute o par exato acima. Se todas as 40 solicitações individuais forem bem-sucedidas, o teste custa $0.12 em tarifas brutas de busca.
Na terça-feira, revise quatro resultados: latência p95 da solicitação, respostas vazias bem-sucedidas, cobertura de fontes úteis e pontuação de sustentação das respostas. Se fast mantiver o nível de evidência no grupo específico, migre apenas essa classe. Se perder uma fonte primária no grupo ambíguo, mantenha a web padrão ali, independentemente do benchmark agregado.
Essa é a consequência empresarial do Photon: não uma configuração global mais barata, mas um roteador prático de risco da busca. O agente gasta $1 por 1,000 chamadas quando a consulta tolera falhas e paga os $4 adicionais somente quando uma recuperação mais ampla pode evitar um erro mais caro.
Perguntas frequentes
Por que a Perplexity é controversa?
Os debates sobre o produto para consumidores, a atribuição de fontes e a relação com publishers não fazem parte desta escolha entre modos da API. Quem compra a API deve validar cobertura de fontes, termos de uso e tratamento de evidências conforme os requisitos da própria organização.
Como trocar o mecanismo de busca padrão pela Perplexity?
Essa é uma configuração do navegador ou do dispositivo. Nesta comparação, “padrão” significa o comportamento da Search API: omitir search_type aciona o modo web convencional, enquanto Fast Search exige search_type: "fast".
Por que a Perplexity está falhando?
A premissa é ampla demais para ser demonstrada pelas evidências citadas sobre a API. Em uma integração, defina a falha com precisão: resultado vazio, ausência da fonte primária esperada, cobertura útil fraca, resposta sem sustentação, timeout ou erro upstream.
O que é melhor para pesquisar: Perplexity ou o modo de IA do Google?
Essa pergunta compara produtos de resposta para consumidores, não os modos da Search API bruta da Perplexity. A escolha entre fast e web padrão deve considerar latência de recuperação, cobertura útil de fontes e evidências que sustentem a resposta posterior.
Por que Joe Rogan usa a Perplexity?
Um endosso público ou anúncio não estabelece um motivo técnico nem oferece evidências para escolher fast ou web. Tome a decisão sobre a API com dados da carga de trabalho, não com o uso por celebridades.
A Perplexity ainda é boa?
Fast Search cumpre uma função clara por $1 a cada 1,000 solicitações brutas bem-sucedidas, e a Perplexity informa latência p50 de 160 ms. Os próprios resultados de recuperação da empresa também mostram que a web padrão continua sendo a escolha superior quando relevância mais ampla e disponibilidade de respostas importam.
Qual é a desvantagem da Perplexity?
No Fast Search, a desvantagem documentada é a menor relevância de recuperação e disponibilidade de respostas. Na web padrão, são o preço cinco vezes maior por solicitação bruta e a latência superior à do modo criado especificamente para velocidade.
A Perplexity está perdendo usuários?
As páginas de lançamento e da API citadas não publicam dados auditados sobre a tendência de usuários ativos; esta comparação, portanto, não sustenta essa alegação. O crescimento de usuários tampouco decidiria qual modo da Search API atende uma consulta em produção.
A Perplexity AI é melhor que o ChatGPT?
A Search API bruta da Perplexity retorna resultados da web ranqueados para outro sistema processar, enquanto o ChatGPT é um assistente voltado ao usuário final, com ferramentas e modelos próprios. Compare o fluxo concreto e seus requisitos de evidência, não as marcas de forma abstrata.
Quer reunir em uma única planilha as perguntas sobre roteamento, validação e custo? Baixe o Checklist de Auditoria de Workflows de IA e desenhe o primeiro roteador de risco de busca na segunda-feira.
- Última atualização
- 24 de set. de 2026
- Categoria
- Build
Prefira este site no Google


Marque omidsaffari.com como fonte preferida e o Google destaca o site para você em Top Stories, AI Overviews e AI Mode.

Agentes de IA: quando o fallback pago vira o caminho padrão
Um fallback pago drenou o saldo compartilhado e deixou artigos sem capa nem embeddings. Entenda como corrigir o handoff sem expor credenciais.24 de set. de 2026Build
Cursor preço: o Rollouts é grátis? Planos, créditos e custos
Cursor Rollouts exige Teams ou Enterprise. Entenda os créditos de lançamento por 10 dias, cerca de 50 ou 500 alterações, e os custos a conferir.24 de set. de 2026Build
Unreal Agent na prática: como avaliar um agente de IA
Veja como testar o Unreal Agent, um agente de IA para repositórios: isole o ambiente, salve a sessão em JSONL e meça custo, segurança e desempenho.24 de set. de 2026Build
Codex JetBrains com Air: do primeiro prompt à revisão
Aprenda a instalar o Air Alpha, conectar o Codex ao JetBrains, fornecer o contexto certo e revisar a primeira alteração de código com segurança.23 de set. de 2026Build
JetBrains Air é grátis? Entenda quem paga cada camada
JetBrains Air é grátis no plugin, mas agente, IDE e uso de API podem gerar custos. Veja as quatro formas de autorização e descubra qual conta paga.23 de set. de 2026Build
Firecrawl API com hospedagem própria: instalação e custos
Entenda como instalar a Firecrawl API em infraestrutura própria, validar scrapes reais e comparar o custo operacional com o Firecrawl Cloud em 30 dias.22 de set. de 2026Build
Agentes de IA: quando um retry pago exige aprovação humana
Entenda por que retries pagos de agentes de IA precisam de aprovação humana no ponto da recompra, mesmo em fluxos que já mantêm pessoas no circuito.22 de set. de 2026Build