Perplexity API: Fast Search o ricerca web predefinita?
Perplexity API a confronto: costi, latenza e copertura di Fast Search e ricerca web, con una regola pratica per scegliere la modalità giusta.




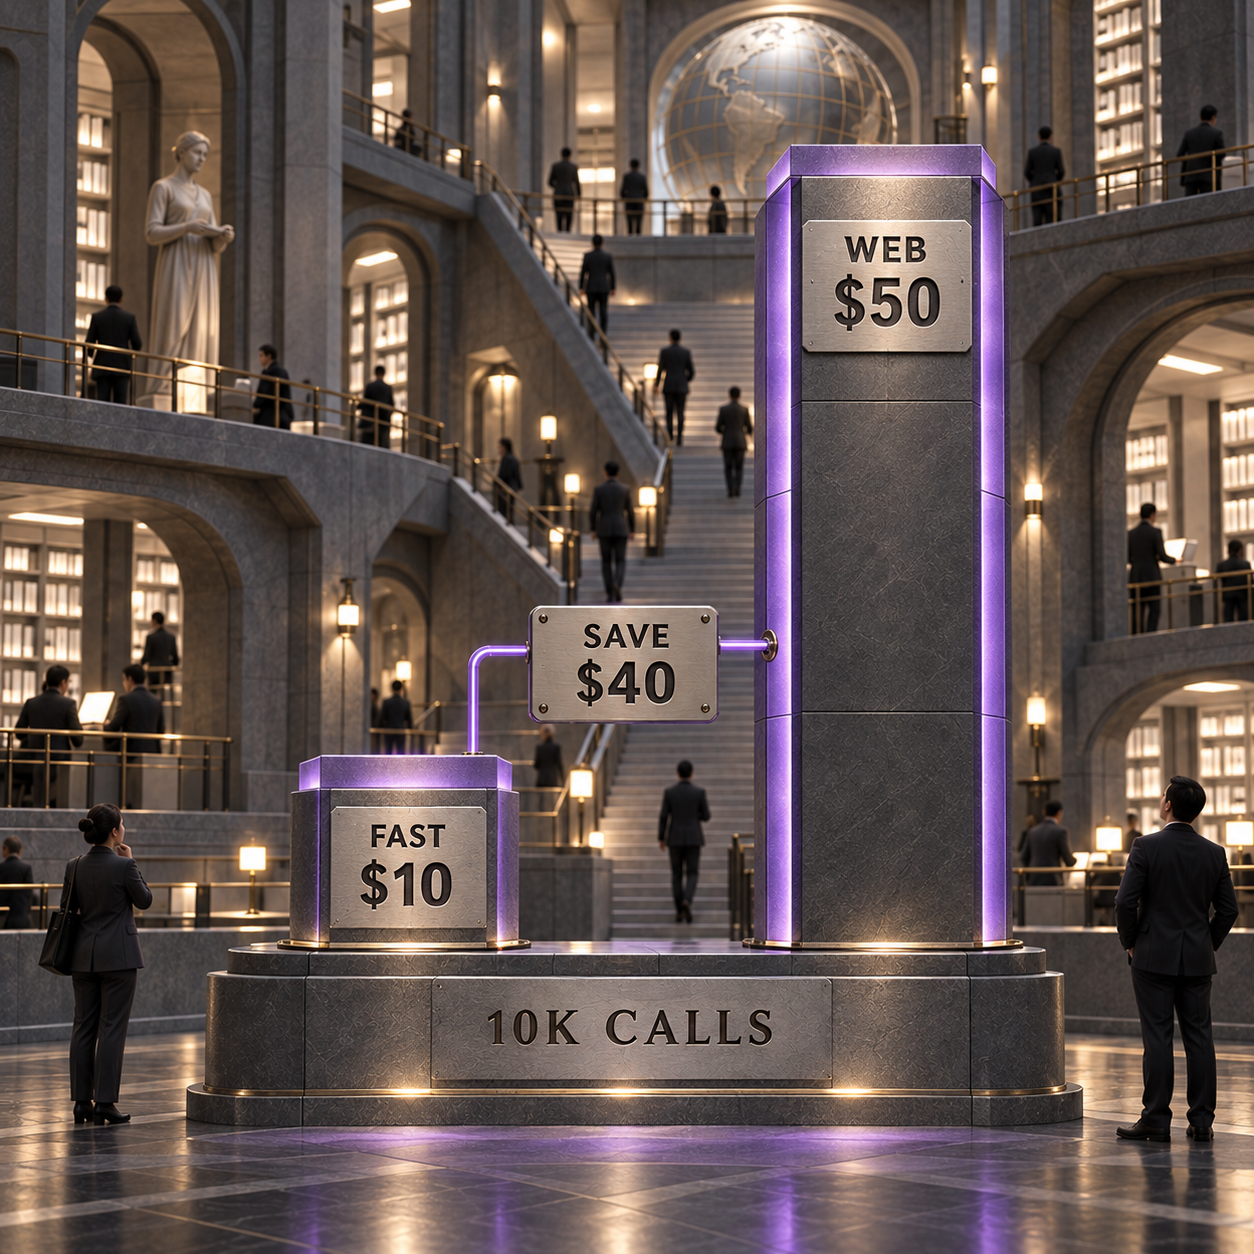
Scegliere tra Fast Search e la modalità predefinita della Perplexity API è una decisione di routing: fast è adatto alle ricerche ripetibili degli agenti, a $1 ogni 1,000 chiamate riuscite; web resta la scelta per le ricerche ambigue o sensibili alla copertura, a $5. Su 10,000 chiamate, la sola ricerca costa $10 contro $50, prima ancora di conteggiare il modello che utilizza i risultati.
Perplexity API: meglio Fast Search o web predefinito?
Fast Search è la scelta giusta per attività circoscritte e ripetibili; il web predefinito serve quando una fonte mancante può cambiare la decisione. Fast vince su prezzo e latenza. Il web predefinito offre invece risultati migliori per qualità del recupero e disponibilità delle risposte. In produzione conviene instradare le query tra le due modalità, non imporne una a tutte.
Perplexity, nella sua guida aggiornata a Fast Search, consiglia fast per il lavoro quotidiano degli agenti e l'impostazione predefinita web per le domande rare, difficili o ambigue. Prezzi e misurazioni del fornitore riportati in questo confronto sono stati verificati sulle pagine live di Perplexity il 24 settembre 2026.
Per chi sviluppa da solo un agente di assistenza, il punto di partenza è fast per consultare documentazione e stati ricorrenti, passando poi a web quando le prove sono assenti o deboli. Il sovrapprezzo di $0.004 per una chiamata al web predefinito è minimo se una lacuna comporta una verifica umana; diventa invece uno spreco per una ricerca a basso rischio ripetuta migliaia di volte.
Per una startup finanziata che costruisce uno strumento di market research, il web predefinito dovrebbe gestire le domande ambigue su aziende, normative e concorrenza. Fast resta utile per controlli su fonti note, disponibilità dei prodotti e monitoraggi ripetuti. Il carico di lavoro comprende due classi di recupero, anche se il prodotto mostra un'unica casella di ricerca.
Per il CTO di un'azienda mid-market, è prudente mantenere il web predefinito nelle ricerche su acquisti, sicurezza, regolamentazione e incidenti, almeno finché un replay interno non dimostra che Fast Search conserva l'insieme di fonti necessario. Una richiesta cinque volte meno cara non genera risparmio se poi un analista deve ricostruire le prove.
Perplexity Fast Search API: che cosa cambia con Photon
Fast Search modifica il budget di recupero, non l'endpoint né lo schema dei risultati. Perplexity ha introdotto la modalità il 24 settembre 2026; alla base c'è Photon, il suo motore interno di recupero e ranking. La documentazione aggiornata di Fast Search ne conferma la disponibilità: lo stesso endpoint POST /search restituisce il medesimo array ordinato results[] e alla richiesta basta aggiungere search_type: "fast".
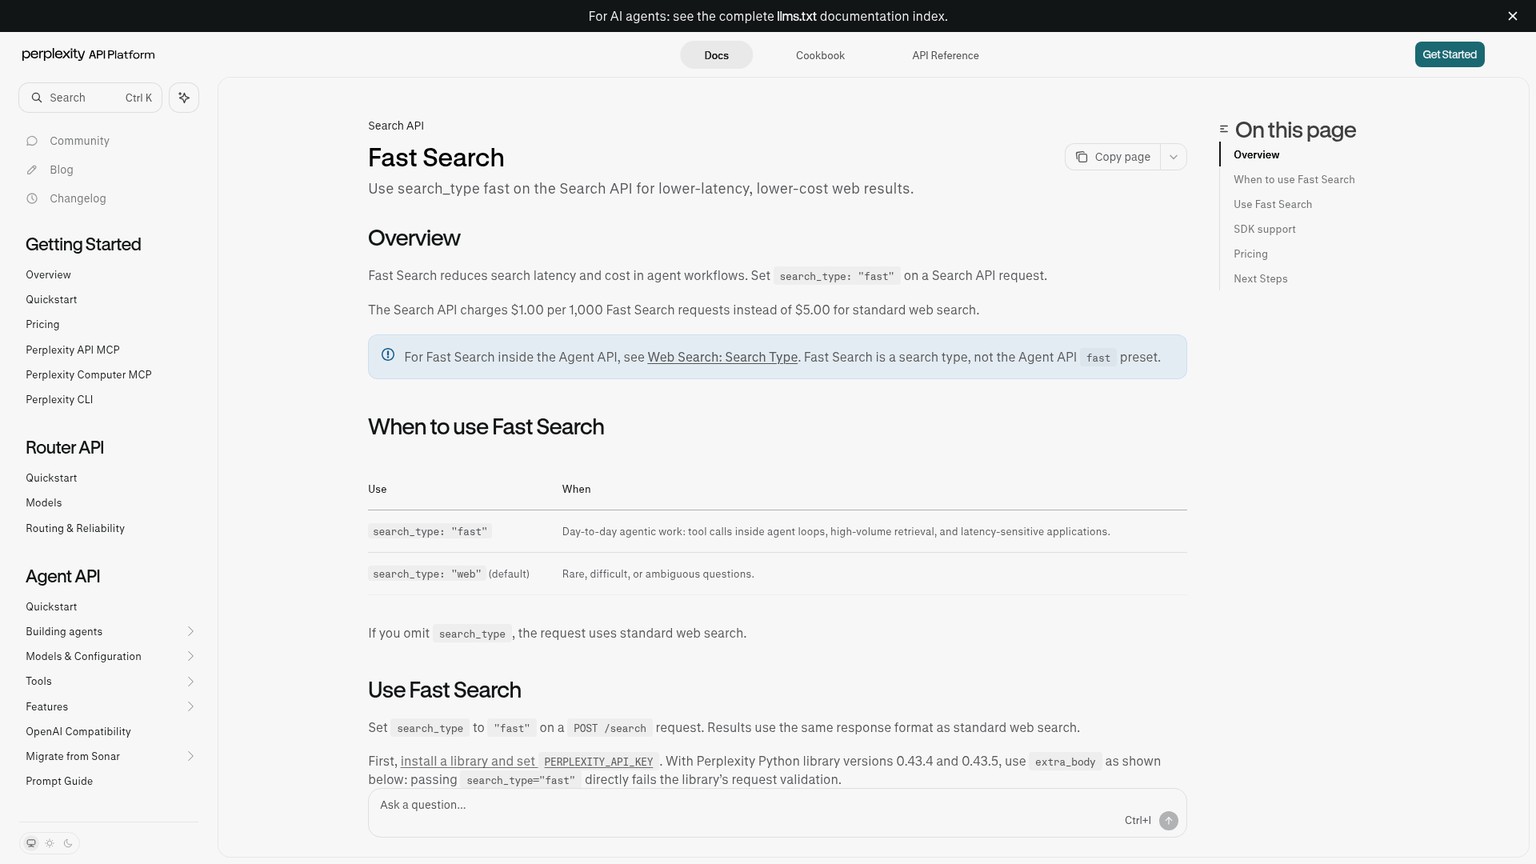
Se search_type non viene specificato, Perplexity usa lo standard web. È un dettaglio importante: in questo articolo “predefinito” non indica il modello linguistico selezionato di default nell'app Perplexity destinata agli utenti. Si riferisce alla modalità di recupero standard della Search API. Entrambe le opzioni restituiscono titoli, URL, snippet ed eventuali date di pubblicazione e aggiornamento per le elaborazioni successive.
Secondo la presentazione di Photon, il motore legge soltanto i dati necessari alla query, sovrappone le attese del disco e utilizza una cache ottimizzata per i batch; la figura ufficiale dell'architettura di Perplexity mostra il percorso della richiesta attraverso broker e shard. Queste scelte ingegneristiche spiegano la velocità dichiarata. Non eliminano però il compromesso deliberato nel ranking: Fast Search usa meno capacità di calcolo e rinuncia a parte della qualità di recupero più ampia.
Perplexity Photon è il motore, non una terza modalità
Photon è l'infrastruttura sottostante allo stack di ricerca di Perplexity. Nell'API le opzioni restano fast, web e il tipo di ricerca separato people. Non è possibile selezionare o distribuire Photon direttamente, né si riceve un oggetto di risposta differente.
Va inoltre considerato un limite pratico degli SDK attuali. Perplexity documenta extra_body={"search_type": "fast"} per le versioni 0.43.4 e 0.43.5 della libreria Python, perché la validazione diretta rifiuta il nuovo valore. Nell'esempio TypeScript usa il cast "fast" as any con l'SDK 0.38.5, in attesa dell'aggiornamento dei tipi. Le richieste HTTP dirette evitano entrambe queste limitazioni temporanee lato client.
Costo della Perplexity API: $10 contro $50 per 10,000 richieste
Vincitore: Fast Search. La tabella prezzi aggiornata di Perplexity applica $1 ogni 1,000 richieste riuscite alla Search API grezza con Fast Search e $5 ogni 1,000 richieste riuscite con il web predefinito, senza costi aggiuntivi per i token della Search API.
Il carico normalizzato rende il confronto immediato:
- 10,000 chiamate Fast Search: 10,000 × $0.001 = $10.
- 10,000 chiamate al web predefinito: 10,000 × $0.005 = $50.
- Differenza: $40, pari a una riduzione dell'80% sulla sola voce di recupero.
Quei $40 non rappresentano l'intero costo dell'agente. A valle ci sono il modello che legge i risultati, i recuperi successivi, i nuovi tentativi, la validazione e la revisione umana. Fast è davvero più conveniente solo se non genera oltre $40 di lavoro aggiuntivo nell'intero lotto da 10,000 chiamate.
Anche le risposte vuote riuscite hanno un costo
Una risposta riuscita a POST /search viene fatturata anche se results[] è vuoto. In base alle regole di prezzo attuali, le richieste non valide, quelle soggette a rate limiting e gli errori upstream non vengono addebitati. Il tasso di risultati vuoti è quindi una metrica di budget, non soltanto di qualità.
Il batching cambia il costo, non la decisione sulla qualità
Il quickstart multi-query di Perplexity accetta fino a cinque query correlate in una singola richiesta. Una richiesta multi-query riuscita vale come un'unica unità di fatturazione, anche se ciascuna query continua a incidere sui limiti di frequenza. Venti query distribuite in quattro richieste per modalità costerebbero quindi $0.024 in totale, contro $0.12 per 40 richieste separate con una sola query.
Il batching non va usato per confrontare la latenza di una singola chiamata. Un payload con cinque query modifica il lavoro svolto dalla richiesta e nasconde i tempi delle singole query. Prima è meglio confrontare 20 chiamate single-query per modalità. Il batching può essere testato a parte, una volta presa una decisione affidabile sulla modalità.
Le tariffe degli strumenti Agent API meritano una voce di budget separata
La tabella degli strumenti Agent API prevede prezzi standard diversi: $1 ogni 1,000 invocazioni web_search fast e $2.50 ogni 1,000 invocazioni con il web standard, oltre ai token del modello scelto. Non sono le tariffe da $1 e $5 della Search API grezza. Inoltre, nonostante il termine in comune, Fast Search non coincide con il preset fast separato della Agent API.
Il precedente confronto dei costi tra Perplexity, Exa e Tavily aiuta a scegliere il fornitore. La decisione qui analizzata arriva un livello più in profondità, quando Perplexity è già nello stack.
Latenza: vince Fast, con un asterisco sui dati del fornitore
Vincitore: Fast Search, in base alle misurazioni di Perplexity. Il grafico ufficiale della latenza indica 160 ms al p50 e 230 ms al p95 per una singola chiamata Fast Search. Nel testo di lancio e nella guida live a Fast Search, Perplexity non pubblica valori p50 e p95 confrontabili per il web predefinito: non sarebbe quindi corretto attribuire un rapporto diretto tra le latenze.
I percentili contano. Il p50 rappresenta la richiesta centrale; il p95 è la soglia entro la quale termina il 95% delle richieste. Un agente che esegue più ricerche in sequenza risente della coda lenta più che della mediana, perché una sola chiamata in ritardo può bloccare l'intero piano.
Fast merita dunque il percorso sensibile alla latenza, ma in produzione la risposta dipende comunque dal carico specifico. Distanza di rete, filtri, numero di risultati richiesti, contesto estratto, batching e criteri di retry influenzano tutti il tempo end-to-end percepito dall'agente. Il dato del fornitore è un riferimento di base, non una promessa di livello di servizio per ogni integrazione.
La lettura pratica di Mikhail Basyuk centra il criterio: un p95 inferiore a 250 ms serve soltanto se resta intatta la rilevanza necessaria per l'attività. Velocità e qualità delle prove devono comparire nella stessa dashboard.
Copertura: vince il web predefinito
Vincitore: il web predefinito nelle ricerche difficili e ambigue. Nella valutazione interna del recupero, Perplexity assegna a Fast Search un punteggio di rilevanza di 2.21, contro 2.45 per la modalità predefinita: il divario è di 0.24 punti. La disponibilità delle risposte è 0.567 contro 0.596, con uno scarto di 2.9 punti percentuali.
La rilevanza misura quanto il materiale ordinato corrisponda alla query. La disponibilità della risposta indica invece se il recupero ha trovato materiale sufficiente a sostenerla. Fast può rispondere rapidamente e lasciare comunque al modello successivo un insieme di prove più sottile. Ecco perché una domanda ampia su una normativa, un confronto fra più aziende o un'affermazione controversa appartengono al web predefinito, anche quando il percorso fast sembra reattivo.
Perplexity presenta anche un risultato apparentemente opposto nel suo grafico aggregato sui fornitori, costruito su sei benchmark agentici pubblici e 3,554 attività selezionate: Fast ha ottenuto 64.3% con un costo totale stimato modello più ricerca di $59.73, mentre la modalità predefinita ha segnato 64.0% a $187.60. Il fornitore descrive la configurazione fast come più economica di circa il 68%, a fronte di una qualità aggregata delle attività comparabile.
I due risultati possono coesistere. Gli agenti aggregati possono compensare un recupero più debole grazie alle conoscenze del modello, al ragionamento, a chiamate ripetute o al fatto che le attività selezionate non penalizzano ogni fonte mancante. Un sistema di recupero grezzo usato per compliance o ricerche aziendali non può dare per scontato che il modello a valle ricostruisca un documento assente.
La più ampia guida alle API di ricerca AI applica lo stesso principio operativo a tutti i fornitori: acquistare il livello di recupero più economico capace di produrre un pacchetto di prove che superi il successivo controllo deterministico.
Come impostare fast nella Perplexity API
Eseguire due volte la stessa richiesta, modificando soltanto search_type. query, max_results, search_context_size, filtri, area geografica e posizione del client devono restare invariati. Il riferimento della Search API indica web come valore predefinito, max_results pari a 10 di default e high come dimensione standard del contesto estratto. Conviene impostare esplicitamente entrambi i controlli del confronto, così un futuro cambio dei valori predefiniti dell'API non altererà il replay.
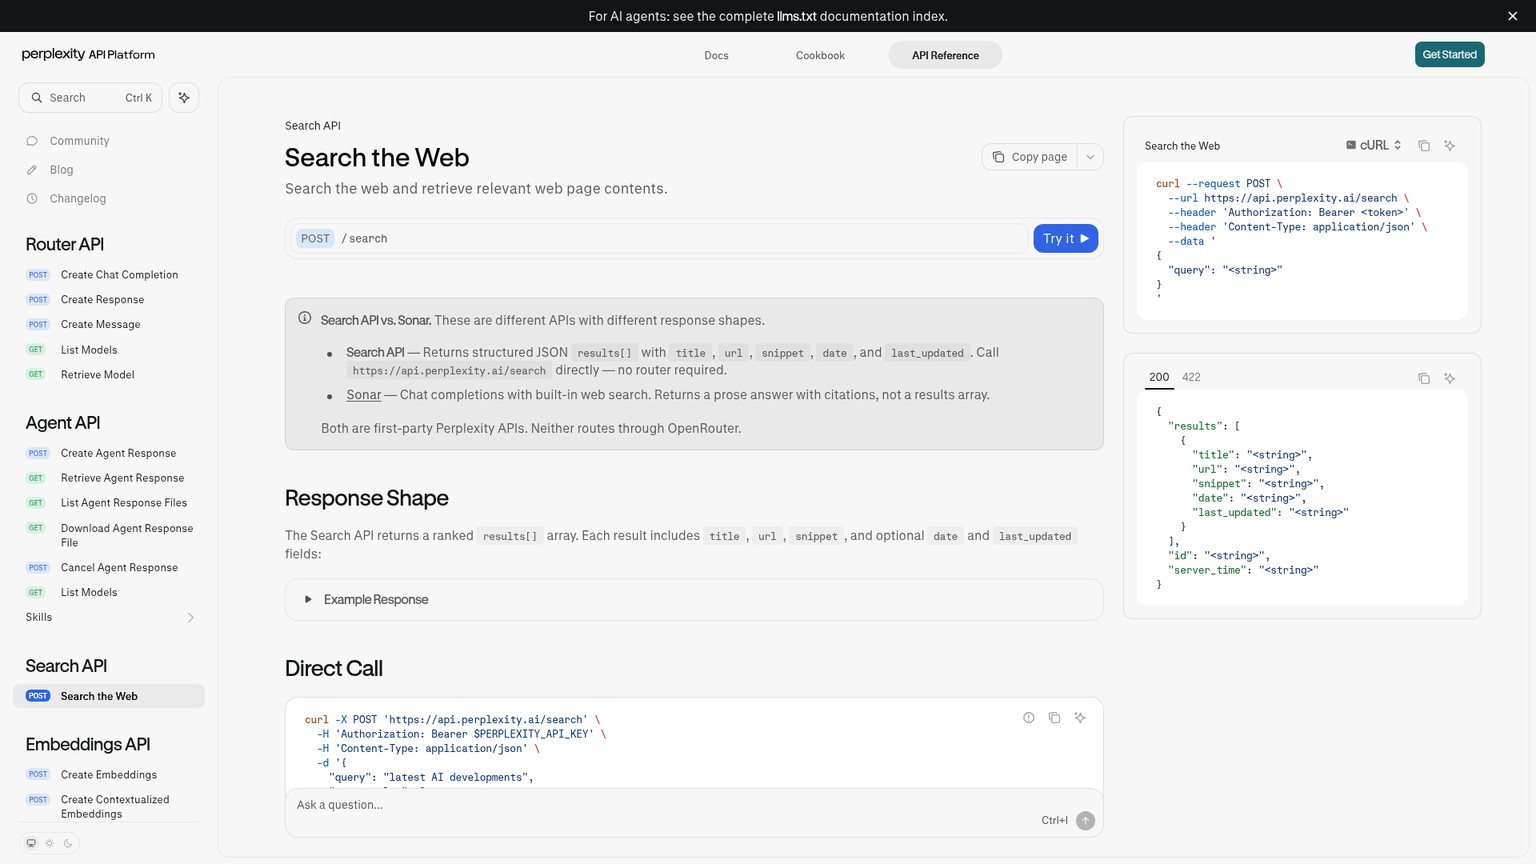
La coppia di richieste seguente è eseguibile così com'è:
set -euo pipefail
: "${PERPLEXITY_API_KEY:?Set PERPLEXITY_API_KEY first}"

QUERY='Which CRM has the stronger current EU data residency and audit-control evidence?'
COMMON=$(jq -nc --arg query "$QUERY" '{
  query: $query,
  max_results: 10,
  search_context_size: "high"
}')

for MODE in fast web; do
  jq --arg mode "$MODE" '. + {search_type: $mode}' <<<"$COMMON" |
    curl -sS 'https://api.perplexity.ai/search' \
      -H "Authorization: Bearer $PERPLEXITY_API_KEY" \
      -H 'Content-Type: application/json' \
      -o "$MODE.json" \
      -w "$MODE\tHTTP %{http_code}\t%{time_total}s\n" \
      --data-binary @-
done
In questa pubblicazione non erano disponibili credenziali per la Perplexity API. Di conseguenza, non vengono dichiarati risultati misurati su latenza, copertura, tasso di risposte vuote o supporto delle risposte. Il protocollo seguente è una piccola verifica appaiata, non una replica dello studio di Perplexity sui sei benchmark.
Il test usa 20 query di ricerca aziendale: 10 ricerche specifiche con un obiettivo autorevole e 10 domande ambigue che richiedono più fonti. Un insieme pratico e fisso può coprire prezzi SaaS correnti, limiti cloud, date normative, Paesi supportati, controlli di sicurezza, documenti societari recenti, confronti fra fornitori, effetti delle politiche, domande sul costo totale e affermazioni sostenute da prove credibili per entrambe le posizioni.
Con una sola query per chiamata, le 40 richieste grezze riuscite costano $0.12 prima di qualsiasi chiamata al modello a valle: $0.02 per 20 chiamate fast più $0.10 per 20 chiamate al web predefinito.
Bloccare i parametri della richiesta
Usare
max_results: 10esearch_context_size: "high"in entrambe le modalità. Filtri, Paese, lingua e area del client devono essere identici. L'ordine di esecuzione delle modalità va randomizzato per ciascuna query, così cache già calde e condizioni di rete temporanee non favoriscono sempre lo stesso lato.Registrare il comportamento del recupero
Acquisire
time_totalend-to-end, stato HTTP, numero di risultati, indicatore di risposta vuota, domini unici, numero di fonti autorevoli e presenza dell'eventuale fonte primaria attesa. Conservare tutto il JSON grezzo per la revisione.Applicare un'unica scala di utilità
Assegnare zero alla copertura utile quando non emerge alcuna fonte rilevante per la decisione, uno per un insieme utilizzabile ma incompleto e due per prove indipendenti sufficienti a procedere. Domini duplicati o snippet lunghi che ripetono una sola fonte non meritano punti.
Mantenere invariato il livello di risposta
Se un modello trasforma i risultati in una risposta, usare lo stesso modello, prompt, budget di token e controllo delle citazioni. Il supporto della risposta vale zero quando un'affermazione sostanziale non ha prove, uno quando il sostegno è parziale e due quando ogni affermazione sostanziale è collegata alle prove restituite.
Decidere per classe di carico
Confrontare mediane e latenza p95, risposte vuote, copertura delle fonti e supporto della risposta separatamente per le ricerche puntuali e per quelle ambigue. Promuovere fast soltanto per una classe in cui il punteggio delle prove resta entro la soglia di accettazione del team.
Il confronto decisivo non è il numero medio di risultati. Un mucchio di link deboli può essere peggiore di un piccolo insieme di fonti primarie. La copertura utile e le risposte sostenute dalle prove sono le metriche che danno significato a prezzo e latenza.
Qual è il vero costo del passaggio
Modificare il corpo della richiesta è facile; il lavoro consiste nel cambiare la politica operativa. Spostare un carico dal web predefinito a fast non richiede migrazioni di dati né un nuovo endpoint. Cambiano però il comportamento del recupero, l'identità della cache, il monitoraggio e la gestione degli errori.
search_type deve far parte della chiave di cache. Una risposta fast in cache non può soddisfare in silenzio una successiva richiesta al web predefinito, il cui chiamante ha pagato per un recupero più ampio. Per lo stesso motivo, la chiave deve includere dimensione del contesto, numero di risultati, filtri, Paese e lingua.
La modalità va registrata per ogni richiesta e ogni affermazione prodotta a valle. In caso contrario, un calo del tasso di accettazione delle fonti può sembrare deriva del modello o rumore casuale della ricerca. Il router deve inoltre esporre un motivo di escalation chiaro, come empty_results, missing_primary_source, ambiguous_query o high_impact.
Anche i tentativi successivi devono rispettare la modalità. Ripetere un timeout nella stessa modalità è un intervento sulla disponibilità. Passare da fast a web è invece un'escalation di qualità e modifica il prezzo. I due eventi non dovrebbero finire nello stesso contatore.
Chi non dovrebbe effettuare il passaggio
Fast Search non dovrebbe diventare la modalità predefinita universale quando:
- L'agente gestisce contratti, regolamentazione, sicurezza, finanza, informazioni mediche o incident response, ambiti in cui una fonte mancante può avere conseguenze gravi.
- Il carico attuale è dominato da domande ambigue che richiedono fonti diverse, non la ricerca di un fatto noto.
- Non esiste una scala per l'accettazione delle prove, quindi “più veloce” diventerebbe l'unico indicatore di successo visibile.
- Un adapter del fornitore o un SDK rifiuta il nuovo enum e il team non può usare in sicurezza la soluzione documentata o una richiesta HTTP diretta.
- Le risposte vuote ma riuscite non vengono registrate separatamente dagli errori di trasporto.
- Il sovrapprezzo del web predefinito è trascurabile rispetto alla revisione umana già obbligatoria per ogni risposta.
La migrazione più solida è un rollout instradato: spostare su fast una sola classe ripetibile, conservare web come percorso di escalation e confrontare le prove accettate prima di estendere il cambiamento.
La mossa da fare lunedì
Prima di cambiare la modalità predefinita globale, va messa in produzione una semplice politica di ricerca. Le ricerche ripetibili e a basso impatto vanno a fast; le domande ambigue o ad alto impatto a web. Il rifiuto delle prove deve poi innescare un'escalation automatica, non produrre una risposta debole invisibile.
È meglio partire dalle richieste della settimana precedente, non da demo inventate. Selezionarne 20 che rappresentino il lavoro ordinario del prodotto, dividerle in gruppi specifici e ambigui, quindi riprodurre la coppia esatta indicata sopra. Se tutte le 40 richieste single-query vanno a buon fine, il test costa $0.12 in tariffe di ricerca grezza.
Martedì vanno esaminati quattro risultati: latenza p95 delle richieste, risposte vuote ma riuscite, copertura utile delle fonti e punteggio di supporto della risposta. Se fast mantiene la soglia richiesta per il gruppo specifico, si può spostare quella sola classe. Se perde una fonte primaria nel gruppo ambiguo, il web predefinito deve rimanere, indipendentemente dal benchmark aggregato.
Questa è la conseguenza aziendale di Photon: non un'unica impostazione globale più economica, ma un pratico router basato sul rischio della ricerca. L'agente spende $1 ogni 1,000 chiamate quando la query tollera lacune e paga i $4 aggiuntivi soltanto quando un recupero più ampio può evitare un errore più costoso.
Domande frequenti
Perché Perplexity è controversa?
Le discussioni sul prodotto consumer, sull'attribuzione delle fonti e sui rapporti con gli editori sono separate dalla scelta della modalità API. Chi acquista l'API dovrebbe verificare copertura delle fonti, termini d'uso e gestione delle prove rispetto ai requisiti della propria organizzazione.
Come si imposta Perplexity come motore di ricerca predefinito?
È un'impostazione del browser o del dispositivo. In questo confronto, “predefinito” indica il comportamento della Search API: se search_type viene omesso, si usa lo standard web; Fast Search richiede invece search_type: "fast".
Perché Perplexity non funziona?
La premessa è troppo generica per essere dimostrata dalle prove API citate. In un'integrazione, l'errore va definito con precisione: risultato vuoto, fonte primaria attesa mancante, copertura utile debole, risposta non sostenuta, timeout o errore upstream.
Per le ricerche è meglio Perplexity o la modalità AI di Google?
Questo confronto riguarda prodotti di risposta destinati agli utenti, non le modalità della Search API grezza di Perplexity. La scelta fra Fast e web predefinito dipende da latenza del recupero, copertura utile delle fonti e supporto probatorio della risposta a valle.
Perché Joe Rogan usa Perplexity?
Un endorsement pubblico o una pubblicità non dimostrano una ragione tecnica e non offrono prove per scegliere fast o web. La modalità API va decisa sui dati del carico di lavoro, non sull'uso da parte di una celebrità.
Perplexity è ancora valida?
Fast Search ha un ruolo chiaro a $1 ogni 1,000 richieste grezze riuscite e Perplexity dichiara una latenza p50 di 160 ms. I risultati di recupero dello stesso fornitore mostrano però che il web predefinito resta la scelta migliore quando contano una rilevanza più ampia e la disponibilità delle risposte.
Qual è lo svantaggio di Perplexity?
Per Fast Search, lo svantaggio documentato è la minore rilevanza del recupero e la minore disponibilità delle risposte. Per il web predefinito, è il prezzo per richiesta grezza cinque volte maggiore e una latenza superiore a quella della modalità progettata appositamente per la velocità.
Perplexity sta perdendo utenti?
Le pagine citate sul lancio e sull'API non pubblicano dati certificati sull'andamento degli utenti attivi, quindi questo confronto non può sostenere tale affermazione. La crescita degli utenti, in ogni caso, non stabilirebbe quale modalità della Search API sia adatta a una query di produzione.
Perplexity AI è migliore di ChatGPT?
La Search API grezza di Perplexity restituisce risultati web ordinati che un altro sistema deve elaborare; ChatGPT è un assistente per utenti finali, con strumenti e modelli propri. È più utile confrontare il workflow concreto e i requisiti delle prove che i marchi in astratto.
Vuoi riunire in un unico foglio le domande su routing, validazione e costi? Scarica la checklist per l'audit dei workflow aziendali con l'AI e definisci lunedì il primo router basato sul rischio della ricerca.
- Ultimo aggiornamento
- 24 set 2026
- Categoria
- Build
Preferisca questo sito su Google


Segni omidsaffari.com come fonte preferita e Google lo mette in evidenza per lei in Top Stories, AI Overviews e AI Mode.

Agenti AI: quando il fallback svuota il budget
Un writer in sandbox ha reso il fallback a pagamento il percorso predefinito: come proteggere budget, credenziali e output finali degli agenti AI.24 set 2026Build
Cursor gratis? Quanto costa davvero Rollouts
Cursor gratis non include Rollouts: servono Teams o Enterprise. Scopri cosa coprono i crediti di 10 giorni, i costi ancora ignoti e quando provarlo.24 set 2026Build
AI code review con Unreal Agent: guida pratica al runner
Scopri come usare Unreal Agent in sicurezza, conservare le sessioni JSONL e valutarne costi, prestazioni e casi d’uso concreti per l’AI code review.24 set 2026Build
JetBrains Air: guida pratica al plugin Alpha
Scopri come installare JetBrains Air Alpha, collegare un agente, aggiungere il contesto del progetto e verificare ogni modifica senza perdere il controllo.23 set 2026Build
JetBrains Air gratis: cosa costa davvero e chi paga
JetBrains Air è gratis solo come plugin. Scopri chi paga agenti, API, IDE e crediti JetBrains AI, più quando convengono i piani Pro o Ultimate.23 set 2026Build
Firecrawl self host: guida a Docker, verifica e costi
Come installare Firecrawl self host con Docker Compose, verificare uno scrape reale e confrontare costi e limiti con Firecrawl Cloud in 30 giorni.22 set 2026Build
Agenti AI: perché i retry a pagamento richiedono approvazione umana
Un agente ha speso $5.48 prima della verifica umana. Ecco perché i retry a pagamento degli agenti AI richiedono un’autorizzazione indipendente.22 set 2026Build