Perplexity API Fast Search와 기본 web, 무엇을 써야 할까?
Perplexity API의 Fast Search와 기본 web을 가격, 지연 시간, 검색 품질로 비교합니다. 10,000회 호출 비용, Photon의 차이, 반복 조회와 모호한 리서치를 나누는 실전 라우팅 기준, 근거를 지키는 전환 테스트까지 한 번에 확인하세요.




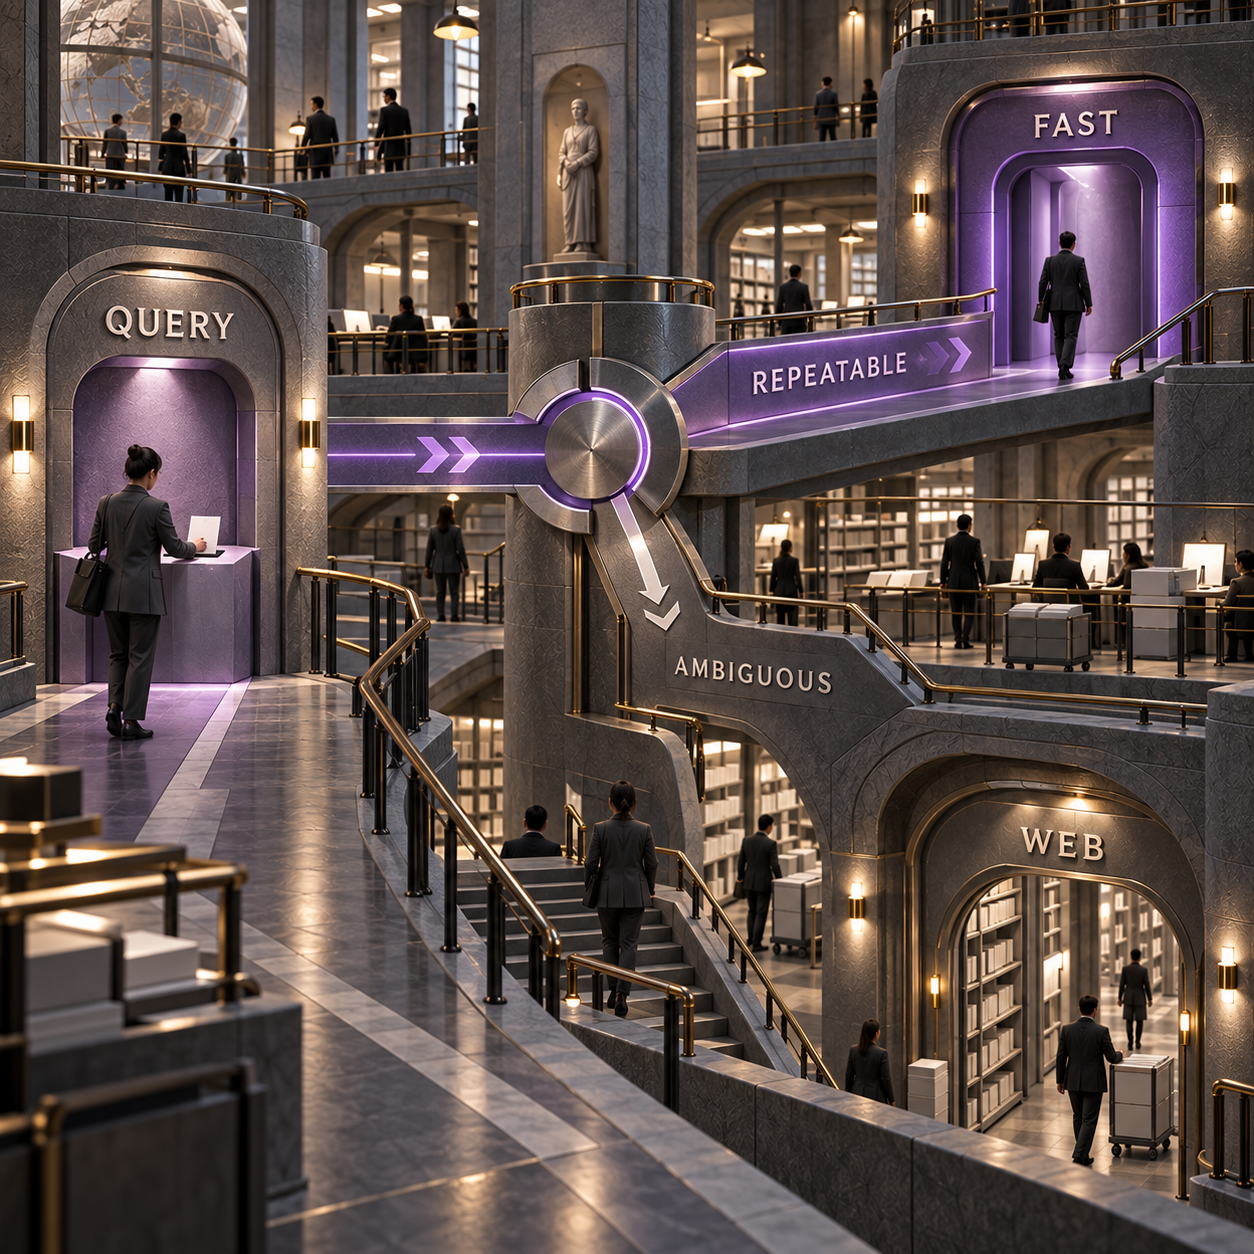
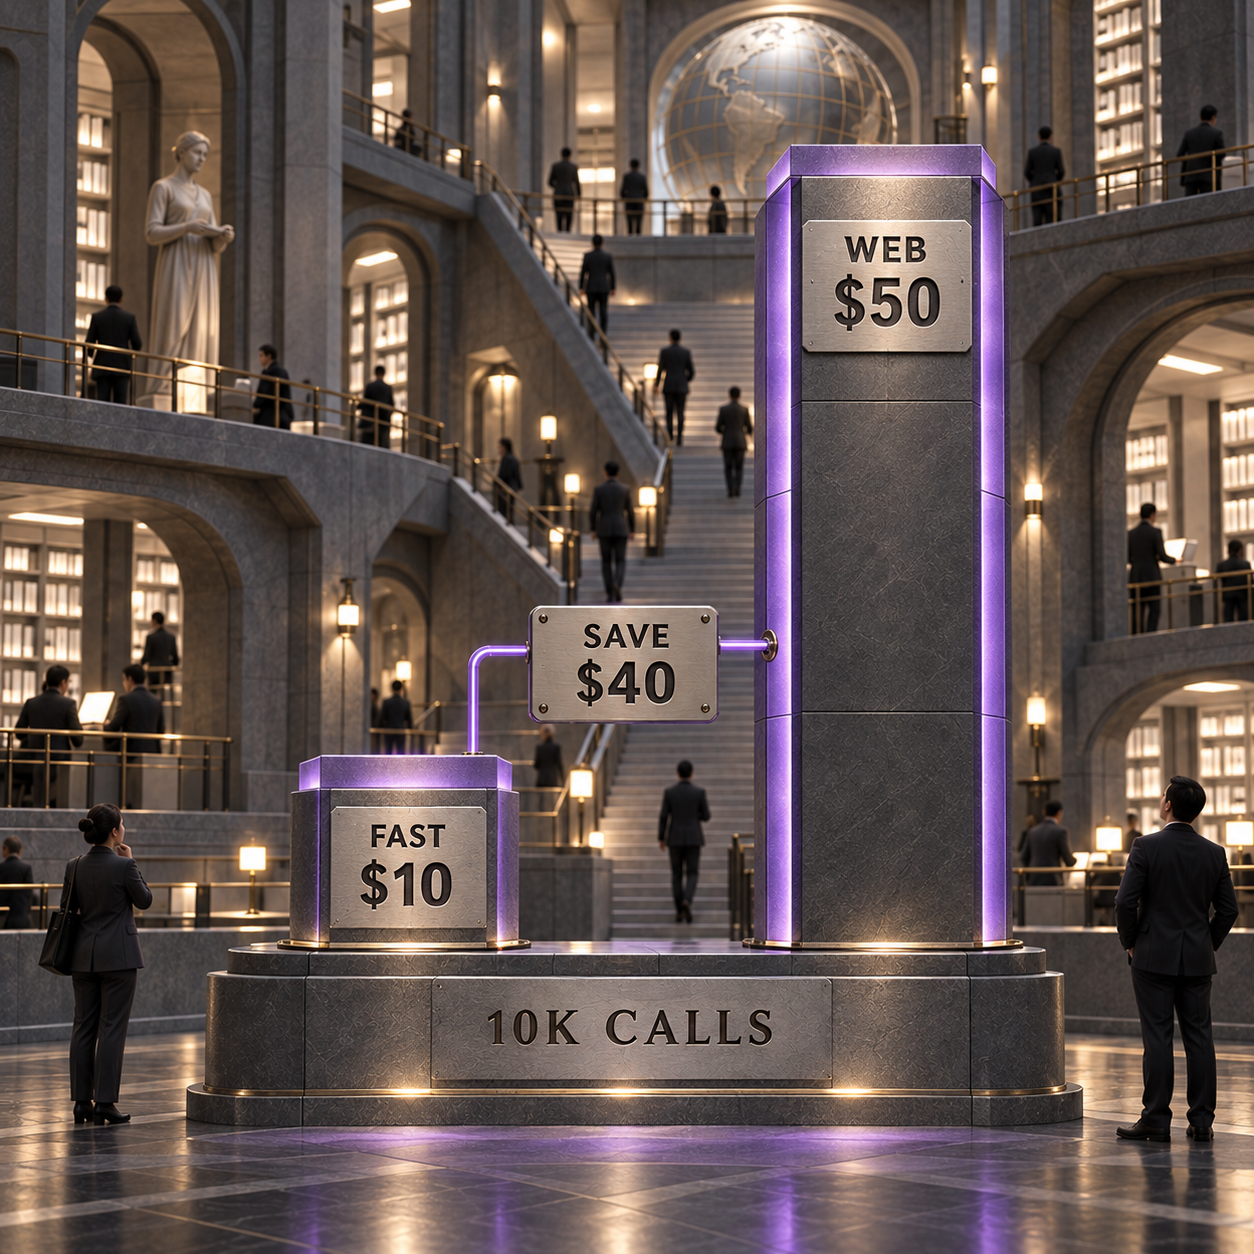
Perplexity API에서 Fast Search와 기본 모드 중 무엇을 쓸지는 결국 라우팅의 문제입니다. 반복 가능한 에이전트 조회에는 성공한 1,000회 호출당 $1인 fast를 사용하고, 질문이 모호하거나 검색 범위가 중요한 리서치에는 $5인 기본 web 모드를 유지해야 합니다. 10,000회 호출을 기준으로 결과를 처리하는 모델 비용을 제외한 순수 검색 비용은 $10와 $50입니다.
Perplexity API Fast Search와 기본 web, 무엇을 선택해야 하나?
범위가 명확하고 반복 가능한 작업에는 Fast Search를, 소스 하나의 누락만으로도 의사결정이 달라질 수 있는 작업에는 기본 web을 선택해야 합니다. 가격과 지연 시간은 Fast가 앞서고, 검색 품질과 답변 가능성은 기본 web이 앞섭니다. 프로덕션 에이전트라면 모든 쿼리를 한 모드에 몰아넣지 말고 두 모드 사이에서 라우팅해야 합니다.
Perplexity의 최신 Fast Search 가이드는 일상적인 에이전트 작업에는 fast를, 드물고 어렵거나 모호한 질문에는 기본 web 설정을 권합니다. 이 비교에 사용한 가격과 벤더 측정값은 2026년 9월 24일 Perplexity의 최신 페이지에서 확인했습니다.
고객 지원 에이전트를 출시하는 개인 개발자라면 일상적인 문서 및 상태 조회는 fast로 시작하고, 근거가 비어 있거나 약할 때 web으로 올리는 방식이 좋습니다. 기본 web 호출의 추가 비용 $0.004는 누락 때문에 사람이 검토해야 할 때는 미미하지만, 위험이 낮은 조회를 수천 번 반복할 때는 낭비입니다.
시장 조사 제품을 만드는 투자를 유치한 창업자라면 기업, 정책, 경쟁사와 관련된 모호한 질문은 기본 web에 맡겨야 합니다. 알려진 소스 확인, 제품 제공 여부, 반복 모니터링은 여전히 Fast로 처리할 수 있습니다. 제품 화면에 검색창이 하나뿐이어도 워크로드에는 두 가지 검색 등급이 존재합니다.
중견기업 CTO라면 내부 리플레이 테스트에서 Fast Search가 필요한 소스 집합을 보존한다는 사실을 확인할 때까지 조달, 보안, 규제, 사고 조사에는 기본 web을 유지해야 합니다. 요청 가격이 5배 더 저렴해도 분석가가 근거 자료를 다시 채워야 한다면 진짜 절감은 아닙니다.
Photon 기반 Perplexity Fast Search API에서 달라지는 점
Fast Search가 바꾸는 것은 검색 예산이지 엔드포인트나 결과 스키마가 아닙니다. Perplexity는 자체 검색·랭킹 엔진 Photon을 기반으로 이 모드를 2026년 9월 24일 출시했습니다. 최신 Fast Search 문서를 보면 같은 POST /search 엔드포인트가 동일한 정렬 구조의 results[] 배열을 반환하며, 요청에 search_type: "fast"만 추가하면 됩니다.
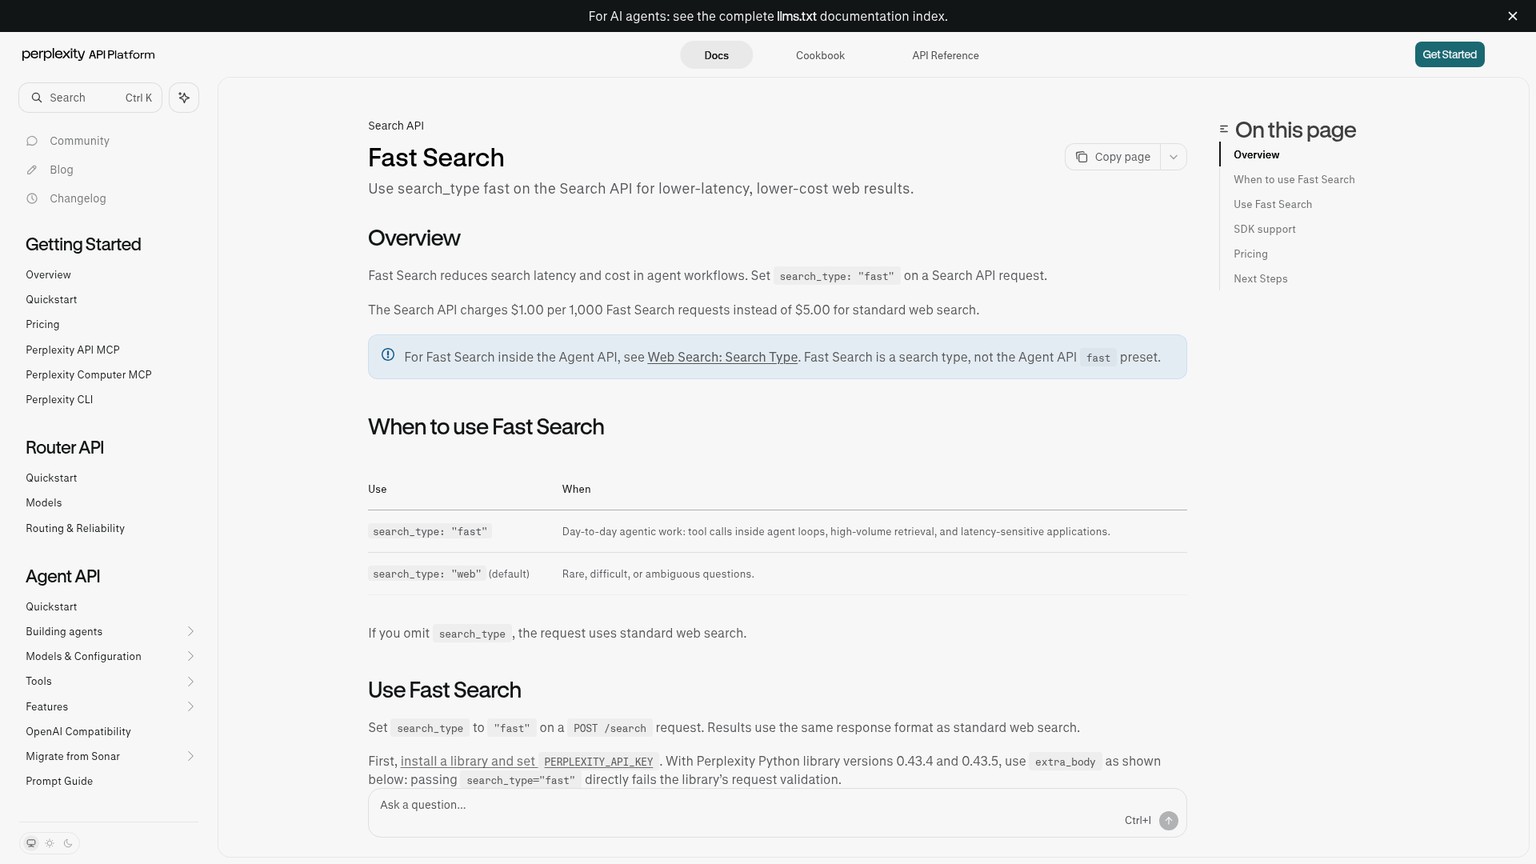
search_type을 생략하면 Perplexity는 표준 web을 사용합니다. 여기서 “기본”은 소비자용 Perplexity 앱의 기본 언어 모델을 뜻하지 않습니다. Search API의 표준 검색 모드를 뜻합니다. 두 모드 모두 후속 처리를 위해 제목, URL, 스니펫과 선택 항목인 게시일 및 업데이트 날짜를 반환합니다.
Photon 출시 자료는 쿼리에 필요한 데이터만 읽고, 디스크 대기 시간을 겹쳐 처리하며, 배치를 고려한 캐싱을 사용하는 엔진이라고 설명합니다. Perplexity의 공식 아키텍처 그림에는 브로커와 샤드를 통과하는 요청 경로가 나와 있습니다. 이런 엔지니어링 선택은 속도 주장의 배경을 설명합니다. 하지만 의도적인 랭킹 상충 관계까지 없애지는 않습니다. Fast Search는 더 적은 컴퓨팅 자원을 사용하는 대신 폭넓은 검색 품질 일부를 포기합니다.
Perplexity Photon은 엔진이지 세 번째 모드가 아닙니다
Photon은 Perplexity 검색 스택의 기반 인프라입니다. API에서 선택할 수 있는 유형은 여전히 fast, web, 그리고 별도의 인물 검색 유형인 people입니다. 개발자가 Photon을 직접 선택하거나 배포할 수 없으며, 다른 응답 객체를 받는 것도 아닙니다.
현재 SDK에는 실무적인 주의점이 있습니다. Perplexity는 Python 라이브러리 버전 0.43.4와 0.43.5에서 직접 검증이 새 값을 거부하기 때문에 extra_body={"search_type": "fast"}를 사용하라고 안내합니다. TypeScript 예제는 타입 정의가 업데이트될 때까지 SDK 0.38.5에서 "fast" as any로 캐스팅합니다. 직접 HTTP 요청을 사용하면 이 두 가지 임시 클라이언트 제약을 피할 수 있습니다.
Perplexity 검색 API 비용: 요청 10,000회에 $10 vs $50
승자: Fast Search. 최신 Perplexity 가격표에 따르면 성공한 순수 Fast Search 요청 1,000회당 $1, 성공한 기본 web 요청 1,000회당 $5이며, Search API 토큰 비용은 추가되지 않습니다.
동일한 워크로드로 환산하면 간단합니다.
- Fast Search 10,000회 호출: 10,000 × $0.001 = $10.
- 기본 web 10,000회 호출: 10,000 × $0.005 = $50.
- 차이: $40, 즉 순수 검색 비용이 80% 줄어듭니다.
이 $40가 에이전트 비용의 전부는 아닙니다. 결과를 읽는 모델, 후속 가져오기, 재시도, 검증, 사람의 검토는 모두 그 뒤에 이어집니다. Fast를 사용해 10,000회 처리하는 동안 추가 작업 비용이 $40를 넘지 않을 때만 Fast가 이깁니다.
결과가 비어 있어도 성공한 응답에는 요금이 부과됩니다
성공한 POST /search 응답은 results[]가 비어 있어도 과금됩니다. 현재 가격 규칙에 따르면 잘못된 요청, 속도 제한에 걸린 요청, 업스트림 장애는 과금되지 않습니다. 따라서 빈 결과 비율은 품질 지표일 뿐 아니라 예산 지표이기도 합니다.
배치는 비용을 바꾸지만 품질 판단은 바꾸지 않습니다
Perplexity의 다중 쿼리 빠른 시작 가이드는 요청 하나에 관련 쿼리를 최대 5개까지 받습니다. 성공한 다중 쿼리 요청은 과금 단위 하나이지만, 각 쿼리는 여전히 속도 제한에 포함됩니다. 따라서 모드마다 20개 쿼리를 4개 요청으로 묶으면 총비용은 $0.024이며, 단일 쿼리 요청 40개를 따로 보낼 때는 $0.12입니다.
단일 호출 지연 시간을 비교할 때는 배치를 사용하지 않아야 합니다. 쿼리 5개가 든 페이로드는 요청이 수행하는 작업량을 바꾸고 쿼리별 소요 시간을 가립니다. 먼저 모드별로 단일 쿼리 호출 20회를 비교해야 합니다. 모드 선택의 근거가 확보된 뒤 배치를 별도로 테스트합니다.
Agent API 툴 요금은 예산에서 별도 항목으로 분리해야 합니다
Agent API 툴 가격표의 표준 요금은 다릅니다. fast web_search 호출 1,000회당 $1, 표준 web 호출 1,000회당 $2.50이며, 선택한 모델의 토큰 비용이 추가됩니다. 이는 순수 Search API의 $1 및 $5 요금과 다릅니다. 이름에 같은 단어가 쓰였지만 Fast Search와 Agent API의 별도 fast 프리셋도 서로 다릅니다.
기존 Perplexity·Exa·Tavily 비용 비교는 어떤 제공업체를 살지 답합니다. 이번 판단은 Perplexity를 이미 스택에 도입한 뒤 한 단계 더 들어간 문제입니다.
지연 시간은 Fast가 우세하지만 벤더 측정값이라는 단서가 있습니다
승자: Perplexity 측정 기준 Fast Search. Perplexity의 공식 지연 시간 차트는 단일 Fast Search 호출이 p50에서 160 ms, p95에서 230 ms라고 보고합니다. Perplexity는 주변 출시 자료나 최신 Fast Search 가이드에 동일 조건의 기본 web p50과 p95를 공개하지 않았으므로, 두 모드의 지연 시간 비율을 정직하게 제시할 수는 없습니다.
백분위수는 중요합니다. p50은 한가운데에 위치한 요청입니다. p95는 요청의 95%가 그 안에 완료되는 시간의 경계입니다. 검색 호출을 여러 번 순차 실행하는 에이전트는 중앙값보다 느린 꼬리 구간의 영향을 더 크게 받습니다. 툴 호출 하나가 지연돼도 전체 계획이 멈출 수 있기 때문입니다.
따라서 지연 시간에 민감한 경로는 Fast에 맡길 만하지만, 프로덕션 환경의 답은 워크로드마다 다릅니다. 네트워크 거리, 필터, 요청 결과 수, 추출할 컨텍스트, 배치, 재시도 정책이 모두 에이전트가 체감하는 종단 간 시간에 영향을 줍니다. 벤더 수치는 기준점이지 모든 통합 환경에 대한 서비스 수준 보장은 아닙니다.
Mikhail Basyuk의 실무적 관점이 적절한 기준을 제시합니다. p95가 250 ms 미만이라는 수치는 작업에 필요한 관련성이 유지될 때만 유용합니다. 속도와 근거는 같은 대시보드에서 봐야 합니다.
검색 범위는 기본 web이 우세합니다
승자: 어렵고 모호한 리서치에서는 기본 web. Perplexity의 내부 검색 차트에 따르면 Fast Search의 관련성 점수는 2.21, 기본 모드는 2.45로 0.24점 차이가 납니다. 답변 가능성은 각각 0.567과 0.596으로 2.9%포인트 차이입니다.
관련성은 순위가 매겨진 자료가 쿼리와 얼마나 잘 맞는지를 뜻합니다. 답변 가능성은 검색 결과가 답변을 뒷받침하기에 충분한 자료를 제시했는지를 나타냅니다. Fast는 빠르게 응답하면서도 다음 모델에 더 빈약한 근거 묶음을 넘길 수 있습니다. 그래서 광범위한 정책 질문, 여러 기업 비교, 논쟁적인 주장은 fast 경로가 빠르게 느껴지더라도 기본 web으로 보내야 합니다.
Perplexity는 6개의 공개 에이전틱 벤치마크와 선별된 작업 3,554개를 다룬 종합 벤더 차트에서 겉보기에는 반대인 결과도 보고합니다. Fast는 모델과 검색을 합친 총 예상 비용 $59.73으로 **64.3%**를 기록했고, 기본 모드는 $187.60으로 **64.0%**를 기록했습니다. 벤더는 fast 구성이 전체 작업 품질은 비슷하면서 약 68% 저렴하다고 설명합니다.
두 결과는 동시에 성립할 수 있습니다. 종합 에이전트는 모델 지식, 추론, 반복 호출로 약한 검색을 보완할 수 있고, 선별된 작업이 누락된 모든 소스에 불이익을 주지 않을 수도 있습니다. 규정 준수나 비즈니스 리서치를 지원하는 순수 검색 시스템은 후속 모델이 누락 문서를 복구해 줄 것이라고 가정해서는 안 됩니다.
더 폭넓은 AI 검색 API 가이드도 제공업체 전반에 같은 운영 원칙을 적용합니다. 다음 단계의 결정론적 검사를 통과할 근거 묶음을 만들어 내는 범위에서 가장 저렴한 검색 단계를 선택해야 합니다.
Perplexity의 search_type을 fast로 설정하는 방법
같은 요청을 두 번 보내고 search_type만 바꾸면 됩니다. query, max_results, search_context_size, 필터, 리전, 클라이언트 위치는 그대로 유지합니다. 최신 Search API 레퍼런스는 web이 기본값이고, max_results의 기본값은 10, 추출 컨텍스트 크기의 기본값은 high라고 명시합니다. 비교할 때 두 제어값을 모두 직접 설정해야 나중에 API 기본값이 바뀌어도 리플레이 결과가 달라지지 않습니다.
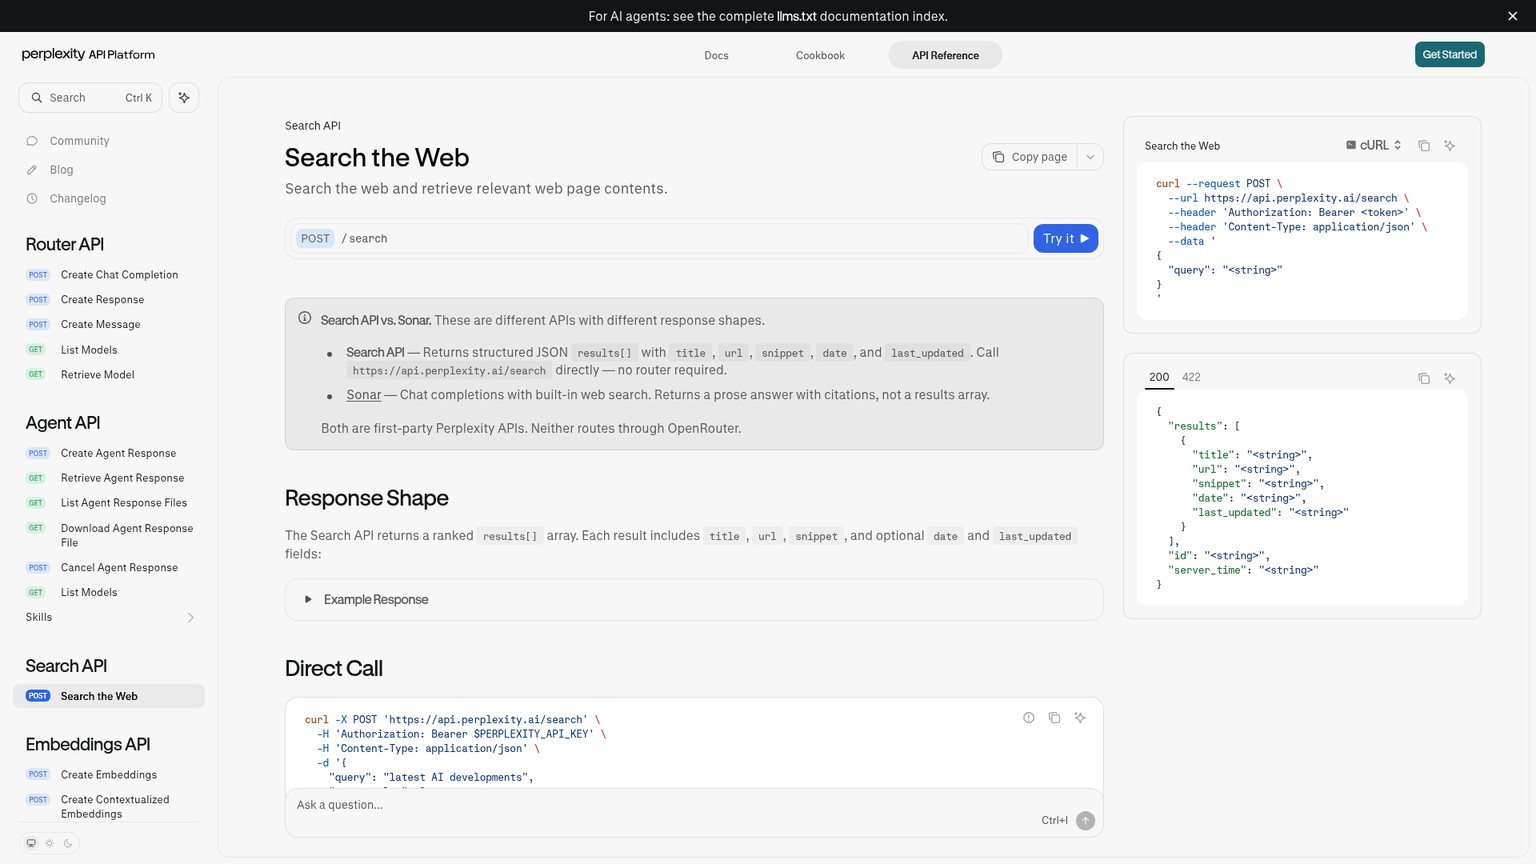
아래 요청 쌍은 그대로 실행할 수 있습니다.
set -euo pipefail
: "${PERPLEXITY_API_KEY:?Set PERPLEXITY_API_KEY first}"

QUERY='Which CRM has the stronger current EU data residency and audit-control evidence?'
COMMON=$(jq -nc --arg query "$QUERY" '{
  query: $query,
  max_results: 10,
  search_context_size: "high"
}')

for MODE in fast web; do
  jq --arg mode "$MODE" '. + {search_type: $mode}' <<<"$COMMON" |
    curl -sS 'https://api.perplexity.ai/search' \
      -H "Authorization: Bearer $PERPLEXITY_API_KEY" \
      -H 'Content-Type: application/json' \
      -o "$MODE.json" \
      -w "$MODE\tHTTP %{http_code}\t%{time_total}s\n" \
      --data-binary @-
done
이 글을 발행하는 과정에서는 Perplexity API 자격 증명을 사용할 수 없었습니다. 따라서 지연 시간, 검색 범위, 빈 결과 비율, 답변 근거 충족 여부에 대해 직접 측정한 결과는 주장하지 않습니다. 아래 프로토콜은 소규모 짝지은 검사이며, Perplexity의 6개 벤치마크 연구를 재현하는 것이 아닙니다.
비즈니스 리서치 쿼리 20개를 사용합니다. 권위 있는 목표 소스가 있는 구체적인 조회 10개와 여러 소스가 필요한 모호한 질문 10개로 나눕니다. 현재 SaaS 가격, 클라우드 제한, 규제 날짜, 지원 국가, 보안 통제, 최근 공시, 벤더 비교, 정책 영향, 총비용 질문, 양쪽 모두에 신뢰할 만한 근거가 있는 주장을 고정된 실전 세트로 구성할 수 있습니다.
단일 쿼리 기준으로 이 성공한 순수 요청 40회의 비용은 후속 모델을 호출하기 전 $0.12입니다. fast 20회에 $0.02, 기본 web 20회에 $0.10가 듭니다.
요청 조건을 고정합니다
두 모드 모두
max_results: 10과search_context_size: "high"를 사용합니다. 필터, 국가, 언어, 클라이언트 리전을 동일하게 유지합니다. 각 쿼리에서 먼저 실행할 모드를 무작위로 정해 예열된 캐시와 일시적인 네트워크 상태가 늘 한쪽에 유리하게 작용하지 않도록 합니다.검색 동작을 기록합니다
종단 간
time_total, HTTP 상태, 결과 수, 빈 응답 플래그, 고유 도메인, 권위 있는 소스 수, 예상한 주요 소스의 포함 여부를 수집합니다. 검토를 위해 모든 원본 JSON을 보관합니다.하나의 유용성 평가표를 적용합니다
유용한 소스 범위는 의사결정에 관련된 소스가 없으면 0점, 쓸 수 있지만 불완전하면 1점, 진행하기에 충분한 독립 근거가 있으면 2점으로 평가합니다. 중복 도메인이나 한 소스의 내용을 반복하는 긴 스니펫에는 점수를 주지 않습니다.
답변 계층을 동일하게 유지합니다
모델이 결과를 답변으로 변환한다면 같은 모델, 프롬프트, 토큰 예산, 인용 검사기를 사용합니다. 중요한 주장에 근거가 없으면 답변 근거 점수를 0점, 일부만 뒷받침되면 1점, 모든 중요 주장이 반환된 근거와 연결되면 2점으로 평가합니다.
워크로드 등급별로 결정합니다
조회 그룹과 모호한 질문 그룹을 나눠 중앙값과 p95 지연 시간, 빈 응답, 소스 범위, 답변 근거를 비교합니다. 해당 등급의 근거 점수가 팀의 허용 범위 안에 있을 때만 fast로 전환합니다.
핵심 비교 지표는 평균 결과 수가 아닙니다. 질 낮은 링크가 많이 쌓인 결과는 소수의 주요 소스보다 못할 수 있습니다. 유용한 검색 범위와 근거가 뒷받침된 답변을 측정해야 가격과 지연 시간이 의미를 갖습니다.
모드를 전환할 때 실제로 드는 비용
요청 본문을 바꾸는 일은 쉽지만, 운영 정책을 바꾸는 일이 진짜 작업입니다. 워크로드를 기본 web에서 fast로 옮길 때 데이터 마이그레이션이나 새 엔드포인트는 필요하지 않습니다. 하지만 검색 동작, 캐시 식별자, 모니터링, 실패 처리 방식은 달라집니다.
캐시 키에 search_type을 넣어야 합니다. fast 응답 캐시가 나중에 더 넓은 검색을 위해 비용을 지불한 기본 web 요청에 몰래 쓰여서는 안 됩니다. 같은 이유로 컨텍스트 크기, 결과 수, 필터, 국가, 언어도 포함해야 합니다.
모든 요청과 모든 후속 주장에 모드를 기록합니다. 이 정보가 없으면 소스 채택률 하락이 모델 드리프트나 무작위 검색 노이즈처럼 보입니다. 라우터에는 empty_results, missing_primary_source, ambiguous_query, high_impact처럼 확인 가능한 상향 전환 이유도 필요합니다.
재시도는 모드를 인식하도록 설계해야 합니다. 같은 모드에서 시간 초과 요청을 다시 보내는 것은 가용성 조치입니다. fast에서 web으로 재시도하는 것은 품질 상향 조정이며 가격도 바뀝니다. 두 이벤트를 하나의 카운터에 집계해서는 안 됩니다.
Fast Search로 전환하지 말아야 할 경우
다음 조건에서는 Fast Search를 모든 요청의 기본값으로 삼지 않아야 합니다.
- 소스 누락의 파급력이 큰 계약, 규제, 보안, 금융, 의료 정보, 사고 대응을 에이전트가 처리합니다.
- 현재 워크로드 대부분이 이미 알려진 사실 조회보다 다양한 소스가 필요한 모호한 질문입니다.
- 채택 가능한 근거의 평가 기준이 없어 “더 빠르다”는 지표만 성공으로 보이게 됩니다.
- 제공업체 어댑터나 SDK가 새 enum을 거부하며, 문서에 나온 우회 방법이나 직접 HTTP를 팀이 안전하게 사용할 수 없습니다.
- 성공했지만 비어 있는 응답을 전송 실패와 구분해 기록하지 않습니다.
- 모든 답변에 이미 사람의 검토가 필요해 기본 web의 추가 비용이 미미합니다.
더 나은 마이그레이션 방식은 라우팅 기반의 점진적 배포입니다. 반복 가능한 워크로드 하나만 fast로 옮기고, web을 상향 전환 경로로 유지하면서 채택된 근거를 비교한 뒤 범위를 넓혀야 합니다.
월요일에 바로 할 일
전역 기본값을 바꾸기 전에 간단한 검색 정책부터 배포합니다. 반복 가능하고 영향이 작은 조회는 fast로, 모호하거나 영향이 큰 질문은 web으로 라우팅합니다. 근거가 기준을 통과하지 못하면 보이지 않는 부실 답변으로 남기지 말고 자동으로 상향 전환합니다.
인위적으로 만든 데모가 아니라 지난주 요청부터 시작합니다. 제품의 일상 업무를 대표하는 요청 20개를 골라 구체적인 질문과 모호한 질문 그룹으로 나눈 뒤 위의 요청 쌍을 그대로 리플레이합니다. 단일 쿼리 요청 40개가 모두 성공하면 테스트의 순수 검색 비용은 $0.12입니다.
화요일에는 p95 요청 지연 시간, 성공했지만 비어 있는 응답, 유용한 소스 범위, 답변 근거 점수라는 4가지 결과를 검토합니다. 구체적인 질문 그룹에서 fast가 근거 기준을 지키면 그 등급만 옮깁니다. 모호한 질문 그룹에서 주요 소스를 놓친다면 종합 벤치마크 결과와 관계없이 기본 web을 유지합니다.
Photon이 만드는 비즈니스 변화는 하나의 저렴한 전역 설정이 아니라 실용적인 검색 위험 라우터입니다. 에이전트는 쿼리의 누락 위험이 작을 때 호출 1,000회당 $1를 쓰고, 더 넓은 검색으로 비용이 큰 누락을 막을 수 있을 때만 $4를 추가로 지불합니다.
자주 묻는 질문
Perplexity는 왜 논란이 되나요?
소비자용 제품, 출처 표기, 퍼블리셔 관계를 둘러싼 논쟁은 이 API 모드 선택과 별개입니다. API 구매자는 조직의 자체 요구사항에 맞춰 소스 범위, 이용 약관, 근거 처리 방식을 검증해야 합니다.
기본 검색 엔진을 Perplexity로 바꾸려면 어떻게 해야 하나요?
이는 브라우저나 기기의 설정입니다. 이 비교에서 “기본”은 Search API의 동작을 뜻합니다. search_type을 생략하면 표준 web을 사용하고, Fast Search를 쓰려면 search_type: "fast"를 지정해야 합니다.
Perplexity가 실패하는 이유는 무엇인가요?
인용한 API 근거만으로는 이처럼 광범위한 전제를 확립할 수 없습니다. 통합 환경에서는 빈 결과, 예상한 주요 소스의 누락, 부족한 유용 소스 범위, 근거 없는 답변, 시간 초과, 업스트림 오류처럼 실패를 정확히 정의해야 합니다.
검색에는 Perplexity와 Google AI 모드 중 무엇이 더 좋은가요?
이는 Perplexity의 순수 Search API 모드가 아니라 소비자용 답변 제품을 비교하는 질문입니다. Fast와 기본 web 중 하나를 고를 때는 검색 지연 시간, 유용한 소스 범위, 후속 답변을 뒷받침하는 근거로 판단해야 합니다.
Joe Rogan은 왜 Perplexity를 사용하나요?
공개적인 추천이나 광고만으로 기술적인 이유가 입증되지는 않으며, fast와 web을 고르는 근거도 얻을 수 없습니다. API는 유명인의 사용 여부가 아니라 워크로드 데이터로 결정해야 합니다.
지금도 Perplexity를 쓸 만한가요?
Fast Search는 성공한 순수 요청 1,000회당 $1라는 분명한 용도가 있고, Perplexity는 p50 지연 시간이 160 ms라고 보고합니다. 동시에 벤더의 자체 검색 결과에서도 더 넓은 관련성과 답변 가능성이 중요할 때는 기본 web이 더 나은 선택으로 나타납니다.
Perplexity의 단점은 무엇인가요?
Fast Search의 문서화된 단점은 더 낮은 검색 관련성과 답변 가능성입니다. 기본 web의 단점은 순수 요청 가격이 5배 더 높고, 속도를 위해 특별히 만든 모드보다 지연 시간이 길다는 점입니다.
Perplexity는 사용자를 잃고 있나요?
인용한 출시 자료와 API 페이지는 감사를 거친 활성 사용자 추세 데이터를 공개하지 않으므로, 이 비교는 그런 주장을 뒷받침할 수 없습니다. 사용자 증가율을 알아도 프로덕션 쿼리에 어떤 Search API 모드가 맞는지는 결정할 수 없습니다.
Perplexity AI가 ChatGPT보다 더 좋은가요?
Perplexity의 순수 Search API는 다른 시스템이 처리할 순위화된 웹 결과를 반환하고, ChatGPT는 자체 툴과 모델을 갖춘 최종 사용자용 어시스턴트입니다. 브랜드를 추상적으로 비교하기보다 구체적인 워크플로와 근거 요구사항을 비교해야 합니다.
라우팅, 검증, 비용 질문을 한 장에서 정리하고 싶나요? AI Business Workflow Audit Checklist를 다운로드하고 월요일에 첫 검색 위험 라우터를 설계해 보세요.
- 마지막 업데이트
- 2026년 9월 24일
- 카테고리
- Build
Google에서 이 사이트를 우선하기


omidsaffari.com을 선호 소스로 지정하면 Google이 Top Stories, AI Overviews, AI Mode에서 우선적으로 보여 줍니다.

AI 에이전트 비용 누수의 시작: 유료 폴백이 기본 경로가 된 날
샌드박스의 파일 전달 실패가 유료 이미지 폴백을 기본 경로로 바꿔 공유 잔액을 소진시킨 실제 사례를 분석합니다. AI 에이전트 비용 누수를 막기 위해 아티팩트 전달, 완료 상태, 예산 통제를 운영 환경에서 어떻게 설계하고 검증해야 하는지 실무 관점에서 짚습니다.2026년 9월 24일Build
Cursor 가격 분석: Rollouts 무료 크레딧 뒤의 실제 비용
Cursor 가격을 기준으로 Rollouts가 정말 무료인지 따져봅니다. Teams의 사용자당 월 $40 요금, 10일 크레딧, 공개되지 않은 이후 사용료를 분리하고, 개발자·운영자·구매 담당자가 도입 전에 확인할 핵심 비용과 테스트 기준을 정리했습니다.2026년 9월 24일Build
AI 에이전트 Unreal Agent 실전 사용법: 러너부터 검증까지
Unreal Agent 러너로 범위를 제한한 저장소 작업을 실행하고 JSONL 세션, 비용, 소요 시간, 토큰 사용량을 검증하는 방법을 알아봅니다. 비동기 Go 기반 AI 에이전트 런타임을 실제 개발 워크플로에 넣기 전에 확인할 선택 기준과 운영 조건까지 정리했습니다.2026년 9월 24일Build
JetBrains Air로 AI 코딩 에이전트 시작하기
JetBrains IDE에 Air Alpha를 설치하고 AI 코딩 에이전트를 연결하는 과정부터, 필요한 파일만 컨텍스트로 추가해 작은 수정과 테스트를 맡기고 변경된 코드를 직접 검토해 유지·수정·커밋·되돌리기까지 결정하는 안전한 첫 실전 워크플로를 단계별로 안내합니다.2026년 9월 23일Build
JetBrains Air 무료 사용 범위: 플러그인과 AI 비용 구조
JetBrains Air 플러그인은 $0이지만 IDE 라이선스와 코딩 에이전트 비용은 별도입니다. Junie Lite, 에이전트 로그인, API 키, JetBrains AI 중 누가 비용을 부담하는지와 2026년 말까지 적용되는 무료 경로를 한눈에 정리합니다.2026년 9월 23일Build
Firecrawl Docker 셀프 호스팅: 설치·검증·비용 가이드
Firecrawl Docker 셀프 호스팅의 설치와 검증 방법, 기본 스택의 기능 경계, Firecrawl Cloud와의 30일 비용 차이를 분석합니다. v2.11.162 고정부터 실제 스크래핑과 재시작 테스트까지 확인하고 통제권이 추가 비용을 감수할 가치가 있는지 판단해 보세요.2026년 9월 22일Build
AI 에이전트 재시도, 사람의 승인이 필요한 순간
AI 에이전트가 자체 품질 검수 뒤 유료 렌더링을 다시 실행해 $5.48의 비용을 지출한 사례를 분석합니다. 휴먼 인 더 루프 승인 경계를 어디에 두고, 모델이 쓸 수 없는 승인 필드와 코드 차단으로 반복 결제를 막는지 실무 흐름과 적용 원칙까지 단계별로 설명합니다.2026년 9월 22일Build